著者注:本文では、2026-10-24に取得した公式料金表をもとに、Kimi K3.1 Proの5段階の料金、キャッシュ料金、レート制限の各プランを解説します。さらに、すぐに使える3つの計算例を通じて、1回のリクエストにかかる費用を具体的に説明します。
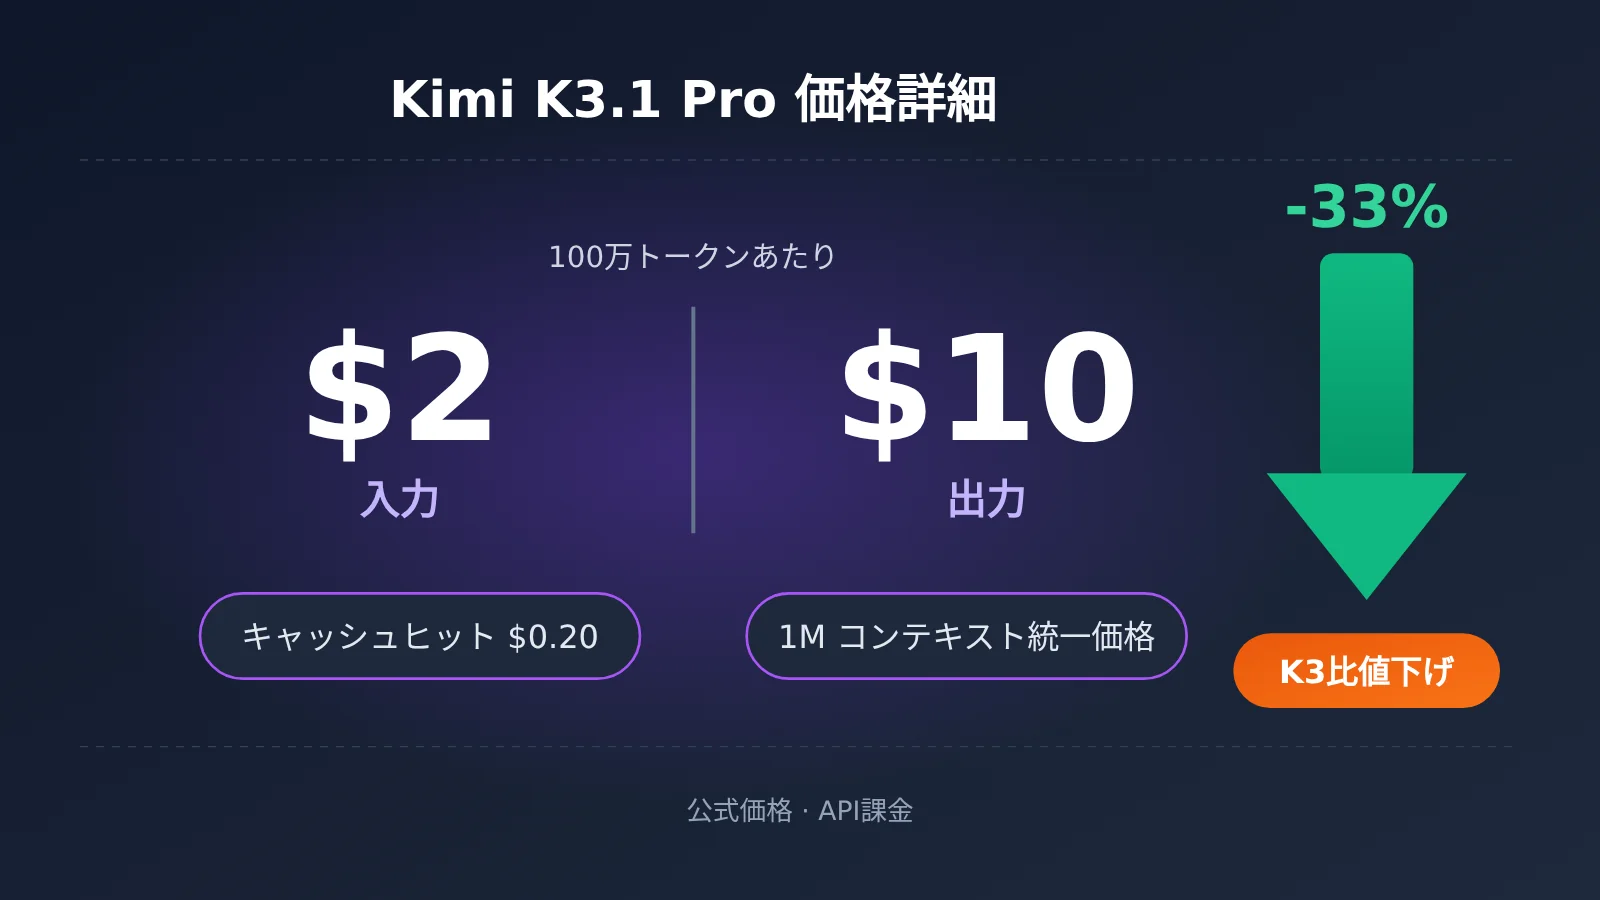
Kimi K3.1 Proの公式料金は、入力が$2、出力が$10、キャッシュヒット時はわずか$0.20(単位:100万トークンあたり)です。前世代のKimi K3より33%安く、Claude Sonnet 5.5やGPT-6.1 Solと同額で、Claude Opus 5.5の半額です。
これらの結論は、Moonshotの公式料金ページ(platform.kimi.aiのpricingドキュメント)と、第三者機関Artificial Analysisの試算データに基づいています。本文中の数値には、出典の区分を明記します。「公式」はMoonshotのブログまたは公式ドキュメントの公表値、「第三者」はArtificial Analysisなどによる外部試算を指します。信頼できる出典が見つからない情報は「未確認」と記載します。
この記事は、料金表を書き写しただけのものではありません。 単価が33%下がっても、請求額が必ず33%下がるとは限りません。どのような場合に節約できるのか、そうでないのはどんな場合なのかも、詳しく解説します。
この記事でわかること:読み終えると、Kimi K3.1 Proのリクエスト1回あたりのコストを自分で計算できるようになります。また、どのような場面でキャッシュを有効にするべきか、いつレート制限のプランを事前にアップグレードするべきか、国内の開発者がどのように支払い、接続すればよいかもわかります。
1. Kimi K3.1 Proの料金:押さえておきたいポイント
まずは、よくある疑問を表にまとめました。詳しくは後半の各セクションで解説します。
| ポイント | 内容 | 情報源 | 利用者にとっての意味 |
|---|---|---|---|
| 基本料金 | 入力 $2 / 出力 $10 / キャッシュヒット $0.20 | 公式 | Sonnet 5.5、GPT-6.1 Solと同じ価格帯 |
| 前世代との比較 | 3項目すべて、K3から33%値下げ | 公式 / 第三者 | 単価は大幅に下がっています |
| コンテキスト | 1,048,576 tokens。長さによる料金区分なし | 公式 | 長い文書でも、長さを理由に料金が上がることはありません |
| 1タスクあたりのコスト | 約 $1.98(公開記事)/ $2.11(モデルページ) | 第三者 | K3とほぼ同じで、単価の値下げと同じ割合では下がっていません |
| 利用開始の条件 | 最低 $1のチャージが必要。Tier0は3 RPM | 公式 | 本格的に利用する前に、上位ティアへの移行が必要です |
ここでは、後の説明で何度も出てくる用語を2つ紹介します。tokenはモデルの課金に使われる最小単位で、「単語や文字のかけら」のようなものです。公式の目安では、英語の場合、約3〜4文字が1 tokenに相当します。百万tokens(MTok)は1,000,000 tokensのことで、料金表の「$2」は入力tokenを100万個処理するごとに$2かかることを意味します。
1.1 Kimi K3.1 Proの課金項目
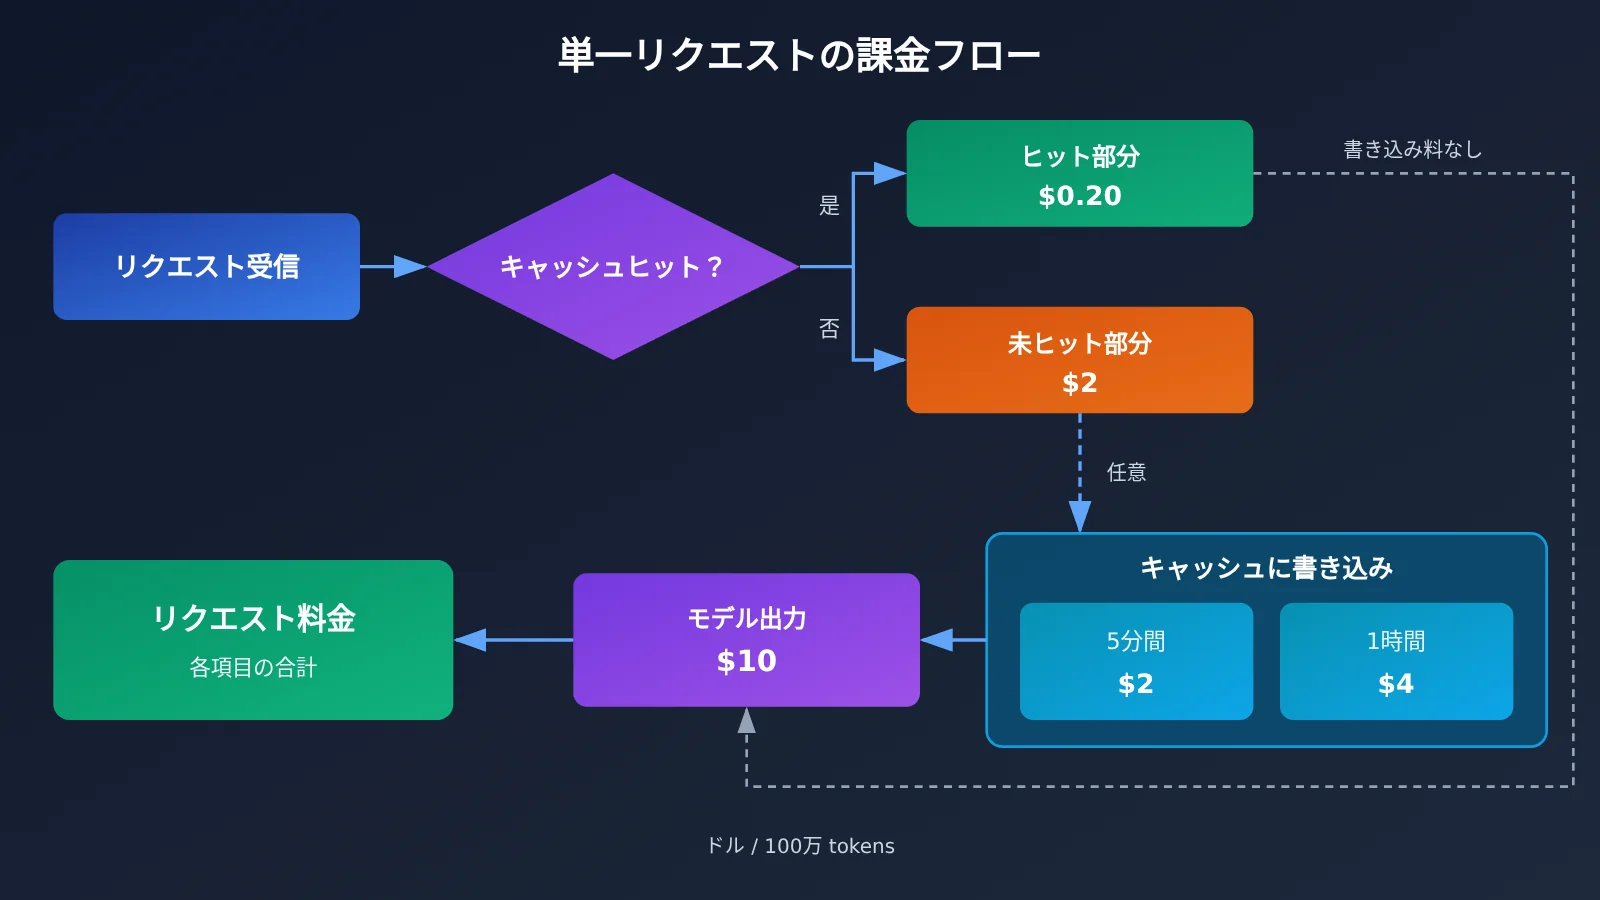
公式ドキュメントに記載されている課金項目は、大きく分けて3種類です。キャッシュへの書き込み(5分と1時間の2種類)、入力(キャッシュヒットとキャッシュミス)、出力です。これらを分けると、料金表にある5つの料金になります。リクエストごとの料金は、それぞれの項目をtoken数に応じて計算し、合算した金額です。
今回の料金設定で特に注目したいのが、コンテキストキャッシュです。連続した複数のリクエストで、冒頭部分が完全に同じ場合(たとえば、同じ長いシステムプロンプトを使う場合)、プラットフォームがその内容を保存し、次回以降に再利用します。再利用された部分には、通常より大幅に安い「キャッシュヒット料金」が適用されます。公式によると、Kimi APIではリクエスト内で繰り返されるプレフィックスに対して、キャッシュ料金が自動的に適用されます。デフォルトのTTLは5分です。TTLとは「キャッシュが保持される期間」を指します。
公式ドキュメントには、見落としやすいルールもいくつか記載されています。K3シリーズでは、キャッシュヒットした部分にはヒット料金のみが適用され、書き込み料金は別途かかりません。ファイル関連API(文書内容の抽出、ファイルの保存)は現在無料ですが、抽出した内容をモデルに入力すると、通常どおりtoken数に応じた料金がかかります。料金表の価格は税抜きで、最終的な金額は支払い地域のルールに従って決まります。
2. Kimi K3.1 Proの完全価格表:5つの価格を一覧で比較
以下の表では、Kimiの現在の主力モデルの5つの価格をまとめています。モデルごとの価格を比較する際にご活用ください。「記載なし」は公式価格ページに価格が掲載されていないことを示し、無料という意味ではありません。
| モデル | 入力(キャッシュ未ヒット) | 出力 | キャッシュヒット時の入力 | キャッシュ書き込み(5分) | キャッシュ書き込み(1時間) |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3(前世代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | 記載なし | 記載なし |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | 記載なし | 記載なし |
注:2026-10-24時点で取得。単位は100万トークンあたりの米ドルで、価格に税金は含まれていません。出典:公式価格ページ。
この表から、いくつかの傾向が読み取れます。まず、K3.1 Proの5分間のキャッシュ書き込み料金は通常の入力料金と同じ$2です。そのため、5分間のキャッシュを有効にしても、追加コストはほとんどかかりません。一方、1時間のキャッシュ書き込み料金は$4で、入力料金の2倍です。
次に、Highspeed版はキャッシュヒット時の料金が同じ$0.20である点を除き、すべての項目で標準版の2倍です。そのため、長いプレフィックスを再利用する場合は、両者の価格差が小さくなります。
最後に、K2.7 CodeとK2.6の単価はK3.1 Proの半分以下です。最も高い推論能力が必要ないタスクであれば、これらのモデルが引き続きより低コストな選択肢になります。
2.1 Kimi K3.1 Proと同価格帯モデルの比較
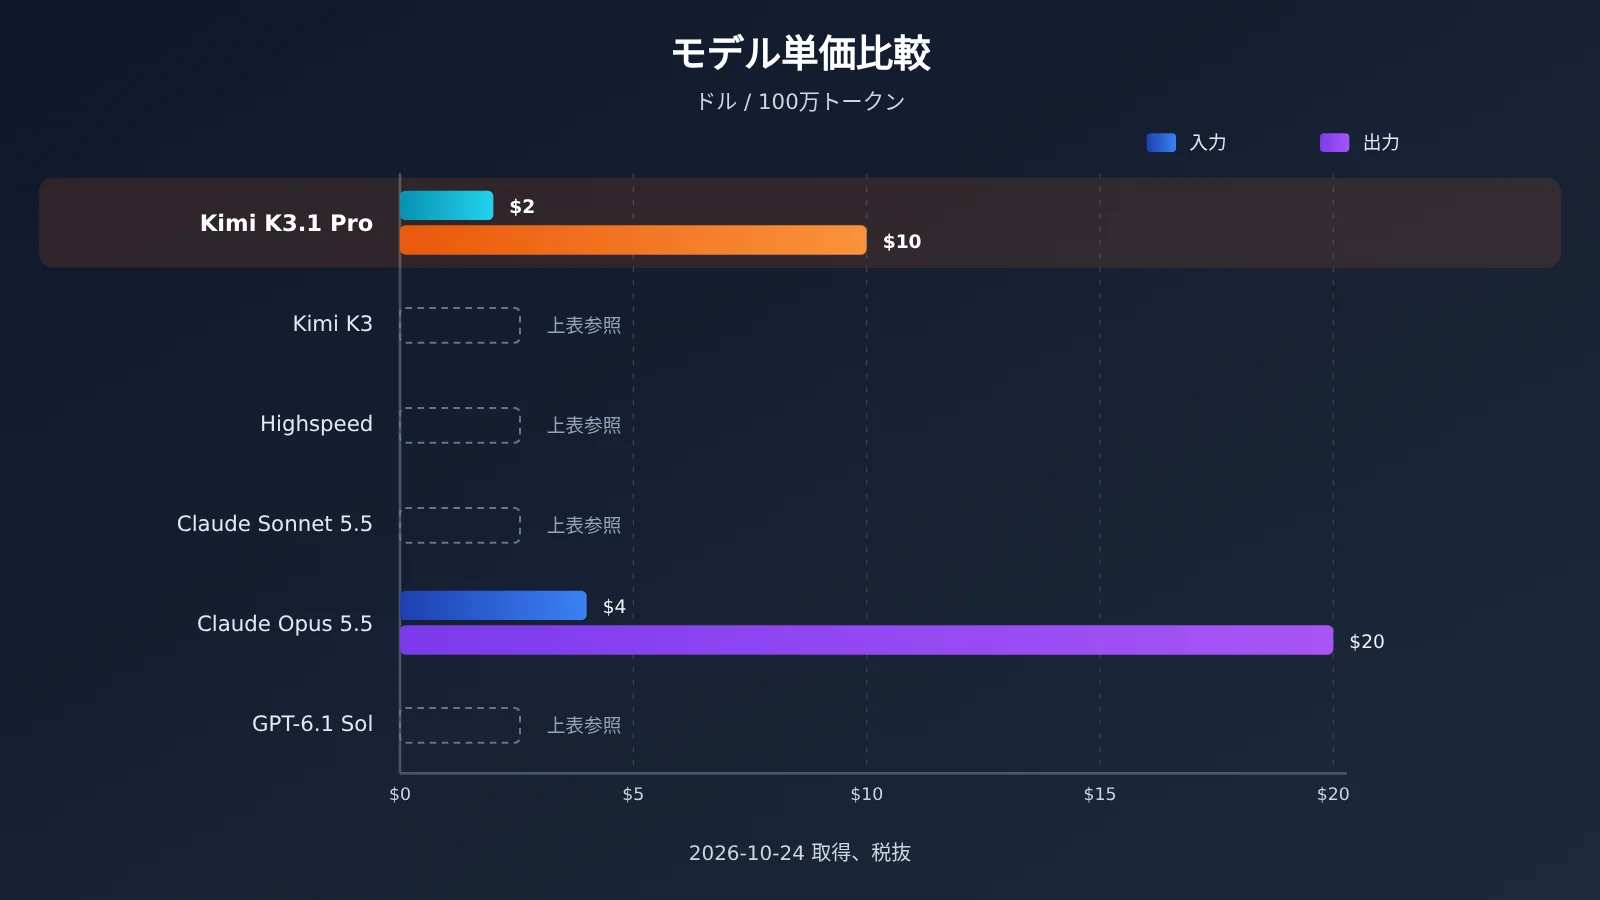
同じ基準(米ドル/100万トークン)で主要モデルを比較すると、K3.1 Proの位置づけがより明確になります。
| モデル | 入力/出力 | キャッシュ読み込み | キャッシュ書き込み · 短時間 | キャッシュ書き込み · 長時間 | 出典 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2(5分) | $4(1時間) | 公式 |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4(5分) | $8(1時間) | 公式 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50(5分) | $4(1時間) | 公式 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5(5分) | $8(1時間) | 公式 |
| GPT-6.1 Sol(入力 ≤272K) | $2 / $10 | $0.10 | $2.50(30分) | $5(12時間) | 公式 |
| GPT-6.1 Sol(入力 >272K) | $4 / $15 | $0.20 | $5(30分) | $10(12時間) | 公式 |
| GPT-6 Astra(入力 ≤272K) | $10 / $50 | $1.00 | $12.50(30分) | $25(12時間) | 公式 |
| GPT-6 Astra(入力 >272K) | $20 / $75 | $2.00 | $25(30分) | $50(12時間) | 公式 |
表のデータは各社の公式料金ページに基づいています。2026-10-24時点の取得データで、単位は米ドル/100万トークン、税抜きです。各社でキャッシュの有効期間が異なり、KimiとClaudeは5分/1時間、OpenAIは30分/12時間です。書き込み料金は、キャッシュされていない入力料金のそれぞれ1.25倍、2.5倍です。読み込み料金は多くのモデルで入力料金の10%ですが、GPT-6.1 Solのみ5%です。また、OpenAIは入力長に応じて料金が変わります。入力が272Kトークン以下の場合は短いコンテキスト向けの料金、272Kトークンを超える場合は長いコンテキスト向けの料金が適用されます。表には標準料金のみを記載しています。OpenAIのBatch(半額)、Fast(旧Priority)、UltraFastはさらに高額なため、含めていません。
比較すると、Claude Sonnet 5.5とGPT-6.1 Solはキャッシュ読み込み料金がより安く、どちらも$0.10です。そのため、長いプレフィックスを頻繁に再利用する用途では有利です。ただし、Sonnet 5.5の5分間の書き込み料金は$2.50で、K3.1 Proの$2をやや上回ります。一方、K3.1 Proは「書き込み料金が安いこと」と「コンテキスト長にかかわらず料金が一律であること」が強みで、一度に大きな文書を読み込むタスクに向いています。Claude Opus 5.5は入力・出力ともにK3.1 Proの2倍の料金です。選ぶ理由は価格ではなく、必要な性能にあるでしょう。GPT-6.1 Solはキャッシュ書き込み料金が弱点です。30分間の書き込み料金は$2.50で、K3.1 Proの5分間の料金$2を上回ります。また、入力長によって料金が変わり、272Kトークンを超えると入力料金は$4、出力料金は$15になります。長文書を扱う場合は、長いコンテキスト向けの料金を確認してください。
選び方のヒント:同価格帯のモデルでも、実際の性能差はタスクによって異なります。同じプロンプトを使ってそれぞれ試し、比較してから選ぶのがおすすめです。APIYI(apiyi.com)のモデル一覧には、claude-sonnet-5-5、claude-opus-5-5、kimi-k3などがあり、1つのAPIキーで比較テストできます。K3.1 Proの具体的なモデル名と料金は、プラットフォームのモデル一覧をご確認ください。本モデルは近日中に提供開始予定です。
3. Kimi K3.1 Proの1回あたりのリクエスト料金:計算例3つ
料金表がわかったら、次に気になるのは「1回の呼び出しでいくらかかるのか」でしょう。ここでは、短い会話、長いプロンプトの再利用、長文ドキュメントの読み取りという、代表的な3つのケースを取り上げます。計算式も示すので、ご自身のトークン数を当てはめてみてください。基本の計算式は次のとおりです。料金 = トークン数 × 単価 ÷ 1,000,000。
3.1 例1:Kimi K3.1 Proの短いリクエストの料金
ケース:一般的な質疑応答で、入力は2,000トークン(キャッシュ未ヒット)、出力は500トークン。
- 入力:
2000 × 2 ÷ 1000000 = $0.004 - 出力:
500 × 10 ÷ 1000000 = $0.005 - 合計:
$0.004 + $0.005 = $0.009
このような短い会話なら、1回あたり1セント未満です。注意したいのは、出力単価が入力単価の5倍である点です。短いリクエストでは、出力が料金の半分以上を占めることもよくあります。入力を圧縮するより、出力の長さを抑えるほうが効果的です。
3.2 例2:Kimi K3.1 Proで長いプロンプトを再利用・キャッシュする場合
ケース:システムプロンプトが20,000トークンで、5分以内に新しい入力を1,000トークンずつ追加しながら、10回続けて質問します。出力は毎回800トークンです。
キャッシュを使わない場合、リクエストごとにプロンプト全体の通常料金がかかります。
- 1回あたり:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - 10回分:
$0.05 × 10 = $0.50
キャッシュを使う場合、最初の1回でシステムプロンプトをキャッシュに書き込み、残りの9回はキャッシュがヒットします。
- 1回目:書き込み料金
20000 × 2 ÷ 1000000 = $0.04に、新しい入力の$0.002と出力の$0.008を加えて、合計$0.05 - 2〜10回目:キャッシュヒット料金
20000 × 0.2 ÷ 1000000 = $0.004に、$0.002 + $0.008を加えて、1回あたり$0.014 - 残り9回の合計:
$0.014 × 9 = $0.126 - 総額:
$0.05 + $0.126 ≈ $0.18
10回の会話で、料金は $0.50 から約 $0.18 に下がり、約6割の節約になります。「固定の長いプロンプト+複数回の追加質問」という構成は、カスタマーサポートのチャットボット、コードアシスタント、Agentフレームワークなどでよく使われます。キャッシュの効果を最も発揮しやすいケースです。
3.3 例3:Kimi K3.1 Proで長文ドキュメントを読む場合
ケース:300,000トークンのドキュメントを読み込み、3,000トークンの要約を出力します。
- 入力:
300000 × 2 ÷ 1000000 = $0.60 - 出力:
3000 × 10 ÷ 1000000 = $0.03 - 合計:約
$0.63
5分以内に同じドキュメントについて追加で質問する場合、ドキュメント部分はキャッシュにヒットします。そのため、入力料金は 300000 × 0.2 ÷ 1000000 = $0.06 となり、あとは今回の出力料金を加えるだけです。同じ契約書や決算報告書、コードベースについて繰り返し質問する場合は、キャッシュの有効期間内に質問をまとめると、コストを大幅に抑えられます。
4. Kimi K3.1 Proの1Mコンテキスト統一料金:料金区分がないことの意味
コンテキストとは、「モデルが一度に確認できる情報の総量」のことです。プロンプトや過去の会話、アップロードしたドキュメントなどが含まれます。公式ドキュメントによると、K3シリーズはすべて1,048,576トークンのコンテキストに対応しており、K3.1 Proはコンテキストの長さによる区分のない従量課金制を採用しています。
公式FAQの説明を要約すると、K3.1 Proは1Mコンテキストに対応し、キャッシュへの書き込み、入力(キャッシュヒット・未ヒット)、出力のすべてに統一料金が適用されます。つまり、2,000トークンのリクエストでも800,000トークンのリクエストでも、100万トークンあたりの単価は同じ2ドルです。リクエストが長くなっても、料金が高い区分に切り替わることはありません。
比較するうえで、これは重要なポイントです。すべてのプロバイダーが同じ料金体系を採用しているわけではありません。OpenAIのGPT-6シリーズは、入力の長さに応じて料金が変わります。272Kトークン以下では短いコンテキスト向けの料金が適用され、272Kトークンを超えると、長いコンテキスト向けのより高い料金に切り替わります。たとえばGPT-6 Astraでは、入力料金が10ドルから20ドル、出力料金が50ドルから75ドルに上がり、キャッシュヒット時の料金も1.00ドルから2.00ドルになります。一方、Claudeは異なる方式です。公式料金ページによると、Claude 4.6以降のモデル(Claude Haiku 5.5を除く)は、1Mのコンテキスト全体で標準料金が適用されます。90万トークンのリクエストも、9,000トークンのリクエストも単価は同じです。料金が上がるのは、Claude Haiku 5.5でプロンプトが10万トークンを超えた場合のみです。つまり、K3.1 Proの「料金区分なし」は特別なものではなく、Claude Sonnet 5.5やOpus 5.5もコンテキストの長さによる追加料金はありません。料金区分が切り替わるのは、GPT-6シリーズです。
開発者にとって、統一料金には主に2つのメリットがあります。
- 予算を比例計算しやすい:トークン数が2倍になれば料金も2倍になり、特定の長さを超えたときに急に高くなることはありません。例3のような30万トークンのドキュメントも、単価をそのまま掛けて見積もれます。
- ドキュメントを無理に分割しなくてよい:料金区分があるモデルでは、高い料金を避けるために長いドキュメントを複数に分割することがあります。K3.1 Proでは、分割しても料金の節約にはならず、かえってコンテキストが失われて精度に影響する可能性があります。
5. Kimi K3.1 Proはどこでコストを抑えられ、どこでは抑えられないのか
ここでは、実際のコストを率直に見ていきます。単価は確かに下がりましたが、実際のタスクコストは出力の長さにも左右されます。
| 項目 | 詳細 | 出典 | コストへの影響 |
|---|---|---|---|
| 単価の引き下げ | 入力、出力、キャッシュヒットの3項目すべてがK3より33%安い | 公式 / 第三者 | コスト削減 |
| キャッシュヒット時の料金 | $0.20で、入力料金の1/10 | 公式 | 長いプレフィックスを再利用する場面で大幅に節約 |
| 1時間キャッシュの書き込み | $4で、入力料金の2倍 | 公式 | 呼び出し間隔が長いタスクではお得。短いタスクでは不要 |
| 常時思考 | 思考を無効にできず、平均出力は55K tokensでK3より14%多い | 公式 / 第三者 | 値下げ効果の一部を相殺 |
| 1タスクあたりのコスト | $1.98(記事公開時の数値)/ $2.11(モデルページの加重値) | 第三者 | K3とほぼ同水準 |
5.1 Kimi K3.1 Proでコストを抑えられる3つのポイント
1つ目は、単価がそのまま33%下がったことです。K3の$3/$15から$2/$10に下がり、キャッシュヒット時の料金も$0.30から$0.20になりました。この点は、公式の料金表とArtificial Analysisのデータで一致しています。
2つ目は、キャッシュヒット時の料金が入力料金の1/10で済むことです。例2で計算したように、固定の長いプロンプトを使う複数ターンの対話では、約6割のコストを削減できます。
3つ目は、1時間キャッシュの書き込み料金は2倍ですが、キャッシュをより長く保持できることです。2回の呼び出しの間隔が5分を超えるタスクに向いています。たとえば、10数分ごとに定期実行するAgentや、ユーザーが考える時間を置いてから追加質問する長文書のQ&Aなどです。1時間以内に2回以上キャッシュがヒットすれば、通常は割増分を回収できます。
5.2 Kimi K3.1 Proでコストを抑えられないところ
思考とは、モデルが回答を出す前に内部で推論することです。この推論内容も出力として課金されます。公式ドキュメントによると、K3.1 Proでは思考を無効にできず、reasoning_effortをlowに設定して思考量を減らすことしかできません。
Artificial Analysis(第三者)の測定によると、K3.1 Proは同社のIntelligence Indexの各タスクで、平均約55K tokensを出力しています。K3の48Kと比べて14%多い数値です。出力単価は最も高いため、増えた分のトークンが値下げ効果の一部を相殺します。その結果、第三者が算出した1タスクあたりのコストは約$1.98(記事公開時の数値)で、モデルページに掲載されている加重1タスクあたりのコストは$2.11(キャッシュ割引率を90%として計算)となり、K3とほぼ同水準です。
結論として、長い入力や複数ターンでの再利用が中心の業務では、K3.1 Proの値下げが請求額にはっきり表れます。一方、複雑な推論や長い出力が中心のタスクでは、1タスクあたりのコストがK3より下がるとは限りません。まずは実際のタスクを少量試し、実際の請求額を確認することをおすすめします。
6. Kimi K3.1 Proのチャージ条件とレート制限の段階
公式の料金体系は従量課金制で、サブスクリプションはありません。また、Kimi API、Kimi会員、Kimi Codeはそれぞれ独立した料金体系です。会員料金をAPI利用料に充てることはできません。利用を開始するには、アカウントに最低$1のチャージが必要です。累計チャージ額が$5に達すると、$5分のクーポンが付与されます。ただし、クーポン分は累計チャージ額に含まれません(公式情報)。
レート制限の段階は、累計チャージ額によって決まります。まず、いくつかの略語を説明します。並列数は同時に実行できるリクエスト数、RPMは1分あたりの最大リクエスト数、TPMは1分あたりに処理できる最大トークン数、TPDは1日あたりに処理できる最大トークン数です。
| 段階 | 累計チャージ額 | 並列数 | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 50万 | 150万 |
| Tier1 | $10 | 15 | 100 | 200万 | 無制限 |
| Tier2 | $20 | 40 | 100 | 300万 | 無制限 |
| Tier3 | $100 | 50 | 200 | 300万 | 無制限 |
| Tier4 | $1000 | 60 | 200 | 400万 | 無制限 |
| Tier5 | $3000 | 100 | 300 | 500万 | 無制限 |
注:公式のレート制限ドキュメント(platform.kimi.aiのpricing/limitsページ)を参照。2026-10-24取得。
Tier0の制限はかなり厳しく、1分あたりのリクエストは3件まで、1日あたりの合計処理量は150万トークンまでです。例3の30万トークンの文書で計算すると、1日に5回読み込むだけで上限に達します。また、TPMは50万なので、1分間にこのサイズの文書を2つ処理することもできません。一括処理を行う場合や、ユーザー向けにサービスを公開する場合は、テスト段階から累計チャージ額をTier1以上にしておくことをおすすめします。
もう一点、特に注意が必要です。公式によると、リスク管理によるレート制限が発動した場合、解除できません。公開前にクライアント側でリクエスト頻度の制御とリトライ時のバックオフを実装し、並列実行スクリプトで上限を探るようなことは避けてください。
7. Kimi K3.1 Proの中国国内での支払い方法と接続方法
公式チャネルでは米ドル建てで、支払い地域ごとのルールに従って決済されます。中国国内から直接支払うこともできますが、中国国内の開発者にとっては、海外向けの決済手段や領収書の発行、複数のプロバイダーのAPIキーを管理する手間が気になるところです。もう一つの方法は、API集約プラットフォームを利用することです。1つのアカウントとAPIキーで、複数のモデルを呼び出せます。
APIYI(apiyi.com)は、AI大規模言語モデルのAPI集約プラットフォームです。1つのAPIキーでOpenAI、Claude、Geminiなどの主要モデルを利用できます。APIはOpenAI形式と互換性があり、従量課金制で、新規ユーザーには無料のテスト枠があります。2026-10-24にプラットフォームのモデル一覧 docs.apiyi.com/models を確認したところ、現在利用できるKimiシリーズは次のとおりです。
kimi-k3:入力 $3 / 出力 $15 / キャッシュ読み取り $0.3kimi-k2.7-code:入力 $0.95 / 出力 $3.99 / キャッシュ読み取り $0.19kimi-k2.6:入力 $0.6 / 出力 $2.4 / キャッシュ読み取り $0.1kimi-k2.5:入力 $0.6 / 出力 $3.15 / キャッシュ読み取り $0.1
確認した時点では、kimi-k3.1-pro はAPIYIのモデル一覧に掲載されていません。そのため、この記事ではプラットフォームでの価格を記載していません。K3.1 Proのモデル名、価格、提供開始時期は、プラットフォームのコンソールにあるモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。それまでは、まず kimi-k3 で接続手順を確認できます。提供開始後は、モデル名を変更するだけで利用できます。
7.1 Kimi K3.1 Proをすぐに使い始める手順
公式チャネルでもAPI集約プラットフォームでも、基本的な接続手順はほぼ同じです。OpenAI互換形式を使う場合の例を紹介します。
- 登録してAPIキーを取得します。公式チャネルを利用する場合は、事前に少なくとも $1 をチャージしてください。
- 使用するOpenAI SDKまたはクライアントで、
base_urlをhttps://api.apiyi.com/v1に設定します(APIYIを利用する場合)。プロジェクトでAnthropic形式を使う場合は、ベースURLにhttps://api.apiyi.comを指定してください。 api_keyに取得したキーを設定し、modelにはプラットフォームのモデル一覧に記載されたモデル名を入力します。たとえば、現在利用できるkimi-k3を指定します。K3.1 Proの提供開始後は、モデル一覧に記載された名前を使用してください。- 思考による出力コストを抑えたい場合は、リクエストパラメーターに
reasoning_effortを追加し、値をlowに設定します(公式情報によると、K3.1 Proでは思考レベルを下げることはできますが、無効にはできません)。 - 固定の長いシステムプロンプトはメッセージの先頭に置き、内容を変えないようにします。これにより、繰り返し使うプレフィックスが自動的にキャッシュされます。
- 呼び出し後、請求情報またはレスポンスの使用量フィールドで、入力・キャッシュヒット・出力それぞれのトークン数を確認し、第3節の計算式で再計算します。
すぐに試すためのヒント:まずAPIYI(apiyi.com)の無料テスト枠を使い、第3節の例2を実行してみましょう。固定プレフィックスを有効にした場合としない場合の使用量を比較すると、キャッシュが有効になっているかを手早く確認できます。APIYIでのK3.1 Proのモデル名と価格は、モデル一覧をご確認ください。このモデルは近日中に提供開始予定です。
よくある質問(FAQ)
Q1:Kimi K3.1 Pro の価格はいくらですか?
公式価格は、入力が $2、出力が $10、キャッシュヒットが $0.20、5分間のキャッシュ書き込みが $2、1時間のキャッシュ書き込みが $4です。いずれも100万トークンあたりの米ドル価格で、税抜きです。2026-10-24時点の情報です。
Q2:Kimi K3.1 Pro は K3 よりどれくらい安いですか?実際の請求額も33%下がりますか?
公式価格では、3つの単価がいずれも33%低くなっています。ただし、K3.1 Pro は常に思考モードで動作するため、平均出力トークン数は14%増えます。第三者機関の Artificial Analysis が試算した1タスクあたりのコストは約 $1.98〜$2.11で、K3とほぼ同水準です。入力が長い場合や、複数回にわたって同じ内容を使う場合は、コスト削減効果がより大きくなります。
Q3:Kimi K3.1 Pro と Claude Sonnet 5.5 では、どちらが安く使えますか?
入力・出力の料金は、どちらも $2/$10です。Sonnet 5.5 はキャッシュヒットがより安く($0.10)、K3.1 Pro は5分間のキャッシュ書き込みがより安価です($2対$2.50)。また、K3.1 Pro は100万トークンのコンテキストでも料金が一律です。短いプロンプトを高頻度で再利用するなら Sonnet、大きな文書を一度に読み込むなら K3.1 Pro が向いています。実際のタスクで比較するのがおすすめです。
Q4:Kimi K3.1 Pro の1時間キャッシュは利用する価値がありますか?
1時間キャッシュの書き込み料金は $4で、5分間のキャッシュより $2高くなります。同じプロンプトを5分後から1時間以内に2回以上再利用するなら、通常は利用する価値があります。呼び出しが数分以内に集中する場合は、デフォルトの5分間キャッシュで十分です。
Q5:中国国内の開発者が API 経由で Kimi K3.1 Pro を利用するにはどうすればよいですか?
公式チャネルのほか、APIYI(apiyi.com)の OpenAI 互換インターフェースを利用できます。`base_url` には `https://api.apiyi.com/v1` を指定してください。現在、プラットフォームでは `kimi-k3` や `kimi-k2.7-code` などを提供しています。K3.1 Pro のモデル名と価格は、プラットフォームのモデル一覧をご確認ください。本モデルも近日中に提供開始する予定です。
Q6:Kimi の会員料金を API 利用料に充てられますか?
いいえ。公式の説明によると、Kimi API は従量課金制で、サブスクリプションはありません。Kimi の会員サービスや Kimi Code とは、料金体系が別になっています。
Q7:Kimi K3.1 Pro の料金で注意すべき点はありますか?
– 思考モードをオフにできないため、出力トークン数が多くなりがちです。`reasoning_effort` を `low` に設定すると、これを抑えられます。
– Tier0 の上限は3 RPM、150万 TPDです。大量に利用する場合は、事前に上位の利用枠へアップグレードしてください。
– リスク管理によるレート制限が適用されると、解除できません。
– ファイルからの情報抽出は無料ですが、抽出した内容をモデルに送る際は入力料金が発生します。
Q8:K3.1 Pro がまだ提供されていないプラットフォームでは、今のうちに何を準備できますか?
APIYI(apiyi.com)で `kimi-k3` を使い、呼び出しの流れやキャッシュの構成、利用量の集計をあらかじめ整えておけます。K3.1 Pro の提供開始後は、モデル名を差し替えるだけで利用できます。モデル名と価格は、プラットフォームのモデル一覧をご確認ください。本モデルも近日中に提供開始する予定です。
Kimi K3.1 Proの価格:押さえておきたいポイント
- 基本料金:入力 $2 / 出力 $10 / キャッシュヒット $0.20。公式価格で、税抜きです。
- 書き込み料金は5段階:5分間の書き込みは $2、1時間の書き込みは $4と、書き込みコストを低く抑えられます。
- 価格の位置づけ:Sonnet 5.5、GPT-6.1 Solと同価格で、Opus 5.5の半額です。
- 一律料金:コンテキストウィンドウが100万トークンでも、長さによる料金区分はありません。予算を線形に見積もれます。
- 実際のコスト:常時思考するため出力が14%増え、1タスクあたりのコストはK3とほぼ同じです(第三者による情報)。
- 利用開始の条件:$1からチャージできます。Tier 0は3 RPMのみで、リスク管理によるレート制限は解除できません。
- 国内からの接続:APIYIを通じて、OpenAI互換インターフェースで接続できます。K3.1 Proのモデル名と価格はプラットフォームの一覧をご確認ください。このモデルは近日中に提供開始予定です。
まとめ
Kimi K3.1 Proの価格で押さえておきたいポイントは次のとおりです。
- 料金:入力 $2 / 出力 $10 / キャッシュヒット $0.20。K3より33%安く、コンテキストウィンドウが100万トークンでも一律料金です。
- 節約のポイント:固定の長いプレフィックスを先頭に配置してキャッシュを活用すれば、複数ターンの会話で入力コストを約6割削減できます。
- コストの見込み:常時思考によって出力が長くなるため、複雑な推論タスクの1タスクあたりのコストはK3と同程度です。33%の値下がりを前提に予算を組まないようにしましょう。
- 本番導入の準備:事前にレート制限のティアを引き上げ、速度を適切に制御して、解除できないリスク管理によるレート制限を避けましょう。
まずは第3節の計算式に自社のトークン分布を当てはめ、コストを見積もってみてください。そのうえで、少数の実際のタスクを使って検証しましょう。国内から1つのAPIキーでKimi、Claude、GPTなどのモデルを比較したい場合は、APIYI(apiyi.com)の無料枠を使ってテストできます。K3.1 Proのモデル名と価格はプラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。
参考資料
- Kimiオープンプラットフォーム — モデル料金:K3.1 Proおよび各モデルの5段階の料金と課金ルール
- リンク:
platform.kimi.ai/docs/pricing/chat -
説明:本文の料金表と、コンテキストウィンドウ1Mの統一課金に関する公式情報源
-
Kimiオープンプラットフォーム — チャージとレート制限:Tier0からTier5までの各段階とリスク管理に関する説明
- リンク:
platform.kimi.ai/docs/pricing/limits -
説明:チャージ条件、RPM/TPM/TPDの制限に関する公式情報源
-
Artificial Analysis — Kimi K3.1 Pro:タスクごとのコストと出力トークン数の第三者による測定
- リンク:
artificialanalysis.ai -
説明:本文に記載した1タスクあたり$1.98/$2.11のコストと、出力トークン数55Kのデータ出典
-
APIYI モデル一覧:プラットフォームで現在提供されているモデルと料金
- リンク:
docs.apiyi.com/models - 説明:KimiやClaudeなどのモデルがプラットフォームで実際に利用できるかどうかを確認できます
著者:APIYI技術チーム
技術交流:APIYIウェブサイトのトップページからお気軽にお問い合わせください。詳しい資料はdocs.apiyi.comのドキュメントセンターをご覧ください。