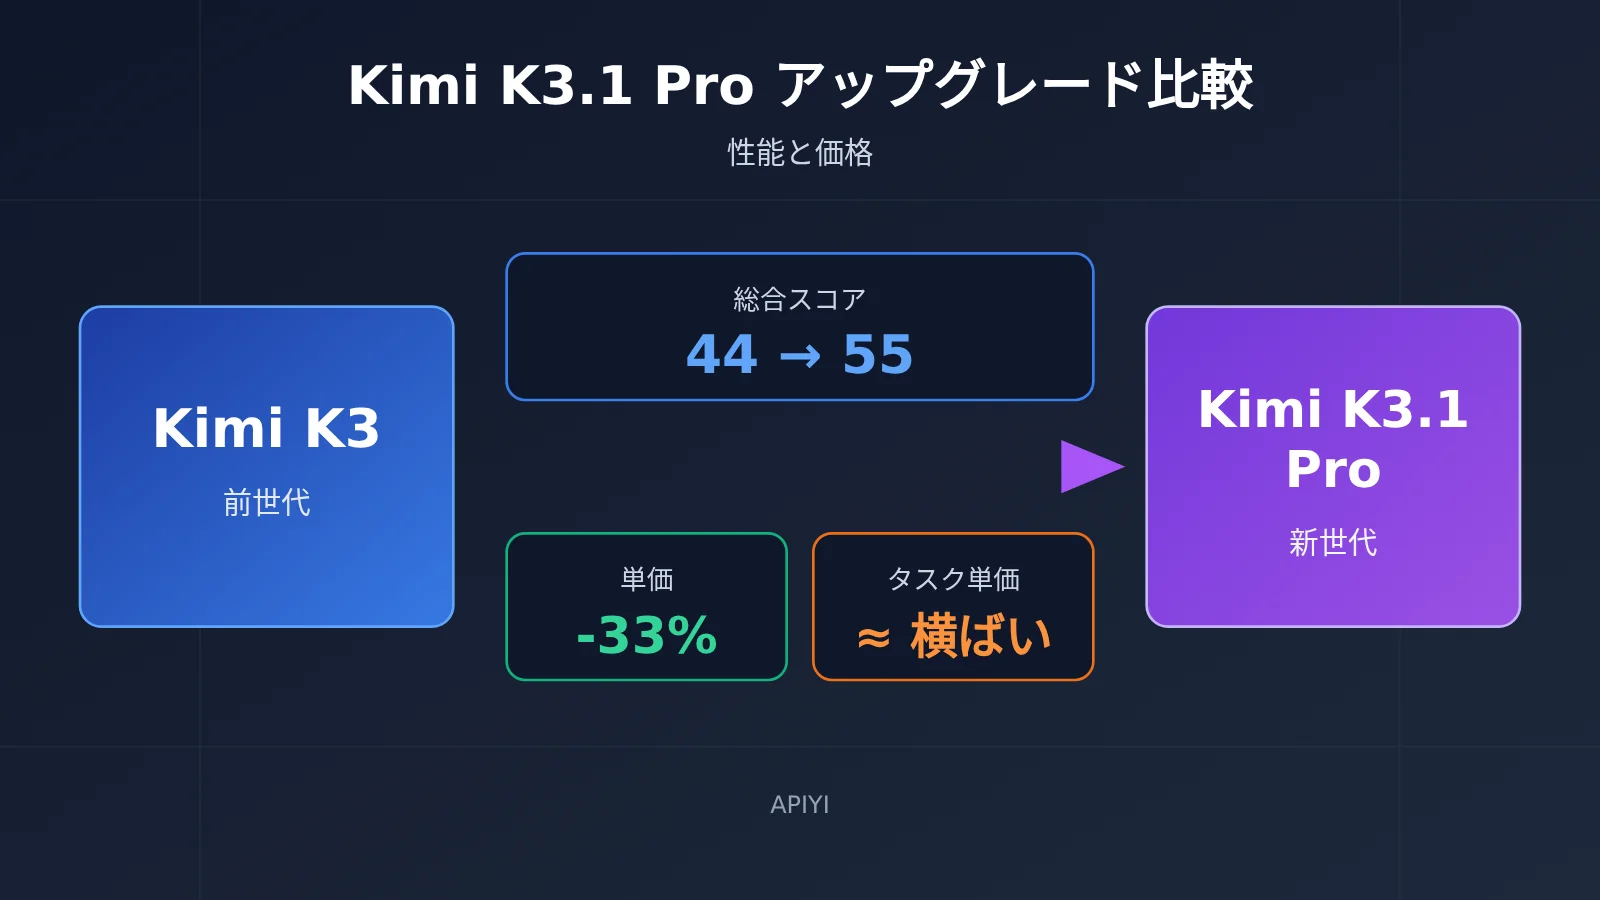
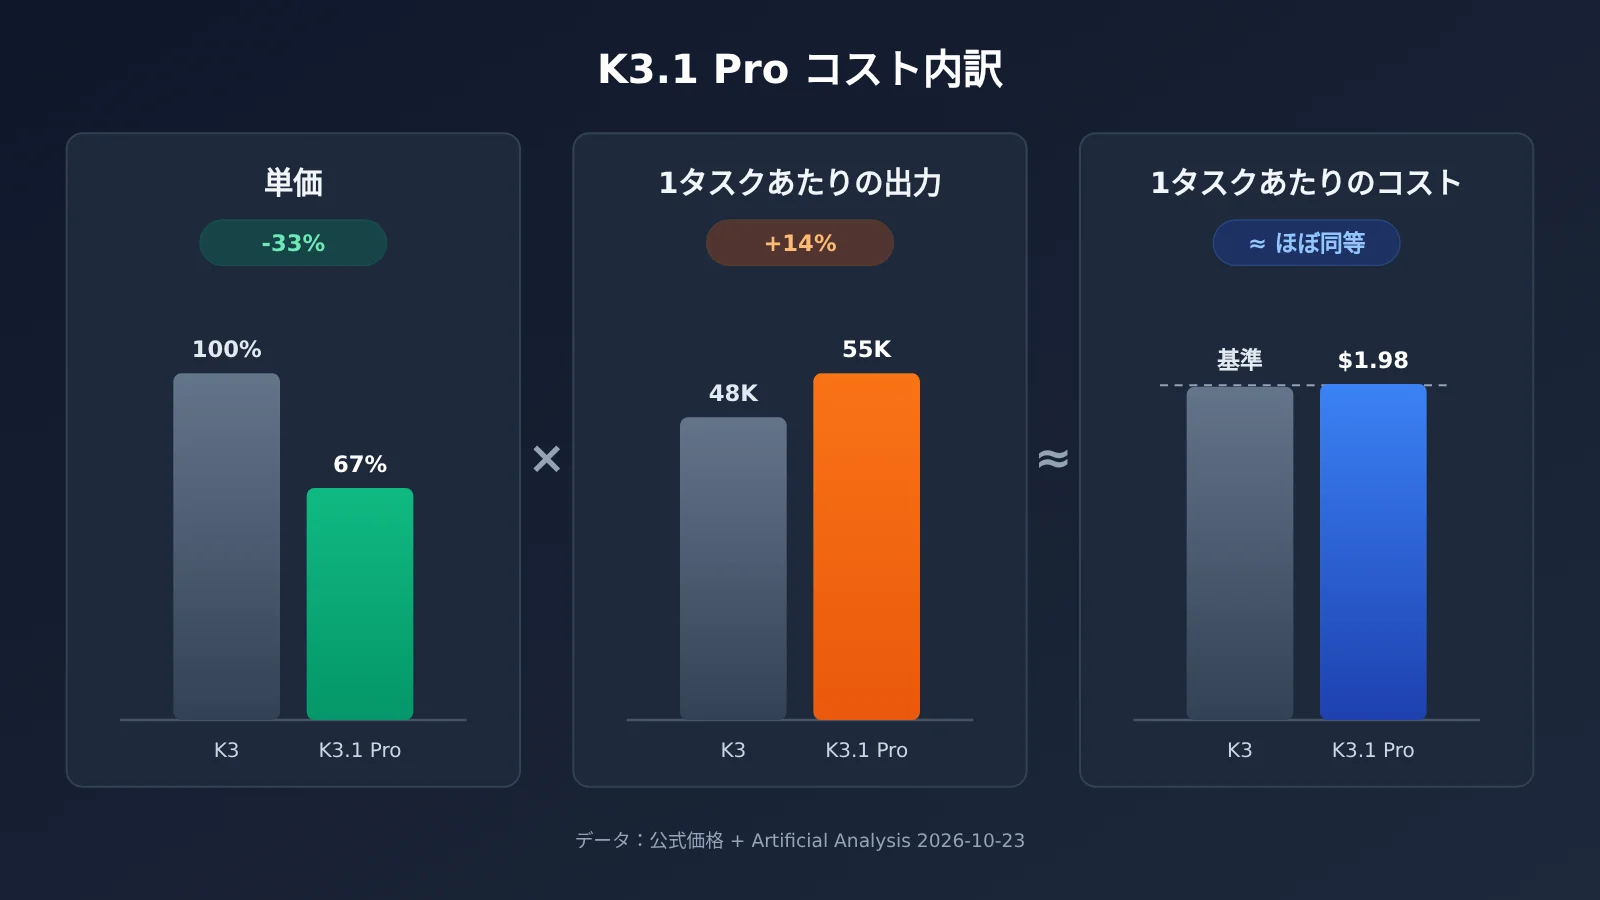
能力面では、Kimi K3.1 Pro は K3 から大きく進化しています。第三者機関 Artificial Analysis の総合スコアは 44 から 55 に上昇し、コーディング Agent のターミナルベンチマーク Terminal-Bench 4.0 では、スコアが 13% から 67% に伸びました。一方、価格は約 3 割下がり、入力・出力・キャッシュの各単価はいずれも K3 より 33%安くなっています。ただし、出力が長くなり、常に思考を行うため、タスクを1つ実行したときのコストは K3 とほぼ同じです。
以下では、根拠を示したうえで、各情報の出典を「公式発表」「第三者機関」「未確認」の3段階に分けて記載します。この記事は発表会の内容をそのまま紹介するものでも、誰にでもすぐ乗り換えるよう勧めるものでもありません。現在 K3 を利用している開発者が、自分の業務で乗り換えるべきか、いつ乗り換えるべきか、移行時に何に注意すべきかを判断するための情報をまとめています。
1. Kimi K3.1 Pro と前世代モデルの5つの主な違い
K3.1 Pro はゼロから学習した新しいモデルではなく、K3 をベースに大規模な「後学習」を施したモデルです。後学習とは、基盤モデルの学習が終わったあと、追加のデータやフィードバックを使って、モデルの振る舞いを調整することです。公式は「K3.1シリーズ初のモデル」「最強の3T級オープンウェイトモデル」と説明しています。オープンウェイトとは、モデルのパラメータファイルが公開され、ダウンロードして自分でデプロイできることを意味します。Artificial Analysis が記録した総パラメータ数は 2.8T、1回の処理で実際に計算に使われるアクティブパラメータ数は 104B です。
| 項目 | Kimi K3 | Kimi K3.1 Pro | 出典 |
|---|---|---|---|
| 学習方式 | 基本バージョン | K3 をベースに後学習。後学習に使う計算量を大幅に増加 | 公式発表 |
| 総合能力 | Intelligence Index 44 | 55、全体4位 | 第三者機関(AA、2026-10-23) |
| 単価 | 入力 $3 / 出力 $15 | 入力 $2 / 出力 $10、33%値下げ | 公式価格 |
| タスクあたりの出力量 | 平均 48K tokens | 平均 55K tokens、14%増 | 第三者機関(AA) |
| コンテキスト / モダリティ | 1M / テキスト+画像 | 1M / テキスト+画像、変更なし | 公式発表 |
表にある tokens は、モデルの料金計算や使用量の計測に使われる基本単位です。おおまかには「単語や文字の断片」と考えるとよく、漢字1文字は通常1〜2 tokens に相当します。この表を見るときは、まず2つの変化に注目してください。能力スコアは上がり、単価は下がっています。3列目の「タスクあたりの出力量」は、値下げによって実際にどれだけ節約できるかを左右します。詳しくは第4節で説明します。
重みについて、公式は2026-11-04までに完全な重みを公開すると約束しています。現在(2026-10-24)の時点では、これはまだ実現していない約束であり、「未確認」の扱いです。Artificial Analysis は、重みの公開後、K3.1 Pro が同機関のランキングで最高スコアを獲得したオープンウェイトモデルになると予測しています。また、オープンウェイトモデルとクローズドモデルの最高スコアの差は、12ポイントから3ポイントに縮まるとしています。
2. Kimi K3.1 Proのベンチマーク比較:公式発表と第三者評価の2つの基準
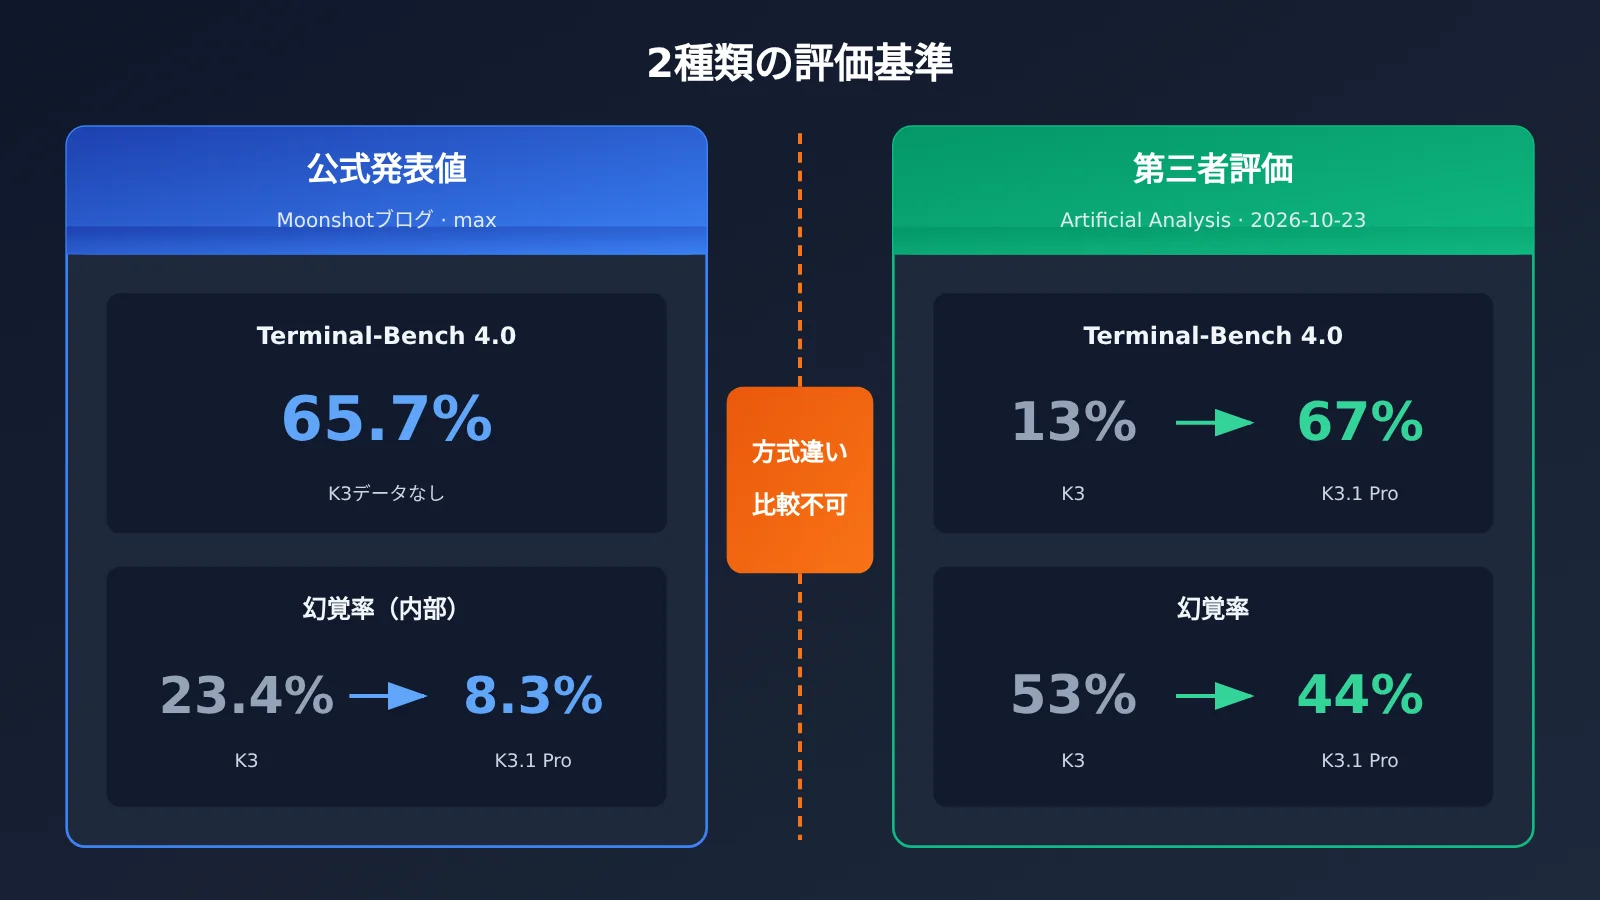
まず、以下の2つの表は、異なる機関が異なるテスト環境で実施した結果です。同じ基準で比較することはできません。特にわかりやすい例がTerminal-Bench 4.0です。公式発表は65.7%、Artificial Analysisの独立測定は67%ですが、これは別々のテストで得られた2つのスコアであり、同じスコアの誤差ではありません。公式はK3のTerminal-Bench 4.0の結果を発表しておらず、K3の13%はArtificial Analysisによる測定結果のみです。
2.1 Kimi K3.1 Proの公式ベンチマーク結果
出典:Moonshot公式ブログ。テスト条件:特に記載がない場合、すべて reasoning_effort=max(推論強度を最大に設定)、temperature=1.0、top_p=0.95。備考に「内部」とあるものは、Moonshotが独自に作成したテストセットを使用しており、外部からは再現できません。
| 項目 | K3.1 Pro | 比較対象 | 備考 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra 58.2%、Claude Opus 5.5 66.4% | Opus 5.5はClaude Code harnessで実行 |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | K3 55.95% | 内部テスト。長い手順を要するプログラミングタスク |
| BenchCAD | 92.7%(ツール使用あり) | Opus 5.5 96.2%、GPT-6 Astra 95.9% | 複数視点の図面をCADコードに変換 |
| OfficeQA Pro v2 | 64.4 | K3を上回る | 実際の財務報告書を分析。公式発表ではSOTA |
| Financial Modeling / Research | K3より7.2 / 11.6ポイント高い | K3 | 内部テスト |
| Business Operation | K3の約4.2倍 | K3 | 内部シミュレーションによる経営テスト |
| Kimi Hallu Bench Hard | claim単位の幻覚率 8.3% | K3 23.4% | 内部の事実性ストレステスト |
| xdev-bench-hard(pass@3) | 81.0% | 安全対策を施していない比較用バージョン 90.5% | 脆弱性の発見 |
用語をいくつか説明します。harnessとは、テスト時にモデルを囲む「実行フレームワーク」のことです。ツールの呼び出しやコマンドの実行を担うため、フレームワークが変わればスコアも変わります。そのため、Opus 5.5の項目は個別に見る必要があります。pass@3は、同じ問題に3回挑戦し、1回でも正解すれば合格とする指標です。最後の行は、安全性を確保するため、公式がモデルの脆弱性発見能力を意図的に抑えていることを示しています。正式版のスコアは、制限をかけていない内部バージョンより約9.5ポイント低くなっています。
2.2 Kimi K3.1 Proの第三者ベンチマーク(Artificial Analysis)
出典:Artificial Analysis、データ日付:2026-10-23。テストは同機関が統一した手順で実施しており、K3とK3.1 Proには同じ方法が使われています。
| 指標 | K3.1 Pro | K3 | 変化 |
|---|---|---|---|
| Intelligence Index | 55(4位) | 44 | +11 |
| GDPval-AA(実際の業務タスクのElo) | 1846(3位) | 1534 | +312 |
| Terminal-Bench 4.0 | 67% | 13% | +54ポイント |
| AutomationBench-AA(SaaSワークフロー) | 73% | 58% | +15 |
| Humanity’s Last Exam | 52% | 47% | +5 |
| CritPt / SciCode | 25% / 61% | 23% / 59% | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| 幻覚率 / 正確性 | 44% / 51% | 53% / 48% | 幻覚率 -9 |
| タスクあたりの平均出力トークン数 | 55K | 48K | +14% |
Artificial Analysisのランキングでは、K3.1 Proは4位です。上位にはClaude Opus 5.5(58)、Claude Sonnet 5.5(56)、Muse Wonder Full(56)が並んでいます。Terminal-Bench 4.0の67%は、同機関がテストした全モデルの中で最高スコアです。Sonnet 5.5は64%でした。
幻覚率については、2つの測定方法で改善の方向性は一致していますが、具体的な数値には大きな差があります。公式の内部ストレステストでは23.4%から8.3%に低下し、AAでは53%から44%に低下しました。両者で使われている問題は異なり、テストの難易度や集計方法も異なります。外部向けに引用する際は出典を明記し、「幻覚率が8%に低下」のようにひとまとめにしないでください。
3. Kimi K3.1 Proで大きく向上した5つの分野
ここでは、2つのデータセットがともに改善を示している分野、または改善幅が十分に大きい分野だけを取り上げます。
- コーディングAgentとターミナルタスク。Agentとは、自分でタスクを分解し、ツールを呼び出しながら複数のステップを実行できるAIアシスタントです。AAの測定では、Terminal-Bench 4.0が13%から67%に向上し、公式の社内長期コーディングテストも55.95%から61.2%に上がりました。K3でコードAgentを動かす際、コマンド実行やファイル操作、複数ステップにわたるトラブルシューティングでつまずくことが多いなら、最も大きな改善を実感できる分野です。
- 実際の業務タスク。GDPval-AAは、Eloレーティングでモデルが実際の職業タスクをこなす能力を評価します。Eloは対戦成績をもとにしたランキング指標で、チェスのランキングにも使われています。スコアの差が大きいほど、勝率の差も大きくなります。K3.1 ProはK3を312ポイント上回り、3位にランクインしました。企画書の作成、表計算、資料の整理といった日常業務で、明確な向上が見られることを示しています。
- SaaSワークフローの自動化。AutomationBench-AAは、メールの確認、チケットの更新、表計算シートの同期など、さまざまなオンラインソフトウェアをまたいだ自動化の実行能力を測定します。スコアは58%から73%に向上しました。公式の社内シミュレーション経営テスト(Business Operation)ではK3の約4.2倍の成績を記録しており、長いワークフローを実行する能力の向上を示しています。ただし、こちらは社内データのため、参考値として扱ってください。
- 事実の正確性とハルシネーション。ハルシネーションとは、モデルがもっともらしく、実在しない事実を作り出すことです。公式の社内テストでは、主張単位のハルシネーション率(個々の事実の記述を基準に集計)が23.4%から8.3%に低下しました。また、少なくとも1つの事実誤認を含む回答数は、K3の42.4%にまで減少しています。AAの測定でも、ハルシネーション率は53%から44%に下がり、正確性は48%から51%に上昇しました。
- 金融モデリングと調査レポート。公式発表によると、OfficeQA Pro v2で64.4点を獲得し、SOTA(現時点での最高成績)を記録しました。社内テストのFinancial ModelingとFinancial Researchも、K3をそれぞれ7.2ポイント、11.6ポイント上回っています。これらの項目は第三者による独立した再検証がまだ行われていないため、「公式発表の数値」として扱います。
科学的推論に関する指標(Humanity’s Last Exam、CritPt、SciCode)も向上していますが、上昇幅は2〜5ポイントにとどまります。学術的な質疑応答や研究用コードが主な用途であれば、K3.1 Proの改善はAgent系タスクほど大きくありません。こうしたユーザーは、これらの結果だけを理由に急いで移行する必要はありません。
4. Kimi K3.1 Proで変わらなかった点と、実際のコスト
4.1 Kimi K3.1 Proで変わらなかった3つのこと
- コンテキストウィンドウは引き続き1M:1,048,576 tokensで、K3と同じです。コンテキストとは、モデルが一度に「読み取れる」内容の総量と考えると分かりやすいでしょう。
- 対応モダリティは引き続きテキスト+画像:音声や動画などの入力方式は追加されていません。
- 公式の速度ベンチマークは未公開:AAの測定では出力速度は80.7 tokens/秒で、同機関の4段階の速度評価では第2段階です。公式はhighspeed版について2〜3倍高速としていますが、再現可能なテスト条件は公開していないため、現時点では「未検証」としています。
4.2 Kimi K3.1 Proの5段階の料金比較
以下は公式料金です。2026-10-24時点の取得データ、米ドル/100万tokens、税抜。
| モデル | 入力 | 出力 | キャッシュヒット | 5分間の書き込み | 1時間の書き込み |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
キャッシュヒットとは、同じ内容のプレフィックス(固定のシステムプロンプトや同じ長文書など)を繰り返し送信した場合、2回目以降が割安な料金で計算される仕組みです。5分間・1時間の書き込み料金は、内容をキャッシュに保存するときにかかる費用で、保存期間が長いほど高くなります。Agentや長文書への質疑応答ではキャッシュが大きな効果を発揮します。プロンプトの構成が安定していれば、請求額のうち入力分をかなり抑えられます。
4.3 Kimi K3.1 Proのコスト面の注意点:値下げされても、節約になるとは限らない
K3.1 Proは常に思考を行います。つまり、回答の前に内部推論を行い、その分も出力tokensとして課金されます。AAの測定では、1タスクあたりの平均出力は55K tokensで、K3の48Kから14%増加しています。
単価だけを見ると33%の値下げなので、大きく節約できるはずです。しかし、AAが実測した1タスクあたりのコストは約$1.98(モデル詳細ページでは$2.11)で、K3とほぼ同じでした。同機関はコストの内訳を公開していないため、「なぜ節約できなかったのか」について公式な説明はありません。考えられる理由の一つは、Agentタスクで複数回モデルを呼び出す際に、入力tokensも増えていることです。ただし、これはあくまで推測であり、「未検証」です。
また、highspeed版の料金は標準版の2倍です。コストを重視するチームは、切り替える前に実際のタスクをいくつか使って試し、総費用を確認することをおすすめします。単価だけで比較しないようにしましょう。
同じコードでK3とK3.1 Proの実際の費用を比較したい場合は、まずAPIYI(apiyi.com)のOpenAI互換インターフェースに接続し、kimi-k3で基準となるデータを取得できます。K3.1 Proのプラットフォーム上のモデル名と料金は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。
5. Kimi K3.1 Proがおすすめの用途:切り替えるべき場面、急がなくてよい場面
タスクの種類ごとに、現在K3を利用している方向けの結論をまとめました。
| タスクの種類 | 結論 | 理由 |
|---|---|---|
| コーディングエージェント、ターミナルの自動化 | 早めの切り替えがおすすめ | Terminal-Bench 4.0の第三者評価は13%から67%に向上。長い工程を伴うコーディングでも、公式評価で5ポイント以上向上 |
| ドキュメント分析、調査レポート、金融モデリング | 切り替えがおすすめ | GDPval Eloが312ポイント向上。財務諸表や調査レポート関連の公式テストでK3を全面的に上回り、ハルシネーションも大幅に減少 |
| SaaSワークフロー、複数ステップの業務プロセス | 切り替えがおすすめ | AutomationBench-AAが58%から73%に向上 |
| 大量の小規模タスク(分類、抽出、書き換え) | 急ぐ必要はありません | 1タスクあたりのコストはK3と同程度。常時思考によって出力が増える一方、簡単なタスクでは性能向上のメリットが限られます |
| 遅延に敏感な用途(リアルタイム会話、オンラインカスタマーサポート) | まずはテストして判断 | 公式の速度データはありません。常時思考によって初回応答までの時間が延びる可能性があり、highspeedの料金は2倍です |
「急ぐ必要はない」というのは、K3の性能が低いという意味ではありません。K3は簡単なタスクなら十分に使えますし、遅延やコストも見積もりやすいため、総合スコアが高いモデルに切り替えるだけの理由で、バッチ処理のパイプライン全体を書き換える必要はありません。K3.1 Proの重みが公開され、第三者による速度データがさらにそろってから評価しても間に合います。
5.1 Kimi K3.1 Proが向いている典型的な用途
- コードリポジトリ全体に関わるバグ修正、リファクタリング、テスト作成。モデル自身がコマンドを実行し、エラーを確認して修正する必要がある場合。
- 長文の財務諸表、契約書、調査レポートに関する質問応答や要約。事実の正確性が重要な場合。
- 複数のオンラインツールをまたぐ自動化フロー。1つのタスクで10ステップ以上を実行する場合。
5.2 Kimi K3をしばらく使い続けてもよい典型的な用途
- 毎日数十万件にのぼるラベル分類や項目抽出など、件数ベースでコストを管理する場合。
- 安定した低遅延が必要なリアルタイムのやり取りで、タイムアウトやリトライの設定をすでにK3向けに調整している場合。
選定方法として最も確実なのは、自社の業務で使う実データを50〜100件用意し、2つのモデルでそれぞれ実行して、完了率と総コストを比較することです。APIYI(apiyi.com)なら、1つのAPIキーでモデルを切り替えられるため、このような比較テストに便利です。K3.1 Proの提供開始前は、まず
kimi-k3でベースラインを測定できます。K3.1 Proのモデル名と料金は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。
6. Kimi K3.1 Proへの移行判断と注意点
6.1 Kimi K2シリーズの提供終了スケジュール
K2シリーズをまだ利用している場合は、まず移行を優先しましょう。公式ドキュメントによると、2026年10月31日以降、K2シリーズは新規登録ユーザーが利用できなくなり、2026年末までにすべて提供終了となります。既存ユーザーは当面利用を続けられますが、終了直前まで待たず、今後2か月以内を目安にK3またはK3.1 Proへ移行することをおすすめします。
6.2 Kimi K3.1 Proへのモデル切り替えで押さえておきたい3つのポイント
- 新しい会話を開始し、途中でモデルを切り替えない。公式は、新しい会話でK3.1 Proを使うことを推奨しています。既存のK3の会話履歴をK3.1 Proに引き継いで続行すると、コンテキスト形式や思考内容に互換性の問題が生じる可能性があります。
- ネイティブAPIを優先する。公式によると、Responses、Chat Completions、Messagesの3種類のネイティブAPIが最も安定しています。
- モデル名を正確に指定する。サードパーティーツールで
kimi-k3.1-proを指定する際に入力を間違えると、リクエストはK2.8 Previewにフォールバックし、思考も行われません。この問題はエラーにならず、結果の品質が低下するだけなので、原因の特定に時間がかかることがあります。本番環境への導入前に、レスポンス内のモデルフィールドを確認しましょう。
6.3 Kimi Codeの会員プランによる違い
Kimi Codeで新しいモデルを使うには、会員プランに条件があります。
k3.1-proの利用にはPlus以上の会員資格が必要です。- 1Mコンテキストの利用にはPro以上の会員資格が必要です。
- highspeed版の利用にはPro以上の会員資格が必要で、クォータを約2倍消費します。
Plus会員でもK3.1 Proを利用できますが、1Mのコンテキストウィンドウは利用できません。コードリポジトリ全体を読むために超長文コンテキストを主に利用する場合は、プランを確認してからアップグレードを検討しましょう。
6.4 API経由で接続する際のチェックリスト
base_urlにhttps://api.apiyi.com/v1を設定します。これはAPIYI(apiyi.com)のOpenAI互換エンドポイントです。既存のOpenAI SDKコードは、この項目とAPIキーを変更するだけで利用できます。modelはまずkimi-k3で一連の処理を確認し、その後、プラットフォームのモデル一覧に記載されたK3.1 Proの正確なモデル名を設定します。K3.1 Proのモデル名と料金はプラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。- 常に思考を行うため、1回のレスポンスに時間がかかることがあります。タイムアウト時間は余裕を持って設定しましょう。
max_tokensを小さく設定しすぎると、思考内容によって本文の出力が押し出される可能性があります。
よくある質問(FAQ)
Q1: Kimi K3.1 Pro とは何ですか?K3 とはどのような関係ですか?
K3.1 Pro は、Moonshot が K3 をベースに事後学習の計算量を増やして開発した新バージョンです。公式には、K3.1 シリーズ初のモデルとされています。コンテキストと入力モダリティは K3 と同じで、主な改善点はプログラミングエージェント、実際の業務タスク、事実の正確性です。
Q2: Kimi K3.1 Pro の Terminal-Bench のスコアは、65.7% と 67% のどちらですか?
どちらも正しい数値ですが、出典が異なります。65.7% は公式の自己報告値で、67% は Artificial Analysis による独立測定値です。テスト環境とハーネスが異なるため、同じスコアとして扱うことはできません。引用する際は出典を明記してください。
Q3: Kimi K3.1 Pro は単価が33%下がったのに、なぜコストが安くならないのですか?
K3.1 Pro は常に思考を行うため、タスクあたりの平均出力は K3 より14%多くなります。AA の実測では、1タスクあたりのコストは約 $1.98(モデルページの記載では $2.11)で、K3 とほぼ同じです。具体的な理由は同機関から詳しく説明されていないため、実際のタスクで検証することをおすすめします。
Q4: Kimi K3.1 Pro の重みはいつ公開されますか?
公式は、2026-11-04 までに完全な重みを公開すると約束しています。2026-10-24 時点ではまだ約束の段階で、公開は実現していません。自社環境への導入を計画する場合は、公式の実際の公開状況をご確認ください。
Q5: API 経由で Kimi K3.1 Pro と K3 を手早く比較するにはどうすればよいですか?
APIYI apiyi.com に登録すると、APIキーと無料のテスト枠を取得できます。まずは OpenAI 互換インターフェースで `kimi-k3` を実行し、ベースラインとして比較してください。K3.1 Pro のモデル名と料金は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供を開始する予定です。公開後は `model` パラメーターを変更するだけで比較できます。
Q6: Kimi K3.1 Pro にはどのような既知の制限がありますか?
– 公式の速度ベンチマークは公開されていません。highspeed 版は料金が2倍です。
– 常に思考を行うため、極めて低いレイテンシが求められる用途には向きません。
– 優れた結果の一部は内部テストセットによるもので、外部では再現できません。
– 脆弱性の発見能力には安全上の制限が設けられており、未調整版より低くなっています。
Q7: まだ K2 を使っていますが、K3.1 Pro に直接移行すべきですか?
K2 シリーズは2026-10-31から新規ユーザーへの提供が停止され、年内に終了するため、移行が必要です。プログラミングエージェントや文書関連の業務なら K3.1 Pro に直接移行できます。小規模なタスクを大量に処理する場合は、K3 のほうが手軽です。APIYI apiyi.com では、まず `kimi-k3` を使って移行を進められます。K3.1 Pro のモデル名と料金は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供を開始する予定です。
Kimi K3.1 Pro の重要ポイント
- 性能が大幅に向上:AA総合スコアは44から55に上昇し、ランキングは4位。上位はクローズドモデル3製品のみです。
- プログラミングAgentの伸びが最大:Terminal-Bench 4.0の第三者検証では、スコアが13%から67%に上昇しました。
- 2種類のデータは分けて見る:公式発表とAAでは評価基準が異なるため、引用時は出典を明記してください。
- 値下げ=コスト削減ではない:単価は33%下がりましたが、1タスクあたりのコストはK3とほぼ同じです。
- 基本仕様に変更なし:コンテキストウィンドウは100万トークン、対応入力はテキストと画像です。公式の速度データはありません。
- 移行時はモデル名を正確に指定:名前を間違えると、K2.8 Previewにフォールバックし、思考モードも無効になります。
- 利用方法:まずはAPIYI apiyi.comでK3のベースラインを確認できます。K3.1 Proのモデル名と価格は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。
まとめ:Kimi K3.1 ProはK3から移行する価値があるか
Kimi K3.1 Proの前世代からの主な変更点は、次の3つです。
- 性能:プログラミングAgent、ターミナルタスク、実務タスク、SaaS自動化、事実性のいずれも大きく向上しました。第三者評価と公式データは、いずれも同じ傾向を示しています。
- 価格:5つの価格帯すべてで単価がK3より33%下がりました。ただし、常時思考によって出力が長くなるため、1タスクあたりのコストはほぼ変わりません。
- 移行:プログラミングAgentや文書・調査レポート関連の業務には、早めの切り替えがおすすめです。小規模なタスクを大量に処理する場合や遅延に敏感な用途では、まずテストしてから判断するとよいでしょう。K2を利用している場合は、年末までに移行を完了してください。
APIYI apiyi.comでは、現在 kimi-k3(入力 $3 / 出力 $15)などのKimiモデルを提供しています。同じAPIキーとOpenAI互換インターフェースを使って、コストと性能のベースラインを確認できます。Kimi K3.1 Proのモデル名と価格はプラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。提供開始後は、モデル名を切り替えるだけで比較できます。
参考資料
- Moonshot公式ブログ:Kimi K3.1 Proのリリースノートと公式自己申告ベンチマークスコア
- 説明:本文の「公式自己申告」データの出典です。テスト条件は
reasoning_effort=max、temperature=1.0、top_p=0.95です。 - Moonshot公式ドキュメント:料金、K2の提供終了スケジュール、モデル切り替えに関する推奨事項、Kimi Codeのメンバーシップに関する説明
- 説明:料金は2026-10-24時点の取得データで、米ドル/100万トークン、税抜きです。
- Artificial Analysis:独立した第三者によるモデル評価
- リンク:
artificialanalysis.ai - 説明:本文の「第三者」データの出典です。データの日付は2026-10-23です。
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI公式サイトのトップページからお気軽にお問い合わせください。接続に関する資料は、docs.apiyi.comのドキュメントセンターでもご覧いただけます。Kimi K3.1 Proのモデル名と料金は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始予定です。