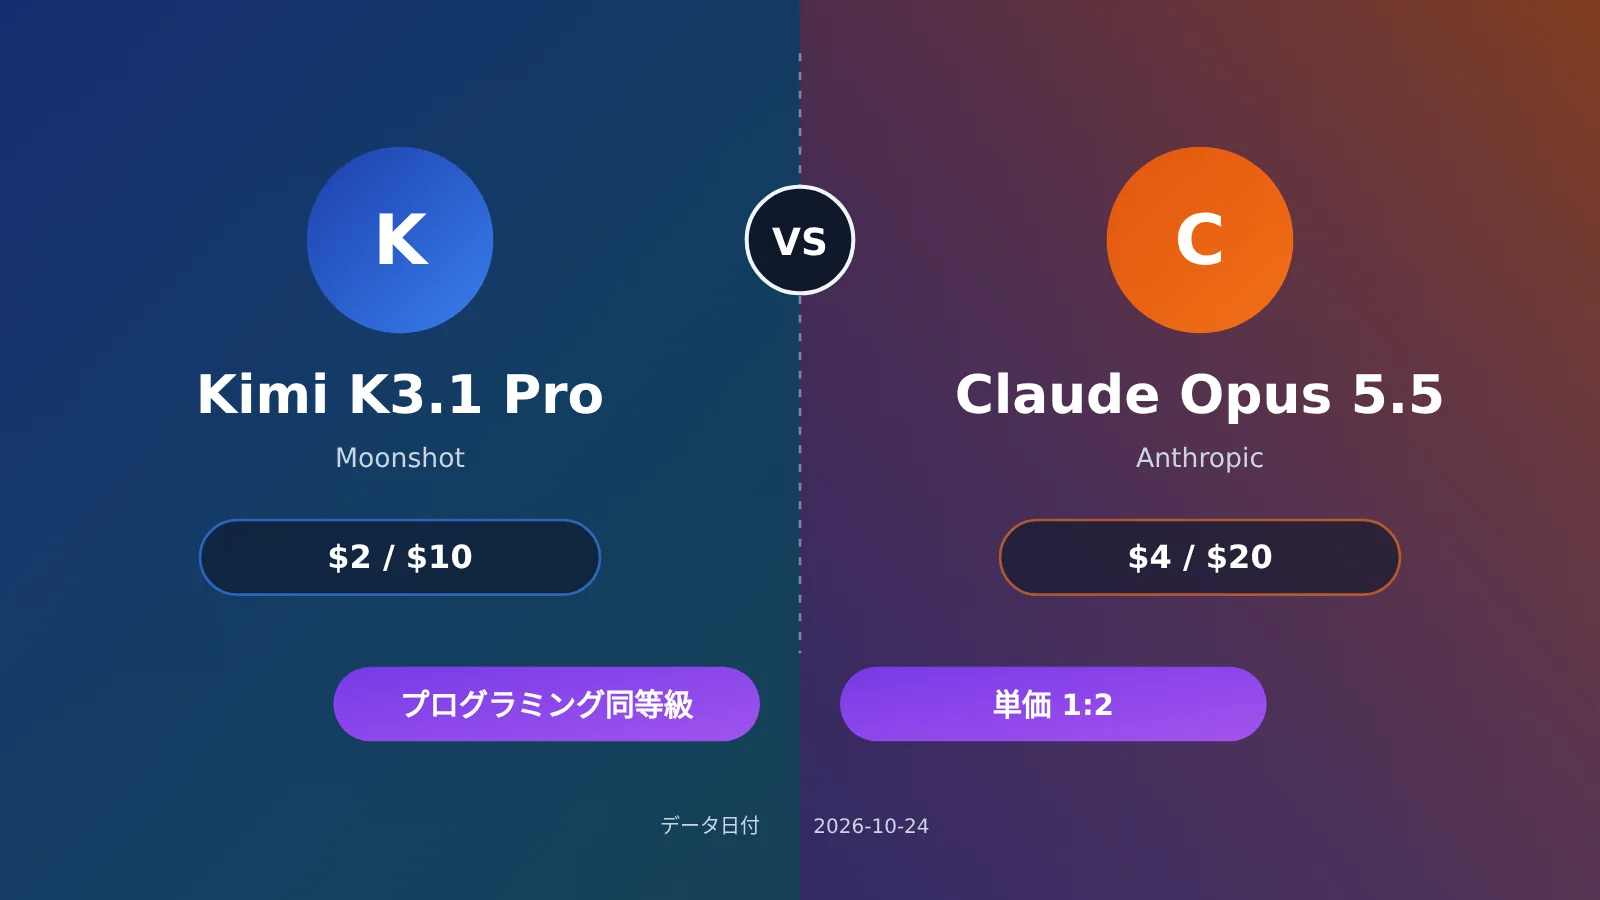
まず結論から言うと、Kimi K3.1 ProとClaude Opus 5.5のコーディング能力は同じくらいの水準です。Moonshotが公式に公表したTerminal-Bench 4.0のスコアは、K3.1 Proが65.7%、Opus 5.5が66.4%で、K3.1 Proは約0.7ポイント下回っています。一方、第三者機関のArtificial Analysisが測定したTerminal-Bench 4.0のスコアでは、K3.1 Proがトップでした。価格を見ると、K3.1 Proの入力・出力単価はOpus 5.5のちょうど半額($2/$10に対して$4/$20)で、キャッシュヒット時の単価は両者同じです。ただし、K3.1 Proは思考過程が長いため、第三者の試算によると、実際のタスクあたりのコストは半額にはなりません。
以下のデータにはすべて出典を明記し、次の3段階に分けています。公式発表(Moonshotのブログ、KimiおよびAnthropicの公式ドキュメント)、第三者データ(Artificial Analysis、以下AA)、未確認(現時点で公開データがなく、方向性の目安のみ示せるもの)。本文でいうトークンは、モデルの料金計算に使われる「文字数の単位」と考えてください。漢字1文字はおよそ1トークン強に相当し、価格はすべて「100万トークンあたりの米ドル」で表示しています。
この記事では「どちらが圧勝か」といった論調は取りません。 2つのモデルにはそれぞれ長所と短所があります。ここでは条件をそろえてデータを比較し、用途別に選び方を提案します。
この記事でわかること:自分のタスクに Kimi K3.1 Pro と Claude Opus 5.5 のどちらが適しているか、そして両者の実際のコスト差がどれほどあるかを判断できます。
1. Kimi K3.1 ProとClaude Opus 5.5の主な違い
まず、最も重要な違いを表にまとめました。各項目の詳細は、後のセクションで順に解説します。「情報源」欄には各数値の出典を記載しているので、必要に応じてご確認ください。
| 比較項目 | Kimi K3.1 Pro | Claude Opus 5.5 | 情報源 |
|---|---|---|---|
| Terminal-Bench 4.0(公式発表値) | 65.7% | 66.4% | 公式発表(Moonshotのブログ) |
| Terminal-Bench 4.0(AAの評価) | 67%、AAの評価対象モデル中で最高 | 参考資料に記載なし | 第三者評価(AA) |
| 入力/出力の料金 | $2 / $10 | $4 / $20 | 公式料金 |
| キャッシュヒット時の料金 | $0.20 | $0.20 | 公式料金 |
| コンテキスト長 | 1,048,576トークン | 最大100万トークン(モデルによって異なる) | 公式ドキュメント |
| 思考機能をオフにできるか | できない。強度の調整のみ可能 | Anthropicのドキュメントを参照 | 公式ドキュメント/未確認 |
| オープンウェイト | 2026年11月4日までに公開すると表明 | 非公開 | 公式発表 |
「コンテキスト」とは、モデルが一度に読み込める情報量のことです。どちらのモデルも100万トークン規模に対応しており、中規模のコードリポジトリならほぼ丸ごと一度に読み込めます。そのため、この点が選択を左右する大きな違いになることはありません。
2. Kimi K3.1 Pro vs Claude Opus 5.5の価格比較:5項目の単価を一覧で比較
まず、料金に関する2つの用語を説明します。キャッシュヒットとは、同じ冒頭部分(システムプロンプトやコードリポジトリの概要など)を繰り返し送信する場合に、モデル提供元がその内容を保存し、次回以降の読み込みを低価格で請求する仕組みです。キャッシュ書き込みとは、その内容を初めてキャッシュに保存するときにかかる料金です。5分間の保存と1時間の保存では、料金が異なります。
| モデル | 入力 | 出力 | キャッシュヒット | キャッシュ書き込み(5分) | キャッシュ書き込み(1時間) |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5(参考) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
価格について:2026-10-24に取得。単位は100万トークンあたりの米ドルで、税抜きです。KimiおよびAnthropicの公式価格情報を参照しています。
2.1 価格差はどのくらい?入力・出力は2倍、キャッシュヒットは同額
入力と出力の単価は、Opus 5.5がK3.1 Proのちょうど2倍です。キャッシュヒットの料金はどちらも$0.20で、差はありません。キャッシュ書き込みはKimiのほうが安く、5分間の保存では$2対$5、1時間の保存では$4対$8です。
比較対象としてClaude Sonnet 5.5も加えると、入力と出力の単価はK3.1 Proとまったく同じで、キャッシュヒットの料金は半額($0.10)です。そのため、「手頃な価格のフラッグシップモデル」を探しているなら、Kimiと直接比較すべき相手はOpus 5.5だけでなく、Sonnet 5.5でもあります。
2.2 どちらのモデルにも高速版がある
両社とも、より高速で価格も高いバージョンを提供しています。モデルを選ぶ際は、比較するバージョンを間違えないようにしましょう。
kimi-k3.1-pro-highspeed:$4 / $20、キャッシュヒット$0.20、5分間のキャッシュ書き込み$4、1時間のキャッシュ書き込み$8(公式価格)- Claude Opus 5.5 Fastモード:$8 / $40。200kを超える部分を含む、コンテキストウィンドウ全体が対象(公式価格)
Kimiの高速版は、入力・出力の単価が通常版のOpus 5.5と同じです。一方、5分間のキャッシュ書き込みは、引き続きKimiのほうが安くなっています。
3. Kimi K3.1 ProとClaude Opus 5.5のコーディングベンチマーク:2つの評価基準を分けて見る
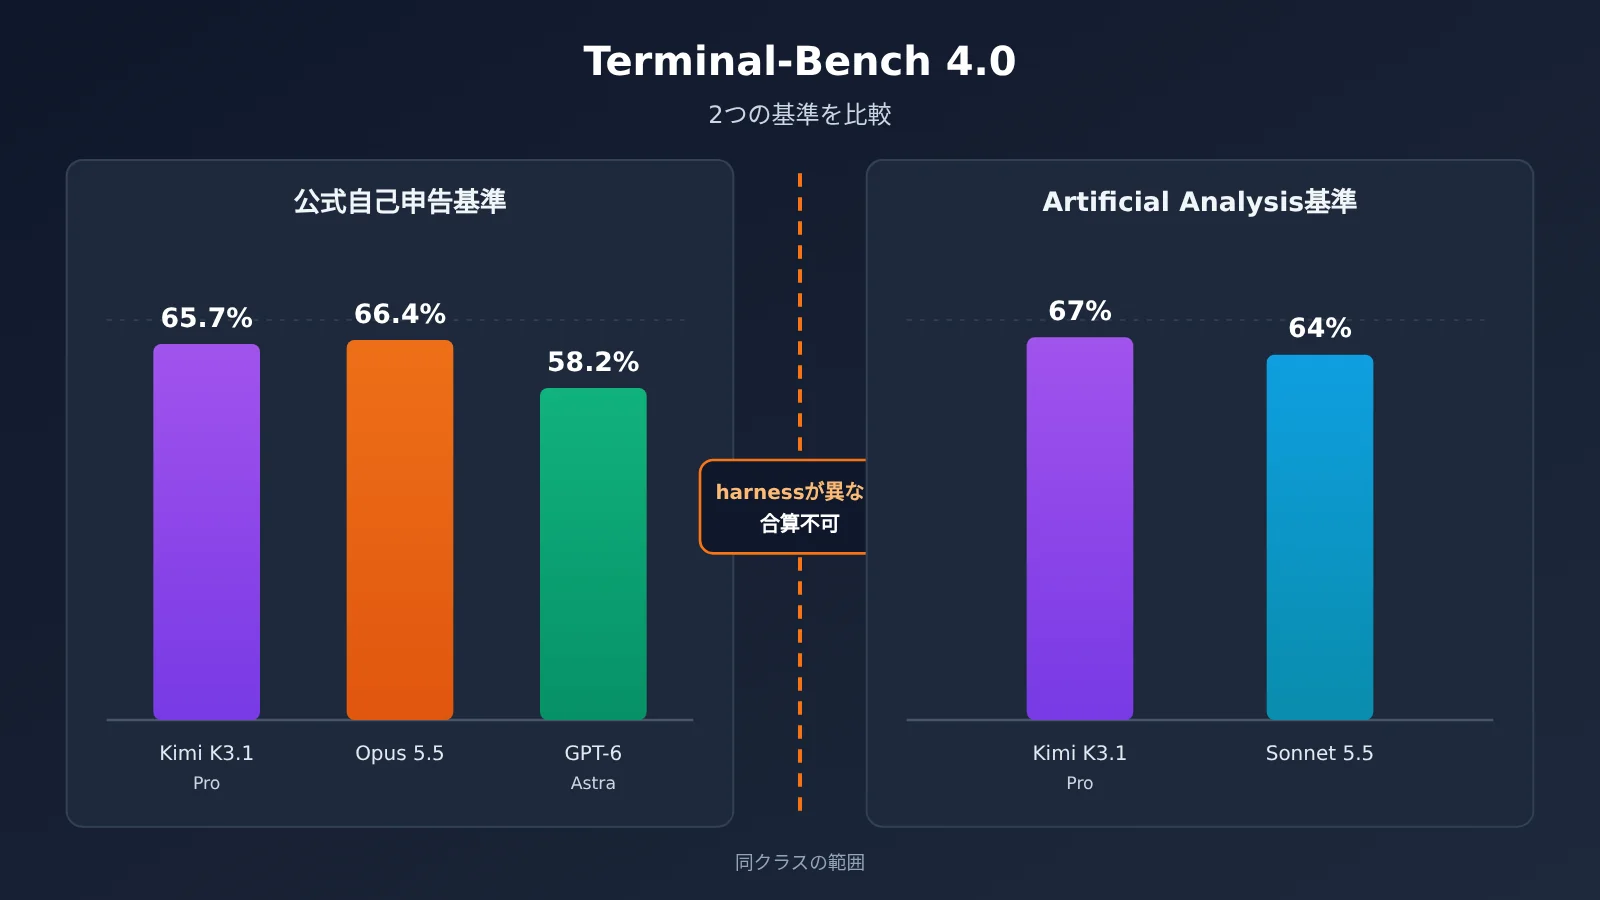
Terminal-Bench 4.0は、依存関係のインストールやバグの修正、スクリプトの実行など、実際のタスクをターミナル上で行うテストです。最終的な結果が正しい場合にのみ合格となります。以下の2つの表は、それぞれ異なる機関が発表したデータに基づいているため、数値を相互に比較することはできません。
3.1 公式発表の評価基準(Moonshotのブログ)
| テスト項目 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD(複数視点からCADコードを生成し、3D再構築を行うテスト) | 92.7%(ツール使用) | 96.2% | — |
テスト条件ではreasoning_effortをmaxに設定し、思考強度を最大にしています。また、K3.1 ProはClaude Codeのハーネスを使って実行されました。Moonshotはブログで、K3.1 Proは「Claude Opus 5.5にわずかに及ばない」と説明しています。
3.2 第三者の評価基準(Artificial Analysis、2026-10-23)
| テスト項目 | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index(総合知能指数) | 55(4位) | 58 | 56 |
| Terminal-Bench 4.0 | 67%(全モデル中最高) | 参考資料に記載なし | 64% |
| GDPval-AA(Elo) | 1846(3位) | 1866 | — |
| AA-Omniscience(知識の信頼性) | 指数 30、ハルシネーション率 44% | 参考資料に記載なし | — |
Opus 5.5の総合指数は、「max with fallback」の条件で測定されています。同じランキングに掲載されているMuse Wonder Fullも56点です。Eloは、チェスなどのレーティングに似た方式で、モデル同士の勝敗を比較して算出されます。数値が高いほど優れています。ハルシネーション率は、モデルが答えられないときに、答えをでっち上げる割合と考えるとわかりやすいでしょう。K3.1 Proの44%という数値には注意が必要です。
3.3 2つの評価基準を混同してはいけない理由
公式発表の65.7%とAAの67%は、どちらもK3.1 ProのTerminal-Bench 4.0の成績ですが、テストに使われたハーネスが異なります。ハーネスとは、「モデルに試験を受けさせるためのプログラム一式」のようなものです。モデルがどのツールを使えるか、ファイルをどう読み書きするか、タイムアウトを何秒にするかなどを決めます。ハーネスが変われば、同じモデルでもスコアは変わります。
そのため、「K3.1 ProはAAで67%を取り、公式発表のOpusの66.4%を上回った」とは言えません。正しくは、公式の評価基準ではK3.1 Proは0.7ポイント下回り、AAの評価基準では同機関が測定したモデルの中で最高だった、ということです。どちらの結論もそれぞれ正しく、並べて見れば、2つのモデルが同じ水準にあることがわかります。
3.4 スコア差1ポイントは、実際の開発で何を意味するのか
Terminal-Bench 4.0はタスクごとに厳密に採点され、結果は合格か不合格のどちらかです。1ポイントの差は、およそ100問あたり1問多く正解するか、少なく正解するかに相当します。こうした差は、ニッチなツールチェーンや特殊な環境設定など、あまり出会わない長尾タスクで生じることがよくあります。日常的なAPIの実装や業務コードの修正、単体テストの追加では、この程度の差を実感することはほとんどありません。
開発体験に本当に影響するのは、2つの「性格」の違いです。1つ目は思考スタイルです。K3.1 Proは常に思考モードが有効で、AAの観測では、タスクごとの出力がより長くなっています(第三者による評価)。2つ目はツールの呼び出し方です。たとえば、どのくらいの頻度でコマンドを実行するか、変更前にファイルを読む傾向があるかといった点ですが、現時点では信頼できる公開比較データがありません(未確認)。自分のリポジトリで実際のタスクをいくつか実行し、判断することをおすすめします。
4. Kimi K3.1 ProとClaude Opus 5.5の長所と短所
Kimi K3.1 Proの長所(公式ドキュメント):
- 入力・出力の単価はOpus 5.5の半額で、キャッシュ書き込みもより安価
- コンテキストウィンドウは1,048,576 tokens。
max_completion_tokensはデフォルトで131072、最大1048576まで設定可能 - OpenAIとAnthropic、両方のAPI形式に対応。公式はKimi Code、Codex、Claude CodeなどのプログラミングAgentでの利用を推奨
- 構造化出力、ツール呼び出し、
partialによる継続生成に対応。API利用者はゼロデータ保持を選択可能で、公式は2026-11-04までに完全な重みを公開すると約束
Kimi K3.1 Proの制限(公式ドキュメント+第三者評価):
- 思考モードは無効にできず、
reasoning_effortはlow/high/maxのみ設定可能。デフォルトはmax temperatureは1.0、top_pは0.95に固定されており、これらのパラメーターは指定できない- 画像入力では公開URLに対応しておらず、base64エンコード(画像を長い文字列に変換する方式)または
ms://file-idで渡す必要がある - AAの測定では幻覚率が44%。タスクごとの出力も長め
Claude Opus 5.5の長所:公式ベンチマークとAA総合指数のどちらでも上位に位置し、BenchCADでは約3.5ポイントリード、GDPval-AAでもより高いスコアを記録しています。1時間のキャッシュ設定とFastモードを利用でき、速度とコストのバランスを必要に応じて調整できます。主な制限は価格で、入力・出力ともにK3.1 Proの2倍です。Fastモードではさらに料金が倍になります。
5. Kimi K3.1 Pro vs Claude Opus 5.5:6種類のタスク別おすすめ
「Agent」とは、自分で手順を計画し、ツールを呼び出しながら、複数のステップにわたってタスクを実行するモデルアプリケーションのことです。たとえば、コードを自動で修正してテストを実行するプログラミングアシスタントが該当します。
| タスクの種類 | おすすめ | 結論 |
|---|---|---|
| 大量のオフラインタスク | Kimi K3.1 Pro | 料金は半額で、キャッシュ書き込みも安価です。大量のタスクをまとめて処理する場合、特にコストを抑えられます |
| 複数ターンのプログラミングAgent | どちらも選択肢。実際に試すのがおすすめ | ベンチマークスコアは同程度です。思考の長さやツールの呼び出し方が、利用するリポジトリに合うかどうかが主な判断基準です |
| 3D/CADコードの生成 | Claude Opus 5.5 | 公式発表のBenchCADスコアは96.2%対92.7%。Opus 5.5のほうが安定しています |
| 画像理解 | 接続方法に応じて選択 | K3.1 Proは画像に対応していますが、公開URLを直接渡すことはできません。両者の画像処理能力を同じ条件で比較できるデータはありません(未確認) |
| 安定性やコンプライアンスが求められる企業利用 | Claude Opus 5.5寄り。データ管理が必要ならKimiも検討 | Opus 5.5は総合指標がより高く、Kimiはデータを保持しないゼロデータ保持に対応し、重みの公開も間近です |
| 思考をオフにして低遅延にしたい場面 | Claude系 | K3.1 Proでは思考をオフにできません。Claudeの思考設定はAnthropicのドキュメントを確認してください。Fastモードを検討する方法もあります |
6. Kimi K3.1 Pro vs Claude Opus 5.5のコスト比較:単価が半額でも、コストが半分とは限らない
まず、簡単な計算をしてみましょう。同じリクエストで、入力が5万 tokens、出力が5,000 tokensの場合です。
- Kimi K3.1 Pro:5万 × $2 ÷ 100万 + 5,000 × $10 ÷ 100万 = $0.10 + $0.05 = $0.15
- Claude Opus 5.5:5万 × $4 ÷ 100万 + 5,000 × $20 ÷ 100万 = $0.20 + $0.10 = $0.30
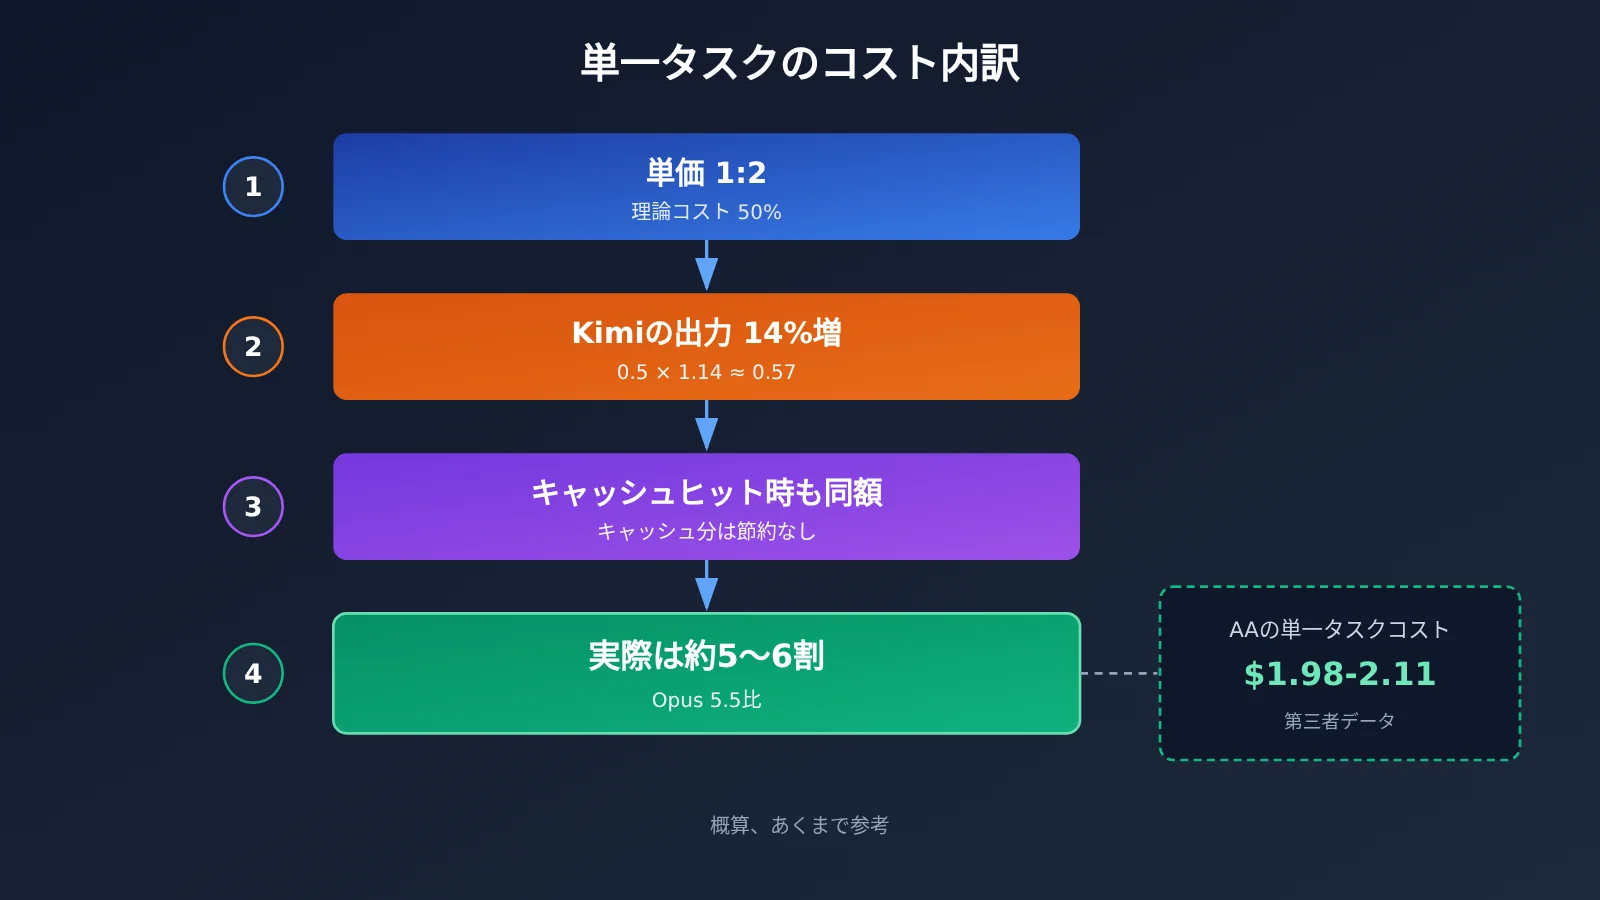
単価だけで計算すれば、ちょうど半分です。ただし、これは2つのモデルの出力が同じ長さであることが前提です。実際はそうではありません。AAのデータによると、Kimiはタスクごとの出力tokensが約14%多く、1タスクあたりの平均出力は約55K tokens、コストは約$1.98(モデルページの表示では$2.11)です(第三者データ)。AAの結論は、Kimiの単価はOpus 5.5の半額でも、思考過程が冗長なため、実際のタスク単位のコストは半額にはならないというものです。
概算ですが(未検証のため、あくまで参考値です)、コーディングAgentのタスクではコストの大半を出力が占めます。Kimiの出力が14%多い場合、出力部分のコストはOpus 5.5の約1.14 × 0.5 ≈ 57%となり、節約幅は半額ではなく4割強です。それでも大きな節約にはなりますが、予算を立てるときは5割削減として計算しないようにしましょう。
7. 国内から Kimi K3.1 Pro と Claude Opus 5.5 を呼び出す方法
国内の開発者が海外の公式APIに直接接続する場合、決済とネットワークの両面で問題が起きることがあります。APIYI(apiyi.com)は、1つのAPIキーで複数のモデルを呼び出せるAPI統合プラットフォームです。OpenAI互換のインターフェースに対応しており、従量課金で利用できます。2026-10-24時点の確認では、プラットフォーム上の claude-opus-5-5 の料金は入力 $4、出力 $20、キャッシュ読み取り $0.2、claude-sonnet-5-5 は $2 / $10 / $0.1 で、いずれもAnthropic公式と同じです。現在利用できるKimiシリーズのモデルは次のとおりです。
kimi-k3:$3 / $15、キャッシュ読み取り $0.3kimi-k2.7-code:$0.95 / $3.99kimi-k2.6:$0.6 / $2.4kimi-k2.5:$0.6 / $3.15
kimi-k3.1-pro は当日時点ではまだリストにありません。APIYIでのモデル名と料金は、プラットフォームのモデル一覧をご確認ください。このモデルは近日中に提供開始する予定です。接続方法は次のとおりです。
- OpenAI互換形式:
base_urlにhttps://api.apiyi.com/v1を指定 - Anthropic形式:ベースURLに
https://api.apiyi.comを指定 - Claude Codeなどのコーディングエージェントでは通常Anthropic形式を、一般的なSDKではOpenAI形式を使用
すぐに試すには:まずはAPIYI(apiyi.com)の新規ユーザー向け無料利用枠を使って、
claude-opus-5-5とclaude-sonnet-5-5で実際のリポジトリ上のタスクをいくつか実行し、比較の基準にしてみましょう。モデル名や料金の詳細はプラットフォームのモデル一覧をご確認ください。Kimi K3.1 Proは近日中に提供開始する予定です。公開後はモデル名を切り替えるだけで、すぐに比較できます。
8. Kimi K3.1 Pro vs Claude Opus 5.5:選び方のポイント
タスク量が多く、予算を抑えたい一方で、モデルが常に思考し続けることを許容できるなら、Kimi K3.1 Proのほうがコストパフォーマンスに優れています。総合的な安定性を重視する場合や、3D/CAD生成が必要な場合、あるいは思考をオフにして低レイテンシを実現したい場合は、Claudeシリーズ(Opus 5.5またはSonnet 5.5)が適しています。複数ターンにわたるコーディングエージェントのタスクでは、両者のベンチマーク結果は同程度です。ランキングを比較するより、自分のコードベースで1週間試してみるのがおすすめです。
見落としがちな選択肢もあります。Kimiを検討する主な理由が「価格が半分」なら、Claude Sonnet 5.5は入出力の単価がKimiと同じで、キャッシュヒット時の価格はさらに安く、AAの総合指数もわずかに上回っています。候補に加えて比較してみるとよいでしょう。
よくある質問(FAQ)
Q1:Kimi K3.1 ProとClaude Opus 5.5のコーディング能力には、どれくらい差がありますか?
Moonshotの公式発表によると、Terminal-Bench 4.0でのK3.1 Proは65.7%で、Claude Opus 5.5の66.4%を0.7ポイント下回っています。一方、AAによる第三者テストでは、K3.1 ProがTerminal-Bench 4.0でテスト対象モデル中の最高スコアを記録しています。両者は同じ水準にあり、差はおおむね1〜3ポイントです。
Q2:価格は何倍違いますか?
入出力の単価は2倍の差があります。キャッシュヒット時の価格はどちらも$0.20で同じですが、キャッシュ書き込みはKimiのほうが安価です。Kimiの出力がより長くなることを考慮すると、実際のタスクあたりのコストはOpus 5.5の約50〜60%と見積もられます。
Q3:公式発表の65.7%とAAの67%が異なるのはなぜですか?
テストに使われているハーネスが異なるためです。公式テストではClaude Codeのハーネスが使われています。測定条件が異なるスコアは、それぞれ同じ条件の中で比較する必要があり、単純に並べて優劣を判断することはできません。
Q4:Kimi K3.1 Proの思考をオフにできますか?
できません。`reasoning_effort`を`low`に下げることはできますが、`temperature`と`top_p`も固定値です。レイテンシを特に重視する場合は、Claudeシリーズのモデルを検討するのがおすすめです。
Q5:中国国内から、2つのモデルを同時に呼び出して比較するにはどうすればよいですか?
APIYI(apiyi.com)を使えば、同じAPIキーで`claude-opus-5-5`を呼び出せます。`base_url`には`https://api.apiyi.com/v1`を指定してください。Kimi K3.1 Proのモデル名と価格は、プラットフォームのモデル一覧をご確認ください。同モデルは近日中に提供開始予定です。それまでは、まず`kimi-k3`を使って比較できます。
Q6:初心者が練習用に選ぶなら、どちらがお得ですか?
まずはClaude Sonnet 5.5で基準を作るのがおすすめです。単価はK3.1 Proと同じです。APIYI(apiyi.com)に登録すると、無料のテスト用クレジットを利用できます。利用できるモデルと価格は、プラットフォームのモデル一覧をご確認ください。K3.1 Proも近日中に提供開始予定で、公開後はモデル名を切り替えるだけで比較できます。
Kimi K3.1 Pro vs Claude Opus 5.5:押さえておきたいポイント
- コーディング性能は同等クラス:公式発表ではK3.1 Proが0.7ポイント下回る一方、AAの評価ではK3.1 ProがTerminal-Bench 4.0で最高スコアを記録
- 価格は1:2:$2/$10と$4/$20。キャッシュヒット時の価格はどちらも$0.20
- コストは半分にならない:Kimiはタスクあたりの出力が約14%多く、AAの測定ではタスクあたりのコストは$1.98〜2.11
- 異なる評価基準を混同しない:公式の65.7%とAAの67%では、使用している評価ハーネスが異なる
- Opusの強み:総合指数、BenchCAD、GDPval-AAで優位
- Kimiの制約:思考モードを無効にできない、公開URL経由で画像を送れない、幻覚率は44%
- 利用を始めるには:APIYI apiyi.comでClaudeシリーズを先に試せます。K3.1 Proのモデル名と価格はプラットフォームの一覧をご確認ください。近日中に提供開始予定です
まとめ
Kimi K3.1 ProとClaude Opus 5.5の比較は、次の3点にまとめられます。
- 性能:コーディングとAgentの能力は同等クラスで、スコアの差はテスト誤差や評価基準の違いの範囲内です
- 価格:単価はちょうど2倍の差がありますが、Kimiは思考に時間をかけるため、実際のコスト削減幅は4割強です
- モデルの選び方:大量のタスクを処理する場合や予算を重視する場合はKimi、3D/CAD、低レイテンシ、総合的な安定性を重視する場合はClaudeが適しています
最も確実なのは、実際のタスクで比較することです。まずはAPIYI apiyi.comでClaudeシリーズを使って基準となる結果を確認できます。モデル名と価格はプラットフォームの一覧をご覧ください。Kimi K3.1 Proは近日中に提供開始予定です。公開後はモデル名を切り替えるだけで比較できます。
参考資料
- Moonshot公式ブログとKimi APIドキュメント:K3.1 Proのベンチマーク結果、パラメータ制限、料金
- リンク:
platform.moonshot.cn/docs -
説明:公式発表のTerminal-Bench 4.0、BenchCADの成績とパラメータに関する説明
-
Anthropic公式料金表:Claude Opus 5.5/Sonnet 5.5の5段階の料金
- リンク:
anthropic.com/pricing -
説明:Fastモードと1時間キャッシュの料金を含む
-
Artificial Analysis:第三者による総合指数とタスクあたりのコスト
- リンク:
artificialanalysis.ai -
説明:2026-10-23時点のデータ。Terminal-Bench 4.0、GDPval-AA、AA-Omniscienceを含む
-
APIYIのモデル一覧:プラットフォームで利用できるモデルと料金
- リンク:
docs.apiyi.com/models - 説明:2026-10-24時点で確認。最新情報はリアルタイムの一覧をご確認ください
著者:APIYI技術チーム
技術に関するお問い合わせ:詳しくは docs.apiyi.com のドキュメントセンターをご覧ください。モデルと料金はプラットフォームのモデル一覧をご確認ください。Kimi K3.1 Proは、できるだけ早くこのモデルを提供する予定です。