著者注:gpt-6.1-sol の呼び出しは成功したのに、空の本文が返ってくる?ドキュメントには completion_tokens 300 がすべて reasoning_tokens と記され、本文は一文字も書かれていない——本記事では原因と2つの解決策を整理します。
gpt-6.1-sol を呼び出した直後、API はエラーを返さず、受け取った message.content が空の文字列だったとしても、まずネットワークやモデルの不具合を疑う必要はありません。レスポンスの usage を見てみましょう。completion_tokens は 300、reasoning_tokens も 300、text_tokens は 0。つまり、この300トークンはすべて思考に費やされ、本文は一文字も書かれていないのです。
これは偶発的なオカルト問題でも、モデルが手を抜いているわけでもありません。ドキュメントによると、gpt-6.1-sol では思考プロセスと最終的な本文が同じ max_tokens の枠を共有しており、思考が書き終わる前に枠を使い切ると、本文が丸ごと打ち切られます。APIYI(apiyi.com)で gpt-6.1-sol を呼び出している開発者の多くも、初めてこの現象に遭遇したときはプラットフォームの障害を疑ったものです。
これは、ありふれた推論モデルの解説記事ではありません。 「本文が空になる」という具体的な症状に焦点を当てたトラブルシューティングガイドです。本記事を読めば、usage に並ぶ数字の意味がわかり、2つのパラメータレベルの変更によって本文を正常に出力させられるようになります。
gpt-6.1-sol で本文が空になる問題の核心
まず結論から。詳細は後述します。ドキュメントに記載されたいくつかの重要情報が、次にどう切り分けを進めるべきかを決めます。
| ポイント | ドキュメントの記載 | あなたにとっての価値 |
|---|---|---|
| 思考と本文が同じ枠を共有 | gpt-6.1-sol の推論プロセスと最終回答は、どちらも max_tokens から差し引かれる |
本文が空になる根本原因を理解できる |
| 300 token がすべて思考に | completion_tokens 300 は reasoning_tokens 300 に等しく、text_tokens は 0 |
問題の種類を一目で判断できる |
| 2つの外的な現れ方 | empty_response エラーコードが返る、または HTTP 200 だが本文が空文字列 |
「偽の成功」に惑わされない |
| 再試行はほぼ無効 | 同じプロンプト、同じ max_tokens でもう一度送ると結果はほぼ同じ |
無駄な回り道を減らせる |
この 300 token はどこに消えたのか
本文が空になる現象を理解するには、まず gpt-6.1-sol の回答の仕組みを押さえる必要があります。これは推論モデルに分類されます。実際に文章を書く前に、内部で「下書き」をするのです。問題を分解し、経路を試し、自己チェックする。この下書きこそが、reasoning_tokens として計上される部分です。
肝心なのは、ドキュメントによると、下書きと本文は2つの独立した枠ではなく、同じ max_tokens を共有しているという点です。max_tokens を 200〜500 程度の範囲に設定し、しかもタスクが実際に推論を必要とする場合、枠は思考段階で使い切られやすくなります。思考がまだ書き終わっていない、本文もまだ始まっていない、それなのに枠が先に底を打つ。返ってくるのは、当然ながら空白の本文です。
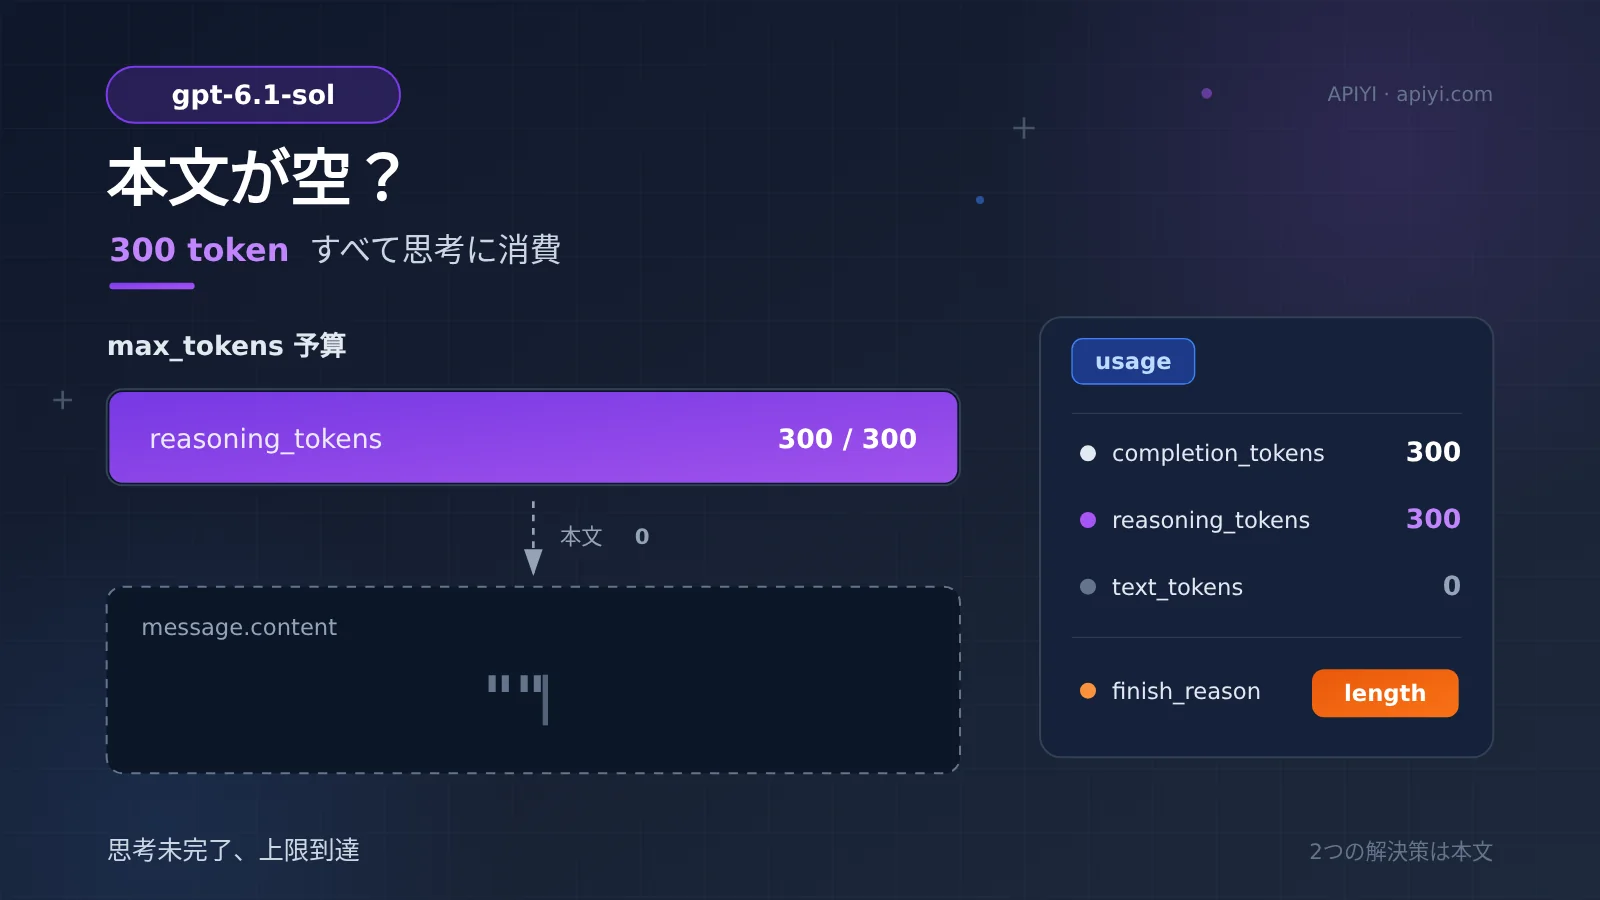
ドキュメントにある数値群が、このことを非常に率直に物語っています。
completion_tokens:300——今回生成されたすべての量reasoning_tokens:300——うち思考に費やされた部分text_tokens:0——実際に本文として書かれた部分finish_reason:length——停止理由は長さ上限に達したことであり、正常な終了ではない
completion_tokens と reasoning_tokens が完全に等しく、text_tokens がゼロ。これはほぼ「枠をすべて思考に食われた」という標準的なシグネチャです。さらに finish_reason が length であることと合わせれば、モデルが「答えたいのに答えられない」のではなく「答える枠がない」ことが確認できます。今回ぶつかった上限も、ドキュメントが言う 200〜500 という枯渇しやすいレンジにちょうど収まっています。
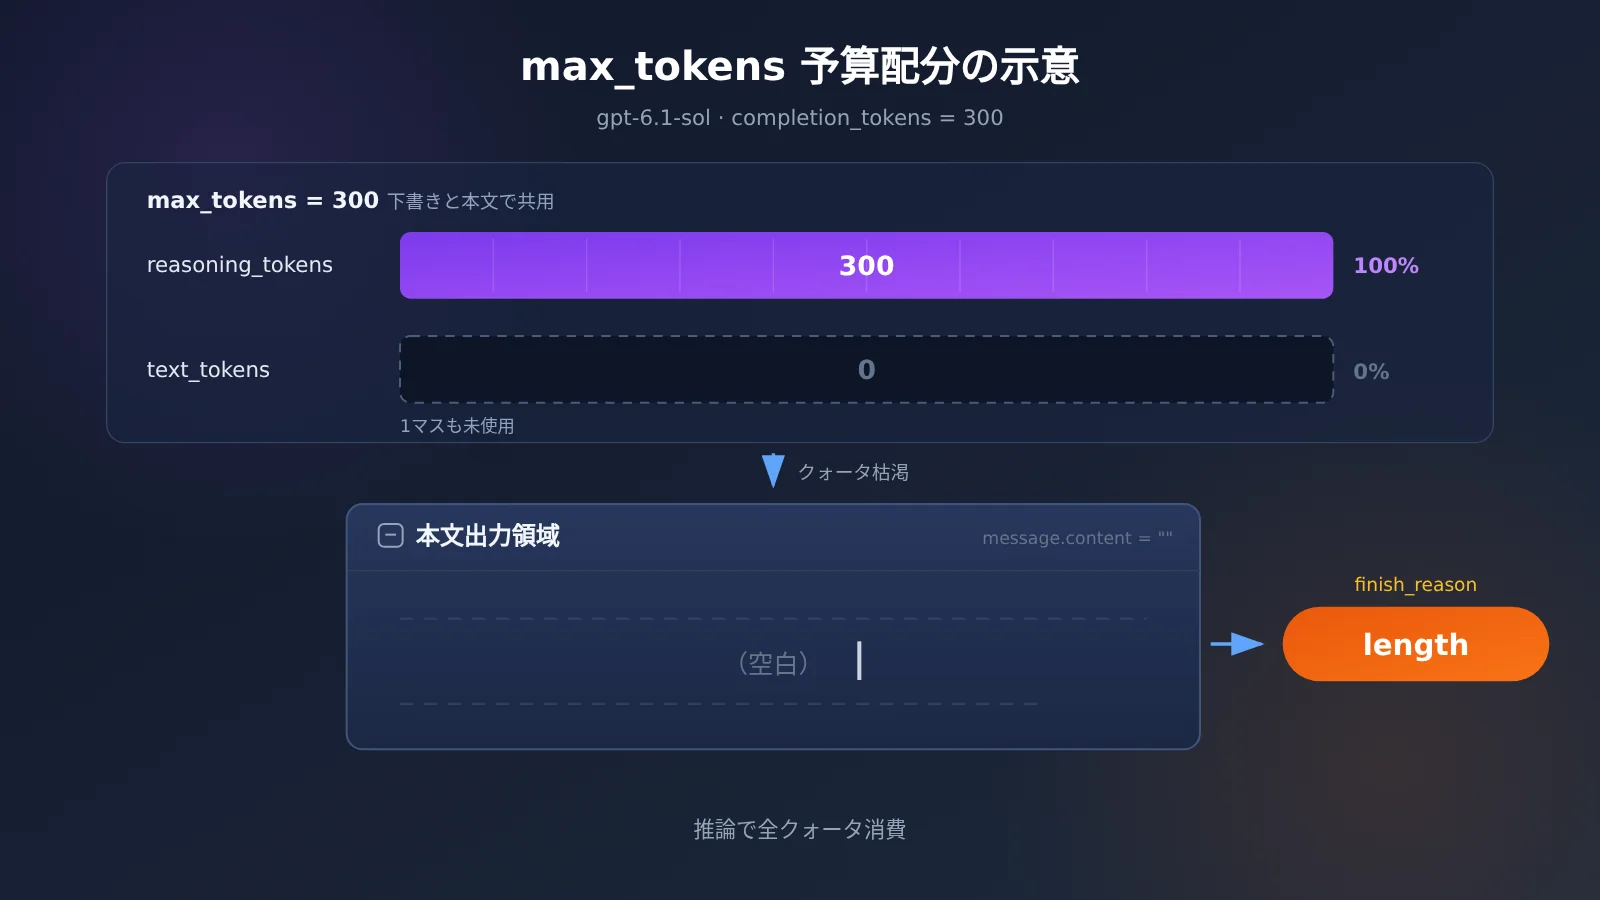
上の図が表しているのは、今回の呼び出しにおける予算配分そのものです。フィールドの意味についての完全な原文は APIYI ドキュメントセンターに収録されています。印象でパラメータを変えないよう、原文と照らし合わせて詳細を再確認することをお勧めします。
本文が空になる2つの外的な現れ方
同じ原因でも、API レベルでは2通りの現れ方があり、いずれもドキュメントに記載されています。ひとつは直接エラーになるケースで、エラーコード empty_response が返り、リクエストは明確に異常としてマークされます。もうひとつは「偽の成功」で、HTTP 200、一見すべて正常なのに、message.content が空文字列になっています。
2つ目のほうが誤解を招きやすいです。ステータスコードは成功で、所要時間も正常なので、usage を見なければ本文が空だということに気づけません。ですから「API は成功したのに内容が空」というときは、まずネットワークを疑うのではなく usage を確認すべきです。
| 外的な現れ方 | 返却内容 | 判断の根拠 |
|---|---|---|
| 直接エラー | エラーコード empty_response |
一目でわかる |
| 偽の成功 | HTTP 200、message.content が空文字列 |
usage と finish_reason の確認が必要 |
gpt-6.1-sol で本文が空になる原因を確認する方法
原因の切り分けはそれほど難しくありません。4つのステップで十分で、確認の順番は usage から始めるのがおすすめです。
completion_tokensとreasoning_tokensが等しいか確認する。等しければ、生成されたトークンがすべて思考に使われ、本文にはまったく割り当てられなかったことを意味します。text_tokensが 0 かどうか確認する。0 なら本文が一文字も書かれていないわけで、これが最も直接的な証拠です。finish_reasonがlengthかどうか確認する。正常な終了ではなくlengthであれば、モデルが上限で打ち切られたことを示します。- 自分の
max_tokens設定を思い出す。200〜500 の範囲に設定していて、しかも推論が必要なタスクなら、ほぼ間違いなくこれが原因です。
確認できたら、すぐに省ける作業が一つあります。それは「そのまま再試行すること」です。ドキュメントによると、同じプロンプト、同じ max_tokens では、再試行してもほとんど効果がありません。これはネットワークの一時的な揺らぎではなく、クォータ配分の必然的な結果だからです。もう一度送っても予算は同じで、思考が先にそれを使い切ってしまいます。
APIYI のようなアグリゲーションプラットフォーム経由で gpt-6.1-sol を呼び出す場合、確認の入口は通常次のとおりです。
- プラットフォーム URL:APIYI apiyi.com
- エンドポイント:
https://api.apiyi.com/v1 - モデル名:
gpt-6.1-sol - API 仕様:OpenAI 互換、パラメータの意味は公式 API と同一
ヒント:APIYI apiyi.com で無料のテストクォータを取得し、同じプロンプトで異なる
max_tokensの戻り値を比較すれば、数分で問題がクォータ配分にあるのか、モデル自体にあるのかを確認できます。
gpt-6.1-sol の空本文を素早く修正:max_tokens を大きくするか reasoning_effort を下げる
原因がはっきりすれば、解決策もおのずと見えてきます。方向性は2つだけです。本文にスペースを確保するか、思考に使う分を減らすか。この2つの解決策はそれぞれ異なるタスクに適しているので、混ぜて使わないようにしてください。
解決策1:max_tokens を大きくする。ドキュメントが示す参考値は、通常の会話なら2000から、複雑な推論や長文タスクなら16000以上です。この数値は適当に決められたものではありません。推論の下書き自体が短くない場合があり、本文にはさらに追加のスペースが必要になります。2000はあくまで通常の会話のスタートラインにすぎません。
解決策2:reasoning_effort を下げる。タスクが深い推論を必要としない場合、たとえば簡単な書き換え、フォーマット変換、一言だけの问答などでは、モデルに「あまり考えさせない」ようにできます。思考フェーズの消費を抑えれば、同じ上限でも足りるようになります。
| 方案 | 做法 | 适用场景 | 预期效果 |
|---|---|---|---|
max_tokens を大きくする |
通常の会話は2000から、複雑な推論や長文は16000以上 | 完全な推論品質が必要なタスク | 根本解決 |
reasoning_effort を下げる |
推論強度を下げる | 軽いタスク、推論の深さをあまり要求しない | 思考の消費を削減 |
| 元のパラメータで再試行 | 何も変えずにもう一度送信 | ほぼ無効 | 推奨しない |
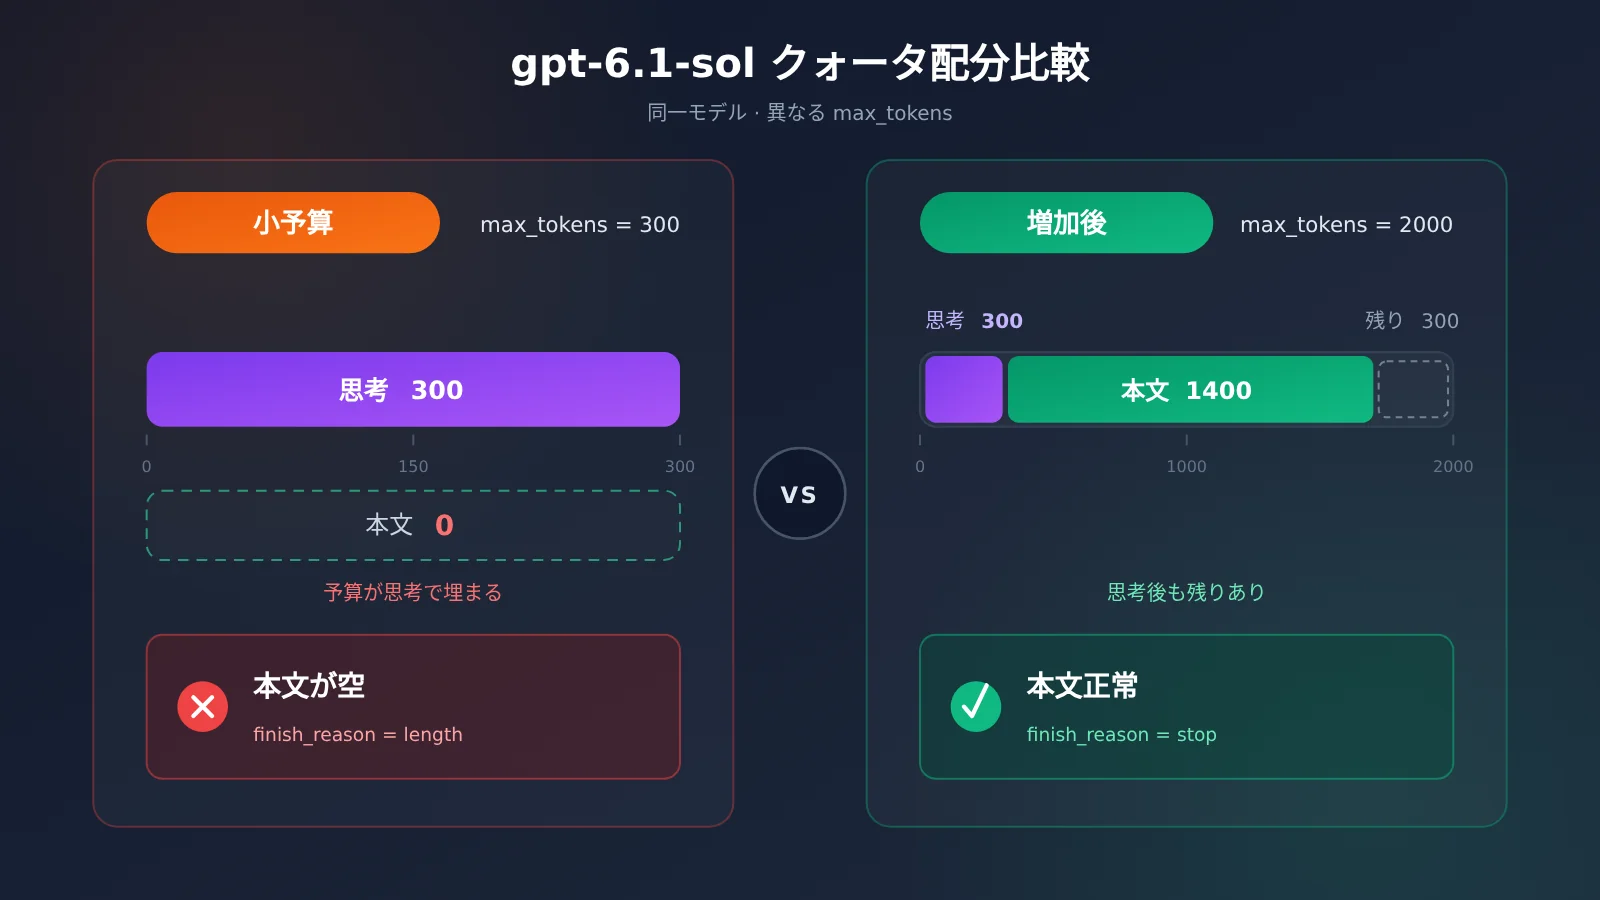
解決策の比較と解説
max_tokens を大きくするのが第一候補です。これはモデルの思考の仕方を変えるものではなく、「下書き用紙」を大きくするだけなので、推論品質には影響しません。上限を大きくすれば、思考は通常どおり行われ、本文にも自分の割り当て分が確保され、text_tokens は自然と0ではなくなります。
reasoning_effort を下げるのは、別の種類のシナリオに適しています。タスク自体は深い思考を必要としていないのに、モデルがデフォルトで完全な推論を実行してしまう場合です。下げれば思考の消費が減り、応答も速くなりますが、複雑なタスクではおすすめしません。推論の深さが圧縮されて回答品質に影響する可能性があります。
元のパラメータでの再試行を個別に取り上げるのは、これが最もよくある間違った反応だからです。ドキュメントによれば、同じプロンプト、同じ max_tokens では、再試行はほとんど役に立ちません。これは運の問題ではなく、算数の問題です。上図の2つのシナリオの違いも、APIYI apiyi.com のプラットフォーム上で同じプロンプトを使って再現でき、2分で比較結果を確認できます。
max_tokens を大きくすると高くなるのか
多くの人が max_tokens を大きくするのをためらうのは、請求額が爆発するのを恐れるからです。ここでドキュメントには重要な説明があります。max_tokens は上限であって実際の消費量ではなく、課金は実際に生成された token に基づいて計算されます。
つまり、max_tokens を300から2000に引き上げても、呼び出しのたびに2000で課金されるわけではありません。思考にいくつ使われ、本文にいくつ書かれたか、その分だけが計上され、上限を使い切らなかった部分には費用が発生しません。上限を大きくする本質は、本文に生存スペースを確保することであり、より大きな支出を前払いすることではありません。APIYI apiyi.com は従量課金モデルを採用しており、具体的な単価はプラットフォームの価格ページを基準とします。本記事では具体的な数字は引用しません。
gpt-6.1-sol 空本文 よくある質問(FAQ)
Q1:gpt-6.1-sol の「空本文」とは何ですか?
`gpt-6.1-sol` を呼び出すとき、思考プロセスと本文は `max_tokens` を共有します。思考が先に枠を使い尽くすと、本文がまるごと切り捨てられ、結果として空になります。ドキュメントに記載された数値の組では、`completion_tokens` の 300 がすべて `reasoning_tokens` で、`text_tokens` は 0 でした。
Q2:HTTP 200 でも異常と見なすべきですか?
はい、異常です。ドキュメントには、空本文には 2 つの現れ方があると記載されています。`empty_response` エラーコードが返る場合と、HTTP 200 ながら `message.content` が空文字列の場合です。ステータスコードが成功でも内容が正常とは限りません。usage の `text_tokens` と `finish_reason` を合わせて判断する必要があります。
Q3:なぜリトライが効かないのですか?
ドキュメントの記載どおり、同じプロンプト・同じ `max_tokens` では、リトライはほとんど意味がありません。枠の配分は決定的だからです。予算が変わらなければ、思考がやはり先に使い終わります。結果を変えたいなら、運ではなくパラメータを変えるべきです。
Q4:モデルが回答していないのでしょうか?
回答を拒否したのではなく、回答する枠がなかったのです。`finish_reason` が `length` なら、モデルは上限によって打ち切られたのであって、自発的に停止したわけではありません。`max_tokens` を大きくすれば、同じ質問でも本文を得られます。
Q5:どんな設定が最もハマりやすいですか?
ドキュメントの記載では、`max_tokens` をおよそ 200〜500 に設定し、しかも推論が必要なタスクだと、思考段階で使い尽くされます。この範囲は通常の対話モデルなら足りるかもしれませんが、`gpt-6.1-sol` のような推論モデルでは、下書きすら書き終わらないことがよくあります。
Q6:修正が有効か素早く検証するには?
APIYI apiyi.com で比較検証するのがおすすめです。アカウント登録で無料テスト枠を取得し、エンドポイントに `https://api.apiyi.com/v1`、モデルに `gpt-6.1-sol` を指定したうえで:
1. 同じプロンプトのまま、`max_tokens` を 2000 に上げて再度リクエスト
2. `text_tokens` が 0 より大きいか確認
3. `message.content` に本文があるか確認
同じプラットフォーム・同じプロンプトでの比較なら、変数はパラメータ 1 つだけなので、結論が最もクリーンになります。
Q7:max_tokens を大きくすると費用が増えますか?
上限で課金されることはありません。ドキュメントの記載では、`max_tokens` は上限であって実際の消費量ではなく、課金は実際に生成された token に基づきます。思考+本文で実際に生成された分だけが課金され、具体的な単価は APIYI の価格ページに準じます。
Q8:非推論モデルでも同じことが起きますか?
ドキュメントの記載では、非推論モデルでこのような空本文は起きません。思考段階がないため、`max_tokens` がすべて本文に割り当てられ、枠が小さい場合は回答が切り詰められるだけで、全体が空になることはありません。これはモデルを替えるべきかどうかを判断する材料のひとつでもあります。
gpt-6.1-sol 空本文の核心ポイント Key Takeaways
- 空本文の根本原因:思考と本文が
max_tokensを共有しており、思考が先に枠を使い尽くしてしまう - 判別のシグネチャ:
completion_tokensがreasoning_tokensと等しく、text_tokensが 0 - 2つの現れ方:
empty_responseエラーコード、または HTTP 200 で空文字列 - 第一の解決策:通常の会話なら 2000 から、複雑な推論や長文なら 16000 以上
- 軽量な代替策:
reasoning_effortを下げて思考の消費を抑える - 無駄な努力は不要:同じパラメータでのリトライはほぼ無効
- 課金のロジック:
max_tokensは上限であり、実際の生成量に応じて課金される
まとめ
gpt-6.1-sol の空本文の核心ポイントは、振り返ってみると実にシンプルです:
- 原因:思考と本文が
max_tokensを共有しており、あの 300 という数字はすべてreasoning_tokensで、text_tokensは 0、finish_reasonはlengthでした。 - 修正:
max_tokensを大きくする(通常の会話なら 2000 から、複雑な推論なら 16000 以上)、またはreasoning_effortを下げる。元のパラメータでのリトライはほぼ無効です。 - 課金:
max_tokensは消費量ではなく上限であり、実際に生成された token に応じて課金されるので、大きくしても気にする必要はありません。
次に「API は成功しているのに本文が空」という状況に遭遇したら、まず usage を確認し、次に finish_reason を見てください。基本的に 10 秒以内に原因を特定できます。修正効果の検証には APIYI(apiyi.com)を使うのがおすすめです。無料のテスト枠と複数モデル統合インターフェースを提供しており、パラメータを 1 つ変えるだけで即座に比較できます。
参考資料
- APIYI ドキュメントセンター:推論モデルの空本文に関する説明
- リンク:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
説明:空本文の原因、2つの症状と解決方法についての原典
-
APIYI ドキュメント速報:gpt-6.1-sol の空本文事例(2026-11)
- リンク:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - 説明:
completion_tokensが 300 の数値データとmax_tokensの推奨値の出典
執筆者:APIYI 技術チーム
技術交流:APIYI サイトのトップページからお問い合わせください。その他の資料は docs.apiyi.com ドキュメントセンターでご覧いただけます