Anmerkung des Autors: Der Aufruf von gpt-6.1-sol war erfolgreich, aber der Antworttext ist leer? Laut Dokumentation sind die 300 completion_tokens vollständig reasoning_tokens – im Text steht kein einziges Wort. Dieser Artikel erklärt die Ursache und zwei Lösungswege.
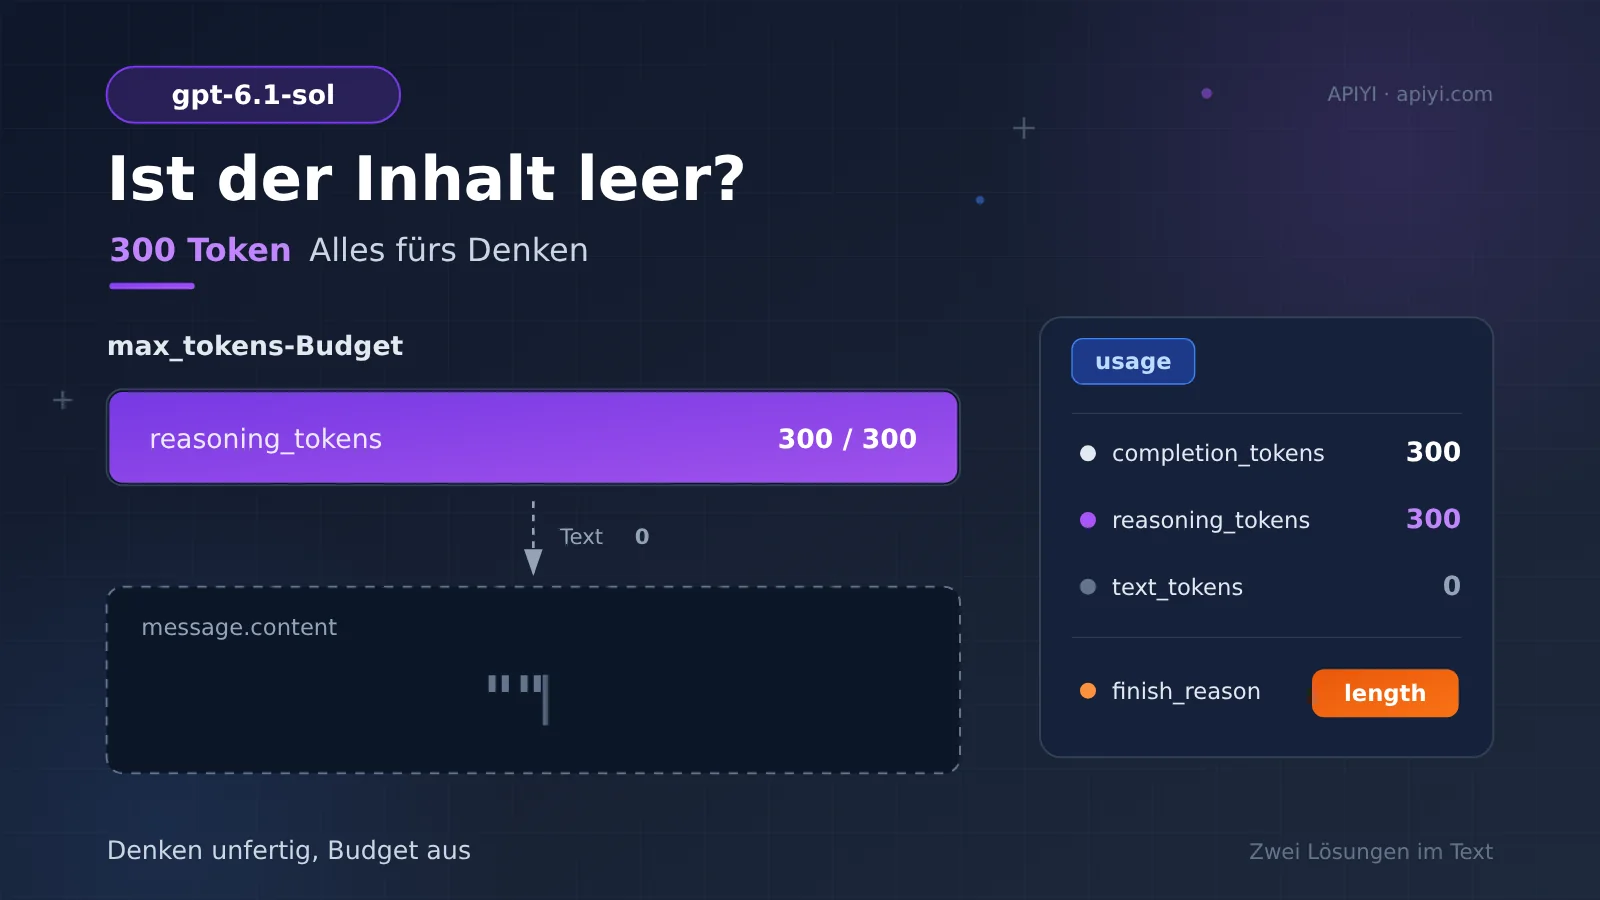
Wenn Sie gerade gpt-6.1-sol aufgerufen haben, die Schnittstelle keinen Fehler gemeldet hat und Sie trotzdem einen leeren String in message.content erhalten haben, sollten Sie nicht sofort das Netzwerk oder das Modell verdächtigen. Werfen Sie einen Blick auf das usage-Objekt der Antwort: completion_tokens ist 300, reasoning_tokens ist ebenfalls 300, text_tokens ist 0. Das heißt: Diese 300 Token wurden komplett fürs Nachdenken verbraucht, und in den eigentlichen Antworttext wurde kein einziges Wort geschrieben.
Das ist kein gelegentliches mystisches Problem und auch keine Faulheit des Modells. Laut Dokumentation teilen sich der Denkprozess und der finale Antworttext von gpt-6.1-sol dasselbe max_tokens-Budget. Wenn das Denken noch nicht abgeschlossen ist und das Budget vorher aufgebraucht wird, wird der Antworttext komplett abgeschnitten. Viele Entwickler, die gpt-6.1-sol über APIYI (apiyi.com) aufrufen, halten dieses Phänomen beim ersten Auftreten für eine Störung der Plattform.
Dies ist kein weiterer allgemeiner Erklärartikel über Reasoning-Modelle, sondern ein Diagnoseleitfaden für genau dieses Symptom: „der Antworttext ist leer“. Nach dem Lesen dieses Artikels können Sie die Zahlen im usage-Objekt richtig deuten und mit zwei Änderungen auf Parameterebene dafür sorgen, dass der Antworttext wieder ordentlich herauskommt.
Kernpunkte bei leerem Antworttext von gpt-6.1-sol
Zuerst die Schlussfolgerung, Details folgen weiter unten. Einige zentrale Informationen aus der Dokumentation bestimmen, wie du als Nächstes vorgehst:
| Punkt | Erläuterung in der Dokumentation | Nutzen für dich |
|---|---|---|
| Reasoning und Antworttext teilen sich ein Budget | Bei gpt-6.1-sol werden sowohl der Reasoning-Prozess als auch die endgültige Antwort von max_tokens abgezogen |
Die Ursache für den leeren Antworttext verstehen |
| 300 Token stecken komplett im Reasoning | completion_tokens 300 entspricht reasoning_tokens 300, text_tokens ist 0 |
Den Problemttyp auf einen Blick erkennen |
| Zwei äußere Erscheinungsformen | Entweder der Fehlercode empty_response oder HTTP 200 mit einem leeren Antwortstring |
Sich nicht vom „falschen Erfolg“ täuschen lassen |
| Wiederholen bringt meist nichts | Gleiche Eingabeaufforderung, gleiche max_tokens, erneutes Senden liefert ungefähr dasselbe Ergebnis |
Weniger Umwege |
Wohin diese 300 Token geflossen sind
Um einen leeren Antworttext zu verstehen, muss man zuerst verstehen, wie gpt-6.1-sol antwortet. Es ist ein Reasoning-Modell: Bevor es mit dem eigentlichen Schreiben beginnt, erstellt es intern einen „Entwurf“ – es zerlegt die Frage, probiert Pfade aus und prüft sich selbst. Dieser Entwurf ist der Teil, der unter reasoning_tokens verbucht wird.
Entscheidend ist: Laut Dokumentation sind Entwurf und Antworttext keine zwei getrennten Budgets, sondern teilen sich dasselbe max_tokens. Wenn max_tokens auf etwa 200 bis 500 gesetzt ist und die Aufgabe tatsächlich Reasoning erfordert, ist das Budget schnell schon in der Reasoning-Phase aufgebraucht: Das Reasoning ist noch nicht fertig, der Antworttext hat noch nicht begonnen, und das Budget ist bereits erschöpft. Zurück kommt natürlich ein leerer Antworttext.
Die Zahlen in der Dokumentation sind sehr eindeutig:
completion_tokens: 300 – die gesamte in diesem Aufruf generierte Mengereasoning_tokens: 300 – davon für das Reasoning aufgewendettext_tokens: 0 – tatsächlich für den Antworttext geschriebenfinish_reason:length– der Stoppgrund ist das Erreichen der Längenobergrenze, kein normales Ende
completion_tokens und reasoning_tokens sind exakt gleich, text_tokens ist null – das ist nahezu die Standard-Signatur dafür, dass „das gesamte Budget vom Reasoning aufgefressen wurde“. Zusammen mit finish_reason length bestätigt das: Das Modell hat nicht „nicht antworten wollen“, sondern „kein Budget zum Antworten gehabt“. Die diesmal erreichte Obergrenze liegt außerdem genau in dem in der Dokumentation genannten, leicht erschöpfbaren Bereich von 200 bis 500.
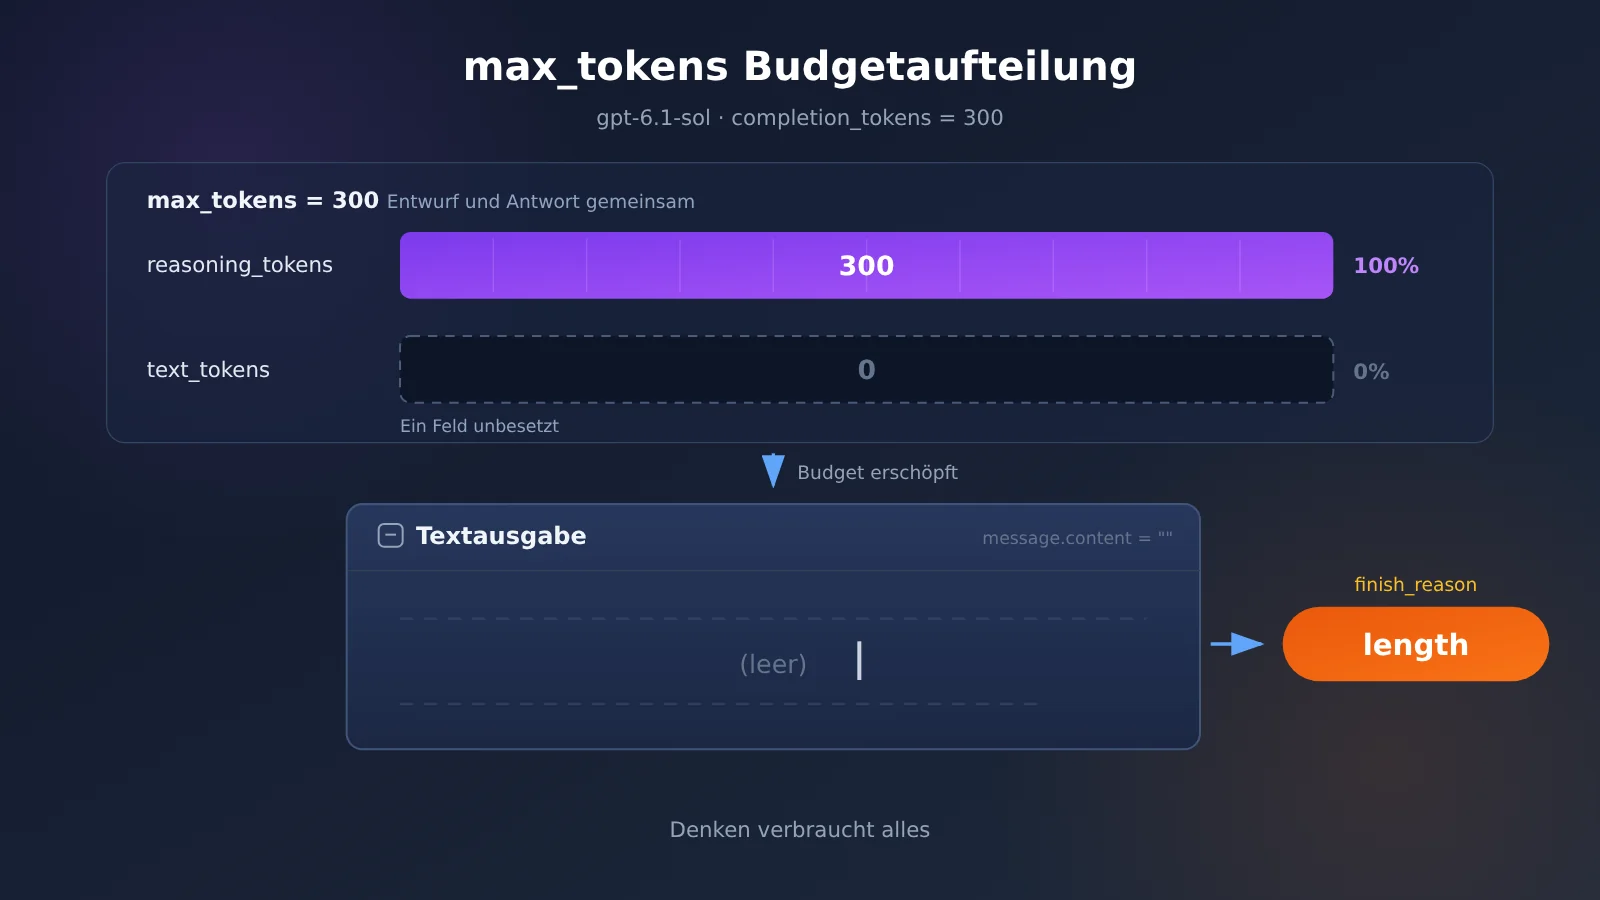
Das obige Bild beschreibt die Budgetverteilung dieses Aufrufs. Die vollständige Originaldokumentation der Feldbedeutungen ist im APIYI-Dokumentationszentrum zu finden; es empfiehlt sich, die Details noch einmal mit dem Original abzugleichen, statt Parameter aus dem Bauch heraus zu ändern.
Zwei Erscheinungsformen einer leeren Antwort
Ein und dieselbe Ursache zeigt sich auf API-Ebene auf zwei Arten – beide sind dokumentiert. Einmal als direkter Fehler mit dem Fehlercode empty_response: Die Anfrage wird eindeutig als fehlgeschlagen markiert. Zum anderen als „falscher Erfolg“: HTTP 200, alles sieht normal aus, doch message.content ist ein leerer String.
Die zweite Variante ist deutlich irreführender. Der Statuscode signalisiert Erfolg, die Laufzeit ist unauffällig, und ohne einen Blick in usage bemerkt man gar nicht, dass die Antwort leer ist. Wenn also „API erfolgreich, aber Inhalt leer“ auftritt, sollte man zuerst usage prüfen – nicht die Netzwerkverbindung.
| Erscheinungsform | Rückgabeinhalt | Erkennungsmerkmal |
|---|---|---|
| Direkter Fehler | Fehlercode empty_response |
Sofort sichtbar |
| Falscher Erfolg | HTTP 200, message.content ist ein leerer String |
usage und finish_reason müssen geprüft werden |
Wie man die Ursache für die leere Antwort von gpt-6.1-sol bestätigt
Die Fehlersuche ist nicht kompliziert – vier Schritte reichen, und man sollte mit usage beginnen:
- Prüfen, ob
completion_tokensundreasoning_tokensgleich sind. Sind sie gleich, wurde das gesamte Generierungsbudget fürs Denken verbraucht, und für die eigentliche Antwort blieb nichts übrig. - Prüfen, ob
text_tokensgleich 0 ist. Null bedeutet: kein einziges Wort Inhalt wurde geschrieben – das ist der direkteste Beweis. - Prüfen, ob
finish_reasongleichlengthist.lengthstatt eines normalen Abschlusses heißt: Das Modell wurde durch das Limit abgeschnitten. - Die eigene
max_tokens-Einstellung in Erinnerung rufen. Liegt sie im Bereich von 200 bis 500 und erfordert die Aufgabe zusätzlich Reasoning, passt das Bild meist genau zusammen.
Nach der Bestätigung kann man sich eines sofort sparen: das unveränderte Wiederholen der Anfrage. Laut Dokumentation bringt ein erneuter Versuch mit demselben Prompt und demselben max_tokens praktisch nichts. Denn das ist kein Netzwerkflackern, sondern das zwangsläufige Ergebnis der Budgetverteilung – schickt man die Anfrage noch einmal, ist das Budget wieder gleich groß, und das Denken verbraucht es erneut zuerst.
Wenn Sie gpt-6.1-sol über eine Aggregationsplattform aufrufen, sieht der Einstieg in die Fehlersuche typischerweise so aus:
- Plattformadresse: APIYI apiyi.com
- API-Adresse:
https://api.apiyi.com/v1 - Modellname:
gpt-6.1-sol - API-Spezifikation: OpenAI-kompatibel, Parametrsemantik identisch mit der offiziellen Schnittstelle
Empfehlung: Holen Sie sich über APIYI apiyi.com ein kostenloses Testkontingent und vergleichen Sie mit demselben Prompt die Rückgaben bei unterschiedlichen
max_tokens. In wenigen Minuten lässt sich bestätigen, dass das Problem in der Budgetverteilung liegt – und nicht im Modell selbst.
gpt-6.1-sol: Leerer Antworttext – Schnellreparatur durch Erhöhen von max_tokens oder Senken von reasoning_effort
Die Ursache ist klar, die Lösung ergibt sich von selbst – und es gibt nur zwei Richtungen: dem Antworttext mehr Platz geben oder das Denken weniger kosten lassen. Die beiden Ansätze passen zu unterschiedlichen Aufgaben, also nicht vermischen.
Lösung 1: max_tokens erhöhen. Die Dokumentation nennt als Referenzwerte: bei normalen Dialogen ab 2000, bei komplexem Reasoning oder Langtext-Aufgaben über 16000. Diese Größenordnung ist nicht aus der Luft gegriffen – der Reasoning-Entwurf selbst kann schon recht lang sein, und der Antworttext braucht zusätzlichen Platz; 2000 ist nur die Startlinie für normale Dialoge.
Lösung 2: reasoning_effort senken. Wenn die Aufgabe kein tiefes Reasoning erfordert, etwa einfaches Umformulieren, Formatkonvertierung oder Frage-Antwort in einem Satz, kann man das Modell „weniger nachdenken“ lassen. Sinkt der Verbrauch in der Denkphase, reicht das gleiche Budget aus.
| Ansatz | Vorgehen | Geeignete Szenarien | Erwartete Wirkung |
|---|---|---|---|
max_tokens erhöhen |
normale Dialoge ab 2000; komplexes Reasoning, Langtext über 16000 | Aufgaben, die vollständige Reasoning-Qualität brauchen | an der Wurzel beheben |
reasoning_effort senken |
Reasoning-Intensität verringern | leichte Aufgaben, geringe Anforderungen an die Reasoning-Tiefe | Denkverbrauch reduzieren |
| Mit Originalparametern erneut versuchen | unverändert noch einmal senden | im Wesentlichen wirkungslos | nicht empfohlen |
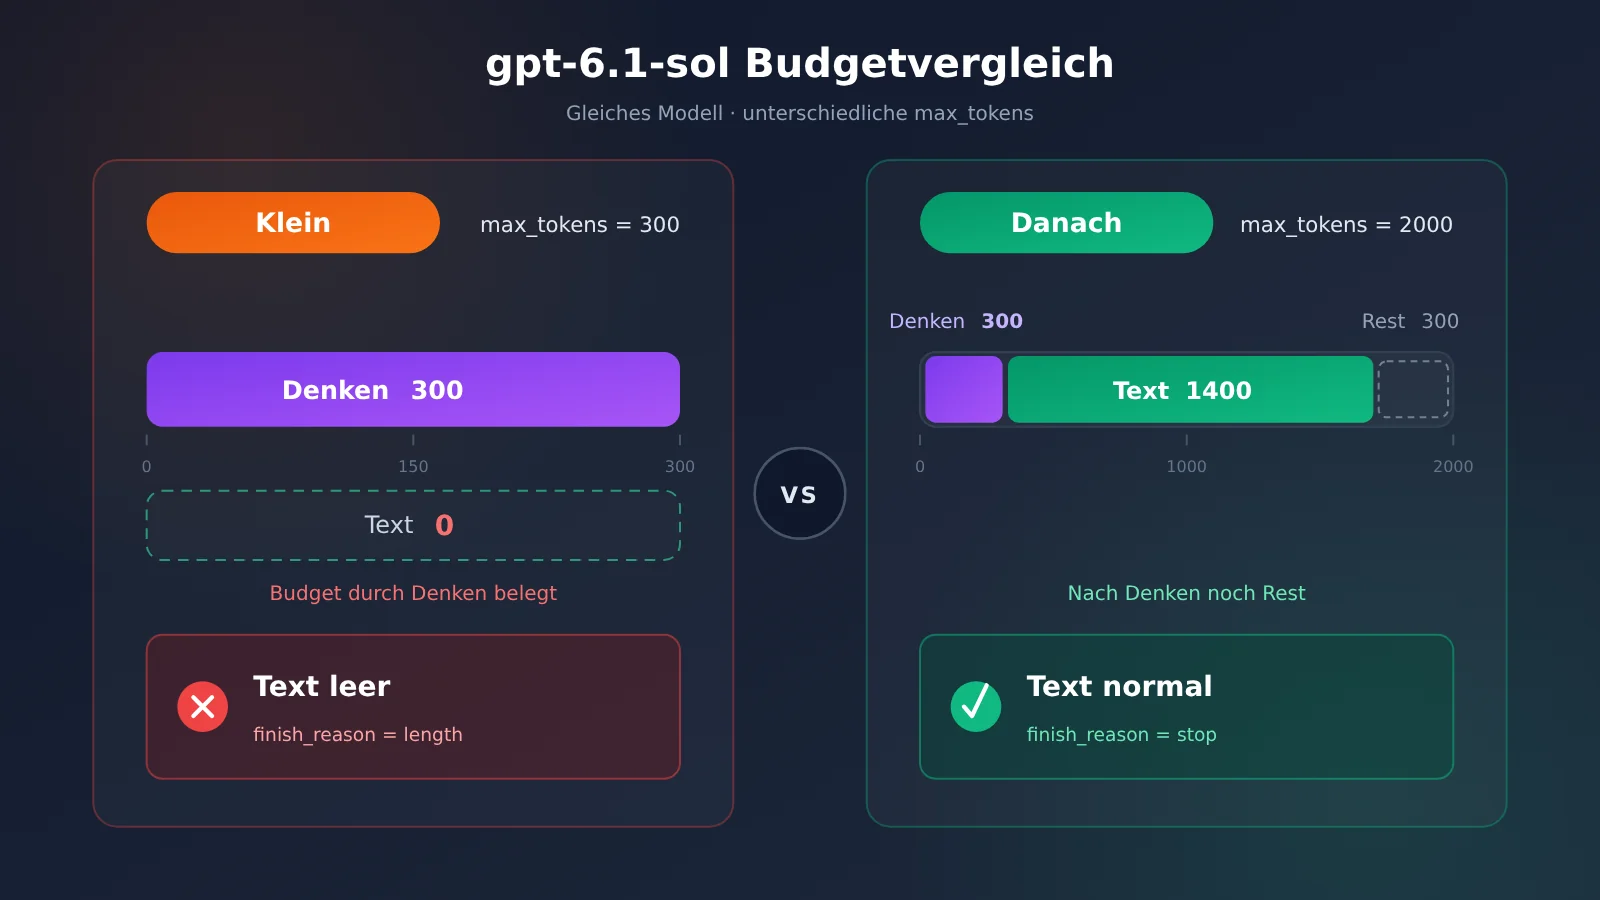
Die Lösungen im Vergleich
max_tokens erhöhen ist die bevorzugte Lösung. Sie ändert die Denkweise des Modells nicht, sondern vergrößert nur das „Entwurfspapier“, die Reasoning-Qualität bleibt unberührt. Nachdem die Obergrenze erhöht wurde, läuft das Denken wie gewohnt weiter, und der Antworttext kann sein eigenes Budget erhalten; text_tokens ist dann natürlich nicht mehr 0.
reasoning_effort senken passt zu einer anderen Art von Szenario: Die Aufgabe selbst braucht kein tiefes Nachdenken, das Modell führt aber standardmäßig das vollständige Reasoning aus. Nach dem Senken sinkt der Denkverbrauch und die Antwort ist schneller, aber bei komplexen Aufgaben ist davon abzuraten – eine komprimierte Reasoning-Tiefe kann die Antwortqualität beeinträchtigen.
Mit Originalparametern erneut versuchen erwähne ich separat, weil es die häufigste Fehlreaktion ist. Die Dokumentation hält fest: bei gleicher Eingabeaufforderung und gleichem max_tokens bringt ein erneuter Versuch im Wesentlichen nichts – das ist keine Glückssache, sondern eine Rechenfrage. Die Unterschiede der beiden Szenarien aus der Abbildung oben lassen sich auch auf der Plattform APIYI apiyi.com mit derselben Eingabeaufforderung reproduzieren; in zwei Minuten sieht man das Vergleichsergebnis.
Wird es teurer, wenn man max_tokens erhöht?
Viele trauen sich nicht, max_tokens zu erhöhen, aus Angst vor einer explodierenden Rechnung. Dazu gibt es eine wichtige Aussage in der Dokumentation: max_tokens ist eine Obergrenze, kein tatsächlicher Verbrauch; abgerechnet wird nach den tatsächlich generierten Tokens.
Anders gesagt: max_tokens von 300 auf 2000 zu erhöhen bedeutet nicht, dass jeder Aufruf mit 2000 abgerechnet wird. Es wird abgerechnet, wie viel das Denken verbraucht und wie viel der Antworttext geschrieben hat; der nicht ausgeschöpfte Teil der Obergrenze verursacht keine Kosten. Das Erhöhen der Obergrenze dient im Kern dazu, dem Antworttext Überlebensraum zu geben, nicht dazu, eine größere Ausgabe im Voraus zu bezahlen. APIYI apiyi.com nutzt ein nutzungsbasiertes Abrechnungsmodell; die konkreten Einzelpreise sind der Preisseite der Plattform zu entnehmen, in diesem Artikel werden keine konkreten Zahlen genannt.
gpt-6.1-sol FAQ zu häufigen Problemen mit leerem Antworttext
Q1: Was ist der leere Antworttext bei gpt-6.1-sol?
Beim Aufruf von `gpt-6.1-sol` teilen sich Denkprozess und Antworttext dasselbe `max_tokens`-Budget. Das Denken verbraucht das Budget zuerst, der Antworttext wird dadurch komplett abgeschnitten – das Ergebnis ist leer. In der in der Dokumentation genannten Zahlenreihe sind die 300 `completion_tokens` vollständig `reasoning_tokens`, die `text_tokens` betragen 0.
Q2: Gilt HTTP 200 ebenfalls als Anomalie?
Ja. Laut Dokumentation zeigt sich ein leerer Antworttext auf zwei Weisen: entweder über den Fehlercode `empty_response` oder über HTTP 200, wobei `message.content` dann ein leerer String ist. Ein erfolgreicher Statuscode bedeutet nicht, dass der Inhalt in Ordnung ist – man muss `text_tokens` und `finish_reason` aus den Usage-Daten mitbewerten.
Q3: Warum bringt ein erneuter Versuch nichts?
Laut Dokumentation hilft ein Wiederholen mit demselben Prompt und demselben `max_tokens` praktisch nicht. Die Budgetverteilung ist deterministisch: Bleibt das Budget gleich, ist das Denken trotzdem zuerst am Zug. Um das Ergebnis zu ändern, muss man die Parameter ändern – nicht das Glück.
Q4: Hat das Modell etwa nicht geantwortet?
Es ist keine Verweigerung der Antwort, sondern eine Antwort ohne Budget. Ein `finish_reason` von `length` zeigt, dass das Modell durch die Obergrenze gestoppt wurde und nicht von sich aus aufgehört hat. Erhöht man `max_tokens`, erhält man für dieselbe Frage den Antworttext.
Q5: Bei welchen Einstellungen passiert das am ehesten?
Laut Dokumentation: Setzt man `max_tokens` auf etwa 200 bis 500 und erfordert die Aufgabe zugleich Reasoning, wird das Budget bereits in der Denkphase aufgebraucht. Dieser Bereich mag für normale Chat-Modelle ausreichen, für Reasoning-Modelle wie `gpt-6.1-sol` reicht er oft nicht einmal für einen Entwurf.
Q6: Wie prüft man schnell, ob die Korrektur wirkt?
Empfohlen ist ein Vergleichstest auf APIYI apiyi.com: Konto registrieren und kostenloses Testkontingent abholen, als Endpunkt `https://api.apiyi.com/v1` eintragen, Modell `gpt-6.1-sol` wählen, dann:
1. Denselben Prompt verwenden und `max_tokens` auf 2000 setzen, dann erneut senden
2. Prüfen, ob `text_tokens` größer als 0 ist
3. Prüfen, ob `message.content` Antworttext enthält
Vergleich auf derselben Plattform mit demselben Prompt: Es gibt nur eine Variable, die Schlussfolgerung ist am saubersten.
Q7: Erhöht ein größeres max_tokens die Kosten?
Es wird nicht die Obergrenze berechnet. Laut Dokumentation ist `max_tokens` eine Obergrenze und kein tatsächlicher Verbrauch – abgerechnet wird nach den real generierten Tokens. Was Denken plus Antworttext tatsächlich erzeugen, wird auch berechnet; der genaue Preis steht auf der Preisseite von APIYI.
Q8: Tritt das auch bei Nicht-Reasoning-Modellen auf?
Laut Dokumentation kommt ein leerer Antworttext bei Nicht-Reasoning-Modellen nicht vor. Da es keine Denkphase gibt, steht das gesamte `max_tokens` dem Antworttext zur Verfügung; bei kleinem Budget wird die Antwort lediglich gekürzt statt komplett leer. Das ist auch ein Kriterium dafür, ob ein Modellwechsel sinnvoll ist.
gpt-6.1-sol leerer Antworttext: die wichtigsten Erkenntnisse
- Ursache des leeren Antworttexts: Denken und Antworttext teilen sich
max_tokens– das Denken verbraucht das Budget zuerst - Erkennungssignatur:
completion_tokensentsprichtreasoning_tokens,text_tokensist 0 - Zwei Erscheinungsformen: Fehlercode
empty_responseoder HTTP 200 mit leerem String - Bevorzugte Lösung: ab 2000 für normale Unterhaltungen, über 16000 für komplexes Reasoning und lange Texte
- Leichtgewichtige Alternative:
reasoning_effortverringern, um den Denkverbrauch zu reduzieren - Keine vergeblichen Versuche: Ein erneuter Versuch mit denselben Parametern bringt praktisch nichts
- Abrechnungslogik:
max_tokensist die Obergrenze, abgerechnet wird nach der tatsächlichen Generierung
Zusammenfassung
Die Kernpunkte zum leeren Antworttext bei gpt-6.1-sol sind im Rückblick eigentlich ganz klar:
- Ursache: Denken und Antworttext teilen sich
max_tokens– die 300er-Werte sind komplettreasoning_tokens,text_tokensist 0,finish_reasonistlength. - Behebung:
max_tokenserhöhen (ab 2000 für normale Unterhaltungen, über 16000 für komplexes Reasoning) oderreasoning_effortverringern; ein erneuter Versuch mit den ursprünglichen Parametern bringt praktisch nichts. - Abrechnung:
max_tokensist eine Obergrenze, kein Verbrauch – abgerechnet wird nach den tatsächlich generierten Tokens, eine höhere Grenze ist also kein Grund zur Sorge.
Wenn dir das nächste Mal „API-Aufruf erfolgreich, aber Antworttext leer“ begegnet, schau zuerst ins usage und dann auf finish_reason – meist lässt sich das in zehn Sekunden eingrenzen. Zum schnellen Verifizieren des Fixes empfiehlt sich APIYI auf apiyi.com: Die Plattform bietet kostenloses Testguthaben und eine einheitliche Schnittstelle für mehrere Modelle, sodass du mit einer einzigen Parameteränderung sofort vergleichen kannst.
Referenzen
- APIYI-Dokumentationszentrum: Erläuterung zur leeren Antwort bei Reasoning-Modellen
- Link:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
Beschreibung: Ursprüngliche Aufzeichnung der Ursachen für leere Antworttexte, der beiden Erscheinungsformen und der Lösungsansätze
-
APIYI-Dokumentations-Update: Fallbeispiel für leeren Antworttext bei gpt-6.1-sol (2026-11)
- Link:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - Beschreibung: Quelle für die Zahlenreihe mit
completion_tokens300 und den empfohlenen Wert fürmax_tokens
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com