作者注:gpt-6.1-sol 調用成功卻拿到空正文?文檔記載 completion_tokens 300 全部是 reasoning_tokens,正文一個字沒寫,本文講清原因與兩個解法。
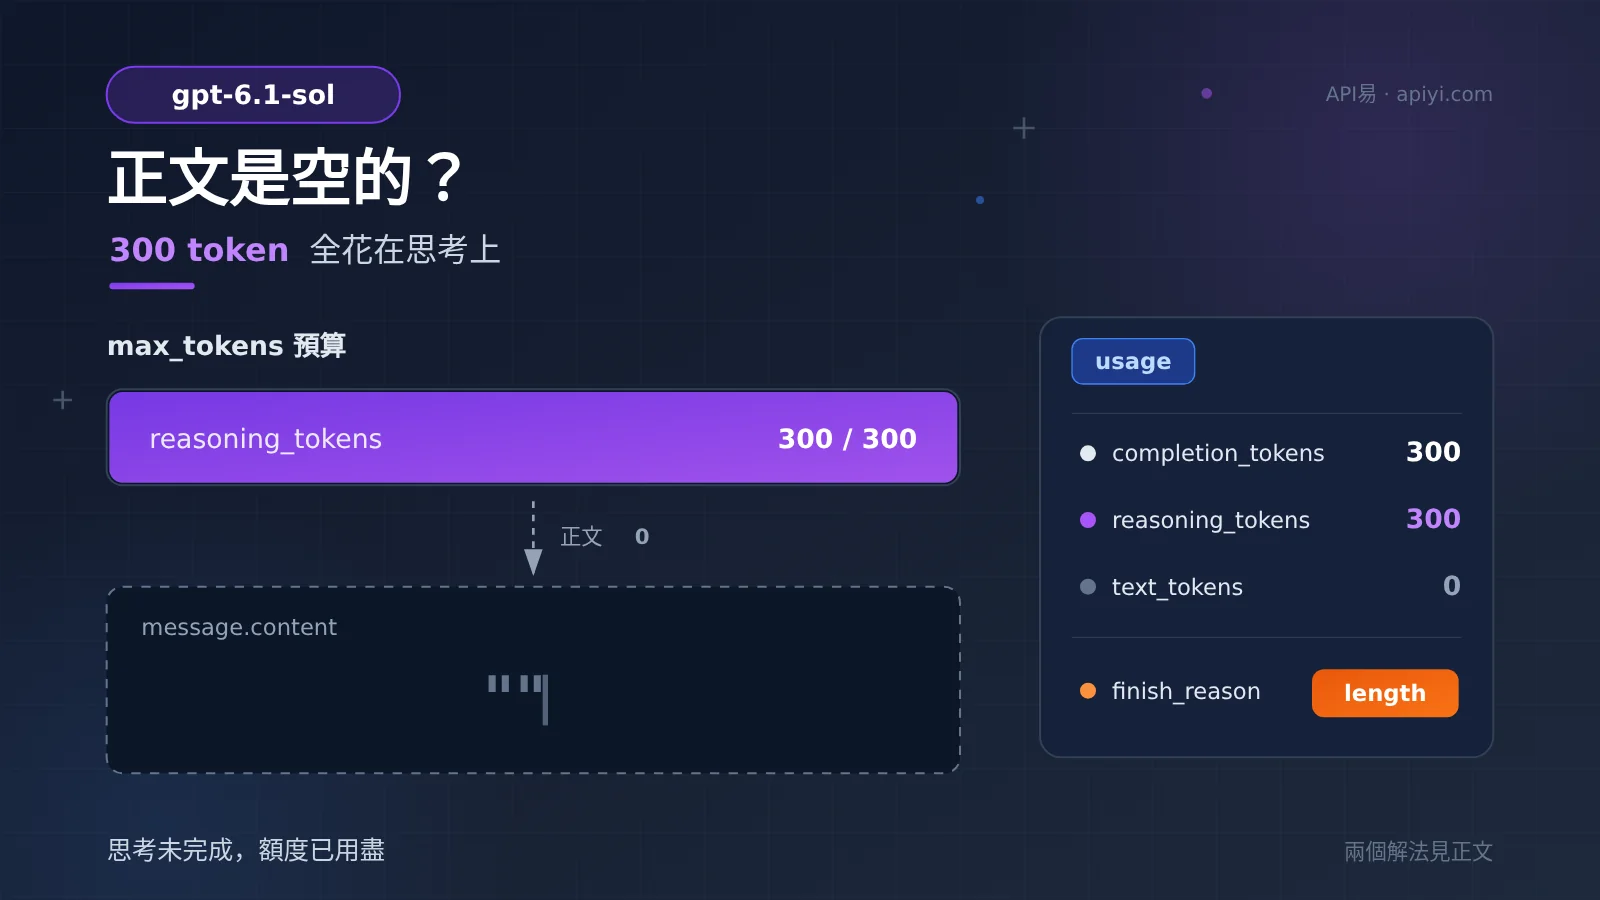
如果你剛調用完 gpt-6.1-sol,接口沒報錯,拿到的 message.content 卻是一個空字符串,先別急着懷疑網絡或者模型壞了。翻一下響應裏的 usage:completion_tokens 是 300,reasoning_tokens 也是 300,text_tokens 是 0。也就是說,這 300 個 token 全部花在了思考上,正文一個字都沒寫。
這不是偶發的玄學問題,也不是模型在偷懶。文檔記載,gpt-6.1-sol 的思考過程和最終正文共用同一個 max_tokens 額度,思考還沒寫完、額度先用完時,正文會被整體截斷。不少在 API易(apiyi.com)上調用 gpt-6.1-sol 的開發者,第一次遇到這個現象時,都以爲是平臺出了故障。
這不是又一篇泛泛的推理模型科普,而是一篇針對“正文是空的”這個具體症狀的排查指南。讀完本文,你能看懂 usage 裏那組數字在說什麼,並且用兩個參數層面的改動,讓正文正常吐出來。
gpt-6.1-sol 空正文的核心要點
先給結論,細節後面展開。文檔記載的幾條關鍵信息,決定了你接下來該怎麼排查:
| 要點 | 文檔記載的說明 | 對你的價值 |
|---|---|---|
| 思考與正文共用額度 | gpt-6.1-sol 的推理過程和最終回答都從 max_tokens 里扣 |
理解空正文的根源 |
| 300 token 全在思考 | completion_tokens 300 等於 reasoning_tokens 300,text_tokens 爲 0 |
一眼判斷問題類型 |
| 兩種外在表現 | 報 empty_response 錯誤碼,或 HTTP 200 但正文爲空字符串 |
不被“假成功”迷惑 |
| 重試基本無效 | 同樣的提示詞、同樣的 max_tokens,再發一次結果差不多 |
少走彎路 |
這 300 token 都花在了哪裏
要理解空正文,得先理解 gpt-6.1-sol 的回答方式。它屬於推理模型:正式動筆之前,會先在內部“打草稿”——拆解問題、嘗試路徑、自我檢查。這份草稿,就是 reasoning_tokens 記賬的部分。
關鍵在於,文檔記載,草稿和正文不是兩份獨立額度,而是共用同一個 max_tokens。當 max_tokens 設在大約 200 到 500 的區間、任務又確實需要推理時,額度很容易在思考階段就被用光:思考還沒寫完,正文還沒開始,額度先見了底。返回給你的,自然是一段空白的正文。
文檔裏的那組數字說得非常直白:
completion_tokens:300——本次完成的全部生成量reasoning_tokens:300——其中花在思考上的部分text_tokens:0——真正寫給正文的部分finish_reason:length——停止原因是撞到長度上限,而不是正常收尾
completion_tokens 與 reasoning_tokens 完全相等,text_tokens 歸零,這幾乎就是“額度全被思考喫掉”的標準簽名。再配合 finish_reason 爲 length,可以確認模型不是“不想答”,而是“沒額度答”。本次撞到的上限,也正好落在文檔說的 200 到 500 這個易耗盡區間之內。
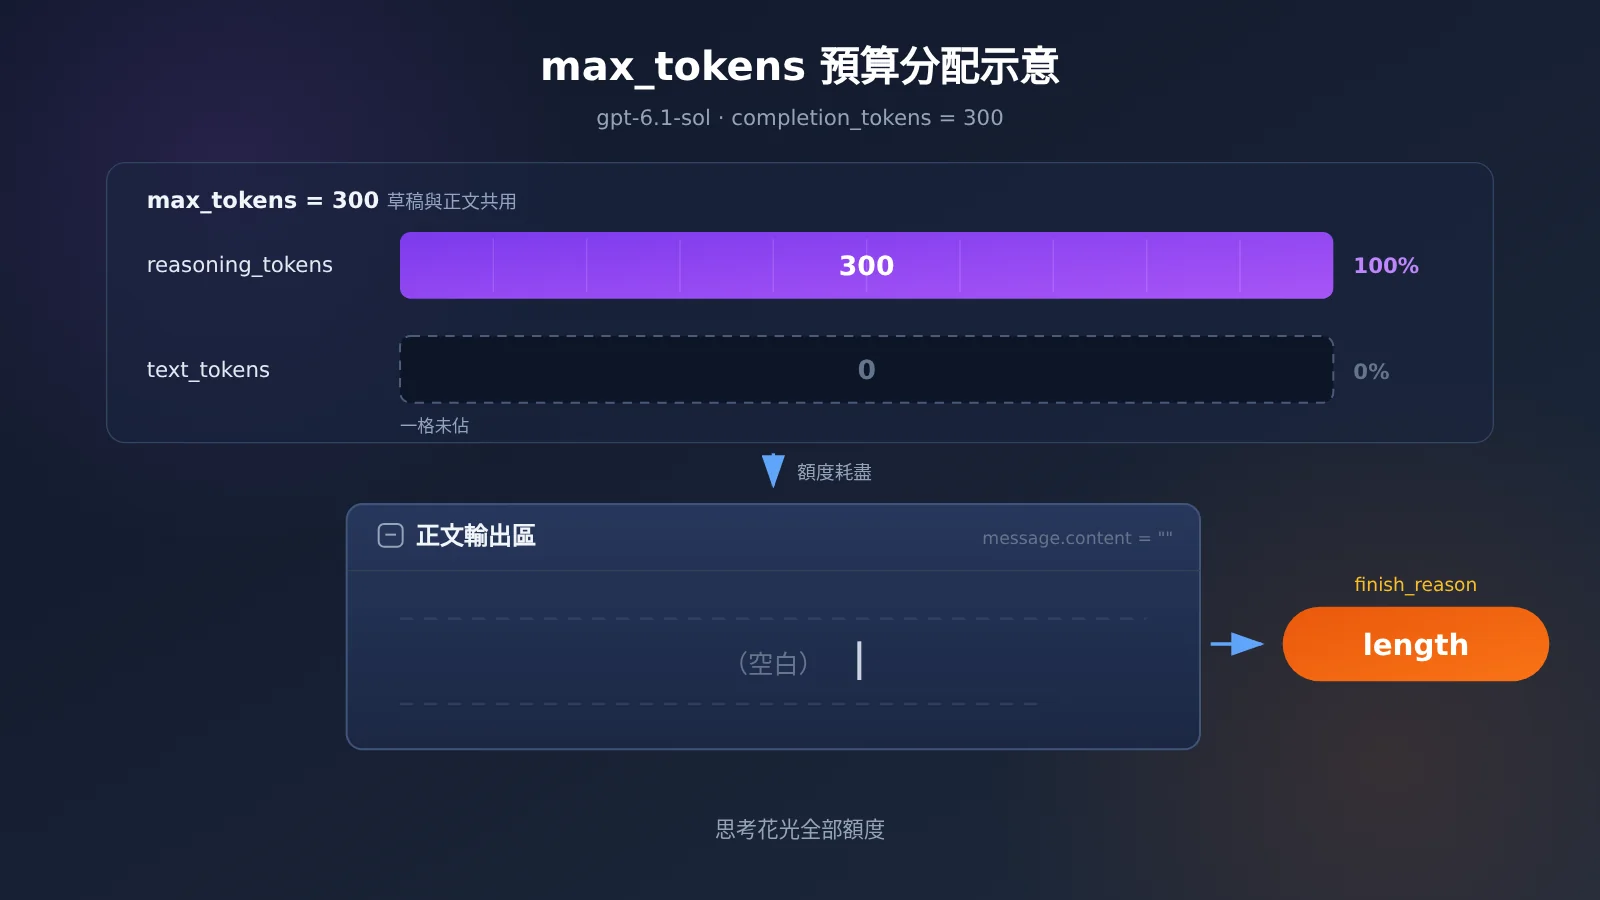
上圖描述的就是這次調用的預算分配方式。字段含義的完整原文收錄在 API易 文檔中心,建議對照原文再確認一遍細節,避免憑印象改參數。
空正文的兩種外在表現
同一個原因,在接口層面有兩種表現,文檔都做了記載。一種是直接報錯,返回錯誤碼 empty_response,請求被明確標記爲異常。另一種是“假成功”,HTTP 200,一切看起來正常,但 message.content 是空字符串。
第二種更容易誤導人。狀態碼是成功的,耗時也正常,不翻 usage 根本發現不了正文是空的。所以遇到“接口成功但內容爲空”,第一反應應該是查 usage,而不是查網絡。
| 外在表現 | 返回內容 | 判斷依據 |
|---|---|---|
| 直接報錯 | 錯誤碼 empty_response |
一眼可見 |
| 假成功 | HTTP 200,message.content 爲空字符串 |
需要檢查 usage 與 finish_reason |
如何確認 gpt-6.1-sol 空正文的原因
排查不復雜,四步就夠,順序建議從 usage 查起:
- 看
completion_tokens與reasoning_tokens是否相等。相等說明生成量全部用於思考,正文沒有分到任何額度。 - 看
text_tokens是否爲 0。歸零說明正文一個字都沒寫,這是最直接的證據。 - 看
finish_reason是否爲length。是length而不是正常收尾,說明模型是被上限截停的。 - 回憶自己的
max_tokens設置。落在 200 到 500 區間、任務又需要推理,基本就能對號入座。
確認之後,有一件事可以立刻省掉:原樣重試。文檔記載,同樣的提示詞、同樣的 max_tokens,重試基本沒用。因爲這不是網絡抖動,而是額度分配的必然結果——再發一次,預算還是那麼多,思考還是會先把它花完。
如果你是通過聚合平臺調用 gpt-6.1-sol,排查入口通常長這樣:
- 平臺地址:API易 apiyi.com
- 接口地址:
https://api.apiyi.com/v1 - 模型名稱:
gpt-6.1-sol - 接口規範:OpenAI 兼容,參數語義與官方接口一致
建議:通過 API易 apiyi.com 獲取免費測試額度,用同一段提示詞對比不同
max_tokens下的返回,幾分鐘就能確認問題出在額度分配,而不是模型本身。
gpt-6.1-sol 空正文快速修復:調大 max_tokens 或降低 reasoning_effort
原因明確了,解法就順理成章,方向只有兩個:給正文留出空間,或者讓思考少花一點。兩個解法分別適合不同任務,別混着用。
解法一:調大 max_tokens。文檔給出的參考值是:普通對話從 2000 起,複雜推理或長文任務 16000 以上。這個量級不是隨手拍的——推理草稿本身可能就不短,正文還需要額外空間,2000 只是普通對話的起步線。
解法二:降低 reasoning_effort。如果任務不需要深度推理,比如簡單改寫、格式轉換、一句話問答,可以讓模型“少想一點”。思考階段的消耗降下來,同樣的額度也就夠用了。
| 方案 | 做法 | 適用場景 | 預期效果 |
|---|---|---|---|
調大 max_tokens |
普通對話 2000 起;複雜推理、長文 16000 以上 | 需要完整推理質量的任務 | 根治 |
降低 reasoning_effort |
調低推理強度 | 輕任務、對推理深度要求不高 | 減少思考消耗 |
| 原參數重試 | 什麼都不改再發一次 | 基本無效 | 不推薦 |
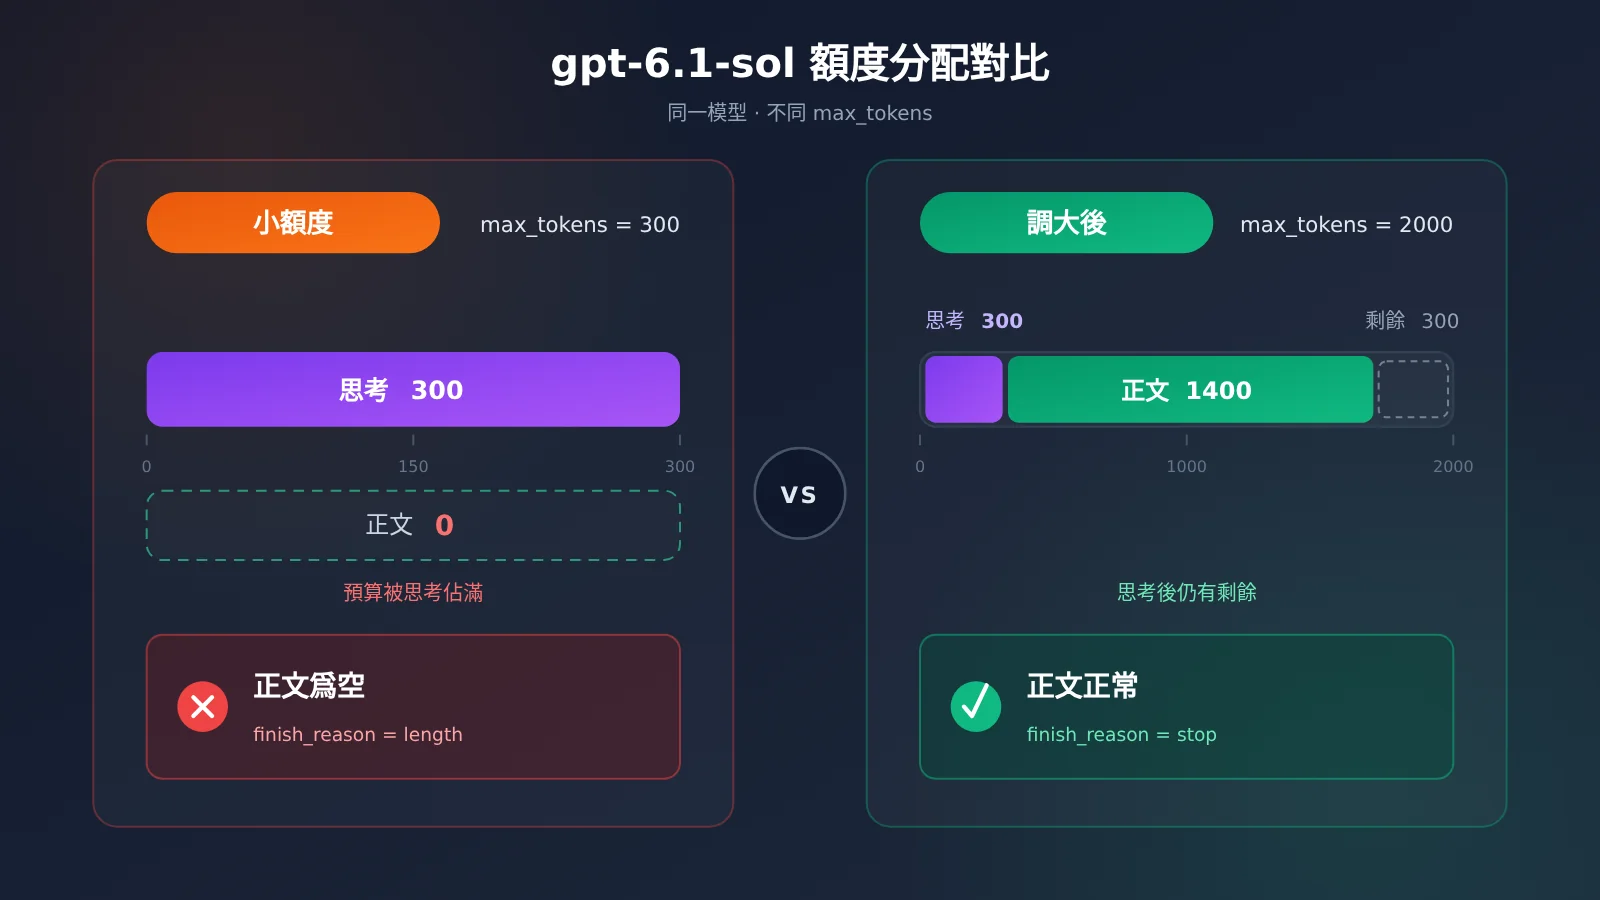
解法對比解讀
調大 max_tokens 是首選方案。它不改變模型的思考方式,只是把“草稿紙”換大,推理質量不受影響。上限調大之後,思考照常進行,正文也能分到自己的額度,text_tokens 自然不再是 0。
降低 reasoning_effort 適合另一類場景:任務本身不需要深度思考,模型卻默認跑了完整推理。調低之後思考消耗減少、響應更快,但複雜任務不建議這麼做,推理深度被壓縮可能影響答案質量。
原參數重試 單獨拎出來說,是因爲它是最常見的錯誤反應。文檔記載,同樣的提示詞、同樣的 max_tokens,重試基本沒用——這不是運氣問題,是算術問題。上圖兩種場景的差異,也可以在 API易 apiyi.com 平臺上用同一提示詞復現,兩分鐘就能看到對比結果。
調大 max_tokens 會更貴嗎
很多人不敢調大 max_tokens,是怕賬單爆炸。這裏文檔有一句關鍵說明:max_tokens 是上限,不是實際消耗,計費按實際生成的 token 計算。
換句話說,把 max_tokens 從 300 調到 2000,不代表每次調用都按 2000 收費。思考用了多少、正文寫了多少,就計多少,上限沒用完的部分不產生費用。調大上限的本質是給正文留出生存空間,而不是預付一筆更大的開支。API易 apiyi.com 採用按量計費的模式,具體單價以平臺價格頁爲準,本文不引用具體數字。
gpt-6.1-sol 空正文常見問題 FAQ
Q1:什麼是 gpt-6.1-sol 的空正文?
調用 `gpt-6.1-sol` 時,思考過程和正文共用 `max_tokens`。思考先花光額度,正文被整體截斷,結果就是空的。文檔記載的那組數字裏,`completion_tokens` 300 全部是 `reasoning_tokens`,`text_tokens` 爲 0。
Q2:HTTP 200 也算異常嗎?
算。文檔記載,空正文有兩種表現:報 `empty_response` 錯誤碼,或者 HTTP 200 但 `message.content` 是空字符串。狀態碼成功不代表內容正常,要結合 usage 裏的 `text_tokens` 和 `finish_reason` 一起判斷。
Q3:爲什麼重試沒用?
文檔記載,同樣的提示詞、同樣的 `max_tokens`,重試基本沒用。因爲額度分配是確定性的:預算不變,思考還是會先花完。想改變結果,得改參數,而不是改運氣。
Q4:是模型沒回答嗎?
不是拒絕回答,而是沒額度回答。`finish_reason` 爲 `length` 說明模型是被上限截停的,不是主動停止。把 `max_tokens` 調大後,同樣的提問就能拿到正文。
Q5:什麼樣的設置最容易踩坑?
文檔記載,`max_tokens` 設成大約 200 到 500、任務又需要推理時,就會在思考階段耗盡。這個區間對普通對話模型可能夠用,但對 `gpt-6.1-sol` 這類推理模型,往往連草稿都寫不完。
Q6:如何快速驗證修復有效?
推薦在 API易 apiyi.com 上做對比驗證:註冊賬號獲取免費測試額度,接口地址填 `https://api.apiyi.com/v1`,模型選 `gpt-6.1-sol`,然後:
1. 用同一段提示詞,`max_tokens` 調到 2000 再發一次
2. 檢查 `text_tokens` 是否大於 0
3. 檢查 `message.content` 是否有正文
同平臺同提示詞對比,變量只有一個參數,結論最乾淨。
Q7:調大 max_tokens 會增加費用嗎?
不會按上限收費。文檔記載,`max_tokens` 是上限,不是實際消耗,計費按實際生成的 token 算。思考加正文實際生成多少,就計多少,具體單價以 API易 價格頁爲準。
Q8:非推理模型也會這樣嗎?
文檔記載,非推理模型不會出現這種空正文。因爲沒有思考階段,`max_tokens` 全部留給正文,小額度的結果只是回答被截短,而不是整體爲空。這也是判斷該不該換模型的依據之一。
gpt-6.1-sol 空正文核心要點 Key Takeaways
- 空正文根源:思考與正文共用
max_tokens,思考先花光額度 - 判斷簽名:
completion_tokens等於reasoning_tokens,text_tokens爲 0 - 兩種表現:
empty_response錯誤碼,或 HTTP 200 空字符串 - 首選解法:普通對話 2000 起,複雜推理、長文 16000 以上
- 輕量替代:降低
reasoning_effort,壓縮思考消耗 - 別做無用功:同參數重試基本無效
- 計費邏輯:
max_tokens是上限,按實際生成計費
總結
gpt-6.1-sol 空正文的核心要點,回頭看其實很清晰:
- 原因:思考與正文共用
max_tokens,那組 300 的數字全是reasoning_tokens,text_tokens爲 0,finish_reason爲length。 - 修復:調大
max_tokens(普通對話 2000 起,複雜推理 16000 以上),或降低reasoning_effort;原參數重試基本無效。 - 計費:
max_tokens是上限不是消耗,按實際生成的 token 計費,調大不必心疼。
下次再遇到“接口成功但正文是空的”,先翻 usage,再看 finish_reason,基本十秒內就能定位。推薦通過 API易 apiyi.com 快速驗證修復效果,平臺提供免費測試額度和多模型統一接口,改一個參數就能立刻對比。
參考資料
- API易文檔中心:推理模型空正文說明
- 鏈接:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
說明:空正文的原因、兩種表現與解法的原始記載
-
API易文檔速遞:gpt-6.1-sol 空正文案例(2026-11)
- 鏈接:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - 說明:包含
completion_tokens300 那組數字與max_tokens建議值的出處
作者:APIYI 技術團隊
技術交流:歡迎在 APIYI 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心