Catatan penulis: pemanggilan gpt-6.1-sol berhasil tetapi malah mendapatkan isi utama kosong? Dokumentasi mencatat completion_tokens 300 semuanya adalah reasoning_tokens, isi utamanya tidak ditulis satu kata pun. Artikel ini akan menjelaskan penyebabnya dan dua solusinya.
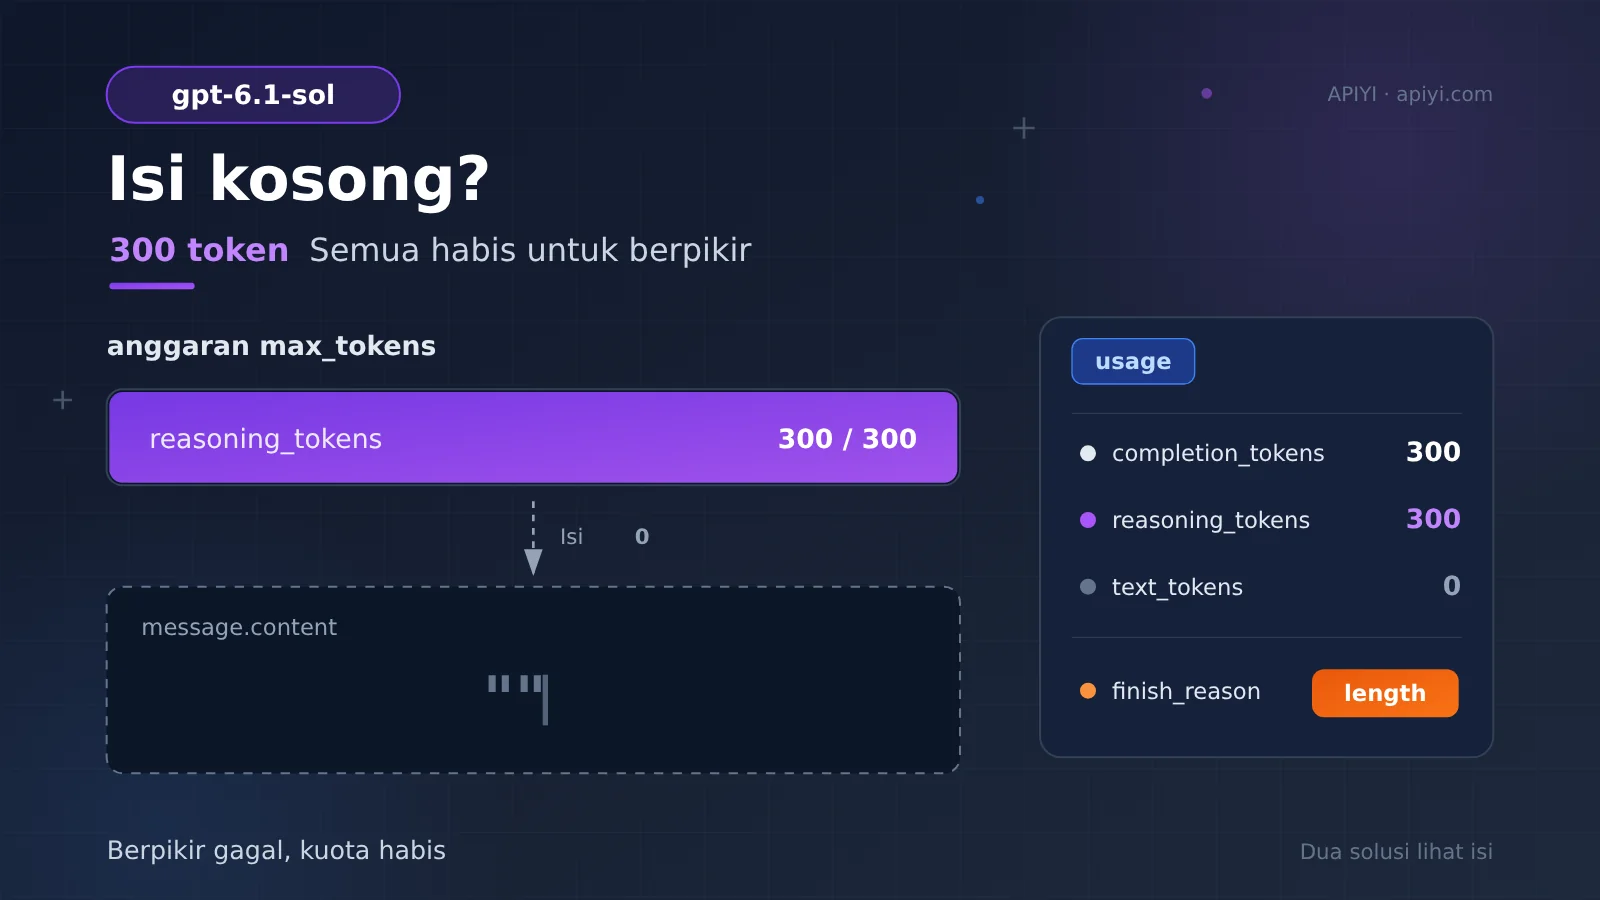
Jika kamu baru saja memanggil gpt-6.1-sol, antarmuka tidak melaporkan error, tetapi message.content yang kamu dapatkan justru berupa string kosong, jangan buru-buru mencurigai jaringan atau modelnya rusak. Coba periksa usage di respons: completion_tokens bernilai 300, reasoning_tokens juga 300, dan text_tokens bernilai 0. Artinya, 300 token itu semuanya habis untuk proses berpikir, sementara isi utamanya tidak ditulis sama sekali.
Ini bukan masalah mistis yang muncul sesekali, dan bukan pula model yang sedang malas. Menurut dokumentasi, proses berpikir dan isi utama gpt-6.1-sol berbagi kuota max_tokens yang sama. Ketika proses berpikir belum selesai tetapi kuota sudah habis lebih dulu, isi utama akan terpotong seluruhnya. Banyak pengembang yang memanggil gpt-6.1-sol di APIYI (apiyi.com) dan pertama kali mengalami fenomena ini langsung mengira platformnya bermasalah.
Ini bukan artikel pengenalan model penalaran yang serba umum, melainkan panduan diagnosis untuk gejala spesifik “isi utama kosong”. Setelah membaca artikel ini, kamu akan paham maksud deretan angka di usage, dan lewat dua perubahan pada level parameter, kamu bisa membuat isi utama keluar dengan normal.
Poin-poin inti body kosong gpt-6.1-sol
Kesimpulan dulu, detailnya menyusul. Beberapa informasi kunci yang tercatat di dokumentasi inilah yang menentukan cara kamu melakukan penelusuran berikutnya:
| Poin | Penjelasan dalam dokumentasi | Nilai bagimu |
|---|---|---|
| Berpikir dan body berbagi jatah yang sama | Proses penalaran dan jawaban akhir gpt-6.1-sol sama-sama dipotong dari max_tokens |
Memahami akar masalah body kosong |
| 300 token semuanya di bagian berpikir | completion_tokens 300 sama dengan reasoning_tokens 300, text_tokens bernilai 0 |
Sekilas bisa menentukan jenis masalahnya |
| Dua manifestasi luar | Mengembalikan kode error empty_response, atau HTTP 200 tetapi body berupa string kosong |
Agar tidak tertipu “sukses palsu” |
| Percobaan ulang praktis tidak berguna | Petunjuk yang sama, max_tokens yang sama, dikirim sekali lagi hasilnya kurang lebih sama |
Menghindari jalan yang tidak perlu |
300 token ini habis di mana
Untuk memahami body kosong, kita harus lebih dulu memahami cara gpt-6.1-sol menjawab. Ia termasuk model penalaran: sebelum resmi mulai menulis, ia akan lebih dulu “membuat draf” di internal—menguraikan masalah, mencoba berbagai jalur, memeriksa diri sendiri. Draf inilah bagian yang dicatat oleh reasoning_tokens.
Kuncinya, dokumentasi mencatat bahwa draf dan body bukan dua kuota terpisah, melainkan berbagi satu max_tokens yang sama. Ketika max_tokens diatur di kisaran sekitar 200 sampai 500, sementara tugasnya memang menuntut penalaran, kuota mudah sekali habis di tahap berpikir: pikiran belum selesai ditulis, body belum dimulai, kuota sudah habis lebih dulu. Yang dikembalikan kepadamu, tentu saja body yang kosong.
Sekelompok angka dalam dokumentasi itu berbicara sangat gamblang:
completion_tokens: 300—seluruh jumlah generasi yang selesai pada pemanggilan inireasoning_tokens: 300—bagian dari itu yang dihabiskan untuk berpikirtext_tokens: 0—bagian yang benar-benar ditulis ke bodyfinish_reason:length—alasan berhenti adalah menabrak batas panjang, bukan berakhir normal
completion_tokens dan reasoning_tokens sepenuhnya sama, text_tokens nol, ini hampir bisa dibilang “tanda tangan standar” dari “kuota habis dimakan berpikir”. Ditambah lagi finish_reason bernilai length, bisa dipastikan model bukan “tidak mau menjawab”, melainkan “tidak punya kuota untuk menjawab”. Batas yang ditabrak kali ini pun tepat berada dalam rentang 200 sampai 500 yang mudah habis, seperti disebutkan dokumentasi.
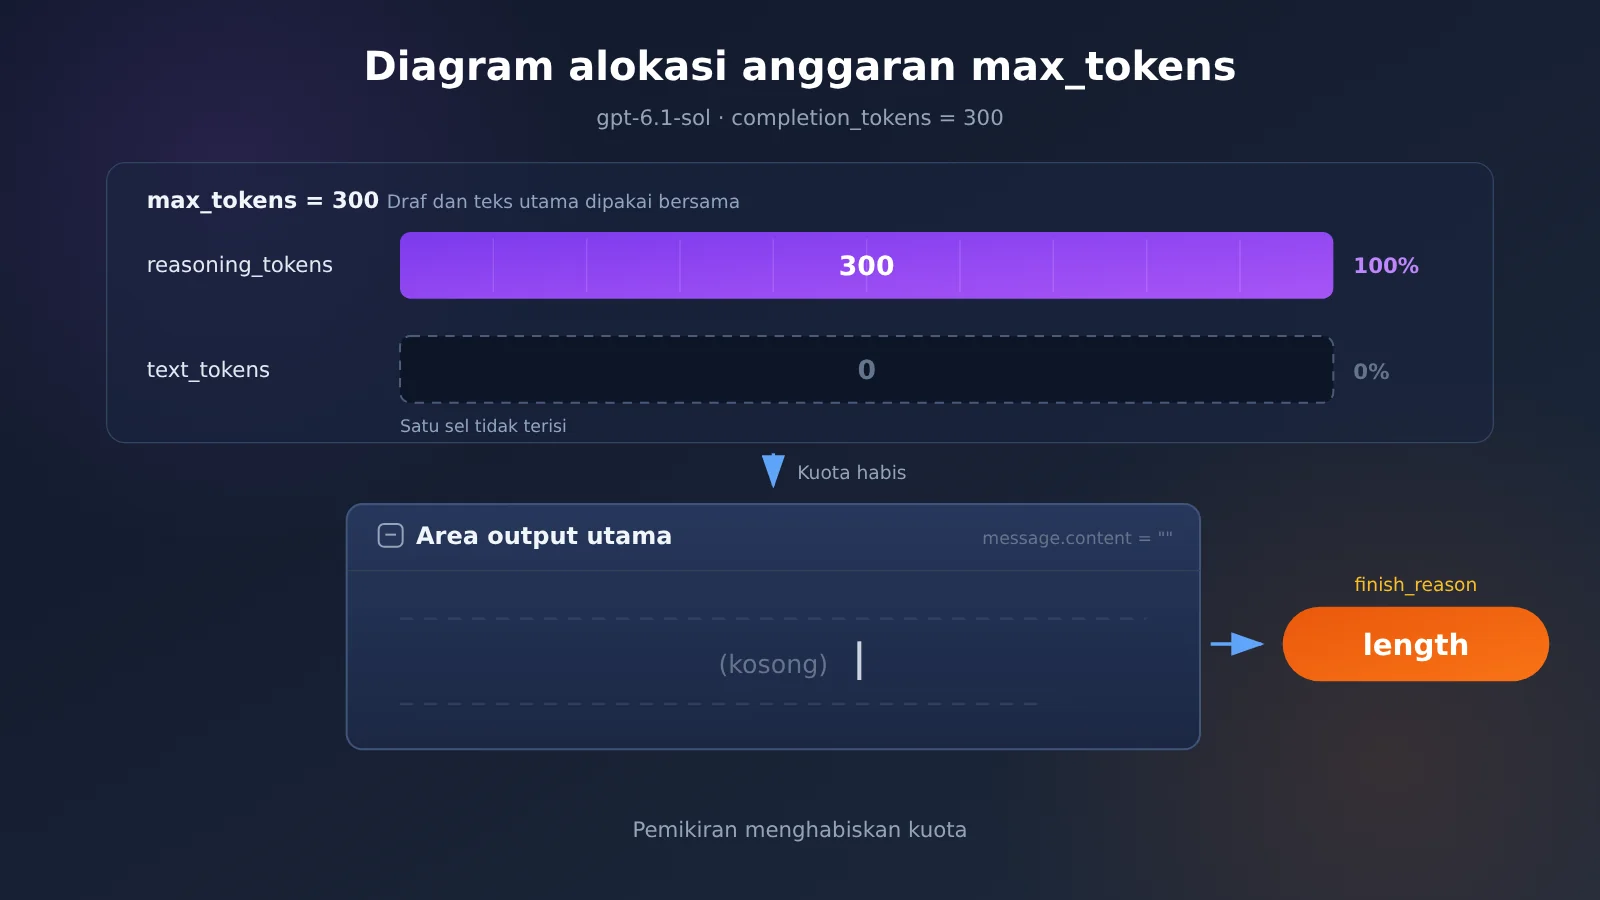
Gambar di atas menggambarkan cara alokasi anggaran pada pemanggilan kali ini. Teks lengkap arti setiap field tercatat di pusat dokumentasi APIYI, sebaiknya bandingkan dengan teks aslinya untuk memastikan detailnya sekali lagi, supaya tidak mengubah parameter hanya berdasarkan kesan.
Dua manifestasi luar dari body kosong
Penyebab yang sama, di tingkat antarmuka punya dua manifestasi, keduanya tercatat dalam dokumentasi. Satu adalah langsung error, mengembalikan kode error empty_response, permintaan secara jelas ditandai sebagai anomali. Yang lain adalah “sukses palsu”, HTTP 200, semuanya tampak normal, tetapi message.content berupa string kosong.
Yang kedua lebih mudah menyesatkan. Kode statusnya sukses, durasinya juga normal, tanpa memeriksa usage sama sekali tidak akan ketahuan body-nya kosong. Jadi ketika menghadapi “antarmuka sukses tetapi konten kosong”, reaksi pertama seharusnya memeriksa usage, bukan memeriksa jaringan.
| Manifestasi luar | Isi yang dikembalikan | Dasar penilaian |
|---|---|---|
| Error langsung | Kode error empty_response |
Terlihat sekilas |
| Sukses palsu | HTTP 200, message.content berupa string kosong |
Perlu memeriksa usage dan finish_reason |
Cara memastikan penyebab badan respons kosong pada gpt-6.1-sol
Diagnosisnya tidak rumit, cukup empat langkah, dan sebaiknya dimulai dari data usage:
- Periksa apakah
completion_tokensdanreasoning_tokenssama besar. Jika sama, artinya seluruh kuota generasi dipakai untuk berpikir, dan badan respons tidak mendapat jatah sama sekali. - Periksa apakah
text_tokensbernilai 0. Jika nol, berarti tidak ada satu kata pun yang ditulis di badan respons—ini bukti paling langsung. - Periksa apakah
finish_reasonbernilailength. Kalaulengthdan bukan penutupan normal, berarti model dihentikan oleh batas maksimum. - Ingat-ingat pengaturan
max_tokensAnda. Jika nilainya di rentang 200 sampai 500 dan tugasnya butuh penalaran, kemungkinan besar inilah penyebabnya.
Setelah terkonfirmasi, ada satu hal yang bisa langsung dihemat: mengulang percobaan dengan cara yang sama. Menurut dokumentasi, dengan petunjuk yang sama dan max_tokens yang sama, mengulang percobaan hampir tidak berguna. Sebab ini bukan gangguan jaringan, melainkan konsekuensi pasti dari alokasi kuota—kirim sekali lagi, anggarannya tetap sama, dan proses berpikir tetap akan menghabiskannya lebih dulu.
Kalau Anda memanggil gpt-6.1-sol lewat platform agregator, pintu masuk diagnosisnya biasanya seperti ini:
- Alamat platform: APIYI apiyi.com
- Alamat API:
https://api.apiyi.com/v1 - Nama model:
gpt-6.1-sol - Spesifikasi API: kompatibel dengan OpenAI, semantik parameter sama dengan API resmi
Saran: Dapatkan kuota uji gratis melalui APIYI apiyi.com, lalu bandingkan respons dengan
max_tokensyang berbeda menggunakan petunjuk yang sama. Dalam beberapa menit Anda sudah bisa memastikan masalahnya ada di alokasi kuota, bukan pada model itu sendiri.
Perbaikan cepat isi kosong gpt-6.1-sol: naikkan max_tokens atau turunkan reasoning_effort
Penyebabnya sudah jelas, solusinya pun masuk akal. Hanya ada dua arah: beri ruang untuk isi respons, atau buat proses berpikir lebih hemat. Kedua solusi cocok untuk tugas yang berbeda, jangan dicampur.
Solusi pertama: naikkan max_tokens. Nilai referensi dari dokumentasi: percakapan biasa mulai dari 2000, tugas penalaran kompleks atau teks panjang 16000 ke atas. Angka ini bukan asal tebak—draf penalaran sendiri bisa cukup panjang, isi respons masih butuh ruang tambahan, dan 2000 hanyalah garis awal untuk percakapan biasa.
Solusi kedua: turunkan reasoning_effort. Jika tugas tidak membutuhkan penalaran mendalam, misalnya parafrase sederhana, konversi format, atau tanya jawab satu kalimat, model bisa diminta “berpikir lebih sedikit”. Konsumsi tahap berpikir turun, dan kuota yang sama jadi cukup.
| Opsi | Cara | Skenario penggunaan | Hasil yang diharapkan |
|---|---|---|---|
Naikkan max_tokens |
Percakapan biasa mulai 2000; penalaran kompleks, teks panjang 16000 ke atas | Tugas yang membutuhkan kualitas penalaran penuh | Mengatasi akar masalah |
Turunkan reasoning_effort |
Turunkan intensitas penalaran | Tugas ringan, tidak menuntut kedalaman penalaran | Mengurangi konsumsi berpikir |
| Ulangi dengan parameter awal | Kirim ulang tanpa mengubah apa pun | Praktis tidak efektif | Tidak disarankan |
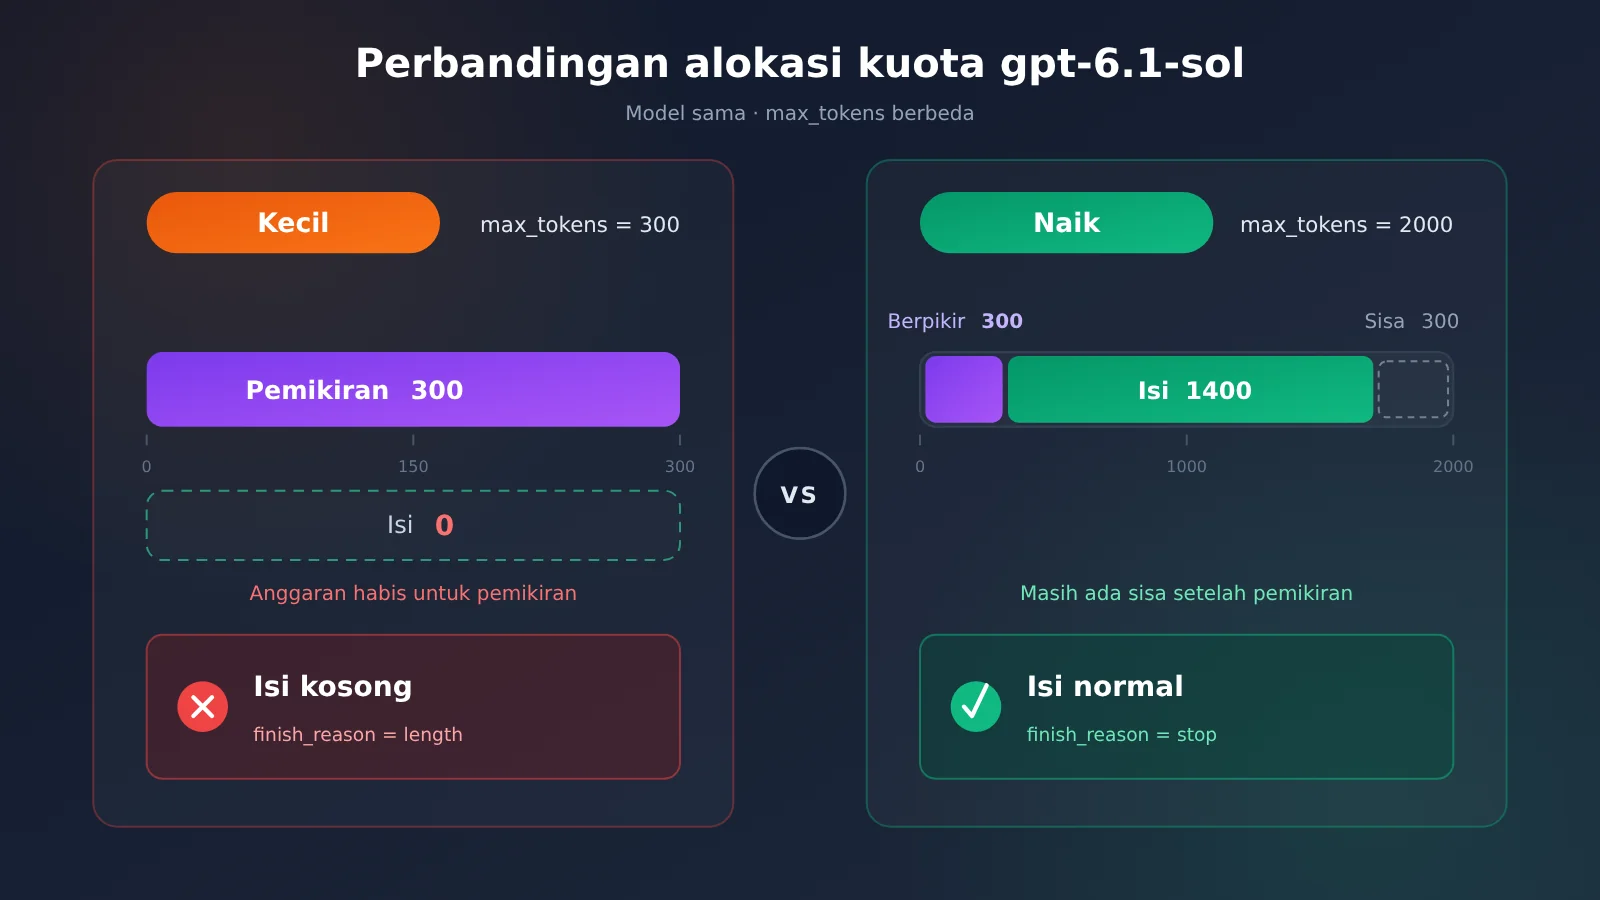
Penjelasan perbandingan solusi
Naikkan max_tokens adalah pilihan utama. Ini tidak mengubah cara model berpikir, hanya memperbesar “kertas coretan”, sehingga kualitas penalaran tidak terpengaruh. Setelah batas atas dinaikkan, penalaran berjalan seperti biasa, isi respons juga mendapat jatahnya sendiri, dan text_tokens otomatis tidak lagi 0.
Turunkan reasoning_effort cocok untuk jenis tugas lain: tugasnya sendiri tidak membutuhkan pemikiran mendalam, tetapi model secara default menjalankan penalaran penuh. Setelah diturunkan, konsumsi berpikir berkurang dan respons lebih cepat, tetapi untuk tugas kompleks cara ini tidak disarankan karena kedalaman penalaran yang tertekan dapat memengaruhi kualitas jawaban.
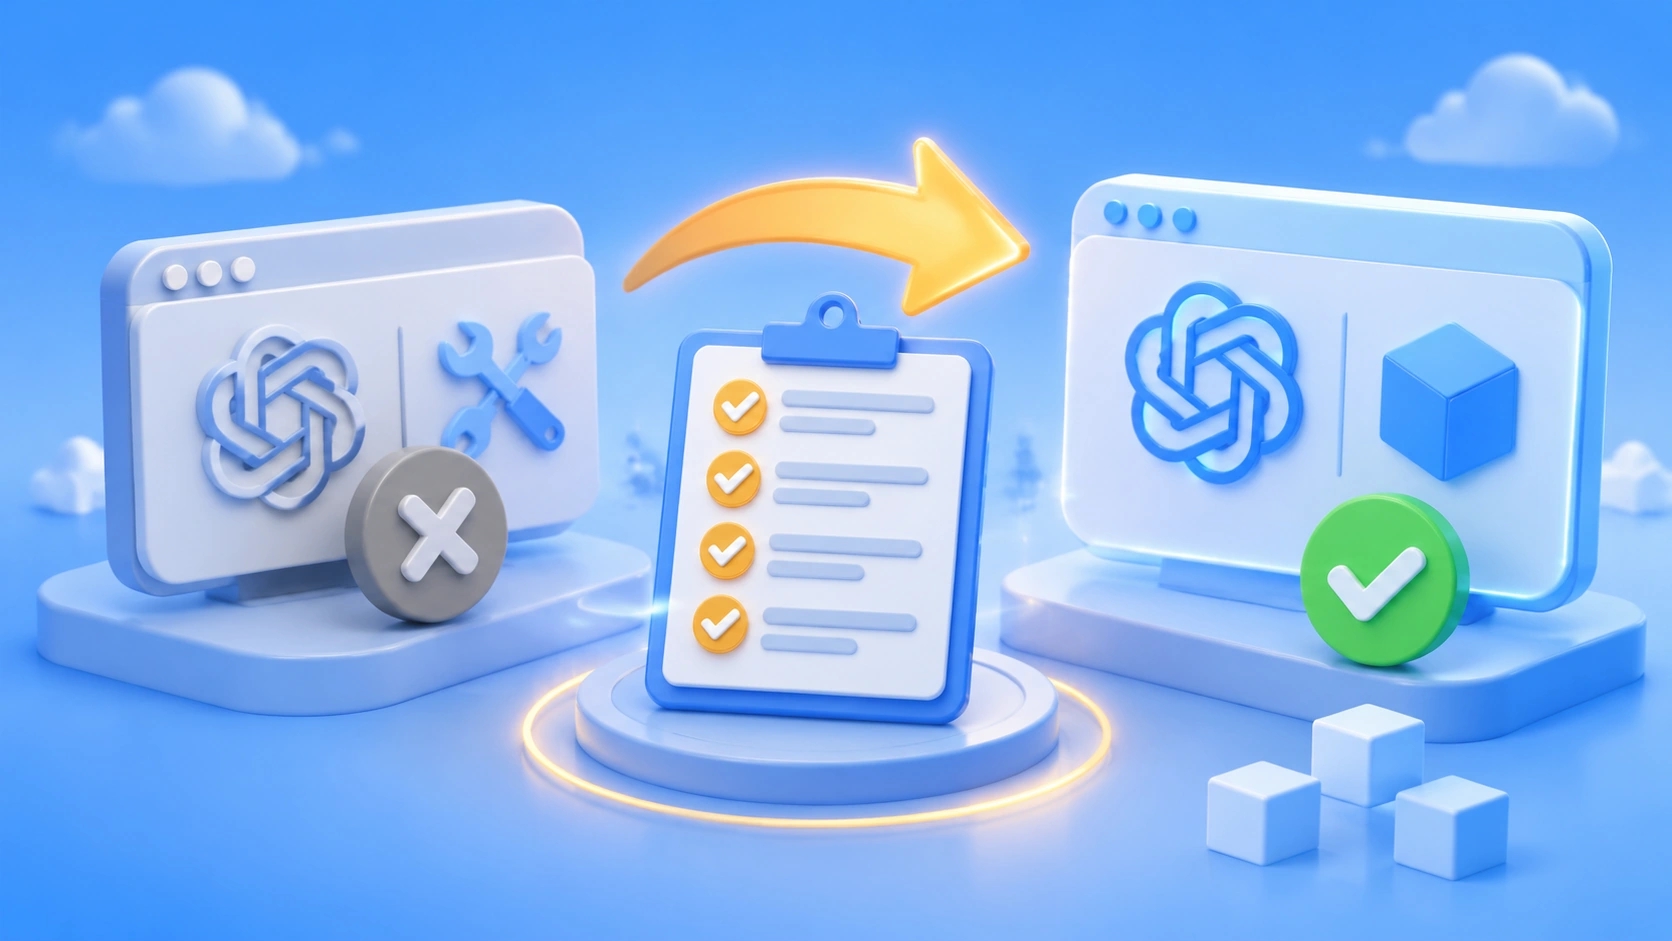
Mengulang dengan parameter awal dibahas terpisah karena inilah reaksi keliru yang paling umum. Dokumentasi mencatat bahwa dengan petunjuk yang sama dan max_tokens yang sama, mengulang praktis tidak berguna—ini bukan masalah keberuntungan, melainkan masalah aritmetika. Perbedaan dua skenario pada gambar di atas juga bisa direproduksi di platform APIYI apiyi.com menggunakan petunjuk yang sama, dan hasil perbandingannya bisa terlihat dalam dua menit.
Apakah menaikkan max_tokens membuat biaya lebih mahal
Banyak orang tidak berani menaikkan max_tokens karena takut tagihan meledak. Di sini dokumentasi punya penjelasan penting: max_tokens adalah batas atas, bukan konsumsi aktual; biaya dihitung berdasarkan token yang benar-benar dihasilkan.
Dengan kata lain, menaikkan max_tokens dari 300 ke 2000 tidak berarti setiap pemanggilan ditagih sebesar 2000. Berapa banyak yang dipakai untuk berpikir dan berapa banyak isi yang ditulis, itulah yang dihitung; bagian batas atas yang tidak terpakai tidak menimbulkan biaya. Menaikkan batas atas pada dasarnya adalah memberi ruang hidup untuk isi respons, bukan membayar di muka pengeluaran yang lebih besar. APIYI apiyi.com menggunakan model penagihan sesuai pemakaian; harga satuan spesifik mengikuti halaman harga platform, dan artikel ini tidak mencantumkan angka konkret.
FAQ Umum: Konten Kosong pada gpt-6.1-sol
Q1: Apa itu konten kosong pada gpt-6.1-sol?
Saat memanggil `gpt-6.1-sol`, proses berpikir dan isi jawaban sama-sama menggunakan jatah `max_tokens`. Proses berpikir menghabiskan kuota lebih dulu, isi jawaban terpotong seluruhnya, dan hasilnya kosong. Pada angka yang tercatat di dokumentasi, `completion_tokens` sebesar 300 seluruhnya adalah `reasoning_tokens`, sedangkan `text_tokens` bernilai 0.
Q2: Apakah HTTP 200 juga termasuk anomali?
Iya. Menurut dokumentasi, konten kosong punya dua bentuk: muncul kode error `empty_response`, atau HTTP 200 tetapi `message.content` berupa string kosong. Status code yang sukses belum tentu berarti kontennya normal, jadi perlu dinilai bersama `text_tokens` dan `finish_reason` di dalam usage.
Q3: Kenapa mencoba ulang tidak membantu?
Dokumentasi mencatat bahwa dengan petunjuk yang sama dan `max_tokens` yang sama, percobaan ulang hampir tidak berguna. Sebab alokasi kuota bersifat deterministik: kalau anggarannya tidak berubah, proses berpikir tetap akan menghabiskannya lebih dulu. Untuk mengubah hasil, yang perlu diubah adalah parameternya, bukan keberuntungan.
Q4: Apakah modelnya tidak menjawab?
Bukan menolak menjawab, melainkan tidak punya kuota untuk menjawab. `finish_reason` bernilai `length` menandakan model dihentikan oleh batas maksimum, bukan berhenti atas kemauan sendiri. Setelah `max_tokens` diperbesar, pertanyaan yang sama bisa menghasilkan isi jawaban.
Q5: Pengaturan seperti apa yang paling rawan bermasalah?
Dokumentasi mencatat, jika `max_tokens` diatur sekitar 200 sampai 500 sementara tugasnya membutuhkan penalaran, kuota akan habis di tahap berpikir. Rentang ini mungkin cukup untuk model percakapan biasa, tetapi untuk model penalaran seperti `gpt-6.1-sol`, sering kali bahkan drafnya belum selesai ditulis.
Q6: Bagaimana cara cepat memverifikasi bahwa perbaikan berhasil?
Disarankan melakukan verifikasi pembanding di APIYI apiyi.com: daftarkan akun untuk mendapatkan kuota uji gratis, isi alamat endpoint dengan `https://api.apiyi.com/v1`, pilih model `gpt-6.1-sol`, lalu:
1. Gunakan petunjuk yang sama, atur `max_tokens` menjadi 2000 lalu kirim sekali lagi
2. Periksa apakah `text_tokens` lebih besar dari 0
3. Periksa apakah `message.content` berisi isi jawaban
Membandingkan di platform yang sama dengan petunjuk yang sama membuat variabelnya hanya satu parameter, sehingga kesimpulannya paling bersih.
Q7: Apakah memperbesar max_tokens menambah biaya?
Tidak ditagih berdasarkan batas maksimum. Dokumentasi mencatat bahwa `max_tokens` adalah batas atas, bukan konsumsi aktual; penagihan dihitung berdasarkan token yang benar-benar dihasilkan. Berapa pun yang benar-benar dihasilkan oleh proses berpikir plus isi jawaban, itulah yang ditagih. Harga satuan spesifik mengikuti halaman harga APIYI.
Q8: Apakah model non-penalaran juga mengalami hal ini?
Dokumentasi mencatat bahwa model non-penalaran tidak mengalami konten kosong seperti ini. Karena tidak ada tahap berpikir, seluruh `max_tokens` disisakan untuk isi jawaban; dengan kuota kecil hasilnya hanya jawaban yang terpotong, bukan kosong seluruhnya. Ini juga menjadi salah satu dasar pertimbangan apakah perlu mengganti model.
Poin-Poin Penting: Body Kosong pada gpt-6.1-sol
- Akar body kosong: Penalaran dan body berbagi
max_tokens; token penalaran menghabiskan kuota lebih dulu. - Tanda pengenal:
completion_tokenssama denganreasoning_tokens, sedangkantext_tokensbernilai 0. - Dua gejala: Kode error
empty_response, atau HTTP 200 dengan string kosong. - Solusi utama: Untuk percakapan biasa, mulai dari 2000; untuk penalaran kompleks dan teks panjang, 16000 ke atas.
- Alternatif ringan: Turunkan
reasoning_effortuntuk menekan konsumsi penalaran. - Jangan sia-siakan usaha: Mengulang dengan parameter yang sama hampir tidak pernah berhasil.
- Logika penagihan:
max_tokensadalah batas atas; tagihan mengikuti jumlah token yang benar-benar dihasilkan.
Ringkasan
Kalau ditinjau kembali, poin-poin inti body kosong gpt-6.1-sol sebenarnya cukup jelas:
- Penyebab: Penalaran dan body berbagi
max_tokens; angka 300 dalam kasus itu seluruhnya adalahreasoning_tokens,text_tokensbernilai 0, danfinish_reasonbernilailength. - Perbaikan: Naikkan
max_tokens(mulai 2000 untuk percakapan biasa, 16000 ke atas untuk penalaran kompleks), atau turunkanreasoning_effort; mengulang dengan parameter awal pada dasarnya tidak efektif. - Penagihan:
max_tokensadalah batas atas, bukan jumlah yang dikonsumsi. Tagihan dihitung berdasarkan token yang benar-benar dihasilkan, jadi tidak perlu ragu menaikkannya.
Lain kali saat menemui “API sukses tetapi body-nya kosong”, cek usage dulu, lalu lihat finish_reason; biasanya dalam sepuluh detik sudah bisa ditemukan penyebabnya. Disarankan memverifikasi hasil perbaikan melalui APIYI apiyi.com; platform ini menyediakan kuota uji gratis dan antarmuka terpadu untuk banyak model, cukup ubah satu parameter dan langsung bisa membandingkan.
Referensi
- Pusat Dokumentasi APIYI: Penjelasan Respons Kosong pada Model Inferensi
- Tautan:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
Keterangan: Catatan asli mengenai penyebab respons kosong, dua gejalanya, serta cara penanganannya
-
Buletin Dokumentasi APIYI: Kasus Respons Kosong gpt-6.1-sol (2026-11)
- Tautan:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - Keterangan: Sumber angka pada kelompok
completion_tokens300 dan nilai rekomendasimax_tokens
Penulis: Tim Teknis APIYI
Diskusi Teknis: Silakan hubungi kami melalui halaman utama situs APIYI; materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com