著者注:モデルのコストを比較する際、100万トークンあたりの単価だけを見ていると、選択を誤りがちです。この記事では、「単価 × 実際のトークン消費量」による試算の考え方と、実際のタスクを少数のサンプルで再検証する手順を紹介します。
モデルを選ぶとき、まず価格表を開き、モデルAは100万トークンあたりわずかな金額、モデルBは数ドルかかるのを見て、Aのほうが安いと判断するチームは少なくありません。しかし、月末の請求額は予想と合わないことがよくあります。ときには「安い」はずのモデルのほうが高くつくこともあります。この記事では、「単価 × 実際のトークン消費量 + キャッシュの割引を反映」する実コストの試算方法を紹介し、モデル選定の段階でコストを正しく把握するための方法を解説します。
この記事は、単なる価格表のまとめではありません。価格表は古くなりますが、試算方法は使い続けられます。公開されている試算で見られた個別の事例から汎用的な考え方を導き、それを実際のタスクに当てはめて検証します。
この記事で得られること:「表示価格が安くても請求額が安いとは限らない」理由を説明できるようになり、20〜50件の実際のリクエストを使って、候補モデルごとの1タスクあたりのコストを測定できます。
モデルの実コストを把握するためのポイント
| ポイント | 説明 | モデル選定への影響 |
|---|---|---|
| 単価は計算要素の一つにすぎない | 請求額 = 各種トークン数 × それぞれの単価の合計 | 単価だけの比較では、計算式の半分しか見ていないことになる |
| トークン分割の違い | 同じテキストでも、モデルによって分割されるトークン数が異なる | 入力コストは各モデルの実際のトークン数に基づいて計算する必要がある |
| 推論トークン | 推論モデルの思考過程は通常、出力として課金されるが、ユーザーには見えない | 表示される回答が短くても、請求額が高くなることがある |
| キャッシュヒット | 繰り返し使うプレフィックスがキャッシュにヒットすると、より安いキャッシュ料金が適用される | 長いシステムプロンプトや複数ターンの会話では差が大きくなる |
| 成功率とリトライ | 回答が間違っていたり、形式が要件を満たしていなかったりすると再実行が必要になる | 実効コスト = 1回あたりのコスト ÷ 成功率 |
なぜ100万トークンあたりの単価だけでは実コストを見誤るのか
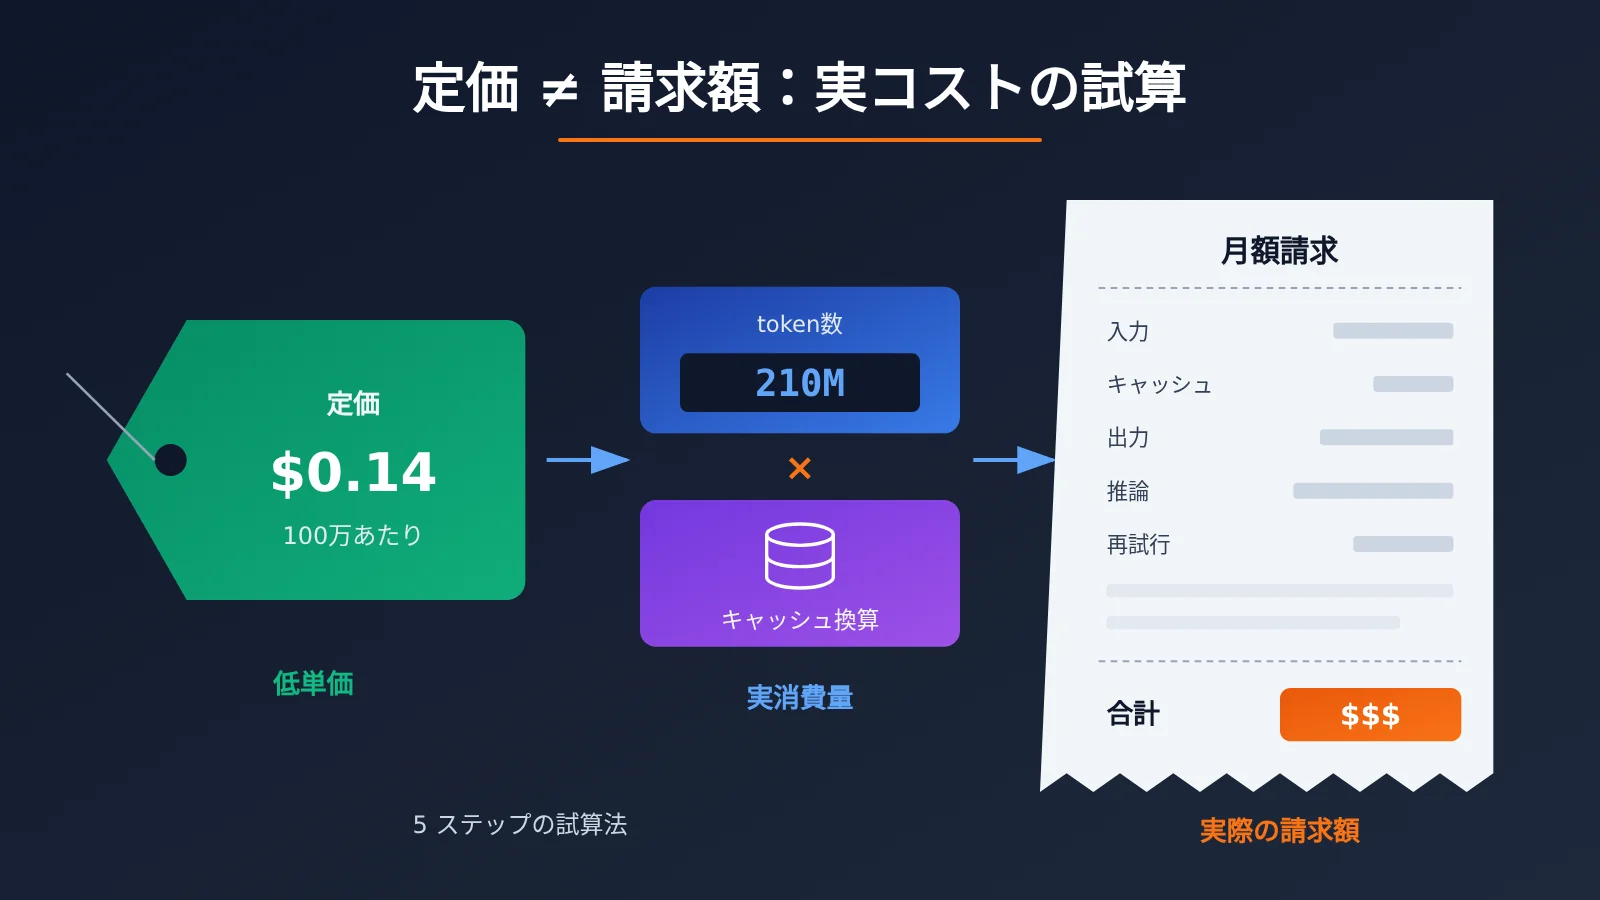
100万トークンあたりの単価が示すのは「1トークンにいくらかかるか」ですが、請求額が示すのは「一つのタスクを完了するのにいくらかかるか」です。この二つの間には、そのタスクを完了するために何トークン必要かという重要な変数があります。この点でのモデル間の差は、単価の差よりも大きいことが少なくありません。
典型的な例として、サードパーティのブログによる2026年8月1日の試算があります。DeepSeek V4 FlashとGemini 3.6 Flashは、Artificial Analysisでどちらも50点と同じスコアでした。前者の表示価格は$0.14/M、後者は$1.50/Mで、単価には約10倍の差があります。しかし、同じ評価では前者が約2億1000万トークン、後者が約5900万トークンを消費し、消費量には3倍以上の差がありました。単価の優位性は消費量によって大きく相殺され、実際の差は10倍には遠く及びません。
もう一つの要因がトークン分割の違いです。同じブログの2026年8月12日の記事では、まったく同じ文書のトークン数を9つのモデルでそれぞれ計測したところ、結果は614〜957トークンとなり、最大と最小の間に約56%の差がありました。つまり、二つのモデルの入力単価がまったく同じでも、同じプロンプトの入力料金が5割以上異なる可能性があります。
💡 データについて:上記の数値はサードパーティのブログによる一度の試算です。評価タスク、モデルのバージョン、価格はいずれも時期によって変わるため、「こうした現象がある」という根拠にはなりますが、そのまま予算に使うことはできません。実際に使うタスクで、ご自身で再測定してください。
モデルの請求内訳:実際のコストを構成する token の種類
コストを正確に計算するには、まず請求項目を把握する必要があります。多くのプロバイダーの料金は、以下のように分類できます。具体的な名称や個別課金の有無は、各社の公式ドキュメントを確認してください。
| 請求項目 | 意味 | 一般的な料金体系 | 見落としがちな点 |
|---|---|---|---|
| キャッシュミスの入力 | 今回新たに送信され、キャッシュにヒットしなかったプロンプト | 入力単価 | トークナイザーの影響を受けるため、同じ文章でも料金が異なる |
| キャッシュヒットの入力 | 以前のリクエストと同じプレフィックス部分 | キャッシュ読み取り単価。通常、入力単価より大幅に安い | ヒットするにはプレフィックスが完全に一致する必要がある |
| キャッシュ書き込み | 一部のプロバイダーが初回のキャッシュ書き込みに対して個別に課金 | 通常の入力単価より高い場合がある | ヒット率が低いとかえって高くなる |
| 可視出力 | ユーザーが最終的に目にする回答 | 出力単価 | 出力単価は通常、入力単価の数倍 |
| 推論 token | モデル内部の思考プロセス | 一般に出力単価で計算 | 回答には表示されないが、請求には含まれる |
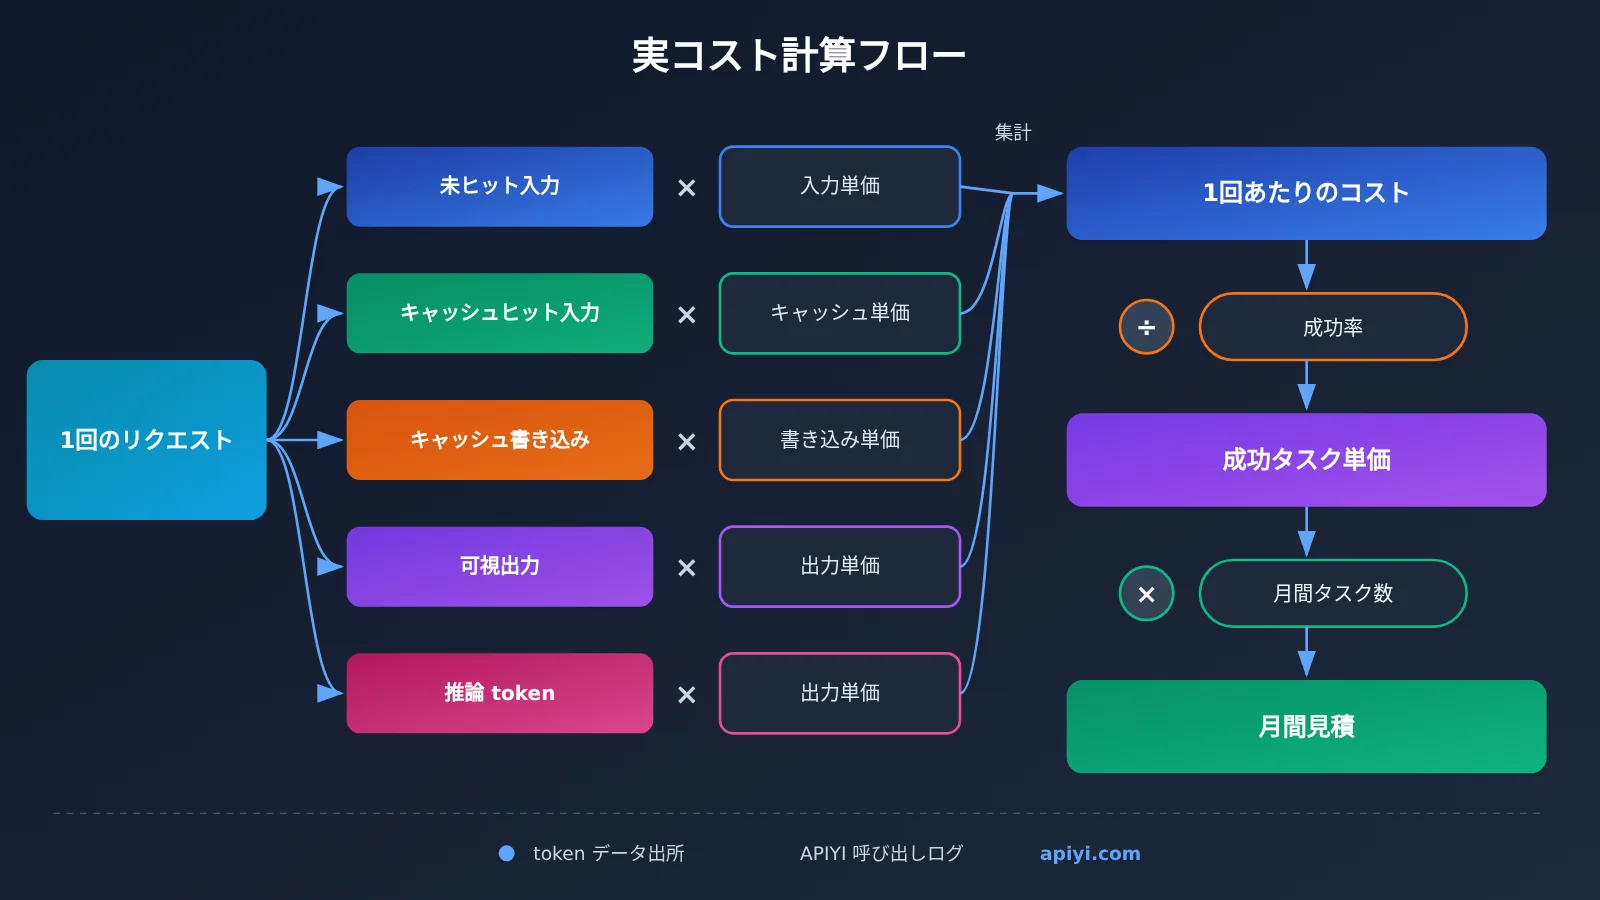
これらを数式にまとめると、この記事のコスト試算の基本的な枠組みになります。
- 1リクエストあたりのコスト = キャッシュミスの入力 token × 入力単価 + キャッシュヒットの入力 token × キャッシュ単価 + キャッシュ書き込み token × 書き込み単価 + (可視出力 + 推論 token)× 出力単価
- タスクあたりの実効コスト = 1リクエストあたりのコスト × 平均呼び出し回数 ÷ タスク成功率
- 月額予測 = タスクあたりの実効コスト × 月間タスク数
キャッシュの影響は、しばしば過小評価されます。同じ情報源の2026年8月6日の記事によると、DeepSeek V4 Flash のキャッシュヒット時の料金は、キャッシュミス時より約50倍安く、ホスティング事業者間ではキャッシュ料金に最大28倍の差があります。つまり、「同じモデルでも利用する経路が違えば」請求額は大きく変わり得ます。キャッシュ料金は、実際に利用する経路ごとに確認しましょう。
推論トークンが実際のコストを押し上げる影響
推論モデルは、「表示価格は安いのに請求額は高い」という状況が起きやすい代表例です。ユーザーが一言質問し、モデルの回答が200文字だったとしても、内部では数千トークンを使って考えている可能性があります。この部分は通常、出力トークンの単価で課金されます。しかも、出力単価はもともと入力単価の数倍です。
第三者による公開測定でも、その影響が示されています。2026年8月4日の記事によると、Qwen 3.8 Max は Artificial Analysis のスコアで DeepSeek V4 Flash を3点上回ったものの、実測した3つのタスクではコストが約345倍、速度は約6分の1でした。同じシリーズの別の記事では、同一の評価方法で Kimi K3 が57点で $2,437、DeepSeek V4 Flash が50点で $72、Qwen 3.7 Max が46点で $1,604 という結果が示されています。スコアが低いのにコストが高くなるケースは実際にあり、その原因は多くの場合、トークンの消費量にあります。
同じベンダーの異なるバージョン間でも差が生じます。ある記事によると、Claude Opus 4.5 から 4.8 と Opus 5 は、いずれも表示価格が $5/$25 で同じですが、実測ではトークン消費量に約1.30倍の差がありました。価格が変わらなくても請求額が30%変わる可能性があり、モデルのバージョンを更新する際には見落としやすいポイントです。
トークン消費量から実際のコストを見積もる:5 ステップで始めよう
複雑なスクリプトを書かなくても実行できる、少数のサンプルを使った見積もり手順を紹介します。基本は、同じタスク・同じ入力について、入力、出力、キャッシュ、推論の各トークン数をそれぞれ集計することです。
ステップ 1:代表的なタスクのサンプルを用意する
本番環境や実際の利用ケースから 20〜50 件のリクエストを選び、短い質問と回答、長文ドキュメント、複数ターンの会話など、主なタイプを網羅します。キャッシュヒットは主に繰り返されるプレフィックスで発生するため、サンプルにはシステムプロンプトとコンテキストをすべて残してください。「こんにちは」の一言だけでテストしても、トークン分割の違いやキャッシュの効果は測れません。
ステップ 2:条件を固定し、候補モデルをそれぞれ呼び出す
各候補モデルに対して、同じシステムプロンプト、ユーザー入力、max_tokens、temperature の設定を使います。推論モデルが推論強度のパラメータに対応している場合は、今回使用した設定レベルも記録してください。レベルによって推論 token の数が大きく変わることがあります。
このステップでは、接続先を統一すると手間を大幅に減らせます。APIYI apiyi.com のような集約プラットフォームを使えば、同じ APIキーと OpenAI 互換の呼び出し方法で、異なる提供元のモデルを切り替えられます。モデル名を変えるだけで一連の比較を実行でき、提供元ごとにアカウントを作成したり、入金したり、SDK を調整したりする必要はありません。
ステップ 3:各種 token を個別に記録する
呼び出しのたびに、レスポンスの usage フィールドから token 数を読み取ります。OpenAI 互換形式では、主に次のフィールドが使われます。
usage.prompt_tokens:入力 token の総数usage.prompt_tokens_details.cached_tokens:そのうちキャッシュがヒットした分usage.completion_tokens:出力 token の総数usage.completion_tokens_details.reasoning_tokens:そのうちの推論 token
フィールド名は提供元によって異なります。たとえば Anthropic 形式では、cache_read_input_tokens と cache_creation_input_tokens でキャッシュの読み取りと書き込みを区別します。詳しくは各社のドキュメントを確認してください。
レスポンスを自分で解析したくない場合は、プラットフォーム側の記録を直接確認することもできます。APIYI では呼び出しごとのログと使用量の統計を提供しており、同じサンプル群を使った各モデルの消費量をまとめて比較するのに便利です。ただし、キャッシュ token と推論 token がログに個別に表示されるか、キャッシュヒットが個別に課金されるかは、実際のコンソール表示とプラットフォームの料金説明に従います。試算する前に確認しておきましょう。
🚀 クイックスタート:まずは APIYI apiyi.com で 20 件のサンプルを使い、小規模な比較を一度試してみるのがおすすめです。各モデルの token 消費量の目安を確認してから、サンプル数を増やすかどうかを決めましょう。共通残高で支払う仕組みなら、複数モデルのテスト費用が一つのアカウントにまとまり、テスト後の精算も把握しやすくなります。
ステップ 4:測定テンプレートにまとめる
記録した結果を、以下のテンプレートにモデルごとに1行ずつ記入します。単価には必ず確認日と出典を明記してください。
| 項目 | 記入内容 | データソース |
|---|---|---|
| モデルとバージョン | 具体的なバージョン番号または日付のサフィックス | 呼び出しパラメータ |
| 単価と確認日 | 入力、出力、キャッシュ読み取り、キャッシュ書き込みをそれぞれ別の列に記入 | 公式料金ページまたは利用プラットフォームの料金ページ |
| 平均キャッシュ未ヒット入力 token | サンプルの平均値 | レスポンスの usage またはプラットフォームのログ |
| 平均キャッシュヒット token | サンプルの平均値とヒット率 | レスポンスの usage またはプラットフォームのログ(APIYI の利用量統計など) |
| 平均可視出力 token | 出力の総数から推論部分を差し引いた値 | レスポンスの usage |
| 平均推論 token | 推論モデルでは別途記録 | レスポンスの usage |
| タスク成功率 | 人手またはルールによって合格と判定された割合 | 評価記録 |
| 有効単一タスクコスト | 前述の式で計算 | 集計結果 |
ステップ 5:有効単一タスクコストを基準に判断する
最後に比較するのは単価ではなく、「有効単一タスクコスト」です。以下では、例示用の価格を使って計算過程を示します。数値は方法を説明するための架空のもので、実際のモデルの価格ではありません。
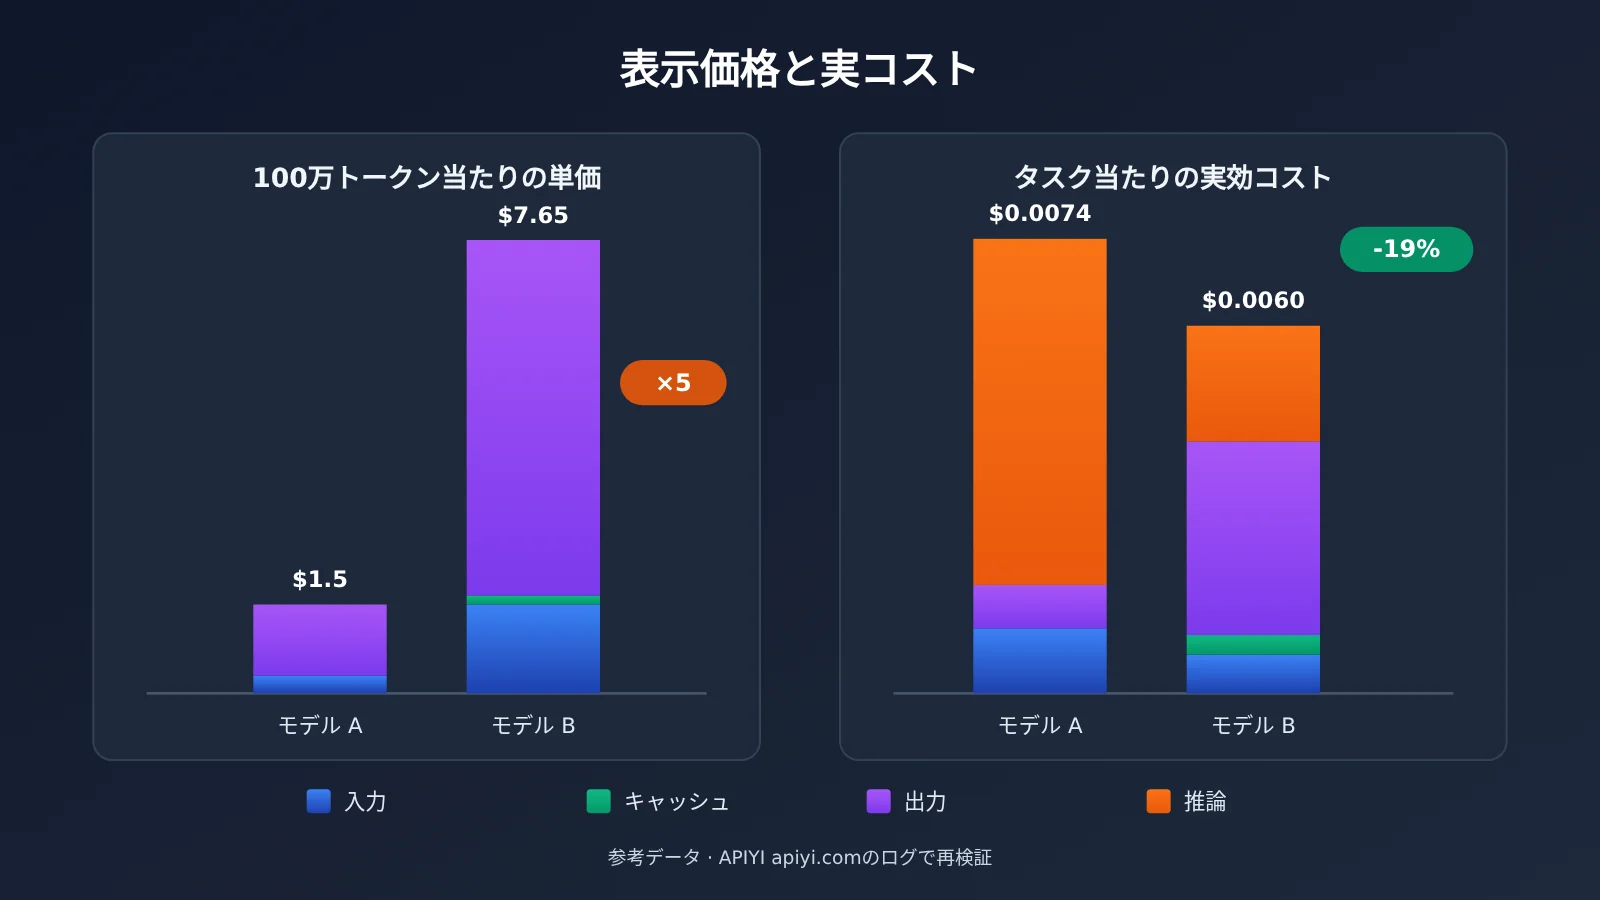
モデル A の表示価格を入力 $0.3/M、出力 $1.2/M、モデル B を入力 $1.5/M、出力 $6/M、キャッシュ読み取り $0.15/M と仮定します。B の単価は A の5倍です。
| 計算項目 | モデル A(低価格) | モデル B(高価格) |
|---|---|---|
| キャッシュ未ヒット入力 token | 3,000 | 400 |
| キャッシュヒット token | 0 | 2,000 |
| 可視出力 + 推論 token | 500 + 4,000 | 500 + 300 |
| 入力費用 | $0.0009 | $0.0006 + $0.0003 |
| 出力費用 | $0.0054 | $0.0048 |
| 1リクエストあたりのコスト | $0.0063 | $0.0057 |
| タスク成功率 | 85% | 95% |
| 有効単一タスクコスト | 約 $0.0074 | 約 $0.0060 |
この例では、モデル B はトークン化がより効率的で、入力の総量が600 token少なくなっています。また、長いシステムプロンプトの大部分がキャッシュにヒットし、推論過程も大幅に短くなっています。その結果、表示価格が5倍の B は、かえって有効コストが A より約19%低くなりました。実際には逆の結果になることもあります。だからこそ、自分のタスクで改めて測定する必要があります。
実際のコストを試算する際の注意点
試算の枠組み自体は複雑ではありませんが、いくつかの落とし穴によって結果が実態からずれることがあります。実施前に一つずつ確認しましょう。
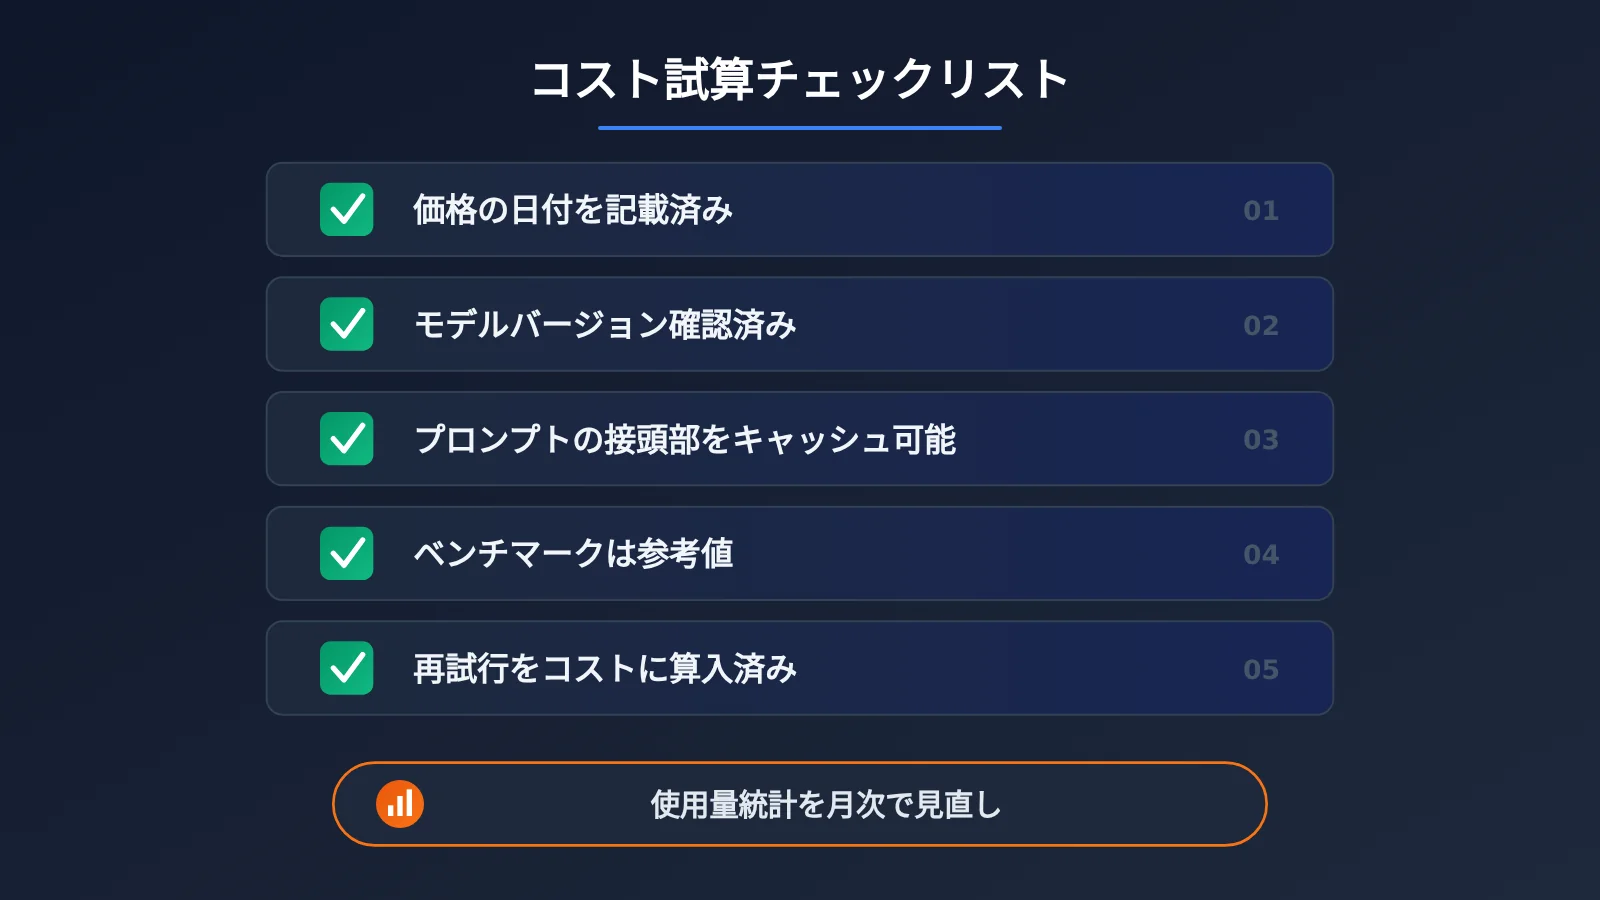
- 価格には必ず日付を明記する:モデルの価格は頻繁に改定されます。参考資料でも、DeepSeek V4 Pro 0813 は 2026 年 8 月 16 日からピーク時とオフピーク時で異なる時間帯別料金が適用されるとされています。同じモデルでも、時間帯や利用するサービスによって価格が異なる場合があります。
- モデルの別名が指すバージョンに注意する:一見「最もよく使われている」モデル名でも、実際には旧バージョンが呼び出されているケースがあると報告されています。試算時にはレスポンスで返されるモデル識別子を記録し、A バージョンを測定したのに B バージョンを本番投入するといった事態を避けましょう。
- キャッシュヒットにはプレフィックスの一致が必要:動的な内容(タイムスタンプやユーザー ID)をプロンプトの先頭に置くと、毎回プレフィックスが異なり、キャッシュがほとんどヒットしなくなります。試算には本番環境と同じプロンプト構造を使いましょう。
- 第三者のベンチマークスコアは参考程度にする:Artificial Analysis のような総合スコアやタスク別に算出されたコストは、評価機関のタスク構成を反映したものです。自社の業務シナリオにもそのまま当てはまるとは限りません。
- リトライも計算に含める:429 によるレート制限、フォーマットエラー、回答の品質不足による再実行にも費用がかかります。成功率は実際の判定結果に基づいて計算しましょう。
💰 コスト最適化のヒント:試算が終わったら、「有効なタスク 1 件あたりのコスト」を選定の主な指標とし、ベンチマークスコアとレイテンシを制約条件にできます。APIYI apiyi.com ではモデル名を変更するだけでモデルを切り替えられるため、試算の結論が変わった場合も本番環境の設定をすばやく調整できます。あわせて、呼び出しログで実際の消費量を継続的に監視しましょう。
よくある質問 FAQ
Q1:モデルの「実際のコスト」とは何ですか?
実際のコストとは、100万トークンあたりの表示価格ではなく、具体的なタスクを完了するために実際に支払う費用のことです。各種トークン(キャッシュ未ヒットの入力、キャッシュヒット、キャッシュ書き込み、表示される出力、推論)の実際の数量にそれぞれの単価を掛け、成功率や再試行も考慮して算出した、タスクあたりの実効コストを指します。
Q2:同じ文書でもモデルによってトークン数が異なるのはなぜですか?
モデルごとに使用するトークナイザーが異なり、中国語やコード、句読点を分割する粒度も違うためです。公開されている試算では、同じ文書が9つのモデルで614〜957トークンと計測されています。そのため、入力コストは各モデルが報告するトークン数に基づいて計算する必要があり、あるモデルの計測値を他のモデルに流用することはできません。
Q3:推論トークンも必ずコストに含める必要がありますか?
はい。多くのプロバイダーは推論トークンを出力に含め、出力単価で課金します。回答本文には表示されませんが、出力の大部分を占めることもあります。推論型モデルを試算する際は、`reasoning_tokens` を別途記録し、同じ推論強度の設定で比較することをおすすめします。
Q4:キャッシュヒットでどれくらい節約できますか?
プロバイダーのキャッシュ料金とヒット率によって異なります。参考資料では、DeepSeek V4 Flash のキャッシュヒット時の価格は未ヒット時の約1/50とされていますが、ホスティング事業者によってキャッシュ料金に最大28倍の差がある場合もあります。長いシステムプロンプト、固定のナレッジベースのプレフィックス、複数ターンの会話などで特に効果が大きくなります。具体的な金額は、利用するサービスの料金案内を確認してください。
Q5:複数のモデルのコストを少数のサンプルで手早く試算するには?
複数のモデルに統一的な方法でアクセスできるプラットフォームを使うのがおすすめです。
1. APIYI apiyi.com に登録し、APIキーを取得する
2. 実際のタスクから20〜50件のサンプルを用意し、プロンプトとパラメータを固定する
3. モデル名を順に切り替えて呼び出し、呼び出しログと使用量の統計から各種トークンを集計する
4. 本文のテンプレートに沿って、タスクあたりの実効コストを計算する
これにより、1つのアカウントと共通の呼び出し方法ですべての比較を完了でき、複数のサービスでのアカウント開設や請求確認にかかる手間を減らせます。
Q6:第三者のブログに掲載されている「タスクあたりのコスト」はそのまま使えますか?
予算にそのまま使うことはおすすめしません。こうしたデータは「トークン消費量に差があるかもしれない」モデルの組み合わせを見つけ、候補を絞り込むのに役立ちます。ただし、評価タスクやモデルのバージョン、価格、キャッシュ条件は自社の業務とは異なるため、最終的な数値は自分たちのサンプルで再検証する必要があります。
Q7:この試算方法にはどのような限界がありますか?
少数のサンプルでは、サンプルに含まれるタスクの種類しか反映できないため、業務の分布が変わったら再計測が必要です。また、プラットフォームによってはログでキャッシュと推論のトークンが区別されないため、その場合はモデルのレスポンスの `usage` フィールドから自分で収集する必要があります。価格やモデルのバージョンも変わるので、料金改定やアップグレードのたびに再計測することをおすすめします。
モデルの実コストを見積もるためのポイント Key Takeaways
- 単価だけでは判断できない:請求額は単価と実際のトークン消費量で決まる
- トークン分割の違いは無視できない:同じ文書でも、モデルによってトークン数が 50% 以上異なることがある
- 推論トークンが出力コストを押し上げる:目に見えない思考プロセスも出力として課金される
- キャッシュ料金は利用経路によって異なる:ヒット率とキャッシュ単価の両方が、長いプロンプトを使う場合のコストを左右する
- 実効タスク単価で判断する:成功率と再試行も含めて計算する
- 統一された窓口で再検証する:APIYI の統一インターフェースと呼び出しログを使えば、同じサンプルで複数のモデルを手軽に比較できる
まとめ
トークン消費量とキャッシュからモデルの実コストを見積もる際のポイントは、次の3つです。
- 請求の内訳を分ける:キャッシュ非ヒットの入力、キャッシュヒット、キャッシュ書き込み、可視出力、推論トークンをそれぞれ集計し、対応する単価を掛けます。
- 自分のタスクで再検証する:第三者のベンチマークや価格はあくまで参考です。同じタスク、同じ入力で実測したデータこそ信頼できます。
- 実効タスク単価を比較する:成功率と再試行を含めて計算し、月間タスク数と合わせて予算を立てます。
モデルの価格は変動し、新しいモデルも次々と登場しますが、この見積もり方法は長く活用できます。次にモデルを選ぶ際は、まず実際のサンプル 20 件で比較し、その結果をもとに本番環境で使うモデルを決めるのがおすすめです。複数のメーカーのモデルを素早く切り替えてテストしたい場合は、APIYI apiyi.com から統一的に接続し、呼び出しログで各モデルの実際の消費量を直接確認できます。
📚 参考資料
- Ofox.ai Blog 23ページ目:DeepSeek V4 Flash と Gemini 3.6 Flash のトークン消費量の比較、キャッシュ料金の違い、Qwen シリーズのコスト試算などの記事概要を掲載
- リンク:
ofox.ai/blog/page/23/ -
注記:記事は2026年8月に公開されたもので、データは第三者による1回限りの試算です。参考情報としてご覧ください
-
Ofox.ai Blog 22ページ目:同じ文書における9モデルのトークン数比較、Claude のバージョン間のトークン消費量の差、DeepSeek V4 Pro の時間帯別料金などの情報を掲載
- リンク:
ofox.ai/blog/page/22/ -
注記:トークン分割やバージョンによる違いの具体例を知るのに役立ちます
-
Ofox.ai Blog 25ページ目:Kimi K3、GLM-5.2、Opus 4.8 のタスクあたりのコスト比較を掲載
- リンク:
ofox.ai/blog/page/25/ - 注記:料金やベンチマークスコアは時間とともに変わるため、利用前に各社の公式料金ページをご確認ください
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI の apiyi.com トップページからお気軽にお問い合わせください。接続に関する詳しい資料は、docs.apiyi.com のドキュメントセンターでご覧いただけます