著者注:OpenAI は 2026 年 11 月 2 日、社内の Git バックエンド「Pando」を公開しました。この記事では、「10 週間で本番環境に投入された」という事実を軸に、人間と AI の役割分担、テスト体系、移行プロセスを解説し、一般のチームも参考にできる Agent を活用した開発手法を整理します。
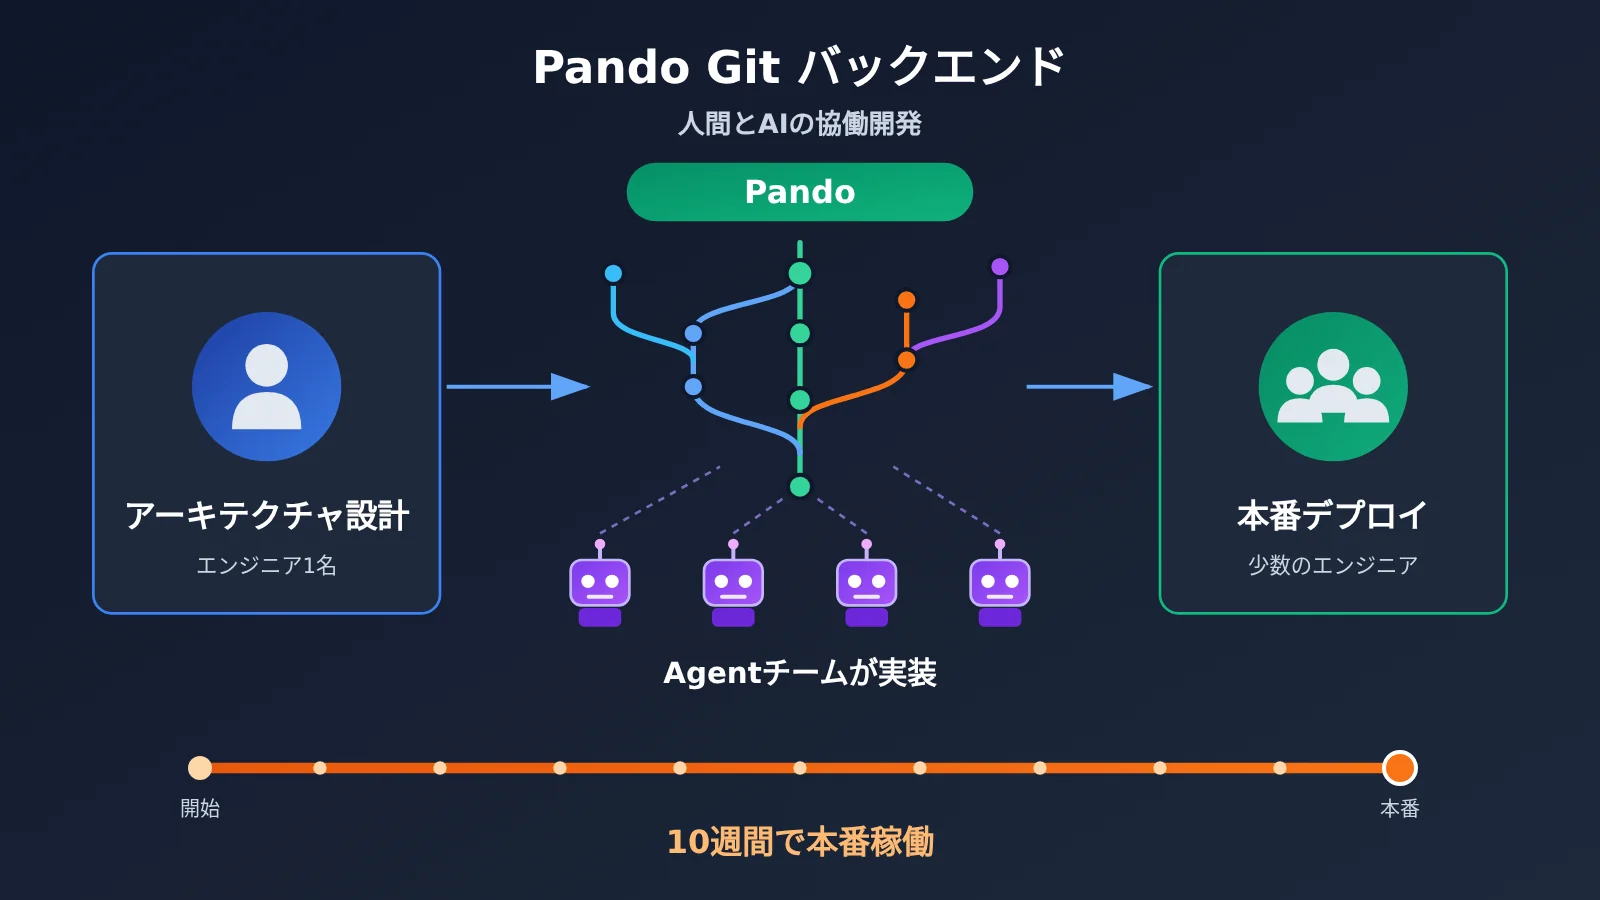
2026 年 11 月 2 日、OpenAI は技術記事《Scaling Git at OpenAI》を公開し、同社のモノリポジトリにおけるすべての開発活動を支える新しい Git バックエンド「Pando」を紹介しました。プロジェクト開始から本番トラフィックを処理するまで約 10 週間。コアアーキテクチャは 1 人のエンジニアが設計し、実装は複数の Agent チームが担当、デプロイは少数のエンジニアが行いました。 これだけ聞くと「1 人が AI を指揮してインフラを作り上げた」という物語になりがちです。しかし、公式に公開された詳細を見ると、実際に機能したのは、エンジニアリング上の制約と検証の体系全体だったことがわかります。
この記事は、AI プログラミングの神話を語り直すものではありません。OpenAI の公式発表をもとに、公開された事実と未公開の情報を区別します。たとえば、参加人数、トークンコスト、タスクの記録、人間がコードを修正した割合は公表されていません。
この記事でわかること:Pando が必要になった理由、Codex Agent チームが具体的に担当したこと、Agent がインフラ開発に参加できるようにした検証手法、そしてこの方法を自分のプロジェクトにどう取り入れるかを解説します。
Pando の概要:Codex Agent チームは何を実現したのか
まず、公式に確認されている情報を表にまとめます。Pando は Git 互換のサーバーサイドバックエンドであり、新しいバージョン管理プロトコルでも、GitHub の直接的な代替品でもありません。
| 項目 | 詳細 |
|---|---|
| 発表日 | 2026 年 11 月 2 日、公式記事《Scaling Git at OpenAI》 |
| 著者 | Aaron Friel、Taylor Blau、Ted Nyman(OpenAI の技術者) |
| プロジェクト期間 | 開始から本番投入まで約 10 週間。2026 年 4 月から本番トラフィックの処理を開始 |
| 実装言語 | サーバーサイドは主に Rust を使用。旧システムへの依存を意図的に避け、ゼロから構築 |
| 人と AI の分担 | 1 人のエンジニアがコアアーキテクチャを設計し、複数の Agent チームが実装。少数のエンジニアがデプロイ |
| 本番環境での成果 | Push レイテンシの中央値が約 80% 低下。1 日あたり約 1 PB の Git データを配信 |
| 公開状況 | 2026-11-03 時点で、サーバーソフトウェア、API、料金は公開されていない |
なぜ OpenAI は Codex Agent を使って Git バックエンドを再構築する必要があったのか
Pando が生まれたきっかけは、コードのコミット数の爆発的な増加です。公式グラフは、2024 年第 1 四半期にメインブランチへマージされた Commit 数を基準に、その後の四半期ごとの増加率を示しています。下表は、その一部を抜粋したものです。
| 四半期 | 2024 Q1 比の Commit 増加率 | 説明 |
|---|---|---|
| 2024 Q4 | +98% | ほぼ 2 倍 |
| 2025 Q4 | +264% | 旧システムが需要に追いつけなくなり始めた |
| 2026 Q1 | +432% | Pando プロジェクトの進行段階 |
| 2026 Q3 | +1,378% | 基準期の約 14.78 倍 |
| 2026 Q4 | +2,442% | 公式の予測値であり、四半期の確定実績ではない |
ここで注意したいのは、Commit 数はコード行数や PR 数、開発生産性と同じではないという点です。この数字を根拠に「コード量が 25 倍になった」「Codex によってエンジニアの生産性が 25 倍になった」とは言えません。OpenAI は、Codex によってエンジニアがより多くのタスクを同時に進められるようになり、その結果、並行して作業するブランチや Push、マージ、CI ジョブ、Fetch・Clone リクエストが増えたと説明しています。
2025 年第 4 四半期ごろには、旧システムで Push や Fetch の遅延、マージの失敗といった問題が発生し、信頼性が 90% を下回ることもありました。ただし、OpenAI はこの信頼性指標の集計方法や時系列データを公開していません。そのため、「コミットの 10% 以上が失敗した」と解釈することもできません。
Pando の技術アーキテクチャを支える4つの設計
Pando は Git を捨てたのではなく、バックエンドのストレージ、参照の更新、データの配信方法を再設計しました。これらの設計を理解すると、「人間がどのような不可欠なトレードオフを判断したのか」が見えてきます。
- ブランチごとの独立した更新:リポジトリ全体で単一時点の一貫したスナップショットを維持することをやめ、各ブランチが独立してバージョンを管理します。同じ Ref を変更するリクエスト間でのみ調整が必要となり、因果一貫性モデルを採用しています。その代償として、複数のブランチを一度に読み取る際、それぞれ異なる時点の状態が返される可能性があります。
- Packfile の保存と再利用:Push のたびに受け取る Packfile を、イミュータブルなデータとして Blob Store に書き込みます。Fetch 時にはクライアントの have/want に基づいて既存の Packfile を選び、Git の packfile-uri 機構を使ってダウンロード先を通知します。これにより、クライアントごとに繰り返しパックと圧縮を行う必要がなくなります。
- リージョンキャッシュ Express:複数のリージョンにクラスターとローカルキャッシュを配置し、一貫性ハッシュでリクエストを振り分けます。Packfile のキャッシュヒット率は 99% を超えています。これは Git データのキャッシュであり、大規模言語モデル API の Prompt Caching とは異なります。
- バックグラウンドでの階層的な Compaction:LSM Tree のように、小さな Packfile を段階的にマージし、連続したバージョン範囲をカバーする大きな集合にまとめます。現在、このモノレポでは L4 レベルまで使用しています。
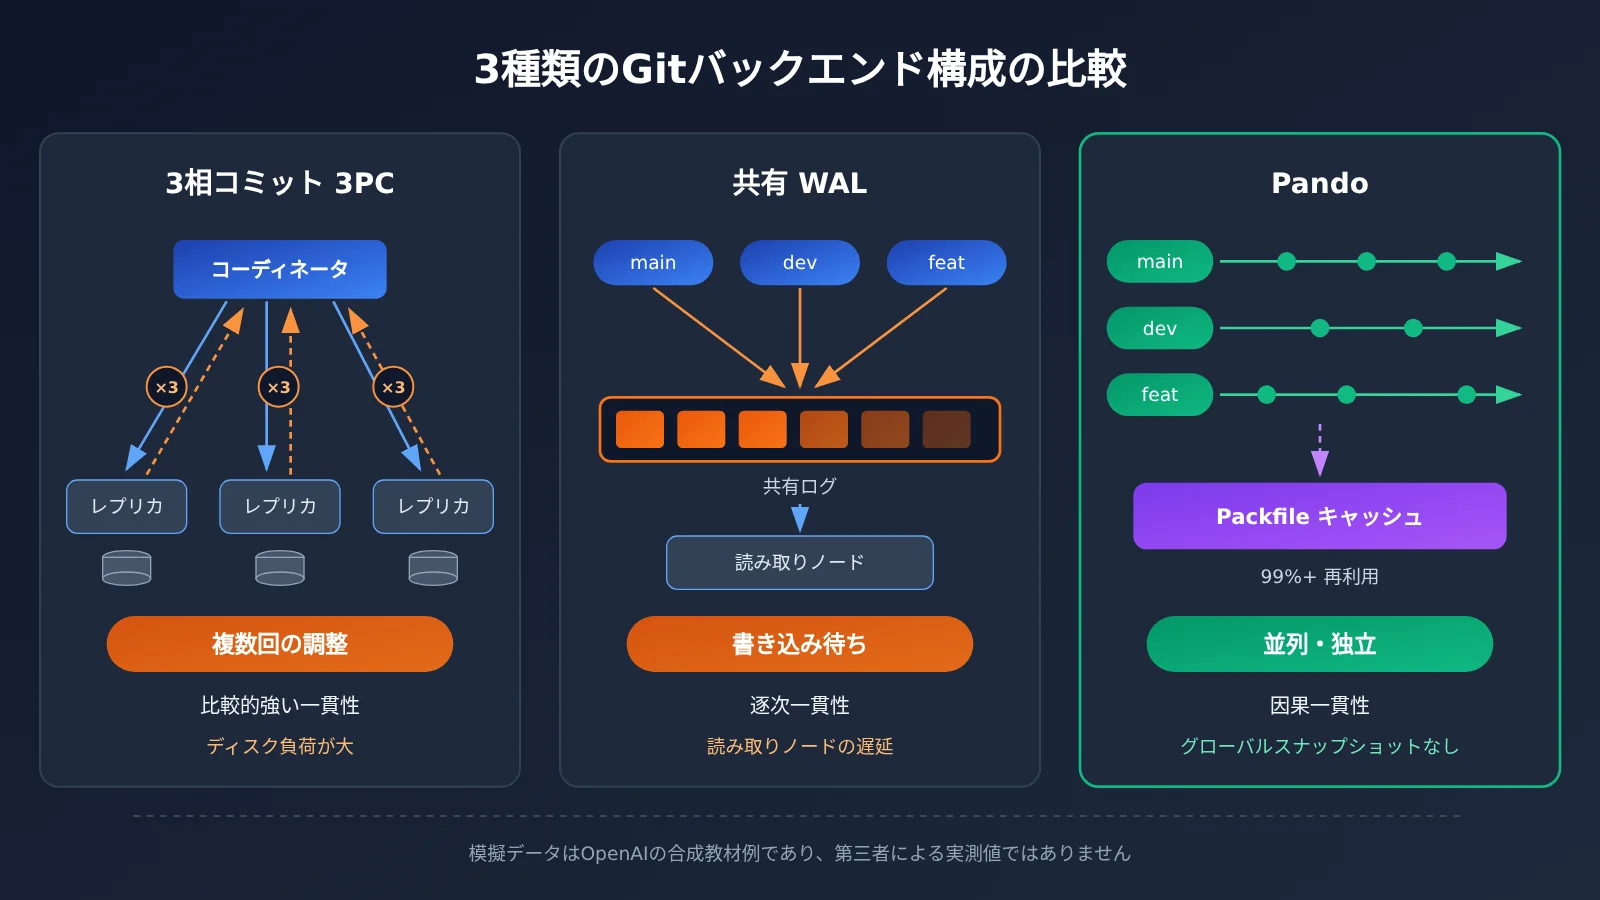
公式は3種類のアーキテクチャを比較し、1,000 クライアントによる合計 10,000 回の Push をシミュレーションしました。これは OpenAI が作成した教育用の合成シミュレーションであり、第三者による独立したベンチマークではありません。
| アーキテクチャ | 書き込み方式 | 一貫性 | 主なボトルネック |
|---|---|---|---|
| 三相コミット 3PC | 複数の完全なレプリカ間で調整して書き込み | 比較的強い | 複数回の調整とディスク負荷により、並行書き込みが遅くなる |
| 共有 WAL | すべての更新が同一ログへの書き込みを競合 | 順次一貫性 | 書き込みが適用より速い場合、読み取りノードが遅延する |
| Pando | 各 Ref が独立したアトミックトランザクション | 因果一貫性 | リポジトリ全体の同一時点のスナップショットを断念 |
公式が公開した本番環境のデータには、ほかにも次のものがあります。1時間あたりの Packfile 配信量のピークは 57 TB を超え、そのうち 99% 以上のバイトがローカルディスクキャッシュから配信されました。標準的なクラウド仮想マシンでは、Clone と Fetch で 10 Gbps のリンク帯域を使い切ることができます。また、Push のメタデータ読み書きは O(1)、Fetch の計画におけるメタデータ読み取りは O(log Δ)です。これらの計算量はメタデータ操作に関するもので、エンドツーエンドのネットワーク所要時間を示すものではありません。
Codex Agent チームはどのように分担して Pando を完成させたのか
「1人のエンジニアが中核を設計した」とは、プロジェクトに1人しか関わっていなかったという意味ではありません。また、「Agent チームが実装した」からといって、すべてのコードを AI が書いたわけでもありません。公式に公開された作業範囲をもとに分担を整理すると、次のようになります。ただし、OpenAI は各 Agent の具体的なタスクリストを公開していません。
| 役割 | 担当した作業 | この役割が担当した理由 |
|---|---|---|
| アーキテクチャ担当エンジニア(人間) | 旧システムのボトルネックの判断、Git プロトコルとの互換性の維持、ブランチごとの独立した更新と Packfile の再利用の選択、リポジトリ全体の強整合性の断念 | 後戻りが難しく、システムの境界を決める技術的な判断であるため |
| Codex などの Agent チーム | Rust バックエンドの実装、Push/Fetch プロトコルとの互換性確保、並行書き込み、パフォーマンス最適化、境界条件に関する問題の修正 | 実装量が多く、テストで繰り返し検証できるため、並行した反復作業に適している |
| 検証用 Agent | 長時間のセッションを実行してエッジケースを発見し、Daybreak 能力を備えたモデルで終日対抗テストを実施 | 継続的な作業であり、人間が同じ頻度を維持するのは難しいため |
| デプロイ担当エンジニア(人間) | 段階的なトラフィック切り替え、新旧システムの同期、数百件の連携の移行 | 本番環境のリスク管理と組織間の調整には、人間が責任を持つ必要があるため |
この表が示すのは、人間がアーキテクチャ、制約、受け入れ基準を定め、Agent が大量の実装と反復作業を担い、エンジニアが本番環境への移行とシステムの信頼性に責任を持つという構図です。公式には人手による開発との対照実験が示されていないため、Codex によってこのプロジェクトが何倍速くなったかは計算できません。
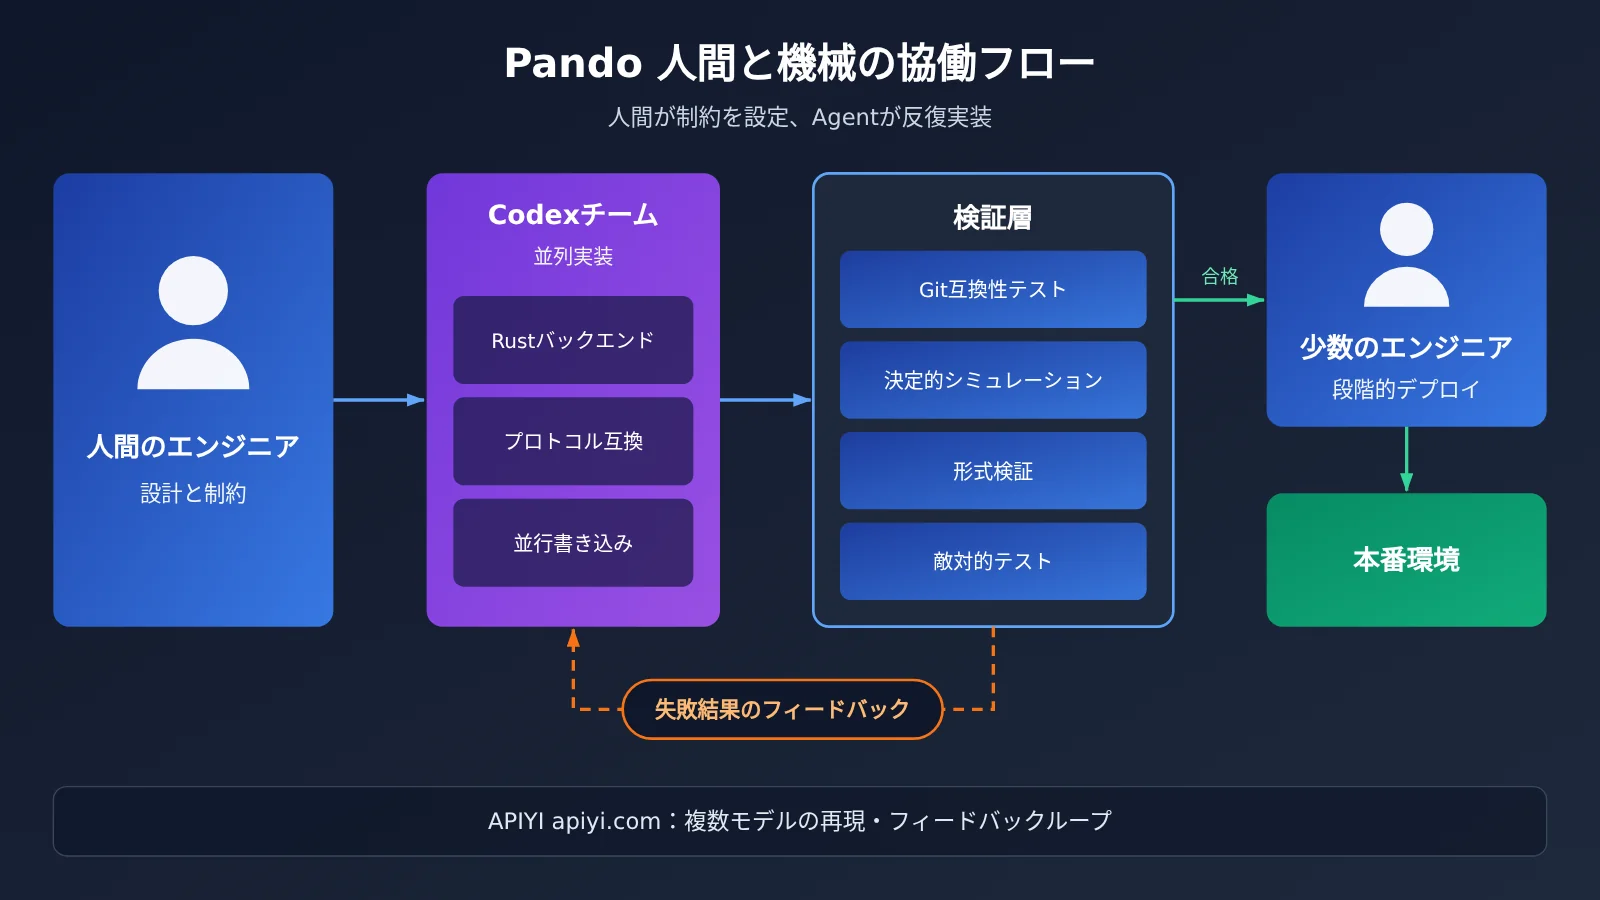
Pando のテスト体系:Codex Agent がインフラ開発に参加できる理由
Pando はインフラストラクチャソフトウェアです。不具合が起きれば、ブランチが正しいコミットを指しているか、Push でオブジェクトが失われないか、Fetch で履歴全体を取得できるかに影響します。通常の Web ページなら間違いがあっても再読み込みできますが、Git バックエンドの不具合は会社全体の開発を止めかねません。そこで OpenAI は、Agent により長いプロンプトを与えるのではなく、実行可能な検証システムを用意しました。
Git 互換性テスト:コンパイルではなく動作を検証
OpenAI は Git Conformance Test Suite を構築し、Agent がサーバー側の実装を変更した後、その動作が標準的な Git の期待どおりかを自分で確認できるようにしました。検証対象には Ref の更新、Push、Fetch、Packfile の転送、プロトコルの互換性が含まれます。重要なのは、「コードがコンパイルでき、単体テストに通る」だけでなく、「Git と同じように動作する」ことを基準にしている点です。公式はテストケースの数を公開していません。
決定論的な並行シミュレーション:競合状態を再現可能にする
分散システムで最も厄介なエラーは、複数の操作が入り交じって発生するときに起こりがちです。OpenAI は Deterministic Simulation Harnesses を使用して、システムの状態や並行イベントを再現可能な形でシミュレーションし、競合状態、Git のネゴシエーションの問題、Packfile の計画ミス、リグレッションの発見に役立てています。例えば、2 つの Agent が同時に同じブランチを変更した場合、競合する両方の更新を成功と判定してはいけません。また、ブランチポインターを更新する前に、新しいコミットオブジェクトが読み取り可能になっている必要があります。これらはテストの目的を説明するための例であり、公式が個別に公開したテストケースではありません。
Lean と TLA+ による形式検証:時系列に注意
公式によると、GPT-6 Astra を使って Agent による Lean と TLA+ の形式記述の作成を支援し、いわゆる「Theory of Pando」を構築しました。これは不変条件の確認、エラーの発見と修正、特定の性質の証明に使われています。ここには 2 つの注意点があります。第一に、検証されたのは指定された性質であり、システム全体のすべてのコードパスが数学的に証明されたわけではありません。第二に、公式は新しいモデルが登場するたびに、性能と信頼性の向上に継続的に活用したと説明しています。そのため、これらの取り組みをすべて最初の 10 週間に含めることはできません。
長時間の Agent セッションと敵対的セキュリティテスト
OpenAI はまた、複数の Agent セッションを継続的に実行し、数百時間にわたってエッジケースの問題を発見・修正したことや、Daybreak 能力を持つモデルが Git と Pando に対して継続的に敵対的テストを行ったことにも言及しています。公式は Agent の数、1 セッションの長さ、トークン消費量、修正したバグの数、人的監督の頻度を公開していません。そのため、「Agent が無人で数百時間連続してコードを書いた」と推論することはできません。注目したいのは、Agent を最初のコード生成だけでなく、継続的な検証にも使うという発想の転換です。
OpenAI が公開した Git のフォークからも、この継続的な改善がうかがえます。例えば、2026 年 8 月の index-pack の並列ハッシュ化や、10 月のレート制限時のリトライ、完成済み Pack の再利用などのパッチです。ただし、これらのコミットはいずれも 2026 年 4 月の初回本番投入より後のものであり、10 週間以内の成果物には含められません。
Pando の段階的移行:Codex Agent がコードを書き終えても、本番で使えるとは限らない
10週間というのは、プロジェクト開始から本番投入までの期間であり、システムを十分に成熟させるまでにかかった全期間ではありません。Pando は典型的な「無停止の段階的移行」によって導入されました。公式に公開された移行プロセスは、おおむね次のとおりです。
- Pando を旧システムの前段に配置し、読み書きを透過的に中継するプロキシとして機能させ、新旧のバックエンドを同期した状態に保つ。
- 実際のリクエストで同一リクエストをまとめ、Git データをキャッシュする。トラフィックの一部を移行した結果、むしろ旧システムの負荷が軽減された。
- 社内の Git CLI ラッパーを通じて、開発用クライアントを段階的に移行する。
- 旧 API、Webhook、リポジトリのダウンロード方法に依存する数百のインテグレーションと、Review、Change Request のワークフローを移行する。
- 移行用の Codex Skills を提供し、開発者がローカルリポジトリや移行環境の準備を Codex に直接支援してもらえるようにする。
- 改良版の Git クライアントをエンジニアのデバイスと ChatGPT デスクトップアプリに展開する。
公式によると、移行の全期間を通じてエンジニアリング作業が中断されることはありませんでした。ただし、ロールバック率、障害の分布、失敗事例は公開されていません。技術責任者にとっては、「10週間」という数字以上に、この移行プロセスこそ詳しく調べる価値があります。既存のワークフローとの互換性確保、インテグレーションの移行、トラフィックの段階的な切り替えは、いずれも新システムそのものを作るのに劣らず複雑な作業だからです。
Pandoの影響分析:Agent開発者と技術チームにとっての意味
Agent開発者への影響
- 検証能力がAgentの能力の上限を決める:Pandoでは、互換性テスト、決定論的シミュレーション、形式的な記述が用意され、Agentが信頼できるフィードバックを得られることを前提に、コア実装にもAgentを参加させています。
- Agentの役割が広がっている:コードを書く仕事から、エッジケースの継続的な発見、敵対的テスト、ユーザーの移行支援へと役割が広がっています。
技術責任者への影響
- AI Codingは下流工程の負荷を増幅する:コミット数の増加は、CI、コードレビュー、コードホスティングにも波及します。OpenAIは2026年7月の別の記事で、社内の週間PR数がそれ以前の第4四半期と比べて2倍以上に増え、コードレビューが新たなボトルネックの一つになったと明かしています。
- Pandoをむやみに自作する必要はない:大規模Monorepoのスケールに関する問題は、AI時代になって初めて生まれたものではありません。大多数のチームにとって、Gitのバックエンドを作り直す必要はありません。
Harness Engineeringの事例との比較
2026年2月、OpenAIは別の独立したプロジェクトを公開しました。空のリポジトリから始め、プロダクトコードをCodexが記述し、約5か月で100万行規模のコードと約1,500件のPRを生み出したプロジェクトです。初期には3人のエンジニアが主導しました。Pandoとはチームもプロセスも異なるため、データを混同することはできませんが、両者は同じ傾向を示しています。エンジニアは、システム設計、テスト環境の整備、Agentのワークフロー設計を担う機会が増えているのです。このプロジェクトからは、タスクを小さく分割する、各ブランチに独立した実行環境を用意する、Agentがログやメトリクスを参照できるようにする、ナレッジベース全体をプロンプトに詰め込むのではなくAGENTS.mdで指針を示す、といった知見が得られました。
Hacker Newsでは異なる意見も見られます。懐疑派はコミット数の増加が品質の向上を意味するわけではないと主張し、支持派はコードを書くコストが下がったことで、より多くの小規模プロジェクトが実現可能になったと考えています。これらはコミュニティの意見であり、統計的な結論ではありません。
Codex Agent チームの手法をどう取り入れるか:テスト駆動のフィードバックループ
Pando の取り組みで最も応用しやすいのは、規模ではなく「Agent が実行可能なフィードバックを受け取る」仕組みです。以下は、モデルがパッチを生成し、テスト結果をモデルに戻して修正を続ける、最小限のテスト駆動ループです。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="YOUR_CODING_MODEL",  # テストするプログラミングモデルに置き換える
    messages=[{"role": "user", "content": "根据以下失败测试修复函数:..."}]
)
print(resp.choices[0].message.content)
テストフィードバックループの実装全体を見る
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "你是严格遵守约束的工程 Agent。"
    "只修改指定文件,不得改动测试;输出完整的新文件内容。"
)

def run_tests() -> tuple[bool, str]:
    """実行可能な検証を行う。Pando の互換性テストに相当する"""
    r = subprocess.run(["pytest", "-q", "tests/"], capture_output=True, text=True)
    return r.returncode == 0, r.stdout[-3000:] + r.stderr[-1000:]

def agent_loop(target: str, spec: str, max_rounds: int = 5) -> bool:
    for i in range(max_rounds):
        ok, log = run_tests()
        if ok:
            print(f"第 {i} 轮:测试全部通过,等待人工审核")
            return True
        source = open(target, encoding="utf-8").read()
        resp = client.chat.completions.create(
            model="YOUR_CODING_MODEL",
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content":
                    f"需求与约束:\n{spec}\n\n当前代码:\n{source}\n\n测试输出:\n{log}"}
            ],
        )
        with open(target, "w", encoding="utf-8") as f:
            f.write(resp.choices[0].message.content)
    print("达到轮次上限,转交人类工程师处理")
    return False

agent_loop("src/ref_store.py", "同一分支的并发更新必须只有一个成功")
🚀 クイックスタート:このようなフィードバックループを構築する際は、まず APIYI apiyi.com で無料のテスト枠を取得し、同じ APIキーで複数のプログラミングモデルを切り替えながら、手元のテストセットで修正成功率を比較できます。
Pando の取り組みを一般のチームでも実践できるフレームワークにまとめると、次の表のようになります。これは公式の公開情報を基に整理した提案であり、OpenAI が公開した Pando 専用のワークフローではありません。
| 段階 | 主なアクション | 対応する Pando の実践 | 利用できるツール |
|---|---|---|---|
| 目標と境界を定める | 互換性を維持すべきプロトコルと、妥協できない指標を明確にする | Git プロトコルとの互換性を維持 | 設計文書、AGENTS.md |
| 検証環境を構築する | 互換性テスト、並行処理のシミュレーション、リグレッション検出 | Conformance テストと決定的シミュレーション | pytest、プロパティテスト、TLA+ |
| Agent が分担して実行する | タスクを小分けにし、独立したブランチで作業し、テストを自動実行する | 複数の Agent チームによる実装 | APIYI apiyi.com などを使った複数モデルの呼び出し |
| 人間がレビューする | 重要なトレードオフ、モジュール間の依存関係、セキュリティへの影響を確認する | 人間のエンジニアがアーキテクチャを管理 | コードレビューのルール |
| 段階的に本番導入する | 少量のトラフィックから始め、旧システムとの互換性を維持する | 読み書きを透過的に転送するプロキシ、段階的な移行 | カナリアリリース、監視指標 |
よくある質問 FAQ
Q1:Pando とは何ですか?
Pando は、OpenAI 内部で使われている Git 互換のサーバーサイドバックエンドで、モノレポでの開発活動全体を支えています。標準の Git プロトコルとクライアントを維持しながら、参照の更新、Packfile ストレージの再利用、キャッシュの配信を再設計しています。多数の Agent とエンジニアによる同時のコミットや読み取りに対応することが目的です。
Q2:Pando は一人で Codex を使って作ったのですか?
いいえ。公式の説明によると、一人のエンジニアがコアアーキテクチャを設計し、複数の Agent チームが実装し、少数のエンジニアがデプロイしました。参加人数、コードを人間が修正した割合、Agent の設定は公表されていません。また、すべてのコードを Codex が生成したとも、人間によるレビューがなかったとも述べられていません。
Q3:Pando はいつ稼働を開始しましたか?外部から利用できますか?
Pando は 2026 年 4 月に本番トラフィックの処理を開始し、技術記事は 2026 年 11 月 2 日に公開されました。2026 年 11 月 3 日時点で、サーバー、API、料金、一般公開日は発表されていません。公開されているのは OpenAI の Git クライアントのフォークと、一部のアップストリーム向けパッチのみであり、Pando サーバーがオープンソース化されたわけではありません。
Q4:すべての検証作業が 10 週間で完了したのですか?
そのようには言えません。公式によると、新しいモデルが登場するたびに継続して Pando の改善に活用されています。GPT-6 Astra の支援を受けた Lean/TLA+ による形式的検証、数百時間に及ぶ Agent セッション、敵対的テストがすべて最初の 10 週間に行われたかどうかは確認できません。公開された Git パッチの大半も、初回の本番稼働後に公開されています。
Q5:API を使って、同様の Agent テストフィードバックループを構築するにはどうすればよいですか?
まずは小さなモジュールから始めるのがおすすめです。
1. APIYI apiyi.com に登録し、APIキーと無料テスト枠を取得する
2. 実行可能なテストや互換性チェックを先に用意してから、モデルにコードを修正させる
3. 本文のコードを使い、base_url を `https://api.apiyi.com/v1` に設定して、「生成→テスト→ログのフィードバック」を繰り返す
OpenAI 互換のインターフェースなので、model パラメータを変更するだけで異なるモデルに切り替えられ、修正効果を比較しやすくなります。
Q6:一般のチームが Pando の方法をそのまま取り入れる場合、どのような制約がありますか?
主な制約は 3 つあります。第一に、公式はトークンやインフラの費用を公表しておらず、コストが不明です。第二に、Pando は質の高い検証体制に依存しており、テストのないプロジェクトで Agent に大量のコードを書かせると、リスクが高まります。第三に、10 週間という結果を同規模のすべてのプロジェクトに当てはめることはできません。まずは非中核モジュールで APIYI apiyi.com を少額から試し、フィードバックループが有効であることを確認してから、適用範囲を広げることをおすすめします。
Pando と Codex Agent の重要ポイント Key Takeaways
- Pando とは:OpenAI 内部の Git 互換バックエンド。約 10 週間で本番運用に入り、外部には公開されていません
- 開発の背景:Codex によって同時コミットが増え、旧システムで処理の遅延やマージの失敗などが発生しました
- 人間と Agent の分担:人間がアーキテクチャと制約を定め、Agent が実装と改善を繰り返し、エンジニアがデプロイを担当します
- 成功の鍵:互換性テスト、決定的シミュレーション、形式検証によって信頼できるフィードバックを得ました
- 時間軸の注意点:後から登場した新しいモデルや検証手法を、すべて最初の 10 週間に含めることはできません
- 本番導入の方法:読み書きを透過するプロキシと段階的なトラフィック切り替えにより、日常の開発を止めずに移行しました
- 始め方:まずテストを用意し、APIYI apiyi.com を通じて複数のモデルでフィードバックループを検証します
まとめ
Pando の事例から得られる重要なポイントは次のとおりです。
- 規模の拡大がインフラの変化を促す:AI Coding によるコミットの増加は、Git、CI、コードレビューにも影響します。Pando は、この負荷に対するエンジニアリング上の対応です。
- Agent の成果は検証に支えられる:Codex Agent チームがインフラの実装に参加できたのは、実行可能な互換性テスト、並行処理のシミュレーション、形式的な記述があったからです。
- 人間の判断は引き続き重要:アーキテクチャのトレードオフ、一貫性の境界、本番環境への移行は、いずれも人間のエンジニアが責任を持って判断しました。
多くのチームが取り入れられるのは、「10 週間」という数字ではなく、明確な制約、実行可能なテスト、タスクの分担、継続的なフィードバック、人間による重要な判断という 5 つの要素です。完全自動の開発を目指す必要はありません。まずはテストが整った小さなモジュールで Agent のフィードバックループを回し、徐々に範囲を広げていきましょう。
効果を手早く検証するには、APIYI apiyi.com の利用がおすすめです。OpenAI 互換のインターフェースと新規ユーザー向けの無料枠が提供されており、同じフィードバックループでさまざまなプログラミングモデルを比較できます。
📚 参考資料
- OpenAI 公式技術記事 Scaling Git at OpenAI:Pando のアーキテクチャ、移行、パフォーマンスデータの主な出典
- リンク:
openai.com/index/scaling-git-at-openai -
説明: 2026-11-02 公開。この記事の事実に関する主要な根拠
-
OpenAI Harness Engineering:Codex が主導して開発した別の社内プロジェクト
- リンク:
openai.com/index/harness-engineering -
説明: Agent エンジニアリングの方法論を理解するための資料。Pando のデータと混同しないこと
-
Custom Code Review Rules for Codex:AI Coding によって生じたコードレビューのボトルネック
- リンク:
developers.openai.com/blog/custom-code-review-rules-for-codex -
説明: 社内の週間 PR 件数の増加と AGENTS.md のレビュールールについて紹介
-
OpenAI 公開 Git フォーク:クライアントの改善を含むコードリポジトリ
- リンク:
github.com/openai/git -
説明: packfile-uri などの改善を含む。Pando のサーバー側ソースコードではない
-
OpenAI Git パッチ追跡:アップストリームへの貢献記録
- リンク:
oai-git.openai.chatgpt.site - 説明: 本番導入後も継続されているエンジニアリングの改善を確認できる
著者:APIYI 技術チーム
技術交流:APIYI のウェブサイトのトップページからお気軽にお問い合わせください。Agent 開発に関する詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください