Примечание автора: вызов gpt-6.1-sol прошёл успешно, но вернулся пустой текст ответа? В документации указано: completion_tokens — 300, и все они reasoning_tokens, а в тексте ответа ни одного слова. В этой статье разберём причины и два способа решения.
Если вы только что вызвали gpt-6.1-sol, API не вернул ошибку, а message.content оказался пустой строкой, не спешите грешить на сеть или модель. Загляните в usage ответа: completion_tokens — 300, reasoning_tokens — тоже 300, text_tokens — 0. То есть все 300 токенов ушли на рассуждения, а на сам текст не осталось ни одного.
Это не случайная мистика и не лень модели. В документации сказано, что процесс рассуждения и финальный текст в gpt-6.1-sol используют один и тот же лимит max_tokens. Если рассуждение ещё не закончилось, а лимит уже исчерпан, текст ответа обрезается целиком. Многие разработчики, вызывающие gpt-6.1-sol через APIYI (apiyi.com), при первом столкновении с этим явлением решают, что платформа дала сбой.
Это не очередная общая статья о моделях с рассуждением, а руководство по разбору конкретного симптома — «текст ответа пустой». Прочитав статью, вы поймёте, что означают эти цифры в usage, и сможете двумя изменениями на уровне параметров заставить модель нормально выдавать текст.
Главное о пустом ответе в gpt-6.1-sol
Сначала выводы, детали — дальше. Несколько ключевых пунктов из документации определяют, как вам стоит действовать при диагностике:
| Пункт | Что сказано в документации | Чем это полезно |
|---|---|---|
| Рассуждение и ответ делят один лимит | И процесс рассуждения, и финальный ответ в gpt-6.1-sol вычитаются из max_tokens |
Помогает понять корень пустого ответа |
| Все 300 токенов ушли на рассуждение | completion_tokens = 300, при этом reasoning_tokens = 300, а text_tokens = 0 |
Сразу определяете тип проблемы |
| Два внешних проявления | Код ошибки empty_response либо HTTP 200, но тело ответа — пустая строка |
Не попадаетесь на «ложный успех» |
| Повтор почти не помогает | Тот же промпт, тот же max_tokens — результат будет примерно таким же |
Экономите время |
Куда именно ушли эти 300 токенов
Чтобы понять пустой ответ, сначала нужно понять, как отвечает gpt-6.1-sol. Это модель с рассуждением: прежде чем приступить к ответу, она «пишет черновик» внутри себя — разбирает задачу, пробует варианты, проверяет себя. Этот черновик и есть то, что учитывается в reasoning_tokens.
Ключевой момент: по документации черновик и ответ — не два отдельных лимита, а один общий max_tokens. Когда max_tokens установлен примерно в диапазоне от 200 до 500, а задача действительно требует рассуждения, лимит легко расходуется уже на этапе размышления: рассуждение ещё не закончено, ответ ещё не начат, а лимит уже на нуле. В итоге вы получаете пустой текст ответа.
Цифры из документации говорят об этом предельно прямо:
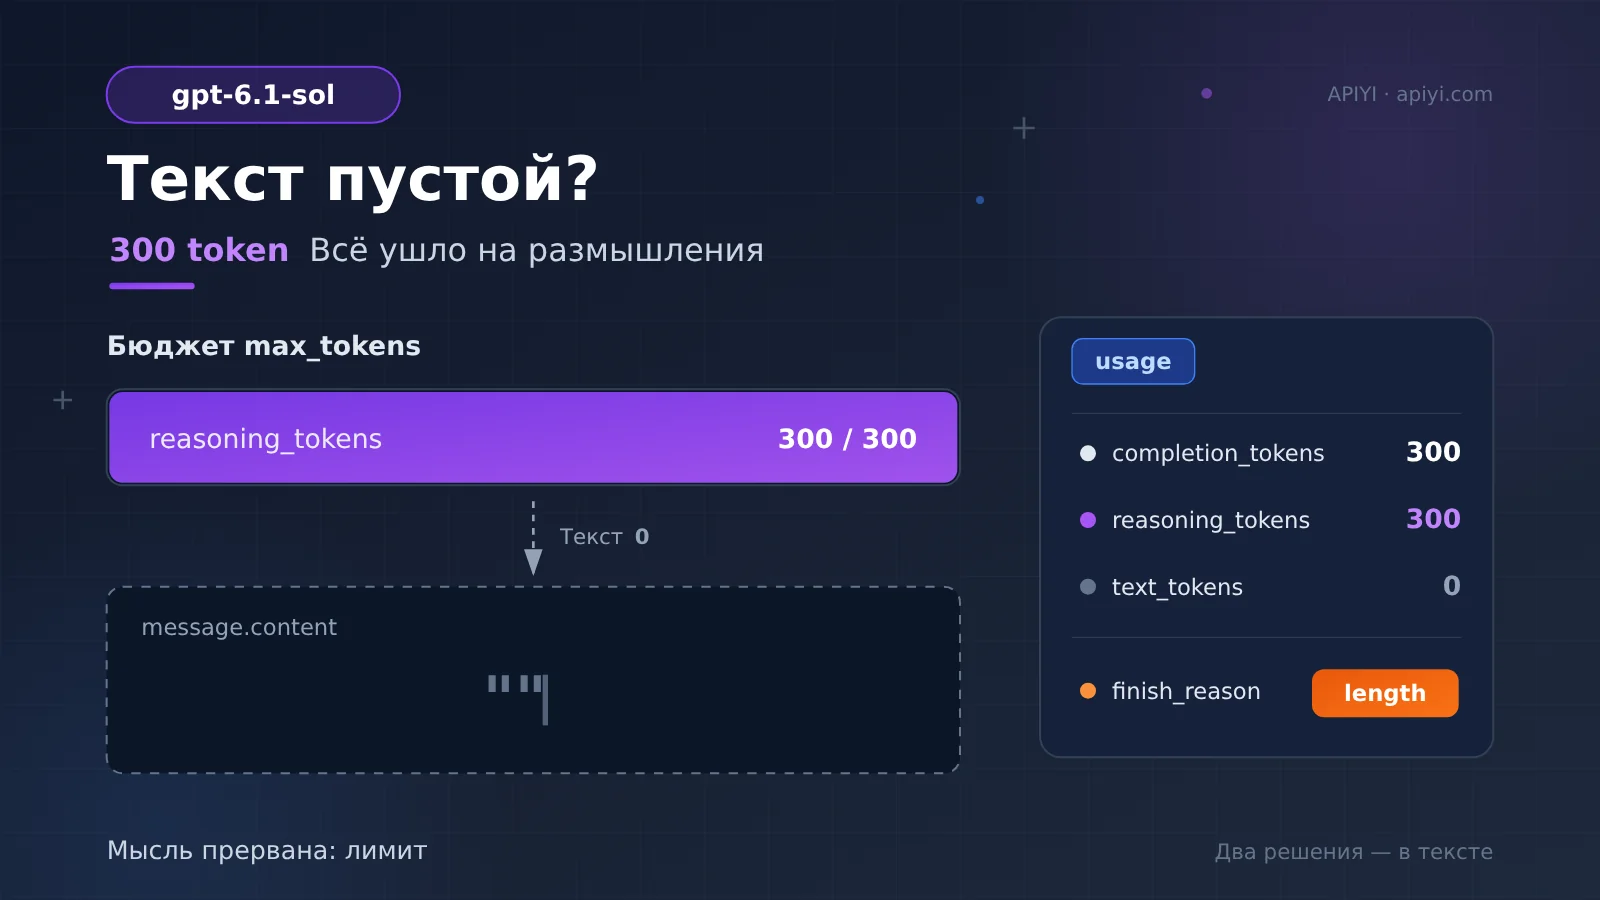
completion_tokens: 300 — весь объём генерации за этот запросreasoning_tokens: 300 — из них потрачено на рассуждениеtext_tokens: 0 — сколько реально ушло в текст ответаfinish_reason:length— остановка из-за достижения лимита длины, а не нормальное завершение
completion_tokens в точности равен reasoning_tokens, а text_tokens — ноль: это практически эталонная подпись ситуации «лимит целиком съеден рассуждением». Вместе с finish_reason = length это подтверждает: модель не «не захотела отвечать», а «не осталось лимита, чтобы ответить». И упёрлись мы в потолок, который как раз попадает в описанный в документации диапазон 200–500 — зону лёгкого исчерпания.
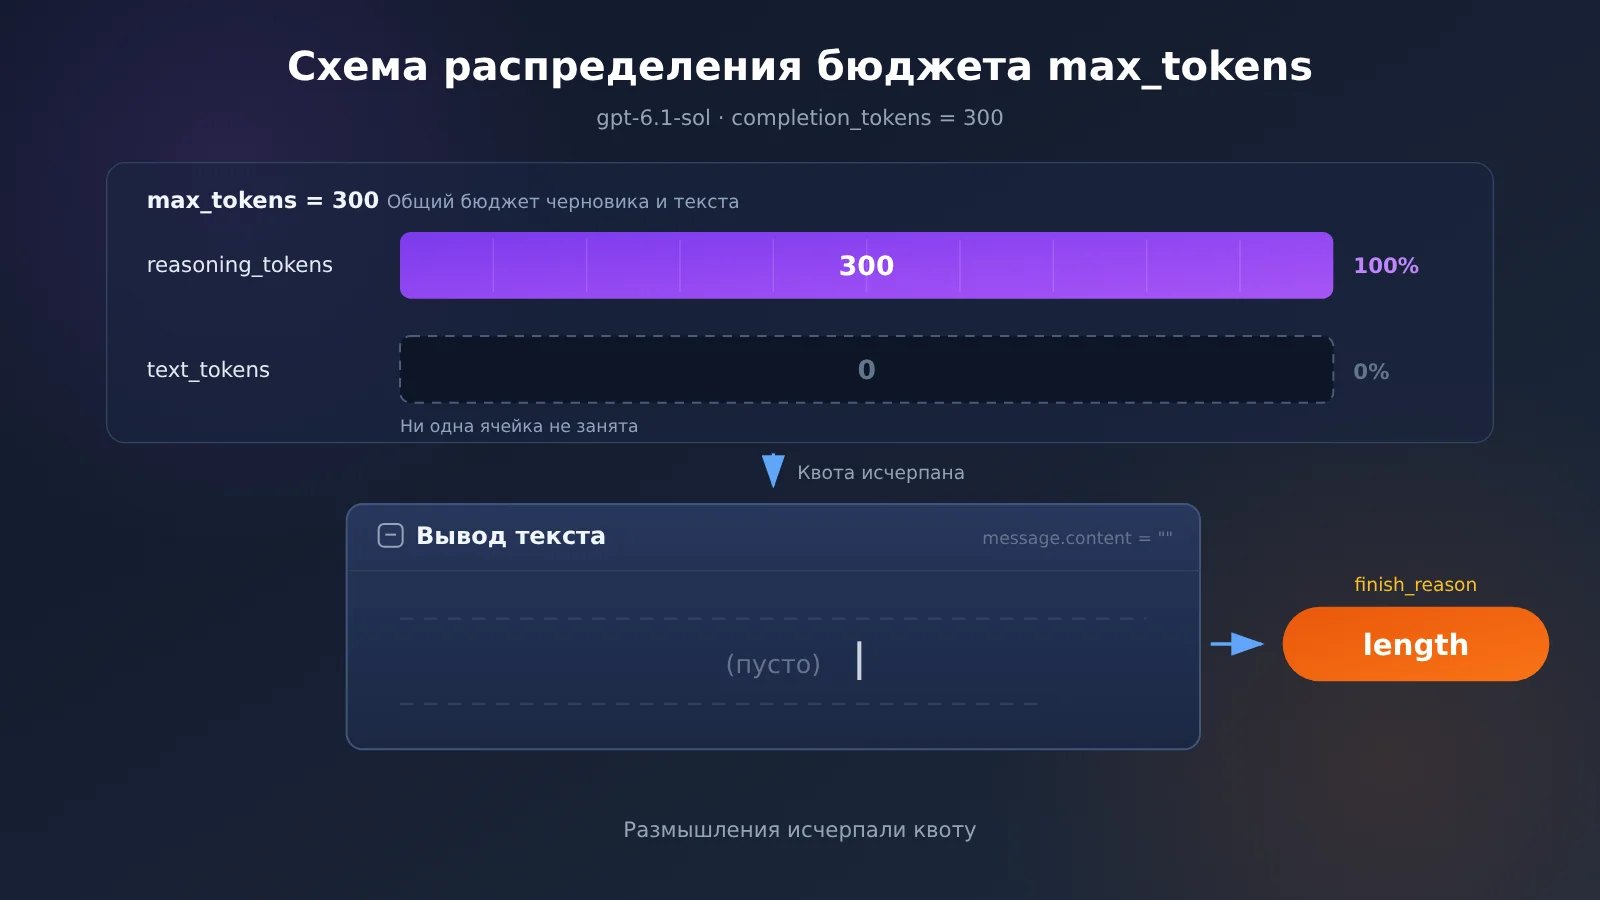
На схеме показано, как распределился бюджет этого вызова. Полные формулировки полей собраны в центре документации APIYI — советую сверяться с оригиналом и перепроверять детали, чтобы не менять параметры по памяти.
Два внешних проявления пустого ответа
Одна и та же причина на уровне интерфейса проявляется двояко, и оба случая описаны в документации. В первом — прямая ошибка с кодом empty_response, запрос явно помечается как аварийный. Во втором — «ложный успех»: HTTP 200, всё выглядит нормально, но message.content — пустая строка.
Второй случай сбивает с толку сильнее. Код состояния успешный, время выполнения в норме, и если не заглянуть в usage, то никак не обнаружишь, что тело ответа пустое. Поэтому при «интерфейс вернул успех, а содержимое пустое» первая реакция должна быть — проверить usage, а не сеть.
| Внешнее проявление | Что возвращается | По какому признаку определить |
|---|---|---|
| Прямая ошибка | Код ошибки empty_response |
Видно сразу |
| Ложный успех | HTTP 200, message.content — пустая строка |
Нужно проверять usage и finish_reason |
Как подтвердить причину пустого ответа у gpt-6.1-sol
Диагностика несложная, хватит четырёх шагов, причём начинать лучше с usage:
- Сравните
completion_tokensиreasoning_tokens. Если они равны, значит весь объём генерации ушёл на рассуждения, а телу ответа не досталось ни капли бюджета. - Проверьте, равен ли
text_tokensнулю. Ноль означает, что в тело не написано ни слова — это самое прямое доказательство. - Посмотрите, равен ли
finish_reasonзначениюlength. Если тамlength, а не нормальное завершение, значит модель остановил лимит. - Вспомните свою настройку
max_tokens. Если она попадает в диапазон 200–500, а задача требует рассуждений, — почти наверняка это ваш случай.
После подтверждения одно действие можно сразу отбросить — повтор запроса как есть. В документации указано, что при том же промпте и том же max_tokens повтор практически бесполезен. Потому что это не сетевой сбой, а неизбежный результат распределения бюджета: отправите ещё раз — бюджет останется тем же, и рассуждения снова его израсходуют первыми.
Если вы вызываете gpt-6.1-sol через агрегаторную платформу, точка входа для диагностики обычно выглядит так:
- Адрес платформы: APIYI apiyi.com
- Адрес интерфейса:
https://api.apiyi.com/v1 - Имя модели:
gpt-6.1-sol - Спецификация интерфейса: совместим с OpenAI, семантика параметров такая же, как у официального интерфейса
Совет: получите бесплатную тестовую квоту через APIYI apiyi.com и сравните ответы на один и тот же промпт при разных
max_tokens— за несколько минут станет ясно, что проблема в распределении бюджета, а не в самой модели.
Причина ясна — значит, и решение вытекает логично. Направлений всего два: либо оставить место для основного текста, либо заставить модель меньше «думать». Каждое решение подходит для своих задач, не стоит их смешивать.
Решение первое: увеличить max_tokens. В документации рекомендуют: для обычного диалога — от 2000, для сложных рассуждений или длинных текстов — от 16000. Эти цифры не с потолка: сам черновик рассуждений может быть немалым, а основному тексту ещё нужно дополнительное место, так что 2000 — это лишь стартовая планка для обычного диалога.
Решение второе: снизить reasoning_effort. Если задаче не нужны глубокие рассуждения — например, простое переписывание, преобразование формата, вопрос-ответ в одну строку — можно позволить модели «поменьше думать». Расход на этапе размышлений падает, и того же лимита уже хватает.
| Решение | Что делать | Когда подходит | Ожидаемый эффект |
|---|---|---|---|
Увеличить max_tokens |
Обычный диалог — от 2000; сложные рассуждения и длинные тексты — от 16000 | Задачи, где нужна полная проработка рассуждений | Устраняет причину |
Снизить reasoning_effort |
Уменьшить интенсивность рассуждений | Лёгкие задачи, где глубина рассуждений не важна | Сокращает расход на размышления |
| Повторить с прежними параметрами | Не менять ничего и отправить ещё раз | Практически бесполезно | Не рекомендуется |
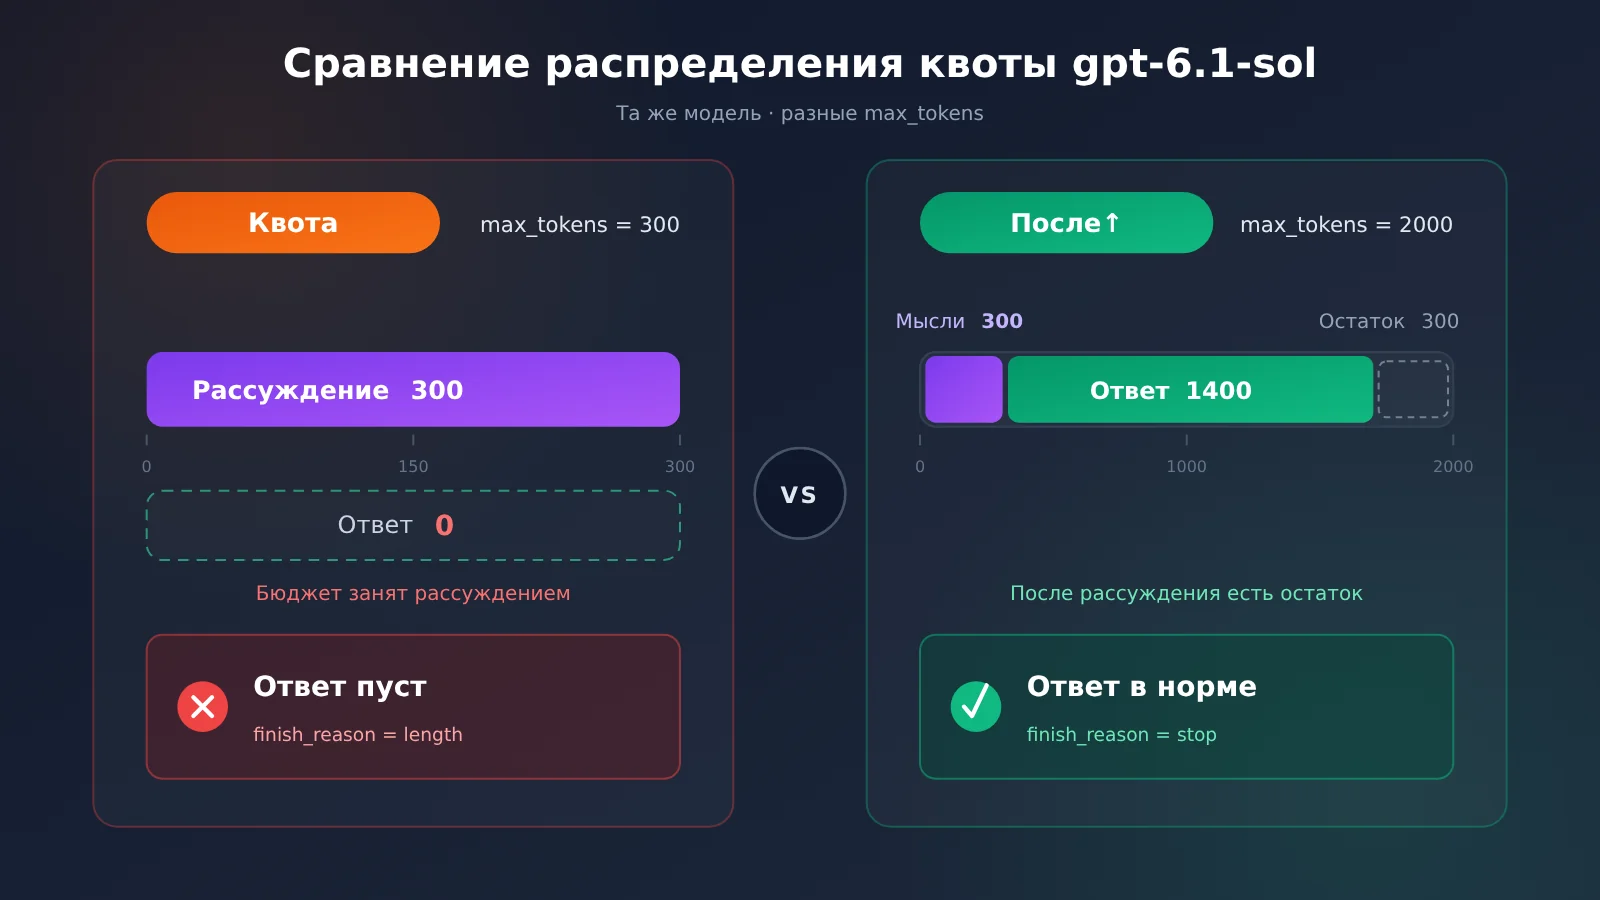
Разбор сравнения решений
Увеличить max_tokens — первый вариант, к которому стоит обратиться. Он не меняет способ мышления модели, просто делает «черновик» больше, и качество рассуждений от этого не страдает. После увеличения лимита рассуждения идут как обычно, а основному тексту достаётся собственный бюджет — так text_tokens естественным образом перестаёт быть нулём.
Снизить reasoning_effort подходит для другой ситуации: сама задача не требует глубоких размышлений, а модель по умолчанию выполняет полный цикл рассуждений. После снижения расход на рассуждения уменьшается, ответ приходит быстрее, но для сложных задач так делать не рекомендуется — сжатие глубины рассуждений может сказаться на качестве ответа.
Повторную попытку с исходными параметрами выделяю отдельно, потому что это самая распространённая ошибочная реакция. В документации сказано: с тем же промптом и тем же max_tokens повтор практически не помогает — это не вопрос везения, а арифметика. Разницу между двумя сценариями с картинки выше можно воспроизвести на платформе APIYI apiyi.com с тем же промптом — результат сравнения видно за две минуты.
Станет ли дороже, если увеличить max_tokens
Многие не решаются увеличить max_tokens, опасаясь, что счёт вырастет. Здесь в документации есть важное пояснение: max_tokens — это верхний предел, а не фактический расход; оплата считается по реально сгенерированным токенам.
Иными словами, поднять max_tokens с 300 до 2000 не значит, что каждый вызов будет тарифицироваться по 2000. Сколько ушло на рассуждения, сколько написано в основном тексте — столько и начисляется, неиспользованная часть лимита расходов не создаёт. По сути, увеличение лимита даёт основному тексту место, чтобы поместиться, а не означает предоплату более крупной суммы. APIYI apiyi.com работает по модели оплаты за фактический объём; конкретные тарифы смотрите на странице цен платформы, в этой статье мы цифры не приводим.
Частые вопросы о пустом тексте ответа у gpt-6.1-sol
Q1: Что такое пустой текст ответа у gpt-6.1-sol?
При вызове `gpt-6.1-sol` рассуждение и основной текст делят между собой один и тот же `max_tokens`. Рассуждение первым съедает весь лимит, основной текст обрезается целиком — в результате он пустой. В той группе цифр, что есть в документации, `completion_tokens` 300 — это всё `reasoning_tokens`, а `text_tokens` равен 0.
Q2: HTTP 200 тоже считается аномалией?
Да. По документации у пустого текста два проявления: либо ошибка с кодом `empty_response`, либо HTTP 200, но `message.content` — пустая строка. Успешный код состояния ещё не значит, что содержимое в порядке: смотреть надо вместе на `text_tokens` в usage и на `finish_reason`.
Q3: Почему повторные попытки не помогают?
По документации при том же промпте и том же `max_tokens` повторные попытки практически бесполезны. Распределение лимита детерминировано: бюджет не меняется — рассуждение всё равно потратит его первым. Чтобы изменить результат, нужно менять параметры, а не надеяться на удачу.
Q4: Это модель не ответила?
Это не отказ отвечать, а нехватка лимита на ответ. `finish_reason` со значением `length` говорит о том, что модель остановил верхний предел, а не она сама. Если увеличить `max_tokens`, на тот же вопрос уже придёт нормальный текст.
Q5: Какие настройки чаще всего приводят к этой проблеме?
По документации, если `max_tokens` стоит где-то в районе 200–500, а задача требует рассуждения, лимит выгорает уже на этапе размышлений. Для обычной чат-модели такого диапазона может хватить, а для рассуждающих моделей вроде `gpt-6.1-sol` его часто не хватает даже на черновик.
Q6: Как быстро проверить, что исправление сработало?
Рекомендую сделать сравнительную проверку на APIYI apiyi.com: зарегистрируйте аккаунт и получите бесплатный тестовый лимит, в поле адреса API укажите `https://api.apiyi.com/v1`, модель выберите `gpt-6.1-sol`, а дальше:
1. С тем же промптом отправьте запрос ещё раз, подняв `max_tokens` до 2000
2. Проверьте, что `text_tokens` больше 0
3. Проверьте, что в `message.content` есть текст ответа
Сравнение на одной платформе с одним и тем же промптом: переменная всего одна — параметр, и вывод получается самый чистый.
Q7: Увеличение max_tokens повысит стоимость?
Плата берётся не по верхнему пределу. По документации `max_tokens` — это лимит, а не фактический расход, и оплата считается по реально сгенерированным токенам. Сколько на самом деле生成илось (рассуждение плюс текст) — столько и спишется; конкретные цены смотрите на странице тарифов APIYI.
Q8: У моделей без рассуждения так же?
По документации у моделей без рассуждения такого пустого текста не бывает. Фазы размышлений нет, весь `max_tokens` уходит на основной текст, и при маленьком лимите ответ просто обрежется, а не станет пустым целиком. Это в том числе один из критериев, стоит ли менять модель.
gpt-6.1-sol: ключевые выводы о пустом теле ответа
- Корень проблемы с пустым телом: рассуждения и основной текст используют общий
max_tokens, и рассуждения расходуют лимит первыми - Признак для диагностики:
completion_tokensравенreasoning_tokens, аtext_tokensравен 0 - Два проявления: код ошибки
empty_responseлибо HTTP 200 с пустой строкой - Главное решение: для обычных диалогов — от 2000, для сложных рассуждений и длинных текстов — 16000 и выше
- Лёгкая альтернатива: снизить
reasoning_effort, чтобы сократить расход на рассуждения - Не тратьте силы впустую: повторные попытки с теми же параметрами практически бесполезны
- Логика биллинга:
max_tokens— это верхний предел, оплата идёт по фактически сгенерированным токенам
Резюме
Если оглянуться назад, ключевые моменты про пустое тело ответа у gpt-6.1-sol выглядят вполне ясно:
- Причина: рассуждения и основной текст делят один
max_tokens; те самые 300 токенов — целикомreasoning_tokens,text_tokensравен 0, аfinish_reason—length. - Исправление: увеличьте
max_tokens(для обычных диалогов от 2000, для сложных рассуждений — 16000 и выше) или снизьтеreasoning_effort; повтор с исходными параметрами практически бесполезен. - Биллинг:
max_tokens— это предел, а не фактический расход; оплата идёт по реально сгенерированным токенам, так что увеличивать его можно без сожалений.
В следующий раз, когда снова столкнётесь с «запрос успешен, а тело ответа пустое», сначала загляните в usage, потом проверьте finish_reason — и причину найдёте буквально за десять секунд. Рекомендую быстро проверить результат исправления через APIYI apiyi.com: платформа даёт бесплатную тестовую квоту и единый интерфейс для множества моделей — достаточно изменить один параметр, чтобы сразу всё сравнить.
Справочные материалы
- Центр документации APIYI: пояснение о пустом теле ответа у reasoning-моделей
- Ссылка:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
Описание: первоисточник о причинах пустого тела ответа, двух проявлениях и способах решения
-
Экспресс-документация APIYI: случай пустого тела ответа gpt-6.1-sol (2026-11)
- Ссылка:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - Описание: содержит источник той самой группы цифр
completion_tokens300 и рекомендуемых значенийmax_tokens
Автор: техническая команда APIYI
Техническая связь: будем рады, если вы свяжетесь с нами на главной странице сайта APIYI; больше материалов можно найти в центре документации docs.apiyi.com