ملاحظة المؤلف: استدعاء gpt-6.1-sol ينجح لكن النص المستلم فارغ؟ التوثيق يذكر أن completion_tokens البالغة 300 كلها reasoning_tokens، ولم يُكتب حرف واحد من النص. يشرح هذا المقال السبب وحلّين.
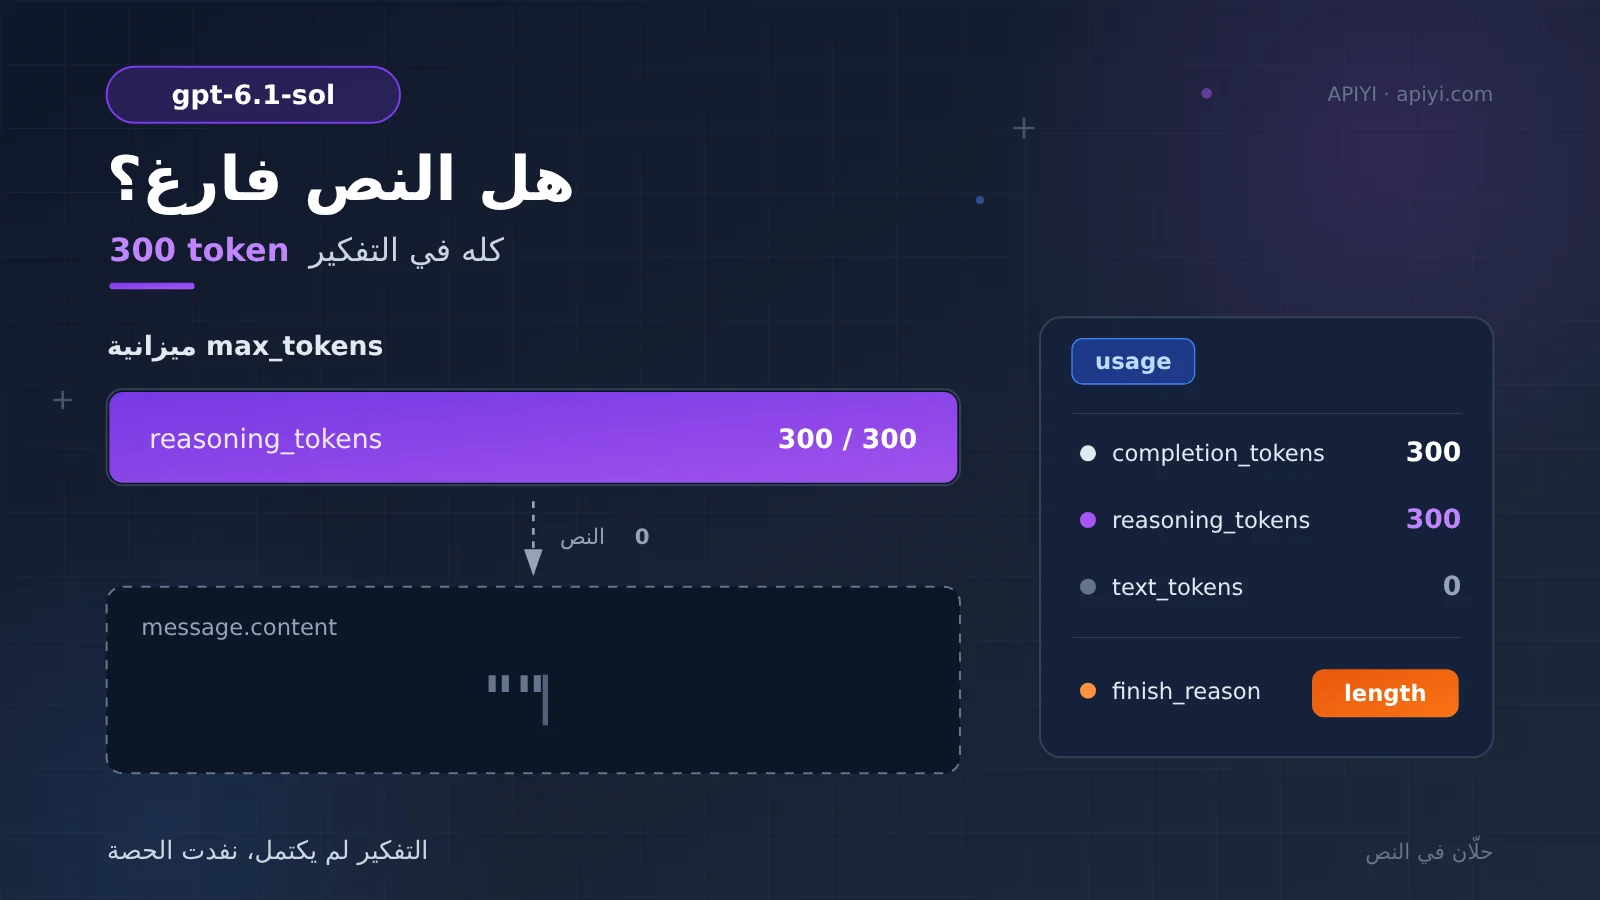
إذا كنت للتو قد استدعت gpt-6.1-sol، ولم تُرجع الواجهة أي خطأ، لكن message.content الذي حصلت عليه سلسلة فارغة، فلا تتعجل بالشك في الشبكة أو في أن النموذج معطّل. راجع usage في الاستجابة: completion_tokens تساوي 300، وreasoning_tokens تساوي 300 أيضًا، وtext_tokens تساوي 0. بمعنى أن هذه الـ 300 token صُرفت كلها في التفكير، ولم يُكتب حرف واحد من النص.
هذه ليست مشكلة عشوائية نادرة، ولا النموذج يتحايل. حسب التوثيق، تشترك عملية التفكير والنص النهائي في gpt-6.1-sol في السقف نفسه max_tokens، وعندما ينفد السقف قبل اكتمال التفكير، يُقطع النص بالكامل. كثير من المطورين الذين يستدعون gpt-6.1-sol عبر APIYI (apiyi.com) ظنوا عند أول مواجهة لهذه الظاهرة أن المنصة تعطّلت.
هذا ليس مقالًا آخر من مقالات التعريف العام بنماذج الاستدلال، بل دليل تشخيصي يستهدف عَرَضًا محددًا هو «النص فارغ». بعد قراءة هذا المقال ستتمكن من فهم ما تقوله تلك الأرقام في usage، وبتعديلين على مستوى المعاملات ستجعل النص يظهر بشكل طبيعي.
النقاط الأساسية لاستجابة فارغة من gpt-6.1-sol
لنبدأ بالخلاصة، ثم نفصّل التفاصيل لاحقًا. هناك عدة معلومات رئيسية موثّقة في الوثائق تحدد كيفية تشخيص المشكلة التي تواجهك:
| النقطة | ما تذكره الوثائق | قيمتها بالنسبة لك |
|---|---|---|
| التفكير والاستجابة يشتركان في نفس الحصة | عملية الاستدلال والاستجابة النهائية في gpt-6.1-sol تُخصَمان معًا من max_tokens |
فهم جذر الاستجابة الفارغة |
| 300 توكن كلها في التفكير | completion_tokens 300 يساوي reasoning_tokens 300، وtext_tokens يساوي 0 |
تمييز نوع المشكلة بنظرة واحدة |
| مظهران خارجيان | إما خطأ empty_response، أو HTTP 200 مع نص فارغ تمامًا |
لا تنخدع بـ”النجاح الزائف” |
| إعادة المحاولة لا تنفع غالبًا | نفس الموجه ونفس max_tokens، إعادة الإرسال تعطي نتيجة مشابهة |
توفير الوقت والجهد |
أين ذهبت هذه الـ300 توكن
لفهم الاستجابة الفارغة، عليك أولاً فهم طريقة إجابة gpt-6.1-sol. فهو نموذج استدلالي: قبل أن يبدأ الكتابة الفعلية، يقوم داخليًا بـ”مسودة أولية” — تفكيك المشكلة، تجربة مسارات، فحص ذاتي. هذه المسودة هي الجزء الذي يُحاسَب عليه في reasoning_tokens.
النقطة الجوهرية أن الوثائق تذكر أن المسودة والاستجابة ليستا حصتين مستقلتين، بل يشتركان في نفس max_tokens. عندما يُضبط max_tokens في نطاق حوالي 200 إلى 500، وتكون المهمة فعلًا تحتاج إلى استدلال، فمن السهل أن تُستهلك الحصة بالكامل في مرحلة التفكير: التفكير لم ينتهِ بعد، والاستجابة لم تبدأ، والحصة نفدت أولاً. وما يعود إليك حينها هو بالطبع نص فارغ.
الأرقام الواردة في الوثائق واضحة جدًا:
completion_tokens: 300 — إجمالي المخرجات المكتملة في هذه الجلسةreasoning_tokens: 300 — منها الجزء المستهلك في التفكيرtext_tokens: 0 — الجزء المكتوب فعلاً في الاستجابةfinish_reason:length— سبب التوقف هو الوصول إلى حد الطول، لا إكمال طبيعي
تساوي completion_tokens مع reasoning_tokens تمامًا، وعودة text_tokens إلى الصفر، هو تقريبًا التوقيع القياسي لـ”الحصة كلها أكلها التفكير”. ومع finish_reason بقيمة length، تتأكد أن النموذج ليس “لا يريد الإجابة”، بل “ليس لديه حصة للإجابة”. والحد الذي تم الاصطياد به هذه المرة يقع أيضًا ضمن نطاق 200 إلى 500 الذي تذكر الوثائق أنه سريع الاستنفاد.
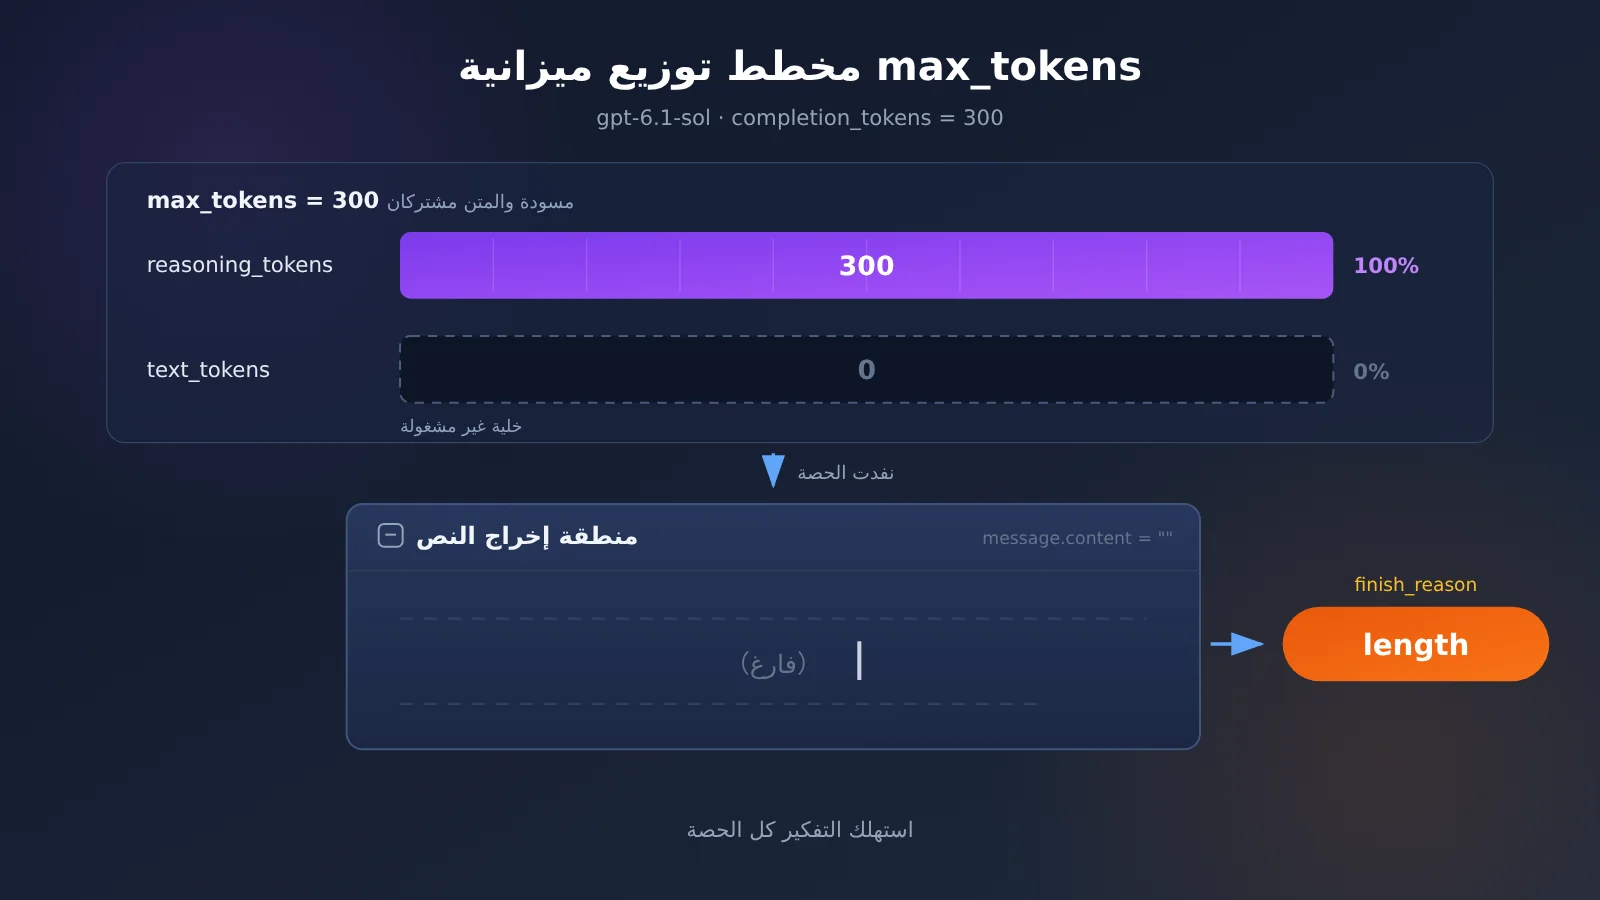
ما يصفه الرسم أعلاه هو بالفعل أسلوب توزيع الميزانية في هذه الاستدعاء. النص الكامل لمعاني الحقول متاح في مركز وثائق APIYI، ويُنصح بمقارنة النص الأصلي للتأكد من التفاصيل مرة أخرى، لتجنب تعديل المعاملات بناءً على الذاكرة.
المظهران الخارجيان للنص الفارغ
لنفس السبب مظهران على مستوى الواجهة، وقد وثّقت الوثائق كليهما. أحدهما خطأ مباشر، يُرجع رمز الخطأ empty_response، ويُصنّف الطلب بوضوح كاستجابة شاذة. والآخر “نجاح زائف”: HTTP 200، وكل شيء يبدو طبيعيًا، لكن message.content سلسلة فارغة.
النوع الثاني أكثر تضليلًا. رمز الحالة ناجح، والزمن المستغرق طبيعي، ولن تكتشف أن النص فارغ إلا إذا فحصت usage. لذلك عندما تواجه حالة “الواجهة ناجحة لكن المحتوى فارغ”، ينبغي أن يكون أول ما تفحصه هو usage، لا الشبكة.
| المظهر الخارجي | المحتوى المُرجَع | معيار الحكم |
|---|---|---|
| خطأ مباشر | رمز الخطأ empty_response |
مرئي للعين المجردة |
| نجاح زائف | HTTP 200، message.content سلسلة فارغة |
يجب فحص usage وfinish_reason |
كيف تتأكد من سبب النص الفارغ في gpt-6.1-sol
الاستقصاء ليس معقدًا، أربع خطوات تكفي، ويُفضّل أن تبدأ الفحص من usage:
- انظر هل
completion_tokensوreasoning_tokensمتساويان. التساوي يعني أن كمية التوليد كلها ذهبت إلى التفكير، ولم يحصل النص على أي حصة. - انظر هل
text_tokensيساوي 0. التصفير يعني أن النص لم يُكتب فيه حرف واحد، وهذا هو أوضح دليل. - انظر هل
finish_reasonيساويlength. أن يكونlengthوليس ختامًا طبيعيًا يعني أن النموذج أُوقَف عند الحد الأقصى. - تذكّر إعدادات
max_tokensالتي ضبطتها. إن كانت تقع في نطاق 200 إلى 500 وكانت المهمة تتطلب استدلالًا، فستنطبق عليك الحالة تمامًا.
بعد التأكد، هناك أمر يمكنك أن توفّر به الوقت فورًا: إعادة المحاولة كما هي. فقد وثّقت الوثائق أنه مع نفس الموجه ونفس max_tokens، لن تُجدي إعادة المحاولة نفعًا تقريبًا. لأن هذا ليس اضطرابًا في الشبكة، بل نتيجة حتمية لتوزيع الحصة — إن أرسلت الطلب مرة أخرى، ستكون الميزانية هي نفسها، وسيستهلكها التفكير أولًا.
إذا كنت تستدعي gpt-6.1-sol عبر منصة تجميع، فمدخل الاستقصاء عادة يبدو هكذا:
- عنوان المنصة: APIYI apiyi.com
- عنوان الواجهة:
https://api.apiyi.com/v1 - اسم النموذج:
gpt-6.1-sol - معيار الواجهة: متوافق مع OpenAI، ودلالات المعاملات مطابقة للواجهة الرسمية
نصيحة: احصل على حصة اختبار مجانية عبر APIYI apiyi.com، واستخدم نفس الفقرة من الموجه لمقارنة الاستجابات تحت قيم
max_tokensمختلفة، وستتمكن خلال دقائق من التأكد أن المشكلة في توزيع الحصة، لا في النموذج نفسه.
إصلاح سريع للنص الفارغ في gpt-6.1-sol: زد max_tokens أو خفّض reasoning_effort
بعد أن صار السبب واضحًا، تصبح الحلول منطقية، والاتجاهات اثنان فقط: إما أن توفّر مساحة للنص، أو أن تجعل التفكير يستهلك أقل. كل حل يناسب نوعًا مختلفًا من المهام، فلا تخلط بينهما.
الحل الأول: زيادة max_tokens. القيم المرجعية الواردة في التوثيق هي: المحادثات العادية تبدأ من 2000، ومهام الاستدلال المعقدة أو النصوص الطويلة 16000 فأكثر. هذا المقدار ليس رقمًا عشوائيًا — فمسودة الاستدلال نفسها قد تكون طويلة، والنص يحتاج مساحة إضافية، و2000 ليست سوى خط البداية للمحادثات العادية.
الحل الثاني: خفّض reasoning_effort. إذا كانت المهمة لا تحتاج استدلالًا عميقًا، مثل إعادة صياغة بسيطة أو تحويل تنسيق أو سؤال وجواب من جملة واحدة، فيمكنك أن تجعل النموذج «يفكر أقل». وعندما ينخفض استهلاك مرحلة التفكير، تكفي نفس الحصة.
| الخيار | الطريقة | الحالات المناسبة | الأثر المتوقع |
|---|---|---|---|
زيادة max_tokens |
المحادثات العادية من 2000؛ الاستدلال المعقد والنصوص الطويلة 16000 فأكثر | مهام تحتاج جودة استدلال كاملة | حل جذري |
خفض reasoning_effort |
تقليل شدة الاستدلال | المهام الخفيفة التي لا تتطلب عمقًا في الاستدلال | تقليل استهلاك التفكير |
| إعادة المحاولة بالمعاملات الأصلية | إرسال الطلب مرة أخرى دون تغيير أي شيء | بلا فائدة عمليًا | غير مستحسن |
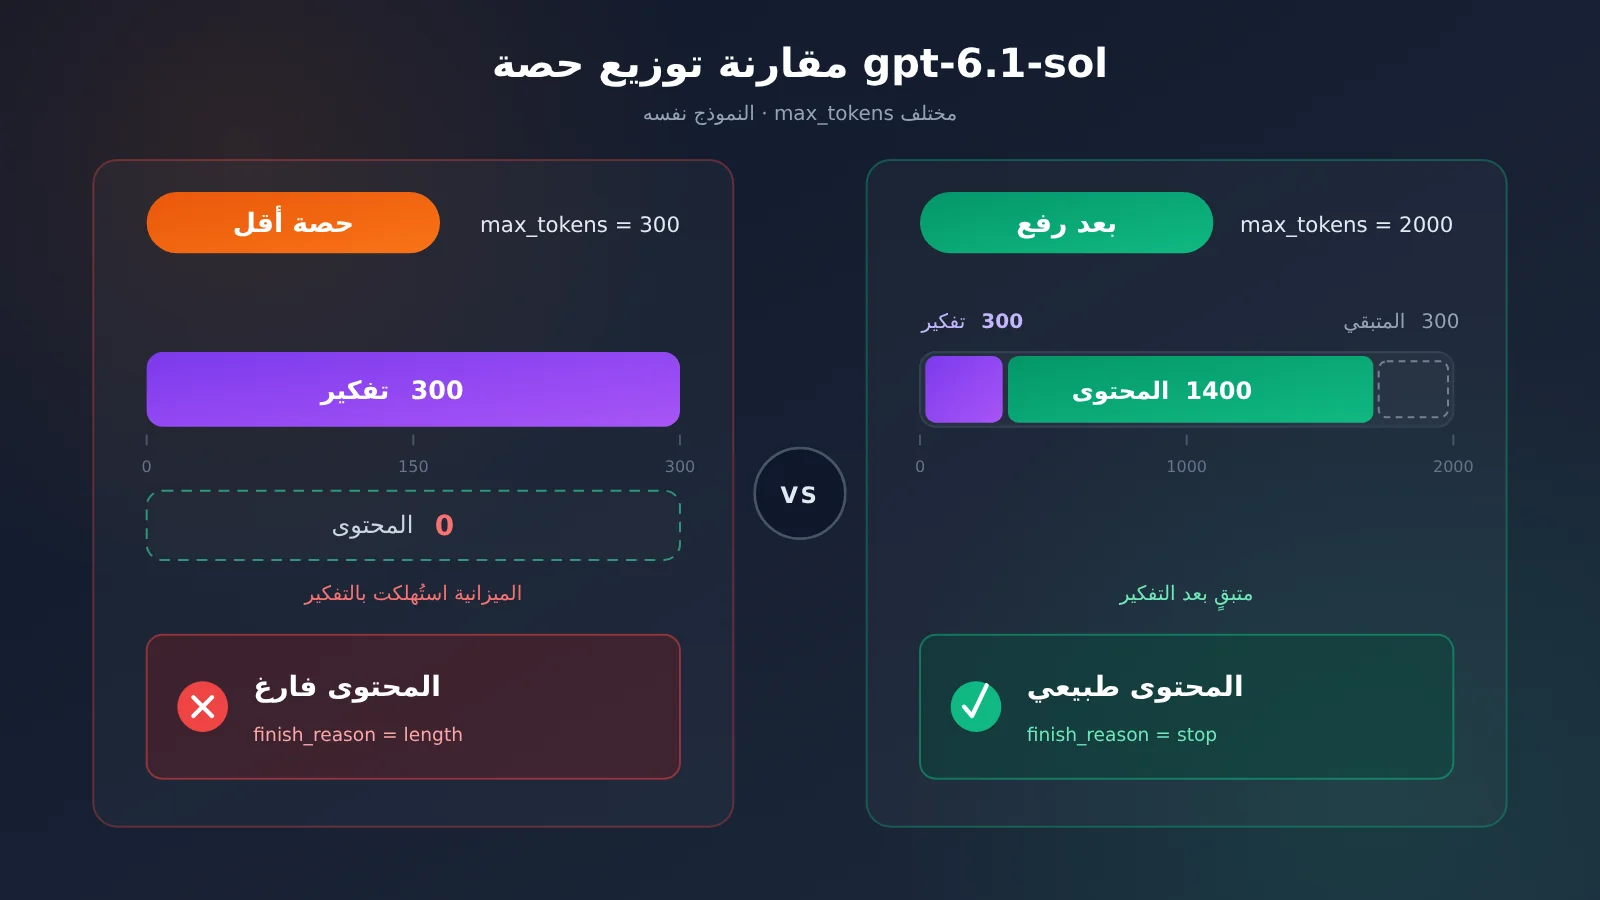
تفسير مقارنة الحلول
زيادة max_tokens هي الخيار المفضل. فهي لا تغيّر طريقة تفكير النموذج، بل تكتفي بتوسيع «ورقة المسودة»، فلا تتأثر جودة الاستدلال. وبعد رفع الحد الأعلى، يستمر التفكير كالمعتاد، ويحصل النص الأساسي على حصته الخاصة، ولن يبقى text_tokens صفرًا بطبيعة الحال.
تقليل reasoning_effort يناسب نوعًا آخر من الحالات: حين لا تتطلب المهمة تفكيرًا عميقًا، لكن النموذج يشغّل الاستدلال الكامل افتراضيًا. بعد التقليل يقل استهلاك التفكير وتصبح الاستجابة أسرع، لكن لا يُنصح بذلك في المهام المعقدة، إذ قد يؤثر ضغط عمق الاستدلال على جودة الإجابة.
إعادة المحاولة بالمعاملات الأصلية أفردناها بالذكر لأنها ردة الفعل الخاطئة الأكثر شيوعًا. توثّق الوثائق أن إعادة المحاولة بالـ موجه نفسه وmax_tokens نفسه لا تنفع عمليًا — فالمسألة ليست مسألة حظ، بل مسألة حساب. ويمكن أيضًا إعادة إنتاج الفرق بين السيناريوهين في الصورة أعلاه على منصة APIYI apiyi.com باستخدام الموجه نفسه، لترى نتيجة المقارنة في دقيقتين.
هل زيادة max_tokens أكثر تكلفة
كثيرون لا يجرؤون على زيادة max_tokens خوفًا من انفجار الفاتورة. وهنا توضح الوثائق نقطة أساسية: max_tokens حد أقصى وليس استهلاكًا فعليًا، والفوترة تُحسب حسب الـ tokens المولدة فعليًا.
بعبارة أخرى، رفع max_tokens من 300 إلى 2000 لا يعني أن كل استدعاء سيُفوتر على أساس 2000. ما استهلكه التفكير وما كتبه النص الأساسي هو ما يُحسب، والجزء غير المستخدم من الحد الأقصى لا يُولّد تكلفة. وجوهر رفع الحد الأقصى هو إتاحة مساحة بقاء للنص الأساسي، وليس دفع مبلغ أكبر مقدمًا. تعتمد APIYI apiyi.com نمط الفوترة حسب الاستخدام، والأسعار الفعلية وفقًا لصفحة الأسعار على المنصة، ولا يورد هذا المقال أرقامًا محددة.
الأسئلة الشائعة حول المحتوى الفارغ في gpt-6.1-sol
س1: ما المقصود بالمحتوى الفارغ في gpt-6.1-sol؟
عند استدعاء `gpt-6.1-sol`، تتشارك عملية التفكير والنص الأساسي في `max_tokens`. يستهلك التفكير الحصة أولًا، فيُقطع النص الأساسي بالكامل، وتكون النتيجة محتوى فارغًا. في مجموعة الأرقام المذكورة في التوثيق، كل قيم `completion_tokens` البالغة 300 هي `reasoning_tokens`، بينما `text_tokens` تساوي 0.
س2: هل يُعد HTTP 200 خطأ أيضًا؟
نعم. وفقًا للتوثيق، للمحتوى الفارغ مظهران: إرجاع رمز الخطأ `empty_response`، أو HTTP 200 لكن `message.content` سلسلة فارغة. لا يعني نجاح رمز الحالة أن المحتوى سليم؛ بل يجب الحكم بالجمع بين `text_tokens` و`finish_reason` في `usage`.
س3: لماذا لا تفيد إعادة المحاولة؟
وفقًا للتوثيق، مع الموجّه نفسه و`max_tokens` نفسه، لا تفيد إعادة المحاولة عمليًا. لأن توزيع الحصة حتمي: فالميزانية لا تتغير، وسيستهلك التفكير الحصة أولًا. لتغيير النتيجة، غيّر المعاملات لا الحظ.
س4: هل يعني ذلك أن النموذج لم يجرِ الإجابة؟
ليس رفضًا للإجابة، بل عدم وجود حصة للإجابة. تعني قيمة `finish_reason` المساوية لـ `length` أن النموذج أُوقِف بسبب الحد الأقصى، لا أنه توقف من تلقاء نفسه. بعد رفع `max_tokens`، يمكن الحصول على النص الأساسي للسؤال نفسه.
س5: ما الإعدادات الأكثر عرضة للمشكلة؟
وفقًا للتوثيق، عندما يُضبط `max_tokens` عند نحو 200 إلى 500 وتتطلب المهمة استدلالًا، تُستهلك الحصة في مرحلة التفكير. قد يكفي هذا النطاق لنموذج محادثة عادي، لكن بالنسبة لنموذج استدلالي مثل `gpt-6.1-sol`، غالبًا لا يكفي حتى لكتابة مسودة.
س6: كيف يمكن التحقق سريعًا من فعالية الإصلاح؟
يُنصح بإجراء تحقق مقارن على APIYI apiyi.com: سجّل حسابًا واحصل على حصة اختبار مجانية، وأدخل عنوان الواجهة `https://api.apiyi.com/v1`، واختر النموذج `gpt-6.1-sol`، ثم:
1. باستخدام الموجّه نفسه، اضبط `max_tokens` على 2000 ثم أعد الإرسال
2. تحقق مما إذا كانت `text_tokens` أكبر من 0
3. تحقق مما إذا كان `message.content` يحتوي على نص أساسي
عند المقارنة على المنصة نفسها وبالموجّه نفسه، يكون المتغير الوحيد هو المعامل، وتكون النتيجة أوضح.
س7: هل رفع max_tokens يزيد التكلفة؟
لن تُحتسب التكلفة على أساس الحد الأقصى. وفقًا للتوثيق، `max_tokens` حد أقصى وليس استهلاكًا فعليًا، وتُحتسب التكلفة حسب عدد tokens المولدة فعليًا. يُحتسب ما يُولَّد فعليًا من التفكير والنص الأساسي فقط، والسعر النهائي يعتمد على صفحة أسعار APIYI.
س8: هل يحدث هذا مع النماذج غير الاستدلالية أيضًا؟
تذكر الوثائق أن هذه المشكلة لا تظهر في النماذج غير الاستدلالية؛ فبما أنه لا توجد مرحلة تفكير، تُترك `max_tokens` بالكامل للمحتوى، وعند الحدود الصغيرة تكون النتيجة مجرد إجابة مقتصة لا محتوى فارغًا بالكامل. وهذا أيضًا أحد المعايير لتحديد ما إذا كان ينبغي تغيير النموذج.
النقاط الرئيسية لمشكلة المحتوى الفارغ في gpt-6.1-sol
- جذر المحتوى الفارغ: التفكير والمحتوى يتشاركان
max_tokens، ويستهلك التفكير الحصة أولاً. - علامة التشخيص:
completion_tokensيساويreasoning_tokens، وtext_tokensيساوي 0. - حالتان: رمز الخطأ
empty_response، أو استجابة HTTP 200 بسلسلة فارغة. - الحل المفضل: ابدأ من 2000 للمحادثات العادية، ومن 16000 فأكثر للاستدلال المعقد والنصوص الطويلة.
- بديل خفيف: خفّض
reasoning_effortلتقليل استهلاك التفكير. - لا تجهد نفسك بلا فائدة: إعادة المحاولة بالمعلمات نفسها غير مجدية أساسًا.
- منطق الفوترة:
max_tokensهو الحد الأعلى، وتُحتسب التكلفة وفق ما يتم توليده فعليًا.
الخلاصة
النقاط الأساسية حول مشكلة النص الفارغ في gpt-6.1-sol، عند مراجعتها، تبدو واضحة جدًا:
- السبب: التفكير والنص الرئيسي يتشاركان
max_tokens، وتلك المجموعة من الأرقام 300 كلهاreasoning_tokens، بينماtext_tokensتساوي 0، وfinish_reasonهيlength. - الإصلاح: زيادة
max_tokens(ابدأ من 2000 للمحادثة العادية، و16000 أو أكثر للتفكير المعقد)، أو تقليلreasoning_effort؛ إعادة المحاولة بالمعاملات الأصلية غالبًا لا تنفع. - الفوترة:
max_tokensهو حد أقصى وليس استهلاكًا، والفوترة تتم حسب الـ tokens المُولّدة فعليًا، فزيادته لا تستدعي القلق.
في المرة القادمة التي تصادف فيها “الواجهة تنجح لكن النص فارغ”، راجع أولاً usage، ثم انظر إلى finish_reason، وستتمكن من تحديد المشكلة في حوالي عشر ثوانٍ. ننصح بالتحقق السريع من نتيجة الإصلاح عبر APIYI apiyi.com، فالمنصة توفر رصيد اختبار مجاني وواجهة موحدة لعدة نماذج، ويكفي تغيير معامل واحد للمقارنة فورًا.
المراجع
- مركز توثيق APIYI: شرح النص الفارغ في نماذج التفكير
- الرابط:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
الوصف: السجل الأصلي لأسباب النص الفارغ، والمظهرين والحلول
-
نشرة توثيق APIYI: حالة النص الفارغ في gpt-6.1-sol (2026-11)
- الرابط:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - الوصف: مصدر مجموعة الأرقام الخاصة بـ
completion_tokens300 والقيم الموصى بها لـmax_tokens
المؤلف: فريق APIYI التقني
التبادل التقني: مرحبًا بك للاتصال بنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من المواد يمكنك زيارة مركز توثيق docs.apiyi.com