作者注:gpt-6.1-sol 调用成功却拿到空正文?文档记载 completion_tokens 300 全部是 reasoning_tokens,正文一个字没写,本文讲清原因与两个解法。
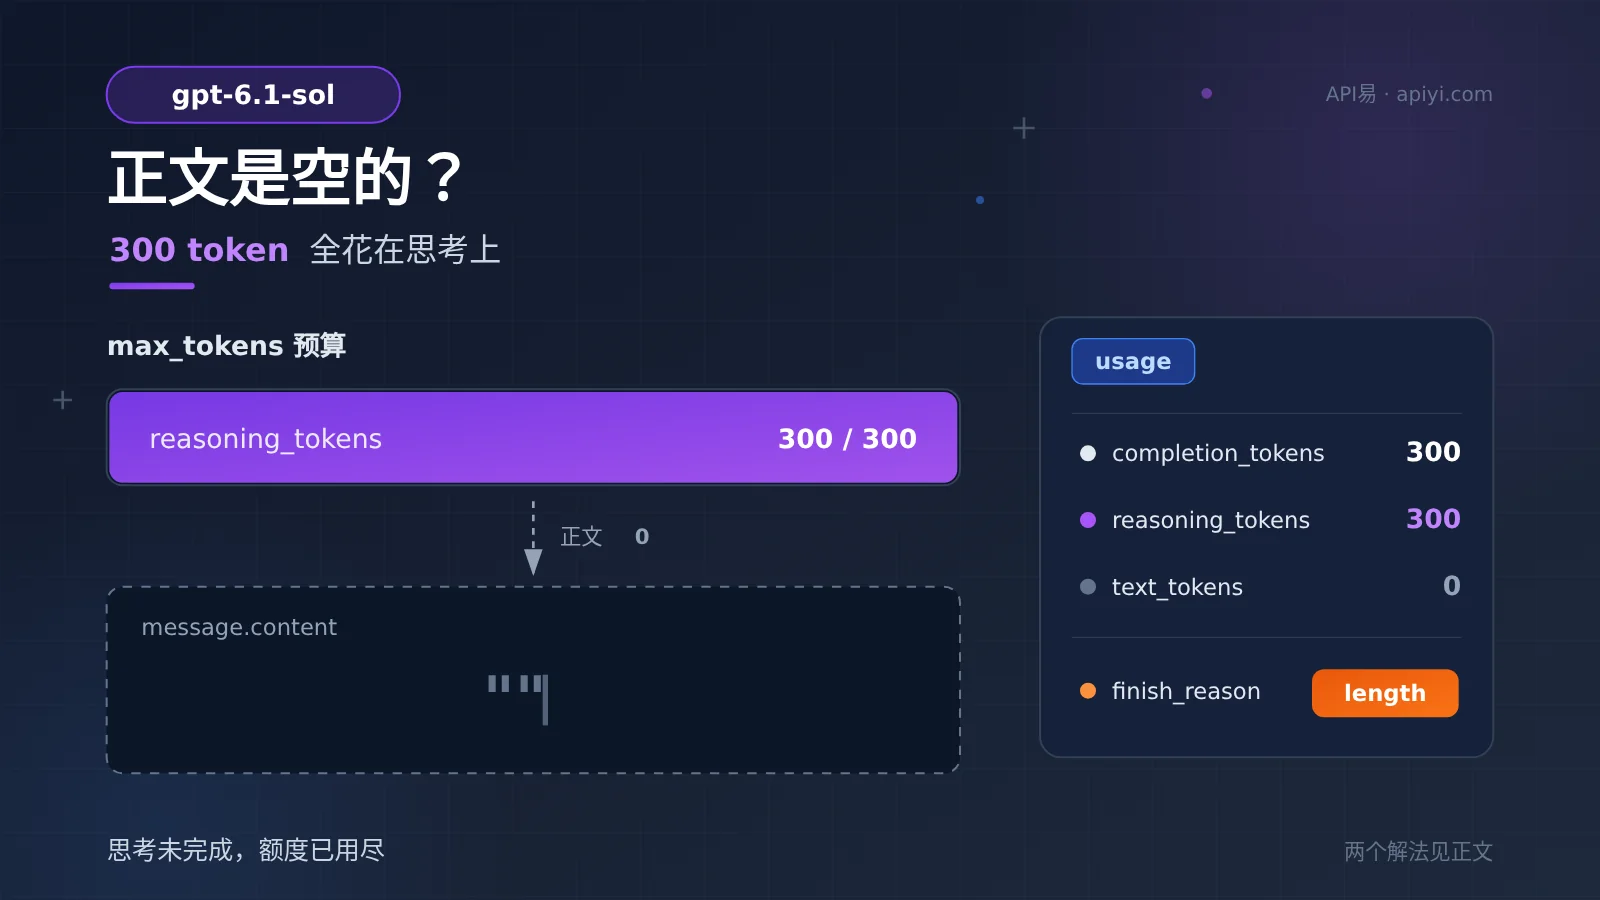
如果你刚调用完 gpt-6.1-sol,接口没报错,拿到的 message.content 却是一个空字符串,先别急着怀疑网络或者模型坏了。翻一下响应里的 usage:completion_tokens 是 300,reasoning_tokens 也是 300,text_tokens 是 0。也就是说,这 300 个 token 全部花在了思考上,正文一个字都没写。
这不是偶发的玄学问题,也不是模型在偷懒。文档记载,gpt-6.1-sol 的思考过程和最终正文共用同一个 max_tokens 额度,思考还没写完、额度先用完时,正文会被整体截断。不少在 API易(apiyi.com)上调用 gpt-6.1-sol 的开发者,第一次遇到这个现象时,都以为是平台出了故障。
这不是又一篇泛泛的推理模型科普,而是一篇针对“正文是空的”这个具体症状的排查指南。读完本文,你能看懂 usage 里那组数字在说什么,并且用两个参数层面的改动,让正文正常吐出来。
gpt-6.1-sol 空正文的核心要点
先给结论,细节后面展开。文档记载的几条关键信息,决定了你接下来该怎么排查:
| 要点 | 文档记载的说明 | 对你的价值 |
|---|---|---|
| 思考与正文共用额度 | gpt-6.1-sol 的推理过程和最终回答都从 max_tokens 里扣 |
理解空正文的根源 |
| 300 token 全在思考 | completion_tokens 300 等于 reasoning_tokens 300,text_tokens 为 0 |
一眼判断问题类型 |
| 两种外在表现 | 报 empty_response 错误码,或 HTTP 200 但正文为空字符串 |
不被“假成功”迷惑 |
| 重试基本无效 | 同样的提示词、同样的 max_tokens,再发一次结果差不多 |
少走弯路 |
这 300 token 都花在了哪里
要理解空正文,得先理解 gpt-6.1-sol 的回答方式。它属于推理模型:正式动笔之前,会先在内部“打草稿”——拆解问题、尝试路径、自我检查。这份草稿,就是 reasoning_tokens 记账的部分。
关键在于,文档记载,草稿和正文不是两份独立额度,而是共用同一个 max_tokens。当 max_tokens 设在大约 200 到 500 的区间、任务又确实需要推理时,额度很容易在思考阶段就被用光:思考还没写完,正文还没开始,额度先见了底。返回给你的,自然是一段空白的正文。
文档里的那组数字说得非常直白:
completion_tokens:300——本次完成的全部生成量reasoning_tokens:300——其中花在思考上的部分text_tokens:0——真正写给正文的部分finish_reason:length——停止原因是撞到长度上限,而不是正常收尾
completion_tokens 与 reasoning_tokens 完全相等,text_tokens 归零,这几乎就是“额度全被思考吃掉”的标准签名。再配合 finish_reason 为 length,可以确认模型不是“不想答”,而是“没额度答”。本次撞到的上限,也正好落在文档说的 200 到 500 这个易耗尽区间之内。
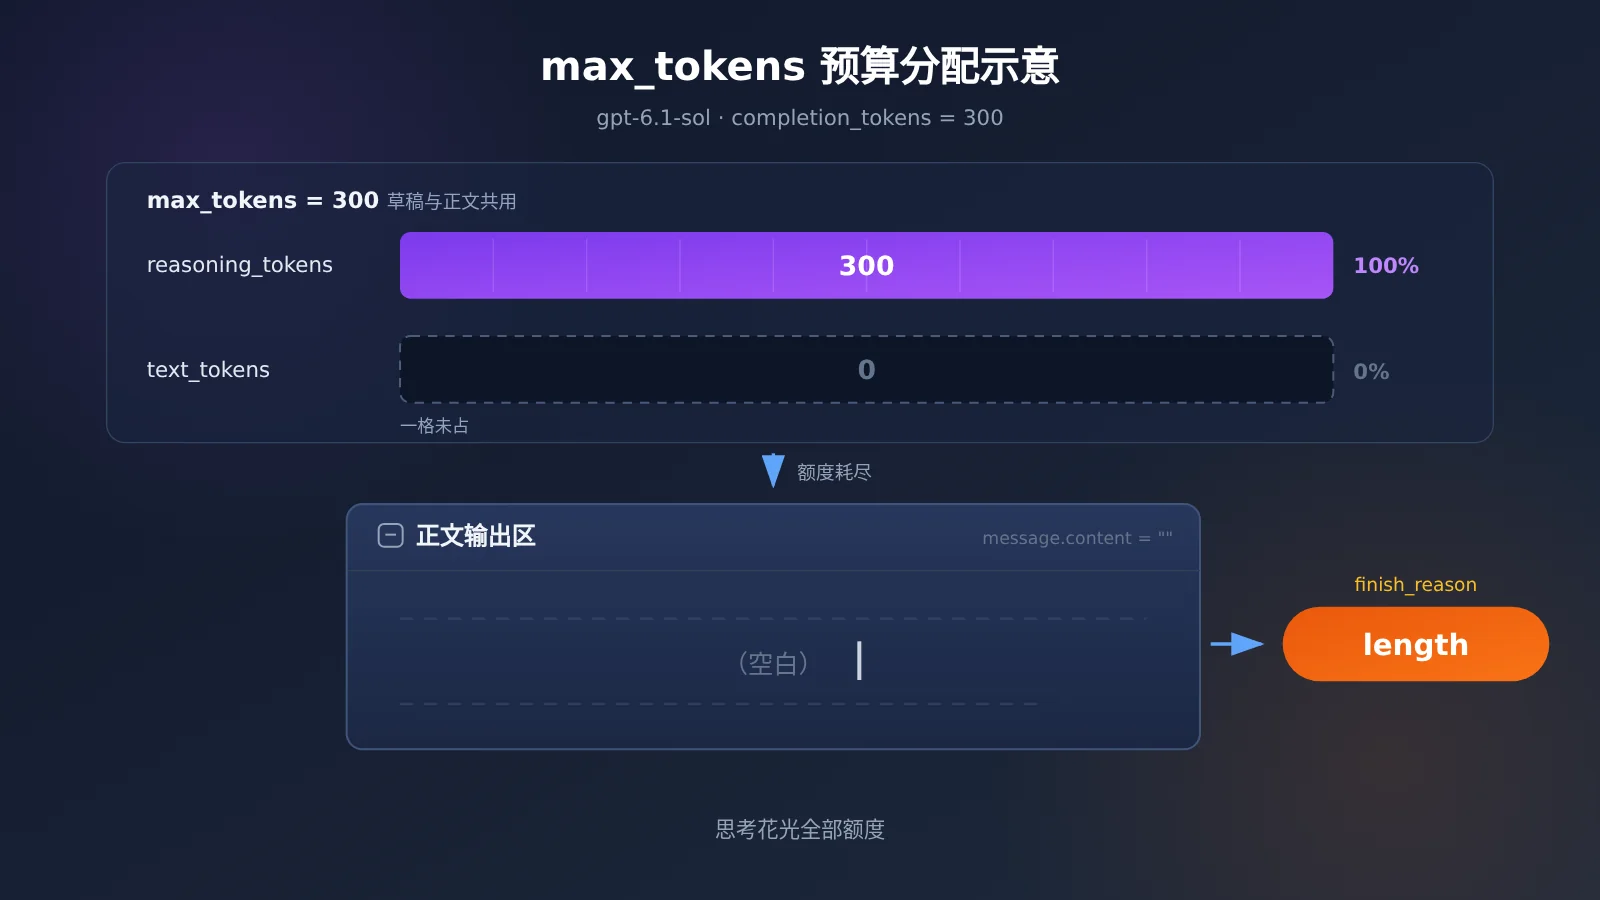
上图描述的就是这次调用的预算分配方式。字段含义的完整原文收录在 API易 文档中心,建议对照原文再确认一遍细节,避免凭印象改参数。
空正文的两种外在表现
同一个原因,在接口层面有两种表现,文档都做了记载。一种是直接报错,返回错误码 empty_response,请求被明确标记为异常。另一种是“假成功”,HTTP 200,一切看起来正常,但 message.content 是空字符串。
第二种更容易误导人。状态码是成功的,耗时也正常,不翻 usage 根本发现不了正文是空的。所以遇到“接口成功但内容为空”,第一反应应该是查 usage,而不是查网络。
| 外在表现 | 返回内容 | 判断依据 |
|---|---|---|
| 直接报错 | 错误码 empty_response |
一眼可见 |
| 假成功 | HTTP 200,message.content 为空字符串 |
需要检查 usage 与 finish_reason |
如何确认 gpt-6.1-sol 空正文的原因
排查不复杂,四步就够,顺序建议从 usage 查起:
- 看
completion_tokens与reasoning_tokens是否相等。相等说明生成量全部用于思考,正文没有分到任何额度。 - 看
text_tokens是否为 0。归零说明正文一个字都没写,这是最直接的证据。 - 看
finish_reason是否为length。是length而不是正常收尾,说明模型是被上限截停的。 - 回忆自己的
max_tokens设置。落在 200 到 500 区间、任务又需要推理,基本就能对号入座。
确认之后,有一件事可以立刻省掉:原样重试。文档记载,同样的提示词、同样的 max_tokens,重试基本没用。因为这不是网络抖动,而是额度分配的必然结果——再发一次,预算还是那么多,思考还是会先把它花完。
如果你是通过聚合平台调用 gpt-6.1-sol,排查入口通常长这样:
- 平台地址:API易 apiyi.com
- 接口地址:
https://api.apiyi.com/v1 - 模型名称:
gpt-6.1-sol - 接口规范:OpenAI 兼容,参数语义与官方接口一致
建议:通过 API易 apiyi.com 获取免费测试额度,用同一段提示词对比不同
max_tokens下的返回,几分钟就能确认问题出在额度分配,而不是模型本身。
gpt-6.1-sol 空正文快速修复:调大 max_tokens 或降低 reasoning_effort
原因明确了,解法就顺理成章,方向只有两个:给正文留出空间,或者让思考少花一点。两个解法分别适合不同任务,别混着用。
解法一:调大 max_tokens。文档给出的参考值是:普通对话从 2000 起,复杂推理或长文任务 16000 以上。这个量级不是随手拍的——推理草稿本身可能就不短,正文还需要额外空间,2000 只是普通对话的起步线。
解法二:降低 reasoning_effort。如果任务不需要深度推理,比如简单改写、格式转换、一句话问答,可以让模型“少想一点”。思考阶段的消耗降下来,同样的额度也就够用了。
| 方案 | 做法 | 适用场景 | 预期效果 |
|---|---|---|---|
调大 max_tokens |
普通对话 2000 起;复杂推理、长文 16000 以上 | 需要完整推理质量的任务 | 根治 |
降低 reasoning_effort |
调低推理强度 | 轻任务、对推理深度要求不高 | 减少思考消耗 |
| 原参数重试 | 什么都不改再发一次 | 基本无效 | 不推荐 |
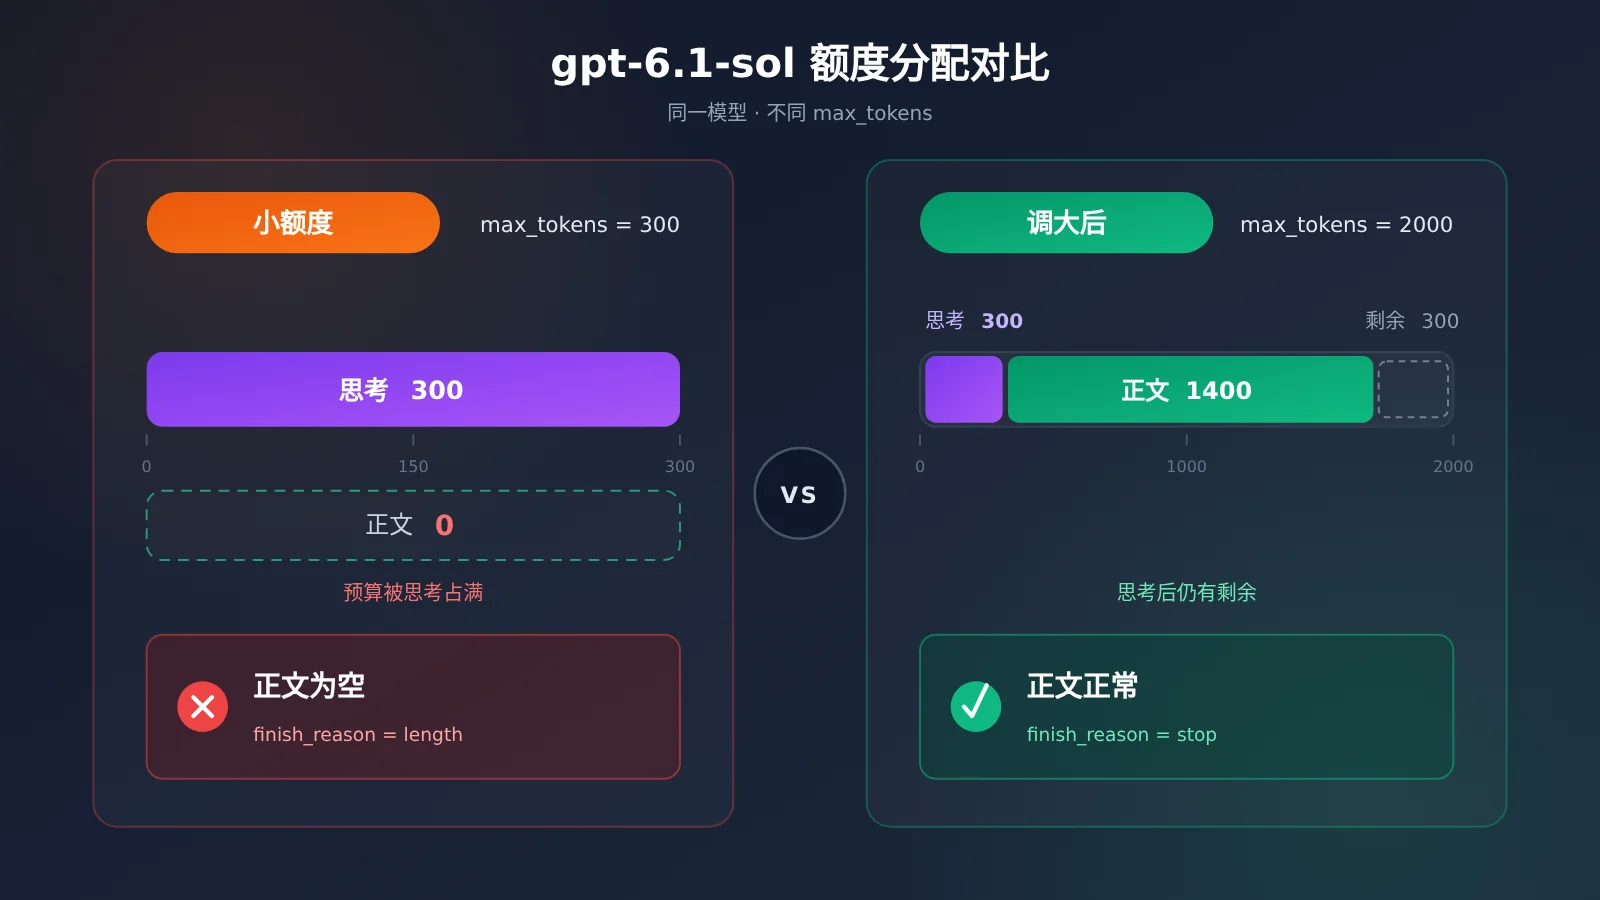
解法对比解读
调大 max_tokens 是首选方案。它不改变模型的思考方式,只是把“草稿纸”换大,推理质量不受影响。上限调大之后,思考照常进行,正文也能分到自己的额度,text_tokens 自然不再是 0。
降低 reasoning_effort 适合另一类场景:任务本身不需要深度思考,模型却默认跑了完整推理。调低之后思考消耗减少、响应更快,但复杂任务不建议这么做,推理深度被压缩可能影响答案质量。
原参数重试 单独拎出来说,是因为它是最常见的错误反应。文档记载,同样的提示词、同样的 max_tokens,重试基本没用——这不是运气问题,是算术问题。上图两种场景的差异,也可以在 API易 apiyi.com 平台上用同一提示词复现,两分钟就能看到对比结果。
调大 max_tokens 会更贵吗
很多人不敢调大 max_tokens,是怕账单爆炸。这里文档有一句关键说明:max_tokens 是上限,不是实际消耗,计费按实际生成的 token 计算。
换句话说,把 max_tokens 从 300 调到 2000,不代表每次调用都按 2000 收费。思考用了多少、正文写了多少,就计多少,上限没用完的部分不产生费用。调大上限的本质是给正文留出生存空间,而不是预付一笔更大的开支。API易 apiyi.com 采用按量计费的模式,具体单价以平台价格页为准,本文不引用具体数字。
gpt-6.1-sol 空正文常见问题 FAQ
Q1:什么是 gpt-6.1-sol 的空正文?
调用 `gpt-6.1-sol` 时,思考过程和正文共用 `max_tokens`。思考先花光额度,正文被整体截断,结果就是空的。文档记载的那组数字里,`completion_tokens` 300 全部是 `reasoning_tokens`,`text_tokens` 为 0。
Q2:HTTP 200 也算异常吗?
算。文档记载,空正文有两种表现:报 `empty_response` 错误码,或者 HTTP 200 但 `message.content` 是空字符串。状态码成功不代表内容正常,要结合 usage 里的 `text_tokens` 和 `finish_reason` 一起判断。
Q3:为什么重试没用?
文档记载,同样的提示词、同样的 `max_tokens`,重试基本没用。因为额度分配是确定性的:预算不变,思考还是会先花完。想改变结果,得改参数,而不是改运气。
Q4:是模型没回答吗?
不是拒绝回答,而是没额度回答。`finish_reason` 为 `length` 说明模型是被上限截停的,不是主动停止。把 `max_tokens` 调大后,同样的提问就能拿到正文。
Q5:什么样的设置最容易踩坑?
文档记载,`max_tokens` 设成大约 200 到 500、任务又需要推理时,就会在思考阶段耗尽。这个区间对普通对话模型可能够用,但对 `gpt-6.1-sol` 这类推理模型,往往连草稿都写不完。
Q6:如何快速验证修复有效?
推荐在 API易 apiyi.com 上做对比验证:注册账号获取免费测试额度,接口地址填 `https://api.apiyi.com/v1`,模型选 `gpt-6.1-sol`,然后:
1. 用同一段提示词,`max_tokens` 调到 2000 再发一次
2. 检查 `text_tokens` 是否大于 0
3. 检查 `message.content` 是否有正文
同平台同提示词对比,变量只有一个参数,结论最干净。
Q7:调大 max_tokens 会增加费用吗?
不会按上限收费。文档记载,`max_tokens` 是上限,不是实际消耗,计费按实际生成的 token 算。思考加正文实际生成多少,就计多少,具体单价以 API易 价格页为准。
Q8:非推理模型也会这样吗?
文档记载,非推理模型不会出现这种空正文。因为没有思考阶段,`max_tokens` 全部留给正文,小额度的结果只是回答被截短,而不是整体为空。这也是判断该不该换模型的依据之一。
gpt-6.1-sol 空正文核心要点 Key Takeaways
- 空正文根源:思考与正文共用
max_tokens,思考先花光额度 - 判断签名:
completion_tokens等于reasoning_tokens,text_tokens为 0 - 两种表现:
empty_response错误码,或 HTTP 200 空字符串 - 首选解法:普通对话 2000 起,复杂推理、长文 16000 以上
- 轻量替代:降低
reasoning_effort,压缩思考消耗 - 别做无用功:同参数重试基本无效
- 计费逻辑:
max_tokens是上限,按实际生成计费
总结
gpt-6.1-sol 空正文的核心要点,回头看其实很清晰:
- 原因:思考与正文共用
max_tokens,那组 300 的数字全是reasoning_tokens,text_tokens为 0,finish_reason为length。 - 修复:调大
max_tokens(普通对话 2000 起,复杂推理 16000 以上),或降低reasoning_effort;原参数重试基本无效。 - 计费:
max_tokens是上限不是消耗,按实际生成的 token 计费,调大不必心疼。
下次再遇到“接口成功但正文是空的”,先翻 usage,再看 finish_reason,基本十秒内就能定位。推荐通过 API易 apiyi.com 快速验证修复效果,平台提供免费测试额度和多模型统一接口,改一个参数就能立刻对比。
参考资料
- API易文档中心:推理模型空正文说明
- 链接:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
说明:空正文的原因、两种表现与解法的原始记载
-
API易文档速递:gpt-6.1-sol 空正文案例(2026-11)
- 链接:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - 说明:包含
completion_tokens300 那组数字与max_tokens建议值的出处
作者:APIYI 技术团队
技术交流:欢迎在 APIYI 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心