
著者注:OpenAI Signals v3.0 が公開した165種類の仕事活動における ChatGPT 利用データを読み解き、統計の定義を整理したうえで、開発者や企業の AI 活用にとっての参考価値を分析します。
2026年10月26日、OpenAI の経済研究チームは『ChatGPT’s expanding world of work』(中国語の公式タイトルは『ChatGPT 不断拓展的工作版图』)を公開し、約100の国と地域、165種類の仕事活動、7四半期連続にわたる ChatGPT 利用データを明らかにしました。このデータは OpenAI Signals v3.0 計画の一環で、CC BY 4.0 ライセンスのもとで無料ダウンロードが可能になっており、研究者は CSV をそのまま二次分析に活用できます。
これは新しいモデルや新機能のリリースではありません。研究者向けの経済利用データセットです。公式発表、データ辞書、そして第三者のメディアによる元 CSV の検証がすでに揃っており、数値の定義は互いに裏付けが取れます。本記事では公式の結論と第三者による計算を明確に区別し、「メッセージ占有率」を「職種の代替」と誤読しないようにします。
核心的な価値:OpenAI の165種類の仕事活動データが何を統計し、何を発見したのか、そして AI アプリ開発者にとってどんな実用的な意味があるのかを数分で理解できます。
OpenAI 165種類の作業活動データ 主要情報の早見表
まずは表で、今回のChatGPT利用データ公開に関する基本情報を整理します。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026年10月26日 |
| 公開元 | OpenAI 経済研究チーム(OpenAI Signals v3.0) |
| 分類体系 | 米国O*NETの中間レベル作業活動(IWA) |
| 対象範囲 | 約100の国・地域、165種類の作業活動 |
| 期間 | 2025年第1四半期から2026年第3四半期までの7四半期 |
| サンプル源 | Free、Go、Plus、Proの個人アカウント、申告年齢18歳以上 |
| 除外対象 | ChatGPT Enterprise、Codex、削除済みアカウント、学習利用が許可されていないサンプル |
| データライセンス | CC BY 4.0、無料で閲覧・CSVダウンロード可能、クレジット表記が必要 |
165種類の作業活動は165種類の職業ではない
OpenAIのこのデータを読み解くうえで、最も間違えやすいポイントです。O*NETは米国政府が支援する職業情報データベースで、「職業」を複数層の「作業活動」に分解しています。たとえば「文書を編集する」という活動は、編集者の仕事だけでなく、教師、弁護士、エンジニア、財務担当者の日常業務にも現れます。
したがってOpenAIが集計しているのは「人々がChatGPTで何をしているか」であり、「どの職業の人がChatGPTを使っているか」ではありません。IWA(Intermediate Work Activities、中間レベルの作業活動)は、広範な作業行動と非常に具体的なタスクの中間に位置し、O*NETの参照体系には332項目のIWAがあります。
OpenAIが個別に報告したのは、そのうちよく見られ、サンプル基準を満たす活動だけです。低頻度の活動は統合されています。PPC Landが元のCSVを確認したところ、公開表は実際には164の名称付きカテゴリに「Other IWA」という統合カテゴリ1つを加えた、合計165の分類結果でした。そのため、OpenAIが332種類のIWAすべてを完全に集計したとは言えません。
データはどのように収集・分類されるのか
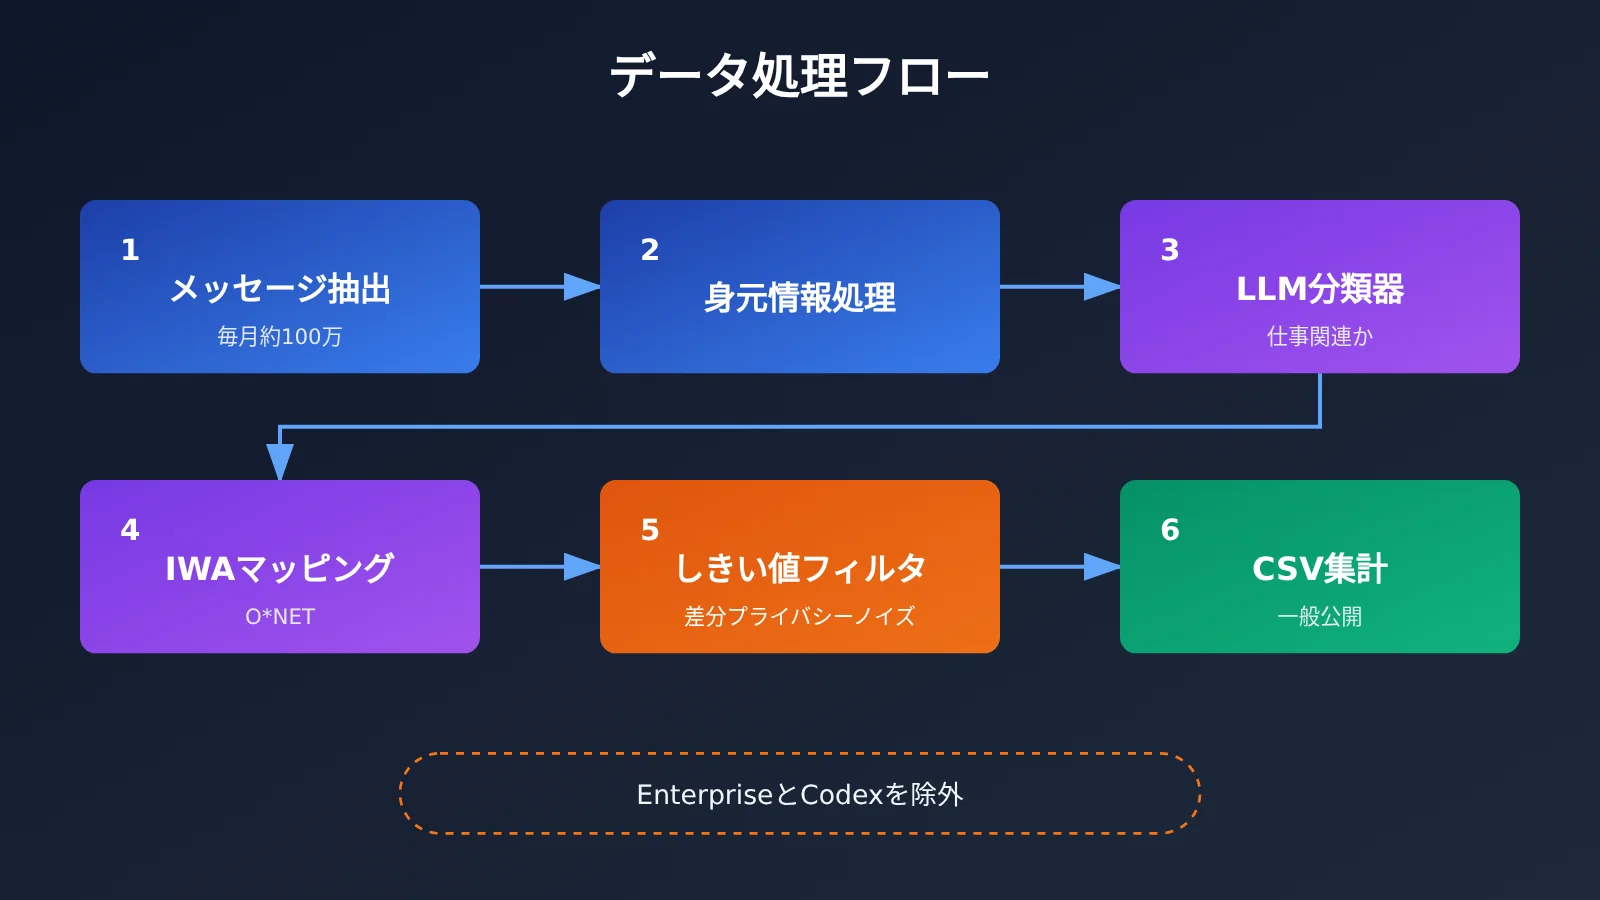
Signals v3.0は毎月約100万件のChatGPTメッセージをサンプリングし、全体では2024年7月から2026年9月までの27か月、合計約2,700万件の分類サンプルを対象としています。注意が必要なのは、2,700万件が各月のサンプル数の合計であり、独立ユーザー数とは異なるうえ、すべてが仕事関連のメッセージというわけでもない点です。
分類は自動化された言語モデル分類器が行います。まずメッセージが仕事に関連するかを判定し、次にO*NETの作業活動にマッピングします。同時に、トピック、意図、時期、地域などの軸も付与します。プライバシー面では、OpenAIは研究者が元のチャットを直接読むことはなく、分類前に身元情報を処理し、集計結果のみを公開すると説明しています。また、小規模サンプルの非表示化と差分プライバシーによるノイズ付加も行っています。国・四半期別の作業活動分布は、有効メッセージが少なくとも1,000件ある場合にのみ公開されます。
ChatGPT利用データの最も核心的な発見:仕事用途がより分散している
OpenAIが公式に発表したヘッドラインの結論は、個人ユーザーがChatGPTで処理する仕事の種類がより多様化しているというものです。7四半期すべてで完全な記録がある74の国と地域において、各国で最も一般的な上位10種類の仕事活動が、その国の分類済み仕事メッセージに占める平均割合は明確に低下しました。
| 時期 | 各国上位10仕事活動の平均占有率 |
|---|---|
| 2025年第1四半期 | 56.0% |
| 2026年第3四半期 | 51.1% |
| 変化 | -4.9ポイント |
ここでは2つの基準を明確にしておく必要があります。第一に、51.1%はグローバル統一の上位10リストの割合ではなく、まず各国自身の上位10を算出し、それを74か国で平均したもので、各国の上位10項目は異なっていても構いません。第二に、割合の低下はメッセージ量の減少を意味せず、全体の使用量が増加していれば、上位活動の絶対リクエスト数は依然として増加する可能性があります。
言い換えれば、より多くの「ロングテール」仕事活動がより大きなシェアを獲得したということです。74か国と約100か国は異なるサンプル範囲であり、引用時に混同してはいけません。
具体的にどの仕事活動が最も一般的か
PPC Landは2026年10月27日に、公開されているすべてのCSVに基づいて独自計算を行い、74か国それぞれで集計した後に平均を算出しました。以下は2026年第3四半期に最も一般的だった6つの具体的な仕事活動です(第三者による計算であり、OpenAIの発表に直接記載されているものではありません):
| 順位 | 仕事活動 | 74か国平均メッセージ占有率 |
|---|---|---|
| 1 | 文書や資料の編集 | 15.0% |
| 2 | ビジュアルデザインやプレゼン内容の作成 | 7.9% |
| 3 | マーケティングやプロモーション資料の作成 | 5.1% |
| 4 | 言語や文化情報の説明 | 4.0% |
| 5 | 情報や教材の準備 | 3.2% |
| 6 | コンピュータシステムや生産設備のプログラミング | 3.1% |
文書編集は依然として最も一般的な仕事用途であり、ビジュアルデザインは第2位に上昇しています。マーケティングコンテンツ、教材、言語をまたいだ理解には明確な需要があり、プログラミングは重要であるものの、この個人アカウントのサンプルでは最大のシェアを占めてはいません。
ビジュアルデザインが上昇、プログラミングの比率は低下
PPC Landの算出によると、「ビジュアルデザインやプレゼンテーションコンテンツの作成」の74カ国平均の割合は、2025年第1四半期の3.1%から2026年第3四半期には7.9%へと上昇し、4.8ポイント増となりました。これは165カテゴリの中で最も伸び幅が大きい具体的な活動です。米国でも同期間に2.4%から7.6%へ上昇し、2026年第3四半期にはブラジルが11.2%、インドが8.7%に達しています。
反対に、「コンピュータシステムや生産設備のプログラミング」は7.8%から3.1%へ低下し、米国では6.7%から2.4%へ、インドでも2026年第3四半期時点で5.8%となっています。コンピュータ関連のトラブル解決や技術設計の調査といった関連活動も、同じように減少しています。開発者がCodexなどのプログラミング専用エージェントへ移行したという仮説は合理的ですが、データ自体がその移行を証明しているわけではありません。より慎重に表現するなら、Codexと企業アカウントを除外したこのデータにおいて、プログラミング系の作業メッセージの割合が明確に低下した、ということになります。
マーケティングも注目すべきシグナルの一つです。「マーケティングや販促資料の作成」の平均割合は5.2%から5.1%とほぼ横ばいで、アルゼンチン、パキスタン、ナイジェリアなどは2026年第3四半期に9%前後に達しています。これは、汎用的な文章作成の割合は低下しているものの、マーケティング特化型のコンテンツ需要は依然として安定していることを示しています。
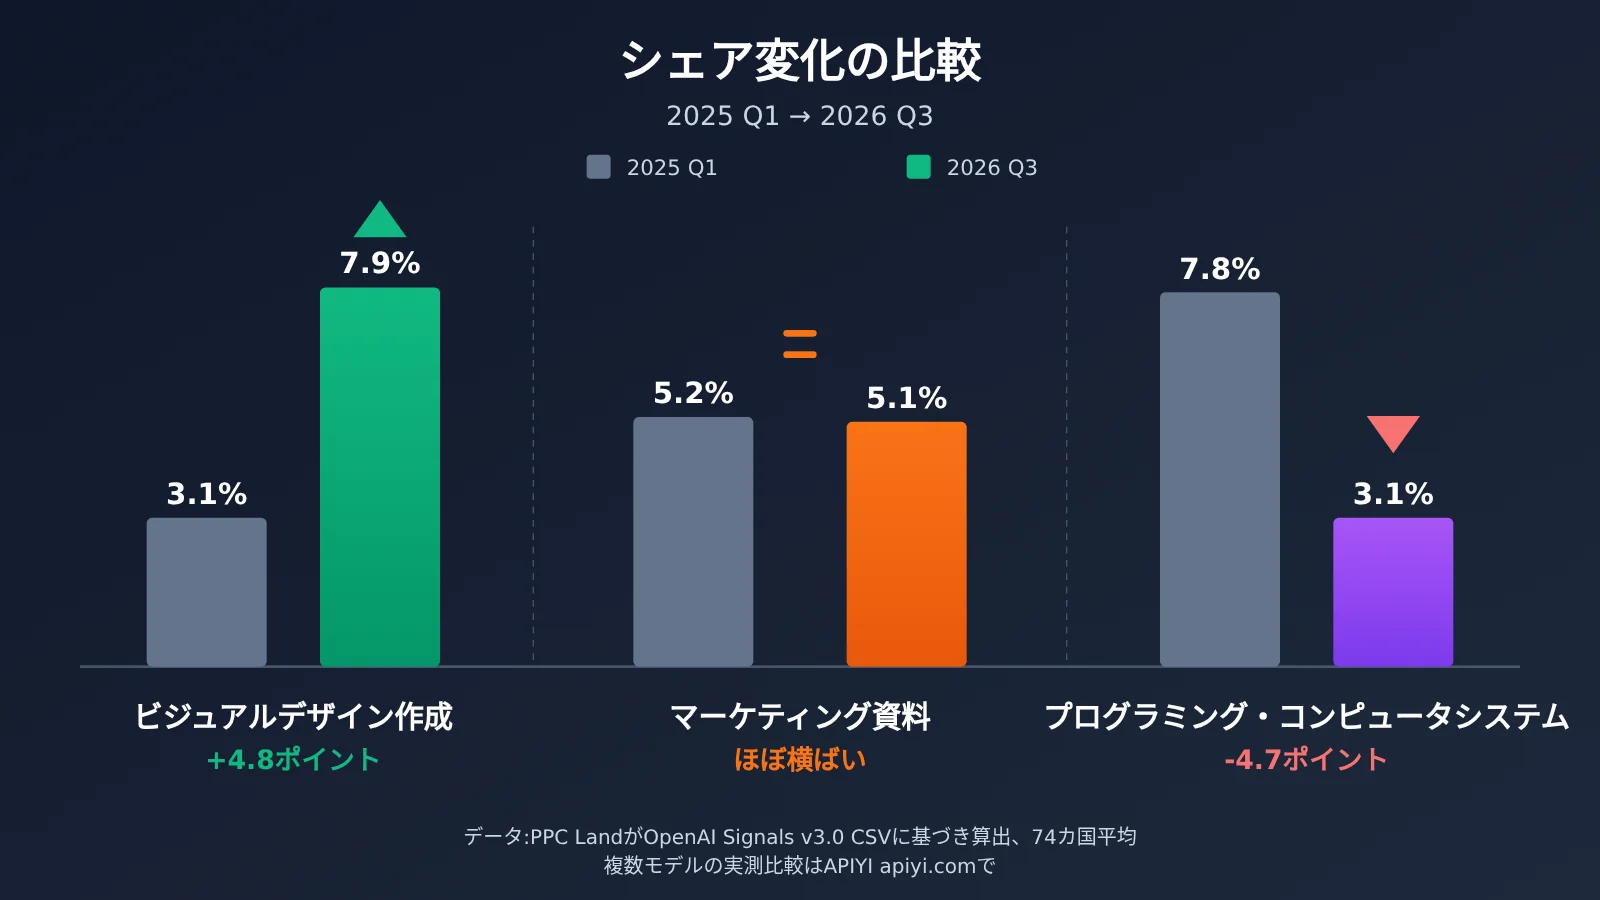
📊 グラフの説明:上の図のデータは、PPC LandがOpenAIの公開CSVを再集計したものです。自分の業務で「デザイン系・コピー系・プログラミング系」のリクエストがそれぞれどのモデルに適しているかを検証したい場合は、APIYI apiyi.com を通じて同じAPIキーでOpenAI、Claude、Geminiなどのモデルを切り替え、小規模な比較を行えます。
アメリカとドイツにおける ChatGPT の仕事構造の比較
PPC Land はさらに、OpenAI のインタラクティブなグラフに含まれる、より広範な Generalized Work Activities を項目ごとに読み取っています(上記の IWA とは階層が異なるため、混在させてはいけません)。統計の基準は、各国の仕事関連メッセージに占める割合です:
| 広範な作業活動 | アメリカ Q1 2025 | アメリカ Q1 2026 | ドイツ Q1 2025 | ドイツ Q1 2026 |
|---|---|---|---|---|
| 意思決定と問題解決 | 22.8% | 21.6% | 22.0% | 19.4% |
| 創造的思考 | 11.8% | 15.6% | 11.3% | 13.1% |
| 情報の記録 | 10.6% | 11.8% | 10.3% | 11.4% |
| コンピュータの使用 | 11.7% | 6.7% | 12.7% | 8.4% |
| コンサルティングと助言の提供 | 5.5% | 9.0% | 7.1% | 11.7% |
| 他者への情報説明 | 5.1% | 4.0% | 9.5% | 8.6% |
両国とも「意思決定と問題解決」が重要な用途であることが示されており、「創造的思考」と「コンサルティング・助言」の割合が明確に上昇しています。これはあくまでユーザーのリクエストの種類を表すものであり、ChatGPT が独自にビジネス上の意思決定を行ったことや、検証済みの専門家レベルのコンサルティングを提供したことを意味するものではありません。
国間の比較では、PPC Land が読み取ったクロスカントリーな分布差異の指標(総変差距離)は約 22.2% から約 23.0% へとわずかに上昇しました。OpenAI も、この差異は仕事の構造、言語や文化、ツールの利用可能性、利用習慣などに由来する可能性があると認めており、今回のデータだけでは因果関係を証明するには不十分です。
165種類の業務活動データが開発者に与える影響の分析
AIアプリ開発者への影響
- ニーズの幅が広がっている:ユーザーはもはやChatGPTで文書を修正するだけでなく、ビジュアルデザイン、マーケティング、教材、コンサルティングの提案などもかなりの割合を占めています。単機能のAIツールは、マルチタスクのシナリオを考慮する必要があるでしょう。
- マルチモーダルの重要性が増している:ビジュアルデザインは増加幅が最も大きい活動で、同期間の全個人メッセージのうち「マルチメディア」というテーマも2.0%から8.8%へと上昇しました(PPC Landの算出)。画像機能は製品計画に組み込む価値があります。
- プログラミングのシーンは専用化へ:汎用チャットにおけるプログラミング関連メッセージの割合は低下しており、開発系のニーズはむしろ専用エージェントや企業環境で多く発生する可能性を示唆しています。専用のコードモデルとワークフローで対応するのが適しているでしょう。
- 再利用可能な分類手法:OpenAIはLLM分類器を使ってメッセージを標準的なタスク体系にマッピングしています。この考え方は、自身の製品ログ分析にも同様に活用できます。
企業のAI実装への影響
個人アカウントのデータは、企業での利用を代表するものではありません。OpenAIの別のEnterprise Signalsデータによると、2026年6月時点で、分析対象の企業顧客においてCodexがChatGPTとCodexの合計出力トークンの64%を占めていました。これは、企業側の利用構造が個人アカウントとは大きく異なる可能性があることを示しています。社内のAIソリューションを評価する際は、Signalsの個人データをそのまま当てはめるのではなく、自社のタスクログに基づくべきです。
🚀 クイックスタート:OpenAIのように自社の業務リクエストへ「作業活動」タグを付けたいなら、APIYI apiyi.comを通じて素早くプロトタイプを構築するのがおすすめです。プラットフォームはOpenAI互換インターフェースを提供しており、新規ユーザーには無料のテスト枠があります。数分で以下のサンプルを動かせます。
APIで「作業活動分類」の考え方を再現する
以下は非常にシンプルなサンプルです。大規模言語モデルを使って、1件のユーザーリクエストを少数の作業活動ラベルに分類します。原理はOpenAIの分類器と同じです(ラベルは簡略化した例であり、O*NETの完全な体系ではありません)。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

labels = "编辑文档, 视觉设计, 营销推广, 语言解释, 教学材料, 编程, 决策分析, 其他"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"从[{labels}]中选一个标签描述这条工作请求,只输出标签:帮我写一份新品发布的公众号推文"}]
)
print(resp.choices[0].message.content)
バッチ分類と比率統計の完全なコードを見る
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1つのキーで複数のモデルを切り替え可能
)

LABELS = ["编辑文档", "视觉设计", "营销推广", "语言解释",
          "教学材料", "编程", "决策分析", "非工作", "其他"]

SYSTEM = (
    "你是工作活动分类器。先判断请求是否与工作相关,"
    f"再从以下标签中选择一个:{', '.join(LABELS)}。只输出标签本身。"
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "其他"
    except Exception as e:
        print(f"Error: {e}")
        return "其他"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "非工作"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "帮我润色这份季度汇报",
        "设计一组活动海报的构图建议",
        "这段 Python 为什么读不到数据",
        "周末去哪里露营比较好",
    ]
    print(activity_share(logs))
OpenAIの手法と同様に、この自動分類には誤判定が発生します。また、1つのタスクが複数のメッセージに分割されることもあります。そのため、統計で得られた「メッセージ比率」を、そのまま作業量や業務価値と同一視することはできません。
さまざまな業務活動におけるモデル選定の参考
データ内で割合の高い活動を踏まえ、タスク種別ごとに初步的な選定を行うことができます。実際の効果は、必ずご自身のデータで検証してください。
| 業務活動 | 重視する能力 | 選定の考え方 | 利用可能なプラットフォーム |
|---|---|---|---|
| 書面資料の編集 | テキスト理解と書き換え | コストパフォーマンスの高い汎用対話モデル | APIYI apiyi.com、公式API |
| ビジュアルデザインとプレゼン | 画像生成と画像理解 | マルチモーダル/画像モデル | APIYI apiyi.com、公式API |
| マーケティング・販促資料 | 創造性とスタイル制御 | 文体が安定したフラッグシップモデル | APIYI apiyi.com、公式API |
| プログラミングとデバッグ | コード推論 | コード能力の高いモデルまたは専用エージェント | APIYI apiyi.com、公式API |
| 意思決定とコンサルティング | 長いコンテキストでの推論 | 推論型モデル+人によるレビュー | APIYI apiyi.com、公式API |
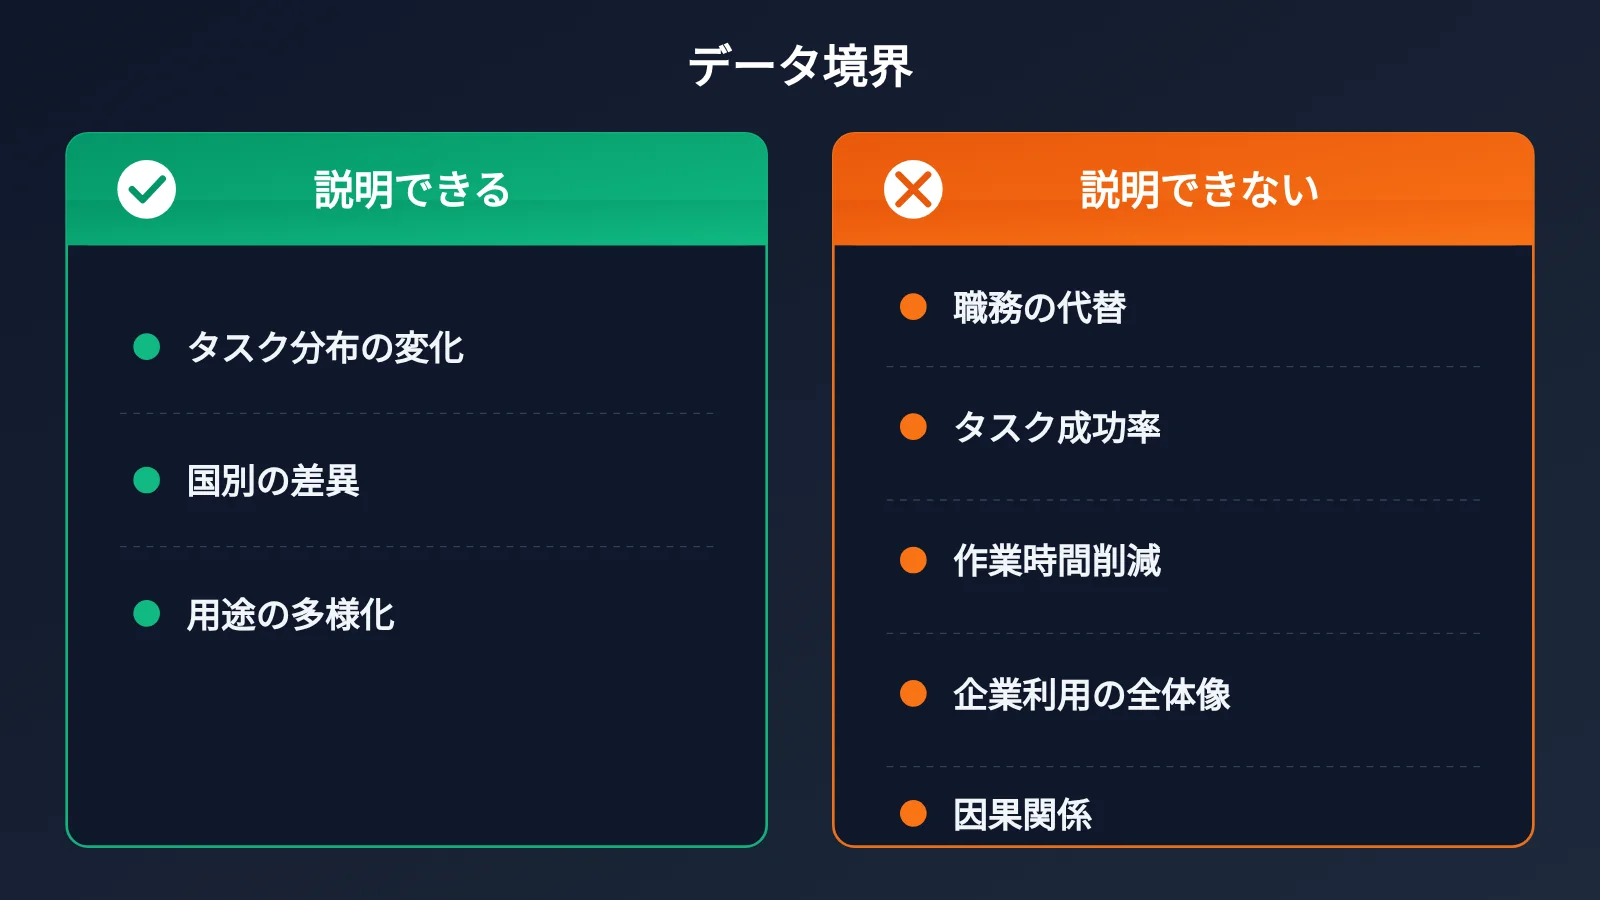
OpenAIの165種類の業務活動データが持つ限界
このデータは非常に価値がありますが、境界もはっきりしています。引用する際に特に注意すべき点は次のとおりです。
- サンプルは成人の個人アカウントのみ:EnterpriseとCodexは除外されており、OpenAIの企業向け製品における業務利用の全体を代表するものではありません。
- 分類は自動で行われる:LLMの分類器が意図を誤って解釈する可能性があります。たとえば「イベント宣伝プランの設計」は実際のマーケティング業務かもしれませんし、個人の趣味かもしれません。
- メッセージの割合は成果と等しくない:タスク数、作業時間、利用者数、削減できた工数、成功率を表すものではありません。
- プライバシーノイズとサンプル閾値がある:小規模サンプルの結果は非表示にされ、差分プライバシーのノイズが加えられています。
- 現実の経済と一対一で対応するわけではない:雇用者数で重み付けすると、米国の現実の業務活動のうち約43%が「Other IWA」カテゴリに該当します。これは43%の仕事がAIで完遂できないという意味でも、残りの57%がすでにChatGPTでカバーされているという意味でもありません。
さらに、PPC Landの試算によると、個人メッセージ全体のうち業務関連とラベル付けされた割合は、2024年7月の約51.6%から2026年9月には約32.2%へ低下しています。これはむしろ、非業務ユーザーが大量に流入したことや、一部の専門業務が企業アカウントや専用エージェントへ移行したことによる可能性が高く、これをもってChatGPTが職場で重要でなくなったと判断することはできません。
よくある質問(FAQ)
Q1:OpenAI が公開した165種類の「作業活動」データとは何ですか?
これは OpenAI Signals v3.0 プロジェクトで公開された集計データです。個人の ChatGPT ユーザーによる仕事関連のメッセージを、O*NET の165種類の中間レベルの作業活動にマッピングしたものです。約100の国と地域、2025年第1四半期から2026年第3四半期までの7四半期分をカバーしており、CSV 形式で無料ダウンロードできます。
Q2:165種類の「作業活動」と165種類の「職業」はどう違うのですか?
作業活動は「何をするか」、職業は「どの職種か」を指します。同じ活動(例:文書の編集)が複数の職業にまたがって存在するため、このデータが示すのは「ChatGPT がどの種類の作業に使われているか」であり、各職業の利用率ではありません。ましてや、どの職業が代替されるかを推測できるものでもありません。
Q3:このデータはいつ公開されましたか。今後も更新されますか?
OpenAI が公開したのは2026年10月26日で、データは2026年第3四半期までのものです。公式は四半期単位で変化を追跡しており、今後も継続的に更新されるかどうかは OpenAI Signals のデータページの告知に従います。本記事では推測しません。
Q4:プログラミング関連メッセージの比率が下がったのは、AI によるコーディング需要が縮小しているということですか?
そう結論づけることはできません。このデータには Codex と法人アカウントが含まれておらず、Enterprise Signals では法人側の Codex の出力トークン比率が高いことが示されています。コーディング需要が専用エージェントに移った可能性もあれば、ユーザー構成の変化による可能性もあり、データだけでは区別できません。
Q5:API を使って、同様の作業活動の分類分析を再現するにはどうすればよいですか?
本記事のサンプルコードを参考に、大規模言語モデルで自分のユーザーリクエストにラベルを付け、その比率を集計する方法があります。
1. APIYI(apiyi.com)にアクセスしてアカウント登録し、APIキーを取得します
2. 新規ユーザー向けの無料テスト枠を受け取ります
3. コード内の base_url を `https://api.apiyi.com/v1` に設定すれば、さまざまなモデルを切り替えて分類精度を比較できます
Q6:設計・コピーライティング・コーディングのタスクで、モデルごとの性能を比較する手軽な方法はありますか?
もっとも手間が少ないのは、統一インターフェースで複数社のモデルを呼び出し、同じプロンプト群を一通り実行してから人手で評価する方法です。APIYI(apiyi.com)なら1つのキーで OpenAI、Claude、Gemini などのモデルを呼び出せ、従量課金なのでこうした小規模な比較実験に向いています。
OpenAI 165種類の職務活動データ:主なポイント
- 集計対象は職業ではなく活動:165種類はO*NETの職務活動を指し、「その他」の統合カテゴリを1つ含みます。
- 用途はより分散:74カ国における上位10活動の平均シェアは、56.0%から51.1%に低下しました。
- ビジュアルデザインの伸びが最大:第三者による算出では、3.1%から7.9%へ上昇しています。
- プログラミング比率は低下したが、解釈には注意:サンプルからはCodexと企業アカウントが除外されています。
- マーケティング需要は安定:マーケティング・販促資料の比率は、ほぼ5%前後を維持しています。
- メッセージ比率は成果と同義ではない:職務代替、工数削減、成功率を導き出せるわけではありません。
- 分類手法は再利用可能:APIYI apiyi.com のマルチモデルAPIを活用すれば、独自のタスク分類分析を素早く構築できます。
まとめ
OpenAIの165種類の職務活動に関するChatGPT利用データの要点は、次のとおりです。
- データの性質:無料で公開され、四半期ごとに追跡される研究データで、個人アカウントにおいて「ChatGPTでどのような職務活動を行っているか」を集計したものです。
- 主な発見:業務での用途はより分散しつつあり、ビジュアルデザイン、コンサルティング提案、創造的思考が増加する一方、汎用的なプログラミング関連メッセージの比率は低下しています。
- 解釈の限界:データには企業アカウントとCodexが含まれておらず、メッセージ比率は作業量、職務への影響、経済的価値と同一視できません。
このデータが本当に示しているのは、165種類のどの職業がまもなく消えるかということではなく、AIがより細かく多様な形でさまざまな業務フローに入り込み、しかも国やタスクの種類によって異なるという点です。開発者にとっては、「AIが誰を代替するのか」と問うよりも、ユーザーが実際にAIでどの活動を完了しているのかを見極め、その活動に合ったモデルとワークフローを選ぶことが重要です。
APIYI apiyi.com で、さまざまなモデルがあなたの業務シーンでどのように機能するかを素早く検証することをおすすめします。同プラットフォームでは、無料のテスト枠と複数モデルを統合したインターフェースを提供しています。
📚 参考資料
- OpenAI 公式発表:ChatGPT’s expanding world of work:今回のリリースの中心的な出典
- リンク:
openai.com/index/chatgpt-expanding-world-of-work -
説明:165種類の活動、約100カ国、56.0%から51.1%といった公式の結論
-
OpenAI Signals データダウンロードと方法の説明:元のCSVとデータ辞書の入口
- リンク:
openai.com/signals/data-download -
説明:サンプル範囲、プライバシー処理、CC BY 4.0ライセンスの説明
-
PPC Land:Writing drops from 34% to 21% of ChatGPT requests since July 2024:第三者によるCSV分析
- リンク:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
説明:具体的な活動ランキング、ビジュアルデザインとプログラミングの割合の変化
-
PPC Land:Americans use ChatGPT at work most to make decisions:米独のインタラクティブチャートの読み取り
- リンク:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
説明:広範な業務活動の国別比較データ
-
O*NET 公式サイト:業務活動と職業分類の体系
- リンク:
onetcenter.org -
説明:IWAの定義と332の参考項目の理解
-
OpenAI Enterprise Signals:企業アカウントの利用データ
- リンク:
openai.com/signals/enterprise-data - 説明:個人データと企業データの範囲を区別するために使用
著者:APIYI 技術チーム
技術交流:APIYI のウェブサイトトップページからお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます




