著者注:両モデルのピーク時の価格は同じですが、得意なタスクは異なります。この記事では、パラメータ、価格、ベンチマーク、役割分担の4つの表を使って、どのタスクをどちらのモデルに任せるべきかを解説します。
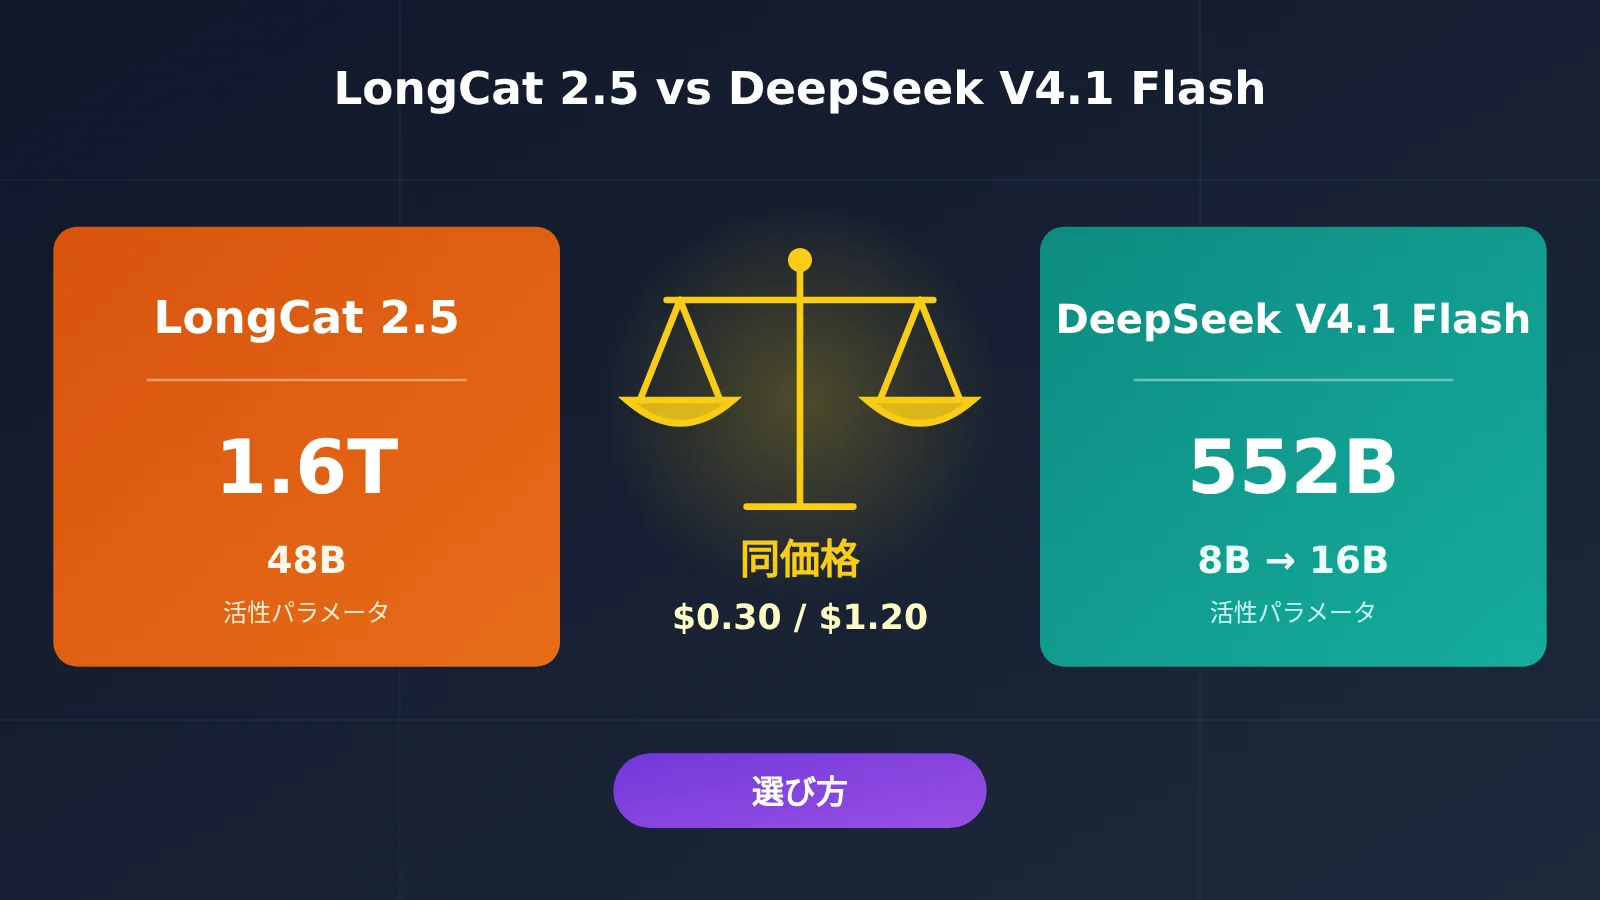
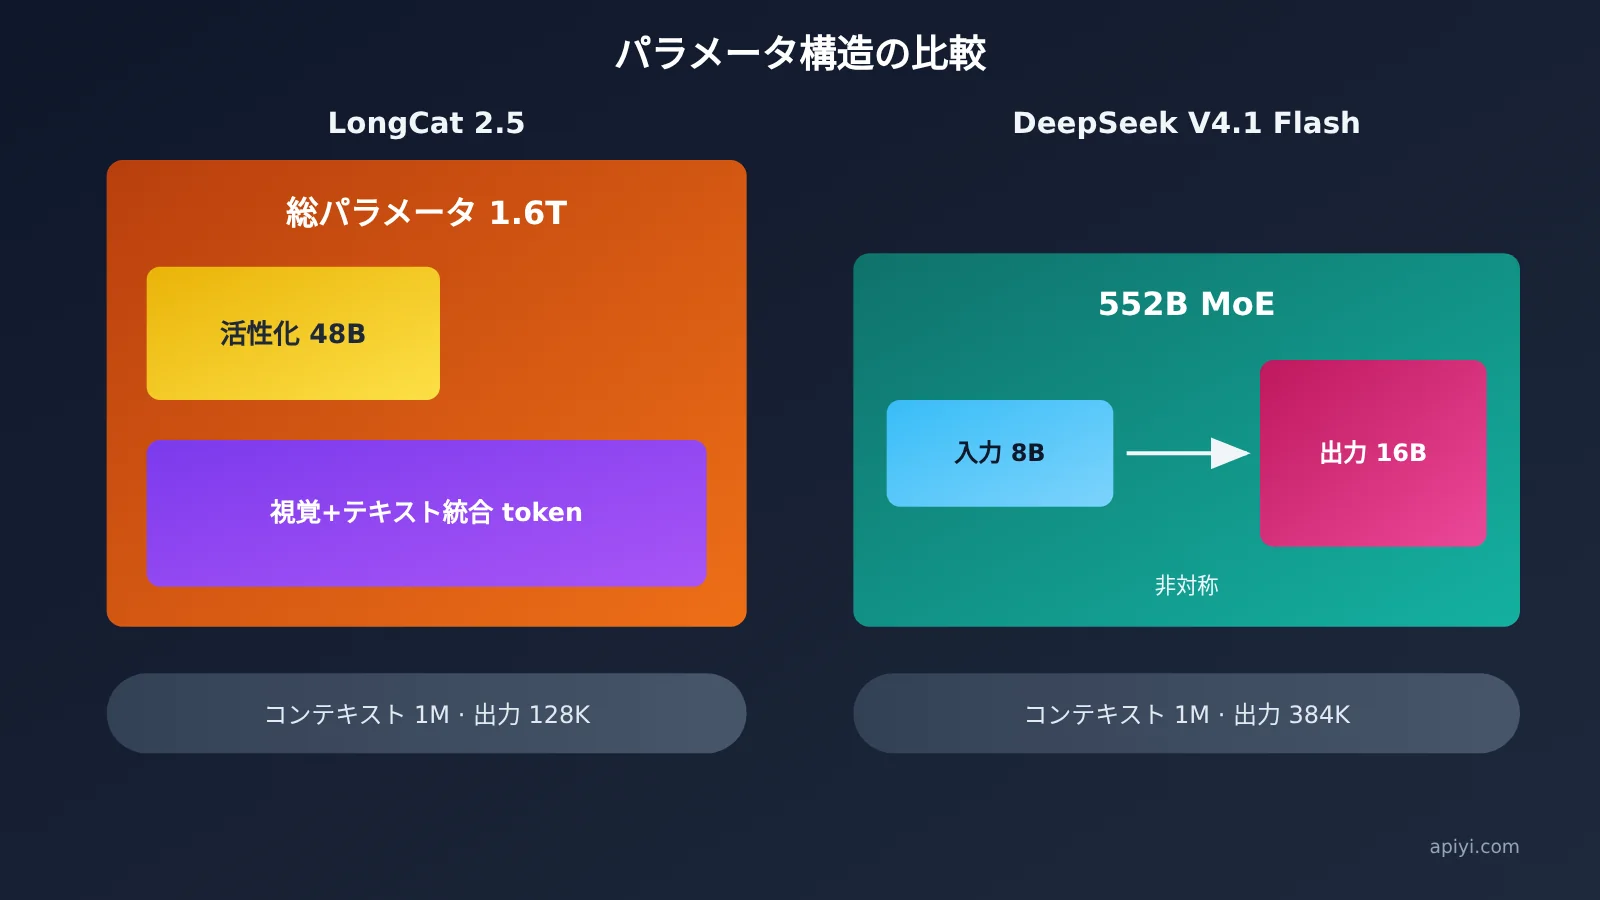
両モデルのピーク時の価格は完全に同じです。100万トークンあたり、入力 $0.30、キャッシュ $0.006、出力 $1.20。違いは得意なタスクにあるため、何に使うかで選ぶ必要があります。LongCat 2.5は総パラメータ数1.6T、トークンあたりの活性化パラメータ数が約48Bのネイティブなマルチモーダルモデルです。DeepSeek V4.1 Flashは総パラメータ数552Bの非対称MoEで、活性化パラメータ数は入力時8B、出力時16B。重みはすでにオープンソースとして公開されています。
この記事は、両者の「一長一短」を並べるだけの折衷的な比較ではありません。以下の数値はすべて、両社の公式ブログ、技術レポート、料金ページに基づいています。ベンチマークは両社それぞれによる自己測定のため、同水準の参考値として扱い、総合順位は付けません。また、実際に試していないことを実測結果として書くこともありません。
この記事でわかること:自分のプロジェクトのタスクを一つずつ照らし合わせ、どちらを主に使い、どちらを補助に使うかを判断できます。さらに、バッチ処理をオフピーク時に移した場合の節約額も計算できます。
LongCat 2.5 と DeepSeek V4.1 Flash:2つのモデルの基本情報
結論から言うと、LongCat 2.5 は総パラメータ数も、1回あたりの活性化パラメータ数も多いモデルです。DeepSeek V4.1 Flash はモデル規模が小さく、活性化パラメータ数も少ないうえ、最大出力が長く、重みを直接ダウンロードできます。コンテキスト長はどちらも 1M です。モデル選定で特に重要なのは、最大出力が 128K と 384K で異なること、重みが公開されているかどうか、そして活性化パラメータの規模です。
| 項目 | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| 総パラメータ数 | 1.6T(1.6兆) | 552B |
| 活性化パラメータ数 | 1トークンあたり約 48B | 入力時は 8B、出力時は 16B |
| 構造 | AIエージェント向けのネイティブマルチモーダルモデル。画像とテキストを統一されたトークンで処理 | MoE、Causal-Encoder-Decoder の非対称構造 |
| コンテキスト長 | 1M | 1M |
| 最大出力 | 128K | 384K |
| ネイティブ視覚機能 | 対応。視覚信号を複数階層の離散トークンで表現 | 対応(Vision) |
| 重みのオープンソース公開 | 未公開。GitHub と Hugging Face にはいずれも「近日公開」と記載 | 公開済み。Hugging Face で重みと技術レポートを公開 |
| 思考モードの切り替え | 公式評価は thinking を有効にした状態で実施 | 思考モードはデフォルトで有効。reasoning_effort でレベルを調整可能 |
LongCat 2.5の構造のポイント
LongCat 2.5は、長期的なエージェントタスク向けのモデルと明確に位置づけられています。バージョン2.0と比べて、特に強化されたのはネイティブな視覚理解とエージェントによるプログラミングの2点です。視覚処理では、画像をネイティブ解像度のまま離散化(SAE+RVQ)し、オフラインで事前に視覚トークンへ変換したうえで、バックボーンと共同学習します。バックボーンは視覚とテキストを同じ仕組みでトークンとして処理するため、ネイティブマルチモーダルと呼ばれています。
学習では、長期的な行動軌跡のデータと、大規模な長期強化学習(RL)が多用されています。公式ブログでは、実際のエージェントの失敗軌跡を検証可能なタスクに作り替えること、非同期RLで部分ロールアウトを採用し、全問正解または全問不正解で勾配がゼロになるサンプル群を除外すること、繰り返しの思考やツール呼び出しにペナルティを与えることなどが紹介されています。最後の点は、エージェントを開発する人にとって特に重要です。モデルがツール呼び出しのループで同じ行動を繰り返すことが減り、トークンの無駄も抑えられます。
推論の実装面では、W4A4はW8A8 INT8と比べて、prefillのスループットが43.3%、decodeのスループットが42.77%向上し、TTFTは15.91%、TPOTは19.72%低下しています。学習面では、二重シャーディングFSDPにより、長いシーケンスを使ったSFTのGPU 1基あたりのスループットが、DDPのベースラインを86%上回りました。これらの数字から、1.6Tという規模のモデルをサーバーで提供するために、専用の圧縮が行われていることがわかります。ただし、公式はレート制限の数値を公開していません。
DeepSeek V4.1 Flash のアーキテクチャのポイント
DeepSeek V4.1 Flash は、新アーキテクチャのシリーズで最も小さいモデルです。特徴は、入力と出力で活性化されるパラメータ数が異なることです。入力の読み取り時には 8B、出力の生成時には 16B が活性化されます。エージェントの利用では、リポジトリやログ、ツールの返り値の読み取りなど、出力より入力のほうがはるかに多くなりがちです。この設計によって、読み取り側の計算量を抑えられます。
コスト面での変化はさらに大きくなっています。新世代の KV Cache は大幅に縮小され、HBM の必要量は前世代の 1/4、SSD の必要量は 1/8 になりました。初代モデルと比べると、KV Cache は累計で 437 分の 1 に縮小されています。
もう一つ注意したい変更があります。2026-09-14 12:00 以降、deepseek-v4-pro へのリクエストは V4.1 Flash にルーティングされ、Flash の単価で課金されます。この措置は V4.1 Pro の提供開始まで続きます。旧モデル名を使い続けているプロジェクトでも、実際に呼び出されるのは Flash です。
LongCat 2.5とDeepSeek V4.1 Flashの価格比較:「同価格」はピーク時だけ
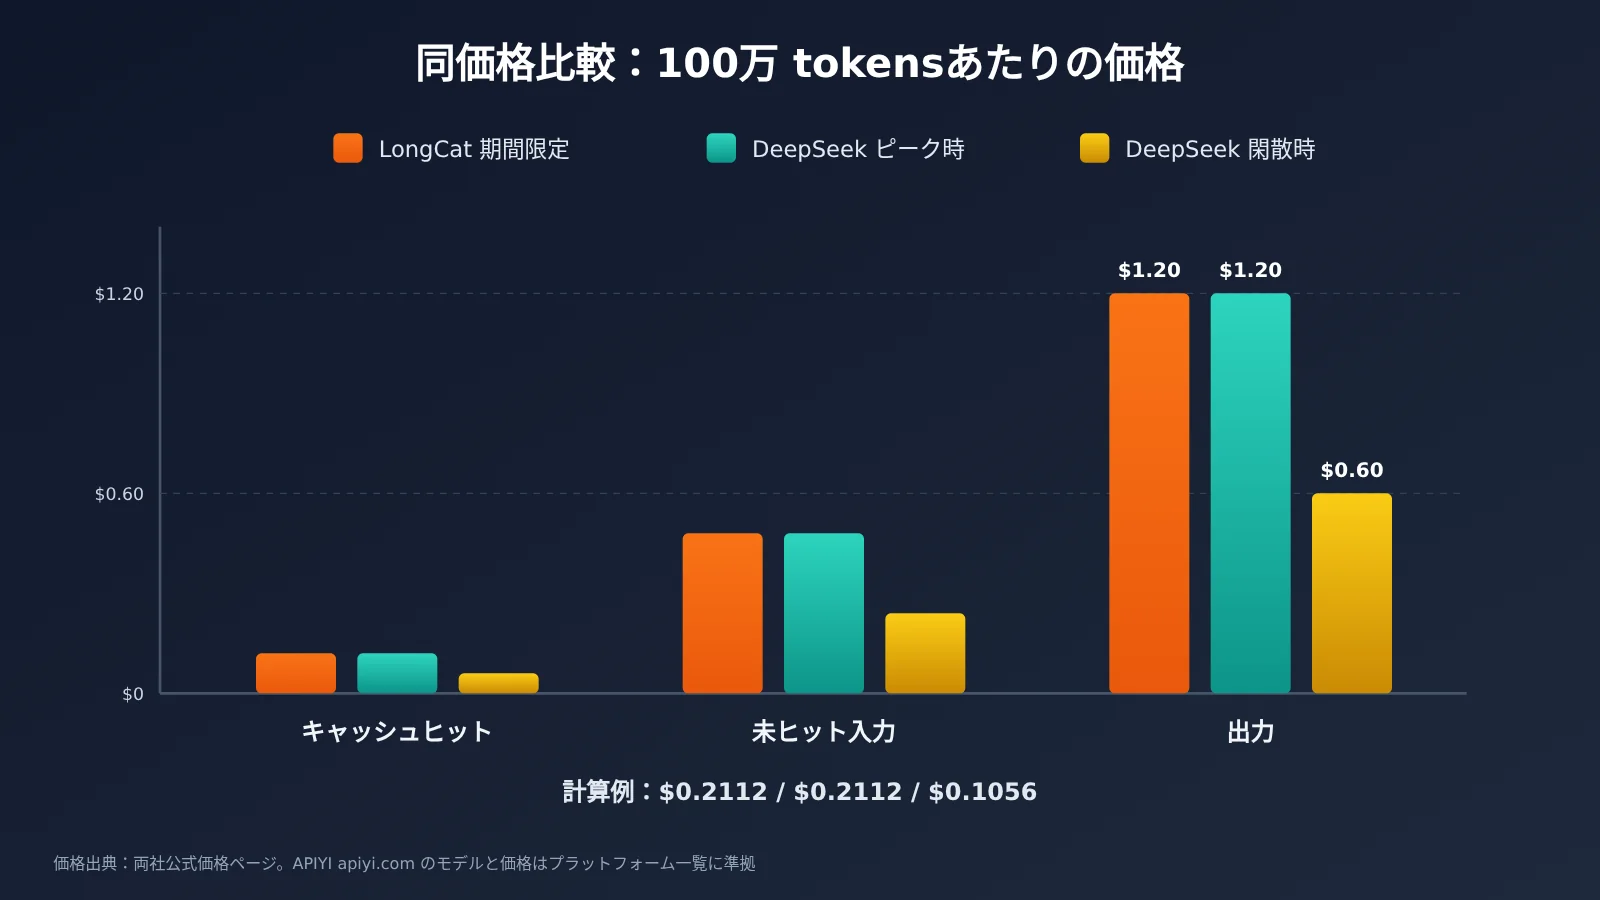
結論から言うと、LongCat 2.5の期間限定割引価格は、DeepSeek V4.1 Flashのピーク時価格と項目ごとに同じです。一方、DeepSeekはオフピーク時に半額になるため、同じタスクを半分の費用で実行できます。つまり、「同価格」と言えるのは平日の日中に限られます。
| 100万トークンあたり(米ドル) | LongCat 2.5(期間限定割引) | DeepSeek ピーク時 | DeepSeek オフピーク時 |
|---|---|---|---|
| キャッシュヒット入力 | $0.006 | $0.006 | $0.003 |
| キャッシュミス入力 | $0.30 | $0.30 | $0.15 |
| 出力 | $1.20 | $1.20 | $0.60 |
実際に計算してみましょう。あるエージェントのタスクで、入力50万トークン(キャッシュミス30万、キャッシュヒット20万)と出力10万トークンを消費すると仮定します。
- LongCat 2.5(期間限定割引):0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek ピーク時:計算は同じで、$0.2112
- DeepSeek オフピーク時:0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
1タスクあたりの差額は約10セントで、あまり大きく見えないかもしれません。しかし、同規模のタスクを毎日1,000件実行すると、LongCatとDeepSeekのピーク時はどちらも$211.2、DeepSeekのオフピーク時は$105.6です。バッチ処理を行うチームにとって、1か月の差額はかなり大きくなります。
DeepSeekのピーク時間帯は、北京時間の平日09:00〜12:00、14:00〜18:00です。UTCでは月曜日から金曜日の01:00〜04:00と06:00〜10:00にあたり、中国の法定祝日は除きます。それ以外はすべて半額のオフピーク時間帯で、平日の昼休み、夜間、早朝に加え、週末と法定祝日の終日が含まれます。つまり、1週間168時間のうち、ピーク時間帯は平日1日あたり7時間だけです。
LongCat 2.5の料金体系にも、押さえておきたい点がいくつかあります。
- HTTP 200の場合のみ課金され、401、403、429、500は課金対象外です。リトライが失敗しても費用はかかりません。
- 利用枠パックは毎日、北京時間の10:00、16:00、21:00、23:00に数量限定で販売されます。有効期間は30日で、未使用分は全額返金可能です。キャッシュヒット分はパックのトークンを消費しません。
- 無料付与枠:新規ユーザーには1,000万トークン、既存ユーザーには500万トークンが自動付与されます。キャッシュヒット分は付与枠を消費しません。
- 価格は期間限定割引と明記されているため、今後の変更については公式の価格ページを確認してください。
一方、DeepSeekのウェブ検索とウェブページ取得は別料金のAPIで、成功したリクエスト1,000回あたり$0.75です。検索と取得は同じ価格です。エージェントが頻繁にウェブへアクセスする場合は、この費用も別途予算に含める必要があります。
💰 コストのヒント:APIYI apiyi.com を通じてDeepSeek V4.1 Flashを呼び出す場合、料金はプラットフォームのモデル一覧に従い、公式のピーク時・オフピーク時の価格と必ずしも同じではありません。まずプラットフォームのコンソールで少数のタスクを実行して請求額を確認し、それから一括実行の方法を決めると、より正確に見積もれます。
LongCat 2.5とDeepSeek V4.1 Flashの公式ベンチマーク比較
結論:両モデルは、多くのエージェント向けベンチマークで差が3ポイント未満と、ほぼ同等の水準です。LongCat 2.5はTerminal Bench v4.0、Program Bench、JobBench、3D生成でリードしています。一方、DeepSeek V4.1 FlashはDeepSWE、NL2Repo、AutomationBenchでリードしており、その差も比較的大きくなっています。
| ベンチマーク | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(テキストから3D生成) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
評価条件の注意点(必読):両社の数値はいずれも公式の自社測定結果です。LongCat 2.5は独自のハーネスを使用し、thinkingを有効にして、temperature=1.0、top_p=0.95の設定で測定しています。DeepSeekの列は大半が公開技術レポートからの引用で、DeepSeek独自のハーネスとMax推論モードを使用しています。両者はハーネス、評価日、推論モードが異なるため、この表は同水準のモデルとして比較する際の参考にとどまり、順位を示すものではありません。
ベンチマークスコアの読み方
差が最も大きい2項目では、優位なモデルがそれぞれ逆になっています。Terminal Bench v4.0 では LongCat 2.5 が DeepSeek を7.3ポイント上回り(38.5 対 31.2)、DeepSWE v1.1 では DeepSeek が LongCat を9.6ポイント上回っています(74.2 対 64.6)。前者はより難易度が高く、手順の長いターミナルタスクを、後者は実際のリポジトリでバグを修正する能力を測るベンチマークです。ここに両モデルの得意分野の違いが表れています。一方は長い手順を伴うターミナル操作に、もう一方は既存のコードベースを正確に修正することに強みがあります。
旧版の Terminal Bench v2.1 では、逆に DeepSeek が2.2ポイント上回っています。難易度が上がって初めて、LongCat の優位性が表れたことがわかります。Program Bench では LongCat が5.2ポイント、NL2Repo では DeepSeek が4.9ポイント上回っています。NL2Repo は自然言語の説明からリポジトリ全体を生成するベンチマークで、「ゼロからプロジェクトを構築する」実践的な開発能力により近いものです。
視覚関連の項目では差が小さくなっています。Vision2Web では DeepSeek が0.6ポイント、3DCodeBench では LongCat が2.1ポイント上回っています。公式の比較表では、CharXiv-RQ w/tools は LongCat が90.2、DeepSeek が87.7。MathVision w/tools は DeepSeek が97.4、LongCat が96.5です。純粋な視覚理解だけを見ると、両者はほぼ互角です。LongCat の強みは、視覚理解を3Dやインタラクティブなページの生成につなげることにあります。公式の8つのデモには、リアルタイムの流体シミュレーション、3D文化財のインタラクティブ展示、都市ジオラマ、ミニチュアシーン用のアセットなどが含まれており、その方向性は明確です。
BrowseComp、HLE w/tools、MCP Atlas の3項目はいずれも差が1.3ポイント以内です。Web検索や MCP ツールの呼び出しといった汎用的なエージェント能力は、互角と見てよいでしょう。
DeepSeek の推論レベルはコスト調整の鍵
DeepSeek の技術レポート 5.3.3 節には、実用的なデータが掲載されています。reasoning effort を 25 から 100 に上げると、推論系ベンチマーク 8 種の平均 Pass@1 は 67.1% から 76.3% に、DeepSWE v1.1 は 66.0 から 74.2 に上昇します。その一方で、出力トークン数は約 2.5 倍になります。60〜80 のレベルですでに最大レベルに近い精度に達し、トークン予算は最大レベルの半分未満です。最後に 100 まで上げると、エージェントの実行経路はさらに 1.6〜1.8 倍長くなりますが、得られる精度の向上はわずかです。
また、DeepSeek API の reasoning_effort のデフォルトは high ですが、公式スコアは Max レベルで測定されています。上の表の DeepSeek のスコアを再現するには、明示的に max に設定する必要があります。日常的なタスクには中程度のレベルを使い、最も難しいタスクに限って最大レベルにするのがおすすめです。出力トークンは両社の料金項目の中で最も高いため($1.20)、このレベル設定がコストを大きく左右します。
LongCat 2.5 と DeepSeek V4.1 Flash:タスクの分担は?
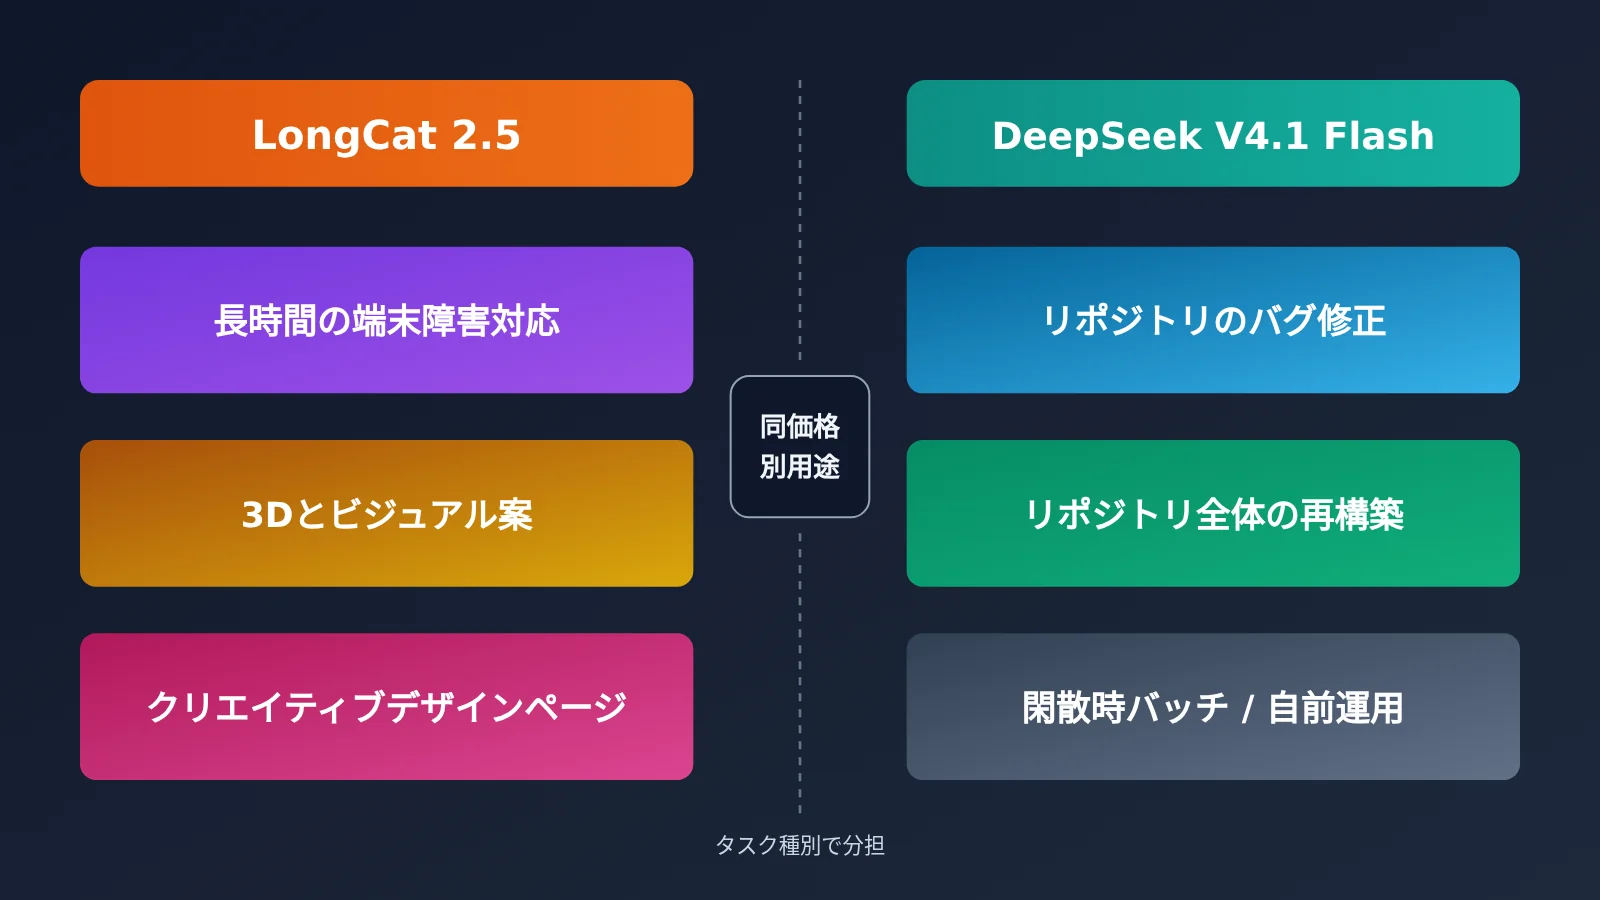
結論は、同じ価格でも得意な仕事が違う、ということです。長時間にわたるターミナル作業、ビジュアルや 3D、クリエイティブなデザインページは LongCat 2.5 に。実際のリポジトリでのコード修正、SWE のバグ修正、自動化パイプライン、セルフホスティングが必要な場面は DeepSeek V4.1 Flash に任せるのが適しています。
| LongCat 2.5 が適しているタスク | DeepSeek V4.1 Flash が適しているタスク |
|---|---|
| 長時間にわたるターミナルでのトラブルシューティング:サーバーへのログイン、ログ確認、設定変更、再起動後の検証といった複数ステップの作業(Terminal Bench v4.0 で 7.3 ポイント上) | 実際のリポジトリでのバグ修正:issue の確認、対象ファイルの特定、修正、テストの実行(DeepSWE で 9.6 ポイント上) |
| 3D アセットとビジュアル案:テキストからの 3D シーン生成、インタラクティブな展示ページ(3DCodeBench 55.4) | リポジトリ全体のリファクタリングやゼロからの構築:要件の記述に基づく複数ファイルのプロジェクト生成(NL2Repo で 4.9 ポイント上) |
| クリエイティブなデザインページ:イベントの招待状、独自の配色を使ったページ、データ可視化レポート(公式デモの例) | 自動化パイプラインとバッチ処理:夜間バッチ処理、データクレンジング、レポート生成(AutomationBench で 3.0 ポイント上、オフピーク時は半額) |
| プログラミング問題形式のプログラム構築や、職業に関する総合タスク(Program Bench、JobBench で優位) | セルフホスティングやプライベート環境での利用が必要な場合:重みが HuggingFace で公開済み。1 回あたりの長文出力にも対応(最大 384K) |
LongCat 2.5 を選ぶ理由
LongCat 2.5 で最も説得力がある数字は、Terminal Bench v4.0 のスコアです。v2.1 では 2.2 ポイント差で負けていましたが、v4.0 では逆に 7.3 ポイント差でリードしています。これは、タスクが長く複雑になるほど、相対的な強みが大きくなることを示しています。学習時に長い一連の操作履歴を大量に使用し、繰り返しのツール呼び出しにペナルティを設けた方針とも一致します。エージェントがターミナルで数十ステップを連続実行することが多いなら、LongCat 2.5 を優先的に試す価値があります。
2つ目の理由は、視覚と生成を組み合わせたタスクです。ネイティブなマルチモーダル対応に加え、3D やインタラクティブなページを対象とした学習により、「画像を見て成果物を作る」「テキストから 3D を生成する」といった作業に向いています。また、新規ユーザーには 10M トークンが付与され、キャッシュヒット分は付与枠から差し引かれないため、低コストで試せます。
DeepSeek V4.1 Flash を選ぶ理由
DeepSeek V4.1 Flash の最も確かな強みを示す数字は、DeepSWE の 74.2 です。両モデルの比較項目の中で、最も大きな差がついています。日々のコーディングでは、既存のリポジトリを修正する作業がよく発生しますが、まさにこれが得意分野です。最大出力は 384K と LongCat の3倍で、長いファイルや大きなパッチを生成する際にも、途中で切れにくくなっています。
3つ目の理由はコスト構造です。オフピーク時の半額料金に加え、推論レベルも調整できるため、この2つを組み合わせれば、バッチ処理のコストを LongCat の期間限定固定価格よりも柔軟に調整できます。同時実行数の上限 2500 も公式ドキュメントに明記されており、スループットを計画する際の明確な目安になります。プライベート環境での運用が必要なチームは重みを直接ダウンロードすることもできますが、公式によると、大規模なデプロイには GPU 2,000枚規模のリソースが必要です。小規模チームが自前でデプロイする場合は、事前にハードウェアを評価しましょう。
💡 選び方のヒント:表で候補を絞ることはできますが、最終的には自分のタスクで確かめることが大切です。プロジェクトから代表的なタスクを 10〜20 件選び、両方のモデルで実行して、成功率とトークン消費量を比べてみましょう。DeepSeek V4.1 Flash は APIYI(apiyi.com)経由で接続してテストすれば、別途アカウントを開設する手間を省けます。
LongCat 2.5 と DeepSeek V4.1 Flash の接続方法
結論から言うと、両者とも OpenAI と Anthropic の2種類のAPI形式に対応しています。Claude Code に接続するには、~/.claude/settings.json の環境変数をいくつか変更するだけです。DeepSeek は Responses API にも対応しています。
LongCat 2.5 を接続する
- OpenAI 形式(任意の OpenAI SDK):base_url に
https://api.longcat.ai/openai、モデル名にLongCat-2.5を指定します。 - Anthropic 形式(Anthropic SDK):base_url に
https://api.longcat.ai/anthropicを指定します。 - Claude Code(
~/.claude/settings.jsonの env フィールドを編集):以下の4つの変数をすべて設定します。 ANTHROPIC_AUTH_TOKENに LongCat のキーを指定ANTHROPIC_BASE_URLにhttps://api.longcat.ai/anthropicを指定ANTHROPIC_MODELにLongCat-2.5を指定CLAUDE_CODE_MAX_OUTPUT_TOKENSに131072を指定- レート制限への対応(自分の呼び出しコード):制限を超えると 429(rate_limit_exceeded、retry_after 60)が返されます。公式は指数バックオフを推奨しています。RPM・TPM の数値はドキュメントで公開されておらず、429 に対する課金はありません。
DeepSeek V4.1 Flash を接続する
- OpenAI 形式(任意の OpenAI SDK):モデル名に
deepseek-flashを指定します。旧モデル名のdeepseek-v4-flash、deepseek-v4-flash-vision-expも引き続き使用でき、V4.1-Flash-1017 にルーティングされ、Flash の料金が適用されます。 - Claude Code(
~/.claude/settings.jsonの env フィールドを編集): ANTHROPIC_AUTH_TOKENに DeepSeek のキーを指定ANTHROPIC_BASE_URLにhttps://api.deepseek.com/anthropicを指定ANTHROPIC_MODELにdeepseek-flashを指定- 推論レベル(OpenAI SDK のリクエストパラメータ):普段は
reasoning_effortを中程度に設定し、難しい問題ではmaxに設定します。 - 対応ツール:WorkBuddy(CodeBuddy を含む)と OpenCode は公式パートナーツールで、すでに全面的に対応しています。
APIYI で統一して呼び出す
複数のモデルを同時に動かして比較したい場合は、APIYI なら1つのアカウントと1つのAPIキーで切り替えられます。各サービスで個別にアカウントを開設する必要はありません。
- OpenAI SDK の設定(プロジェクトコード):base_url に
https://api.apiyi.com/v1、api_key に APIYI のコンソールで生成したキーを指定します。 - モデル名(同じリクエストパラメータ内で切り替え):DeepSeek V4.1 Flash には
deepseek-v4.1-flashまたはdeepseek-v4.1-flash-1017を使用します。料金はプラットフォームのモデル一覧に従います。 - 比較テスト(同じコードを使用):model パラメータを変更するだけで、プラットフォーム上のほかのモデルと同じタスクを並べて実行できます。base_url は
https://api.apiyi.com/v1のままです。
モデルと価格はプラットフォームのモデル一覧をご確認ください。APIYI では現在 LongCat-2.5 をまだ提供していませんが、近日中に対応予定です。それまでは LongCat 2.5 に公式エンドポイントを使用し、DeepSeek は APIYI apiyi.com で一元管理できます。
🚀 クイックスタート:APIYI apiyi.com に新規登録すると、無料のテスト枠がもらえます。まずは既存の OpenAI SDK プロジェクトに DeepSeek V4.1 Flash を接続しましょう。base_url を1行変更するだけで動かせます。
LongCat 2.5 と DeepSeek V4.1 Flash の比較に関するよくある質問
Q1:両社の料金は本当に同じですか?
同じなのは DeepSeek のピーク時間帯だけです。LongCat 2.5 の期間限定割引価格は $0.30 / $0.006 / $1.20 で、DeepSeek のピーク時間帯と各項目が同額です。DeepSeek はオフピーク時にすべて半額となり、平日の 09:00〜12:00、14:00〜18:00 以外のすべての時間が対象です。また、LongCat の価格は期間限定の割引価格で、今後変更される可能性があります。
Q2:ベンチマークの比較表を見れば、どちらが優れているかわかりますか?
直接順位をつけることはできません。どちらも公式の自社測定で、テスト用ハーネス、測定日、推論レベルが異なります。DeepSeek の数値は Max レベルでの成績です。差が大きい個別項目に注目するとよいでしょう。Terminal Bench v4.0 では LongCat が 7.3 ポイントリードし、DeepSWE では DeepSeek が 9.6 ポイントリードしています。差が 1〜2 ポイント以内の項目は、引き分けと考えてよいでしょう。
Q3:LongCat 2.5 はいつオープンソース化されますか?
公式からスケジュールは発表されていません。現在、GitHub と HuggingFace にはどちらも「公開予定」と記載されており、モデルの重みは公開されていません。自社環境へのデプロイが必須のプロジェクトでは、現時点で選べるのは DeepSeek V4.1 Flash です。こちらは重みと技術レポートの両方が公開されています。
Q4:APIYI でこの2つのモデルを両方呼び出せますか?
現在呼び出せるのは DeepSeek V4.1 Flash のみです。モデル名は `deepseek-v4.1-flash` と `deepseek-v4.1-flash-1017` で、プラットフォームのモデル一覧に従って課金されます。APIYI では LongCat-2.5 はまだ提供されていませんが、近日中に提供予定です。モデル名と料金は APIYI の apiyi.com にあるモデル一覧をご確認ください。
Q5:バッチ処理のコストを抑えるにはどうすればよいですか?
DeepSeek を使う場合は、2つの設定を活用しましょう。1つ目は、タスクをオフピーク時間帯に実行して単価を半額にすることです。2つ目は、reasoning_effort を中程度に設定することです。レポートによると、60〜80 のレベルでは最大レベルに近い精度が得られ、トークン予算は最大レベルの半分未満で済みます。また、キャッシュヒット時の料金は非ヒット時の 1/50 です。固定のシステムプロンプトやツール定義をリクエストの先頭に置くと、ヒット率を高められます。
まとめ:LongCat 2.5 と DeepSeek V4.1 Flash、どう選ぶ?
結論はシンプルです。同じ価格でも得意分野は異なるため、タスクに応じて使い分け、バッチ処理はオフピーク時間に実行しましょう。
- 規模:LongCat は総パラメータ数 1.6T/活性化パラメータ数 48B。DeepSeek は総パラメータ数 552B/活性化パラメータ数は入力時 8B、出力時 16B。コンテキストウィンドウはいずれも 1M。
- 出力上限:LongCat は 128K、DeepSeek は 384K。長い出力が必要なタスクには DeepSeek を選びましょう。
- 価格:LongCat の期間限定価格は DeepSeek のピーク時価格と同額。DeepSeek はオフピーク時に半額となり、試算例では $0.2112 に対して $0.1056 です。
- ベンチマーク:長時間にわたるターミナルタスクでは LongCat が 7.3 ポイント、リポジトリ内のバグ修正では DeepSeek が 9.6 ポイントリード。その他の項目はおおむね互角です。
- オープンソース:DeepSeek は公開済みですが、LongCat の重みは公開されていません。
- 接続:どちらも OpenAI 形式と Anthropic 形式に対応しており、Claude Code では環境変数を変更するだけで切り替えられます。
一言でまとめると、まずタスクごとの使い分け表を参考にメインを選び、もう一方を補完用にしましょう。バッチ処理はできるだけオフピーク時間に実行するのがおすすめです。DeepSeek V4.1 Flash は、APIYI apiyi.com の統一インターフェースを通じて、まず小規模に検証してからメインの構成を決めることができます。
📚 参考資料
- LongCat-2.5 公式ブログ:モデルの位置づけ、構造、学習、エンジニアリングの詳細
- リンク:
longcat.ai/blog/longcat-2.5 -
内容:パラメータ規模、ビジュアルトークンの方式、W4A4 推論データ、公式評価表
-
LongCat オープンプラットフォームのドキュメント:価格、エンドポイント、Claude Code との接続
- リンク:
longcat.ai/platform/docs -
内容:期間限定の割引価格、429 エラーへの対処、利用枠パッケージと無料付与のルール
-
DeepSeek V4.1 Flash リリース記事:構造、オープンソース化、API の変更点
- リンク:
deepseek.com/news/deepseek-v4-1-flash -
内容:非対称 MoE、KV Cache の圧縮、モデル名の移行に関する説明
-
DeepSeek API 価格ページ:ピーク時・オフピーク時の価格と同時実行数の制限
- リンク:
api-docs.deepseek.com/quick_start/pricing -
内容:ピーク・オフピーク時間帯の定義、同時実行数 2500、検索・取得の別料金
-
DeepSeek-V4.1-Flash 重みリポジトリ:オープンソースの重みと技術レポート
- リンク:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - 内容:Table 3 のベンチマーク結果と、5.3.3 節の推論レベル分析
著者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお気軽にお問い合わせください。接続に関するその他の資料は、docs.apiyi.com のドキュメントセンターをご覧ください。