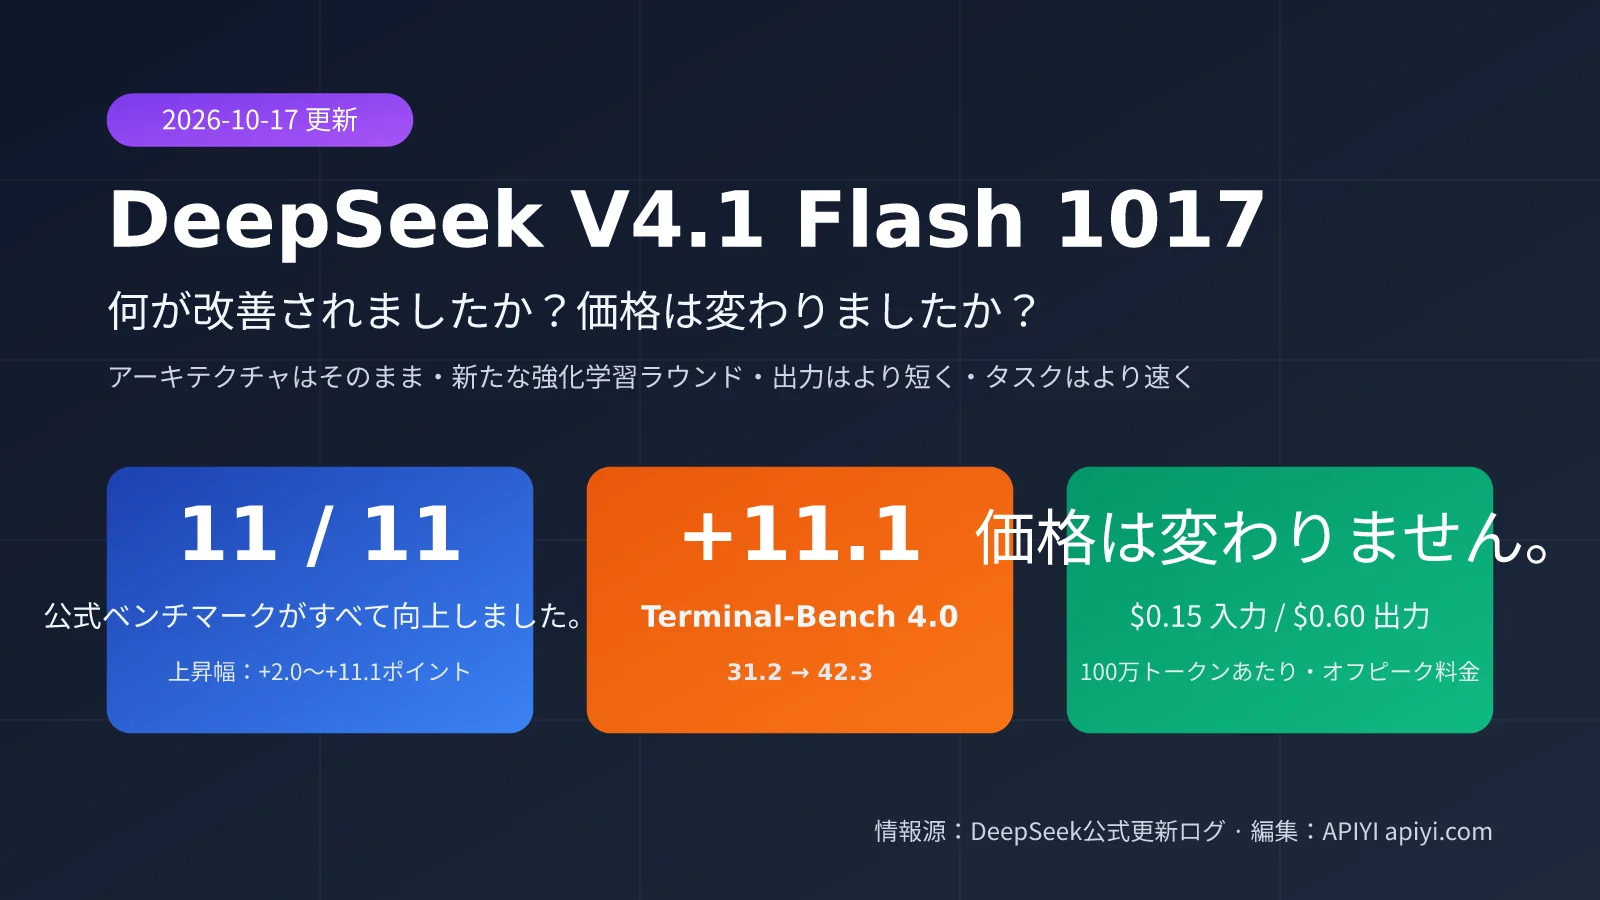
2026年10月17日、DeepSeekはV4.1 FlashをひそかにDeepSeek-V4.1-Flash-1017へアップグレードしました。公式は小規模なアップデートと位置づけていますが、公開されたデータを見ると、公式が公表した11項目のベンチマークはすべて上昇し、Terminal-Bench 4.0は一度に11.1ポイント向上しています。これを「小さな修正」と片づけることはできません。
開発者が特に気になるのは、次の2点でしょう。DeepSeek V4.1 Flash 1017では何が改善されたのか? 価格に変更はあったのか? この記事では、DeepSeek公式の更新履歴、料金ページ、Hugging Faceのモデルカードに記載されたデータだけをもとに解説します。サードパーティの情報は、別途その旨を明記します。
この記事のポイント:1017バージョンの実際の性能向上、価格据え置きが実質的な値下げを意味する理由、そしてオフピーク時間帯を活用してDeepSeek APIのコストをさらに半分に抑える方法がわかります。
DeepSeek V4.1 Flash 1017とは:アーキテクチャを変えずに行われた小規模アップデート
DeepSeek V4.1 Flashは、2026年9月10日に発表された新しいアーキテクチャファミリーの中で最小のモデルで、画像理解にネイティブ対応しています。1017は、リリースから約1カ月後に行われた初めてのアップデートです。公式の更新履歴は簡潔で、モデルをDeepSeek-V4.1-Flash-1017にアップグレードし、Web版とアプリを同時に更新したとのことです。APIの呼び出し方法と価格に変更はありません。
Hugging Faceの技術情報を見る限り、1017は同じアーキテクチャを引き継いでいます。主幹パラメーターは552Bで、プリフィル段階ではトークンあたり約8B、デコード段階では約16Bがアクティブになります。さらに、196BのEngram条件付きメモリを備えています。英語圏コミュニティの分析では、今回の変更は新たな強化学習による後学習の結果と見られています。設定ファイル、トークナイザー、プロンプトのエンコードには変更がないため、既存のコードを修正する必要はありません。
| 項目 | DeepSeek V4.1 Flash 1017 | 説明 |
|---|---|---|
| リリース日 | 2026-10-17 | 9月10日の初版以来、初めてのアップデート |
| APIモデル名 | deepseek-flash |
エイリアスは自動的に最新バージョンを参照 |
| 旧モデル名 | deepseek-v4-flash など |
引き続き呼び出し可能。1017にルーティングされ、Flashの料金が適用 |
| アーキテクチャ | MoE、主幹552B、アクティブ8B/16B | 初版と同じ |
| コンテキスト / 最大出力 | 1M / 384K | 公式料金ページのデータ |
| 思考モード | 思考(デフォルト)と非思考 | どちらのモードも利用可能 |
| マルチモーダル | 画像入力に対応 | Pro版は現時点で画像に未対応 |
| オープンソースライセンス | MIT | 重みはHugging FaceとModelScopeで公開 |
| 同時実行上限 | 2,500 | Pro版は500 |
注目したいのは、公式が特に言及している点です。1017はDeepSeek Harness、Tencent CodeBuddy、WorkBuddy向けに最適化されており、DeepSeek Harness 0.2.1-rc.1以降の使用が推奨されています。今回の学習では、Agentによるコーディングが重点的に扱われたことがうかがえます。そのため、自前のAgentループを使っている場合、実際の効果は公式の数値ほど大きくならない可能性があります。
🎯 技術的なアドバイス:モデルのエイリアスは自動的に新バージョンを参照します。本番トラフィックを切り替える前に、実際の業務データを使って回帰テストを行うのがおすすめです。APIYI(apiyi.com)を利用すれば、同じAPIキーでDeepSeekやほかの主要モデルを呼び出せるため、同一の評価スクリプトで横並びに比較できます。
DeepSeek V4.1 Flash 1017は何を改善したのか:11項目のベンチマークを徹底比較
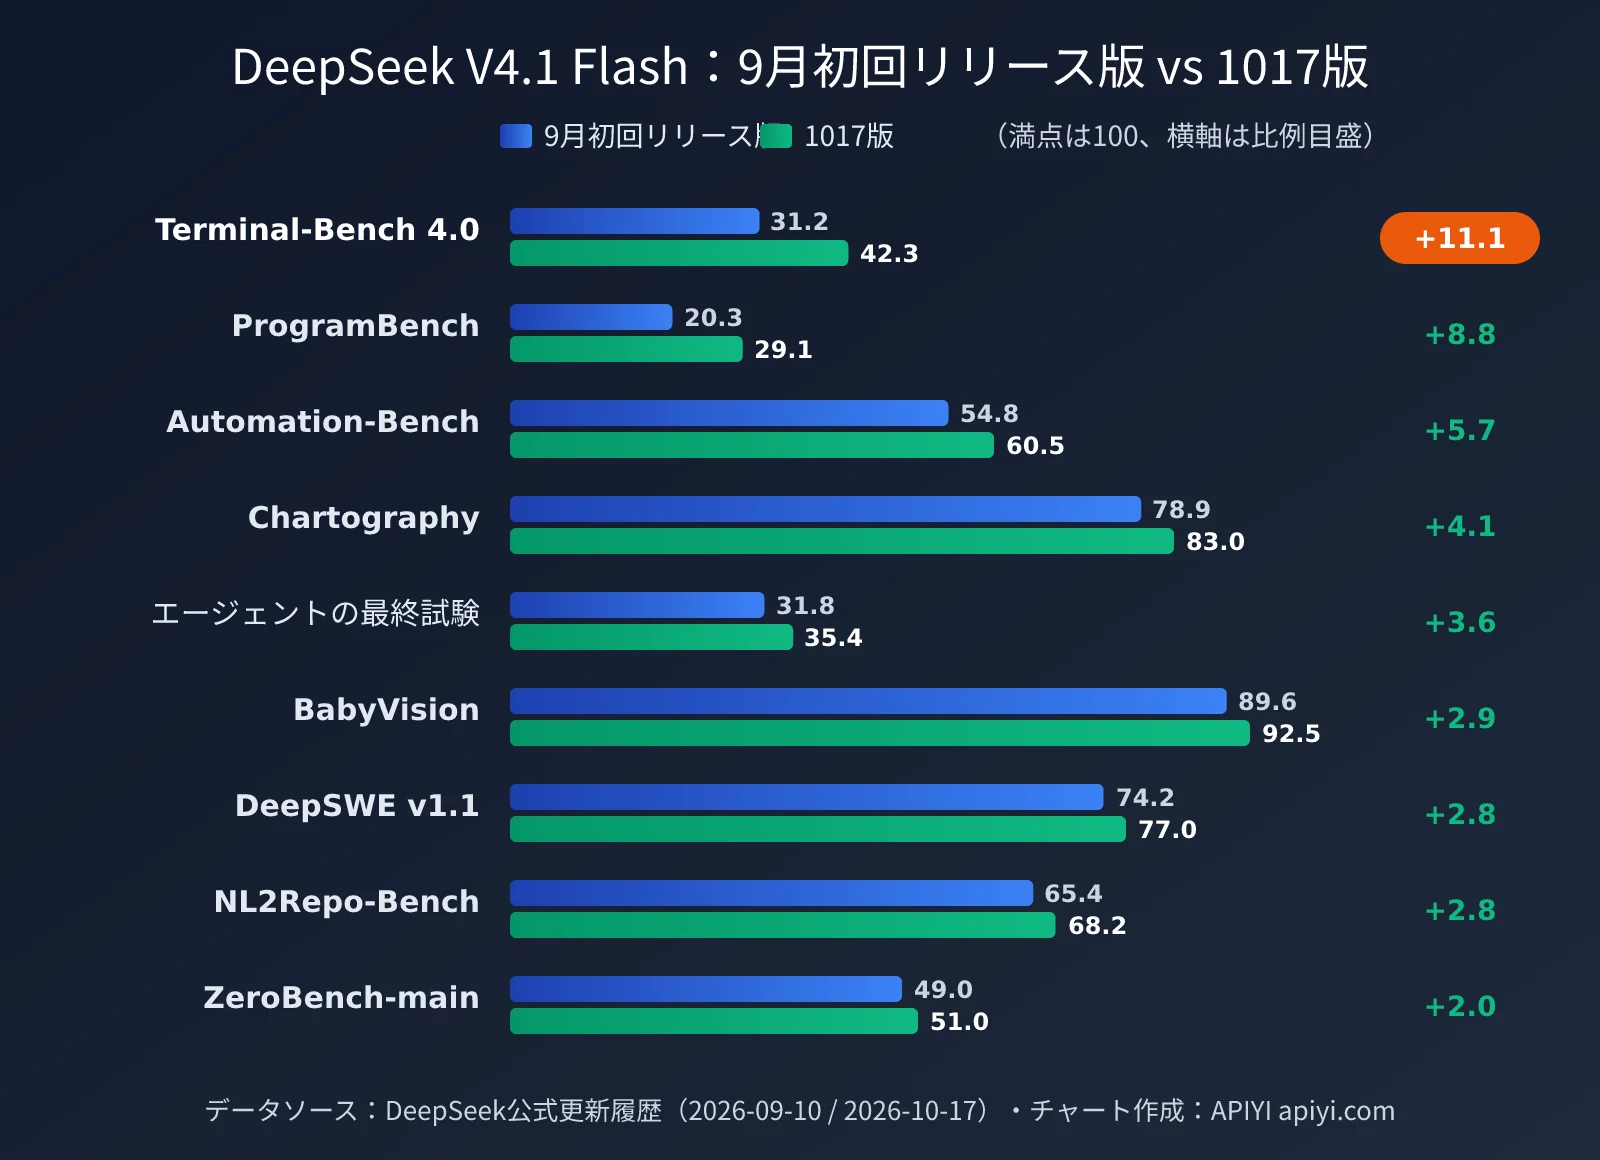
「何が改善されたのか」を知るには、公式の9月初版と10月の1017版のスコアを並べて見るのが最もわかりやすいでしょう。以下のデータはすべてDeepSeek公式の更新ログに基づいています。Apex Benchの旧スコアは公式ログに記載がないため、英語圏コミュニティによる集計値を参考として掲載しています。
| ベンチマーク | 能力の評価軸 | 9月初版 | 1017版 | 向上幅 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | ターミナルAgentタスク | 31.2 | 42.3 | +11.1 |
| ProgramBench | プログラム生成 | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | 総合推論(旧スコアは第三者データ) | 64.6 | 72.1 | +7.5 |
| HLE(ツールなし) | 高難度の知識推論 | 36.8 | 42.6 | +5.8 |
| Automation-Bench | 自動化ワークフロー | 54.8 | 60.5 | +5.7 |
| Chartography(ツールあり) | グラフ理解 | 78.9 | 83.0 | +4.1 |
| Agents’ Last Exam | 汎用Agent | 31.8 | 35.4 | +3.6 |
| BabyVision(ツールあり) | 視覚理解 | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | ソフトウェアエンジニアリング | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | 自然言語からのリポジトリ生成 | 65.4 | 68.2 | +2.8 |
| ZeroBench-main(ツールあり) | 視覚推論 | 49.0 | 51.0 | +2.0 |
この表からは、3つの傾向が読み取れます。1つ目は、伸びが最も大きいのがAgentやプログラミング関連のタスクだということです。Terminal-Bench 4.0とProgramBenchは、どちらも相対的に35%を超える伸びを記録しており、HarnessとCodeBuddy向けに最適化したという公式発表とも一致します。2つ目は、視覚系のベンチマークも2〜4ポイント安定して向上していることです。今回の後学習で、マルチモーダル能力が犠牲になっていないことがわかります。3つ目は、ベンチマークによってテスト条件が前後で完全には一致していないことです。たとえば、Automation-Benchの新版にはv1.0.6と記載されていますが、HLEの初版はツールを使用したかどうかが明記されていません。そのため、単一の数値だけを見て判断するのは避けたほうがよいでしょう。
DeepSeek V4.1 Flash 1017の効率改善:出力が短く、タスクも速く完了
スコアに加えて、公式が強調しているのが見落とされがちな変化です。1017版はタスクの完了にかかる時間が短く、出力も短くなっています。トークン課金のAPIでは、スコアと同じくらい重要なポイントです。同じタスクでも出力するトークンが減れば、その分だけ料金も下がります。
ただし、DeepSeekは具体的に何%短縮されたかを公表しておらず、英語圏コミュニティにも信頼できる前後比較の測定結果はまだありません。確実な方法は、自社の業務データでusage.completion_tokensの変化を集計し、実際にどれだけコストが下がったかを確かめることです。
英語圏コミュニティでは、今回の学習手法を「Wish-Driven Programming(願望駆動型プログラミング)」と表現しています。モデルがまずプロジェクトを一貫して完成させ、目標と照らし合わせて自己採点しながら改善を重ねる手法です。公式が紹介した事例には、3Dでの故宮復元、ブラウザー上のレースゲーム、Godotを使った『Portal 2』の再現などがあります。こうした長い工程を伴うプロジェクトは、Terminal-BenchやProgramBenchのようなベンチマークとまさに関連しており、Agent系のスコアが大きく伸びた理由も説明できます。
DeepSeek V4.1 Flash 1017の価格は変わった?閑散時間帯・ピーク時間帯の料金を解説
まず結論です。DeepSeek V4.1 Flash 1017のAPI価格は変更されておらず、9月の初回リリース版と同じです。ただし、「変更なし」には2つの背景があります。9月の初回リリース時点ですでに一度値下げされていること、そして現在のDeepSeekは閑散時間帯とピーク時間帯の2段階料金を採用しており、時間帯によって実際の単価が2倍異なることです。
| 料金項目(100万Tokenあたり) | Flash 閑散時間帯 | Flash ピーク時間帯 | V4 Pro 閑散時間帯 | V4 Pro ピーク時間帯 |
|---|---|---|---|---|
| 入力(キャッシュヒット) | $0.003 | $0.006 | $0.022 | $0.044 |
| 入力(キャッシュミス) | $0.15 | $0.30 | $0.66 | $1.32 |
| 出力 | $0.60 | $1.20 | $1.98 | $3.96 |
公式が定めるピーク時間帯は、月曜から金曜のUTC 01:00~04:00と06:00~10:00です。北京時間に換算すると、平日の09:00~12:00と14:00~18:00にあたります。中国の法定祝日はピーク時間帯に含まれません。それ以外の時間帯、つまり夜間、昼休み、週末、祝日の終日はすべて閑散時間帯料金となり、ピーク時間帯料金の半額で利用できます。
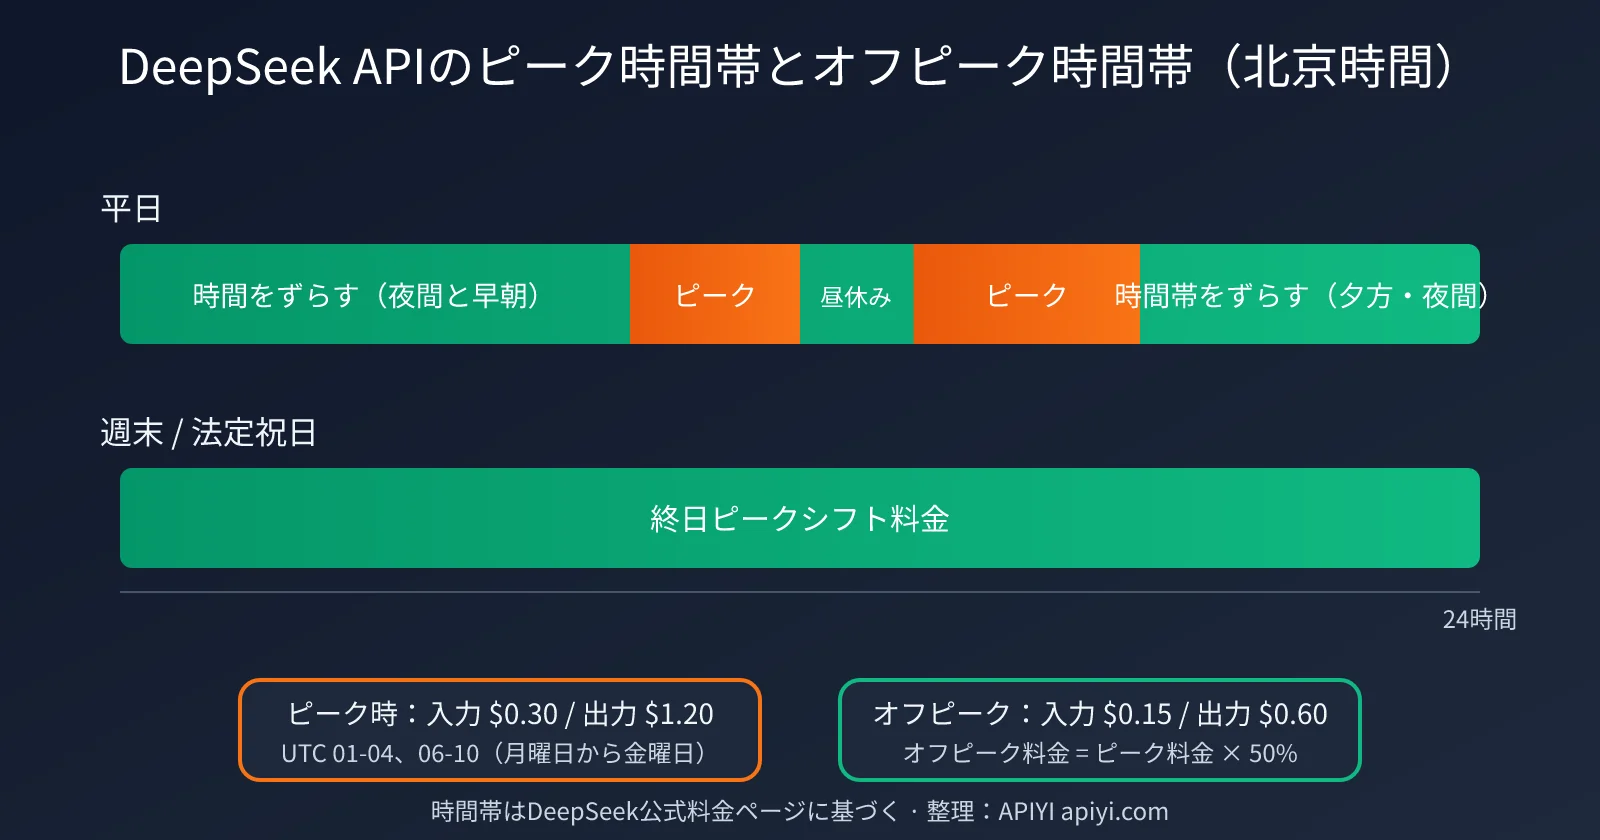
この時間帯設定は、中国国内のチームに直接影響します。ピーク時間帯のほとんどが、国内の勤務時間と重なるためです。バッチ翻訳、オフラインのデータラベリング、コードリポジトリのスキャンなど、リアルタイムでの応答が不要な作業は、18時以降や週末に実行するようスケジュールすれば、単価をすぐに半分にできます。これは、どんなプロンプト最適化よりも直接的なコスト削減策です。
DeepSeek V4.1 Flashの価格改定の推移
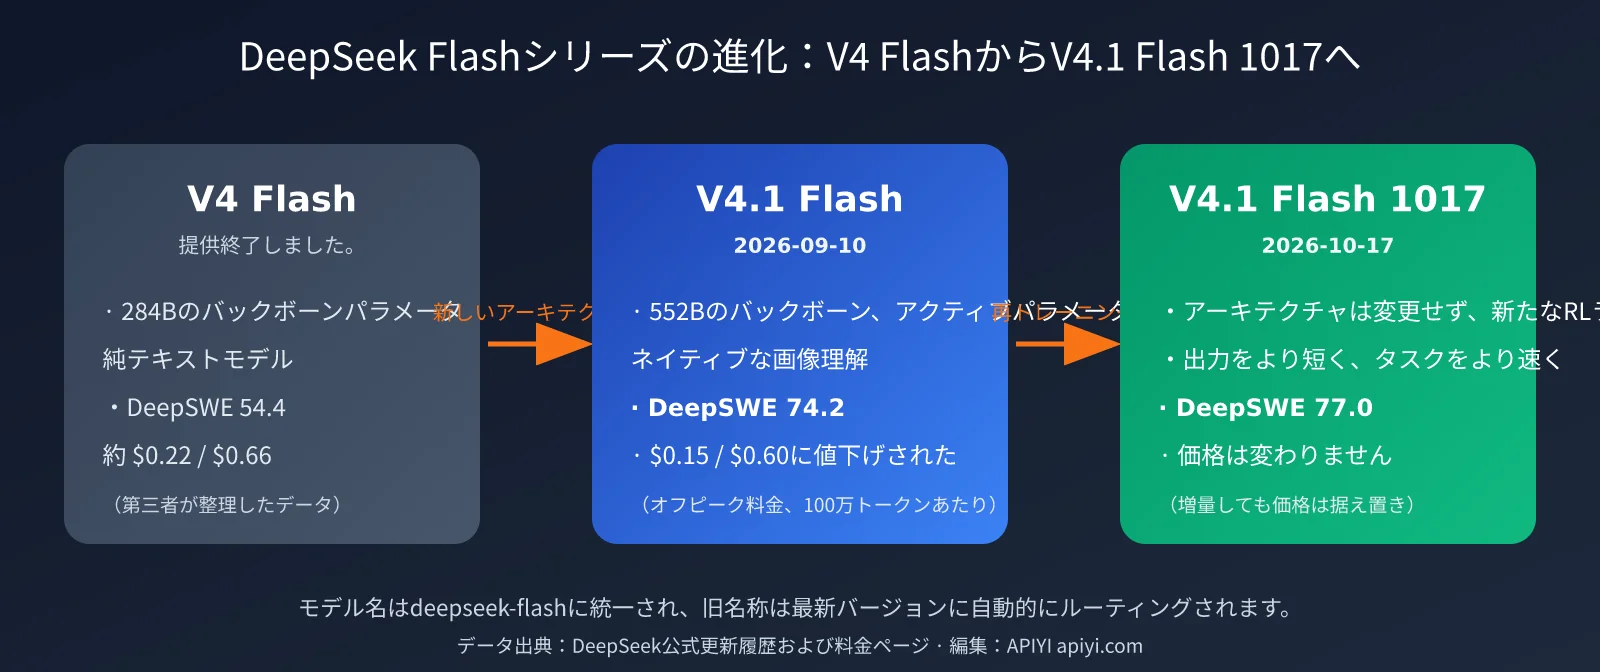
期間を広げて見ると、Flashシリーズは2か月の間に「値下げ」から「価格据え置きで性能向上」へと進みました。V4 Flash時代の価格は英語圏のコミュニティによる情報整理に基づく参考値です。9月版と10月版のデータは公式情報に基づいています。
| バージョン | リリース日 | 入力(キャッシュミス) | 入力(キャッシュヒット) | 出力 | 変更点 |
|---|---|---|---|---|---|
| V4 Flash | 2026年9月以前 | 約$0.22 | 約$0.007 | 約$0.66 | 提供終了 |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | 公式に値下げを発表 |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | 価格据え置き、性能向上 |
表のV4.1シリーズの料金は閑散時間帯のものです。ピーク時間帯は料金が2倍になります。
「価格据え置き」は実質的な値下げ
単価が変わらなくても、タスク全体の費用は「単価 × Token数」で決まります。1017では出力が短くなったと公式に確認されているため、同じタスクでも消費する出力Tokenが減ります。出力単価は入力単価の4倍なので、入力を減らすよりも出力を短くするほうが、コスト削減効果は大きくなります。
例として、あるAgentタスクが閑散時間帯に、キャッシュミスの入力Tokenを100万、出力Tokenを20万消費するとします。この場合、費用は約$0.15 + $0.12 = $0.27です。出力量が20%減った場合(あくまで仮定であり、実際の数値はご自身の環境で測定してください)、出力費用は$0.12から約$0.096に下がります。さらに、長いコンテキストを再利用してキャッシュヒット料金の$0.003が適用されれば、実際のコストをもう一段抑えられます。
💰 コスト削減のポイント:バッチ処理や予算を重視するプロジェクトでは、リアルタイム性が不要なタスクを閑散時間帯に実行し、固定のシステムプロンプトをできるだけ再利用してキャッシュヒット率を高めましょう。APIYI(apiyi.com)経由でAPIを利用すれば、各モデルの利用状況を一元的に確認でき、タスクごとの実コストも把握しやすくなります。
Search・Fetch API:1017と同時に公開された新たな課金項目
1017と同時に発表されたもう一つの変更は、DeepSeekが独自のSearch(ウェブ検索)とFetch(ウェブページ取得)機能を外部開発者向けに公開したことです。この2つの機能はモデルのToken料金とは別に、リクエスト成功1,000回あたり各$0.75で課金されます。
公式の料金ページでは、移行期間についても案内されています。DeepSeek Harness、Claude Code、Codexから行う該当リクエストは現在無料ですが、北京時間2026年11月1日0時からリクエストごとの課金が始まります。Agentのワークフローでウェブ検索を頻繁に利用する場合は、11月までに呼び出し回数を集計し、追加コストを事前に見積もっておきましょう。
DeepSeek V4.1 Flash 1017 クイックスタート:API呼び出し例
1017 ではモデル名 deepseek-flash が引き継がれているため、既存のコードは変更しなくても自動的に新バージョンを利用できます。以下は、OpenAI SDKと互換性のある最小限の呼び出し例です。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェースを使用
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # 実際に利用できるモデル名は、プラットフォームのモデル一覧を確認してください
    messages=[{"role": "user", "content": "用 Python 写一个读取 CSV 并按列求和的函数"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # Token 使用量を記録し、新旧バージョンの出力長を比較できるようにする
完全なコードを表示:新旧バージョンの出力長を比較するスクリプト
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース。1つのキーで複数のモデルを呼び出せる
)

PROMPTS = [
    "解释 Python 中生成器和迭代器的区别,并给出示例",
    "写一个带重试和指数退避的 HTTP 请求函数",
    "把下面的 SQL 改写成 pandas 代码:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # 過去の記録にある completion_tokens と今回の結果を比較すれば、1017 で出力がどれほど短くなったかを推定できる
    print(run("deepseek-flash", PROMPTS))
スムーズに動かすための実践的なポイントをいくつか紹介します。
- 思考モード:
deepseek-flashはデフォルトで思考モードが有効です。簡単な質疑応答やフォーマット変換などのタスクでは、非思考モードに切り替えると、出力 Token をさらに節約できます。具体的なパラメーターの指定方法は、公式ドキュメントを確認してください。 - サンプリングパラメーター:Hugging Faceのモデルカードでは、
temperature=1.0、top_p=0.95が推奨されています。旧バージョン向けに温度を調整していた場合は、改めてテストすることをおすすめします。 - 旧モデル名:
deepseek-v4-flashでも引き続き呼び出せますが、現在は 1017 にルーティングされています。今後エイリアスが廃止された際の問題を避けるため、deepseek-flashに統一することをおすすめします。 - 回帰テスト:出力が短くなることで、固定フォーマットや長さを前提とする後続の処理に影響する可能性があります。切り替える前に、実際のサンプルでテストしてください。
🚀 クイックスタート:プロトタイプを素早く構築するには、APIYI(apiyi.com)プラットフォームがおすすめです。OpenAI互換のインターフェースをすぐに利用でき、数分でDeepSeek V4.1 Flash 1017を既存プロジェクトに組み込み、ほかのモデルとのA/B比較も行えます。
DeepSeek V4.1 Flash 1017 はどんな用途に向いている?:V4 Proとの比較と選び方
1017のアップデート後に気になるのは、「より高価なV4 Proを使う必要はあるのか」という点です。公式の料金表を見ると、価格、同時実行数、視覚機能ではFlashが優位です。一方、Proは現在もDeepSeekが一般公開している、より大規模なモデルです。
| 比較項目 | deepseek-flash(V4.1 Flash 1017) | deepseek-v4-pro(V4 Pro 0813) | おすすめ |
|---|---|---|---|
| 出力料金(オフピーク時) | $0.60 / 100万 Token | $1.98 / 100万 Token | FlashはProの約30% |
| コンテキスト/最大出力 | 1M / 384K | 1M / 384K | 同等 |
| 視覚理解 | 対応 | 非対応 | 画像を入力するならFlash |
| 同時実行数の上限 | 2,500 | 500 | 大量のバッチ処理にはFlash |
| Agent向けコーディング最適化 | Harness、CodeBuddy向けに個別最適化 | 汎用 | コーディングAgentでは、まずFlashを試す |
| 利用可能なプラットフォーム | DeepSeek公式、APIYI(apiyi.com)など | 同左 | 統一インターフェースなら切り替えが簡単 |
以上を踏まえると、用途に応じて次のように選べます。
- コーディングAgentとターミナルの自動化:今回、特に大きく強化された領域であり、料金もProの約3分の1のFlash 1017が第一候補です。
- 図表、スクリーンショット、ドキュメントの理解:Proは現在、視覚入力に対応していないため、Flashを選びます。
- 大量のオフラインタスク:Flashは同時実行数の上限が2,500で、オフピーク料金も利用できるため、コストパフォーマンスに優れています。
- 1回ごとの回答品質を最重視する複雑な推論:FlashとProを同じサンプルで比較してから決めるのがおすすめです。ベンチマークスコアだけで判断しないようにしましょう。
💡 選び方のポイント:どのモデルを選ぶかは、タスクの種類と求める品質によって変わります。APIYI(apiyi.com)プラットフォームで、実際のサンプルを使ってFlashとProを同時にテストするのがおすすめです。統一インターフェースならモデル名を1か所変更するだけで切り替えられるため、すばやく結論を出せます。
よくある質問
Q1:DeepSeek V4.1 Flash 1017を使うために、コードの変更は必要ですか?
必要ありません。公式発表によると、APIの呼び出し方法は変わりません。deepseek-flash は自動的に1017バージョンを指し、旧名称の deepseek-v4-flash も新バージョンにルーティングされます。おすすめするのは、出力が短くなった後も後続の処理で問題なく解析できるか、回帰テストで確認することです。APIYI(apiyi.com)を利用すれば、テスト用の利用枠を使って、新バージョンが自社の業務にどう適合するかをすばやく検証できます。
Q2:DeepSeek V4.1 Flash 1017の料金は、結局変わったのですか?
単価は変わっていません。オフピーク時は、キャッシュ未ヒットの入力が$0.15、キャッシュヒットが$0.003、出力が$0.60(いずれも100万トークンあたり)で、ピーク時は2倍です。ただし、1017は出力が短くなったため、同じタスクにかかる総費用は通常下がります。新たに従量課金の対象となるのはSearch APIとFetch APIで、どちらも成功リクエスト1,000件あたり$0.75です。
Q3:ピーク時間は日本時間で何時ですか?
平日の日本時間10:00~13:00と15:00~19:00です。UTCでは01:00~04:00と06:00~10:00にあたります。中国の法定休日はピーク時間の対象外です。それ以外の時間帯はすべてオフピーク料金となり、ピーク料金の半額です。
Q4:1017のベンチマーク向上は信頼できますか?
スコアはDeepSeek公式が発表したものです。第三者による独立した再検証は現在も進められています。一部のベンチマークは特定のフレームワークに依存しており、たとえばTerminal-Bench 4.0ではClaude Codeフレームワーク、DeepSWEではMini-SWE-V2フレームワークが使われています。そのため、自作のエージェントループに置き換えると、結果が異なる可能性があります。最も確実なのは、自社のサンプルとフレームワークで実測し、その結果を踏まえて切り替えを判断することです。
Q5:DeepSeek V4.1 Flash 1017をローカル環境にデプロイできますか?
できます。重みはMITライセンスでHugging FaceとModelScopeに公開されており、vLLM、SGLang、Transformersなどの推論フレームワークに対応しています。ただし、主幹モデルのパラメーター数は552Bで、非常に大きなGPUメモリが必要です。中小規模のチームであれば、APIを利用するほうが一般的に費用を抑えられます。
重要なポイント
- 何が改善されたか:アーキテクチャはそのままに、新たな強化学習を実施。公式の11項目のベンチマークすべてでスコアが向上し、Terminal-Bench 4.0は31.2から42.3に上がりました。
- 効率の変化:タスクをより速く完了でき、出力も短くなりました。トークン単位の課金では、タスクあたりのコストを直接削減できます。
- 料金の変更:単価は据え置きです。オフピーク時は入力$0.15/出力$0.60、ピーク時はその2倍です。ピーク時間は平日の日本時間10~13時と15~19時です。
- 新たな課金:Search APIとFetch APIは、それぞれ成功リクエスト1,000件あたり$0.75です。11月1日から、Harness、Claude Code、Codex経由の呼び出しが課金対象になります。
- 接続方法:従来どおり
deepseek-flashを使えます。コードの変更は不要ですが、切り替え前に回帰テストを実施しましょう。
まとめ
タイトルにある2つの問いに戻ると、答えは次の3点にまとめられます。
- 何が改善されたのか:DeepSeek V4.1 Flash 1017 は、同じアーキテクチャをベースに再トレーニングしたモデルです。特にAgentによるコーディング能力が大きく向上し、視覚理解も安定して改善しています。さらに、出力が短くなり、速度も向上しました。
- 価格に変更はあるのか:変更はありません。9月の値下げ後と同じ価格です。出力が短くなったことで実質的なコストは下がり、オフピーク時間帯ならさらに半額になります。
- 何をすればよいのか:コードの変更は不要ですが、回帰テストを一度実施し、11月から始まるSearch/Fetchの従量課金がAgentのワークフローに与える影響を評価することをおすすめします。
DeepSeekを使ったコーディングAgentやバッチ処理、グラフの理解に取り組んでいる、またはこれから導入するチームにとって、1017は「価格据え置きで性能向上」を実現したアップデートです。早めに切り替えて検証する価値があります。APIYI(apiyi.com)を利用すれば、効果を手早く確認できます。統一されたインターフェースを使って、DeepSeek V4.1 Flash 1017とほかの主要モデルを同じサンプルで比較し、本番トラフィックの配分を決めましょう。
あわせて読みたい Related Articles
DeepSeekシリーズのモデルに興味がある方は、こちらの記事もご覧ください。
- 📘 DeepSeek V4.1 Flash 初公開レビュー:新アーキテクチャとネイティブなマルチモーダル対応 — 9月の初公開版でアーキテクチャがどう変わったのかを解説
- 📊 DeepSeek APIコスト最適化ガイド:キャッシュヒットとオフピーク時間帯の活用 — トークンコストを抑える実践的なテクニックを紹介
- 🚀 コーディングAgent向けモデルの選び方:Flash、Pro、主要クローズドモデルを比較 — 用途ごとに最適な組み合わせを探ります
参考資料
- DeepSeek API 更新履歴: V4.1 Flash と 1017 バージョンの公式リリースノートおよびベンチマークデータ
- リンク:
api-docs.deepseek.com/updates -
説明: 本記事のベンチマークスコアとバージョン情報の主な出典です。
-
DeepSeek モデルと料金: 公式料金、ピーク時間帯、Search/Fetch の課金ルール
- リンク:
api-docs.deepseek.com/quick_start/pricing -
説明: 料金は公式ページの最新情報をご確認ください。
-
Hugging Face モデルカード: DeepSeek-V4.1-Flash のアーキテクチャ、パラメーター、推奨サンプリング設定
- リンク:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
説明: ローカル環境へのデプロイとパラメーター設定の参考資料です。
-
Regolo の比較記事: V4 Flash と V4.1 Flash の料金・ベンチマーク比較
- リンク:
regolo.ai - 説明: 本文で引用している V4 Flash の旧料金は、こちらの第三者による情報整理を参照しています。
著者: APIYI 技術チーム
技術交流: コメント欄でお気軽にご意見をお寄せください。詳しい資料は APIYI のドキュメントセンター(docs.apiyi.com)をご覧ください。