Catatan penulis: Gunakan curl dan SDK untuk mengukur waktu dan memecah DNS, TLS, token pertama, serta total durasi. Empat langkah untuk menentukan apakah hambatan pemanggilan API Model Bahasa Besar dari dalam negeri berasal dari “jalur lintas batas” atau “inferensi model”.
“Kenapa API-nya lambat sekali?” Ini adalah kalimat yang paling sering diucapkan pengembang di dalam negeri saat mengakses API Model Bahasa Besar. Masalahnya, “lambat” hanyalah gejala permukaan. Itu bisa berasal dari resolusi DNS, jabat tangan TLS lintas batas, antrean model, atau mungkin memang modelnya sendiri yang sedang berpikir dengan sungguh-sungguh. Artikel ini akan memperkenalkan metode lokalisasi kecepatan 4 langkah, membantu Anda memecah waktu yang dihabiskan untuk satu permintaan dan secara akurat menentukan akar penyebab lambatnya pemanggilan API Model Bahasa Besar dari dalam negeri.
Ini bukan panduan mistis “coba ganti node saja”, melainkan alur pemecahan masalah yang dapat direproduksi berdasarkan konsultasi integrasi nyata. Kami sering ditanya: jika bisnis dideploy di server Amerika, alamat aksesnya harus diisi apa? Apakah akses dari dalam negeri akan tersendat karena lintas batas? Apakah hasil besar seperti gambar dan video dapat dikirim balik secara utuh? Jawabannya akan diberikan satu per satu di bawah ini.
Nilai inti: Setelah membaca artikel ini, Anda akan belajar menggunakan curl dan Python SDK untuk mengukur waktu per segmen, membedakan waktu yang dihabiskan untuk jalur jaringan dan inferensi model, serta memilih base_url yang tepat sesuai wilayah deployment.
Poin inti lambatnya pemanggilan API Model Bahasa Besar di dalam negeri
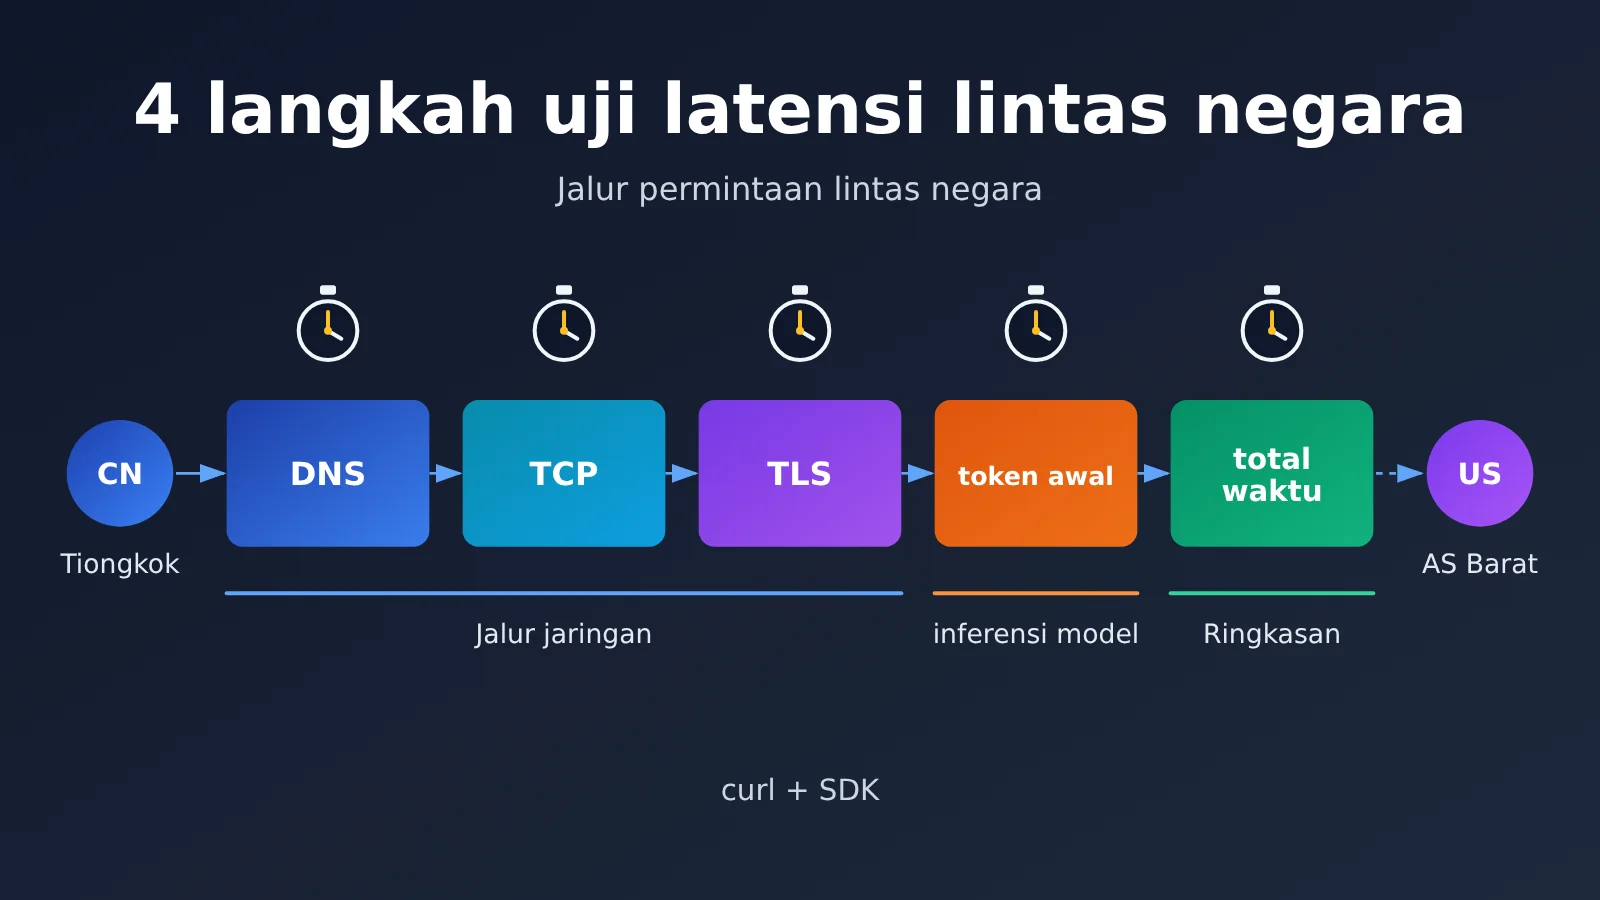
Sebelum mulai mengukur kecepatan, bangun dulu pemahaman dasar: total waktu satu pemanggilan API Model Bahasa Besar adalah hasil penjumlahan “waktu jaringan” dan “waktu model”. Latensi lintas negara hanya memengaruhi yang pertama, sedangkan “lambat” yang banyak orang rasakan justru sebagian besar berasal dari yang kedua.
| Langkah | Apa yang diukur | Alat | Pertanyaan yang bisa dijawab |
|---|---|---|---|
| Langkah 1 | Waktu pembangunan koneksi DNS, TCP, TLS | parameter -w pada curl |
Apakah jalur lintas negara itu sendiri lancar |
| Langkah 2 | Latensi token pertama (TTFT) | pemanggilan streaming SDK | Berapa lama menunggu sampai model mulai merespons |
| Langkah 3 | Total waktu dan throughput | SDK non-streaming + statistik multi-putaran | Apakah output panjang dan badan respons besar terkirim dengan stabil |
| Langkah 4 | Diagnosis pembanding | matriks diagnosis | Apakah hambatannya ada di jaringan, model, atau kode |
Dari segmen mana latensi lintas negara terbentuk
Sebuah permintaan HTTPS yang dikirim dari server Anda melewati resolusi DNS, three-way handshake TCP, dan handshake TLS secara berurutan, barulah kemudian badan permintaan dikirim. Dalam skenario lintas negara, handshake TCP dan TLS sama-sama memerlukan beberapa kali round-trip, dan latensi pulang-pergi akibat jarak fisik bisa berlipat beberapa kali. Inilah sumber “lambatnya pembangunan koneksi”. Untungnya, pembangunan koneksi biasanya hanya terjadi pada permintaan pertama; setelah koneksi digunakan ulang, biaya bagian ini turun drastis.
Setelah permintaan tiba di server, masuklah ke tahap inferensi model. Untuk model percakapan, penantian sebelum token pertama muncul bergantung pada ukuran model, panjang input, dan beban saat itu; setelah token pertama, kecepatan output bergantung pada laju generasi model. Berbeda dengan pembuatan gambar dan video: keduanya biasanya mengembalikan hasil berukuran besar secara sinkron, sehingga bandwidth dan stabilitas jalur balik langsung memengaruhi apakah hasil bisa terkirim utuh.
Prinsip menentukan: jaringan lambat atau model lambat
Prinsip penentuannya sebenarnya sederhana: lambat di tahap pembangunan koneksi, lihat jaringan; lambat di token pertama, lihat model dan input; lambat di tahap output dengan fluktuasi besar, lihat jalur balik dan ukuran badan respons. Cukup ukur tiga angka ini, dan sebagian besar masalah “lambat” bisa dipastikan penyebabnya dalam beberapa menit.
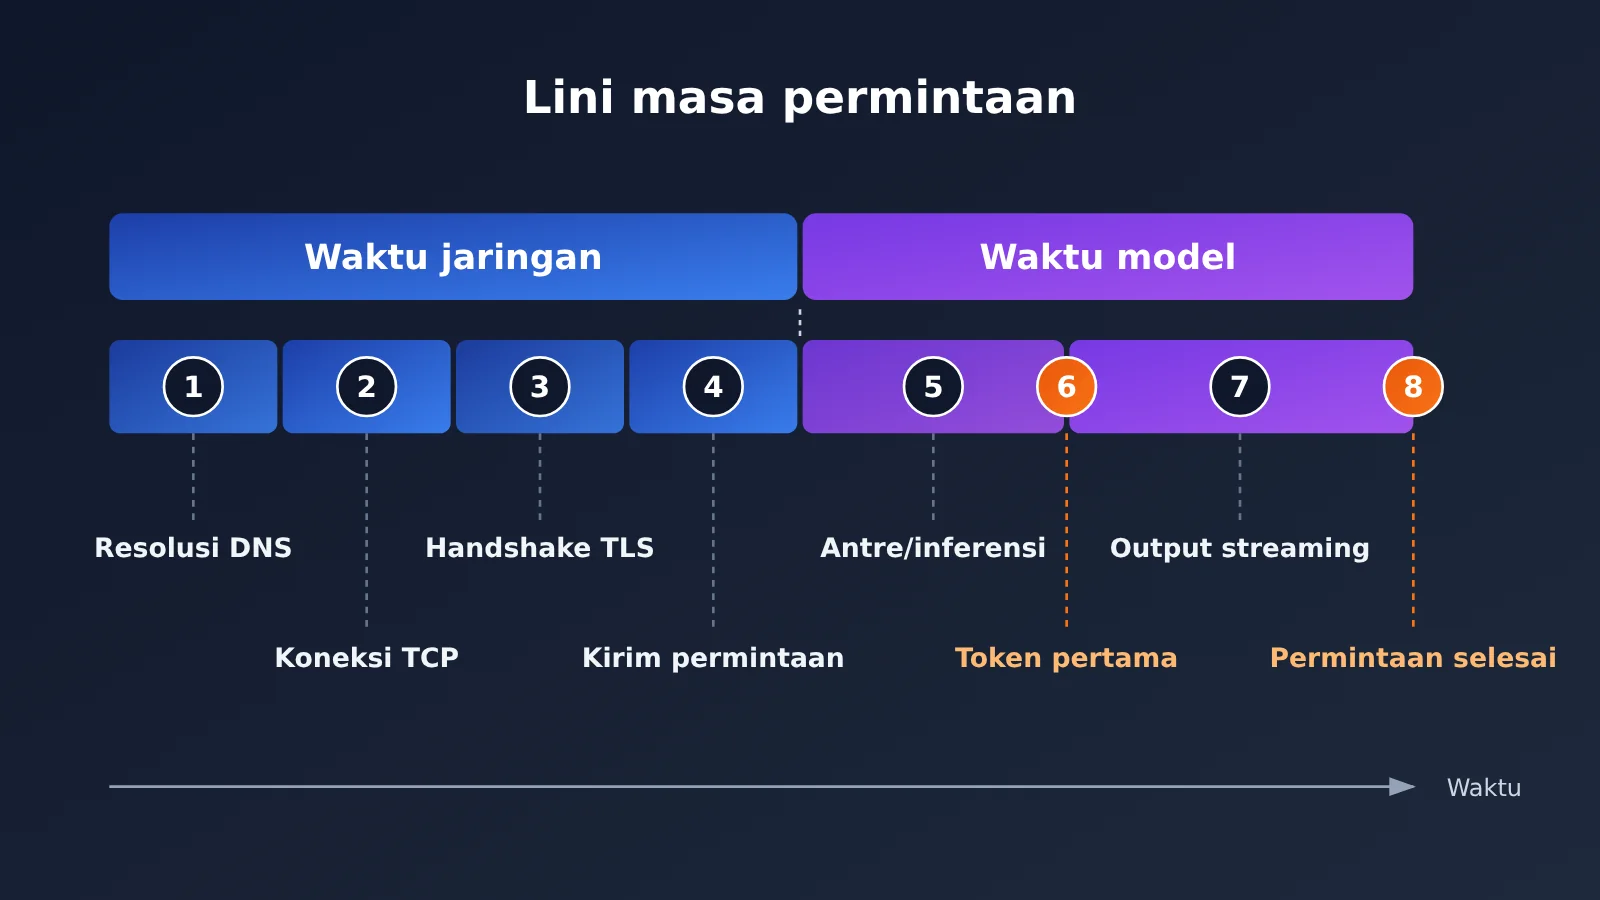
4 Langkah Cepat Tes Kecepatan untuk Melacak Latensi Lintas Negara
Contoh di bawah ini menggunakan antarmuka yang kompatibel dengan OpenAI. Baik layanan Anda ditempatkan di dalam maupun di luar negeri, Anda hanya perlu mengubah base_url untuk terhubung; bagian kode lainnya tidak perlu diubah.
Langkah 1: Uraikan waktu pembentukan koneksi lintas negara dengan curl
Parameter -w bawaan curl dapat menampilkan titik waktu setiap tahap, dan merupakan alat tercepat untuk mendiagnosis latensi lintas negara. Sebaiknya panggil endpoint ringan seperti /v1/models agar waktu inferensi model tidak mengganggu pengukuran jaringan.
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS解析:   %{time_namelookup}s\nTCP连接:   %{time_connect}s\nTLS握手:   %{time_appconnect}s\n首字节:    %{time_starttransfer}s\n总耗时:    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
Perlu diperhatikan bahwa setiap nilai yang ditampilkan curl adalah titik waktu kumulatif sejak permintaan dimulai, bukan durasi independen untuk masing-masing tahap. Arti dan cara menghitung setiap field adalah sebagai berikut:
| Field curl | Arti | Perhitungan durasi per segmen | Penyebab umum jika nilainya tinggi |
|---|---|---|---|
time_namelookup |
DNS selesai di-resolve | Baca langsung | DNS lokal lambat, resolve ke node yang jauh |
time_connect |
Koneksi TCP terbentuk | connect − namelookup | Latensi round-trip lintas negara tinggi, packet loss |
time_appconnect |
Handshake TLS selesai | appconnect − connect | Jaringan berfluktuasi, handshake beberapa kali round-trip |
time_starttransfer |
Byte pertama diterima | starttransfer − appconnect | Pemrosesan server, antrean |
time_total |
Permintaan selesai | total − starttransfer | Ukuran body respons besar, bandwidth jalur balik tidak memadai |
Sebaiknya jalankan 5–10 kali berturut-turut dan amati apakah nilainya stabil. Jika durasi segmen TCP dan TLS sangat berfluktuasi, kualitas jalur tidak stabil; jika nilainya stabil dan berada dalam rentang yang dapat diterima, kemungkinan besar jaringan bukanlah bottleneck utama.
Langkah 2: Mengukur latensi token pertama menggunakan pemanggilan streaming SDK
Koneksi sudah berjalan lancar. Langkah berikutnya adalah melihat seberapa cepat model mulai merespons. Latensi token pertama (Time To First Token, TTFT) adalah metrik yang paling terasa pada aplikasi percakapan—pengguna menatap layar menunggu karakter pertama muncul, dan setiap detik terasa sangat lama.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Dapat digunakan untuk deployment domestik maupun luar negeri
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"首 token 延迟: {time.perf_counter() - start:.2f}s")
        break
Setelah mendapatkan TTFT, kurangi nilainya dengan waktu pembukaan koneksi pada Langkah 1. Sisanya pada dasarnya adalah waktu antrean dan inferensi model. Jika porsi ini sangat mendominasi, optimasi jaringan hanya akan memberi dampak terbatas; sebaiknya pertimbangkan untuk beralih ke model yang lebih cepat, mempersingkat konteks input, atau mengaktifkan output streaming.
Langkah 3: Statistik multi-putaran untuk total waktu dan pengembalian body respons besar
Pengukuran sekali saja mudah terpengaruh fluktuasi sesekali. Untuk evaluasi di lingkungan produksi, sebaiknya lakukan statistik beberapa putaran dan perhatikan median serta nilai maksimum. Skrip lengkap di bawah ini akan mengukur DNS, TCP, TLS, TTFT, dan total waktu secara otomatis, lalu menampilkan ringkasan hasilnya.
Lihat skrip pengukuran lengkap
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # alamat akses terpadu
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """Mengukur waktu DNS, TCP, dan TLS secara terpisah"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """Mengukur latensi token pertama dan total waktu"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "Tulis pengantar produk sekitar 200 kata"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} median {statistics.median(values):.3f}s  "
          f"maks {max(values):.3f}s  min {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"Putaran ke-{i + 1} selesai, output {llm['chars']} karakter")

    print("\n===== Ringkasan kecepatan =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
Untuk endpoint gambar, ada satu hal tambahan yang perlu diperhatikan: pembuatan gambar biasanya berupa panggilan sinkron, dan body respons yang dikembalikan jauh lebih besar daripada teks. Jika total waktu jauh lebih lama daripada waktu byte pertama, atau koneksi sesekali terputus, masalahnya sering ada di jalur balik, bukan karena model lambat menghasilkan. Dalam kasus seperti ini, naikkan timeout klien secukupnya dan lakukan retry idempoten saat terjadi gangguan.
Langkah 4: Menentukan bottleneck dengan matriks diagnostik
Setelah mendapatkan data dari tiga langkah sebelumnya, cocokkan dengan matriks berikut. Biasanya masalahnya bisa langsung teridentifikasi.
| Fenomena | Bottleneck paling mungkin | Cara penanganan prioritas |
|---|---|---|
| Fase DNS terlihat jauh lebih tinggi | Resolusi DNS lokal | Ganti ke layanan DNS yang stabil, aktifkan cache resolusi |
| TCP dan TLS tinggi serta fluktuatif | Kualitas jalur lintas negara | Gunakan ulang koneksi, pilih layanan akses dengan optimasi jalur |
| Koneksi terbentuk normal, TTFT sangat tinggi | Inferensi model atau input terlalu panjang | Ganti ke model yang lebih cepat, ringkas konteks, aktifkan streaming |
| TTFT normal, total durasi lama | Output terlalu panjang atau laju generasi rendah | Batasi max_tokens, pecah tugas |
| Gambar/video kadang terputus | Pengiriman balik body respons besar tidak stabil | Perbesar timeout, retry idempoten, polling asinkron |
| Pertama lambat, berikutnya cepat | Pembentukan koneksi cold start | Gunakan koneksi persisten, reuse client secara global |
🚀 Mulai cepat: Jika Anda ingin langsung menjalankan skrip uji kecepatan di atas, sebaiknya daftar dulu di APIYI (apiyi.com) untuk mendapatkan kunci API. Pengguna baru mendapat kuota uji gratis yang cukup untuk beberapa putaran perbandingan uji kecepatan, tanpa perlu men-deploy proxy tambahan.
Bagaimana memilih base_url untuk berbagai area deployment
Banyak developer masih bingung: jika bisnis di-deploy di luar negeri dan di dalam negeri, apakah perlu mengisi alamat akses yang berbeda? Jawabannya tidak perlu. Server APIYI sendiri berada di AS Barat, sehingga layanan luar negeri mengakses langsung dengan jalur yang secara alami lebih pendek; platform juga menyediakan akselerasi jalur pulang untuk akses dari dalam negeri, dengan fokus menjaga stabilitas pengiriman balik untuk bisnis berukuran respons besar seperti gambar dan video. Jadi di mana pun deployment-nya, cukup gunakan satu base_url yang sama.
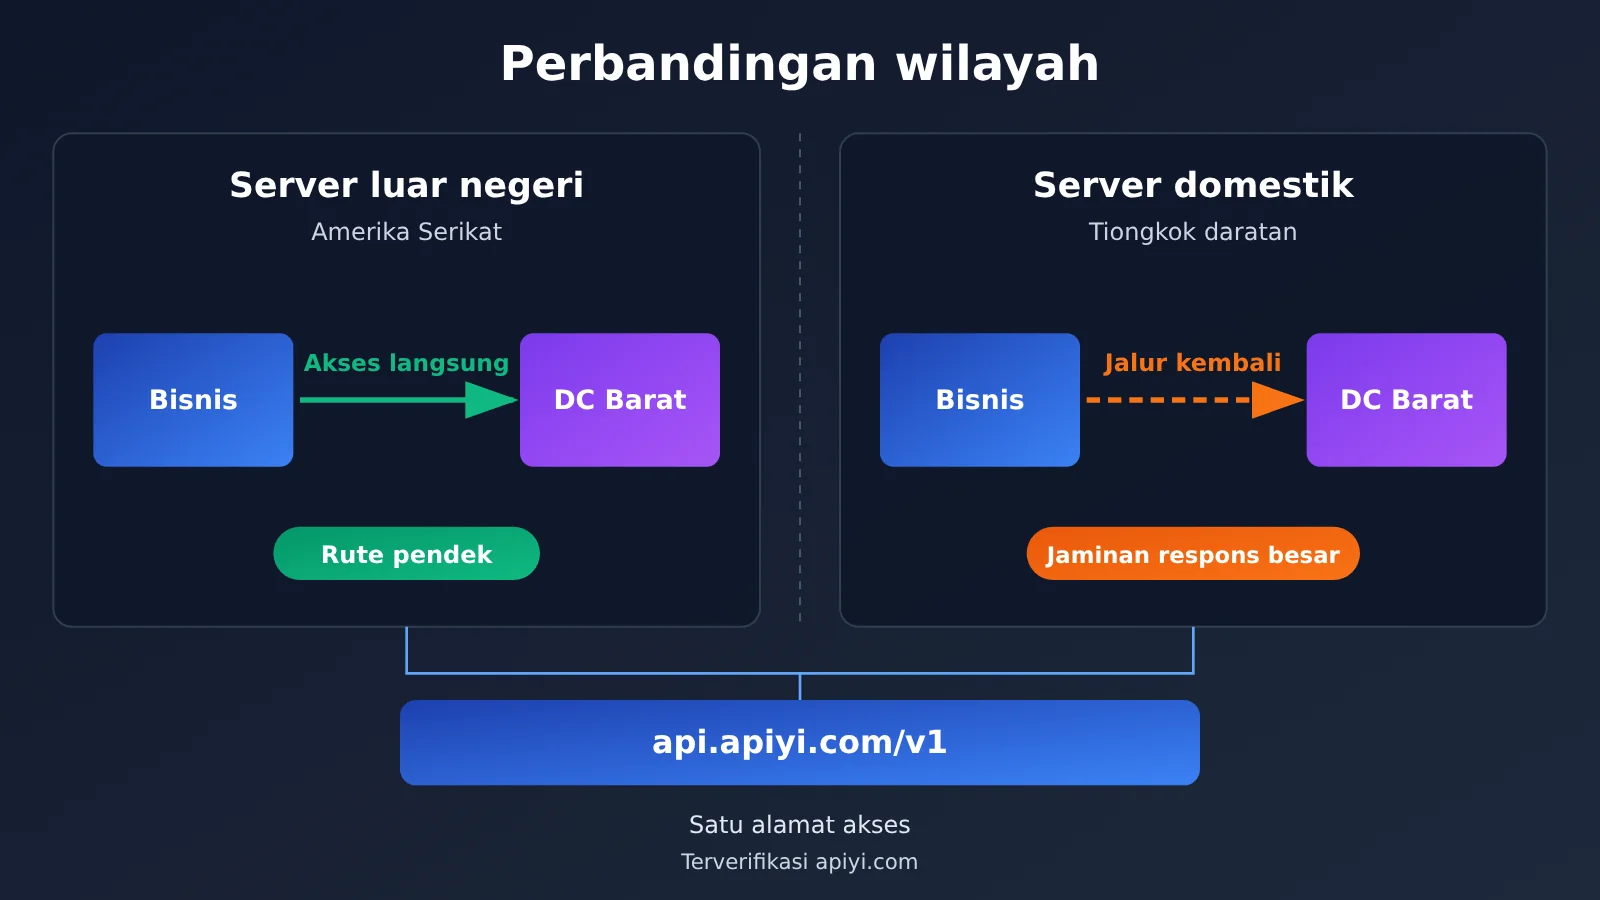
| Lokasi deployment | Karakteristik jalur | Fokus pengukuran kecepatan | Saran akses |
|---|---|---|---|
| AS / AS Barat | Satu region dengan server, latensi round-trip rendah | Fokus pada TTFT dan waktu proses model | Langsung gunakan alamat akses terpadu |
| Eropa / Asia-Pasifik luar negeri | Lintas samudra, tetapi jalur internasional biasanya stabil | Perhatikan TLS handshake dan connection reuse | Alamat akses terpadu + koneksi panjang |
| Tiongkok Daratan | Jalur lintas batas, sudah ada akselerasi jalur pulang | Perhatikan fluktuasi pembentukan koneksi dan pengiriman balik respons besar | Alamat akses terpadu + timeout yang wajar |
| Deployment campuran | Pemanggilan dari beberapa region sekaligus | Uji kecepatan dan bandingkan per region | Satu kode, tanpa konfigurasi bercabang |
Keuntungan desain ini adalah kode yang sama dapat berpindah mulus antara lingkungan pengujian (dalam negeri) dan produksi (luar negeri), tanpa perlu memelihara banyak konfigurasi. Yang benar-benar perlu dilakukan adalah menjalankan 4 langkah pengukuran kecepatan sebelumnya di masing-masing lingkungan deployment, untuk memastikan performa aktual sesuai ekspektasi bisnis.
Saran optimasi pemanggilan lintas batas untuk respons berukuran besar
API gambar dan video paling sensitif terhadap jalur lintas batas. Sebaiknya lakukan beberapa hal berikut di level kode:
- Gunakan ulang
clientsecara global: hindari membuat koneksi baru setiap request; dalam skenario lintas batas, ini bisa menghemat banyak waktu handshake. - Atur timeout berdasarkan jenis bisnis: percakapan teks bisa lebih singkat, sedangkan pembuatan gambar dan pengambilan hasil video harus diberi kelonggaran yang cukup.
- Lakukan retry idempoten saat koneksi terputus: gunakan exponential backoff untuk menghindari pengiriman ulang task generasi dalam waktu singkat.
- Gunakan polling asinkron untuk task video: setelah task dikirim, cek status secara berkala dan unduh hasil setelah siap, sehingga risiko koneksi panjang terputus lebih rendah.
- Catat log durasi per segmen: tulis TTFT dan total durasi ke monitoring, agar masalah bisa ditelusuri dengan cepat.
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Apa itu latensi lintas negara, dan apa bedanya dengan latensi inferensi model?
Latensi lintas negara adalah waktu yang dihabiskan jaringan saat mentransfer permintaan antara server dalam negeri dan server luar negeri, yang terutama terlihat pada tahap pembentukan koneksi TCP, TLS, dan pengiriman balik data. Sedangkan latensi inferensi model adalah waktu yang dibutuhkan server untuk menghasilkan konten, yang terlihat pada waktu tunggu token pertama dan kecepatan output. Keduanya perlu diukur secara terpisah agar arah optimasi bisa tepat sasaran.
Q2: Jika bisnis saya di-deploy di server Amerika Serikat, alamat mana yang harus saya isi untuk memanggil APIYI?
Cukup gunakan `https://api.apiyi.com/v1`. Server APIYI berada di wilayah barat Amerika Serikat, sehingga jalur akses dari bisnis yang di-deploy di AS sangat pendek dan tidak perlu konfigurasi tambahan. Untuk langkah integrasi spesifiknya, Anda bisa merujuk ke panduan quick start di pusat dokumentasi APIYI apiyi.com, cukup tiga langkah untuk menyelesaikannya.
Q3: Servernya di wilayah barat AS, kenapa akses dari dalam negeri juga cukup lancar?
Karena platform telah melakukan akselerasi jalur pulang untuk akses dari dalam negeri, yang terutama bertujuan menjaga stabilitas pengiriman balik untuk bisnis dengan response body besar seperti gambar dan video. Anda bisa menggunakan perintah curl pada langkah 1 di artikel ini untuk menguji langsung di server dalam negeri, lalu amati durasi dan fluktuasi pada tahap TCP dan TLS.
Q4: Latensi token pertama sangat tinggi, apakah ini berarti ada masalah jaringan?
Belum tentu. Pertama, lihat dulu durasi pembentukan koneksi yang diukur dengan curl. Jika pembentukan koneksi normal, maka TTFT yang tinggi biasanya disebabkan oleh model itu sendiri yang lebih besar, konteks input yang terlalu panjang, atau inferensi yang lebih kompleks. Dalam kondisi ini, Anda bisa mencoba beralih ke model yang lebih ringan, merampingkan petunjuk, atau mengaktifkan output streaming untuk memperbaiki pengalaman pengguna.
Q5: Bagaimana cara cepat membandingkan kecepatan respons berbagai model?
Disarankan menggunakan antarmuka agregat yang mendukung banyak model untuk pengujian:
1. Daftar akun di APIYI apiyi.com dan dapatkan kunci API
2. Gunakan skrip uji kecepatan lengkap di artikel ini, cukup ubah variabel `MODEL`
3. Jalankan jumlah putaran yang sama untuk setiap model, lalu bandingkan median TTFT dan waktu total
Karena satu kunci saja sudah bisa memanggil berbagai model seperti OpenAI, Claude, Gemini, dan lainnya, kondisi jaringan saat perbandingan tetap konsisten sehingga kesimpulannya lebih dapat dipercaya.
Q6: Bagaimana cara menelusuri koneksi API gambar yang kadang terputus?
Antarmuka gambar adalah pemanggilan sinkron dengan response body yang besar, sehingga gangguan paling sering terjadi pada tahap pengiriman balik hasil. Disarankan untuk memperbesar timeout klien terlebih dahulu, lalu amati selisih antara `time_total` dan `time_starttransfer` pada curl. Jika selisihnya besar dan tidak stabil, berarti jalur pulang menjadi hambatan; Anda bisa menambahkan retry idempoten dan menghindari pengiriman batch pada jam sibuk.
Q7: Metode uji kecepatan ini punya keterbatasan apa saja?
Hasil uji kecepatan hanya mencerminkan kondisi jaringan pada saat dan lokasi pengukuran; operator yang berbeda dan waktu yang berbeda bisa menunjukkan perbedaan yang cukup signifikan. Selain itu, beban model berubah seiring waktu, sehingga satu kali TTFT tidak bisa mewakili performa jangka panjang. Disarankan untuk mencatat durasi per segmen secara konsisten di lingkungan produksi, lalu mengambil keputusan berdasarkan tren, bukan data satu titik.
Poin-Poin Utama Pengujian Kecepatan Pemanggilan API Model Bahasa Besar di Dalam Negeri
- Pisahkan dulu, baru optimalkan: total waktu sama dengan waktu jaringan ditambah waktu model, jadi wajib diukur per segmen.
- curl untuk menguji pembentukan koneksi: pakai parameter
-wuntuk mendapatkan titik waktu kumulatif DNS, TCP, dan TLS. - SDK untuk mengukur TTFT: pemanggilan streaming mencatat waktu token pertama, jadi kita bisa menilai kecepatan respons model.
- Lihat median dari banyak putaran: hasil satu kali jalan mudah terpengaruh fluktuasi, minimal kumpulkan statistik dari 5 putaran atau lebih.
- Respons besar, perhatikan jalur balik: untuk gambar dan video, perhatikan selisih antara total waktu dan waktu byte pertama.
- Satukan alamat akses: akses lewat APIYI apiyi.com, dalam dan luar negeri memakai
base_urlyang sama.
Ringkasan
Inti dari排查 pemanggilan API Model Bahasa Besar yang lambat di dalam negeri:
- Metode 4 langkah untuk melokalisasi masalah: uji kecepatan pembentukan koneksi, uji kecepatan token pertama, statistik total waktu, lalu pencocokan matriks diagnosis — mempersempit cakupan selapis demi selapis.
- Bedakan dua jenis latensi: latensi lintas negara diatasi dengan penggunaan ulang koneksi dan optimasi jalur; latensi model diatasi dengan pemilihan model dan pemangkasan input.
- Perhatikan respons besar secara terpisah: bisnis gambar dan video perlu mengatur timeout yang wajar, retry idempoten, dan polling asinkron.
base_urltidak perlu dibedakan per wilayah: dari luar negeri terhubung langsung ke data center US West, dari dalam negeri ada jalur balik yang dipercepat — satu konfigurasi sudah cukup.
Daripada menilai “lambat” hanya berdasarkan perasaan, lebih baik luangkan beberapa menit untuk menjalankan skrip pengujian kecepatan dan biarkan data yang memberi tahu di mana hambatannya. Disarankan mengambil kuota uji gratis lewat APIYI apiyi.com, lakukan pengujian nyata di lingkungan deployment Anda sendiri, baru kemudian tentukan pemilihan model dan strategi timeout.
📚 Referensi
- Pusat Dokumentasi APIYI: Penjelasan alamat akses dan proses integrasi tiga langkah
- Tautan:
docs.apiyi.com -
Keterangan: Mencakup konfigurasi mode kompatibel OpenAI, hal yang perlu diperhatikan saat memanggil API gambar, dan pemecahan masalah koneksi terputus
-
Manual resmi curl: Penjelasan lengkap variabel write-out
-w - Tautan:
curl.se/docs/manpage.html -
Keterangan: Lihat definisi resmi untuk bidang timing seperti
time_namelookup,time_appconnect, dan lainnya -
OpenAI Python SDK: Repositori open source resmi
- Tautan:
github.com/openai/openai-python - Keterangan: Cara menggunakan panggilan streaming, timeout, dan parameter retry
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika Anda mengalami masalah selama pengujian kecepatan, silakan hubungi kami melalui halaman utama situs APIYI. Materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com