Nota del autor: con curl y el SDK medimos y desglosamos DNS, TLS, el primer token y el tiempo total. En 4 pasos podrás saber si el cuello de botella al llamar a una API de Modelos de Lenguaje Grande desde China está en la “ruta transfronteriza” o en la “inferencia del modelo”.
«¿Por qué va tan lenta la API?» Es lo que más dicen los desarrolladores en China cuando empiezan a usar una API de Modelos de Lenguaje Grande. El problema es que «lento» es solo la punta del iceberg: puede venir de la resolución DNS, del handshake TLS transfronterizo, de la cola del modelo o, simplemente, de que el modelo se está tomando su tiempo para pensar. Este artículo presenta un método de diagnóstico de velocidad en 4 pasos para desglosar el tiempo de una solicitud y determinar con precisión de dónde viene la lentitud al invocar API de Modelos de Lenguaje Grande desde China.
Esta no es una guía esotérica de “prueba cambiando de nodo”, sino un proceso de diagnóstico reproducible basado en consultas reales de integración. Nos preguntan a menudo: si el negocio está desplegado en servidores de Estados Unidos, ¿qué dirección de acceso hay que poner? ¿El acceso desde China se ralentiza por cruzar la frontera? ¿Se pueden devolver completos los resultados grandes, como imágenes y videos? A continuación respondemos una por una.
Valor clave: al terminar el artículo, sabrás usar curl y el SDK de Python para medir por segmentos, distinguir el tiempo de la ruta de red del de la inferencia del modelo y elegir bien el base_url según la región de despliegue.
Puntos clave sobre la lentitud al invocar APIs de Modelo de Lenguaje Grande desde China
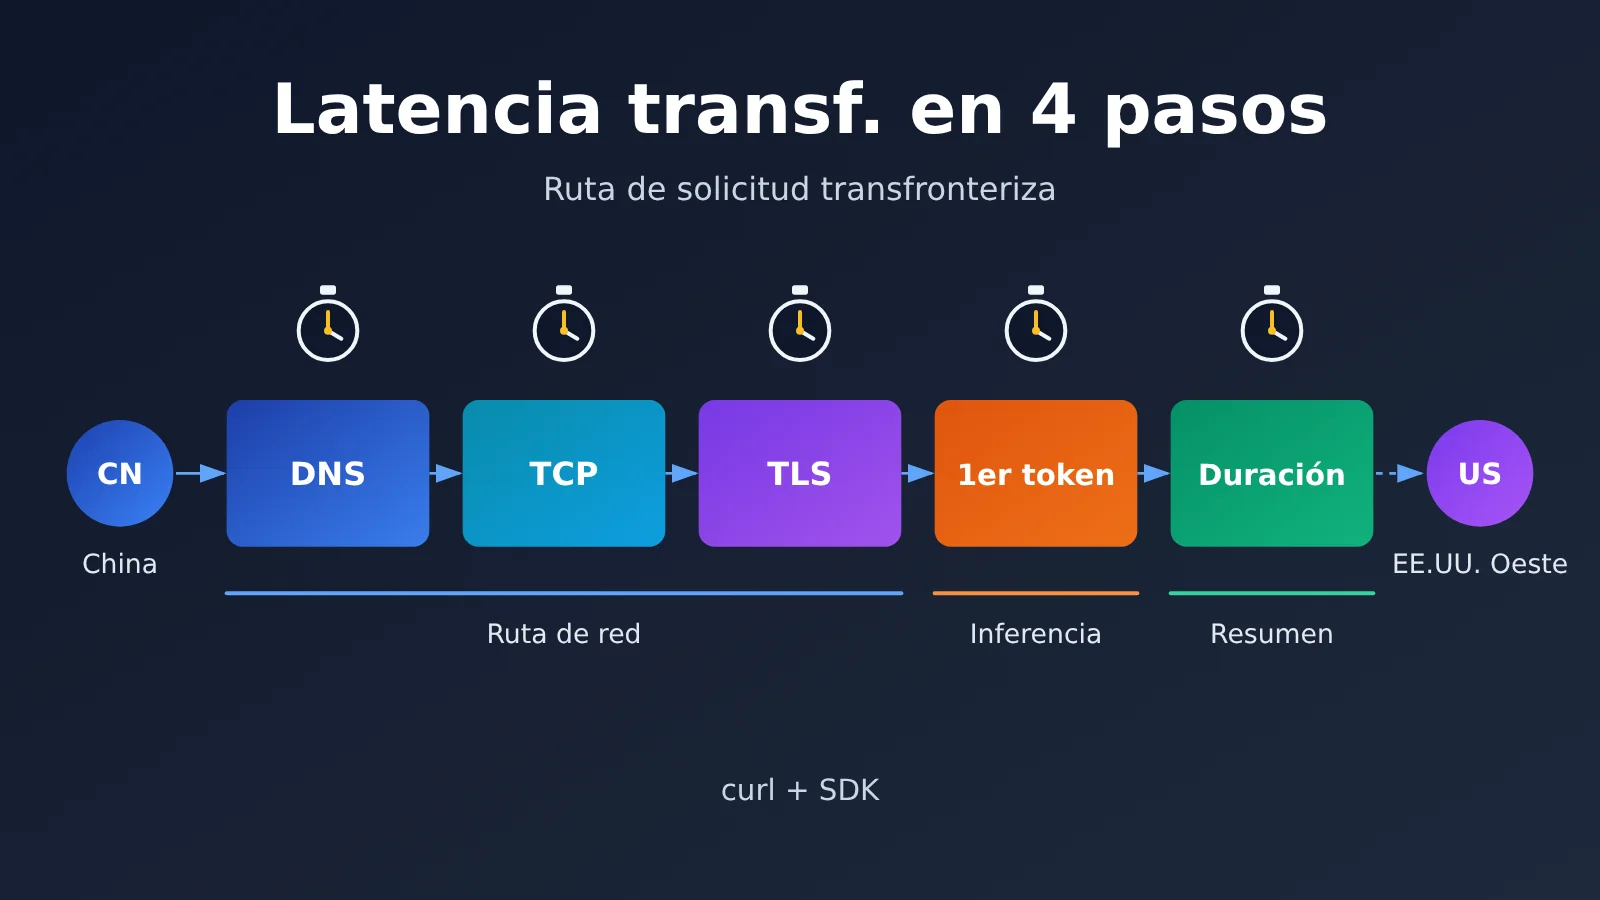
Antes de ponerse a medir, conviene tener clara una idea básica: el tiempo total de una invocación a la API de un Modelo de Lenguaje Grande es la suma del “tiempo de red” y el “tiempo del modelo”. La latencia transfronteriza solo afecta a lo primero, y gran parte de esa “lentitud” que perciben muchos usuarios viene, en realidad, de lo segundo.
| Paso | Qué medir | Herramienta | Pregunta que responde |
|---|---|---|---|
| Paso 1 | Tiempo de establecimiento de conexión DNS, TCP y TLS | parámetro -w de curl |
Si el enlace transfronterizo está en buen estado |
| Paso 2 | Latencia del primer token (TTFT) | Llamada en streaming con SDK | Cuánto hay que esperar hasta que el modelo empieza a responder |
| Paso 3 | Tiempo total y rendimiento | SDK sin streaming + estadísticas de varias rondas | Si la devolución de salidas largas y cuerpos de respuesta grandes es estable |
| Paso 4 | Diagnóstico comparativo | Matriz de diagnóstico | Si el cuello de botella está en la red, en el modelo o en el código |
De qué etapas se compone la latencia transfronteriza
Cuando una solicitud HTTPS sale de tu servidor, pasa primero por la resolución DNS, el handshake de tres vías de TCP y el handshake TLS, y solo después envía el cuerpo de la solicitud. En escenarios transfronterizos, los handshakes TCP y TLS requieren varias idas y vueltas, y la latencia de ida y vuelta provocada por la distancia física se multiplica varias veces; de ahí viene la “conexión lenta”. Por suerte, el establecimiento de conexión suele ocurrir solo en la primera solicitud; al reutilizar la conexión, ese costo baja bastante.
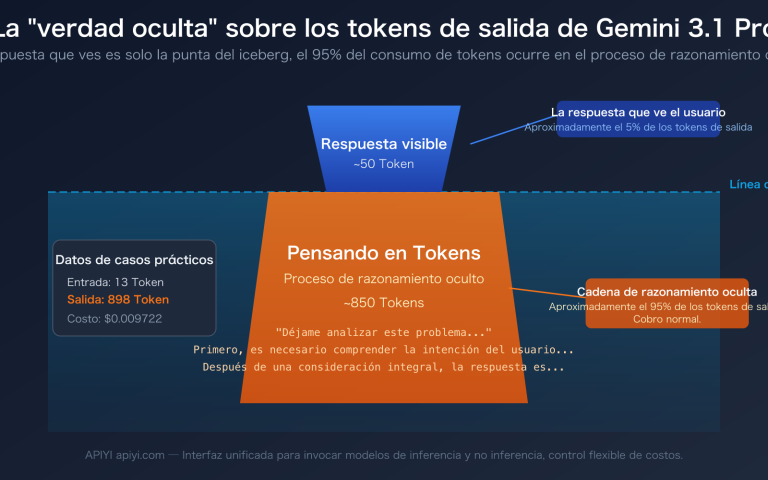
Una vez que la solicitud llega al servidor, empieza la fase de inferencia del modelo. En modelos de chat, la espera antes de que aparezca el primer token depende del tamaño del modelo, la longitud de la entrada y la carga actual; después del primer token, la velocidad de salida depende de la tasa de generación del modelo. La generación de imágenes y videos es distinta: suele devolver resultados voluminosos de forma síncrona, y el ancho de banda y la estabilidad del enlace de retorno influyen directamente en si el resultado llega completo.
Principios para determinar si la lentitud es de red o del modelo
El principio es bastante simple: si la fase de conexión es lenta, mira la red; si el primer token tarda, mira el modelo y la entrada; si la fase de salida es lenta e inestable, mira el enlace de retorno y el tamaño del cuerpo de respuesta. Con medir estos tres tramos, la mayoría de los problemas de “lentitud” se pueden diagnosticar en pocos minutos.
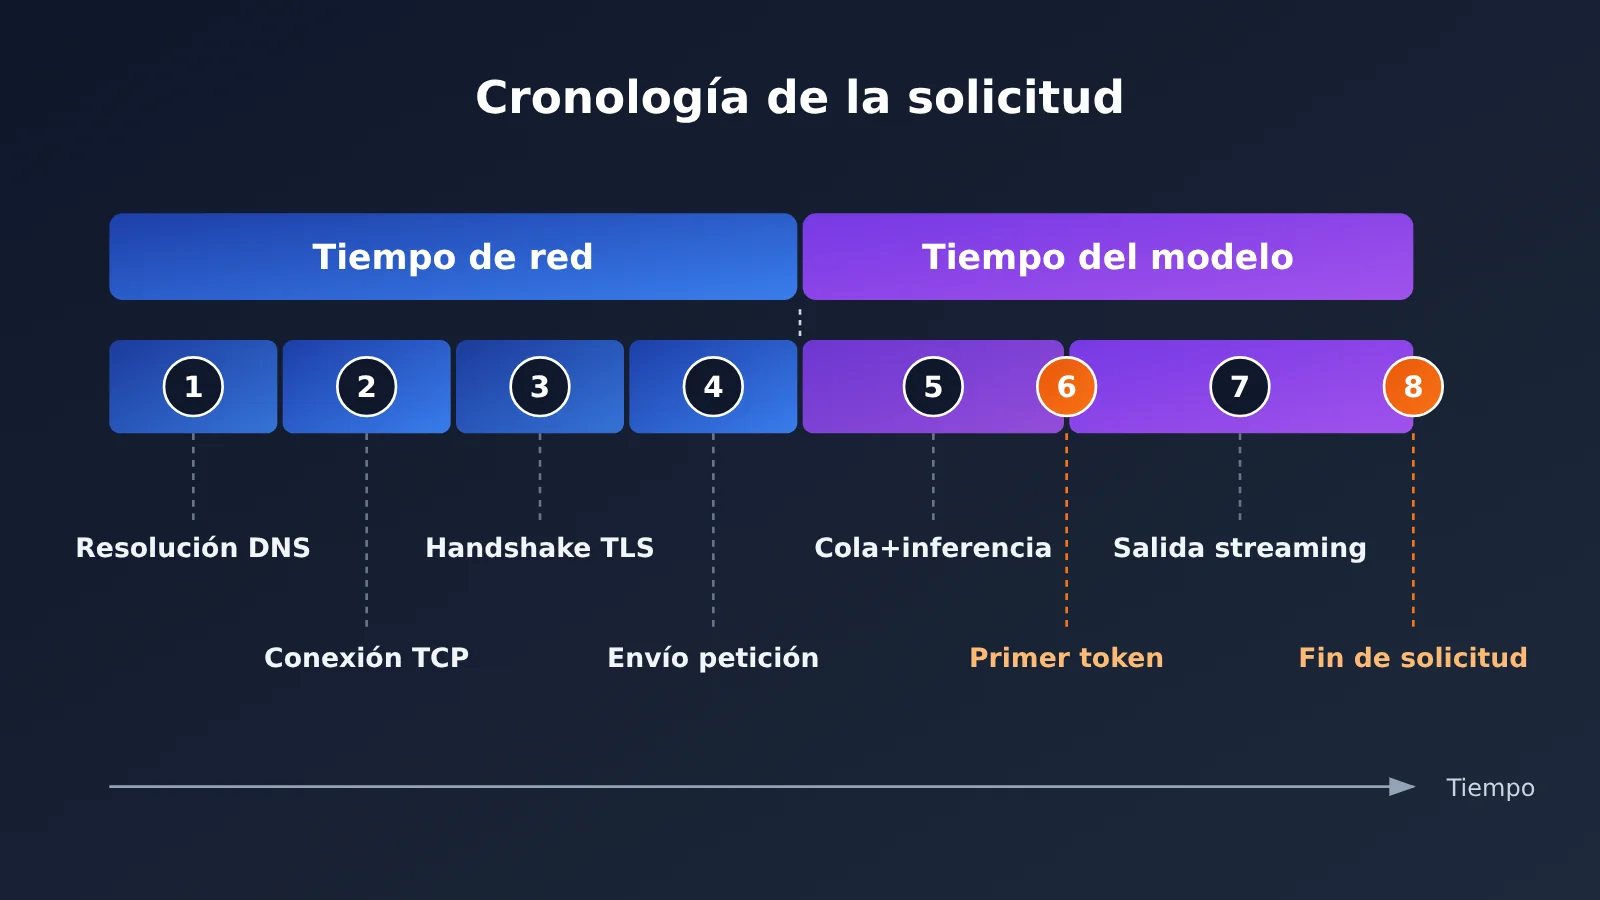
Diagnóstico rápido en 4 pasos: localizar la latencia transfronteriza
Los ejemplos siguientes usan la interfaz compatible con OpenAI. No importa si tu servicio está desplegado en China continental o en el extranjero: solo tienes que cambiar base_url para conectarte; el resto del código se mantiene igual.
Paso 1: usa curl para desglosar el tiempo de conexión de la ruta transfronteriza
El parámetro -w que incluye curl permite mostrar los tiempos de cada fase y es la herramienta más rápida para diagnosticar latencia transfronteriza. Te recomiendo solicitar un endpoint ligero como /v1/models para que el tiempo de inferencia del modelo no interfiera con la medición de red.
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS解析:   %{time_namelookup}s\nTCP连接:   %{time_connect}s\nTLS握手:   %{time_appconnect}s\n首字节:    %{time_starttransfer}s\n总耗时:    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
Ojo: cada valor que imprime curl es un instante acumulado desde el inicio de la solicitud, no el tiempo aislado de cada fase. Estos son el significado de cada campo y cómo se calcula su duración individual:
| Campo de curl | Significado | Cálculo de la duración del tramo | Causas habituales cuando sale alto |
|---|---|---|---|
time_namelookup |
Resolución DNS completada | Se lee directamente | DNS local lento, resolución hacia un nodo lejano |
time_connect |
Conexión TCP establecida | connect − namelookup | RTT transfronterizo alto, pérdida de paquetes |
time_appconnect |
Handshake TLS completado | appconnect − connect | Fluctuación del enlace, handshake con varias idas y vueltas |
time_starttransfer |
Primer byte recibido | starttransfer − appconnect | Procesamiento en el servidor, cola de espera |
time_total |
Fin de la solicitud | total − starttransfer | Cuerpo de respuesta grande, ancho de banda de retorno insuficiente |
Ejecuta la prueba entre 5 y 10 veces seguidas y fíjate en si los valores son estables. Si los tiempos de TCP y TLS fluctúan mucho, la calidad del enlace no es estable; si los valores son estables y están dentro de un rango aceptable, lo más probable es que la red no sea el principal cuello de botella.
Paso 2: Medir la latencia del primer token con una llamada en streaming usando el SDK
La conexión funciona sin problemas; el siguiente paso es comprobar la velocidad con la que el modelo empieza a responder. La latencia del primer token (Time To First Token, TTFT) es la métrica que más se nota en las aplicaciones de conversación: el usuario se queda mirando la pantalla esperando a que aparezca la primera palabra, y cada segundo se hace eterno.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Disponible para despliegues en China y en el extranjero
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"首 token 延迟: {time.perf_counter() - start:.2f}s")
        break
Una vez que tengas el TTFT, réstale el tiempo de conexión del paso 1: lo que queda es, básicamente, el tiempo de cola e inferencia del modelo. Si esa parte se lleva la mayor parte del total, optimizar la red tendrá un efecto limitado; probablemente convenga más cambiar a un modelo más rápido, acortar el contexto de entrada o activar la salida en streaming.
Paso 3: Estadísticas de varias rondas del tiempo total y del retorno de respuestas grandes
Una sola medición se ve fácilmente afectada por fluctuaciones puntuales. Cuando evalúas en producción conviene hacer estadísticas de varias rondas y fijarte en la mediana y en el valor máximo. El siguiente script completo mide automáticamente DNS, TCP, TLS, TTFT y el tiempo total, y muestra un resumen de los resultados.
Ver el script completo de medición de velocidad
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # Dirección de acceso unificada
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """Mide por separado los tiempos de DNS, TCP y TLS"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """Mide la latencia del primer token y el tiempo total"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "Escribe una presentación de producto de unos 200 caracteres"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} mediana {statistics.median(values):.3f}s  "
          f"máx {max(values):.3f}s  mín {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"Ronda {i + 1} completada, {llm['chars']} caracteres generados")

    print("\n===== Resumen de la medición =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
Con las interfaces de imágenes hay que prestar atención a un punto adicional: la generación de imágenes suele ser una llamada síncrona y el cuerpo de respuesta final es mucho más grande que en el caso del texto. Si el tiempo total es mucho mayor que el tiempo hasta el primer byte, o si aparecen cortes de conexión esporádicos, el problema normalmente está en el enlace de vuelta (el camino de retorno de la respuesta) y no en una generación lenta del modelo. En ese caso conviene aumentar el tiempo de espera del cliente y hacer reintentos idempotentes ante las interrupciones.
Paso 4: Identificar el cuello de botella con la matriz de diagnóstico
Con los datos de los tres pasos anteriores en la mano, basta con buscar tu caso en la siguiente matriz para localizar el problema.
| Síntoma | Cuello de botella más probable | Qué atacar primero |
|---|---|---|
| La fase DNS tarda claramente de más | Resolución DNS local | Cambiar a un servicio DNS estable y activar la caché de resolución |
| TCP y TLS altos y con mucha fluctuación | Calidad del enlace transfronterizo | Reutilizar conexiones y elegir un servicio de acceso con optimización de ruta |
| La conexión se establece bien, pero el TTFT es muy alto | Inferencia del modelo o entrada demasiado larga | Usar un modelo más rápido, recortar el contexto, activar streaming |
| TTFT normal, pero el tiempo total se dispara | Salida demasiado larga o tasa de generación baja | Limitar max_tokens y dividir la tarea |
| Cortes esporádicos en imágenes y vídeos | Devolución inestable de respuestas de gran tamaño | Subir el timeout, reintentos idempotentes, sondeo asíncrono |
| La primera llamada es lenta y las siguientes vuelan | Conexión en arranque en frío | Usar conexiones persistentes y reutilizar el client de forma global |
🚀 Inicio rápido: si quieres ejecutar ya el script de medición de velocidad que vimos arriba, te recomendamos registrarte primero en APIYI apiyi.com para obtener tu clave API. Los usuarios nuevos cuentan con crédito de prueba gratuito, más que suficiente para hacer varias rondas de comparación sin desplegar ningún proxy adicional.
Cómo elegir base_url según la región de despliegue
Muchos desarrolladores se preguntan: si el servicio está desplegado en el extranjero o en China, ¿hay que usar una dirección de acceso distinta? La respuesta es no. Los servidores de APIYI están en el oeste de EE. UU., así que las conexiones desde servicios en el extranjero tienen una ruta naturalmente más corta. Además, la plataforma ofrece aceleración de la línea de retorno para accesos desde China, priorizando la estabilidad en la transmisión de respuestas grandes, como imágenes y videos. Por eso, sin importar dónde esté desplegado el servicio, basta con usar el mismo base_url.
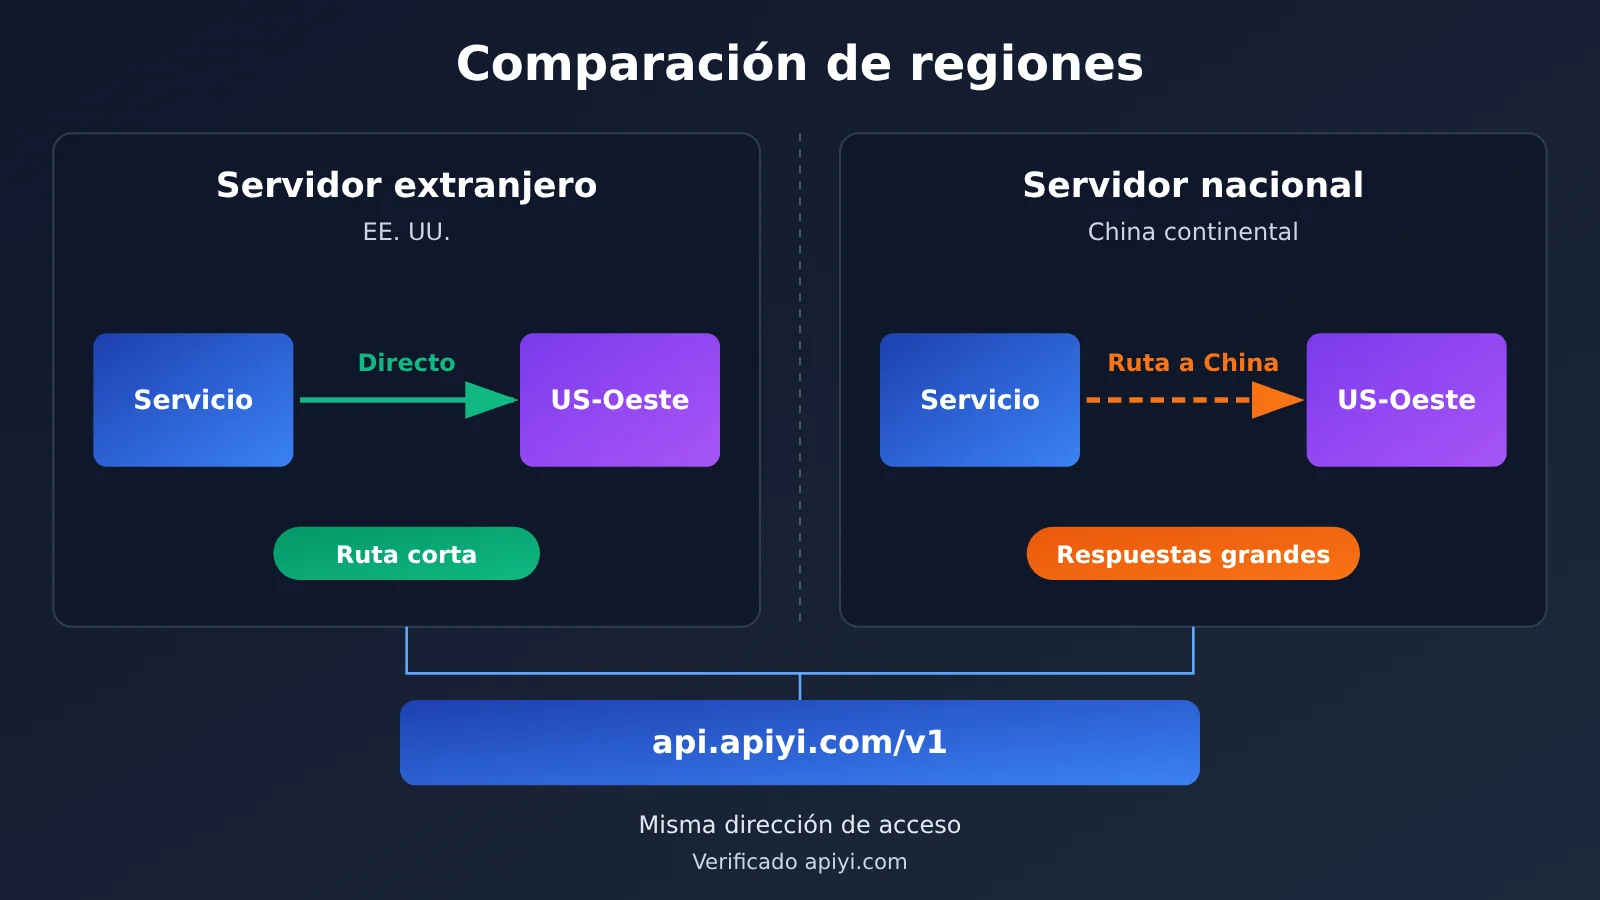
| Ubicación de despliegue | Características de la ruta | Aspectos clave al medir velocidad | Recomendación de conexión |
|---|---|---|---|
| EE. UU. / Oeste de EE. UU. | Misma región que el servidor, baja latencia de ida y vuelta | Revisar sobre todo TTFT y tiempo del modelo | Usar directamente la dirección de acceso unificada |
| Europa / Asia-Pacífico internacional | Cruce oceánico, pero las rutas internacionales suelen ser estables | Vigilar el handshake TLS y la reutilización de conexiones | Dirección de acceso unificada + conexiones persistentes |
| China continental | Ruta transfronteriza, con aceleración de línea de retorno a China | Vigilar variaciones al establecer conexión y la transmisión de respuestas grandes | Dirección de acceso unificada + timeouts razonables |
| Despliegue híbrido | Llamadas simultáneas desde varias regiones | Medir velocidad por región y comparar | El mismo código, sin configuración por ramas |
La ventaja de este diseño es que el mismo código puede migrar sin fricción entre el entorno de pruebas (China) y producción (extranjero), sin mantener varias configuraciones. Lo que sí conviene hacer es ejecutar los 4 pasos de medición de velocidad en cada entorno de despliegue y confirmar que el rendimiento real cumple con las expectativas del negocio.
Recomendaciones para optimizar llamadas transfronterizas con respuestas grandes
Las API de imágenes y videos son las más sensibles a las rutas transfronterizas. A nivel de código, conviene hacer lo siguiente:
- Reutilizar el client de forma global: evita restablecer la conexión en cada solicitud; en escenarios transfronterizos ahorra mucho tiempo de handshake.
- Configurar timeouts según el tipo de operación: en chat de texto pueden ser más cortos; para generación de imágenes y descarga de resultados de video conviene dejar margen suficiente.
- Aplicar reintentos idempotentes ante interrupciones: usa retroceso exponencial para no reenviar tareas de generación repetidamente en poco tiempo.
- Usar polling asíncrono para tareas de video: tras enviar la tarea, consulta el estado periódicamente y descarga cuando el resultado esté listo; así reduces el riesgo de cortes en conexiones persistentes.
- Registrar logs de tiempos por etapa: incluye TTFT y el tiempo total en el monitoreo para poder investigar rápido si surge un problema.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la latencia transfronteriza y en qué se diferencia de la latencia de inferencia del modelo?
La latencia transfronteriza es el tiempo de red que se consume al transmitir solicitudes entre servidores nacionales y en el extranjero, y se manifiesta principalmente en las fases de establecimiento de conexión TCP y TLS y en el retorno de datos. La latencia de inferencia del modelo, en cambio, es el tiempo que tarda el servidor en generar el contenido, y se refleja en la espera del primer token y en la velocidad de salida. Conviene medir ambas por separado para identificar bien la dirección de optimización.
Q2: Si mi servicio está desplegado en servidores de EE. UU., ¿qué dirección debo usar para llamar a APIYI?
Basta con usar directamente `https://api.apiyi.com/v1`. Los servidores de APIYI están en la costa oeste de EE. UU., así que el trayecto de acceso desde un servicio desplegado allí es muy corto y no requiere configuración adicional. Para los pasos concretos de integración puedes consultar la guía de inicio rápido del centro de documentación de APIYI apiyi.com; se completa en tres pasos.
Q3: El servidor está en la costa oeste de EE. UU., ¿por qué el acceso desde China también es bastante fluido?
Porque la plataforma ha habilitado una aceleración de las rutas de retorno hacia China, pensada sobre todo para garantizar la estabilidad en la devolución de respuestas grandes, como imágenes y vídeos. Puedes hacer la prueba real en un servidor en China con el comando curl del paso 1 de este artículo, y observar los tiempos y la fluctuación en las fases TCP y TLS.
Q4: La latencia del primer token es muy alta, ¿es un problema de red?
No necesariamente. Primero revisa el tiempo de establecimiento de conexión medido con curl; si la conexión es normal, un TTFT alto suele deberse a que el modelo es grande, el contexto de entrada es demasiado largo o la inferencia es más compleja. En ese caso puedes probar con un modelo más ligero, simplificar la indicación o activar la salida en streaming para mejorar la experiencia del usuario.
Q5: ¿Cómo comparar rápidamente la velocidad de respuesta de distintos modelos?
Te recomendamos usar una interfaz agregada que admita varios modelos:
1. Regístrate en APIYI apiyi.com y obtén una clave API
2. Usa el script completo de medición de velocidad de este artículo y modifica solo la variable `MODEL`
3. Ejecuta el mismo número de rondas para cada modelo y compara la mediana de TTFT y del tiempo total
Como con una sola clave puedes llamar a OpenAI, Claude, Gemini y muchos otros modelos, las condiciones de red se mantienen constantes durante la comparación y las conclusiones son más fiables.
Q6: La API de imágenes a veces se desconecta; ¿cómo lo investigo?
La interfaz de imágenes es una llamada síncrona y el cuerpo de la respuesta es grande, por lo que las interrupciones suelen ocurrir durante el retorno del resultado. Te sugerimos aumentar primero el tiempo de espera del cliente y luego observar la diferencia entre `time_total` y `time_starttransfer` en curl. Si la diferencia es grande e inestable, el enlace de retorno es el cuello de botella; en ese caso puedes añadir reintentos idempotentes y evitar enviar lotes en horas punta.
Q7: ¿Qué limitaciones tiene este método de medición de velocidad?
Los resultados solo reflejan el estado de la red en el momento y la ubicación de la medición; pueden variar notablemente según el operador y la franja horaria. Además, la carga del modelo cambia con el tiempo, y un único TTFT no representa el comportamiento a largo plazo. Se recomienda registrar de forma continua los tiempos por etapa en el entorno de producción y tomar decisiones con base en tendencias, no en datos puntuales.
Puntos clave para medir la velocidad al invocar APIs de Modelos de Lenguaje Grande desde China
- Primero descompón, luego optimiza: el tiempo total es la suma del tiempo de red y el tiempo del modelo; hay que medirlos por separado.
- Mide el establecimiento de conexión con curl: usa el parámetro
-wpara obtener los tiempos acumulados de DNS, TCP y TLS. - Mide el TTFT con el SDK: en una invocación en streaming, registra el tiempo hasta el primer token para evaluar la velocidad de respuesta del modelo.
- Con varias rondas, mira la mediana: un solo resultado se ve fácilmente afectado por la variabilidad; mide al menos 5 rondas.
- En respuestas grandes, observa el tiempo de descarga: para imágenes y video, presta atención a la diferencia entre el tiempo total y el tiempo hasta el primer byte.
- Dirección de acceso unificada: accede mediante APIYI apiyi.com; en China y en el extranjero se usa el mismo base_url.
Resumen
Puntos clave para diagnosticar la lentitud al invocar APIs de Modelos de Lenguaje Grande desde China:
- Método de diagnóstico en 4 pasos: medir la velocidad de establecimiento de conexión, medir el tiempo hasta el primer token, registrar el tiempo total y comparar con una matriz de diagnóstico, reduciendo el alcance paso a paso.
- Distinguir dos tipos de latencia: la latencia transfronteriza se resuelve con reutilización de conexiones y optimización de rutas; la latencia del modelo se resuelve con una buena elección del modelo y entradas más concisas.
- Prestar atención especial a las respuestas grandes: en los servicios de imágenes y video hay que configurar tiempos de espera razonables, reintentos idempotentes y sondeo asíncrono.
- No es necesario diferenciar base_url por región: desde el extranjero se conecta directamente al centro de datos de la costa oeste de EE. UU. y desde China se cuenta con una línea de retorno acelerada; basta con una sola configuración.
En lugar de juzgar la lentitud por intuición, vale la pena dedicar unos minutos a ejecutar el script de medición y dejar que los datos indiquen dónde está el cuello de botella. Se recomienda obtener una cuota de prueba gratuita a través de APIYI apiyi.com, hacer la prueba en tu propio entorno de despliegue y luego decidir la selección del modelo y la estrategia de tiempos de espera.
📚 Referencias
- Centro de documentación de APIYI: dirección de acceso y descripción del proceso de integración en tres pasos
- Enlace:
docs.apiyi.com -
Descripción: incluye la configuración del modo compatible con OpenAI, las indicaciones para llamar a la API de imágenes y la resolución de problemas de interrupción de conexión.
-
Manual oficial de curl: explicación completa de las variables de salida de
-w - Enlace:
curl.se/docs/manpage.html -
Descripción: consulta las definiciones oficiales de campos de temporización como
time_namelookupytime_appconnect. -
OpenAI Python SDK: repositorio oficial de código abierto
- Enlace:
github.com/openai/openai-python - Descripción: uso de llamadas en streaming, tiempos de espera y parámetros de reintento.
Autor: Equipo técnico de APIYI
Intercambio técnico: si tienes problemas durante las pruebas de velocidad, puedes contactarnos desde la página principal de APIYI. Para más material de integración, visita el centro de documentación en docs.apiyi.com.