Anmerkung des Autors: Mit curl und SDK die Zeitmessung in DNS, TLS, erstes Token und Gesamtdauer aufschlüsseln – in 4 Schritten feststellen, ob der Engpass bei API-Aufrufen großer Sprachmodelle aus dem Inland in der „grenzüberschreitenden Verbindung“ oder in der „Modellinferenz“ liegt.
„Warum ist die API bloß so langsam?“ – Das ist der Satz, den Entwickler in China am häufigsten sagen, wenn sie eine Großes-Sprachmodell-API anbinden. Das Problem: „Langsam“ ist nur ein Oberflächenphänomen. Es kann an der DNS-Auflösung liegen, am grenzüberschreitenden TLS-Handshake, an der Warteschlange des Modells – oder einfach daran, dass das Modell selbst gerade gründlich nachdenkt. Dieser Artikel stellt eine 4-Schritte-Methode zur Geschwindigkeitsmessung und -lokalisierung vor, mit der du die Laufzeit einer Anfrage in ihre Bestandteile zerlegst und die Ursache für langsame API-Aufrufe großer Sprachmodelle aus dem Inland präzise bestimmst.
Das hier ist keine esoterische Anleitung nach dem Motto „probier doch mal einen anderen Knoten“, sondern ein reproduzierbarer Diagnoseablauf, der aus echten Integrationsberatungen entstanden ist. Uns wird oft gefragt: Wenn der Dienst auf einem US-Server läuft, welche Zugangsadresse soll man eintragen? Wird der Zugriff aus dem Inland durch die Grenzüberschreitung ausgebremst? Kommen große Ergebnisse wie Bilder und Videos vollständig zurück? Die folgenden Abschnitte beantworten diese Fragen eine nach der anderen.
Der Kernnutzen: Nach dem Lesen dieses Artikels kannst du mit curl und dem Python-SDK abschnittsweise Zeitmessungen durchführen, die Laufzeit von Netzwerkverbindung und Modellinferenz unterscheiden und je nach Deployment-Region die richtige base_url wählen.
Die Kernpunkte: Warum API-Aufrufe großer Sprachmodelle im Inland langsam sind
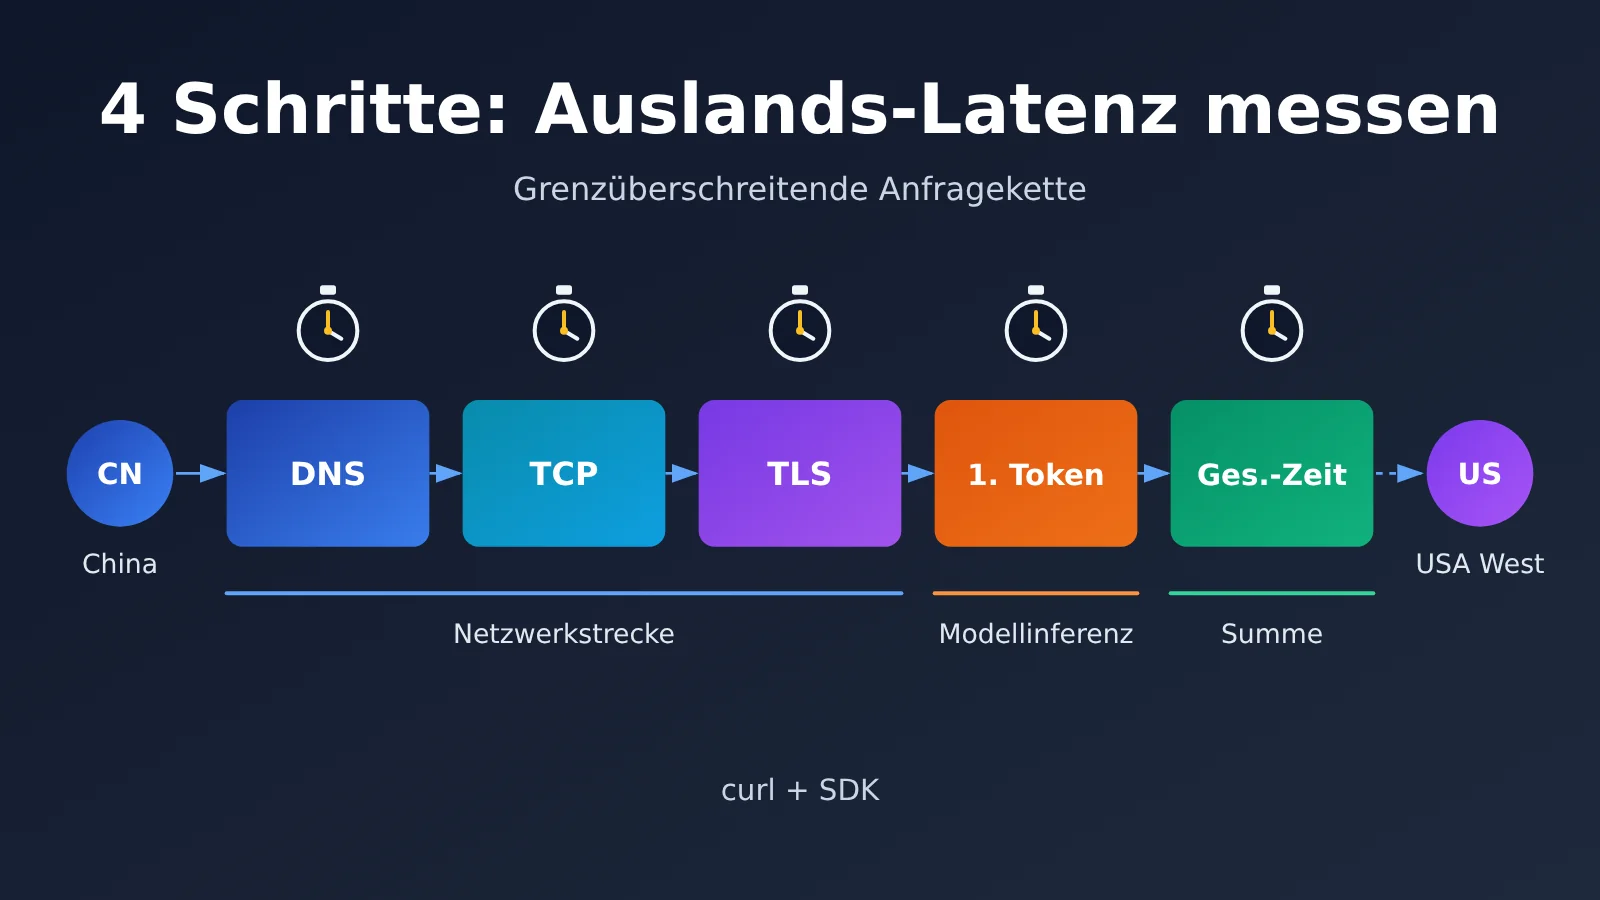
Bevor Sie mit dem Messen loslegen, sollten Sie eine Grundannahme verinnerlichen: Die Gesamtdauer eines API-Aufrufs eines großen Sprachmodells ergibt sich aus der Summe von Netzwerkzeit und Modellzeit. Die grenzüberschreitende Latenz betrifft nur den ersten Teil – und das „langsame“ Gefühl, das viele haben, stammt in Wahrheit überwiegend aus dem zweiten.
| Schritt | Was wird gemessen | Werkzeug | Beantwortet die Frage |
|---|---|---|---|
| Schritt 1 | Verbindungsaufbau: DNS, TCP, TLS | curl-Parameter -w |
Ist die grenzüberschreitende Verbindung selbst in Ordnung? |
| Schritt 2 | Latenz bis zum ersten Token (TTFT) | Streaming-Aufruf über das SDK | Wie lange dauert es, bis das Modell zu antworten beginnt? |
| Schritt 3 | Gesamtdauer und Durchsatz | SDK ohne Streaming + Statistik über mehrere Durchläufe | Bleiben lange Ausgaben und die Rückübertragung großer Antwortkörper stabil? |
| Schritt 4 | Vergleichsdiagnose | Diagnosematrix | Liegt der Engpass im Netz, im Modell oder im Code? |
Woraus sich die grenzüberschreitende Latenz zusammensetzt
Ein HTTPS-Request verlässt Ihren Server und durchläuft nacheinander DNS-Auflösung, TCP-Dreiwegehandshake und TLS-Handshake – erst danach wird der Request-Body gesendet. Im grenzüberschreitenden Szenario benötigen TCP- und TLS-Handshake mehrere Round Trips, und die durch die physische Distanz entstehende Round-Trip-Latenz vervielfacht sich dabei. Genau daraus entsteht der „langsame Verbindungsaufbau“. Zum Glück fällt dieser Aufwand meist nur beim ersten Request an – wird die Verbindung wiederverwendet, sinken diese Kosten deutlich.
Nachdem der Request den Server erreicht hat, beginnt die Inferenz. Bei Dialogmodellen hängt die Wartezeit bis zum ersten Token von der Modellgröße, der Eingabelänge und der aktuellen Last ab; danach bestimmt die Generierungsrate des Modells die Ausgabegeschwindigkeit. Bilder- und Videogenerierung funktioniert anders: Hier werden häufig große Ergebnisse synchron zurückgeliefert, sodass Bandbreite und Stabilität der Rückstrecke direkt darüber entscheiden, ob das Ergebnis vollständig ankommt.
Wie Sie entscheiden: Netzwerk langsam oder Modell langsam?
Die Faustregel ist eigentlich ganz einfach: Ist der Verbindungsaufbau langsam, schauen Sie aufs Netzwerk; ist das erste Token langsam, auf Modell und Eingabe; ist die Ausgabephase langsam und schwankend, auf die Rückstrecke und die Größe des Antwortkörpers. Wenn Sie diese drei Zahlen messen, lässt sich das meiste „langsame“ Verhalten in wenigen Minuten einordnen.
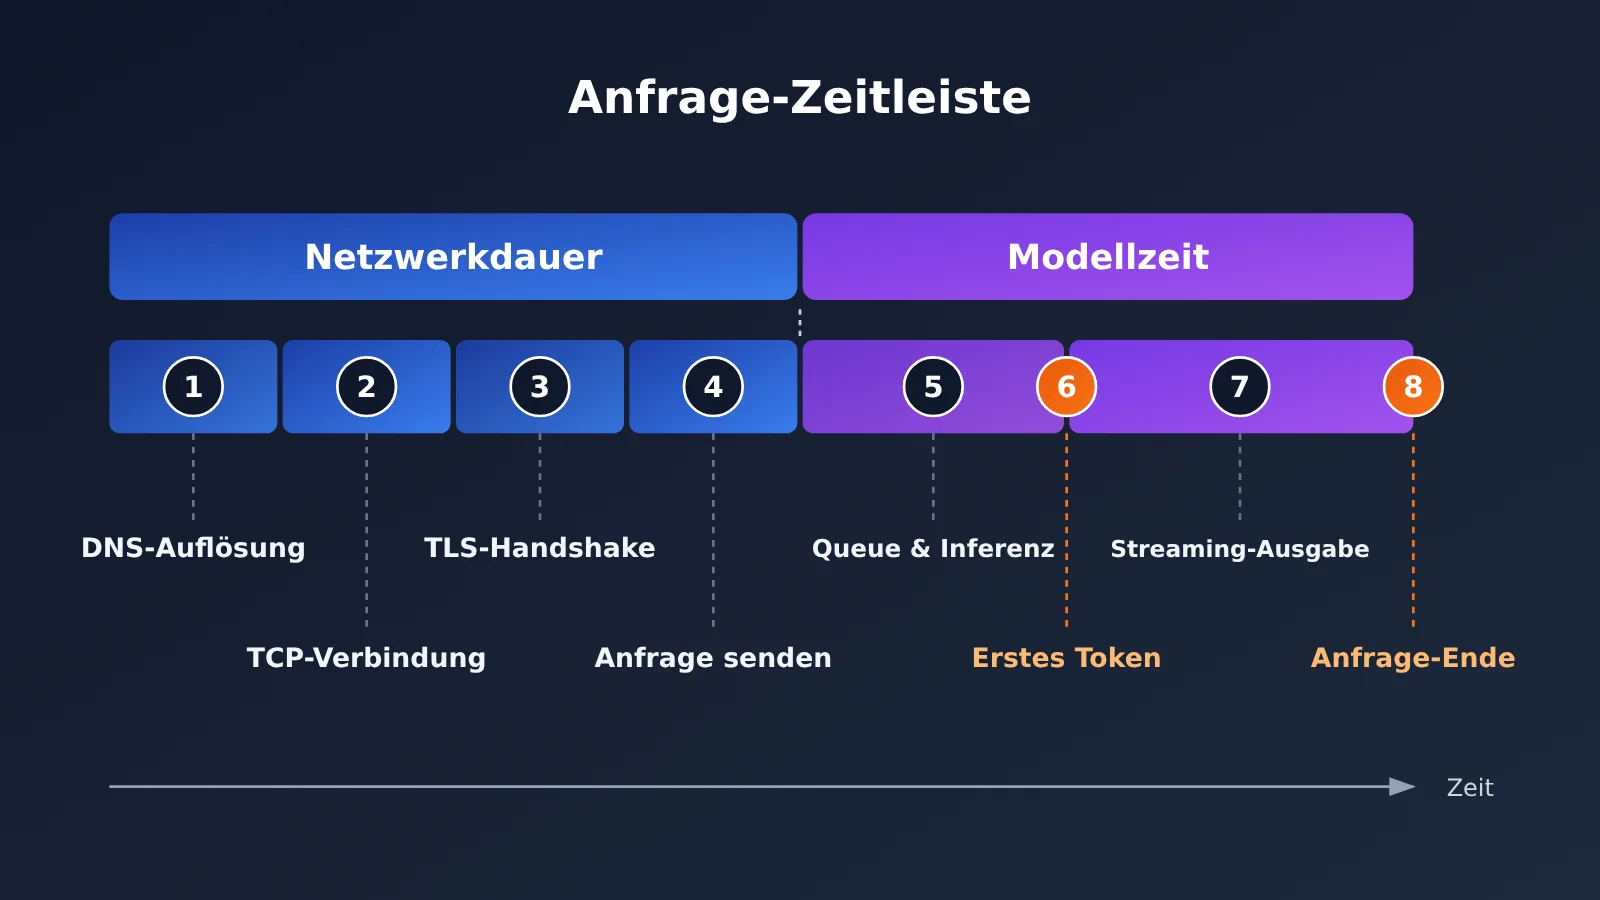
In 4 Schritten die grenzüberschreitende Latenz eingrenzen und schnell starten
Die folgenden Beispiele beziehen sich auf OpenAI-kompatible Schnittstellen. Egal, ob dein Dienst in China oder im Ausland läuft: Du musst nur base_url ändern, der restliche Code bleibt unverändert.
Schritt 1: Mit curl die Verbindungsaufbauzeiten der grenzüberschreitenden Strecke aufschlüsseln
Das -w-Flag von curl gibt die Zeitpunkte der einzelnen Phasen aus und ist damit das schnellste Werkzeug, um grenzüberschreitende Latenz zu untersuchen. Verwende am besten einen leichten Endpunkt wie /v1/models, damit die Modellinferenz die Netzwerkmessung nicht verfälscht.
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS解析:   %{time_namelookup}s\nTCP连接:   %{time_connect}s\nTLS握手:   %{time_appconnect}s\n首字节:    %{time_starttransfer}s\n总耗时:    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
Wichtig: Jeder Wert, den curl ausgibt, ist ein ab dem Start der Anfrage kumulierter Zeitpunkt – nicht die isolierte Dauer einer einzelnen Phase. Bedeutung und Berechnung der Felder:
| curl-Feld | Bedeutung | Berechnung der Einzelphase | Häufige Ursachen bei erhöhten Werten |
|---|---|---|---|
time_namelookup |
DNS-Auflösung abgeschlossen | direkt ablesen | Langsamer lokaler DNS-Server, Auflösung zu einem weit entfernten Knoten |
time_connect |
TCP-Verbindung aufgebaut | connect − namelookup | Hohe Latenz beim grenzüberschreitenden Roundtrip, Paketverlust |
time_appconnect |
TLS-Handshake abgeschlossen | appconnect − connect | Schwankende Verbindung, mehrere Handshake-Roundtrips |
time_starttransfer |
Erstes Byte empfangen | starttransfer − appconnect | Serverseitige Verarbeitung, Warteschlange |
time_total |
Anfrage abgeschlossen | total − starttransfer | Großer Antwortkörper, unzureichende Bandbreite für den Rückweg |
Führe den Befehl am besten 5 bis 10 Mal hintereinander aus und beobachte, ob die Werte stabil bleiben. Wenn die Dauer von TCP und TLS stark schwankt, ist die Verbindungsqualität instabil. Sind die Werte stabil und im akzeptablen Bereich, ist das Netzwerk wahrscheinlich nicht der Hauptengpass.
Schritt 2: Latenz bis zum ersten Token mit SDK-Streaming messen
Wenn der Verbindungsaufbau problemlos funktioniert, ist der nächste Blick darauf gerichtet, wie schnell das Modell mit der Antwort beginnt. Die Time To First Token (TTFT) ist die Kennzahl, die bei Chat-Anwendungen am stärksten spürbar ist: Nutzer starren auf den Bildschirm und warten auf das erste Zeichen – jede Sekunde fühlt sich lang an.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Für Deployments in China und im Ausland geeignet
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"首 token 延迟: {time.perf_counter() - start:.2f}s")
        break
Wenn Sie die TTFT ermittelt haben, ziehen Sie davon die Verbindungsaufbauzeit aus Schritt 1 ab. Der verbleibende Teil entspricht im Wesentlichen der Zeit für Warteschlange und Inferenz des Modells. Macht dieser Anteil den Löwenanteil aus, bringt eine Netzwerkoptimierung nur wenig. Dann sollten Sie eher ein schnelleres Modell wählen, den Eingabekontext verkürzen oder die Streaming-Ausgabe aktivieren.
Schritt 3: Gesamtlaufzeit über mehrere Runden erfassen und große Antwortkörper zurückübertragen
Eine einzelne Messung wird leicht durch gelegentliche Schwankungen verfälscht. Für eine Bewertung im Produktivbetrieb sollte man mehrere Runden messen und dabei Median und Maximalwert im Blick behalten. Das folgende vollständige Skript misst automatisch DNS, TCP, TLS, TTFT und die Gesamtlaufzeit und gibt eine Zusammenfassung aus.
Vollständiges Messskript anzeigen
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # Einheitliche Zugriffsadresse
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """DNS-, TCP- und TLS-Latenz segmentweise messen"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """Latenz des ersten Tokens und Gesamtlaufzeit messen"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "Schreibe eine Produktvorstellung mit etwa 200 Zeichen"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} Median {statistics.median(values):.3f}s  "
          f"Max {max(values):.3f}s  Min {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"Runde {i + 1} abgeschlossen, {llm['chars']} Zeichen ausgegeben")

    print("\n===== Zusammenfassung der Messung =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
Bei Bild-Endpunkten muss man zusätzlich auf eines achten: Die Bilderzeugung ist in der Regel ein synchroner Aufruf, und der zurückgelieferte Antwortkörper ist deutlich größer als bei Text. Wenn die Gesamtlaufzeit viel länger ist als die Zeit bis zum ersten Byte oder die Verbindung gelegentlich abbricht, liegt das Problem häufig auf der Rückstrecke und nicht an einer langsamen Modellgenerierung. In solchen Fällen sollte man das Client-Timeout angemessen erhöhen und Abbrüche idempotent wiederholen.
Schritt 4: Engpässe anhand der Diagnosematrix bestimmen
Sobald Sie die Daten aus den ersten drei Schritten haben, können Sie mit der folgenden Matrix die Ursache eingrenzen – in den meisten Fällen lässt sich das Problem damit zuordnen.
| Symptom | Wahrscheinlichster Engpass | Vorrangige Maßnahme |
|---|---|---|
| DNS-Phase deutlich erhöht | Lokale DNS-Auflösung | Stabilen DNS-Dienst verwenden, Auflösungs-Cache aktivieren |
| TCP und TLS erhöht und stark schwankend | Qualität der grenzüberschreitenden Verbindung | Verbindungen wiederverwenden, Zugangsdienst mit optimierter Route wählen |
| Verbindungsaufbau normal, TTFT sehr hoch | Modellinferenz oder zu lange Eingabe | Schnelleres Modell wählen, Kontext kürzen, Streaming aktivieren |
| TTFT normal, Gesamtdauer lang | Ausgabe zu lang oder niedrige Generierungsrate | max_tokens begrenzen, Aufgabe aufteilen |
| Bilder/Videos brechen gelegentlich ab | Instabile Rückübertragung großer Antwortkörper | Timeouts erhöhen, idempotente Wiederholungen, asynchrones Polling |
| Erster Aufruf langsam, danach schnell | Cold-Start beim Verbindungsaufbau | Persistente Verbindungen nutzen, client global wiederverwenden |
🚀 Schnellstart: Wenn Sie das oben beschriebene Geschwindigkeitstest-Skript direkt ausprobieren möchten, empfehlen wir, sich zuerst bei APIYI (apiyi.com) zu registrieren und einen API-Schlüssel zu holen. Neue Nutzer erhalten ein kostenloses Testkontingent, das für mehrere Vergleichsrunden beim Geschwindigkeitstest ausreicht – ganz ohne zusätzliche Proxy-Bereitstellung.
Wie Sie base_url je nach Deployment-Region wählen
Viele Entwickler sind unsicher: Muss für einen Service, der außerhalb Chinas läuft, eine andere Endpunktadresse eingetragen werden als für einen Service in China? Die Antwort ist nein. Die Server von APIYI stehen in US-West. Services außerhalb Chinas profitieren daher naturgemäß von einem kurzen Weg. Gleichzeitig hat die Plattform für Zugriffe aus China eine beschleunigte Rückroute eingerichtet, um gezielt die stabile Rückübertragung großer Antworten bei Bild- und Videoanwendungen abzusichern. Deshalb verwenden Sie unabhängig vom Deployment-Standort immer dieselbe base_url.
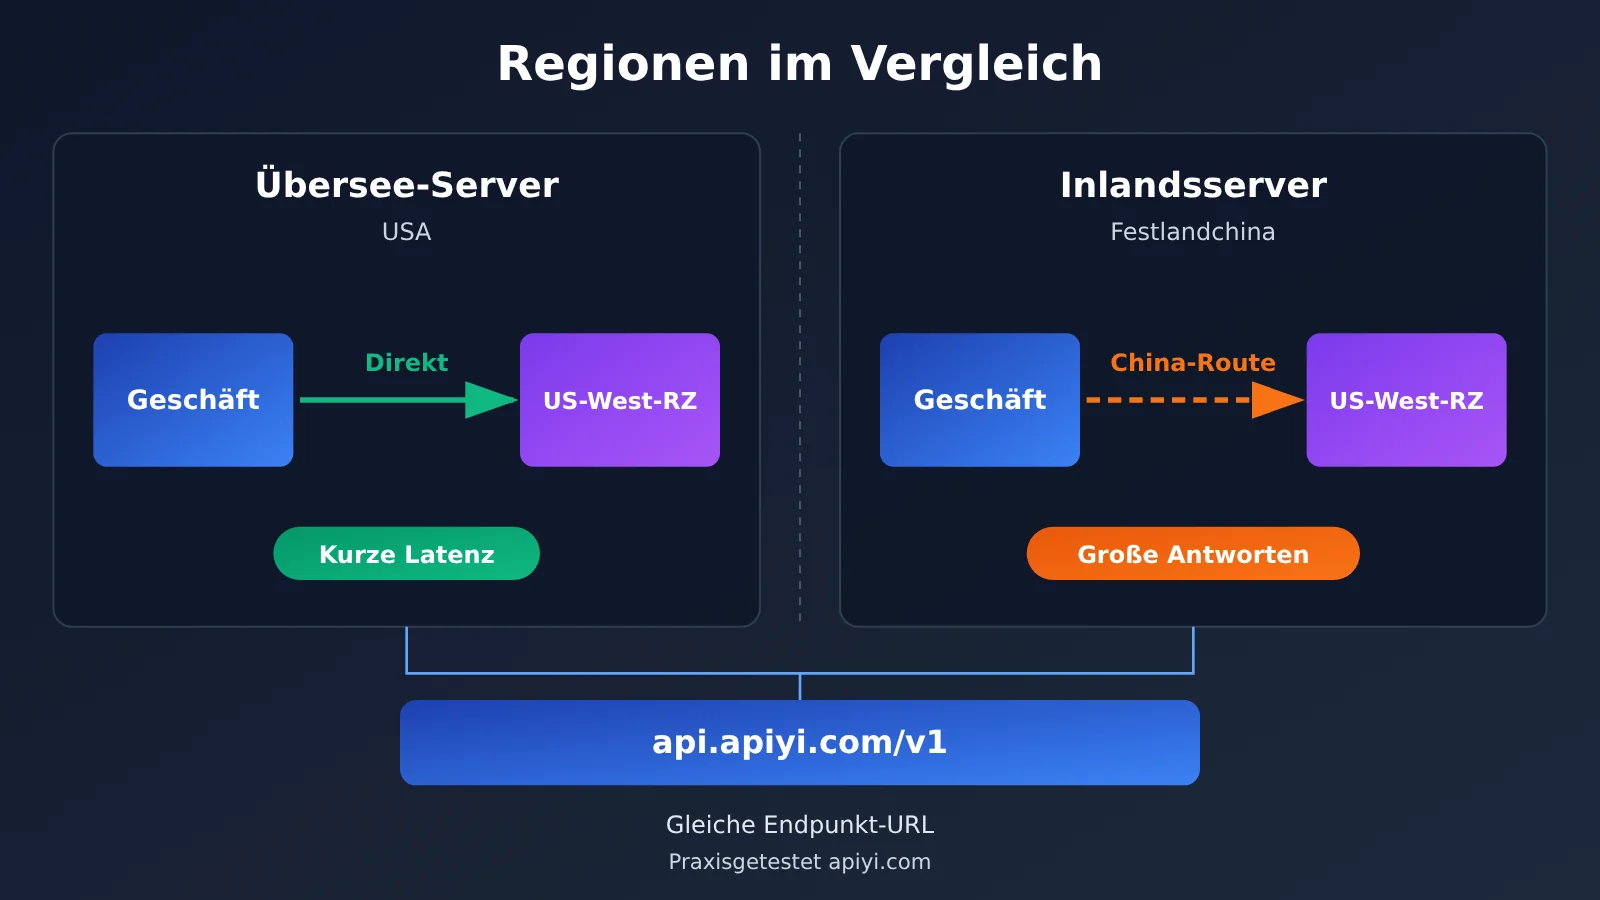
| Deployment-Standort | Verbindungseigenschaften | Worauf beim Latenztest achten | Zugriffsempfehlung |
|---|---|---|---|
| USA / US-West | Gleiche Region wie der Server, niedrige Roundtrip-Latenz | Fokus auf TTFT und Modelllaufzeit | Einheitliche Endpunktadresse direkt verwenden |
| Europa / Asien-Pazifik außerhalb Chinas | Interkontinental, aber internationale Verbindungen sind meist stabil | Auf TLS-Handshake und Connection-Reuse achten | Einheitliche Adresse + persistente Verbindungen |
| China (Festland) | Grenzüberschreitende Verbindung, Rückroute nach China bereits beschleunigt | Auf Schwankungen beim Verbindungsaufbau und die Rückübertragung großer Antworten achten | Einheitliche Adresse + sinnvolle Timeouts |
| Hybrid-Deployment | Aufrufe aus mehreren Regionen gleichzeitig | Messungen getrennt nach Region vergleichen | Derselbe Code, keine verzweigte Konfiguration |
Der Vorteil: Derselbe Code lässt sich nahtlos zwischen Testumgebung in China und Produktionsumgebung außerhalb Chinas verschieben, ohne mehrere Konfigurationen pflegen zu müssen. Was Sie tatsächlich tun sollten: Führen Sie die zuvor beschriebenen vier Messschritte in jeder Deployment-Umgebung aus und prüfen Sie, ob die tatsächliche Performance den Erwartungen des Business entspricht.
Optimierungstipps für grenzüberschreitende Aufrufe mit großen Antworten
Bilder- und Video-APIs reagieren am empfindlichsten auf grenzüberschreitende Verbindungen. Im Code sollten Sie daher Folgendes beachten:
- Client global wiederverwenden: Vermeiden Sie neue Verbindungen pro Request. In grenzüberschreitenden Szenarien sparen Sie dadurch viel Handshake-Zeit.
- Timeouts je nach Workload-Typ festlegen: Bei Textdialogen können sie kürzer ausfallen; für Bilderzeugung und das Abrufen von Videoergebnissen sollten Sie großzügig bemessen.
- Idempotente Wiederholungsversuche bei Abbrüchen: Verwenden Sie exponentielles Backoff, um doppelte Generierungsaufträge in kurzer Zeit zu vermeiden.
- Videoaufgaben asynchron per Polling abholen: Aufgabe absenden, Status regelmäßig abfragen und das Ergebnis erst herunterladen, wenn es bereitsteht – das senkt das Risiko, dass langlebige Verbindungen abbrechen.
- Logs mit segmentierten Laufzeiten erfassen: TTFT und Gesamtlaufzeit ins Monitoring schreiben, damit Sie bei Problemen schnell zurückverfolgen können, wo es hakt.
Häufig gestellte Fragen (FAQ)
F1: Was ist Latenz über Ländergrenzen hinweg und wie unterscheidet sie sich von der Latenz der Modellinferenz?
Die Latenz über Ländergrenzen hinweg ist die Netzwerkzeit, die durch die Übertragung von Anfragen zwischen inländischen und ausländischen Servern entsteht. Sie zeigt sich vor allem beim Aufbau von TCP- und TLS-Verbindungen sowie bei der Datenrückübertragung. Die Latenz der Modellinferenz ist dagegen die Zeit, die der Server für die Generierung des Inhalts benötigt. Sie zeigt sich in der Wartezeit auf das erste Token und in der Ausgabegeschwindigkeit. Beide müssen getrennt gemessen werden, um die richtige Optimierungsrichtung zu finden.
F2: Wenn mein Dienst auf einem US-Server läuft, welche Adresse muss ich für den Aufruf von APIYI angeben?
Verwenden Sie einfach `https://api.apiyi.com/v1`. Die Server von APIYI stehen im Westen der USA. Dienste, die in den USA gehostet werden, haben daher eine sehr kurze Zugriffsstrecke und benötigen keine zusätzliche Konfiguration. Die konkreten Integrationsschritte finden Sie in der Schnellstartanleitung im Dokumentationszentrum von APIYI unter apiyi.com – in drei Schritten ist alles erledigt.
F3: Der Server steht im Westen der USA – warum ist der Zugriff aus China trotzdem recht flüssig?
Weil die Plattform für Zugriffe aus China eine beschleunigte Rückleitung eingerichtet hat. Sie dient vor allem dazu, die Stabilität der Rückübertragung bei Diensten mit großen Antwortgrößen wie Bildern und Videos zu sichern. Sie können den curl-Befehl aus Schritt 1 dieses Artikels auf einem chinesischen Server ausführen und so die Dauer und Schwankungen in der TCP- und TLS-Phase selbst messen.
F4: Die Latenz bis zum ersten Token ist sehr hoch – liegt das am Netzwerk?
Nicht unbedingt. Prüfen Sie zuerst die mit curl gemessene Verbindungsaufbauzeit. Ist der Verbindungsaufbau normal, liegt eine hohe TTFT meist daran, dass das Modell selbst groß ist, der Eingabekontext zu lang ist oder die Inferenz komplexer ausfällt. In diesem Fall können Sie ein leichteres Modell verwenden, die Eingabeaufforderung straffen oder die Streaming-Ausgabe aktivieren, um das Nutzererlebnis zu verbessern.
F5: Wie kann ich die Antwortgeschwindigkeit verschiedener Modelle schnell vergleichen?
Empfehlenswert ist ein Test über eine aggregierte Schnittstelle, die mehrere Modelle unterstützt:
1. Registrieren Sie ein Konto bei APIYI unter apiyi.com und holen Sie sich einen API-Schlüssel
2. Verwenden Sie das vollständige Geschwindigkeitstest-Skript aus diesem Artikel und ändern Sie nur die Variable `MODEL`
3. Führen Sie für jedes Modell die gleiche Anzahl an Durchläufen aus und vergleichen Sie den Median von TTFT und Gesamtdauer
Da Sie mit einem einzigen Schlüssel OpenAI, Claude, Gemini und viele weitere Modelle aufrufen können, bleiben die Netzwerkbedingungen beim Vergleich identisch – das macht die Ergebnisse aussagekräftiger.
F6: Wie gehe ich vor, wenn die Verbindung zur Bild-API gelegentlich abbricht?
Die Bild-Schnittstelle wird synchron aufgerufen und liefert große Antwortgrößen. Abbrüche treten daher meist in der Phase der Ergebnisrückübertragung auf. Erhöhen Sie zunächst das Timeout des Clients und beobachten Sie dann die Differenz zwischen `time_total` und `time_starttransfer` bei curl. Ist die Differenz groß und instabil, ist die Rückstrecke der Engpass. Dann helfen idempotente Wiederholungsversuche und das Vermeiden von Massenanfragen zu Spitzenzeiten.
F7: Welche Grenzen hat diese Geschwindigkeitsmessmethode?
Die Messergebnisse spiegeln nur den Netzwerkzustand zum Zeitpunkt und am Ort der Messung wider. Je nach Anbieter und Tageszeit können die Unterschiede deutlich ausfallen. Außerdem ändert sich die Auslastung der Modelle im Laufe der Zeit, sodass ein einzelner TTFT-Wert nicht die langfristige Leistung abbildet. Empfehlenswert ist es, in der Produktionsumgebung die Teilzeiten dauerhaft zu protokollieren und Entscheidungen eher auf Basis von Trends als auf Basis einzelner Messpunkte zu treffen.
Kernpunkte zur Geschwindigkeitsmessung von Large-Language-Model-APIs in China
- Erst aufteilen, dann optimieren: Die Gesamtzeit setzt sich aus Netzwerkzeit plus Modellzeit zusammen und muss segmentweise gemessen werden.
- Verbindungsaufbau mit curl messen: Mit dem
-w-Parameter erhält man die kumulierten Zeitpunkte für DNS, TCP und TLS. - TTFT mit dem SDK messen: Beim Streaming-Aufruf die Zeit bis zum ersten Token erfassen, um die Antwortgeschwindigkeit des Modells zu beurteilen.
- Bei mehreren Durchläufen den Median betrachten: Einzelne Ergebnisse schwanken leicht, daher mindestens 5 Durchläufe statistisch auswerten.
- Bei großen Antwortkörpern den Rückweg beachten: Bei Bild- und Videoanwendungen auf die Differenz zwischen Gesamtzeit und Time-to-First-Byte achten.
- Einheitliche Zugriffsadresse: Über APIYI apiyi.com anbinden – im Inland und Ausland dieselbe base_url verwenden.
Zusammenfassung
Die Kernpunkte bei der Fehlersuche, wenn Large-Language-Model-APIs in China langsam sind:
- 4-Schritt-Lokalisierungsmethode: Verbindungsaufbau messen, Zeit bis zum ersten Token messen, Gesamtzeit statistisch erfassen, Diagnosematrix abgleichen – den Bereich schrittweise eingrenzen.
- Zwei Arten von Latenz unterscheiden: Grenzüberschreitende Latenz lässt sich durch Verbindungswiederverwendung und Leitungsoptimierung beheben, Modelllatenz durch Modellauswahl und schlankere Eingaben.
- Große Antwortkörper gesondert betrachten: Bei Bild- und Videogeschäft angemessene Timeouts, idempotente Wiederholungsversuche und asynchrones Polling konfigurieren.
- base_url muss nicht nach Region unterschieden werden: Überseeische Direktverbindung zum Rechenzentrum in der US-Westküste, im Inland beschleunigte Rückleitungen nach China – eine Konfiguration genügt.
Statt aus dem Bauch heraus zu urteilen, dass es „langsam“ ist, sollten Sie lieber ein paar Minuten in ein Geschwindigkeitsmessskript investieren und die Daten den Engpass zeigen lassen. Empfehlenswert ist, über APIYI apiyi.com ein kostenloses Testkontingent zu beziehen, die Messung in der eigenen Deployment-Umgebung durchzuführen und erst dann Modellauswahl und Timeout-Strategie festzulegen.
📚 Referenzen
- APIYI Dokumentationszentrum: Integrationsadresse und Beschreibung des dreistufigen Integrationsprozesses
- Link:
docs.apiyi.com -
Beschreibung: Enthält die Konfiguration des OpenAI-kompatiblen Modus, Hinweise zu Bild-API-Aufrufen sowie die Fehlerbehebung bei Verbindungsabbrüchen
-
Offizielles curl-Handbuch: Vollständige Erklärung der
-w-Ausgabevariablen - Link:
curl.se/docs/manpage.html -
Beschreibung: Autoritative Definitionen der Timing-Felder wie
time_namelookup,time_appconnectund weiterer Felder -
OpenAI Python SDK: Offizielles Open-Source-Repository
- Link:
github.com/openai/openai-python - Beschreibung: Verwendung von Streaming-Aufrufen, Timeout- und Wiederholungsparametern
Autor: APIYI Technikteam
Technischer Austausch: Bei Problemen während der Geschwindigkeitsmessung kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com