著者メモ:curlとSDKで計測し、DNS、TLS、初回トークン、全体の所要時間を分解します。4つのステップで、中国国内から大規模言語モデルAPIを呼び出す際のボトルネックが「越境ネットワーク経路」にあるのか「モデル推論」にあるのかを判断できます。
「なんでAPIがこんなに遅いの?」——これは中国国内の開発者が大規模言語モデルAPIを導入する際に、最もよく口にする言葉です。問題は、「遅い」というのはあくまで表面現象にすぎないということです。原因はDNS解決にあるかもしれませんし、越境のTLSハンドシェイク、モデルの順番待ち、あるいは単にモデル自身がじっくり考えているだけかもしれません。本記事では、4ステップの速度測定・特定法を紹介します。1回のリクエストの所要時間を分解して見ることで、中国国内から大規模言語モデルAPIを呼び出す際の遅さの根本原因を正確に特定できるようになります。
これは「ノードを変えて試してみて」という精神論的なガイドではありません。実際の導入相談に基づいてまとめた、再現可能なトラブルシューティング手順です。よく寄せられる質問として、次のようなものがあります。業務が米国のサーバーにデプロイされている場合、接続先アドレスはどう設定すればよいのか?中国国内からのアクセスは越境のせいで遅延するのか?画像や動画のような大きな結果も完全に返送できるのか?以下で順に答えていきます。
核心的な価値:本記事を読み終えると、curlとPython SDKで区間ごとに計測し、ネットワーク経路とモデル推論の所要時間を区別できるようになります。また、デプロイ地域に応じて適切なbase_urlを選べるようになります。
国内で大規模言語モデルAPIの呼び出しが遅い核心的なポイント
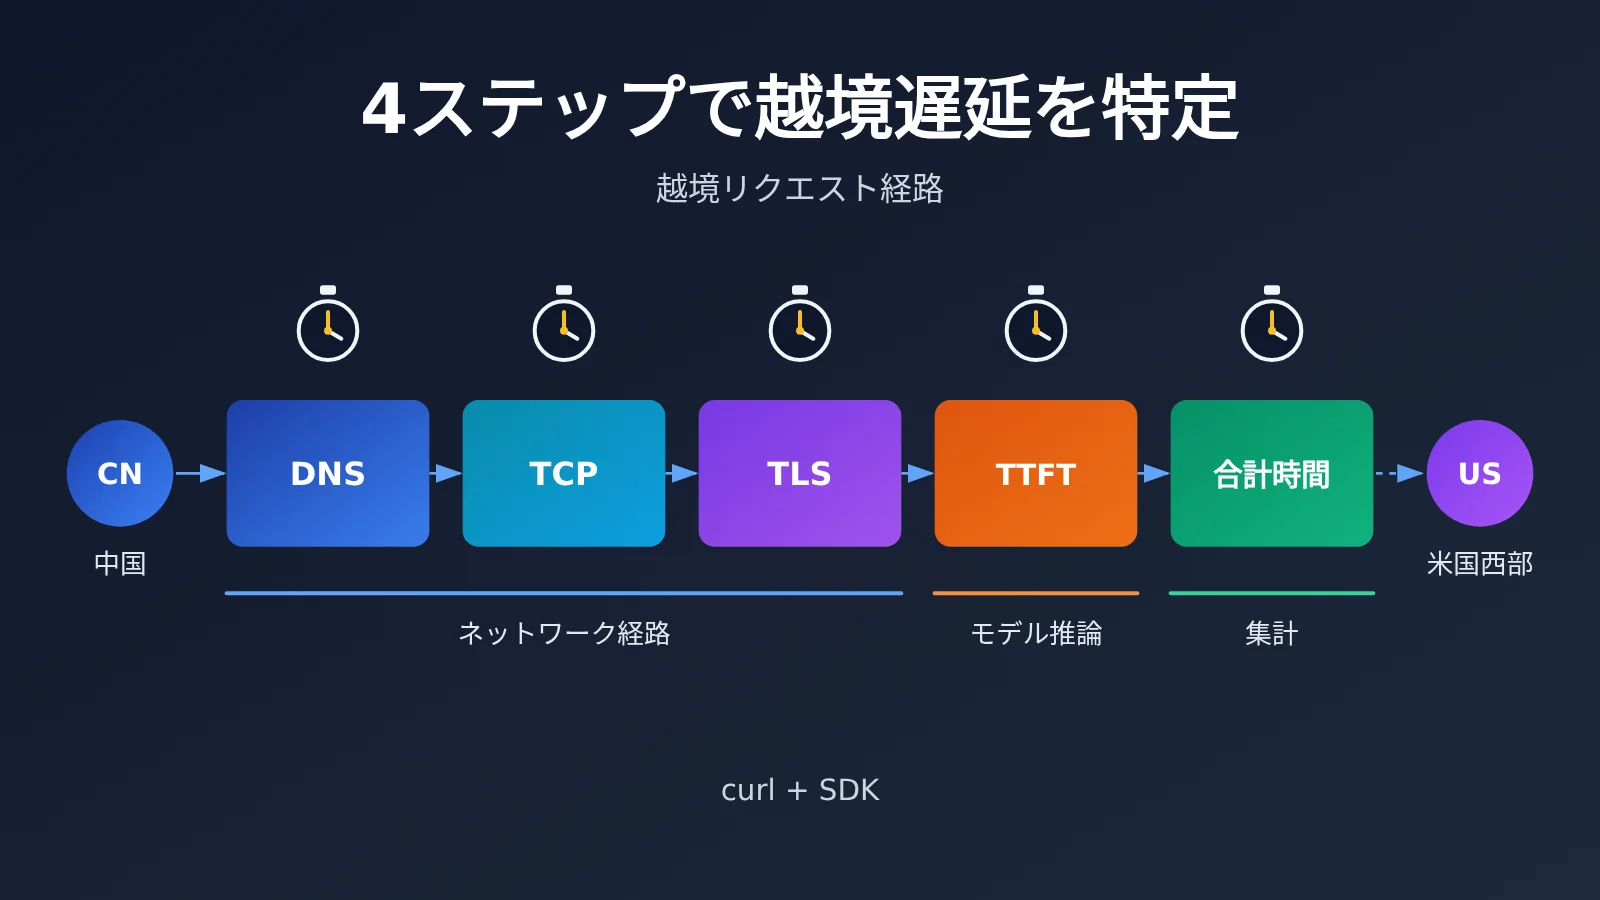
計測を始める前に、まず基本認識を整理しておきましょう。大規模言語モデルAPIの1回の呼び出しにかかる総時間は、「ネットワーク所要時間」と「モデル所要時間」の合計です。海外通信の遅延が影響するのは前者だけで、多くの人が感じる「遅い」の大半は実は後者に由来します。
| ステップ | 測定内容 | ツール | 分かること |
|---|---|---|---|
| ステップ1 | DNS・TCP・TLSの接続確立時間 | curlの-wオプション |
海外との通信経路自体が正常か |
| ステップ2 | 最初のトークンまでの遅延(TTFT) | SDKのストリーミング呼び出し | モデルが応答を開始するまでの待ち時間 |
| ステップ3 | 全体の所要時間とスループット | SDKの非ストリーミング+複数回の統計 | 長い出力や大きなレスポンスの返送が安定しているか |
| ステップ4 | 比較診断 | 診断マトリクス | ボトルネックがネットワーク、モデル、コードのどこにあるか |
海外通信の遅延はどの部分で構成されるか
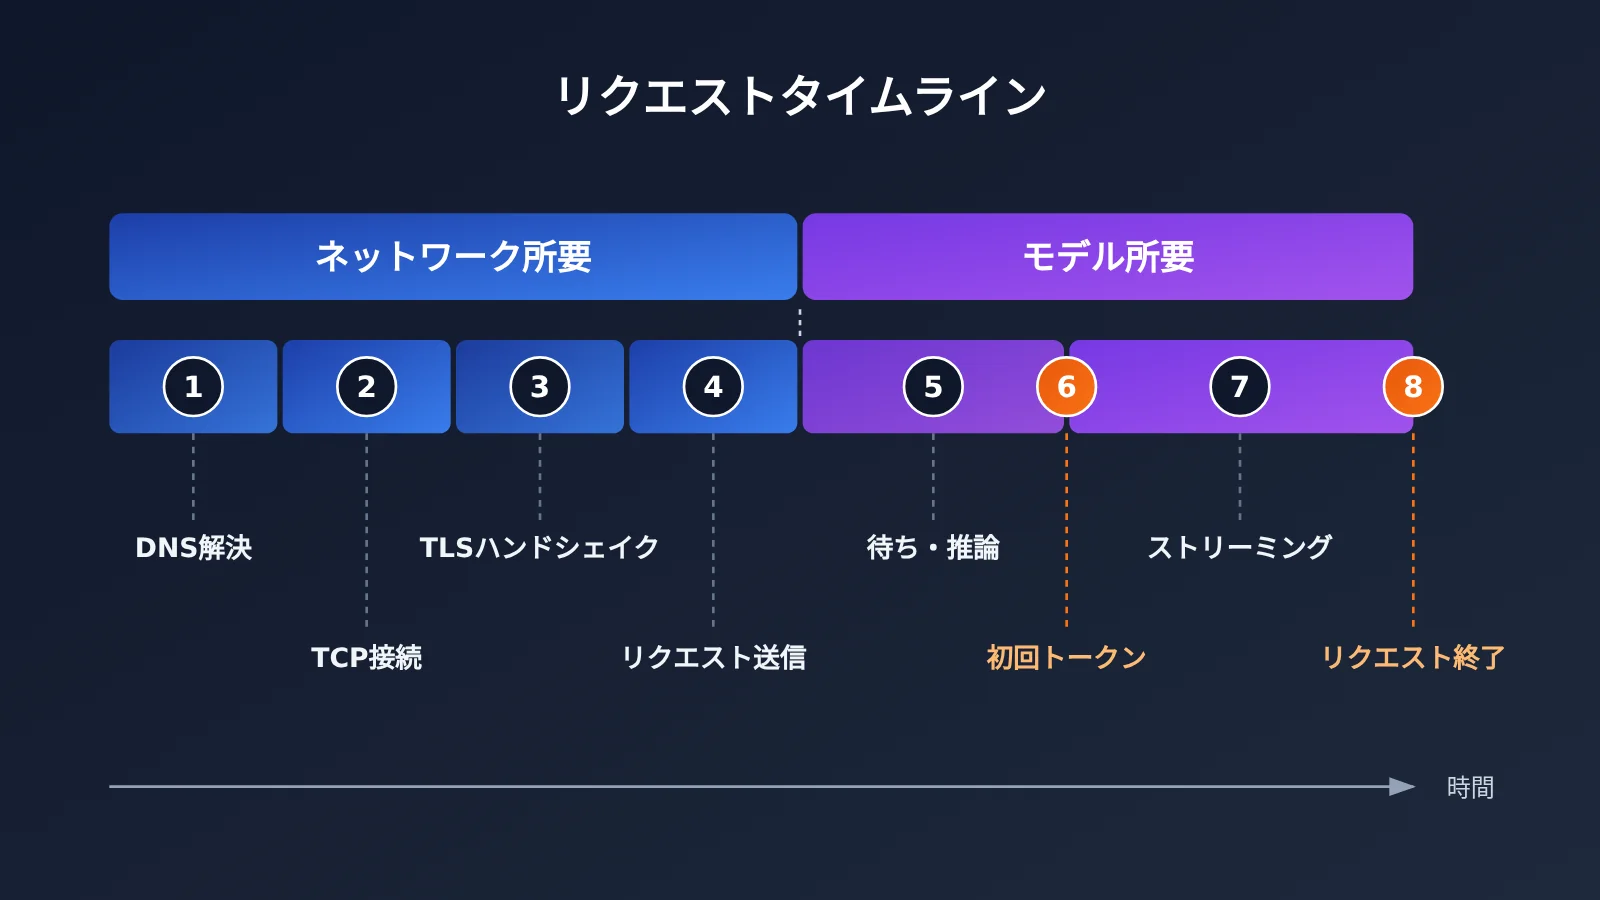
HTTPSリクエストがサーバーから送信されると、DNS解決、TCPの3ウェイハンドシェイク、TLSハンドシェイクを順に経て、ようやくリクエストボディが送信されます。海外通信の場面では、TCPとTLSのハンドシェイクに何度も往復が必要になり、物理的な距離による往復遅延が数倍に拡大されます。これが「接続確立が遅い」原因です。幸いなことに、接続確立は通常最初のリクエスト時のみで、接続を再利用すればこのコストは大幅に下がります。
リクエストがサーバーに到達すると、モデル推論の段階に入ります。対話モデルの場合、最初のトークンが現れるまでの待ち時間は、モデルのサイズ、入力長、現在の負荷によって決まります。最初のトークン以降の出力速度は、モデルの生成レートによって決まります。画像や動画の生成は事情が異なり、多くの場合、大きなサイズの結果が同期的に返されます。戻りの通信経路の帯域幅と安定性が、結果を完全に届けられるかどうかに直接影響します。
ネットワークが遅いのかモデルが遅いのかの判断原則
判断原則はとてもシンプルです。接続確立の段階が遅ければネットワークを、最初のトークンが遅ければモデルと入力を、出力段階が遅く変動が大きければ戻りの通信経路とレスポンスボディのサイズを確認します。 この3段階の数値を測るだけで、ほとんどの「遅い」問題は数分以内に原因を切り分けられます。
4ステップの速度測定で越境遅延を特定してすぐに実践
以下に示す例は、いずれもOpenAI互換インターフェースを前提としています。サービスが国内にデプロイされていても海外にデプロイされていても、base_urlを変更するだけで接続でき、コードのほかの部分はそのまま使えます。
ステップ1:curlで越境リンクの接続確立にかかる時間を分解する
curlに標準搭載されている-wパラメータは、各段階のタイムスタンプを出力できます。越境遅延を調査するうえで最も手早いツールです。モデル推論の時間がネットワーク計測に干渉しないよう、/v1/modelsのような軽量なエンドポイントにリクエストすることをおすすめします。
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS解析:   %{time_namelookup}s\nTCP接続:   %{time_connect}s\nTLSハンドシェイク:   %{time_appconnect}s\n最初のバイト:    %{time_starttransfer}s\n合計時間:    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
特に注意したいのは、curlが出力する各値はリクエスト開始からの累積である時点であり、個々の段階の独立した所要時間ではないということです。各フィールドの意味と計算方法は次のとおりです。
| curlフィールド | 意味 | 単一段階の所要時間の計算 | 値が大きいときのよくある原因 |
|---|---|---|---|
time_namelookup |
DNS解析の完了 | そのまま読み取る | ローカルDNSが遅い、遠いノードに解決されている |
time_connect |
TCP接続の確立 | connect − namelookup | 越境の往復遅延(RTT)が高い、パケットロス |
time_appconnect |
TLSハンドシェイクの完了 | appconnect − connect | リンクの揺らぎ、ハンドシェイクの複数回の往復 |
time_starttransfer |
最初のバイトを受信 | starttransfer − appconnect | サーバー側の処理、キュー待ち |
time_total |
リクエストの終了 | total − starttransfer | レスポンスボディが大きい、復路の帯域不足 |
5~10回連続で実行し、数値が安定しているかどうかを観察することをおすすめします。TCPとTLSの2段階の所要時間の変動が大きい場合は、リンク品質が不安定であることを示しています。数値が安定しており許容範囲内であれば、ネットワークが主なボトルネックでない可能性が高いと言えます。
ステップ2:SDKのストリーミング呼び出しで最初のトークン遅延を計測する
接続に問題がなければ、次はモデルが応答を始めるまでの速さを確認しましょう。最初のトークン遅延(Time To First Token、TTFT)は、対話型アプリで最も体感しやすい指標です。ユーザーは画面を見つめて最初の一言が出るのを待っていますから、1秒1秒がとても長く感じられます。
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 国内・海外のデプロイのどちらでも利用可能
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"最初のトークン遅延: {time.perf_counter() - start:.2f}s")
        break
TTFTが取得できたら、ステップ1で計測した接続所要時間を引いてみましょう。残った部分はほぼ、モデルのキュー待ちと推論にかかった時間です。もしこの部分が大部分を占めているなら、ネットワークを最適化しても効果は限定的です。それよりも、より高速なモデルへの切り替え、入力コンテキストの短縮、ストリーミング出力の有効化などを検討したほうがよいでしょう。
ステップ3:複数回の計測で全体の所要時間と大きなレスポンスボディの返送を評価する
1回だけの計測は偶発的な変動の影響を受けやすいため、本番環境での評価では複数回の統計を取り、中央値と最大値に注目しましょう。以下の完全なスクリプトは、DNS、TCP、TLS、TTFT、および全体の所要時間を自動で計測し、集計結果を出力します。
完全版の速度計測スクリプトを見る
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # 統合アクセスURL
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """DNS、TCP、TLS の所要時間を段階ごとに計測する"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """最初のトークンまでの遅延と全体の所要時間を計測する"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "写一段 200 字左右的产品介绍"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} 中位数 {statistics.median(values):.3f}s  "
          f"最大 {max(values):.3f}s  最小 {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"第 {i + 1} 轮完成,输出 {llm['chars']} 字")

    print("\n===== 测速汇总 =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
画像APIでは、もう1点に特に注意が必要です。画像生成は通常、同期呼び出しであり、最終的に返されるレスポンスボディはテキストよりもはるかに大きくなります。全体の所要時間が最初のバイトまでの時間(TTFB)より大幅に長い場合や、接続がときどき中断される場合、問題はモデルの生成が遅いことではなく、多くの場合、復路のネットワーク経路にあります。このようなときは、クライアントのタイムアウトを適切に長めに設定し、中断に対して冪等なリトライを行うべきです。
ステップ4:診断マトリクスでボトルネックを判断する
最初の3ステップで得たデータを手にしたら、以下のマトリクスに照らし合わせてみましょう。ほとんどの場合、これで問題の所在を特定できます。
| 現象 | 最も可能性の高いボトルネック | 優先的な対処方法 |
|---|---|---|
| DNSフェーズが明らかに遅い | ローカルDNS解決 | 安定したDNSサービスへの変更、解決キャッシュの有効化 |
| TCP、TLSが遅く変動も大きい | 越境回線の品質 | 接続の再利用、回線最適化のある接続サービスの選択 |
| 接続確立は正常だがTTFTが高い | モデル推論、または入力が長すぎる | より高速なモデルへの変更、コンテキストの簡潔化、ストリーミングの有効化 |
| TTFTは正常だが全体の所要時間が長い | 出力が長すぎる、または生成速度が低い | max_tokensの制限、タスクの分割 |
| 画像・動画が時々中断する | 大きなレスポンスボディの返送が不安定 | タイムアウトの延長、冪等リトライ、非同期ポーリング |
| 初回は遅く、以降は速い | コールドスタートの接続確立 | 長接続の使用、clientのグローバル再利用 |
🚀 クイックスタート:上記の速度測定スクリプトをすぐに実行してみたい場合は、まず APIYI apiyi.com で登録してAPIキーを取得するのがおすすめです。新規ユーザーには無料のテスト枠があり、複数回の速度測定比較をこなすのに十分な量です。追加でプロキシをデプロイする必要はありません。
デプロイ地域ごとに base_url はどう選ぶ?
多くの開発者が「海外にデプロイする場合と国内にデプロイする場合で、接続先アドレスを分ける必要があるのか」と悩みます。答えは「不要」です。APIYI のサーバー自体は米国西海岸にあり、海外からのアクセスはもともと経路が短くなっています。さらに、国内アクセス向けには帰国回線のアクセラレーションを用意しており、画像や動画といったレスポンスサイズの大きい業務で、返送の安定性を重点的に確保しています。そのため、どこにデプロイしても同じ base_url を統一して使うだけで問題ありません。
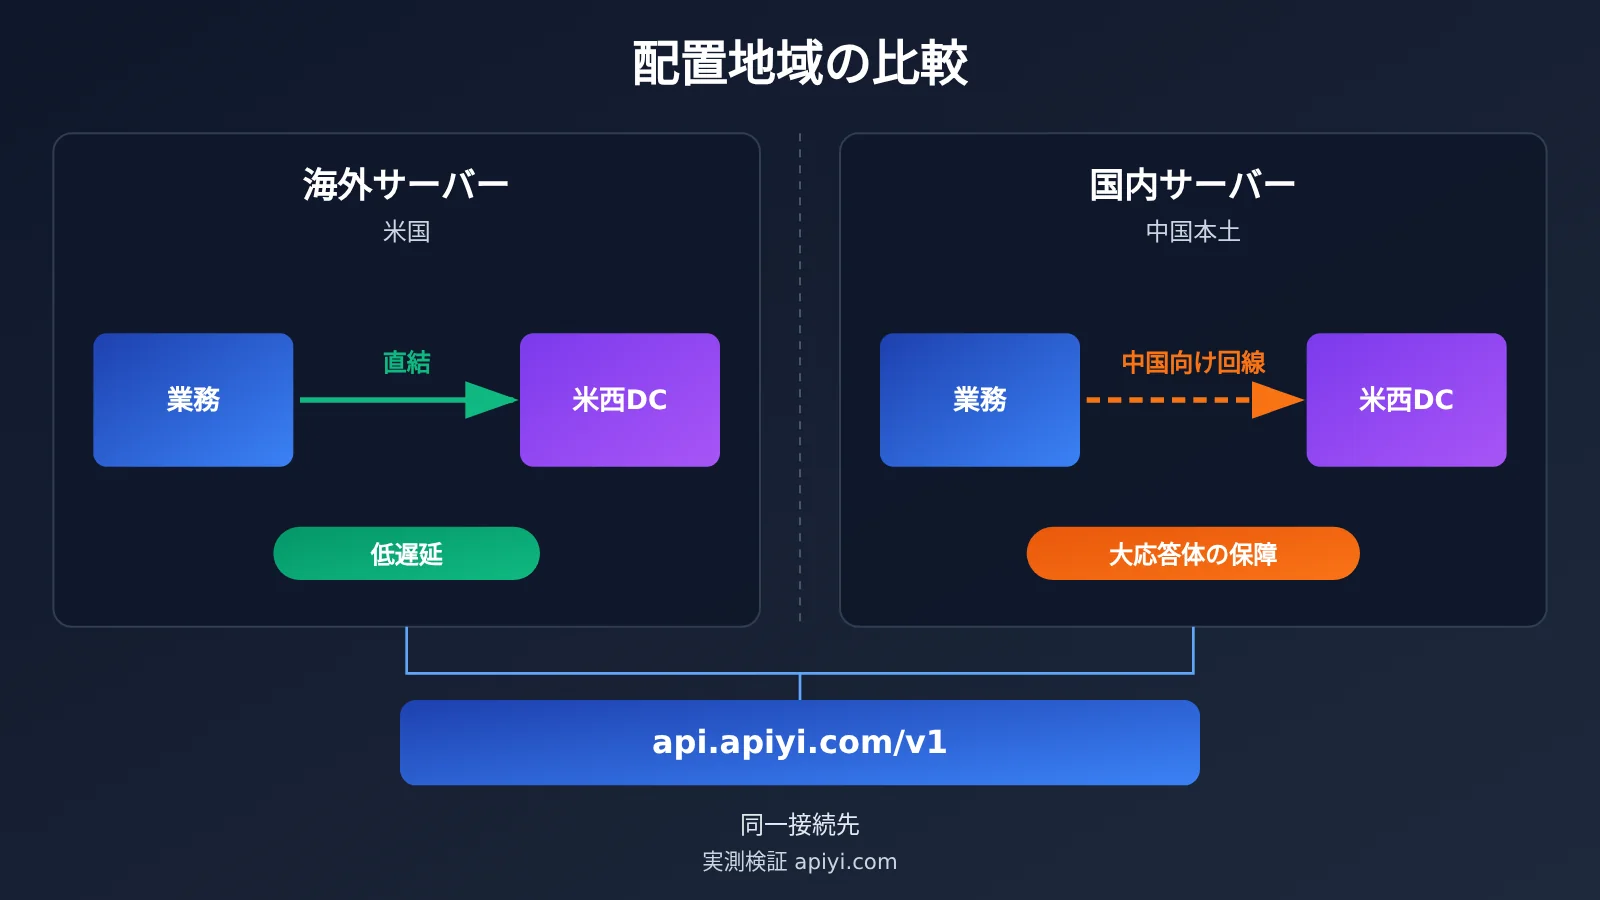
| デプロイ場所 | 経路の特徴 | 速度測定の注目点 | 接続の推奨 |
|---|---|---|---|
| アメリカ / 米国西海岸 | サーバーと同一リージョンで往復遅延が低い | TTFT とモデル処理時間を重点的に確認 | 統一された接続先をそのまま使用 |
| ヨーロッパ / アジア太平洋(海外) | 大洋をまたぐが国際回線は通常安定 | TLS ハンドシェイクと接続の再利用に注目 | 統一された接続先 + 長い接続(keep-alive) |
| 中国大陸 | 越境経路だが帰国回線のアクセラレーションあり | 接続確立の揺らぎと大容量レスポンスの返送に注目 | 統一された接続先 + 適切なタイムアウト |
| ハイブリッドデプロイ | 複数リージョンから同時に呼び出し | リージョンごとに個別に速度測定・比較 | 同一コードで分岐設定は不要 |
この設計の利点は、同じコードをテスト環境(国内)と本番環境(海外)の間でシームレスに移行でき、複数の設定を保守する必要がないことです。実際に必要なのは、それぞれのデプロイ環境で先ほどの4ステップの速度測定を実行し、実パフォーマンスが業務の期待に合っているか確認することです。
大容量レスポンスを越境で呼び出す際の最適化のヒント
画像と動画のAPIは越境経路の影響を最も受けやすいため、コードレベルで以下の点を実施することをおすすめします:
- client をグローバルに再利用:リクエストのたびに接続を張り直すのを避け、越境シナリオではハンドシェイクの時間を大幅に削減できます。
- 業務タイプ別にタイムアウトを設定:テキスト対話は短めに、画像生成や動画結果の取得には十分な余裕を持たせます。
- 中断時は冪等なリトライ:指数バックオフを使い、短時間に生成タスクを重複投入するのを避けます。
- 動画タスクは非同期ポーリング:タスク投入後は定期的にステータスを確認し、結果が準備できてからダウンロードすることで、長い接続の中断リスクを減らせます。
- 区間ごとの所要時間ログを記録:TTFT と全体の所要時間を監視に記録しておけば、問題発生時に素早く原因を追えます。
よくある質問 FAQ
Q1:越境遅延とは何ですか。モデル推論遅延との違いは?
越境遅延は、リクエストが国内と海外のサーバー間を転送されることで発生するネットワークの遅延で、主に TCP・TLS の接続確立やデータ返送の段階で顕在化します。一方、モデル推論遅延はサーバー側がコンテンツを生成するのにかかる時間で、最初のトークンを待つ時間や出力速度として現れます。最適化の方向性を正しく見極めるには、この2つを分けて計測する必要があります。
Q2:業務が米国サーバーにデプロイされている場合、APIYI を呼び出すにはどのアドレスを入力すればよいですか?
`https://api.apiyi.com/v1` をそのまま使えばOKです。APIYI のサーバーは米国西海岸にあるため、米国にデプロイした業務からのアクセス経路はとても短く、追加設定は不要です。具体的な接続手順は APIYI apiyi.com のドキュメントセンターにあるクイックスタートをご覧ください。3ステップで完了します。
Q3:サーバーが米国西海岸にあるのに、国内からのアクセスも比較的スムーズなのはなぜですか?
国内アクセス向けに帰国回線の高速化が施されているためです。主に画像や動画といったレスポンスサイズの大きい業務の返送を安定させることを目的としています。本文のステップ1にある curl コマンドを国内サーバーで実際に実行し、TCP と TLS の各段階の所要時間や変動を確認してみてください。
Q4:最初のトークンの遅延が大きいのは、ネットワークに問題があるからですか?
そうとは限りません。まず curl で計測した接続確立の所要時間を見てください。接続確立が正常であれば、TTFT が高いのはたいていモデル自体が大きい、入力コンテキストが長すぎる、あるいは推論が複雑といった理由によるものです。その場合は、軽量モデルへの切り替え、プロンプトの簡素化、ストリーミング出力の有効化などでユーザー体験を改善できます。
Q5:異なるモデルの応答速度を手早く比較するにはどうすればよいですか?
複数モデルに対応した集約インターフェースでのテストをおすすめします。
1. APIYI apiyi.com でアカウントを登録し、APIキーを取得します
2. 本文の速度計測スクリプト一式を使い、`MODEL` 変数だけを変更します
3. 各モデルで同じ回数を実行し、TTFT と全体の所要時間の中央値を比較します
1つのキーで OpenAI、Claude、Gemini などの多様なモデルを呼び出せるため、比較時もネットワーク条件がそろい、結論の信頼性が高まります。
Q6:画像 API で時々接続が中断されます。どう切り分ければよいですか?
画像インターフェースは同期呼び出しでレスポンスサイズが大きく、中断は結果返送の段階で起こることが多くなります。まずクライアント側のタイムアウトを長めに設定し、次に curl の `time_total` と `time_starttransfer` の差分を確認してください。差分が大きく不安定であれば、帰路の回線がボトルネックである可能性が高いです。冪等なリトライを組み込み、ピーク時間帯を避けてバッチ送信するとよいでしょう。
Q7:この速度計測方法にはどのような限界がありますか?
計測結果は、測定した時点と場所におけるネットワーク状態を反映したものにすぎず、通信事業者や時間帯によって大きく異なることがあります。また、モデルの負荷は時間とともに変化するため、1回の TTFT で長期的な性能を判断することはできません。本番環境で段階ごとの所要時間を長期的に記録し、単発のデータではなく傾向をもとに判断することをおすすめします。
国内で大規模言語モデルAPIを呼び出す際の速度測定 核心ポイント(Key Takeaways)
- まず分離してから最適化:総所要時間は「ネットワーク時間+モデル時間」です。必ずセグメントごとに計測します。
- 接続確立はcurlで測定:
-wパラメータを使って、DNS・TCP・TLSの累積時間を取得します。 - TTFTはSDKで測定:ストリーミング呼び出しで最初のトークンまでの時間を記録し、モデルの応答速度を判断します。
- 複数回の中央値を見る:1回の結果は変動の影響を受けやすいため、最低5回以上は統計を取ります。
- 大きなレスポンスは復路に注目:画像や動画では、全体の所要時間と最初のバイトまでの時間の差に注目します。
- 接続先アドレスを統一:APIYI apiyi.com 経由で接続すれば、国内・海外で同じ base_url を共用できます。
まとめ
国内で大規模言語モデルAPIを呼び出す際に「遅い」原因を調査する核心ポイントは次のとおりです。
- 4ステップの切り分け法:接続確立の速度測定、最初のトークンまでの速度測定、全体所要時間の統計、診断マトリクスとの照合という順で、段階的に範囲を絞り込みます。
- 2種類の遅延を区別する:国境をまたぐ遅延は接続の再利用と回線の最適化で解決し、モデル側の遅延はモデル選定と入力をそぎ落とすことで解決します。
- 大きなレスポンスは個別に注目:画像・動画を扱う業務では、適切なタイムアウト設定、冪等なリトライ、非同期ポーリングを組み合わせます。
- base_url は地域ごとに分ける必要はない:海外は米国西部のデータセンターへ直接接続し、国内は帰国回線で加速されるため、設定は1セットで済みます。
「なんとなく遅い」と感覚で判断するより、数分かけて速度測定スクリプトを1回実行し、データにボトルネックの在処を示してもらいましょう。APIYI apiyi.com で無料のテスト枠を取得し、ご自身のデプロイ環境で実測したうえで、モデル選定とタイムアウト戦略を決めることをおすすめします。
📚 参考資料
- APIYI ドキュメントセンター:接続アドレスと3ステップの接続フローの説明
- リンク:
docs.apiyi.com -
説明:OpenAI 互換モードの設定、画像 API 呼び出しの注意事項、接続中断のトラブルシューティングを収録
-
curl 公式マニュアル:
-wwrite-out 変数の完全な説明 - リンク:
curl.se/docs/manpage.html -
説明:
time_namelookup、time_appconnectなどの計測フィールドの正式な定義を確認できます -
OpenAI Python SDK:公式オープンソースリポジトリ
- リンク:
github.com/openai/openai-python - 説明:ストリーミング呼び出し、タイムアウト、リトライパラメータの使用方法
作者:APIYI 技術チーム
技術交流:速度測定の過程で問題が発生した場合は、APIYI のウェブサイトトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます。