ملاحظة المؤلف: باستخدام curl وSDK للقياس الزمني، فكّك زمن DNS وTLS وأول token والزمن الإجمالي، وحدّد في 4 خطوات ما إذا كانت عنق الزجاجة في استدعاء واجهات نماذج اللغة الكبيرة من داخل الصين تكمن في “الرابط العابر للحدود” أم في “استدلال النموذج”.
“لماذا هذه الواجهة بطيئة إلى هذا الحد؟” هذا أكثر سؤال يردده المطورون داخل الصين عند الوصول إلى واجهات نماذج اللغة الكبيرة. المشكلة أن “البطء” مجرد ظاهرة سطحية، فقد يكون ناتجًا عن تحليل DNS، أو مصافحة TLS العابرة للحدود، أو انتظار النموذج في قائمة الانتظار، وقد يكون ببساطة أن النموذج نفسه يفكر بجدية. تقدم هذه المقالة منهجية تحديد موقع البطء بالقياس في 4 خطوات تساعدك على تفكيك الزمن المستغرق في الطلب الواحد، وتحديد جذر بطء استدعاء نماذج اللغة الكبيرة من داخل الصين بدقة.
هذا ليس دليلًا “خرافيًا” من نوع “جرّب عقدة أخرى”، بل عملية استكشاف قابلة للتكرار مستمدة من استشارات واقعية حول الوصول. كثيرًا ما نُسأل: إذا كانت الخدمة منشورة على خادم في الولايات المتحدة، فما عنوان الوصول الذي يجب إدخاله؟ هل سيتأثر الوصول من داخل الصين بالتباطؤ بسبب العبور عبر الحدود؟ هل يمكن إرجاع النتائج الكبيرة مثل الصور والفيديو بالكامل؟ ستجيب الفقرات التالية عن ذلك واحدًا واحدًا.
القيمة الجوهرية: بعد قراءة هذه المقالة، ستتعلم استخدام curl وSDK الخاص بـ Python للقياس الزمني المُجزّأ، والتمييز بين الزمن المستغرق في الرابط الشبكي والزمن المستغرق في استدلال النموذج، واختيار base_url الصحيح حسب منطقة النشر.
النقاط الأساسية لبطء استدعاء API نماذج اللغة الكبيرة داخل الصين
قبل البدء في قياس السرعة، من المفيد تأسيس فكرة أساسية: إجمالي الزمن الذي يستغرقه استدعاء واحد لواجهة API لنموذج لغة كبير هو حصيلة تراكب «زمن الشبكة» و«زمن النموذج». تؤثر التأخيرات العابرة للحدود في الأول فقط، بينما كثير مما يشعر به الناس على أنه «بطء» يأتي في الواقع معظمه من الثاني.
| الخطوة | ما الذي نقيسه | الأداة | السؤال الذي تجيب عنه |
|---|---|---|---|
| الخطوة 1 | زمن إنشاء اتصال DNS وTCP وTLS | معامل -w في curl |
هل المسار العابر للحدود سليم أصلاً |
| الخطوة 2 | زمن الوصول إلى أول توكن (TTFT) | استدعاء متدفق عبر SDK | كم ينتظر النموذج قبل أن يبدأ بالاستجابة |
| الخطوة 3 | الزمن الكلي والإنتاجية | SDK غير متدفق + إحصاءات عبر عدة جولات | هل إعادة إرسال المخرجات الطويلة والاستجابات الكبيرة مستقرة |
| الخطوة 4 | تشخيص مقارن | مصفوفة التشخيص | أين عنق الزجاجة: الشبكة أم النموذج أم الشيفرة |
من أي أجزاء يتكون التأخير العابر للحدود
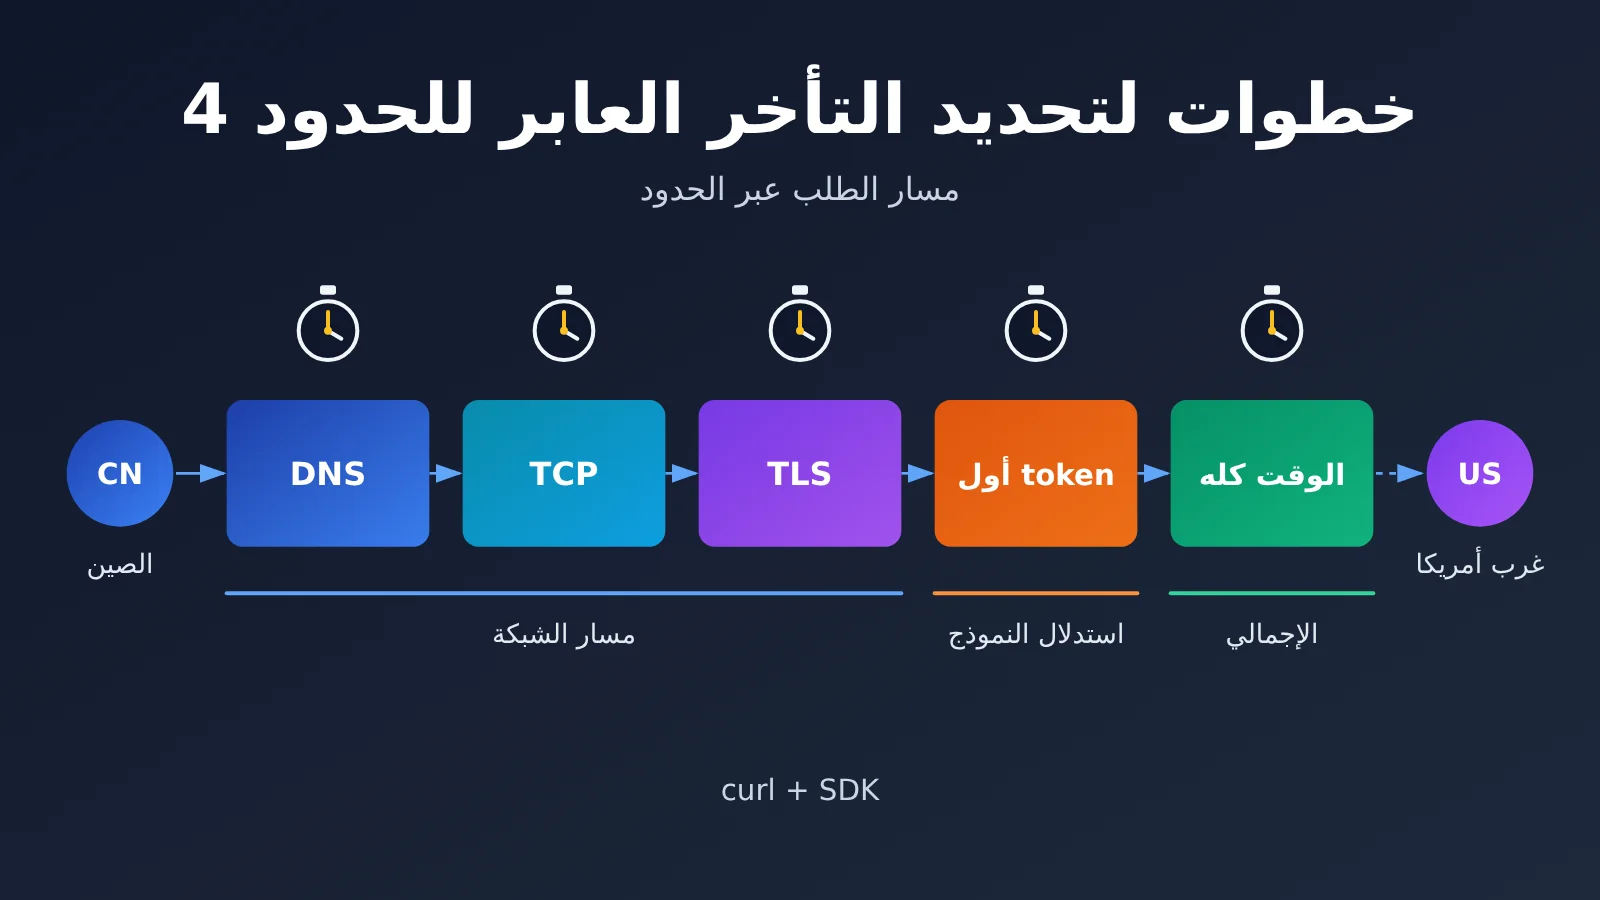
يبدأ طلب HTTPS من خادمك، ويمر بالترتيب عبر تحليل DNS، ثم مصافحة TCP ثلاثية الاتجاهات، ثم مصافحة TLS، وبعدها فقط يُرسل جسم الطلب. في السيناريوهات العابرة للحدود، تحتاج مصافحتا TCP وTLS إلى عدة ذهاب وإياب، ويتضاعف الزمن الناتج عن المسافة الفيزيائية عدة مرات؛ ومن هنا يأتي «بطء إنشاء الاتصال». لحسن الحظ، لا يحدث إنشاء الاتصال عادةً إلا في الطلب الأول، وبعد إعادة استخدام الاتصال تنخفض هذه التكلفة بشكل كبير.
بعد وصول الطلب إلى الخادم، تبدأ مرحلة استدلال النموذج. وبالنسبة لنماذج المحادثة، يعتمد الانتظار قبل ظهور أول توكن على حجم النموذج وطول الإدخال والحمل الحالي؛ وبعد أول توكن، تعتمد سرعة الإخراج على معدل توليد النموذج. أما توليد الصور والفيديو فيختلف؛ فهو غالباً يعيد نتيجة كبيرة الحجم بشكل متزامن، وتؤثر سعة رابط العودة واستقراره مباشرةً في إمكانية وصول النتيجة كاملة.
مبدأ الحكم: هل البطء في الشبكة أم في النموذج
المبدأ بسيط في الحقيقة: إذا كان البطء في مرحلة إنشاء الاتصال، فانظر إلى الشبكة؛ وإذا كان البطء في أول توكن، فانظر إلى النموذج والإدخال؛ وإذا كان البطء في مرحلة الإخراج مع تقلبات كبيرة، فانظر إلى رابط العودة وحجم جسم الاستجابة. بمجرد قياس أرقام هذه المراحل الثلاث، يمكن تحديد طبيعة معظم مشكلات «البطء» خلال دقائق.
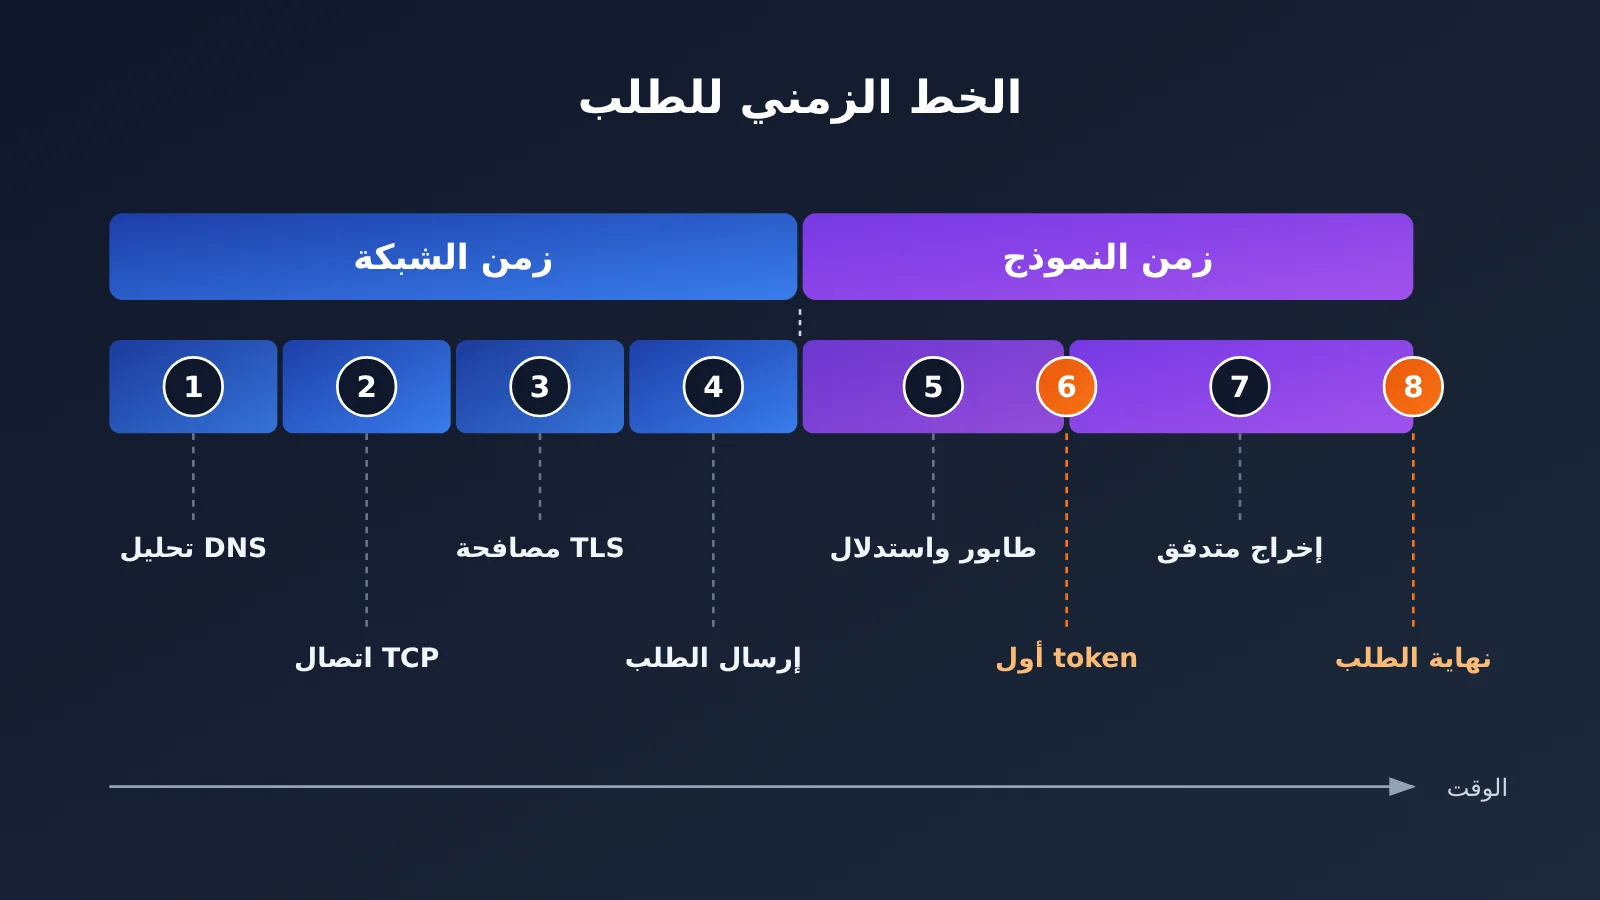
قياس السرعة وتحديد التأخير عبر الحدود في 4 خطوات: دليل سريع
تعتمد الأمثلة التالية على واجهات متوافقة مع OpenAI. وسواء كانت خدمتك مستضافة محليًا أو في الخارج، يكفي تعديل base_url للاتصال، مع إبقاء بقية أجزاء الشيفرة كما هي.
الخطوة 1: تفكيك زمن إنشاء الاتصال عبر الحدود باستخدام curl
تتيح لك المعلمة -w المدمجة في curl إخراج توقيت كل مرحلة، وهي أسرع أداة لتشخيص التأخير عبر الحدود. يُنصح بطلب واجهة خفيفة مثل /v1/models لتجنب أن يؤثر زمن استدلال النموذج في قياس الشبكة.
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS解析:   %{time_namelookup}s\nTCP连接:   %{time_connect}s\nTLS握手:   %{time_appconnect}s\n首字节:    %{time_starttransfer}s\n总耗时:    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
انتبه جيدًا: كل قيمة يخرجها curl هي نقطة زمنية تراكمية من بداية الطلب، وليست زمنًا مستقلًا لكل مرحلة. فيما يلي معنى كل حقل وطريقة حسابه:
| حقل curl | المعنى | حساب زمن المقطع الواحد | الأسباب الشائعة عند الارتفاع |
|---|---|---|---|
time_namelookup |
اكتمال تحليل DNS | يُقرأ مباشرة | بطء DNS المحلي، أو التحليل إلى عقدة بعيدة |
time_connect |
إنشاء اتصال TCP | connect − namelookup | ارتفاع زمن الذهاب والإياب عبر الحدود، وفقدان الحزم |
time_appconnect |
اكتمال مصافحة TLS | appconnect − connect | تقلب الرابط، ومصافحة على عدة رحلات |
time_starttransfer |
استلام أول بايت | starttransfer − appconnect | معالجة الخادم، والانتظار في الطابور |
time_total |
انتهاء الطلب | total − starttransfer | كبر جسم الاستجابة، وضعف نطاق العودة |
يُنصح بالتنفيذ من 5 إلى 10 مرات متتالية ومراقبة ثبات القيم. إذا كانت أزمنة مقطعي TCP وTLS تتقلب كثيرًا، فهذا يشير إلى أن جودة الرابط غير مستقرة. وإذا كانت القيم ثابتة وضمن نطاق مقبول، فمن المرجح ألا تكون الشبكة هي عنق الزجاجة الرئيسي.
الخطوة 2: قياس زمن الوصول إلى أول رمز عبر استدعاء متدفق باستخدام SDK
بعد التأكد من أن الاتصال يعمل، ننتقل إلى سرعة بدء النموذج في الاستجابة. يُعدّ زمن الوصول إلى أول رمز (Time To First Token، ويُختصر إلى TTFT) من أكثر المؤشرات التي تلمسها مباشرةً في تطبيقات المحادثة؛ فالمستخدم يحدّق في الشاشة منتظرًا ظهور أول حرف، وكل ثانية تمر تبدو طويلة جدًا.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # يمكن استخدامه للنشر المحلي والدولي
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "عرّف عن نفسك في جملة واحدة"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"زمن الوصول إلى أول رمز: {time.perf_counter() - start:.2f}s")
        break
بعد الحصول على TTFT، اطرح منه زمن إنشاء الاتصال الذي قسته في الخطوة الأولى؛ فما يتبقى يكون في الغالب هو وقت انتظار النموذج في الطابور والاستدلال. وإذا كان هذا الجزء هو الغالبية العظمى، فإن تحسين الشبكة لن يعطي نتيجة كبيرة، والأجدر أن تفكر في استخدام نموذج أسرع، أو تقصير سياق الإدخال، أو تفعيل الإخراج المتدفق.
الخطوة 3: إحصاء الوقت الكلي واستقبال الاستجابات الكبيرة عبر عدة جولات
من السهل أن تتأثر القياسات الفردية بالتقلبات العارضة، لذا عند تقييم بيئة الإنتاج ينبغي إجراء إحصاء على عدة جولات، مع التركيز على الوسيط والقيمة القصوى. يقوم السكربت الكامل أدناه بقياس زمن DNS وTCP وTLS وزمن أول رمز (TTFT) والوقت الكلي تلقائيًا، ثم يعرض النتائج المجمّعة.
عرض سكربت قياس السرعة الكامل
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # عنوان الوصول الموحد
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """قياس زمن DNS وTCP وTLS على مراحل"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """قياس زمن أول رمز والوقت الكلي"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "اكتب تعريفًا بمنتج في حدود 200 كلمة"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} الوسيط {statistics.median(values):.3f}s  "
          f"الأقصى {max(values):.3f}s  الأدنى {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"اكتملت الجولة {i + 1}، وتم إخراج {llm['chars']} حرفًا")

    print("\n===== ملخص قياس السرعة =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
بالنسبة لواجهات الصور، هناك نقطة إضافية تستحق الانتباه: توليد الصور عادةً ما يكون استدعاءً متزامنًا، وحجم الاستجابة النهائية أكبر بكثير من النصوص. إذا كان الوقت الكلي أكبر بكثير من زمن وصول أول بايت، أو حدث انقطاع في الاتصال بشكل عارض، فالمشكلة غالبًا في مسار العودة وليست في بطء توليد النموذج. في هذه الحالة ينبغي زيادة مهلة العميل بشكل مناسب، وإجراء إعادة محاولة متكررة الأثر (idempotent) عند حدوث الانقطاع.
الخطوة 4: تحديد عنق الزجاجة باستخدام مصفوفة التشخيص
بعد أن تجمع بيانات الخطوات الثلاث السابقة، طابقها مع المصفوفة أدناه، وستتمكن غالباً من تحديد موقع المشكلة.
| الظاهرة | عنق الزجاجة الأكثر احتمالاً | طريقة المعالجة ذات الأولوية |
|---|---|---|
| ارتفاع واضح في مرحلة DNS | تحليل DNS المحلي | تغيير إلى خدمة DNS مستقرة، وتفعيل ذاكرة التخزين المؤقت للتحليل |
| ارتفاع TCP وTLS مع تقلبات كبيرة | جودة الرابط العابر للحدود | إعادة استخدام الاتصالات، واختيار خدمة وصول محسّنة للمسار |
| إنشاء الاتصال طبيعي لكن TTFT مرتفع جداً | استدلال النموذج أو إدخال طويل جداً | التبديل إلى نموذج أسرع، تقليص السياق، تفعيل البث |
| TTFT طبيعي لكن الزمن الكلي طويل | إخراج طويل جداً أو معدل توليد منخفض | تقييد max_tokens، تقسيم المهام |
| انقطاعات متقطعة في الصور والفيديو | عدم استقرار إرجاع جسم استجابة كبير | زيادة المهلة، إعادة محاولة متكررة (idempotent)، استعلام غير متزامن |
| المرة الأولى بطيئة والتالية سريعة | إنشاء اتصال من بداية باردة (cold start) | استخدام اتصالات طويلة، وإعادة استخدام client على المستوى العام |
🚀 البدء السريع: إذا أردت تشغيل سكربت قياس السرعة أعلاه فوراً، نوصي بالتسجيل أولاً في APIYI apiyi.com للحصول على مفتاح API، فالمستخدمون الجدد يحصلون على حصة اختبار مجانية تكفي لإكمال عدة جولات من مقارنات قياس السرعة، دون الحاجة إلى نشر أي وكيل إضافي.
كيف تختار base_url حسب منطقة النشر
يحتار كثير من المطورين في سؤال: إذا كانت الخدمة منشورة خارج الصين أو داخلها، هل يجب استخدام عنوان وصول مختلف لكل حالة؟ الجواب هو: لا حاجة لذلك. فخوادم APIYI موجودة أصلاً في غرب الولايات المتحدة، وبالتالي فإن الوصول من الخارج يسير على مسار قصير بطبيعته. وفي الوقت نفسه، وفّرت المنصة مسارًا مُسرَّعًا للوصول من داخل الصين (خط العودة إلى الوطن)، مع التركيز بشكل خاص على استقرار إرجاع الاستجابات الكبيرة كالصور والفيديو. لذلك، أينما كانت خدمتك منشورة، يكفي استخدام نفس base_url الموحّد.
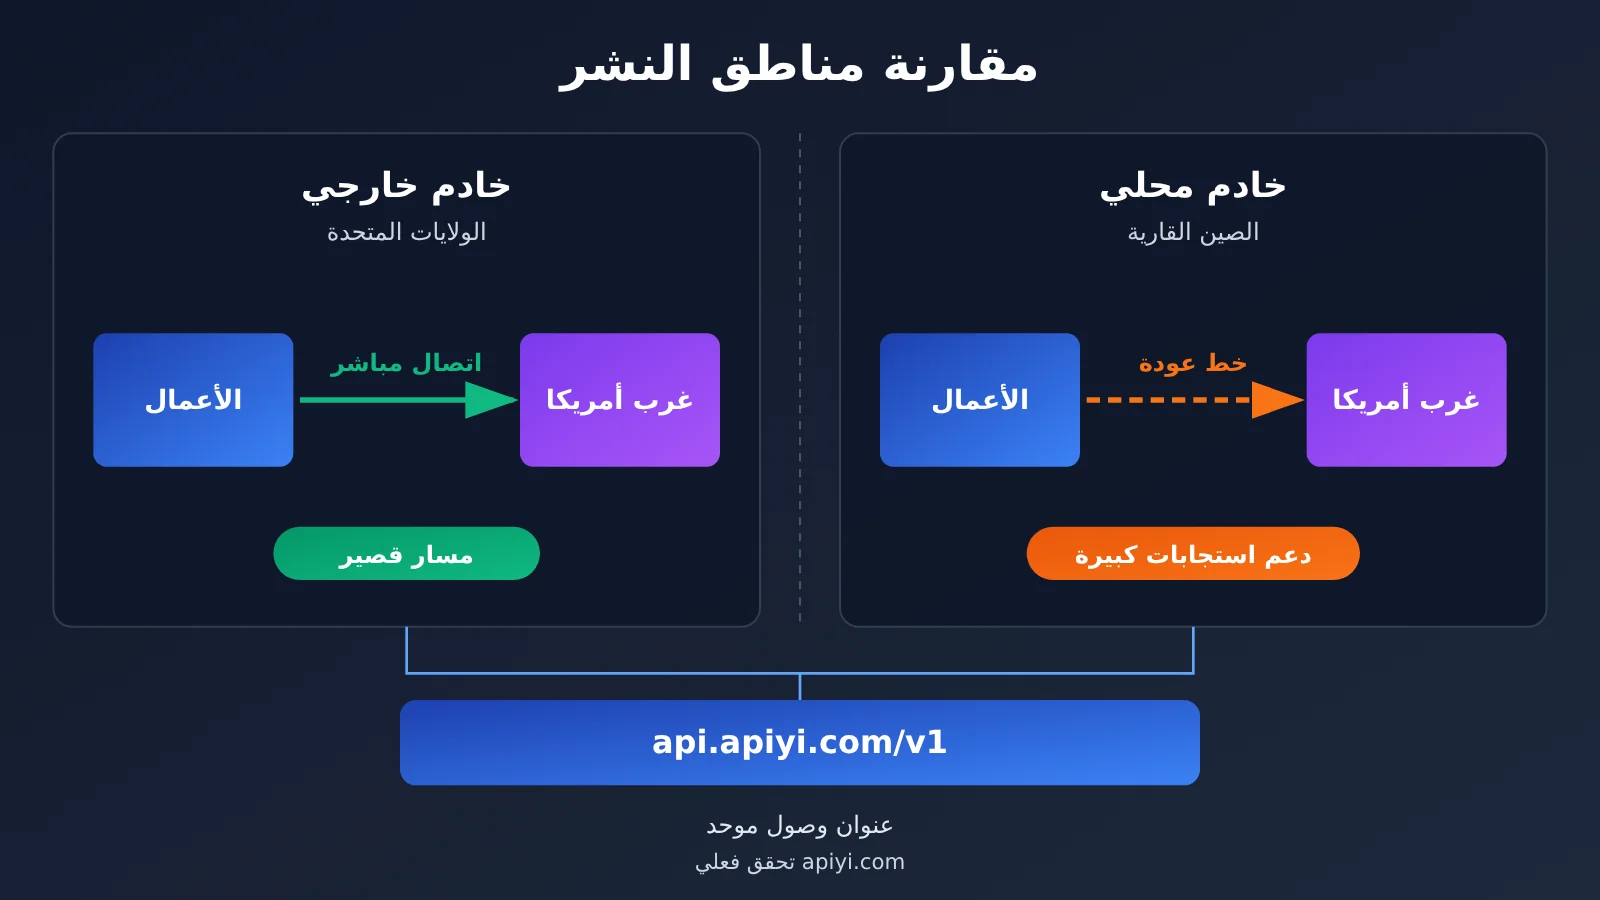
| موقع النشر | خصائص المسار | ما يجب قياسه | توصية الوصول |
|---|---|---|---|
| الولايات المتحدة / غرب أمريكا | نفس منطقة الخادم، زمن ذهاب وعودة منخفض | ركّز على TTFT وزمن النموذج | استخدم عنوان الوصول الموحّد مباشرة |
| أوروبا / آسيا والمحيط الهادئ خارج الصين | عابر للمحيط لكن الروابط الدولية عادة مستقرة | راقب مصافحة TLS وإعادة استخدام الاتصال | العنوان الموحّد + اتصالات طويلة |
| البر الرئيسي للصين | مسار عابر للحدود، مع تسريع خط العودة إلى الوطن | راقب تقلّب إنشاء الاتصال وإرجاع الاستجابات الكبيرة | العنوان الموحّد + مهلات مناسبة |
| نشر مختلط | استدعاء من عدة مناطق في الوقت نفسه | قِس السرعة لكل منطقة على حدة ثم قارن | نفس الكود، دون إعدادات متفرعة |
ميزة هذا التصميم أن نفس الشيفرة يمكن نقلها بسلاسة بين بيئة الاختبار (داخل الصين) وبيئة الإنتاج (خارج الصين)، دون الحاجة إلى صيانة عدة إعدادات. ما تحتاج فعلاً إلى القيام به هو تشغيل خطوات قياس السرعة الأربع السابقة داخل كل بيئة نشر، والتأكد من أن الأداء الفعلي يطابق توقعات العمل.
نصائح لتحسين الاستدعاءات العابرة للحدود ذات الاستجابات الكبيرة
واجهات الصور والفيديو هي الأكثر حساسية للمسارات العابرة للحدود، لذا يُنصح بالقيام بما يلي على مستوى الكود:
- إعادة استخدام client على مستوى التطبيق: تجنّب إنشاء اتصال جديد مع كل طلب، ففي السيناريوهات العابرة للحدود يوفّر ذلك قدرًا كبيرًا من وقت المصافحة.
- ضبط المهلة حسب نوع العمل: المحادثات النصية يمكن أن تكون مهلتها أقصر، أما توليد الصور وجلب نتائج الفيديو فيجب منحها هامشًا كافيًا.
- إعادة محاولة متكررة الآثار عند الانقطاع: استخدم تراجعًا أُسّيًا (exponential backoff) لتجنّب إعادة إرسال مهام التوليد أكثر من مرة خلال فترة قصيرة.
- استخدام الاستقصاء غير المتزامن لمهام الفيديو: أرسل المهمة ثم استعلم عن حالتها دوريًا، ونزّل النتيجة بعد جاهزيتها، ما يقلّل خطر انقطاع الاتصالات الطويلة.
- تسجيل سجلّات زمنية مقسّمة على المراحل: اكتب TTFT والزمن الكلي في نظام المراقبة، حتى تستطيع تتبّع المشكلة بسرعة عند حدوثها.
الأسئلة الشائعة (FAQ)
س1: ما هو التأخير العابر للحدود، وكيف يختلف عن تأخير استدلال النموذج؟
التأخير العابر للحدود هو الوقت الشبكي الذي يستهلكه نقل الطلب بين الخوادم المحلية والخوادم الخارجية، ويظهر بشكل أساسي في مراحل إنشاء اتصال TCP وTLS وإعادة إرسال البيانات. أما تأخير استدلال النموذج فهو الوقت الذي يستغرقه الخادم في توليد المحتوى، ويظهر في انتظار أول token وفي سرعة الإخراج. ولا بد من قياس الاثنين بشكل منفصل حتى نحدد اتجاه التحسين بدقة.
س2: إذا كانت الخدمة منشورة على خوادم في الولايات المتحدة، فأي عنوان أستخدم عند استدعاء APIYI؟
استخدم `https://api.apiyi.com/v1` مباشرةً. فخوادم APIYI موجودة في غرب الولايات المتحدة، وبالتالي يكون مسار الوصول للخدمات المنشورة هناك قصيرًا جدًا ولا يحتاج إلى أي إعداد إضافي. ويمكنك الرجوع إلى دليل البدء السريع في مركز التوثيق على APIYI apiyi.com، فالخطوات ثلاث فقط وتنتهي.
س3: الخادم موجود في غرب الولايات المتحدة، فلماذا يكون الوصول من داخل الصين سلسًا نسبيًا أيضًا؟
لأن المنصة وفّرت تسريعًا لخطوط العودة إلى داخل الصين، وذلك بشكل أساسي لضمان استقرار إعادة نقل الردود كبيرة الحجم مثل الصور والفيديو. يمكنك استخدام أمر curl الوارد في الخطوة الأولى من هذا المقال لإجراء اختبار فعلي على خادم داخل الصين، ومراقبة الزمن والتقلبات في مرحلتي TCP وTLS.
س4: تأخير أول token مرتفع جدًا، فهل المشكلة في الشبكة؟
ليس بالضرورة. ابدأ بالنظر إلى زمن إنشاء الاتصال الذي قاسه curl، فإذا كان طبيعيًا فإن ارتفاع TTFT يعود عادةً إلى أن النموذج نفسه كبير، أو أن سياق الإدخال طويل جدًا، أو أن الاستدلال معقد. في هذه الحالة جرّب نموذجًا أخف، أو اختصر الموجه، أو فعّل الإخراج المتدفق لتحسين تجربة المستخدم.
س5: كيف أقارن سرعة استجابة النماذج المختلفة بسرعة؟
أنصح باستخدام واجهة موحدة تدعم عدة نماذج لإجراء الاختبار:
1. سجّل حسابًا على APIYI apiyi.com واحصل على مفتاح API
2. استخدم سكربت قياس السرعة الكامل الوارد في هذا المقال، وغيّر فقط المتغير `MODEL`
3. شغّل نفس عدد الجولات لكل نموذج، ثم قارن وسيط TTFT والزمن الإجمالي
ولأن مفتاحًا واحدًا يكفي لاستدعاء OpenAI وClaude وGemini وغيرها من النماذج، تبقى ظروف الشبكة متساوية عند المقارنة، وتكون النتائج أكثر موثوقية.
س6: واجهة الصور تنقطع أحيانًا، كيف أستقصي السبب؟
واجهة الصور تعتمد على استدعاء متزامن وردّها كبير الحجم، لذا يحدث الانقطاع غالبًا في مرحلة إعادة نقل النتيجة. أنصح أولاً بزيادة مهلة العميل، ثم مراقبة الفرق بين `time_total` و`time_starttransfer` في curl. إذا كان الفرق كبيرًا وغير مستقر، فهذا يعني أن خط العودة هو عنق الزجاجة؛ وعندها أضف إعادة محاولة آمنة التكرار (idempotent) وتجنّب الإرسال بالجملة في أوقات الذروة.
س7: ما حدود طريقة قياس السرعة هذه؟
تعكس نتائج اختبار السرعة حالة الشبكة في لحظة القياس وموقعه فقط، وقد تختلف بوضوح بين مشغلي الشبكات والأوقات المختلفة. كذلك يتغير حمل النموذج بمرور الوقت، لذا لا يمكن لزمن أول token (TTFT) في قياس واحد أن يمثل الأداء على المدى الطويل. يُنصح بتسجيل الأزمنة المجزأة لكل مرحلة في بيئة الإنتاج لفترة طويلة، واتخاذ القرارات بناءً على الاتجاه العام لا على بيانات نقطة واحدة.
أهم النقاط الأساسية لاختبار سرعة استدعاء واجهات API لنماذج اللغة الكبيرة داخل الصين
- افصل أولًا ثم حسّن: إجمالي الزمن يساوي زمن الشبكة مضافًا إليه زمن النموذج، لذا يجب قياس كل جزء على حدة.
- استخدم curl لقياس إنشاء الاتصال: استخدم المعامل
-wللحصول على أزمنة تراكمية لنقاط DNS وTCP وTLS. - استخدم SDK لقياس TTFT: في الاستدعاء المتدفق، سجّل زمن أول token لتقدير سرعة استجابة النموذج.
- اعتمد الوسيط عبر عدة جولات: النتيجة الواحدة عرضة للتقلب، لذا اجمع 5 جولات على الأقل.
- راقب زمن العودة في الاستجابات الكبيرة: بالنسبة للصور والفيديو، ركّز على الفرق بين الزمن الإجمالي وزمن أول بايت.
- وحّد عنوان الوصول: اتصل عبر APIYI على apiyi.com، واستخدم نفس
base_urlداخل الصين وخارجها.
总结
النقاط الأساسية لتشخيص بطء استدعاء واجهات API لنماذج اللغة الكبيرة محليًا:
- طريقة تحديد موقع المشكلة في 4 خطوات: قياس سرعة إنشاء الاتصال، وقياس سرعة أول رمز (token)، وإحصاء الوقت الإجمالي، ومقارنة مصفوفة التشخيص — لتضييق نطاق البحث طبقة بعد طبقة.
- التمييز بين نوعين من التأخير: التأخير العابر للحدود يُحل عبر إعادة استخدام الاتصال وتحسين المسار، أما تأخير النموذج فيُحل عبر اختيار النموذج المناسب وتبسيط المدخلات.
- الاهتمام المنفصل بأحجام الاستجابات الكبيرة: في أعمال الصور والفيديو، يجب ضبط مهلة زمنية معقولة وإعادة محاولة آمنة (idempotent) واستطلاع غير متزامن (async polling).
- لا حاجة لتمييز base_url حسب المنطقة: الاتصال الخارجي المباشر يذهب إلى مركز البيانات في غرب أمريكا، والداخلية لديها خطوط عودة مسرّعة — إعداد واحد يكفي.
بدلاً من الحكم على “البطء” بناءً على الإحساس، من الأفضل إنفاق بضع دقائق في تشغيل سكربت قياس السرعة ودع البيانات تخبرك أين تكمن عنق الزجاجة. ننصح بالحصول على رصيد تجريبي مجاني عبر APIYI على apiyi.com، وإجراء الاختبار الفعلي في بيئة النشر الخاصة بك، ثم تحديد اختيار النموذج واستراتيجية المهلة الزمنية.
📚 المراجع
- مركز توثيق APIYI: عناوين الوصول وشرح عملية الوصول في ثلاث خطوات
- الرابط:
docs.apiyi.com -
الوصف: يتضمن إعداد وضع التوافق مع OpenAI، والملاحظات المطلوبة لاستدعاء API الصور، وتشخيص انقطاع الاتصال
-
الدليل الرسمي لـ curl: شرح كامل لمتغيرات الإخراج
-w - الرابط:
curl.se/docs/manpage.html -
الوصف: مرجع التعريفات الرسمية لحقول التوقيت مثل
time_namelookupوtime_appconnect -
OpenAI Python SDK: المستودع المفتوح المصدر الرسمي
- الرابط:
github.com/openai/openai-python - الوصف: كيفية استخدام الاستدعاء المتدفق (streaming) ومعاملات المهلة الزمنية وإعادة المحاولة
المؤلف: فريق APIYI التقني
التواصل التقني: إذا واجهت مشاكل أثناء قياس السرعة، نرحب بتواصلك معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد الوصول يمكنك زيارة مركز التوثيق docs.apiyi.com