Note de l’auteur : utiliser curl et le SDK pour chronométrer séparément le DNS, le TLS, le premier token et la durée totale, puis déterminer en 4 étapes si le goulot d’étranglement d’un appel à une API de grand modèle depuis la Chine se situe au niveau du « lien transfrontalier » ou de « l’inférence du modèle ».
« Pourquoi l’API est-elle si lente ? » C’est la phrase qui revient le plus souvent chez les développeurs en Chine lorsqu’ils intègrent une API de grand modèle de langage. Le problème, c’est que « lent » n’est qu’un symptôme de surface : la cause peut être une résolution DNS, une poignée de main TLS transfrontalière, une file d’attente côté modèle, ou tout simplement un modèle qui réfléchit sérieusement. Cet article présente une méthode de diagnostic en 4 étapes qui décompose la durée d’une requête pour identifier précisément l’origine de la lenteur des appels aux API de grands modèles depuis la Chine.
Ce n’est pas un guide mystique du genre « essayez un autre nœud », mais une procédure de diagnostic reproductible, tirée de vraies consultations d’intégration. On nous demande souvent : si le service est déployé sur un serveur aux États-Unis, quelle adresse d’accès faut-il renseigner ? Les accès depuis la Chine vont-ils ralentir à cause du passage transfrontalier ? Les résultats volumineux comme les images et les vidéos peuvent-ils être renvoyés intégralement ? Nous répondrons à chacune de ces questions ci-dessous.
L’essentiel : à la fin de cet article, vous saurez chronométrer par segments avec curl et le SDK Python, distinguer le temps passé sur le réseau de celui de l’inférence du modèle, et choisir le bon base_url selon la zone de déploiement.
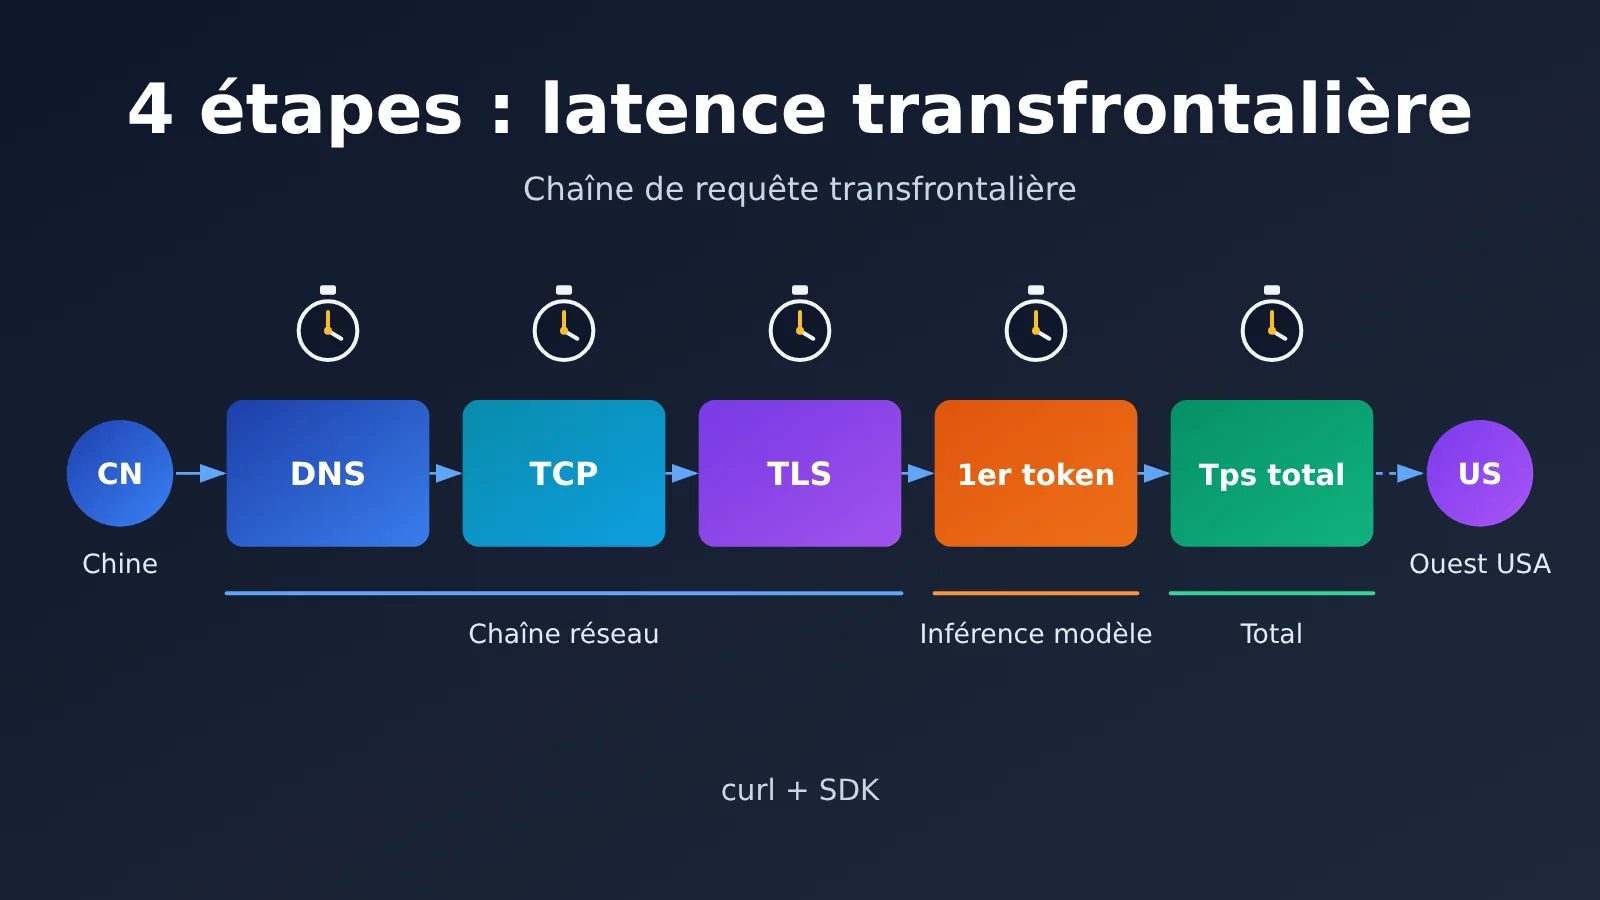
Les points clés de la lenteur des appels aux API de grands modèles de langage depuis la Chine
Avant de commencer à mesurer quoi que ce soit, posons une base : le temps total d’un appel à une API de grand modèle de langage est la somme du « temps réseau » et du « temps modèle ». La latence transfrontalière n’affecte que le premier, alors que la lenteur ressentie par beaucoup de gens vient en réalité majoritairement du second.
| Étape | Ce qu’on mesure | Outil | Question à laquelle on répond |
|---|---|---|---|
| Étape 1 | Temps de DNS, TCP et handshake TLS | paramètre -w de curl |
La liaison transfrontalière est-elle fluide en elle-même |
| Étape 2 | Latence du premier token (TTFT) | appel en streaming via le SDK | Combien de temps avant que le modèle commence à répondre |
| Étape 3 | Durée globale et débit | SDK non-streaming + statistiques sur plusieurs tours | La restitution de sorties longues et de gros volumes de réponse est-elle stable |
| Étape 4 | Diagnostic comparatif | matrice de diagnostic | Le goulot d’étranglement est-il le réseau, le modèle ou le code |
De quoi est faite la latence transfrontalière
Une requête HTTPS partie de votre serveur passe successivement par la résolution DNS, le three-way handshake TCP, le handshake TLS, et seulement ensuite le corps de la requête est envoyé. Dans un contexte transfrontalier, les handshakes TCP et TLS nécessitent plusieurs allers-retours, et le délai d’aller-retour dû à la distance physique se trouve multiplié plusieurs fois : c’est là que naît la « lenteur de connexion ». Bonne nouvelle : la connexion ne s’établit généralement qu’à la première requête, et une fois la connexion réutilisée, ce coût chute fortement.
Une fois la requête arrivée côté serveur, on entre dans la phase d’inférence du modèle. Pour un modèle conversationnel, l’attente avant le premier token dépend de la taille du modèle, de la longueur de l’entrée et de la charge actuelle ; après le premier token, la vitesse de sortie dépend du débit de génération du modèle. Pour la génération d’images et de vidéos, c’est différent : les résultats volumineux sont souvent renvoyés de façon synchrone, et la bande passante ainsi que la stabilité de la liaison retour déterminent directement si le résultat arrive entier ou non.
Comment savoir si c’est le réseau ou le modèle qui est lent
Le principe est simple : lent au stade de l’établissement de connexion → regardez le réseau ; lent sur le premier token → regardez le modèle et l’entrée ; lent et très variable en phase de sortie → regardez la liaison retour et la taille du corps de réponse. Il suffit de mesurer ces trois séries de chiffres pour qualifier la plupart des problèmes de « lenteur » en quelques minutes.
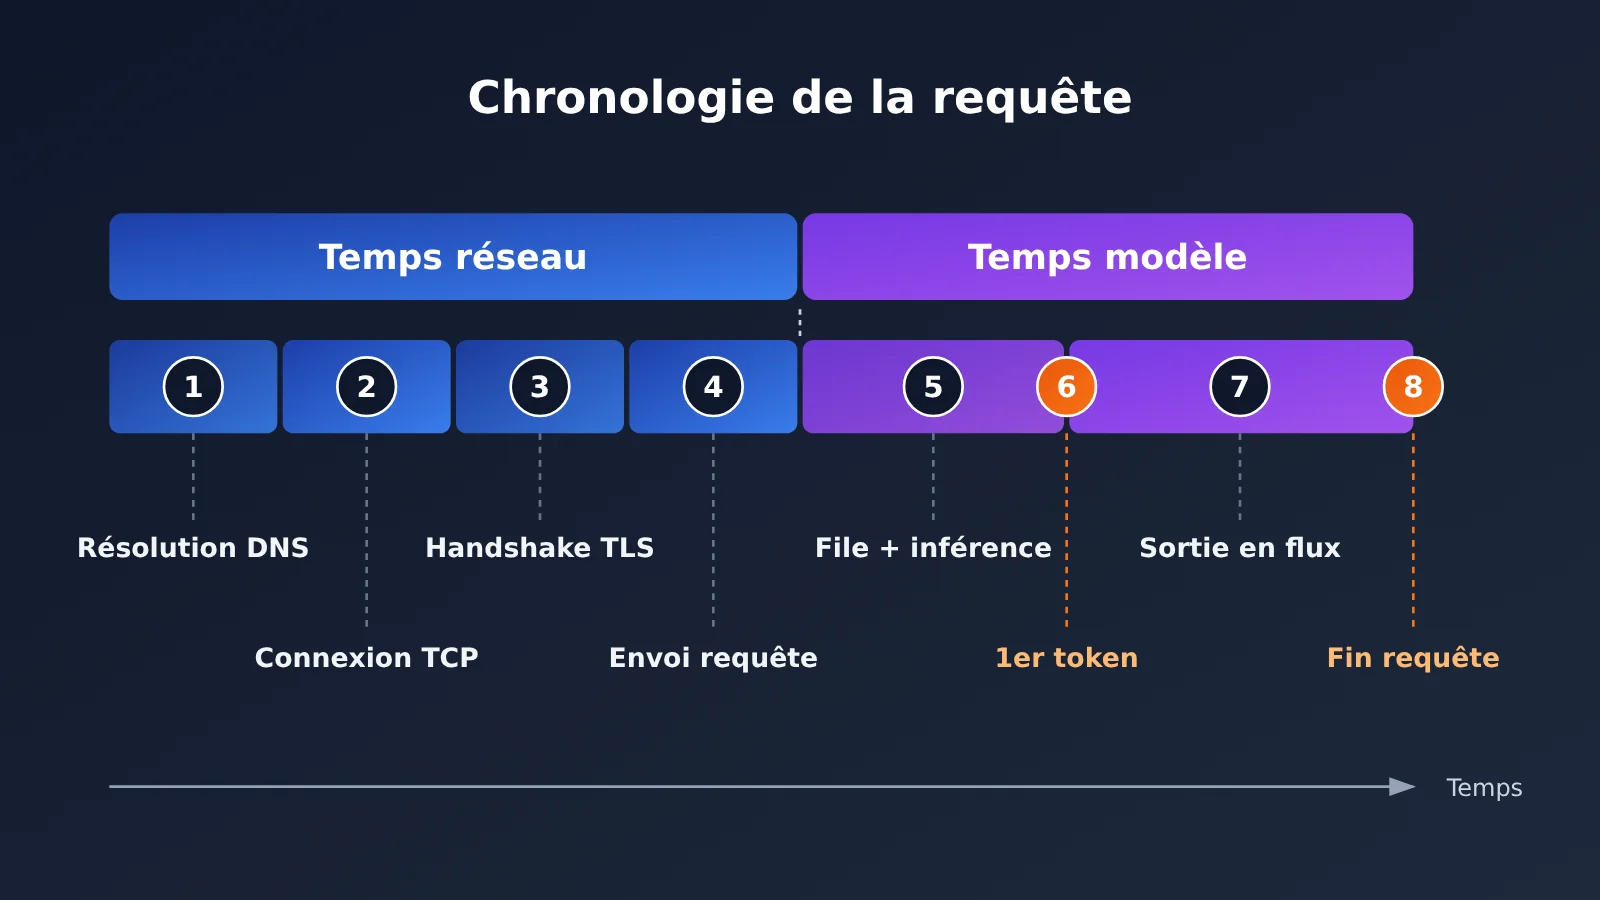
Localiser la latence transfrontalière en 4 étapes : prise en main rapide
Tous les exemples ci-dessous utilisent l’interface compatible OpenAI. Que votre service soit déployé en Chine ou à l’étranger, il suffit de modifier le base_url pour vous connecter — le reste du code ne change pas.
Étape 1 : décomposer le temps d’établissement de la connexion avec curl
Le paramètre -w intégré à curl affiche les temps de chaque phase : c’est l’outil le plus rapide pour diagnostiquer une latence transfrontalière. Je vous conseille d’interroger une route légère comme /v1/models, pour que le temps d’inférence du modèle ne vienne pas parasiter la mesure réseau.
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "Résolution DNS : %{time_namelookup}s\nConnexion TCP :  %{time_connect}s\nHandshake TLS :  %{time_appconnect}s\nPremier octet :  %{time_starttransfer}s\nTemps total :    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
Attention à un point important : chaque valeur affichée par curl est un instant cumulé depuis le début de la requête, et non la durée isolée d’une phase. Voici ce que signifie chaque champ et comment calculer la durée propre à chaque segment :
| Champ curl | Signification | Calcul de la durée du segment | Causes fréquentes d’une valeur élevée |
|---|---|---|---|
time_namelookup |
Résolution DNS terminée | lecture directe | DNS local lent, résolution vers un nœud éloigné |
time_connect |
Connexion TCP établie | connect − namelookup | aller-retour transfrontalier élevé, perte de paquets |
time_appconnect |
Handshake TLS terminé | appconnect − connect | gigue sur le lien, handshake en plusieurs allers-retours |
time_starttransfer |
Premier octet reçu | starttransfer − appconnect | traitement côté serveur, mise en file d’attente |
time_total |
Fin de la requête | total − starttransfer | corps de réponse volumineux, bande passante de retour insuffisante |
Lancez la commande 5 à 10 fois d’affilée et regardez si les valeurs restent stables. Si les durées des segments TCP et TLS varient fortement, la qualité du lien est instable ; si les valeurs sont stables et dans une plage acceptable, le réseau n’est très probablement pas le principal goulot d’étranglement.
Étape 2 : mesurer la latence du premier token avec un appel en streaming via le SDK
Une fois que la connexion tient la route, l’étape suivante consiste à regarder à quelle vitesse le modèle commence à répondre. La latence du premier token (Time To First Token, TTFT) est l’indicateur le plus parlant pour une application conversationnelle : l’utilisateur a les yeux rivés sur l’écran en attendant le premier mot, et chaque seconde paraît interminable.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # utilisable avec un déploiement en Chine comme à l'étranger
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "Présente-toi en une phrase"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"Latence du premier token : {time.perf_counter() - start:.2f}s")
        break
Une fois le TTFT obtenu, soustrayez-en le temps de connexion mesuré à l’étape 1 : le reste correspond en gros au temps de mise en file d’attente et d’inférence du modèle. Si cette part représente l’écrasante majorité du délai, optimiser le réseau apportera peu : mieux vaut envisager un modèle plus rapide, raccourcir le contexte d’entrée ou activer la sortie en streaming.
Étape 3 : statistiques multi-tours sur la latence globale et le retour de réponses volumineuses
Une mesure unique est facilement faussée par des fluctuations ponctuelles. Pour évaluer un environnement de production, mieux vaut faire des statistiques sur plusieurs tours et surveiller la médiane ainsi que la valeur maximale. Le script complet ci-dessous mesure automatiquement les temps DNS, TCP, TLS, le TTFT et la latence globale, puis affiche un récapitulatif des résultats.
Voir le script de mesure complet
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # Adresse d'accès unifiée
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """Mesure segmentée des temps DNS, TCP et TLS"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """Mesure la latence du premier token et le temps total"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "Rédige une présentation produit d'environ 200 mots"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} médiane {statistics.median(values):.3f}s  "
          f"max {max(values):.3f}s  min {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"Tour {i + 1} terminé, {llm['chars']} caractères générés")

    print("\n===== Récapitulatif des mesures =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
Pour les API d’images, il faut prêter attention à un point supplémentaire : la génération d’images est généralement un appel synchrone, et le corps de la réponse final est bien plus volumineux que pour du texte. Si la latence globale dépasse largement le temps du premier octet, ou si des coupures de connexion surviennent de façon ponctuelle, le problème vient souvent du chemin de retour réseau plutôt que d’une génération lente du modèle. Dans ce cas, il convient d’augmenter raisonnablement le délai d’expiration côté client et de prévoir des retentatives idempotentes en cas d’interruption.
Étape 4 : identifier le goulot d’étranglement à l’aide de la matrice de diagnostic
Une fois les données des trois étapes précédentes en main, il suffit de se reporter à la matrice ci-dessous pour, dans la plupart des cas, mettre le doigt sur le problème.
| Symptôme | Goulot d’étranglement le plus probable | Action prioritaire |
|---|---|---|
| Phase DNS nettement trop longue | Résolution DNS locale | Changer pour un service DNS stable, activer le cache de résolution |
| TCP et TLS élevés avec de fortes variations | Qualité de la liaison transfrontalière | Réutiliser les connexions, choisir un service d’accès avec optimisation de ligne |
| Connexion normale mais TTFT très élevé | Inférence du modèle ou entrée trop longue | Passer à un modèle plus rapide, alléger le contexte, activer le streaming |
| TTFT normal mais durée totale longue | Sortie trop longue ou vitesse de génération faible | Limiter max_tokens, découper la tâche |
| Coupures occasionnelles sur image/vidéo | Retour d’une réponse volumineuse instable | Augmenter le timeout, nouvelles tentatives idempotentes, interrogation asynchrone (polling) |
| Lent la première fois, rapide ensuite | Établissement de connexion à froid (cold start) | Utiliser des connexions persistantes, réutiliser le client globalement |
🚀 Pour démarrer vite : si vous voulez lancer tout de suite le script de mesure de vitesse ci-dessus, le plus simple est de commencer par créer un compte sur APIYI (apiyi.com) pour récupérer une clé API. Les nouveaux utilisateurs disposent d’un quota de test gratuit, largement suffisant pour enchaîner plusieurs séries de mesures comparatives, sans avoir à déployer le moindre proxy.
Comment choisir base_url selon la zone de déploiement
Beaucoup de développeurs se posent la question : si l’application est déployée à l’étranger ou en Chine, faut-il renseigner une adresse d’accès différente ? La réponse est non. Les serveurs d’APIYI sont situés dans l’ouest des États-Unis, donc les services hébergés à l’étranger bénéficient naturellement d’un trajet réseau plus court. En parallèle, la plateforme a mis en place une accélération des lignes de retour vers la Chine pour garantir la stabilité du transfert des réponses volumineuses, notamment pour l’image et la vidéo. Bref, quelle que soit la zone de déploiement, il suffit d’utiliser le même base_url.
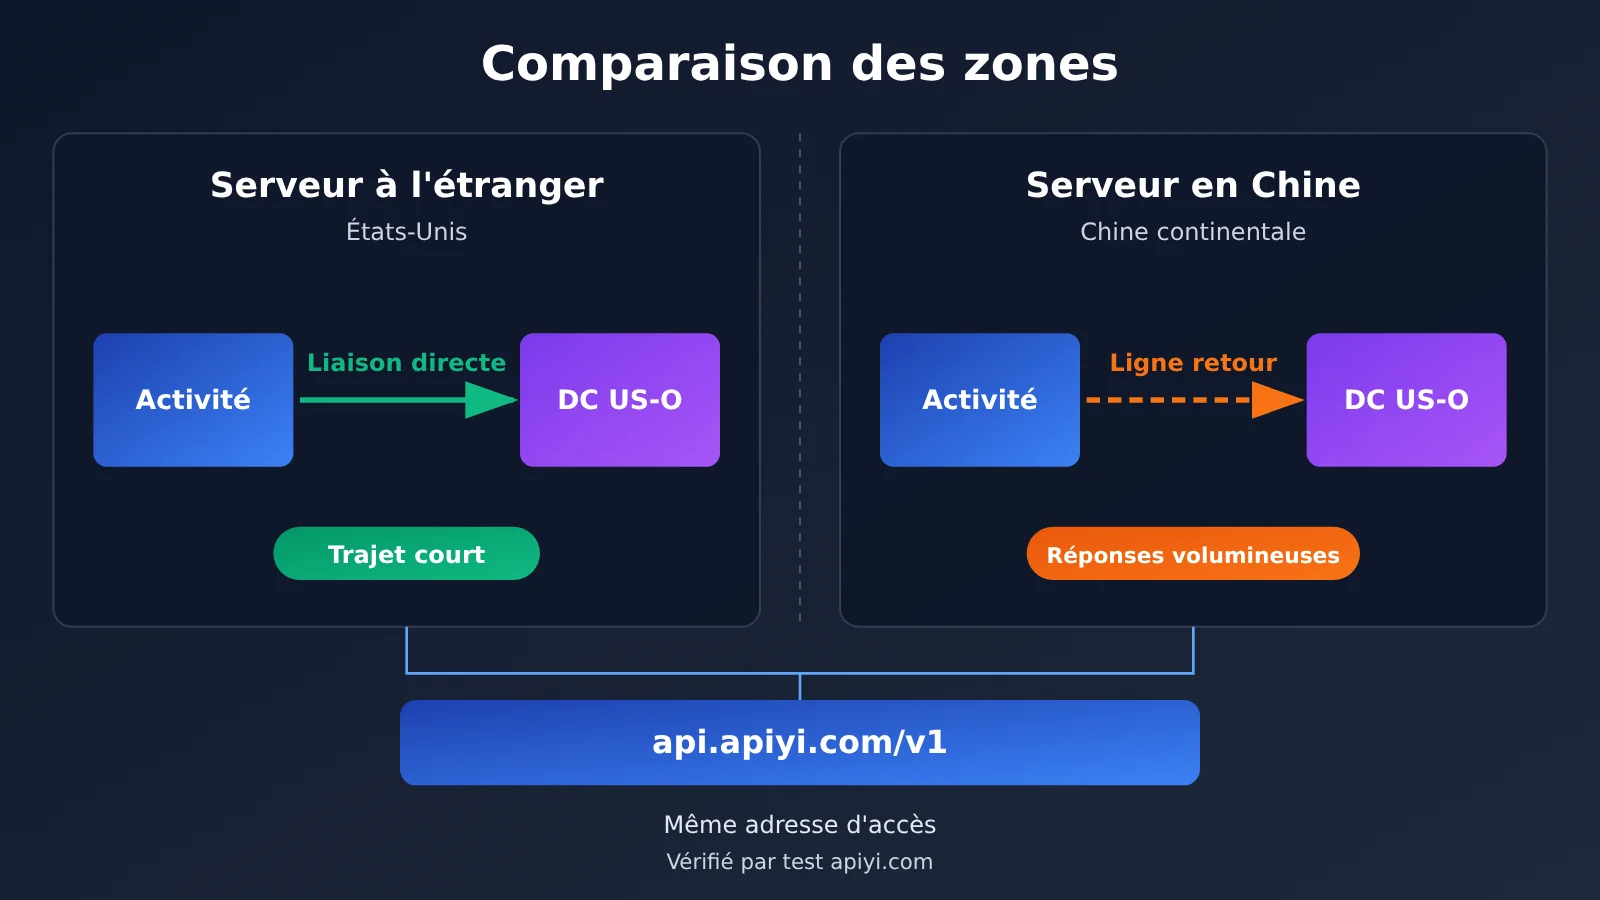
| Emplacement du déploiement | Caractéristiques du trajet | Points à surveiller lors du test de vitesse | Recommandation d’accès |
|---|---|---|---|
| États-Unis / Ouest américain | Même région que le serveur, faible latence aller-retour | Surveiller surtout le TTFT et le temps du modèle | Utiliser directement l’adresse d’accès unifiée |
| Europe / Asie-Pacifique hors Chine | Traversée océanique, mais les liaisons internationales sont généralement stables | Surveiller la poignée de main TLS et la réutilisation des connexions | Adresse unifiée + connexions persistantes |
| Chine continentale | Liaison transfrontalière, avec accélération des lignes de retour | Surveiller la variabilité d’établissement de connexion et le transfert des réponses volumineuses | Adresse unifiée + délais d’attente raisonnables |
| Déploiement hybride | Appels simultanés depuis plusieurs régions | Tester et comparer les vitesses par région | Un seul code, aucune configuration conditionnelle |
L’avantage de cette conception : le même code peut passer sans friction d’un environnement de test (en Chine) à un environnement de production (à l’étranger), sans maintenir plusieurs jeux de configuration. Ce qu’il faut vraiment faire, c’est exécuter les 4 étapes de test de vitesse précédentes dans chaque environnement de déploiement, pour confirmer que les performances réelles correspondent aux attentes métier.
Bonnes pratiques pour les appels transfrontaliers avec réponses volumineuses
Les API d’image et de vidéo sont les plus sensibles aux liaisons transfrontalières. Voici quelques bonnes pratiques à appliquer côté code :
- Réutiliser le client globalement : éviter de rouvrir une connexion à chaque requête ; dans un contexte transfrontalier, cela permet d’économiser beaucoup de temps de poignée de main.
- Adapter le délai d’attente au type de tâche : une conversation texte peut avoir un délai court ; la génération d’images et la récupération de résultats vidéo doivent disposer d’une marge suffisante.
- Faire des retries idempotents en cas d’interruption : utiliser un backoff exponentiel pour éviter de soumettre à nouveau une tâche de génération en peu de temps.
- Utiliser une interrogation asynchrone pour les tâches vidéo : après la soumission, interroger périodiquement l’état, puis télécharger le résultat une fois prêt, afin de réduire le risque d’interruption de connexion longue.
- Journaliser les temps par segment : enregistrer le TTFT et le temps total dans la supervision, pour pouvoir remonter rapidement à la cause en cas de problème.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que la latence transfrontalière et en quoi diffère-t-elle de la latence d’inférence du modèle ?
La latence transfrontalière correspond au temps réseau nécessaire pour que la requête circule entre les serveurs nationaux et ceux situés à l’étranger. Elle se manifeste surtout lors de l’établissement des connexions TCP et TLS, ainsi que pendant le retour des données. La latence d’inférence du modèle, elle, désigne le temps que le serveur met à générer le contenu : elle se traduit par l’attente du premier token et par la vitesse de sortie. Il faut mesurer ces deux aspects séparément pour identifier la bonne piste d’optimisation.
Q2 : Mon service est hébergé sur un serveur américain, quelle adresse dois-je utiliser pour appeler APIYI ?
Utilisez simplement `https://api.apiyi.com/v1`. Les serveurs d’APIYI sont situés dans l’ouest des États-Unis, et un service déployé aux États-Unis bénéficie donc d’un chemin d’accès très court, sans configuration supplémentaire. Pour les étapes d’intégration détaillées, reportez-vous à la section Démarrage rapide du centre de documentation d’APIYI apiyi.com : trois étapes suffisent.
Q3 : Le serveur est dans l’ouest des États-Unis, pourquoi l’accès depuis la Chine reste-t-il fluide ?
Parce que la plateforme a mis en place une accélération des routes de retour vers la Chine, principalement pour garantir la stabilité du retour des réponses volumineuses comme les images et les vidéos. Vous pouvez le vérifier vous-même avec la commande curl de l’étape 1 de cet article, depuis un serveur en Chine, en observant les temps et la variabilité des phases TCP et TLS.
Q4 : Le délai avant le premier token est très élevé, est-ce un problème réseau ?
Pas forcément. Commencez par regarder le temps d’établissement de connexion mesuré avec curl. Si la connexion est normale, un TTFT élevé est généralement dû à un modèle volumineux, à un contexte d’entrée trop long ou à une inférence plus complexe. Dans ce cas, essayez un modèle plus léger, allégez l’invite, ou activez la sortie en streaming pour améliorer le ressenti utilisateur.
Q5 : Comment comparer rapidement la vitesse de réponse de différents modèles ?
Je recommande d’utiliser une interface agrégée supportant plusieurs modèles :
1. Créez un compte sur APIYI apiyi.com et récupérez votre clé API
2. Utilisez le script de test complet de cet article, en ne modifiant que la variable `MODEL`
3. Faites tourner le même nombre d’itérations pour chaque modèle, puis comparez la médiane du TTFT et du temps total
Comme une seule clé permet d’appeler OpenAI, Claude, Gemini et bien d’autres modèles, les conditions réseau restent identiques lors de la comparaison, ce qui rend les conclusions plus fiables.
Q6 : L’API d’images subit parfois des coupures de connexion, comment diagnostiquer ?
L’interface d’images fonctionne en appel synchrone avec un corps de réponse volumineux ; les coupures surviennent le plus souvent lors du retour du résultat. Je conseille d’augmenter d’abord le timeout côté client, puis d’observer l’écart entre `time_total` et `time_starttransfer` dans curl. Si cet écart est important et instable, c’est que le lien de retour constitue le goulot d’étranglement : ajoutez alors des nouvelles tentatives idempotentes et évitez les soumissions en lot aux heures de pointe.
Q7 : Quelles sont les limites de cette méthode de test de vitesse ?
Les résultats ne reflètent l’état du réseau qu’à l’instant et à l’emplacement de la mesure ; selon l’opérateur et le moment de la journée, les écarts peuvent être marqués. De plus, la charge des modèles varie dans le temps, et un TTFT isolé ne représente pas la performance sur la durée. Je recommande d’enregistrer les temps par phase sur le long terme en production, et de décider sur la base des tendances plutôt que de mesures ponctuelles.
Points clés pour tester la vitesse des API de grands modèles de langage en Chine — À retenir
- Décomposer avant d’optimiser : le temps total = temps réseau + temps du modèle. Il faut impérativement mesurer par segments.
- curl pour la connexion : utilisez le paramètre
-wpour récupérer les points de temps cumulés DNS, TCP et TLS. - SDK pour le TTFT : en appel streaming, enregistrez le temps du premier token pour évaluer la vitesse de réponse du modèle.
- Médiane sur plusieurs tours : un résultat unique est trop sensible aux fluctuations ; comptez au moins 5 tours.
- Gros corps de réponse : regardez le retour : pour les images et vidéos, surveillez l’écart entre le temps total et le premier octet.
- Une adresse d’accès unifiée : passez par APIYI apiyi.com pour partager le même
base_urlentre la Chine et l’étranger.
Résumé
Les points essentiels pour diagnostiquer une API de grand modèle de langage lente en Chine :
- Méthode de localisation en 4 étapes : test de connexion, test du premier token, statistiques de temps total, comparaison matricielle de diagnostic — pour réduire progressivement le périmètre.
- Distinguer deux types de latence : la latence transfrontalière se règle par la réutilisation de connexions et l’optimisation des lignes ; la latence du modèle, par le choix du modèle et la simplification des entrées.
- Traiter les gros corps de réponse à part : pour les activités image et vidéo, configurez des timeouts raisonnables, des retentatives idempotentes et du polling asynchrone.
- Pas besoin de différencier le
base_urlpar région : connexion directe aux centres de données de l’ouest des États-Unis depuis l’étranger, lignes de retour accélérées pour la Chine — une seule configuration suffit.
Plutôt que de juger « c’est lent » au ressenti, prenez quelques minutes pour lancer un script de test de vitesse : les données vous diront où se trouve le goulot d’étranglement. Je vous recommande d’obtenir un quota de test gratuit via APIYI apiyi.com, de faire vos propres mesures dans votre environnement de déploiement, puis de décider du choix du modèle et de la stratégie de timeout.
📚 Ressources
- Centre de documentation APIYI : adresse d’accès et procédure d’intégration en trois étapes
- Lien :
docs.apiyi.com -
Description : configuration en mode compatible OpenAI, bonnes pratiques pour l’appel de l’API d’images et dépannage des connexions interrompues
-
Manuel officiel de curl : description complète des variables de sortie
-w - Lien :
curl.se/docs/manpage.html -
Description : définition de référence des champs de chronométrage tels que
time_namelookupettime_appconnect -
OpenAI Python SDK : dépôt open source officiel
- Lien :
github.com/openai/openai-python - Description : utilisation des appels en streaming, des paramètres de timeout et de nouvelle tentative
Auteur : équipe technique APIYI
Échanges techniques : si vous rencontrez des difficultés lors du test de vitesse, n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com