Nota do autor: use curl e o SDK para cronometrar e decompor DNS, TLS, primeiro token e tempo total; em 4 passos, descubra se o gargalo ao chamar APIs de Modelos de Linguagem Grande a partir da China está no “link transfronteiriço” ou na “inferência do modelo”.
“Por que a API está tão lenta?” Essa é uma das frases mais comuns entre desenvolvedores na China que integram APIs de Modelos de Linguagem Grande. O problema é que “lento” é só a superfície: a lentidão pode vir da resolução de DNS, do handshake TLS transfronteiriço, da fila do modelo ou simplesmente do modelo pensando com calma. Este artigo apresenta um método de diagnóstico de velocidade em 4 passos para decompor o tempo de uma requisição e identificar com precisão a raiz da lentidão ao chamar APIs de Modelos de Linguagem Grande a partir da China.
Não é um guia místico do tipo “troque de nó e veja no que dá”, mas um fluxo reproduzível de diagnóstico baseado em casos reais de integração. É comum recebermos perguntas como: se o negócio está implantado em servidores nos EUA, como preencher o endereço de acesso? O acesso a partir da China vai travar por causa da rota transfronteiriça? Resultados grandes, como imagens e vídeos, conseguem ser retornados por completo? O texto responde a cada uma dessas questões.
Valor central: ao terminar a leitura, você vai saber usar curl e o SDK Python para cronometrar por etapas, diferenciar o tempo gasto na rede e na inferência do modelo e escolher o base_url correto de acordo com a região de implantação.
Pontos centrais sobre a lentidão ao chamar APIs de Modelos de Linguagem Grande no mercado doméstico
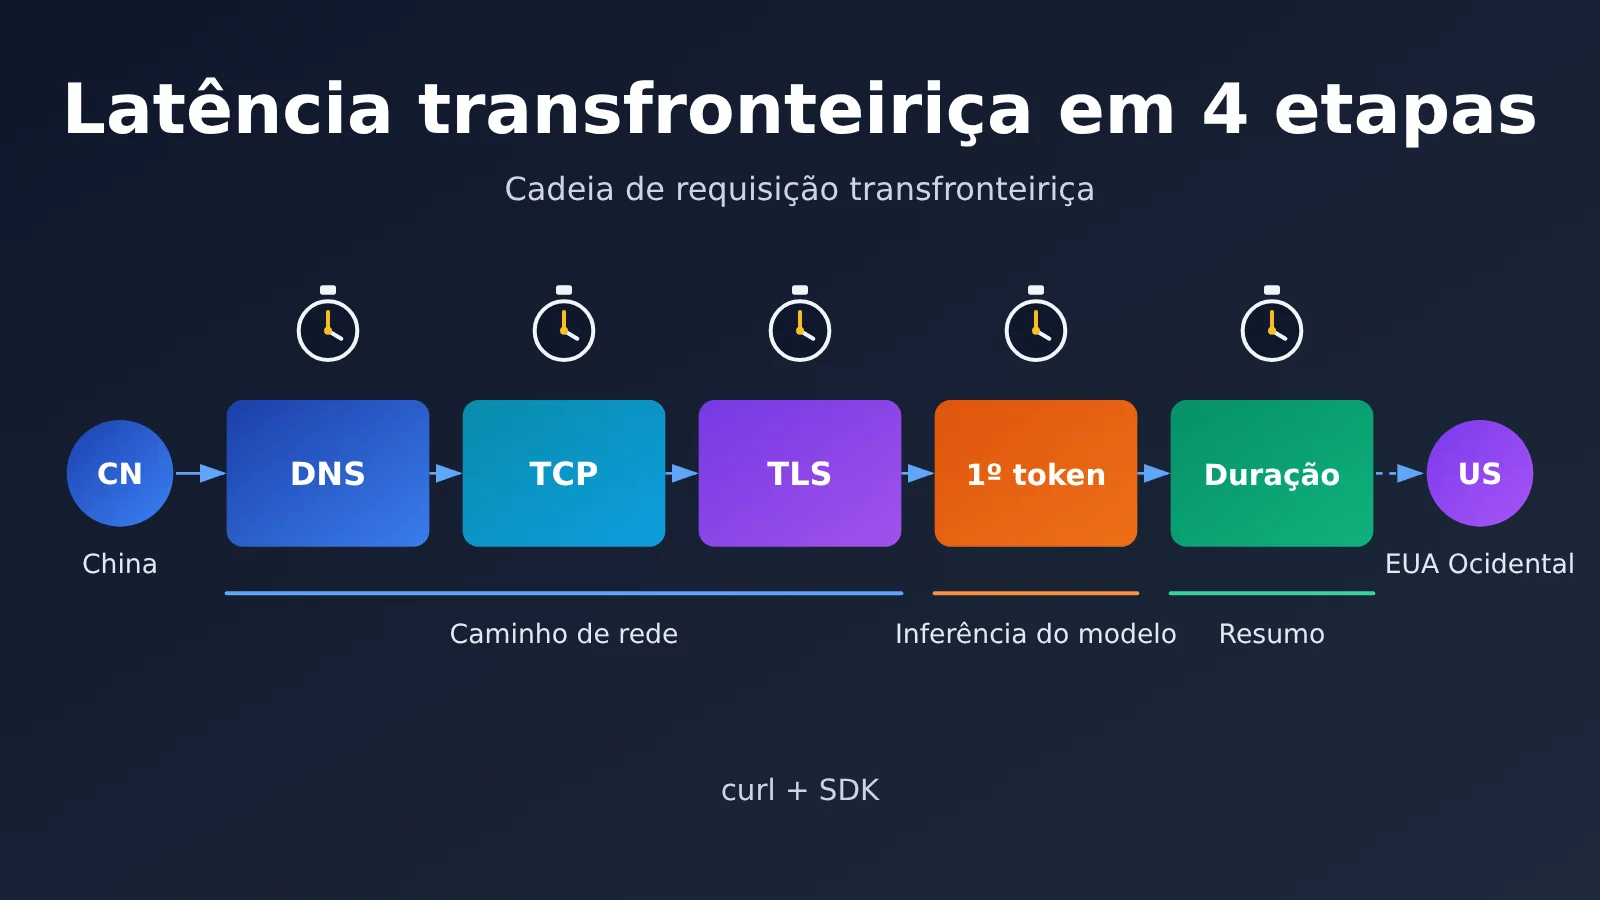
Antes de começar os testes de velocidade, vale estabelecer uma noção básica: o tempo total de uma chamada à API de um Modelo de Linguagem Grande é a soma do “tempo de rede” com o “tempo do modelo”. A latência transfronteiriça afeta apenas o primeiro; e a “lentidão” que muita gente sente vem, na maior parte, do segundo.
| Etapa | O que medir | Ferramenta | Pergunta que responde |
|---|---|---|---|
| Etapa 1 | Tempo de DNS, TCP e estabelecimento de TLS | parâmetro -w do curl |
O link transfronteiriço está fluindo bem? |
| Etapa 2 | Latência do primeiro token (TTFT) | chamada em streaming via SDK | Quanto tempo o modelo leva para começar a responder? |
| Etapa 3 | Tempo total e throughput | SDK sem streaming + estatísticas de múltiplas rodadas | Saídas longas e corpos de resposta grandes voltam de forma estável? |
| Etapa 4 | Diagnóstico comparativo | matriz de diagnóstico | O gargalo está na rede, no modelo ou no código? |
De que partes é feita a latência transfronteiriça
Uma requisição HTTPS sai do seu servidor e passa, em ordem, por resolução DNS, handshake TCP de três vias, handshake TLS, e só então envia o corpo da requisição. Em cenários transfronteiriços, tanto o TCP quanto o TLS exigem vários round-trips, e o atraso de ida e volta causado pela distância física é multiplicado várias vezes — é daí que vem a sensação de “conexão lenta”. A boa notícia é que o estabelecimento de conexão normalmente só acontece na primeira requisição; ao reutilizar a conexão, esse custo cai bastante.
Depois que a requisição chega ao servidor, começa a fase de inferência do modelo. Para modelos de conversa, a espera até o primeiro token depende do tamanho do modelo, do comprimento da entrada e da carga atual; depois do primeiro token, a velocidade de saída depende da taxa de geração do modelo. Já a geração de imagens e vídeos é diferente: muitas vezes o resultado volumoso é retornado de forma síncrona, e a largura de banda e a estabilidade do link de retorno afetam diretamente se o resultado chega completo.
Princípio para saber se a lentidão é da rede ou do modelo
O princípio é bem simples: se a lentidão aparece no estabelecimento de conexão, olhe para a rede; se está no primeiro token, olhe para o modelo e a entrada; se está na fase de saída e varia muito, olhe para o link de retorno e o tamanho do corpo da resposta. Basta medir esses três conjuntos de números e a maioria dos problemas de “lentidão” pode ser diagnosticada em poucos minutos.
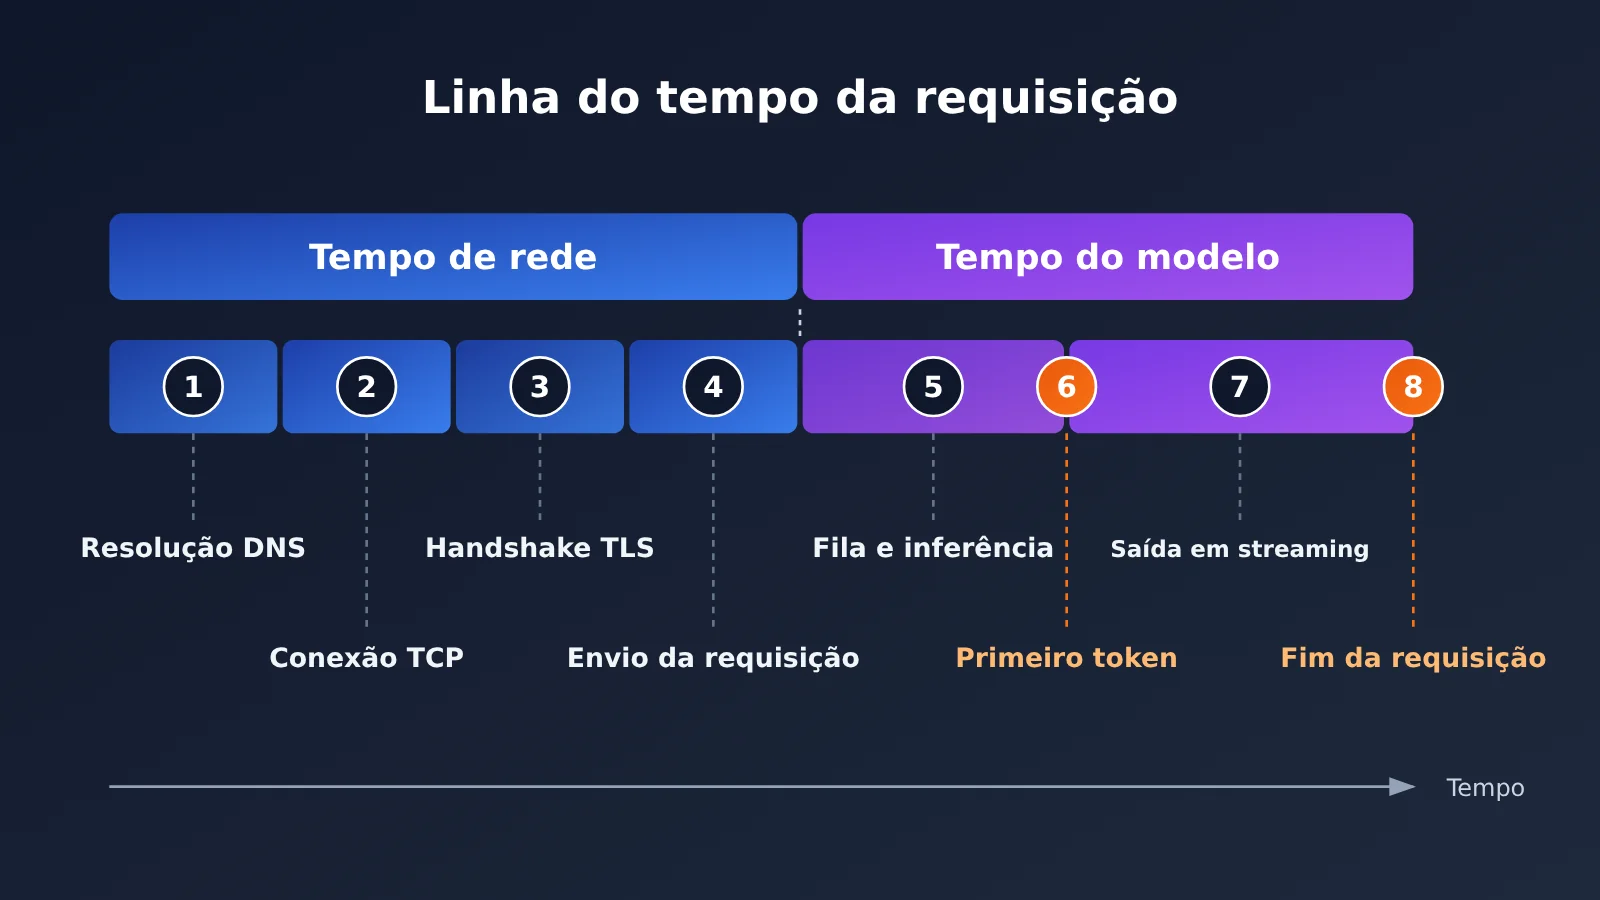
Teste de velocidade em 4 passos para diagnosticar latência transfronteiriça
Os exemplos abaixo usam a interface compatível com OpenAI. Não importa se o seu serviço está hospedado no Brasil ou no exterior, basta alterar o base_url para conectar, mantendo o restante do código inalterado.
Passo 1: usar curl para desmembrar o tempo de conexão do link transfronteiriço
O parâmetro -w nativo do curl permite exibir o tempo de cada fase, sendo a ferramenta mais rápida para investigar latência transfronteiriça. Recomendo requisitar endpoints leves como /v1/models, evitando que o tempo de inferência do modelo interfira na medição de rede.
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS解析:   %{time_namelookup}s\nTCP连接:   %{time_connect}s\nTLS握手:   %{time_appconnect}s\n首字节:    %{time_starttransfer}s\n总耗时:    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
Atenção especial: cada valor exibido pelo curl é um ponto no tempo acumulado desde o início da requisição, e não o tempo individual de cada fase. O significado dos campos e a forma de cálculo são os seguintes:
| Campo do curl | Significado | Cálculo do tempo da fase | Causas comuns quando elevado |
|---|---|---|---|
time_namelookup |
Resolução DNS concluída | Leitura direta | DNS local lento, resolução para nó distante |
time_connect |
Conexão TCP estabelecida | connect − namelookup | Alto RTT transfronteiriço, perda de pacotes |
time_appconnect |
Handshake TLS concluído | appconnect − connect | Instabilidade do link, múltiplos round-trips no handshake |
time_starttransfer |
Primeiro byte recebido | starttransfer − appconnect | Processamento no servidor, fila |
time_total |
Fim da requisição | total − starttransfer | Corpo de resposta grande, largura de banda de retorno insuficiente |
Recomendo executar de 5 a 10 vezes consecutivas e observar se os valores são estáveis. Se os tempos das fases TCP e TLS oscilarem muito, isso indica que a qualidade do link é instável; se os valores forem estáveis e estiverem dentro de uma faixa aceitável, provavelmente a rede não é o principal gargalo.
Etapa 2: medir a latência do primeiro token com chamadas em streaming via SDK
A conexão está funcionando. Agora o próximo passo é ver a velocidade com que o modelo começa a responder. A latência do primeiro token (Time To First Token, TTFT) é a métrica mais perceptível em aplicações de conversação — o usuário fica encarando a tela esperando o primeiro caractere aparecer, e cada segundo parece uma eternidade.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # pode ser usado em implantações na China ou no exterior
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "Apresente-se em uma frase"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"Latência do primeiro token: {time.perf_counter() - start:.2f}s")
        break
Depois de obter o TTFT, subtraia o tempo de estabelecimento de conexão da etapa 1. O restante é basicamente o tempo de fila e de inferência do modelo. Se essa parte representar a grande maioria, otimizar a rede traz pouco ganho; vale mais a pena considerar um modelo mais rápido, encurtar o contexto de entrada ou ativar a saída em streaming.
Passo 3: medir o tempo total e o retorno de respostas grandes em múltiplas rodadas
Uma única medição acaba sendo afetada por variações pontuais. Para avaliar em produção, o ideal é fazer estatísticas de várias rodadas e observar a mediana e o valor máximo. O script completo abaixo mede automaticamente DNS, TCP, TLS, TTFT e o tempo total, e exibe um resumo dos resultados.
Ver o script completo de medição
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # Endereço de acesso unificado
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """Mede DNS, TCP e TLS em etapas"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """Mede a latência do primeiro token e o tempo total"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "Escreva uma apresentação de produto com cerca de 200 caracteres"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} mediana {statistics.median(values):.3f}s  "
          f"máx. {max(values):.3f}s  mín. {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"Rodada {i + 1} concluída, {llm['chars']} caracteres gerados")

    print("\n===== Resumo da medição =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
Para endpoints de imagem, há um ponto extra de atenção: a geração de imagens normalmente é uma chamada síncrona e o corpo da resposta final é muito maior do que no caso de texto. Se o tempo total for bem maior que o tempo até o primeiro byte, ou se houver quedas de conexão ocasionais, o problema costuma estar no caminho de volta da rede, e não na lentidão da geração do modelo. Nessa situação, vale aumentar um pouco o timeout do cliente e fazer novas tentativas idempotentes em caso de interrupção.
Etapa 4: use a matriz de diagnóstico para identificar o gargalo
Com os dados das três etapas anteriores em mãos, basta usar a matriz abaixo para encontrar o cenário que corresponde ao seu caso — assim você consegue, na maioria das vezes, localizar o problema.
| Sintoma | Gargalo mais provável | Ação prioritária |
|---|---|---|
| Tempo na etapa de DNS claramente alto | Resolução DNS local | Trocar por um serviço de DNS estável e ativar cache de resolução |
| TCP e TLS altos e com muita oscilação | Qualidade do link transfronteiriço | Reutilizar conexões e escolher um serviço de acesso com otimização de rota |
| Conexão estabelecida normalmente, mas TTFT muito alto | Inferência do modelo ou entrada muito longa | Usar um modelo mais rápido, enxugar o contexto e ativar streaming |
| TTFT normal, mas tempo total alto | Saída muito longa ou taxa de geração baixa | Limitar max_tokens e dividir a tarefa |
| Interrupções ocasionais em imagens e vídeos | Retorno instável de respostas grandes | Aumentar o timeout, fazer retentativas idempotentes e usar polling assíncrono |
| Primeira chamada lenta, seguintes rápidas | Estabelecimento de conexão com cold start | Usar conexões persistentes e reutilizar o client globalmente |
🚀 Comece rápido: se quiser rodar o script de teste de velocidade acima agora mesmo, recomendamos primeiro se registrar na APIYI apiyi.com para obter uma chave API. Novos usuários ganham uma cota gratuita para testes, suficiente para várias rodadas de comparação de velocidade — sem precisar implantar nenhum proxy adicional.
Como escolher a base_url para diferentes regiões de implantação
Muitos desenvolvedores ficam na dúvida: se o negócio está implantado no exterior ou na China, é preciso preencher endereços de acesso diferentes? A resposta é não. Os servidores da APIYI ficam na costa oeste dos Estados Unidos, então serviços no exterior já têm um caminho naturalmente mais curto até eles. Além disso, a plataforma oferece aceleração de rota de retorno para a China continental, com foco em manter estável o retorno de respostas grandes, como imagens e vídeos. Por isso, independentemente de onde o serviço está implantado, basta usar o mesmo base_url.
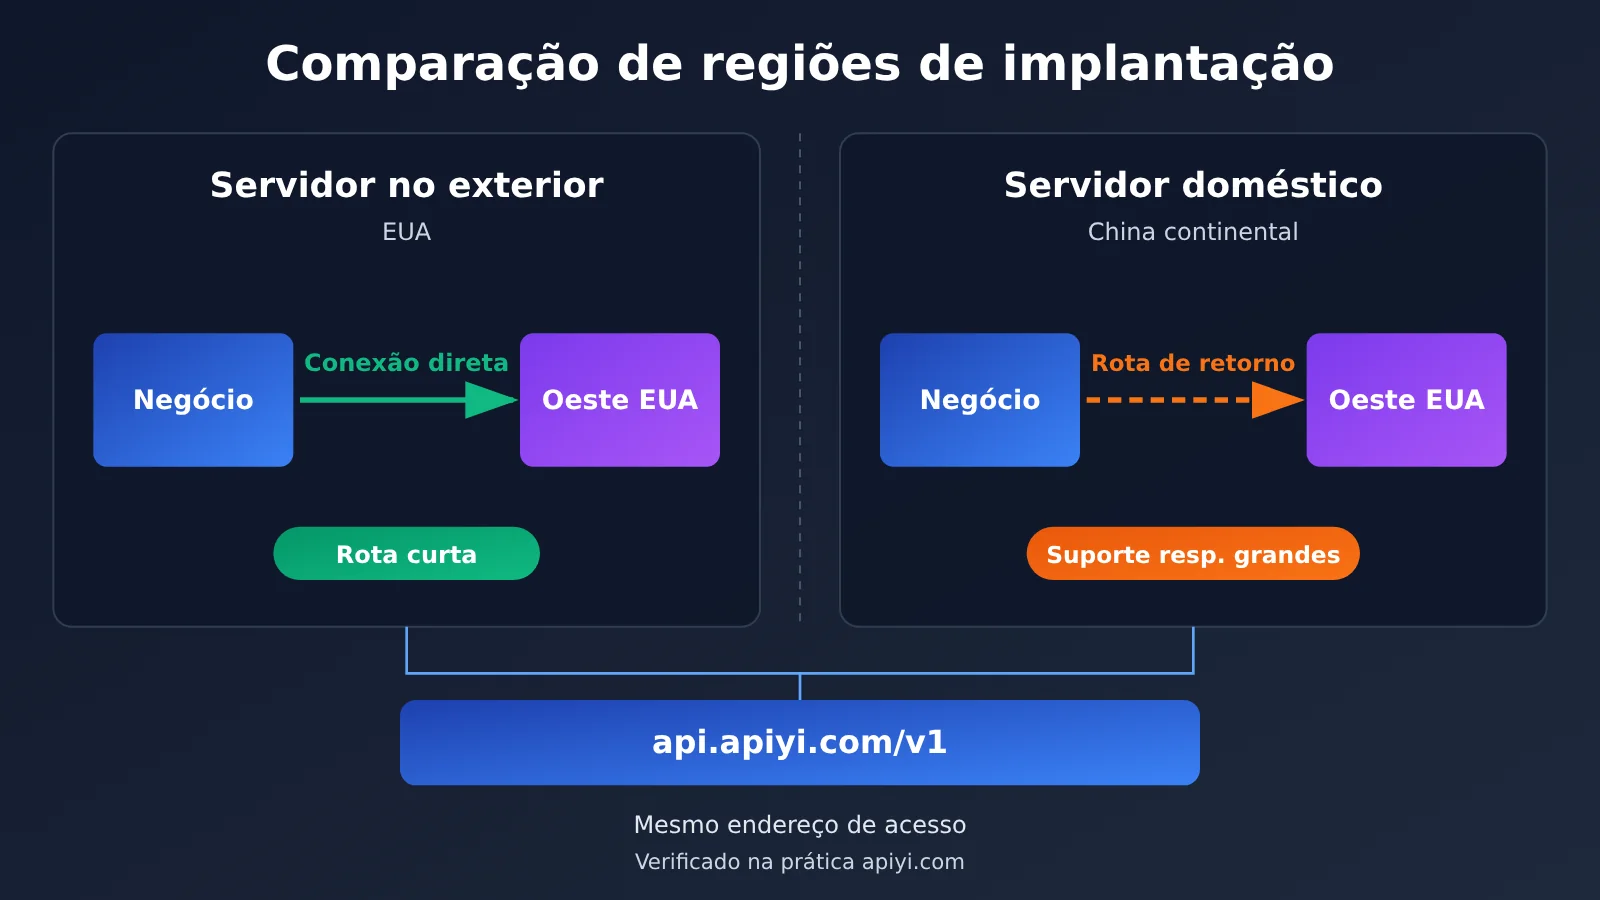
| Local de implantação | Características do link | Foco do teste de velocidade | Recomendação de acesso |
|---|---|---|---|
| EUA / Costa Oeste dos EUA | Mesma região do servidor, baixa latência de ida e volta | Foco em TTFT e no tempo do modelo | Use diretamente o endereço de acesso unificado |
| Europa / Ásia-Pacífico (exterior) | Link transoceânico, mas normalmente estável | Atenção ao handshake TLS e à reutilização de conexão | Endereço unificado + conexão persistente |
| China continental | Link transfronteiriço, com aceleração de rota de retorno para a China | Atenção à variação no estabelecimento de conexão e ao retorno de respostas grandes | Endereço unificado + timeouts adequados |
| Implantação híbrida | Chamadas simultâneas de várias regiões | Testar e comparar a velocidade por região | Mesmo código, sem configuração por região |
A vantagem dessa abordagem é que o mesmo código pode migrar sem atrito entre o ambiente de teste (na China) e o de produção (no exterior), sem manter várias configurações. O que realmente importa é executar as 4 etapas de teste de velocidade anteriores em cada ambiente de implantação e confirmar se o desempenho real atende às expectativas do negócio.
Recomendações de otimização para chamadas transfronteiriças com respostas grandes
As interfaces de imagem e vídeo são as mais sensíveis a links transfronteiriços. Recomendamos cuidar dos seguintes pontos no código:
- Reutilize o client globalmente: evite reabrir conexão a cada requisição; em cenários transfronteiriços, isso economiza muito tempo de handshake.
- Defina timeouts conforme o tipo de negócio: conversas de texto podem ter timeouts mais curtos; geração de imagens e busca de resultados de vídeo devem ter margem suficiente.
- Faça retentativas idempotentes em caso de interrupção: use backoff exponencial para evitar reenviar tarefas de geração em um curto intervalo.
- Use polling assíncrono para tarefas de vídeo: depois de enviar a tarefa, consulte o status periodicamente e baixe o resultado quando estiver pronto, reduzindo o risco de interrupção de conexões persistentes.
- Registre logs de tempo por etapa: inclua o TTFT e o tempo total no monitoramento, para conseguir rastrear problemas rapidamente.
Perguntas Frequentes (FAQ)
Q1: O que é latência transfronteiriça e como ela difere da latência de inferência do modelo?
A latência transfronteiriça é o tempo de rede gasto no tráfego entre servidores domésticos e no exterior, manifestando-se principalmente nas etapas de estabelecimento de conexão TCP, TLS e no retorno de dados. Já a latência de inferência do modelo é o tempo que o servidor leva para gerar conteúdo, refletido na espera pelo primeiro token e na velocidade de saída. É preciso medir as duas separadamente para identificar corretamente a direção da otimização.
Q2: Meu negócio está implantado em servidores nos EUA; qual endereço devo usar para chamar a APIYI?
Basta usar diretamente `https://api.apiyi.com/v1`. Os servidores da APIYI ficam no Oeste dos EUA, e o caminho de acesso para negócios implantados nos EUA é bem curto, sem necessidade de configuração extra. Para os passos detalhados de integração, consulte o guia de início rápido no centro de documentação da APIYI em apiyi.com — em três passos você conclui tudo.
Q3: O servidor está no Oeste dos EUA; por que o acesso doméstico também é fluido?
Porque a plataforma implementou aceleração de linhas de retorno doméstico para acessos vindos do país, voltada principalmente a garantir a estabilidade no retorno de negócios com grandes corpos de resposta, como imagens e vídeos. Você pode usar o comando curl do Passo 1 deste artigo para testar em tempo real no seu servidor doméstico e observar o tempo e a variação nas etapas TCP e TLS.
Q4: A latência do primeiro token está alta; isso indica problema de rede?
Não necessariamente. Primeiro verifique o tempo de estabelecimento de conexão medido pelo curl; se o estabelecimento estiver normal, um TTFT alto costuma ser causado por um modelo maior, contexto de entrada longo demais ou inferência mais complexa. Nesse caso, tente trocar por um modelo mais leve, simplificar os comandos ou ativar a saída em streaming para melhorar a percepção do usuário.
Q5: Como comparar rapidamente a velocidade de resposta de diferentes modelos?
Recomendo usar uma interface agregada com suporte a múltiplos modelos para os testes:
1. Cadastre-se na APIYI em apiyi.com e obtenha uma chave API
2. Use o script completo de teste de velocidade deste artigo, alterando apenas a variável `MODEL`
3. Execute o mesmo número de rodadas para cada modelo e compare a mediana do TTFT e do tempo total
Como uma única chave já permite chamar modelos como OpenAI, Claude e Gemini, as condições de rede permanecem consistentes durante a comparação, tornando as conclusões mais confiáveis.
Q6: A API de imagens às vezes sofre interrupções de conexão; como investigar?
A interface de imagens é uma chamada síncrona, com corpo de resposta grande, e as interrupções costumam ocorrer na fase de retorno do resultado. Recomendo primeiro aumentar o timeout do cliente e depois observar a diferença entre `time_total` e `time_starttransfer` no curl. Se a diferença for grande e instável, isso indica que o link de retorno é o gargalo; nesse caso, adicione retentativas idempotentes e evite enviar lotes em horários de pico.
Q7: Quais são as limitações desse método de teste de velocidade?
Os resultados refletem apenas o estado da rede no momento e no local da medição; podem variar bastante entre operadoras e horários. Além disso, a carga do modelo muda com o tempo, e um único TTFT não representa o desempenho de longo prazo. Recomendo registrar continuamente os tempos por segmento no ambiente de produção e tomar decisões com base em tendências, não em dados pontuais.
Pontos-chave: teste de velocidade ao chamar APIs de Modelos de Linguagem Grande no país (Key Takeaways)
- Primeiro dividir, depois otimizar: o tempo total é igual ao tempo de rede mais o tempo do modelo, então é preciso medir por etapas.
- curl para medir a conexão: use o parâmetro
-wpara obter os tempos acumulados de DNS, TCP e TLS. - SDK para medir o TTFT: em chamadas de streaming, registre o tempo até o primeiro token para avaliar a velocidade de resposta do modelo.
- Várias rodadas: olhe a mediana: um único resultado é facilmente afetado por oscilações, então colete estatísticas de pelo menos 5 rodadas.
- Respostas grandes: olhe o caminho de volta: para imagens e vídeos, observe a diferença entre o tempo total e o tempo até o primeiro byte.
- Endereço de acesso unificado: integre via APIYI apiyi.com; dentro e fora do país usa-se o mesmo base_url.
Resumo
Pontos-chave para diagnosticar lentidão ao chamar APIs de Modelos de Linguagem Grande no país:
- Método de localização em 4 etapas: teste de velocidade de conexão, teste de velocidade do primeiro token, estatística do tempo total e comparação com a matriz de diagnóstico, reduzindo o escopo camada por camada.
- Diferencie dois tipos de latência: a latência transfronteiriça é resolvida com reutilização de conexões e otimização de rotas; a latência do modelo é resolvida com escolha de modelos e enxugamento da entrada.
- Atenção especial a respostas grandes: serviços de imagem e vídeo precisam de timeouts razoáveis, retentativas idempotentes e polling assíncrono.
- base_url não precisa variar por região: do exterior, conexão direta ao data center no oeste dos EUA; no país, há aceleração por rotas de retorno. Uma única configuração basta.
Em vez de julgar “lento” por pura sensação, vale a pena gastar alguns minutos rodando um script de teste de velocidade e deixar os dados mostrarem onde está o gargalo. Recomendamos obter créditos de teste gratuitos via APIYI apiyi.com, fazer o teste real no seu próprio ambiente de implantação e só então decidir a escolha do modelo e a estratégia de timeout.
📚 Referências
- Central de documentação da APIYI: endereço de acesso e instruções do fluxo de integração em três etapas
- Link:
docs.apiyi.com -
Descrição: inclui configuração do modo compatível com OpenAI, orientações para chamadas da API de imagens e diagnóstico de interrupções de conexão
-
Manual oficial do curl: explicação completa das variáveis de write-out do
-w - Link:
curl.se/docs/manpage.html -
Descrição: consulte a definição oficial de campos de tempo como
time_namelookupetime_appconnect -
SDK Python da OpenAI: repositório oficial de código aberto
- Link:
github.com/openai/openai-python - Descrição: como usar chamadas em streaming, timeouts e parâmetros de retry
Autor: Equipe técnica da APIYI
Contato técnico: se tiver problemas durante o teste de velocidade, fale com a gente pela página inicial do site da APIYI. Você encontra mais materiais de integração no centro de documentação docs.apiyi.com