Résumé : cet article compare les budgets de sortie, les valeurs par défaut du raisonnement et le mode de facturation de Qwen4-Max-Preview avec ceux de la version officielle Qwen4-Max. Il fournit aussi une liste de vérifications à exécuter point par point avant la mise hors service de Preview, le 25 novembre.
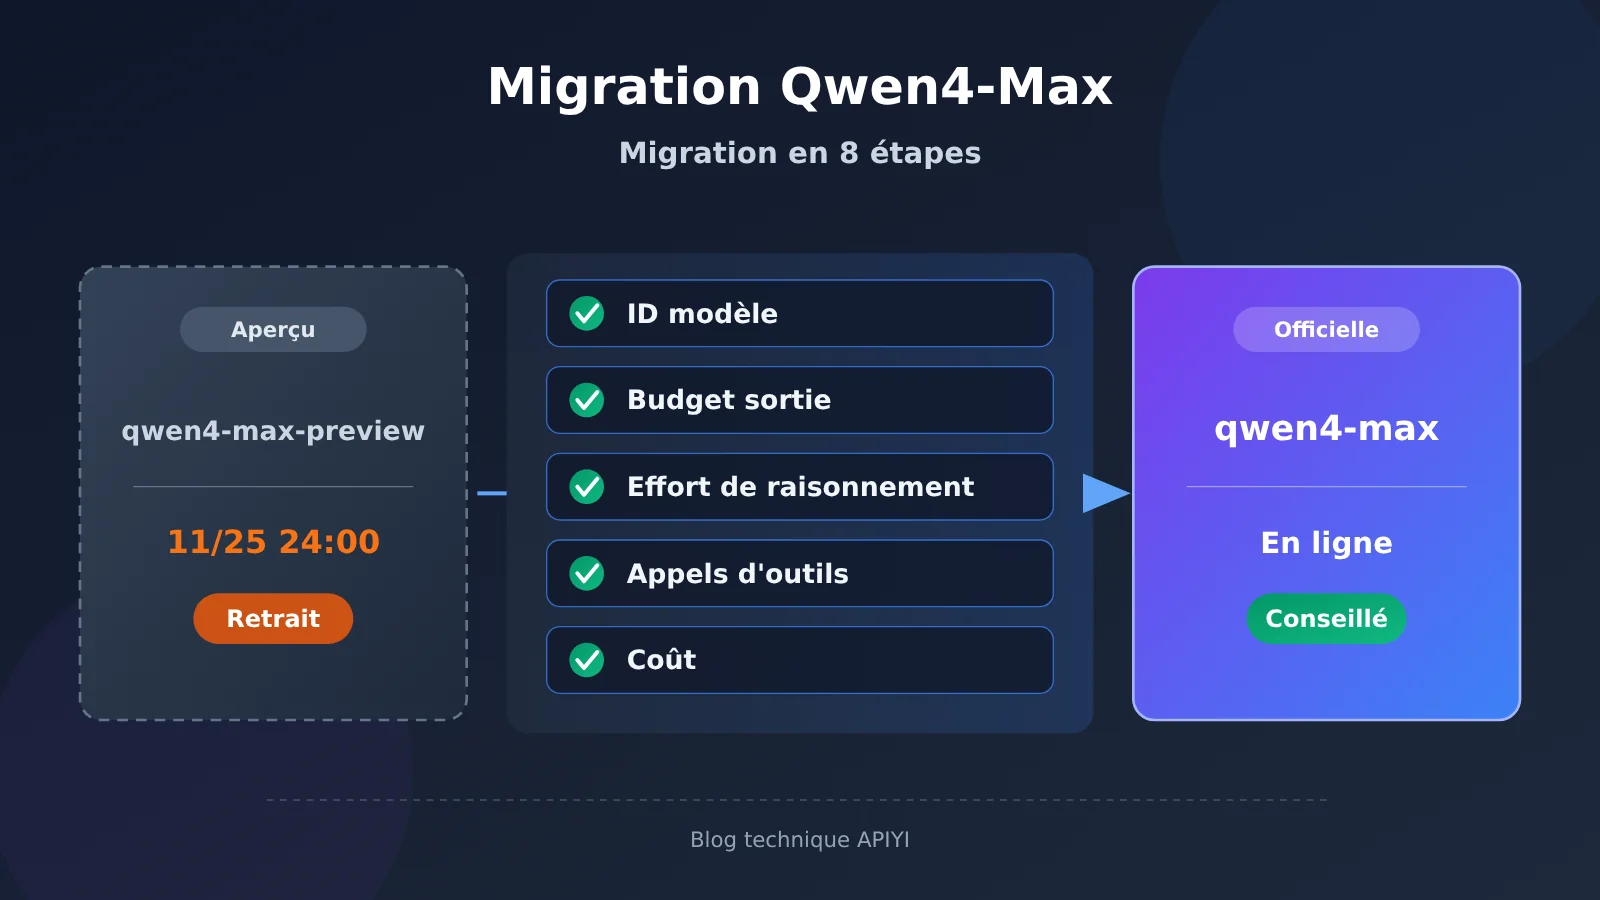
Qwen4-Max-Preview termine sa phase de préversion et sera mis hors service le 25 novembre 2026 à 24:00 (UTC+8). La version officielle Qwen4-Max est disponible depuis le 16 novembre, avec l’ID de modèle qwen4-max. Lors de la migration vers la version officielle, il faut vérifier en même temps cinq points : les produits d’intégration, le budget de sortie, les valeurs par défaut du raisonnement, le comportement des outils et le coût. Les deux versions offrent un contexte de 1 million de tokens, mais dans la version officielle, la limite de sortie en mode réflexion passe de 393 216 à 262 144, l’effort de raisonnement par défaut passe de xhigh à high, et la facturation s’étend des Token Plan Credits au paiement à l’usage. Changer uniquement l’ID du modèle ne garantit pas un comportement identique des tâches en production.
La suite de l’article présente d’abord la chronologie et les différences de spécifications entre Preview et la version officielle, puis le protocole API, les régions, les tarifs et le cache de la version officielle. Vient ensuite une liste de migration organisée dans cet ordre : enregistrer une base de référence, configurer l’accès, paramètres de requête, validation fonctionnelle, suivi de la facturation, bascule progressive. Enfin, nous listons les points d’acceptation pour les tâches telles que les rapports longs, la génération de code et les agents multi-tours. À la fin de votre lecture, vous pourrez transformer cette bascule en un processus de gestion des versions de modèles réutilisable par votre équipe.
À savoir : terminologie de la migration Qwen4-Max
| Terme | Explication |
|---|---|
| Model ID | Identifiant utilisé dans la requête pour spécifier une version précise du modèle, par exemple qwen4-max. |
| Base URL | Adresse de base de l’interface utilisée par le client pour se connecter à un produit et à un service dans une région donnée. |
| Fenêtre de contexte | Capacité totale que le modèle peut traiter en une seule requête, entrée, historique et contenu généré compris. |
| Budget de sortie | Plafond de Tokens qu’une requête peut générer. En mode réflexion, le raisonnement et la réponse finale partagent ce budget. |
| reasoning_effort | Paramètre de requête qui contrôle l’intensité du raisonnement. La valeur par défaut diffère entre la Preview et la version officielle. |
| thinking_budget | Paramètre qui contrôle le budget de Tokens de réflexion. Dans la Preview, il ne peut pas être défini en même temps que reasoning_effort. |
| Token Plan | Service d’abonnement d’Aliyun Bailian, mesuré en Credits, et seul canal d’accès de la Preview. |
| Function Calling | Mécanisme par lequel le modèle renvoie une demande d’appel selon la définition des outils, l’application exécutant l’outil puis renvoyant le résultat. |
| JSON Schema | Spécification décrivant la structure, les champs et les contraintes d’un JSON, utilisée pour encadrer le format de sortie du modèle. |
| TTL | Durée de conservation du cache, qui influence l’étendue de sa réutilisation et les coûts associés. |
| Validation de régression | Vérifier, à l’aide de tâches représentatives existantes, l’évolution des fonctionnalités, des résultats et des coûts après un changement de version. |
1 Quand Qwen4-Max-Preview prend fin et quand la version officielle arrive
1.1 Chronologie des versions de Qwen4-Max
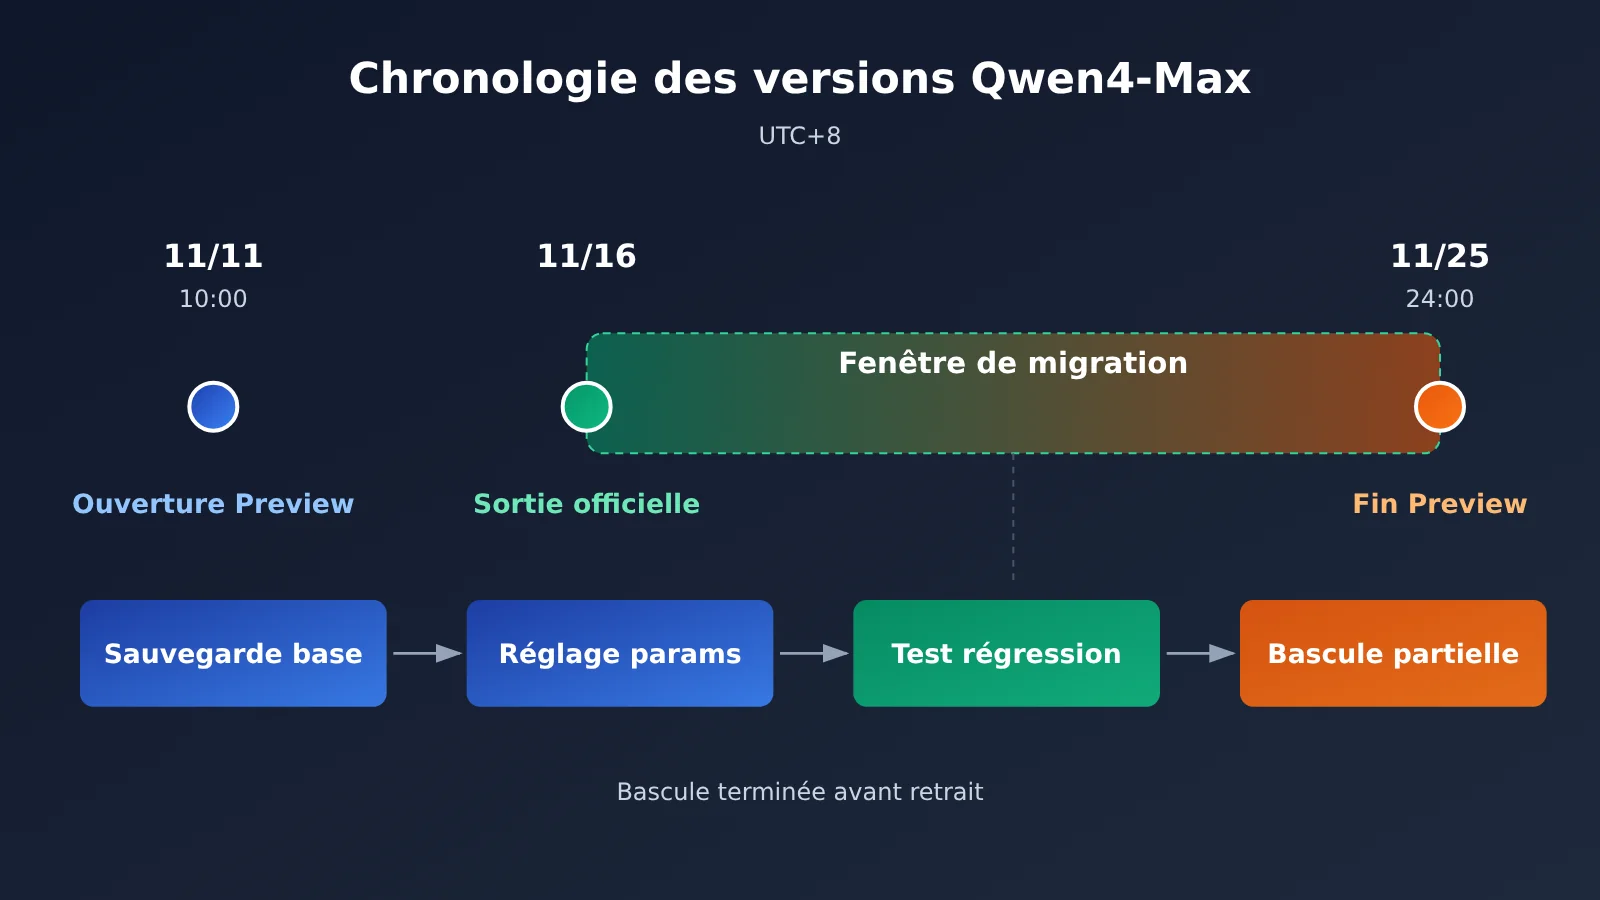
Le journal des mises à jour fonctionnelles d’Alibaba Cloud Token Plan recense deux événements distincts : la mise en ligne de la Preview le 11 novembre, et celle de la version officielle le 16 novembre. Une fois la version officielle publiée, la date de retrait initialement prévue pour la Preview ne change pas. La documentation officielle de la Preview affiche d’ailleurs en tête l’avertissement suivant : « la version officielle Qwen4-Max est désormais disponible, nous vous recommandons de l’utiliser ».
| Date (UTC+8) | Événement | Ce que cela implique pour les développeurs |
|---|---|---|
| 2026-11-11 10:00 | Ouverture de Qwen4-Max-Preview | Appel possible uniquement via Token Plan version personnelle ou version équipe |
| 2026-11-16 | Mise en ligne de la version officielle Qwen4-Max | Prise en charge de l’API à la consommation, également accessible via Token Plan |
| 2026-11-25 24:00 | Fin de la preview et retrait | qwen4-max-preview n’est plus appelable et ne peut plus servir de cible de repli |
1.2 Les deux ID de modèle et leurs canaux respectifs
L’ID de modèle de la Preview est qwen4-max-preview, avec pour alias qwen4.0-max-preview. Les deux ID sont appelables, et la facturation les affiche uniformément sous qwen4.0-max-preview. Pour accéder à la Preview, il faut une clé API dédiée Token Plan plus une Base URL dédiée https://token-plan.cn-beijing.maas.aliyuncs.com ; le paiement à la consommation n’est pas pris en charge.
L’ID de modèle de la version officielle est qwen4-max. Cette version offre deux voies d’accès : d’une part Token Plan version personnelle ou version équipe, d’autre part l’API à la consommation de Bailian. Ces deux voies ont chacune leur clé, leur Base URL et leur mode de facturation ; avant de migrer, il faut donc commencer par décider laquelle vous empruntez.
2 Différences de spécifications entre Qwen4-Max-Preview et la version officielle
2.1 Tableau comparatif des spécifications de Qwen4-Max
Les données ci-dessous proviennent de la documentation officielle des modèles Preview et version officielle.
| Indicateur technique | Qwen4-Max-Preview | Qwen4-Max version officielle |
|---|---|---|
| Model ID | qwen4-max-preview |
qwen4-max |
| Fenêtre de contexte | 1,000,000 | 1,000,000 |
| Entrée maximale (sans réflexion / avec réflexion) | Non répertorié séparément dans la documentation | 991,808 / 983,616 |
| Sortie maximale (mode sans réflexion) | Non répertorié séparément dans la documentation | 131,072 |
| Total maximal réflexion + réponse | 393,216 | 262,144 |
| Intensité de raisonnement par défaut | xhigh | high |
| Budget de réflexion par défaut | Selon les paramètres de l’interface Preview | 131,072 |
| Protocole API | OpenAI Chat Completions, Responses, Anthropic Messages | les trois précédents + DashScope |
| Mode de facturation | Uniquement Token Plan Credits | API avec paiement à l’usage, ou Token Plan |
2.2 Différences entre contexte, entrée, sortie et budget de réflexion
Ces quatre chiffres mesurent des choses différentes, et c’est là que la confusion est la plus fréquente lors d’une migration. La fenêtre de contexte représente la capacité totale qu’une requête peut traiter : les deux versions sont à 1 million. L’entrée maximale détermine la quantité de contenu qu’on peut insérer en une seule fois ; dans la version officielle, elle est de 983 616 en mode réflexion, un peu moins qu’en mode sans réflexion, la marge restante étant réservée au raisonnement. La sortie maximale détermine combien de tokens peuvent être générés au maximum en une seule fois, tandis que le budget de réflexion détermine combien d’entre eux peuvent servir au raisonnement.
Le changement le plus important se situe du côté de la sortie. Dans Preview, la réflexion et la réponse se partagent 393 216 tokens ; dans la version officielle, en mode réflexion, le plafond total est de 262 144, avec un budget de réflexion par défaut de 131 072. En se basant sur la configuration par défaut, la version officielle laisse environ 130 000 tokens d’espace pour la réponse finale. Si votre application repose sur Preview pour des sorties longues de plus de 200 000 tokens en une seule fois, il faudra repenser la façon de produire les sorties après la migration.
3 Capacités d’intégration API et coûts de la version officielle de Qwen4-Max
3.1 Protocoles et fonctionnalités
La version officielle prend en charge quatre protocoles : OpenAI Chat Completions, OpenAI Responses, Anthropic Messages et DashScope. Côté fonctionnalités, la documentation officielle liste le Function Calling, l’appel d’outils en parallèle, la recherche web, JSON Object, JSON Schema, le cache explicite, le cache implicite, ainsi que le résumé de chaîne de pensée et le chiffrement.
Par rapport à la Preview, la documentation de la version officielle ajoute le protocole DashScope, l’appel d’outils en parallèle et les deux types de cache. Si votre application ne gérait jusqu’ici qu’un seul tool_call, il faut maintenant vérifier que le code traite correctement le cas où plusieurs appels d’outils sont renvoyés dans une même réponse.
3.2 Régions et tarification à l’usage
L’API à l’usage de la version officielle couvre six régions. Pour choisir une région, il faut prendre en compte non seulement le prix, mais aussi la latence réseau, les exigences de résidence des données et la zone de déploiement de votre activité. Les capacités précises de chaque région sont à vérifier dans la matrice de capacités officielle.
| Région | Zone de déploiement | Entrée (yuan / million de tokens) | Sortie (yuan / million de tokens, réflexion incluse) |
|---|---|---|---|
| Chine du Nord 2 (Pékin) | Chine continentale | 10 | 30 |
| États-Unis (Virginie) | Mondial | 10 | 30 |
| Allemagne (Francfort) | Mondial | 10 | 30 |
| Japon (Tokyo) | Mondial | 10 | 30 |
| Hong Kong (Chine) | Mondial | 10 | 30 |
| Singapour | International | 10,938 | 32,813 |
La page officielle de la région de Pékin mentionne un quota gratuit de 1 million de tokens, valable 90 jours. Le point de départ est la plus tardive des conditions suivantes : activation de Bailian, publication du modèle, acceptation de la demande. Les prix ci-dessus ne s’appliquent qu’à la version officielle. Les 20 % du prix de la Preview et le tarif de 8 % obtenu après cumul avec la remise nocturne relèvent des avantages Token Plan Credits et ne peuvent pas être repris dans l’estimation de coût de la version officielle.
3.3 Cache explicite et cache implicite
Dans la version officielle, le cache est facturé séparément. Le cache explicite est créé à l’initiative du développeur : il convient pour les préfixes stables sur le long terme, comme l’invite système, la description des outils ou des documents de référence fixes. Le TTL est réglable sur 5 minutes ou 1 heure, et il est pris en charge pour Chat Completions, Responses et Anthropic Messages. Le cache implicite, lui, est géré automatiquement par la plateforme selon des critères comme la répétition de préfixes, sans configuration supplémentaire.
Dans un agent multi-tours, chaque tour transporte les mêmes définitions d’outils et le même matériel de contexte : un usage raisonné du cache permet de réduire nettement le coût des entrées répétées. Le TTL doit être choisi en fonction de l’intervalle entre les sessions : 5 minutes pour les sessions à interaction dense, et éventuellement 1 heure pour les traitements par lots espacés.
4 Étapes pour migrer de Qwen4-Max-Preview vers la version officielle
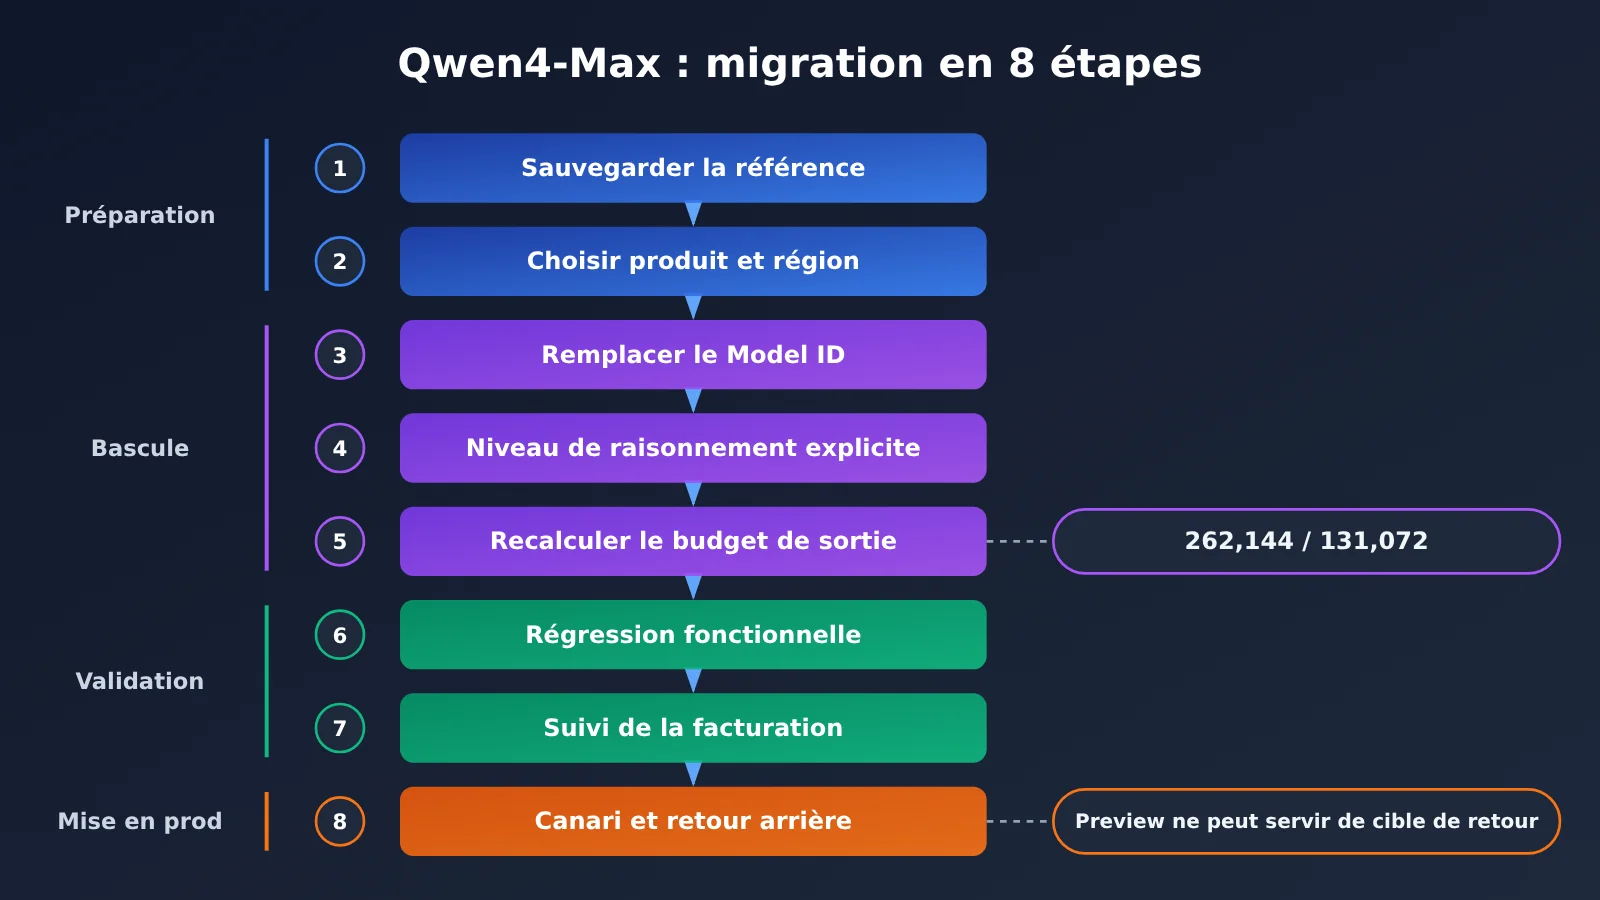
Les 8 étapes ci-dessous constituent la liste de vérification à l’usage des développeurs, établie à partir des spécifications officielles. L’éditeur ne fournit pas d’outil de migration automatique et ne garantit pas que tous les paramètres de requête soient compatibles sans adaptation. Chaque étape doit donc être validée concrètement dans votre propre contexte métier.
| Étape | Point de vérification | Critère d’acceptation |
|---|---|---|
| 1 | Conserver l’ancienne configuration et les tâches représentatives | Les paramètres de requête, les exemples de sortie, les temps d’exécution et la consommation du Preview sont archivés |
| 2 | Choisir le produit d’accès, vérifier la région, la clé et l’URL de base | Les services backend utilisent l’API à l’usage, les outils interactifs utilisent le Token Plan |
| 3 | Remplacer model par qwen4-max |
La requête de validation rapide renvoie un résultat normal, et le nom du modèle apparaît correctement dans la facturation |
| 4 | Définir explicitement l’intensité de raisonnement | Indiquer reasoning_effort ou le champ correspondant selon la tâche, sans dépendre des valeurs par défaut |
| 5 | Recalculer le budget de sortie | Total en mode raisonnement ≤ 262,144, mode non-raisonnement ≤ 131,072 |
| 6 | Vérifier les appels d’outils, la structure JSON, les sorties longues et l’historique multi-tours | Le taux de réussite des tâches représentatives est équivalent à la référence Preview |
| 7 | Surveiller la consommation et la facturation du cache | Les coûts d’entrée, de sortie et de cache correspondent aux prévisions |
| 8 | Basculer un faible volume de trafic et préparer une configuration de retour arrière | La cible de retour arrière est un modèle toujours valide, ce qui n’est pas le cas du Preview |
4.1 Sauvegarder la configuration existante et des tâches représentatives
Avant la mise hors service de Preview, exportez toutes les configurations qui appellent actuellement qwen4-max-preview, notamment max_tokens, reasoning_effort ou thinking_budget, les définitions d’outils, response_format et l’invite système. Choisissez également 10 à 30 tâches représentatives et conservez les sorties, les temps d’exécution et la consommation de Preview comme base de comparaison. Après le 25 novembre, il ne sera plus possible de récupérer les résultats de Preview.
4.2 Choisir le produit d’intégration et vérifier la Key et la Base URL
Le Token Plan autorise uniquement une utilisation interactive dans des outils de programmation ou des outils d’agents tels que Claude Code, Cursor, Qwen Code, Qoder. Les scripts automatisés, les backends d’applications maison et les appels par lots depuis des plateformes de workflow ne sont pas autorisés ; en cas d’infraction, l’abonnement peut être suspendu ou la Key bannie. Si Preview n’est utilisé que dans un outil comme Qoder, vous pouvez continuer à passer à la version officielle via le Token Plan. Si vous devez l’intégrer à votre propre backend, utilisez plutôt l’API à la consommation de la version officielle, avec la Key et la Base URL correspondant à la région dans la console.
La version personnelle du Token Plan inclut aussi une clause d’autorisation des données : pendant l’utilisation, les entrées et les contenus générés servent à améliorer le service. Les équipes qui traitent des informations confidentielles doivent intégrer ce point à leur évaluation au moment de choisir le produit d’intégration.
4.3 Remplacer le Model ID : prise en main rapide de Qwen4-Max
Il suffit de remplacer le Model ID par qwen4-max pour envoyer votre première requête. Voici un exemple minimal avec l’interface compatible OpenAI : on vérifie d’abord que la requête passe, avant de passer au réglage des paramètres :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, remplaçable par le Base URL de la région correspondante sur Bailian
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # Valeur précédente : qwen4-max-preview
    messages=[{"role": "user", "content": "用三句话说明你的版本信息"}],
    reasoning_effort="high",             # Indiqué explicitement, sans dépendre de la valeur par défaut
    max_tokens=8192
)
print(resp.choices[0].message.content)
Les modèles disponibles derrière cette même interface compatible OpenAI dépendent de la liste de modèles en temps réel de la plateforme. En production, revérifiez une dernière fois avant la mise en ligne.
4.4 Définir explicitement les paramètres de raisonnement
Preview utilise xhigh par défaut, la version stable high. Si votre code ne précisait pas l’effort de raisonnement, l’intensité de raisonnement baissera automatiquement après le changement, et la qualité, le temps d’exécution et la consommation de tokens des tâches complexes peuvent évoluer en conséquence. Le mieux est de préciser l’effort de raisonnement selon le type de tâche : pour le code complexe et le raisonnement scientifique, commencez par une comparaison de référence avec la même intensité que Preview ; pour l’extraction et le formatage simples, essayez ensuite de réduire.
La documentation de Preview impose de ne pas définir reasoning_effort et thinking_budget en même temps. Pour la version stable, les noms de champs et les valeurs dans les quatre protocoles Chat Completions, Responses, Anthropic Messages et DashScope sont à vérifier dans la documentation du protocole correspondant. Dans Preview, preserve_thinking est activé par défaut pour les conversations multi-tours, et le contenu de réflexion historique doit être replacé dans le champ reasoning_content. Si votre application renvoie le contenu de réflexion, il faut aussi vérifier sur la version stable que le format des messages historiques est bien accepté.
4.5 Recalculer le budget de sortie à partir des nouvelles limites
Dans la Preview, max_tokens et max_completion_tokens sont équivalents : la réflexion et la réponse partagent un budget total de 393 216. Avec la version stable, le budget total du mode réflexion est de 262 144, et la limite de sortie du mode non-réflexion est de 131 072. Toutes les requêtes qui dépassaient 262 144 sur la Preview doivent être revues à la baisse. Et pour les requêtes dont le budget était déjà juste, il faut en plus tenir compte de la part qu’occupera le budget de réflexion par défaut de 131 072.
Voir le code complet de configuration de migration (validation du budget + repli)
from openai import OpenAI

# Limites officielles de la version stable (en mode réflexion : réflexion + réponse cumulées)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """Calcule max_tokens selon le mode ; lève une erreur si la limite officielle est dépassée, pour éviter une troncature silencieuse"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # Adresse compatible OpenAI d'APIYI
    "reasoning_effort": "high",
}
# La cible de repli doit être un modèle encore en service ; qwen4-max-preview n'est plus disponible après sa mise hors service
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 Valider les appels d’outils, les sorties structurées et les sorties longues
Rejouez les tâches représentatives une par une : le Function Calling renvoie-t-il le même nom d’outil et la même structure d’arguments ? Les appels d’outils parallèles sont-ils correctement traités par le code ? La sortie JSON Schema passe-t-elle le validateur existant ? La sortie longue se termine-t-elle bien par finish_reason == "length" ? Le contexte reste-t-il cohérent après plusieurs tours d’historique renvoyés ? Comparez chaque point à la référence enregistrée en 4.1 et notez les écarts.
4.7 Surveiller l’usage et la facturation du cache
Après être passé des Credits à la facturation à l’usage, le coût doit être calculé séparément sur trois postes : les entrées, les sorties (y compris la réflexion) et le cache. Sur la version finale, le prix unitaire de la sortie est trois fois celui de l’entrée ; comme les tokens de réflexion sont aussi comptés dans la sortie, le réglage de l’effort de raisonnement a un impact direct sur la facture. Vous pouvez d’abord boucler toute la régression avec le quota gratuit de la région de Pékin, puis extrapoler le coût mensuel à partir de l’usage réel.
4.8 Basculement à faible trafic avec configuration de repli conservée
Commencez par basculer 5 % à 10 % du trafic vers qwen4-max, surveillez le taux d’erreur, le taux de troncature et le coût par tâche, puis ne passez au basculement complet qu’une fois la stabilité confirmée. La configuration de repli doit pointer vers un modèle encore en service, par exemple une autre version disponible de la même série, ou un modèle d’un autre fournisseur déjà validé. Une fois Preview retiré, il ne peut plus servir de cible de repli.
🎯 Conseil technique : il est préférable de valider le modèle de repli sur le même lot de tâches représentatives avant le déploiement progressif. Grâce à l’interface compatible OpenAI d’APIYI apiyi.com, une seule clé API permet de basculer entre plusieurs modèles majeurs : il suffit de modifier le champ
modelpour réaliser un exercice de repli.
5 Les problèmes les plus fréquents après la migration vers Qwen4-Max
5.1 Troncature de la sortie
C’est le problème le plus courant. Les longs rapports ou les gros fichiers qui se généraient intégralement sur Preview peuvent être tronqués une fois passés à la version officielle, à cause de la limite de 262 144 ou de l’occupation du budget de réflexion par défaut. La solution consiste à vérifier finish_reason, à générer les tâches trop longues par chapitre ou par fichier, et à réserver un budget explicite pour la partie réponse.
5.2 Baisse de l’intensité de raisonnement par défaut
En passant de xhigh à high, les performances sur les tâches complexes peuvent changer, tandis que le temps et le coût des tâches simples peuvent baisser. Un code qui ne spécifie pas de paramètre de raisonnement changera de comportement à votre insu. Toutes les requêtes de production doivent définir explicitement l’intensité de raisonnement, et déterminer le niveau adapté à chaque type de tâche via un rejeu A/B.
5.3 Appels d’outils et différences de protocole
La version officielle prend explicitement en charge les appels d’outils parallèles : une seule réponse peut contenir plusieurs requêtes d’appel d’outil. Un code qui ne lit que le premier tool_call oubliera d’exécuter des outils et interrompra le flux de l’agent. Lors d’un changement de protocole, par exemple de Chat Completions à DashScope, il faut également recouper la documentation pour le nommage des champs et la manière dont le contenu de réflexion est renvoyé.
5.4 Évolution de la facturation et de la mise en cache
La consommation de Credits sur Preview dépend de coefficients de facturation, des hits de cache, des appels d’outils et d’autres facteurs ; elle ne peut pas être convertie directement en prix par million de Tokens. La version officielle facture en yuans par million de Tokens, avec une facturation distincte pour le cache. Le modèle budgétaire basé sur les Credits doit être reconstruit, en y intégrant le coût d’écriture du cache explicite et le choix du TTL.
6 Quelles tâches doivent être retestées avec la version officielle de Qwen4-Max
| Type de tâche | Points de vérification clés | Paramètres à surveiller |
|---|---|---|
| Génération de rapports longs | Troncature ou non, exhaustivité des sections, cohérence factuelle | Budget de sortie, finish_reason |
| Génération de code complexe | Taux de réussite à la compilation et aux tests, longueur d’un fichier unique, cohérence entre fichiers | reasoning_effort, budget de sortie |
| Agent multi-tours | Ordre des appels d’outils, gestion des appels parallèles, renvoi de l’historique de réflexion | tool_calls, reasoning_content |
| Recherche dans de longs documents | Taux de précision des associations entre paragraphes, dépassement ou non de 983,616 ou 991,808 en entrée | Entrée maximale, taux de succès du cache |
| Sortie structurée JSON | Taux de validation du schéma, champs manquants et erreurs de type | response_format, JSON Schema |
Pour la recherche dans de longs documents, il faut être particulièrement vigilant : la taille d’entrée maximale de la version officielle varie selon le mode, et le mode réflexion dispose d’environ 8,000 Tokens de moins que le mode non-réflexion. Une tâche qui remplit les documents tout près de la limite peut donc dépasser la limite après un changement de mode. Pour les tâches de code, je conseille de réutiliser directement les suites de tests unitaires existantes et de prendre le taux de réussite aux tests comme critère d’acceptation : c’est plus fiable que de lire manuellement les sorties.
💡 Conseil de choix : si vous voulez comparer les performances de Qwen4-Max et d’autres modèles phares sur ces tâches, vous pouvez rejouer le même lot de tâches via l’interface unifiée d’APIYI apiyi.com, ce qui évite d’écrire du code d’adaptation pour chaque fournisseur.
7 Questions fréquentes sur la migration vers Qwen4-Max-Preview
Q1 : Après le retrait de Qwen4-Max-Preview, les anciennes requêtes basculeront-elles automatiquement vers la version officielle ?
La documentation officielle indique seulement que la Preview sera retirée et recommande de passer à la version officielle ; elle ne mentionne aucun transfert automatique. Avant le 25 novembre à 24h00, remplacez manuellement le `model` par `qwen4-max` et effectuez les vérifications de la section 4 de cet article.
Q2 : Suffit-il de remplacer l’ID du modèle par qwen4-max ?
Non. La limite de sortie, l’effort de raisonnement par défaut et le mode de facturation ont tous changé. Il faut au minimum recalculer le budget de sortie, définir explicitement l’effort de raisonnement et lancer des tests de régression sur les appels d’outils et les sorties structurées.
Q3 : La facturation à 20 % du tarif et les remises de nuit de la Preview s’appliquent-elles encore à la version officielle ?
Ces deux avantages ne concernent que la consommation de Credits de la Preview dans le Token Plan. La version officielle en API à l’usage est facturée, pour la région de Pékin, à 10 yuans en entrée et 30 yuans par million de tokens en sortie ; les coûts doivent donc être recalculés.
Q4 : Le backend peut-il continuer à utiliser la clé du Token Plan ?
Non. Le Token Plan autorise uniquement un usage interactif dans les outils de programmation ou d’agents désignés. Un backend d’application auto-hébergé doit passer à l’API à l’usage de la version officielle, ou s’appuyer sur un service d’agrégation facturé à l’usage et proposant une interface compatible OpenAI, comme APIYI apiyi.com.
Q5 : Comment monter rapidement un environnement de régression pendant la migration ?
Regroupez les tâches représentatives dans un jeu de requêtes figé : il suffit de changer le champ `model` dans le même code pour rejouer l’ensemble. APIYI apiyi.com offre un quota de test gratuit aux nouveaux utilisateurs, utile pour valider un modèle de repli et comparer les approches.
8 Conclusion : intégrer la gestion des versions de modèle dans le processus de production de Qwen4-Max
Cette bascule de Qwen4-Max-Preview vers la version officielle touche cinq dimensions qu’il faut gérer dans la durée :
- ID du modèle : centralisez-les dans un centre de configuration plutôt que de les coder en dur, et abonnez-vous aux annonces sur le cycle de vie des modèles.
- Paramètres d’interface : effort de raisonnement, budget de réflexion et
response_formatdoivent tous être définis explicitement. - Limites de sortie : pour chaque modèle, consignez les quatre chiffres — fenêtre de contexte, entrée max, sortie max, budget de réflexion — et vérifiez-les avant d’envoyer la requête.
- Coût : surveillez séparément l’entrée, la sortie et le cache, et reconstruisez votre modèle budgétaire dès que le mode de facturation change.
- Tests de régression : gardez un ensemble de tâches représentatives et les résultats de référence, et rejouez-les intégralement à chaque changement de version.
Le cycle de vie de la Preview n’est que de deux semaines, et la version officielle connaîtra elle aussi de nouvelles versions et des plans de retrait. Mettez en place un processus fixe — « sauvegarde d’une référence, paramètres explicites, bascule progressive, repli possible » — et la prochaine rotation de version pourra se faire en quelques jours. Les équipes qui doivent préparer un plan de repli multi-modèles peuvent tout valider derrière la même interface via APIYI apiyi.com.
Références
-
Documentation officielle de Qwen4-Max (version officielle) : contexte, limites d’entrée/sortie, effort de raisonnement par défaut, régions, tarifs et cache
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max - Description : principale source pour les paramètres de migration
- Lien :
-
Documentation officielle de Qwen4-Max-Preview : spécifications de la Preview, mode d’accès, date de retrait
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max-preview - Description : référence pour comparer lors de la sauvegarde de l’ancienne configuration
- Lien :
-
Mises à jour de la fonctionnalité Token Plan : historique de mise en ligne de la Preview et de la version officielle
- Lien :
help.aliyun.com/zh/model-studio/token-plan-product-updates - Description : source de la chronologie des versions
- Lien :
-
Permissions et règles d’usage de Token Plan : périmètre d’utilisation interactive et scénarios interdits
- Lien :
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Description : base de conformité pour choisir le produit d’accès
- Lien :
-
Abonnement personnel et avantages Token Plan : formules, Credits et offre Preview
- Lien :
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Description : distinguer l’offre Preview de la facturation de la version officielle
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil d’APIYI apiyi.com ; d’autres ressources d’intégration sont disponibles sur le centre de documentation docs.apiyi.com