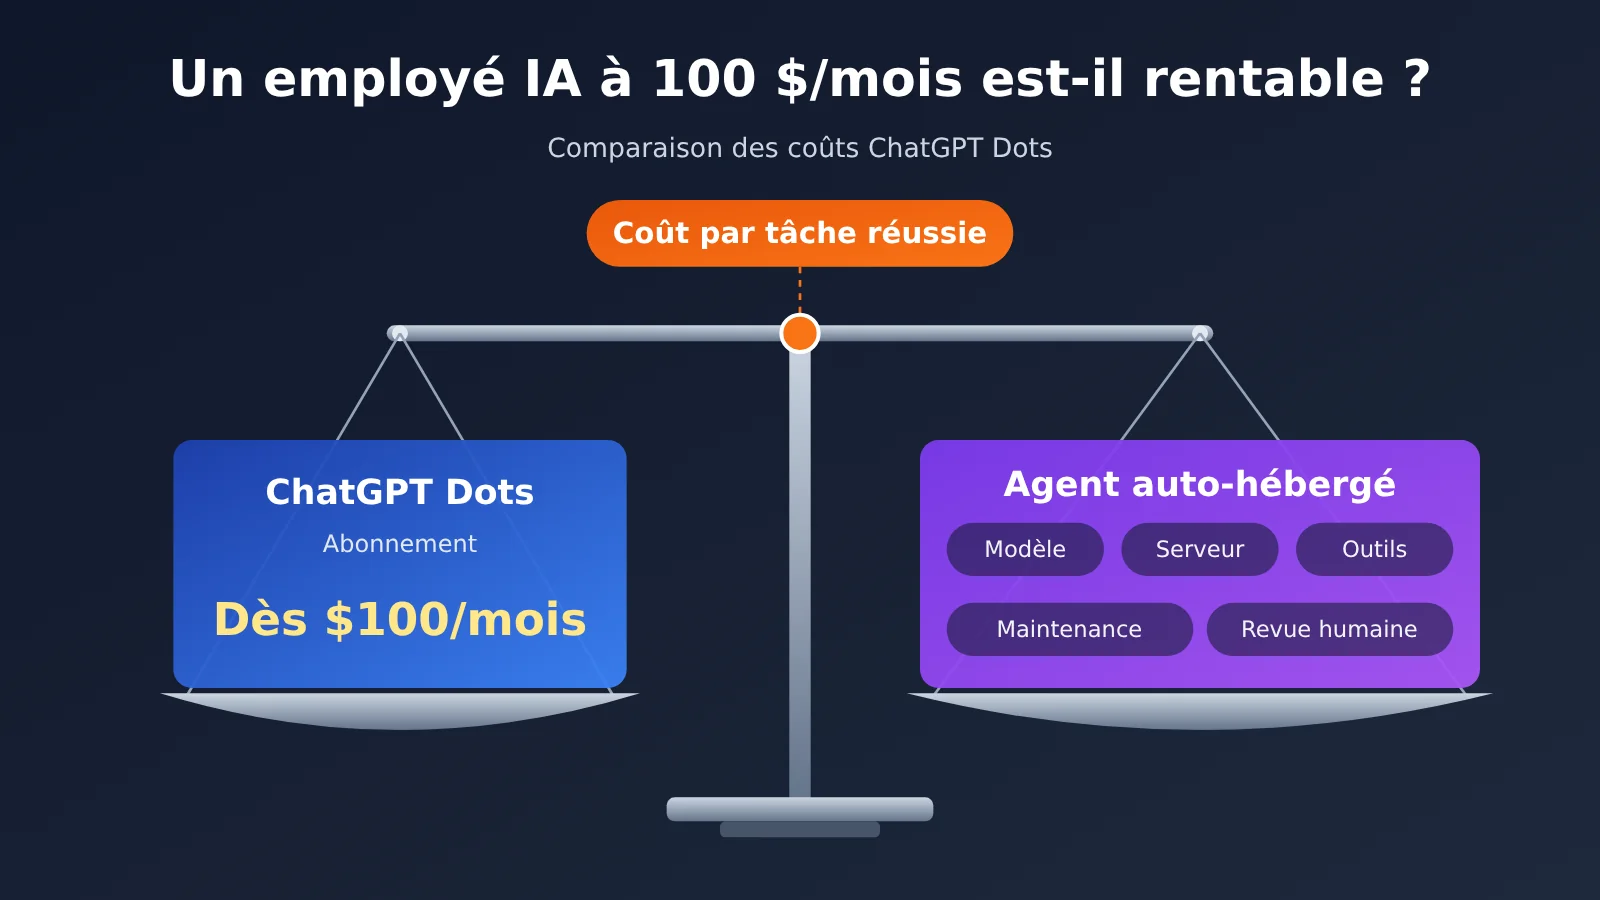
Note de l’auteur : à exigences de livraison égales, comparer l’abonnement ChatGPT Dots et un agent auto-construit sur le coût par tâche réussie, en tenant compte des dépenses de modèle, d’infrastructure, de maintenance et de révision humaine.
Conclusion principale : pour savoir si « payer 100 $ par mois pour un employé IA » est rentable, il faut regarder, à exigences de livraison égales, le coût total pour accomplir une tâche conforme ; l’abonnement mensuel et le prix unitaire des tokens n’en sont qu’une partie. D’après les informations officielles au 16 novembre 2026, le point d’entrée pour un utilisateur individuel qui veut utiliser ChatGPT Dots est Pro 100 (100 $/mois), et l’abonnement inclut un ordinateur cloud, un contexte longue durée, la coordination des tâches et des connexions d’applications. Dans un exemple hypothétique, le coût de modèle d’un agent auto-construit pour 300 tâches par mois serait d’environ 33 $ à 66 $, mais cela n’inclut ni les serveurs, ni les outils, ni le développement et la maintenance, ni les nouvelles tentatives en cas d’échec, ni la révision humaine. Pour savoir quelle approche revient le moins cher, il faut mesurer sur un même lot de tâches avant de conclure.
Cet article commence par décomposer la logique tarifaire et le périmètre de capacités de l’abonnement Dots, puis classe les coûts d’un agent auto-construit en cinq catégories : modèle, infrastructure, outils, développement et maintenance. Il utilise aussi les tarifs Claude d’APIYI pour montrer comment calculer le coût en tokens d’une tâche. Ensuite, il compare Dots, un agent mono-modèle et un agent multi-modèles selon six dimensions, et propose une méthode d’expérimentation comparative centrée sur le « coût par tâche réussie ». Enfin, il donne des recommandations selon trois profils — utilisateur individuel, développeur intensif et entreprise — et présente une méthode de gestion des coûts qui combine abonnement et API.
À savoir : 8 termes pour comprendre le coût d’un employé IA
| Terme | Explication |
|---|---|
| Abonnement Pro | Forfait ChatGPT payé au mois, avec les avantages et les quotas correspondants ; les offres Pro 100, Pro 200 et Pro 500 donnent toutes accès à Dots |
| Dot | Agent personnel permanent dans ChatGPT Dots, doté de son propre ordinateur et navigateur cloud, capable de faire avancer en continu les tâches qui lui sont déléguées |
| Token | Unité de mesure du contenu en entrée et en sortie d’un modèle ; l’API facture au million de tokens |
| Lecture du cache | Les préfixes répétés d’une requête (comme l’invite système ou les définitions d’outils) réutilisent un résultat de traitement déjà existant ; le prix unitaire est bien plus bas que celui d’une entrée classique |
| Écriture dans le cache | On enregistre pour la première fois le préfixe réutilisable, afin que les requêtes suivantes puissent le lire ; les règles de facturation sont celles indiquées dans la console de la plateforme |
| Coût d’infrastructure | Dépenses liées aux serveurs, conteneurs, bases de données, stockage et environnements d’exécution nécessaires pour héberger un agent en interne |
| Taux de réussite des tâches | Part des tâches livrées conformes aux critères d’acceptation définis, après une ou plusieurs exécutions |
| Coût d’une tâche réussie | Total des dépenses de toutes les exécutions (y compris les nouvelles tentatives échouées), de l’infrastructure et de la relecture humaine, divisé par le nombre de tâches livrées conformes |
1 Ce que vous obtenez pour 100 dollars par mois avec ChatGPT Dots
1.1 ChatGPT Dots : tarification du Pro personnel et de l’offre Entreprise
ChatGPT Dots a été officiellement lancé par OpenAI le 29 septembre 2026. Il est positionné comme un agent IA personnel résident : une fois qu’un utilisateur lui a confié un objectif, Dot peut continuer à faire avancer le travail dans le cloud pendant que l’utilisateur s’absente ou éteint son ordinateur, puis lui rendre la main lorsqu’une décision est nécessaire.
Pour parler du prix de Dots, il faut impérativement distinguer le Pro personnel et le Dot d’entreprise. Le tableau ci-dessous s’appuie sur la documentation d’aide officielle d’OpenAI, consultée le 16 novembre 2026.
| Public concerné | Base de facturation | Conditions d’application | Partie facturée séparément |
|---|---|---|---|
| ChatGPT Pro 100 | 100 $/mois | 18 ans et plus ; hors Espace économique européen, Royaume-Uni et Suisse ; déploiement progressif | Les tâches Work/Codex déléguées consomment le quota du produit correspondant |
| ChatGPT Pro 200 | 200 $/mois | Idem | Idem |
| ChatGPT Pro 500 | 500 $/mois | Idem | Idem |
| Espace de travail Enterprise | Tarif fixe selon le type de travail ou facturation à l’usage, montant défini par le contrat ou le devis de l’espace de travail | Du 2026-11-04 au 11-18, période de prévisualisation administrateur gratuite ; les Dot activés à partir du 11-18 deviennent facturables ; chaque membre peut créer 1 Dot personnel | Les tâches déléguées à Work ou Codex sont facturées séparément selon les tarifs correspondants |
Dans la documentation des Dots pour le Pro personnel, aucun abonnement mensuel distinct pour les Dots n’est mentionné : l’abonnement Pro mensuel fait office de seuil d’accès. OpenAI précise également que les tâches ChatGPT Work ou Codex déléguées par Dot sont calculées selon les règles de quota du produit correspondant, la consommation dépendant de facteurs tels que le modèle, la fenêtre de contexte, le raisonnement, les appels d’outils et la recherche. Les 100 $/mois correspondent donc à un ensemble de quotas d’usage délimités, et la documentation officielle ne précise pas non plus combien de tâches représente le travail approfondi d’un Dot en Pro personnel.
1.2 Les capacités de collaborateur IA incluses dans l’abonnement Dots
Lorsqu’on compare Dots à un appel direct à l’API, on a vite tendance à ne regarder que la case « modèle ». En réalité, l’abonnement regroupe tout un environnement d’exécution qu’il faudrait construire soi-même en auto-hébergement :
- Ordinateur et navigateur cloud : chaque Dot dispose de son propre ordinateur cloud, peut ouvrir des sites web, organiser des documents et produire des rapports ; l’utilisateur peut à tout moment suivre et reprendre la main sur les opérations.
- Contexte de long terme : combinaison de ChatGPT Memory, des notes propres à Dot, des éléments de la tâche en cours et des données des applications autorisées.
- Coordination multi-projets : découpage des tâches complexes, lancement d’agents de recherche en arrière-plan en parallèle, consolidation des résultats et demande d’intervention de l’utilisateur en cas de blocage.
- Mode de travail continu : prise en charge des tâches planifiées et de la surveillance d’événements, par exemple vérifier chaque semaine les concurrents ou surveiller les nouveaux bugs dans Slack.
- Recherche proactive : en l’absence de nouveaux messages, recherche dans les sources de données autorisées ; ce processus est en lecture seule et les actions ultérieures doivent passer par le circuit d’approbation normal.
- Connexions aux applications et canaux de communication : lors de la publication, la description officielle évoquait un écosystème de plugins connectables à plus de 4 000 applications, avec une prise de contact via ChatGPT, Slack, Microsoft Teams, etc.
- Mécanismes de permissions et de sécurité : les Custom Rules définissent les limites d’exécution, Auto-review vérifie avant des opérations comme l’envoi d’e-mails, et les actions telles que la modification d’un mot de passe ou le transfert de fonds doivent être reprises en main par l’utilisateur.
Des tests réalisés par des tiers donnent une idée des limites de ces capacités. Dans un test d’Axios du 20 octobre 2026, Dots a produit un programme commémoratif WNBA de 38 pages et généré en 47 secondes un album photo commémoratif de 12 pages, mais le programme contenait des statistiques contestables, et l’étape d’achat devait être réalisée par l’utilisateur dans l’application Target. La conclusion de l’auteur : ce type d’agent convient pour la recherche et la préparation, mais les résultats nécessitent encore une édition humaine et une vérification des faits. Cette conclusion détermine directement que le modèle de coût présenté plus loin doit intégrer une relecture humaine.
2 Le coût complet d’un Agent « employé IA » auto-construit
2.1 Les cinq catégories de coûts d’un Agent auto-construit
Construire avec une API un Agent capable de travailler en continu, la facture va bien au-delà des seuls appels au modèle. On peut décomposer les coûts en cinq catégories :
- Coûts du modèle : entrées, sorties, lecture et écriture du cache, consommation d’inférence, qui varient linéairement avec le volume de tâches.
- Coûts d’infrastructure : serveurs cloud, conteneurs, bases de données, stockage — une partie en abonnement mensuel fixe, une autre variant selon la charge.
- Coûts des outils : API de recherche, navigateur headless, interfaces de données tierces, généralement facturées à l’appel.
- Coûts de développement : développement initial, intégration système, conception des permissions, un investissement concentré sur la phase amont.
- Coûts de maintenance : supervision et alertes, diagnostic des pannes, tests de régression après mise à jour du modèle, qui surviennent en continu.
Sous forme de formule :
$$C_{self}=C_{API}+C_{infra}+C_{tools}+C_{dev}+C_{maintenance}$$
La structure de coûts de l’approche par abonnement est la suivante :
$$C_{subscription}=C_{plan}+C_{extra\ usage}+C_{human\ review}$$
Les deux approches doivent intégrer le temps humain. Dans l’approche auto-construite, ce temps se répartit entre développement, maintenance et vérification ; dans l’approche par abonnement, il se concentre sur la délégation des tâches, le contrôle des résultats et l’approbation.
2.2 Une conception d’Agent « employé IA » auto-construit
Voici une conception destinée au calcul des coûts, qui illustre les composants nécessaires à un Agent auto-construit. Pour les frais de chaque composant, reportez-vous aux tarifs des services cloud que vous utilisez réellement ; cet article n’a pas procédé à un test de déploiement de cette architecture.
- Couche d’ordonnancement : déclencheurs planifiés ou file de messages, chargée des tâches périodiques du type « produire un rapport de veille tous les matins à 8 h ».
- Couche d’orchestration : le framework de l’Agent planifie les étapes, appelle les outils et sauvegarde les états intermédiaires (comme le Checkpointer de LangGraph ou les workflows du OpenAI Agents SDK).
- Couche modèle : invocation des modèles via une interface compatible OpenAI, avec routage vers différents modèles selon la difficulté de la tâche.
- Couche outils : recherche, scraping web, navigateur headless, génération de fichiers.
- Couche état : la base de données conserve les enregistrements de tâches, les notes à long terme et les informations de déduplication.
- Couche d’approbation : les opérations impliquant un envoi externe, un paiement ou une suppression passent par une file d’approbation humaine.
- Couche d’observabilité : enregistre pour chaque appel les Token, la durée et les causes d’échec, comme source de données pour la comptabilité analytique.
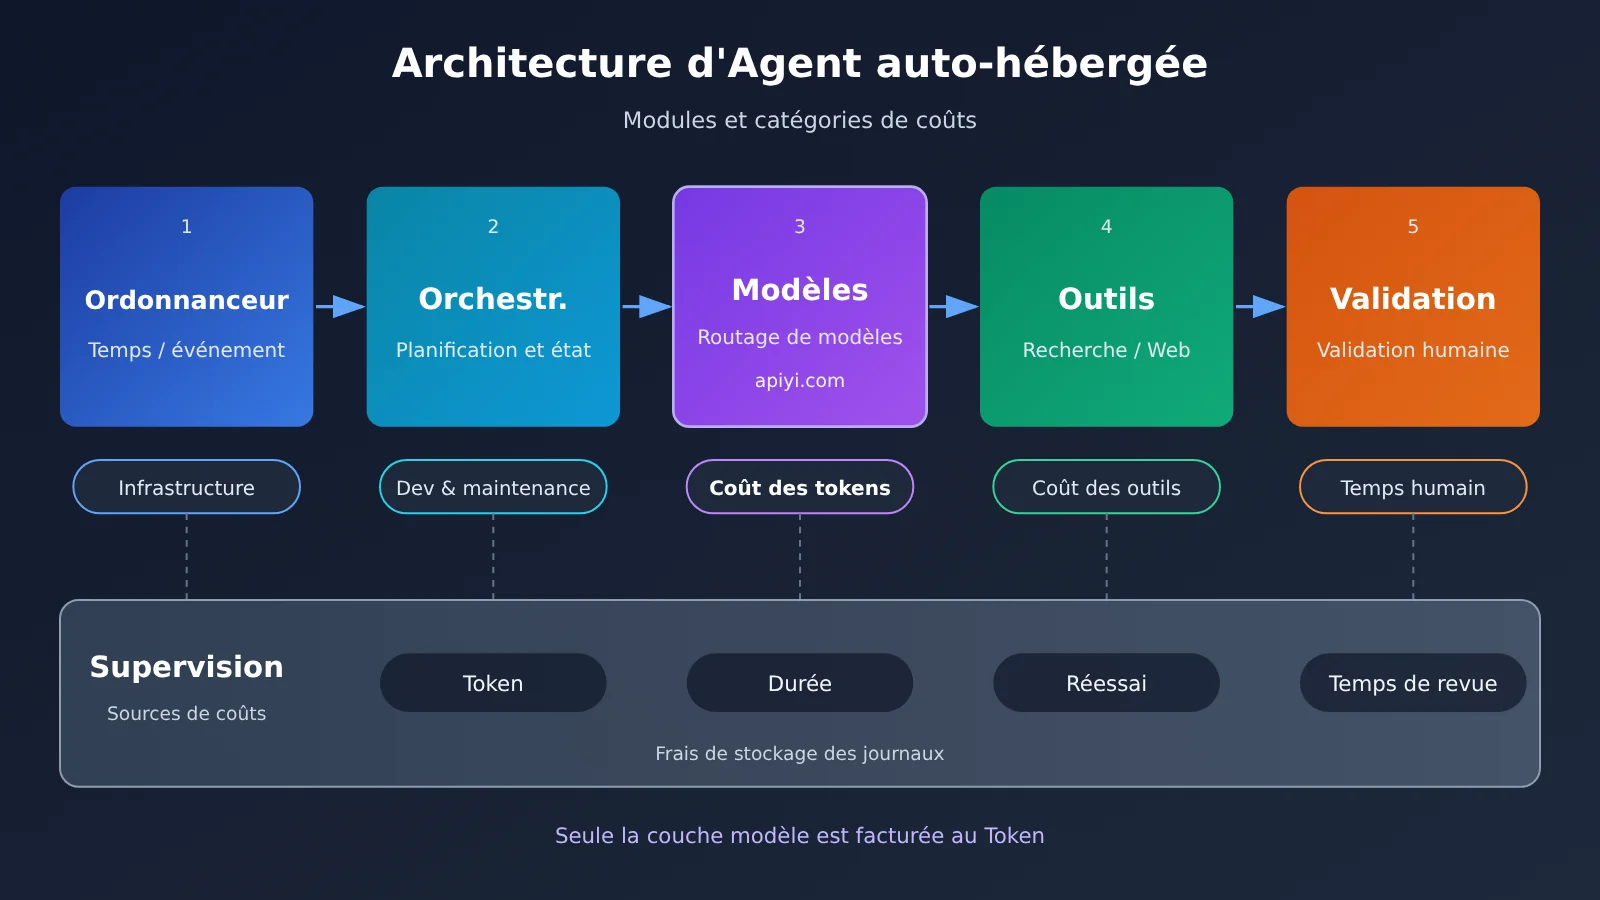
Sur les sept composants représentés dans ce schéma, seuls les coûts de la couche modèle peuvent être calculés directement à partir du prix des Token ; les frais des autres composants dépendent des choix d’architecture et des compétences de l’équipe. C’est précisément pour cela que le coût des Token ne représente qu’une partie du coût d’un Agent auto-construit.
3 Combien de tokens consomme une tâche d’employé IA
3.1 Différences de facturation entre entrée, sortie et cache
Une tâche d’un Agent comprend généralement plusieurs appels au modèle : une phase de planification, puis une inférence après chaque appel d’outil, et enfin une synthèse. À chaque tour, l’invite système, les définitions d’outils et les étapes précédentes sont renvoyées comme entrée. Les tokens d’entrée d’un Agent sont donc souvent bien plus nombreux que ses tokens de sortie.
C’est précisément là que le cache entre en jeu. L’invite système et les définitions d’outils restent identiques d’un appel à l’autre : lorsqu’ils touchent le cache, ils sont facturés au tarif de lecture du cache, soit environ un vingtième du prix d’une entrée normale. L’écriture dans le cache a lieu lors du premier enregistrement du préfixe ; son prix dépend de la console de la plateforme et n’est pas pris en compte dans les exemples de cet article.
3.2 Calculer le coût du modèle par tâche avec les tarifs APIYI
Les prix ci-dessous proviennent des tarifs Claude publiés par APIYI le 13 novembre 2026 ; en pratique, référez-vous à la console et à la liste des modèles au moment de l’appel. Les volumes indiqués sont un échantillon hypothétique destiné à illustrer l’algorithme : chaque tâche compte 30,000 Token en entrée et 5,000 Token en sortie, pour 300 tâches par mois. Cet échantillon n’a aucun rapport avec l’utilisation moyenne réelle de Dots ou de n’importe quelle plateforme.
| Élément de calcul | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Prix d’entrée / de sortie / de lecture du cache (par million de Token) | $4 / $20 / $0.20 | $2 / $10 / $0.10 |
| Coût par tâche (sans cache) | 30,000×$4/10⁶ + 5,000×$20/10⁶ = $0.22 | 30,000×$2/10⁶ + 5,000×$10/10⁶ = $0.11 |
| Coût mensuel pour 300 tâches (sans cache) | $66 | $33 |
| Coût par tâche (en supposant que 20,000 Token d’entrée touchent le cache en lecture) | $0.04 + $0.004 + $0.10 = $0.144 | $0.02 + $0.002 + $0.05 = $0.072 |
| Coût mensuel pour 300 tâches (avec l’hypothèse de lecture du cache) | $43.2 | $21.6 |
| Plateformes disponibles | APIYI, API officielle | APIYI, API officielle |
Dans cette hypothèse, le coût purement lié au modèle reste inférieur au tarif mensuel de 100 $ de Pro 100. Ce résultat montre seulement que la couche modèle est bon marché : il ne prend en compte ni l’infrastructure, ni les outils, ni le développement et la maintenance, ni la relecture humaine, et il ne tient pas compte des relances en cas d’échec.
3.3 Enregistrer par le code la consommation réelle de tokens des tâches des agents IA
Pour estimer les coûts, il faut remplacer les valeurs supposées par des mesures réelles. L’exemple minimal ci-dessous appelle le modèle une fois et lit le champ usage renvoyé :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface compatible OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-5.5",  # utiliser le nom exact figurant dans la liste des modèles APIYI
    messages=[{"role": "user", "content": "Résume les points clés de l'actualité de l'IA aujourd'hui"}]
)
print(resp.usage)  # nombre de tokens d'entrée et de sortie, pour le calcul des coûts
Voir l’implémentation complète : enregistrer chaque exécution et calculer le coût d’une tâche réussie
import time
import openai
from dataclasses import dataclass, field

# Prix par million de tokens (en dollars), à vérifier dans la console au moment de l'appel
PRICES = {
    "claude-opus-5.5":   {"input": 4.0, "output": 20.0, "cache_read": 0.20},
    "claude-sonnet-5.5": {"input": 2.0, "output": 10.0, "cache_read": 0.10},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class RunRecord:
    task_id: str
    model: str
    input_tokens: int
    output_tokens: int
    cached_tokens: int
    seconds: float
    cost: float
    passed: bool = False          # validation manuelle selon des critères d'acceptation communs
    review_minutes: float = 0.0   # temps de vérification et de correction humaines

@dataclass
class Ledger:
    runs: list = field(default_factory=list)

    def call(self, task_id: str, model: str, messages: list) -> str:
        start = time.time()
        resp = client.chat.completions.create(model=model, messages=messages)
        usage = resp.usage
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        p = PRICES[model]
        uncached_input = usage.prompt_tokens - cached
        cost = (uncached_input * p["input"]
                + cached * p["cache_read"]
                + usage.completion_tokens * p["output"]) / 1_000_000
        self.runs.append(RunRecord(task_id, model, usage.prompt_tokens,
                                   usage.completion_tokens, cached,
                                   time.time() - start, cost))
        return resp.choices[0].message.content

    def cost_per_success(self, hourly_rate: float, fixed_cost: float = 0.0) -> float:
        """(coût total des exécutions + coûts fixes + coût de la relecture humaine) / nombre de tâches validées"""
        api = sum(r.cost for r in self.runs)
        review = sum(r.review_minutes for r in self.runs) / 60 * hourly_rate
        passed_tasks = {r.task_id for r in self.runs if r.passed}
        if not passed_tasks:
            return float("inf")
        return (api + fixed_cost + review) / len(passed_tasks)

ledger = Ledger()
text = ledger.call("news-1116", "claude-sonnet-5.5",
                   [{"role": "user", "content": "Résume les points clés de l'actualité de l'IA aujourd'hui"}])
ledger.runs[-1].passed = True
ledger.runs[-1].review_minutes = 8
print(ledger.cost_per_success(hourly_rate=30, fixed_cost=0))
🚀 Conseil pour démarrer rapidement : pour mener une expérience comparative de coûts, vous pouvez d’abord appeler Opus puis Sonnet avec la même clé API sur APIYI apiyi.com, brancher le
Ledgerci-dessus dans votre agent, puis observer le registre après une semaine de vraies tâches. La plateforme facture à l’usage et les nouveaux utilisateurs disposent d’un quota de test gratuit, de quoi obtenir des données réelles de tokens avant d’investir dans le développement.
4 Pourquoi le coût d’un employé IA diverge selon le modèle
Dans l’échantillon hypothétique de la section 3, le coût modèle par tâche d’Opus 5.5 est le double de celui de Sonnet 5.5. En ne regardant que cette colonne, Sonnet permet d’économiser 33 $ par mois. Mais le coût final d’une tâche d’agent dépend aussi du taux de réussite et de la relecture humaine ; voici, avec un ensemble de paramètres hypothétiques, comment cet impact se manifeste.
Supposons qu’Opus réussisse 90 % de ses exécutions du premier coup, contre 60 % pour Sonnet, les tâches non conformes étant relancées jusqu’à réussite. En espérance, le coût modèle par tâche réussie s’établit respectivement à environ 0,22 $ ÷ 0,9 ≈ 0,24 $ et 0,11 $ ÷ 0,6 ≈ 0,18 $. L’écart de taux de réussite a donc déjà absorbé une bonne partie de l’avantage de prix unitaire.
L’impact du temps humain est encore plus marqué. Supposons que le coût horaire d’un relecteur soit de 30 $, soit environ 0,5 $ par minute. Il suffit que la sortie de Sonnet demande en moyenne une minute de correction supplémentaire par tâche pour que les 0,5 $ ajoutés dépassent tout l’écart de prix unitaire entre les deux modèles. Pour les tâches de renseignement et de rédaction de rapports qui exigent de vérifier les données ligne par ligne, le temps de relecture se compte souvent en minutes : choisir un modèle plus stable réduit alors le coût total.
À l’inverse, pour les tâches simples au format fixe et faciles à valider automatiquement (classification, résumé, extraction de champs), le taux de réussite du modèle bon marché peut être proche de celui du modèle coûteux ; il est alors plus raisonnable de recourir à Sonnet ou à un modèle moins cher. Dans un sens comme dans l’autre, ce jugement ne peut être posé qu’après avoir mesuré les taux de réussite sur de vraies tâches.
5 · Employés IA comparés sur six dimensions : Dots, Agent mono-modèle, Agent multi-modèles
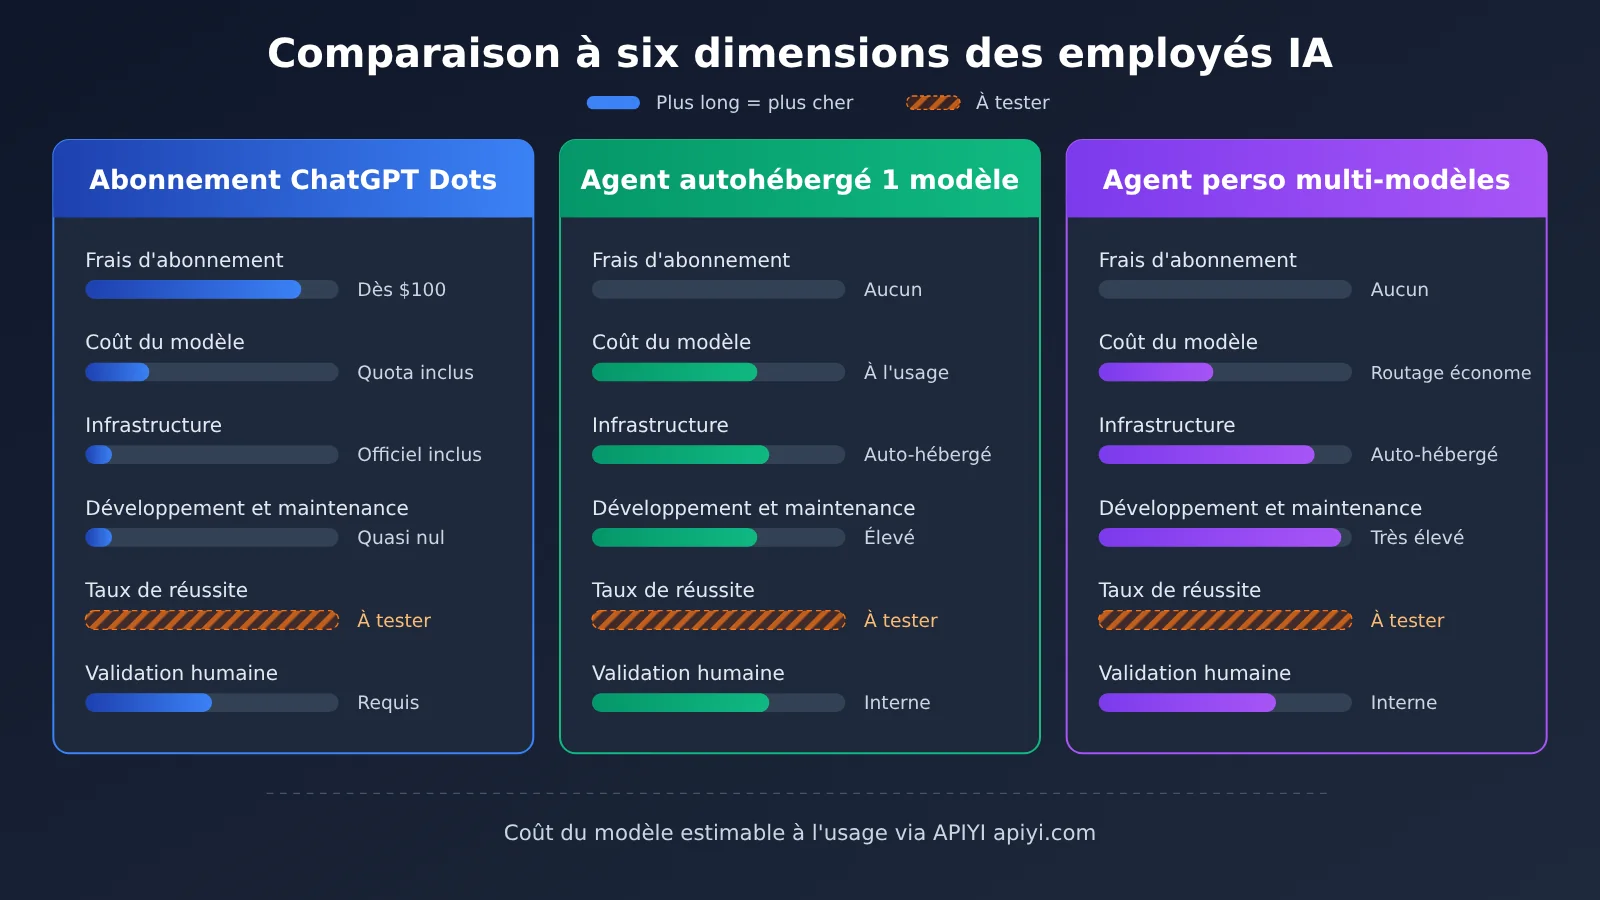
| Dimension | ChatGPT Dots | Agent mono-modèle (interne) | Agent multi-modèles (interne) |
|---|---|---|---|
| Coût de l’abonnement | Pro individuel à partir de 100 $/mois ; entreprise sur contrat | Aucun | Aucun |
| Coût des modèles | Inclus dans le quota d’abonnement ; la délégation à Work/Codex est décomptée séparément | Facturation au Token, croissance linéaire avec le volume de tâches | Facturation au Token, avec un routage selon la difficulté qui fait baisser le prix moyen |
| Infrastructure | Ordinateur et navigateur cloud fournis par le service officiel | Serveurs, base de données et environnement de navigateur à fournir soi-même | Comme le mono-modèle, plus une logique de routage et d’évaluation |
| Développement et maintenance | Développement quasi nul, surtout de la configuration de règles et de permissions | Investissement initial élevé, maintenance continue | Complexité de développement et de maintenance maximale |
| Taux de réussite des tâches | À mesurer sur vos propres tâches ; les tests de tiers montrent qu’une vérification humaine reste nécessaire | Dépend du modèle et de la qualité de l’implémentation, à mesurer | Dépend de la stratégie de routage, à mesurer |
| Validation humaine | Indispensable, avec l’aide des mécanismes Auto-review et d’approbation | Indispensable, le processus d’approbation est à construire | Indispensable, le processus d’approbation est à construire |
| Intégration des modèles | Intégrée aux produits OpenAI | Via l’interface unifiée d’APIYI | Une seule clé APIYI pour appeler plusieurs fournisseurs de modèles |
Analyse comparative de Dots : Dots possède un avantage net sur la mise en service immédiate, la collaboration entre applications et le contexte de long terme — l’ordinateur cloud, un écosystème de plus de 4 000 applications et la communication multicanale ne demandent aucun développement. Ses limites : des règles de quota qui ne descendent pas jusqu’au nombre de tâches, une logique d’exécution impossible à personnaliser en profondeur, et un Pro individuel soumis à des restrictions de région et d’âge.
Analyse comparative de l’Agent mono-modèle : sa structure de coûts est la plus lisible — les Token et le coût de chaque appel sont enregistrés avec précision, et la logique d’exécution est entièrement maîtrisée. Le prix à payer : il faut construire soi-même le navigateur, l’ordonnancement, la gestion d’état et les validations, et le taux de réussite repose entièrement sur les compétences d’ingénierie de l’équipe.
Analyse comparative de l’Agent multi-modèles : il confie les étapes simples à des modèles bon marché et les raisonnements critiques à des modèles puissants ; c’est sur de gros volumes de tâches qu’il a le plus de chances de faire baisser le coût par tâche réussie. C’est aussi celui qui exige le plus de son système d’évaluation : il faut suivre en continu le taux de réussite de chaque modèle sur chaque type d’étape.
6 Mesurer la rentabilité d’un « employé IA » par le coût d’une tâche réussie
6.1 Coût d’une tâche réussie et formule du ROI
Le référentiel de mesure unifié est le suivant :
$$C_{tâche\ réussie}=\frac{C_{toutes\ exécutions}+C_{infrastructure}+C_{revue}}{N_{tâches\ menées\ à\ bien}}$$
Le numérateur inclut toutes les exécutions (y compris les échecs et les relances), l’infrastructure répartie sur la période et la relecture humaine ; le dénominateur ne compte que les tâches livrées conformes. Pour Dots, les « frais d’exécution » du numérateur deviennent l’abonnement mensuel et la consommation supplémentaire.
On peut ensuite calculer le rapport investissement/résultat :
$$ROI=\frac{V_{temps\ gagné}-C_{total}}{C_{total}}$$
Le temps gagné doit être estimé à partir de la durée réelle qu’aurait prise la tâche en manuel, multipliée par un coût de main-d’œuvre raisonnable. Un modèle qui génère un document en quelques dizaines de secondes ne représente que la vitesse de génération : il faut retirer du temps gagné la part consacrée à la vérification et aux corrections.
6.2 Expérience comparée sur trois types de tâches
Je recommande de choisir trois tâches récurrentes représentatives : une veille quotidienne sur l’actualité de l’IA, une surveillance concurrentielle hebdomadaire et un rapport d’analyse mensuel. Avec les mêmes documents d’entrée et le même standard de livraison, on confie l’exécution tour à tour à ChatGPT Dots, à APIYI + un agent mono-modèle, puis à APIYI + un agent multi-modèles, en consignant à chaque exécution les éléments suivants :
| Élément consigné | Méthode de relevé | Utilité |
|---|---|---|
| Heures de début et de fin | Horodatage du journal de tâche | Calculer le cycle réel de livraison |
| Nombre d’appels au modèle | Comptage par la couche d’orchestration | Repérer les boucles et les appels excessifs |
| Tokens d’entrée / de sortie / en cache | Champ usage renvoyé par l’API |
Calculer le coût du modèle et le gain du cache |
| Nombre d’appels d’outils | Comptage par la couche d’outils | Calculer les frais de recherche, de navigateur, etc. |
| Échecs et relances | Classification des causes d’échec | Calculer la consommation supplémentaire |
| Temps de correction humaine | Chronométrage par le relecteur | Calculer l’apport humain réel |
| Résultat de la validation finale | Conforme / non conforme selon la liste préétablie | Calculer le taux de réussite et le dénominateur |
Côté Dots, on n’obtient pas le détail des tokens : on peut noter l’abonnement, la consommation du quota, le temps de réalisation, le temps de correction humaine et le résultat de validation. Les trois approches sont finalement ramenées à une même question : « combien d’argent et combien de minutes de main-d’œuvre pour chaque tâche conforme ». Je conseille de faire porter l’expérience sur au moins un cycle complet de rapport mensuel ; avec un échantillon trop petit, un échec isolé fausse lourdement les résultats.
7 Quand choisir un abonnement Dots et quand créer son propre agent IA de type « employé »
7.1 Utilisateurs individuels : privilégier l’abonnement Dots
- Délégation des tâches quotidiennes : pour les tâches inter-applications comme organiser l’agenda, préparer des réunions, trier les e-mails ou planifier un voyage, les connexions d’applications et l’ordinateur cloud de Dots sont directement disponibles.
- Ne pas vouloir maintenir un système : un agent développé en propre demande de gérer en continu les pannes et les mises à niveau ; pour un utilisateur individuel, le coût en temps dépasse souvent le prix de l’abonnement.
- Conditions préalables : respecter les exigences d’âge et de région, et accepter les règles de quota Pro ; si le volume de tâches mensuel est très faible, il faut comparer le seuil de $100 à la fréquence d’utilisation réelle.
7.2 Développeurs intensifs : privilégier le développement en propre ou une approche hybride
- Besoin d’une logique d’exécution sur mesure : extraction d’informations dans un format fixe, surveillance de sources de données spécifiques, intégration profonde avec les systèmes internes.
- Besoin d’un contrôle précis des coûts : choisir le modèle étape par étape, tirer parti du cache, comptabiliser chaque centime à partir des journaux d’appels.
- Compétences techniques déjà en place : capacité à mettre en place soi-même l’ordonnancement, la gestion d’état et les approbations ; le coût de développement peut être amorti sur des tâches de long terme.
7.3 Équipes d’entreprise : examiner les devis contractuels et les exigences de conformité
- Espace de travail Enterprise déjà en place : Dots peut être configuré de manière centralisée par un administrateur ; par défaut, les données des espaces de travail Business, Enterprise et Edu ne sont pas utilisées pour l’entraînement des modèles, et la facturation doit être calculée selon le devis de l’espace de travail.
- Besoin de se connecter à des systèmes internes ou à des processus privés : un agent développé en propre offre davantage de contrôle sur l’environnement d’exécution, les flux de données et les journaux d’audit.
- Tâches standardisées à grande échelle : lorsque le volume de tâches est suffisamment important et les processus suffisamment stables, un agent développé en propre et multi-modèles a plus de chances de réduire le coût par tâche, à condition de le valider par des expériences contrôlées.
8. Solution hybride pour les « employés IA » : combiner abonnement et appels API à l’usage
Abonnement et API peuvent se répartir le travail selon la nature des tâches, chacun prenant la part qu’il fait le mieux :
- Interactions quotidiennes et tâches demandant un jugement humain : confiez-les à Dots ou à votre abonnement ChatGPT existant, en profitant de son contexte de long terme et de ses mécanismes de validation.
- Tâches par lots stables et vérifiables automatiquement : passez par l’API en paiement à l’usage et laissez des modèles bon marché s’en occuper.
- Raisonnement difficile et conclusions critiques : appelez des modèles plus puissants, en payant le prix fort pour réduire le taux de reprise.
- Pics de charge : quand le quota d’abonnement devient tendu, basculez vers l’appel à l’usage les tâches qui peuvent sortir de l’abonnement.
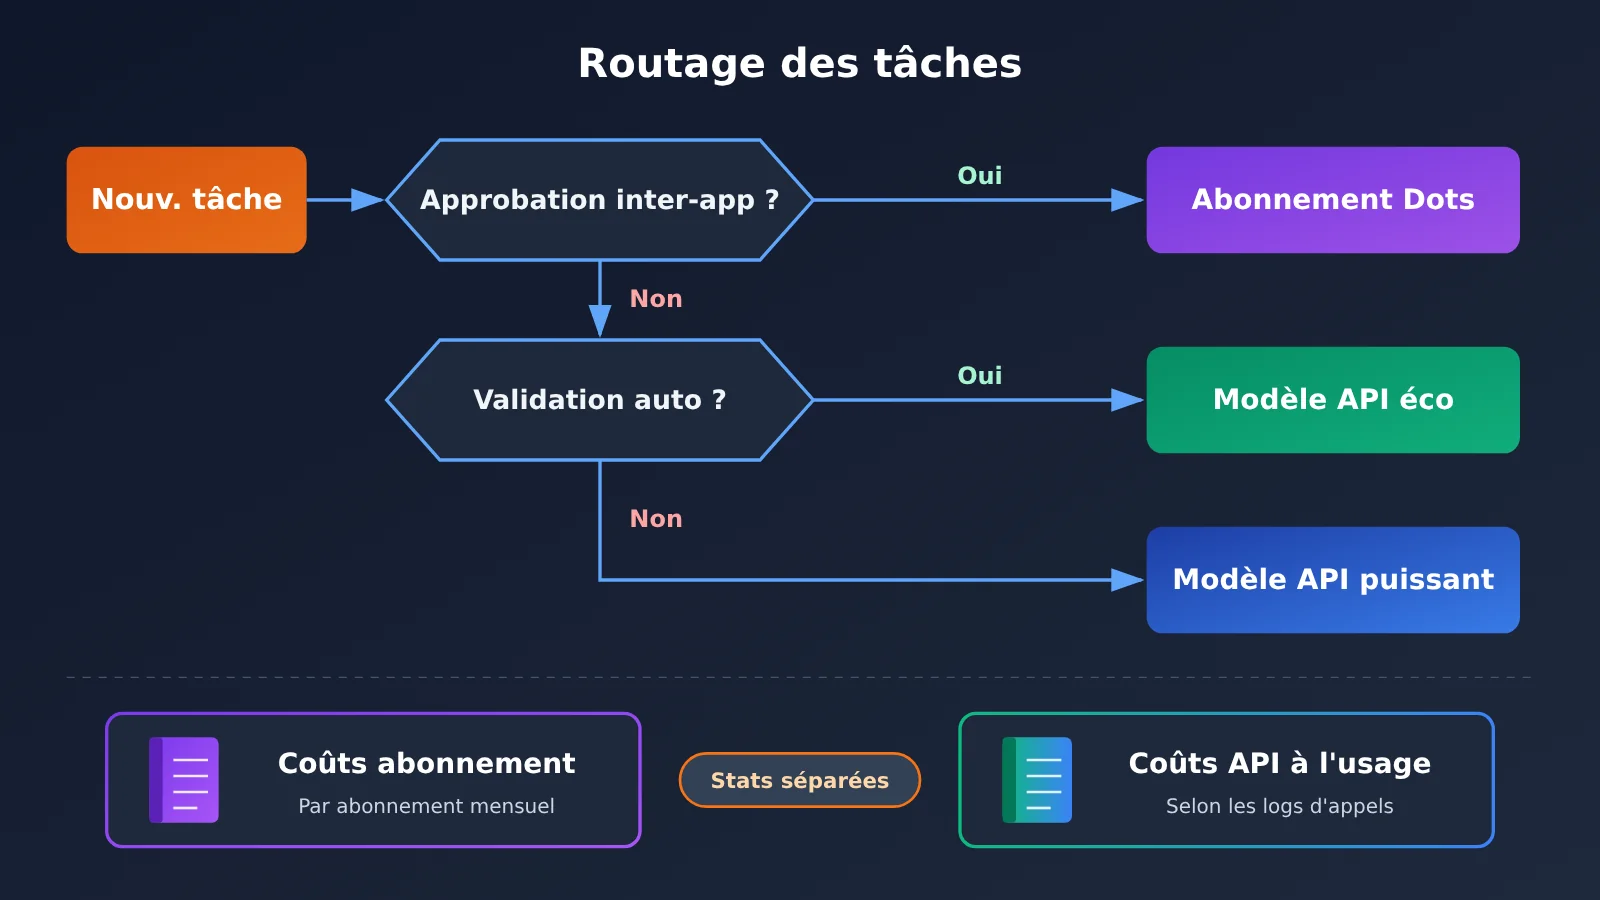
Le point clé d’une solution hybride, c’est de tenir des comptes séparés : les dépenses d’abonnement sont imputées au forfait mensuel, les dépenses API aux journaux d’appels, et une même tâche n’est comptée que sur la route qui l’a réellement exécutée, pour éviter les doubles comptages.
💡 Conseil de décision : commencez par confier le quotidien à Dots ou à votre abonnement actuel, tout en repérant 1 à 2 catégories de tâches standardisées que vous branchez via APIYI apiyi.com sur plusieurs modèles pour des expérimentations comparatives. Décidez ensuite, à partir des données de coût des tâches réussies sur un mois, quelles tâches migrer vers l’API et lesquelles garder sous abonnement : c’est plus prudent que de choisir d’emblée l’un ou l’autre pour tout.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que ChatGPT Dots ?
ChatGPT Dots est un Agent IA personnel permanent lancé par OpenAI le 29 septembre 2026. Il dispose de son propre ordinateur cloud et de son propre navigateur, peut faire avancer les tâches déléguées au fil des sessions et des applications, et rend la main de sa propre initiative lorsqu’une décision de l’utilisateur est nécessaire.
Q2 : Combien coûte Dots chaque mois pour un usage personnel ?
Au 16 novembre 2026, les utilisateurs individuels doivent s’abonner à ChatGPT Pro. Les tarifs mensuels de Pro 100, Pro 200 et Pro 500 sont respectivement de 100 $, 200 $ et 500 $. Les trois formules donnent accès à Dots, et l’éditeur ne prévoit pas de frais mensuels distincts pour Dots. Les tâches Work ou Codex déléguées sont décomptées selon le quota du produit correspondant.
Q3 : Comment Dots est-il facturé en version entreprise ?
Les espaces de travail d’entreprise éligibles peuvent choisir un tarif fixe par type de travail ou une facturation à l’usage. Les montants exacts dépendent du contrat ou du devis applicable à l’espace de travail. Du 4 au 18 novembre 2026 se déroule une période d’aperçu administrateur gratuite ; les Dots activés à partir du 18 novembre commencent à être facturés, et les tâches déléguées à Work ou Codex sont facturées séparément.
Q4 : Si le coût du modèle d’un Agent développé en interne est inférieur à 100 $, est-ce moins cher que Dots ?
Il faut aussi ajouter les serveurs, les bases de données, les outils de recherche et de navigateur, le développement et la maintenance, ainsi que la relecture humaine, sans oublier l’impact des relances après échec. Ce n’est qu’en comparant le coût par tâche réussie sur le même lot de tâches et selon les mêmes critères d’acceptation que l’on peut déterminer quelle approche revient moins cher.
Q5 : Comment estimer rapidement le coût du modèle d’un Agent développé en interne avec l’API ?
Voici les étapes à suivre :
1. S’inscrire sur APIYI (apiyi.com), obtenir une clé API et récupérer le crédit d’essai réservé aux nouveaux utilisateurs.
2. Dans le code de cet article, définir `base_url` sur `https://api.apiyi.com/v1`, puis brancher Ledger pour consigner les tokens de chaque appel.
3. Utiliser de vraies tâches pour appeler séparément Opus 5.5 et Sonnet 5.5, noter les résultats d’acceptation et le temps de correction humaine, puis calculer le coût par tâche réussie.
Q6 : Quel est l’impact du cache sur le coût d’un Agent ?
Lors des appels multi-tours d’un Agent, les invites système et les définitions d’outils sont renvoyées à plusieurs reprises. Lorsqu’elles sont servies depuis le cache, la facturation se fait au tarif de lecture du cache. Pour la série Claude 5.5, ce tarif de lecture du cache représente environ un vingtième de celui d’une entrée normale. Dans l’échantillon hypothétique de cet article, lorsque deux tiers des entrées sont servies depuis le cache, le coût du modèle par tâche diminue d’environ un tiers. Le tarif d’écriture dans le cache est celui indiqué dans la console.
Q7 : Dots peut-il remplacer complètement les humains ?
La documentation officielle et les tests menés par des tiers montrent que les résultats de Dots nécessitent une vérification humaine. Dans le test d’Axios, la brochure de programme produite par Dots contenait des données douteuses. Les opérations impliquant des comptes et des fonds doivent toujours être reprises par l’utilisateur. Le coût de la vérification humaine doit donc toujours être inclus dans le coût total.
Q8 : Dots peut-il traiter un nombre illimité de tâches en parallèle ?
Dots prend en charge plusieurs projets et des Agents en arrière-plan en parallèle, mais l’environnement d’exécution et les quotas d’utilisation ont des limites. Un utilisateur de Reddit raconte avoir rencontré un environnement d’exécution indisponible au moment de lancer une tâche indépendante, et n’avoir pu poursuivre qu’après avoir connecté son ordinateur Linux local. Il précise aussi ne pas avoir pu confirmer comment les quotas sont calculés pour chaque chemin d’exécution.
Points clés sur le coût d’un employé IA
- Base de comparaison : mesurez le coût de la tâche réussie selon un même standard de livraison — l’abonnement mensuel et le prix unitaire des tokens ne sont qu’un élément parmi d’autres.
- Particuliers et entreprises : deux calculs distincts : l’offre Pro pour les particuliers démarre à 100 $/mois ; pour les entreprises, Dot facture selon le type de travail ou le volume d’usage, conformément au contrat.
- L’abonnement inclut l’environnement : ordinateur cloud, contexte longue durée, connexions aux applications et mécanismes de validation — autant de coûts qu’il faudrait couvrir en construisant sa propre solution.
- Les frais de modèle ne sont qu’une couche : dans l’échantillon hypothétique, 300 tâches par mois coûtent 33 à 66 $ en frais de modèle, hors infrastructure et main-d’œuvre.
- Le taux de réussite détermine le coût réel : chaque minute supplémentaire de correction manuelle peut à elle seule effacer tout l’écart de prix unitaire entre les deux modèles.
- L’usage hybride offre plus de souplesse : déléguez le quotidien via l’abonnement, et passez les tâches standardisées en batch par APIYI à l’usage, avec une comptabilité séparée.
En résumé
Dépenser 100 dollars par mois pour un employé IA est-il rentable ? Tout dépend des tâches que vous lui confiez et de vos critères d’acceptation :
- La valeur de Dots réside dans sa capacité de travail continu, prête à l’emploi : ordinateur cloud, collaboration inter-applications et contexte longue durée suppriment le développement et la maintenance — idéal pour les particuliers et les équipes qui veulent une faible charge de maintenance.
- L’avantage d’un agent auto-construit, c’est le contrôle et la traçabilité des coûts : logique d’exécution personnalisable, chaque appel facturable et traçable — adapté aux équipes techniquement solides dont les tâches sont bien standardisées.
- La décision finale passe par une expérimentation comparative : sur trois types de tâches réelles, enregistrez les tokens, les tentatives et le temps de correction manuelle, puis comparez le coût total par tâche conforme.
Notre conseil : gardez d’abord votre abonnement actuel pour le travail quotidien, tout en choisissant une catégorie de tâches standardisées pour un test comparatif via API. Nous recommandons de passer par APIYI apiyi.com pour accéder à plusieurs modèles avec une seule clé API, payer à l’usage et enregistrer la consommation réelle — puis laisser les données décider quelles tâches méritent d’être migrées.
📚 Sources et références
-
OpenAI : Introducing Dots : annonce du lancement de Dots, positionnement du produit, ordinateur cloud et écosystème d’applications
- Lien :
openai.com/index/introducing-dots - À propos : source officielle de première main, publiée le 2026-09-29
- Lien :
-
ChatGPT Learn : Meet Dots / Tasks and memory : présentation du produit, conditions d’éligibilité à l’abonnement, tâches de longue durée et mécanisme de mémoire
- Lien :
learn.chatgpt.com/docs/dots - À propos : documentation de référence sur les agents en arrière-plan, la recherche proactive et les tâches planifiées
- Lien :
-
ChatGPT Learn : guide administrateur Enterprise Dots : activation et facturation des espaces de travail d’entreprise
- Lien :
learn.chatgpt.com/docs/enterprise/dots-admin-guide - À propos : explications en vigueur sur le tarif fixe et la facturation à l’usage en entreprise
- Lien :
-
OpenAI Help Center : About ChatGPT Pro tiers : prix et règles de quota des offres Pro 100 / 200 / 500
- Lien :
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - À propos : base officielle des tarifs des abonnements individuels
- Lien :
-
OpenAI Help Center : FAQ confidentialité, sécurité et sûreté de Dots : autorisations, validations, Auto-review et politiques de données
- Lien :
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - À propos : lecture indispensable pour évaluer la revue humaine et le coût lié à la sécurité
- Lien :
-
Axios : I tested Dots and Muse : test indépendant de Dots et de Meta Muse
- Lien :
axios.com/2026/10/20/battle-of-bots-openai-meta-ai-agents-test - À propos : performances concrètes sur différentes tâches et cas d’échec
- Lien :
-
APIYI : les quotas des forfaits de tokens ne sont pas directement comparables : méthode de calcul en cinq étapes pour comparer abonnement et paiement à l’usage
- Lien :
help.apiyi.com/token-plan-quota-subscription-vs-pay-as-you-go.html - À propos : cadre de calcul du coût équivalent par tâche
- Lien :
-
Grille tarifaire des modèles APIYI : prix actuels des modèles, Claude compris
- Lien :
docs.apiyi.com/models - À propos : avant tout appel réel, c’est cette page et la console qui font foi
- Lien :
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources sur l’intégration des modèles et la facturation, consultez le centre de documentation docs.apiyi.com