Conclusion
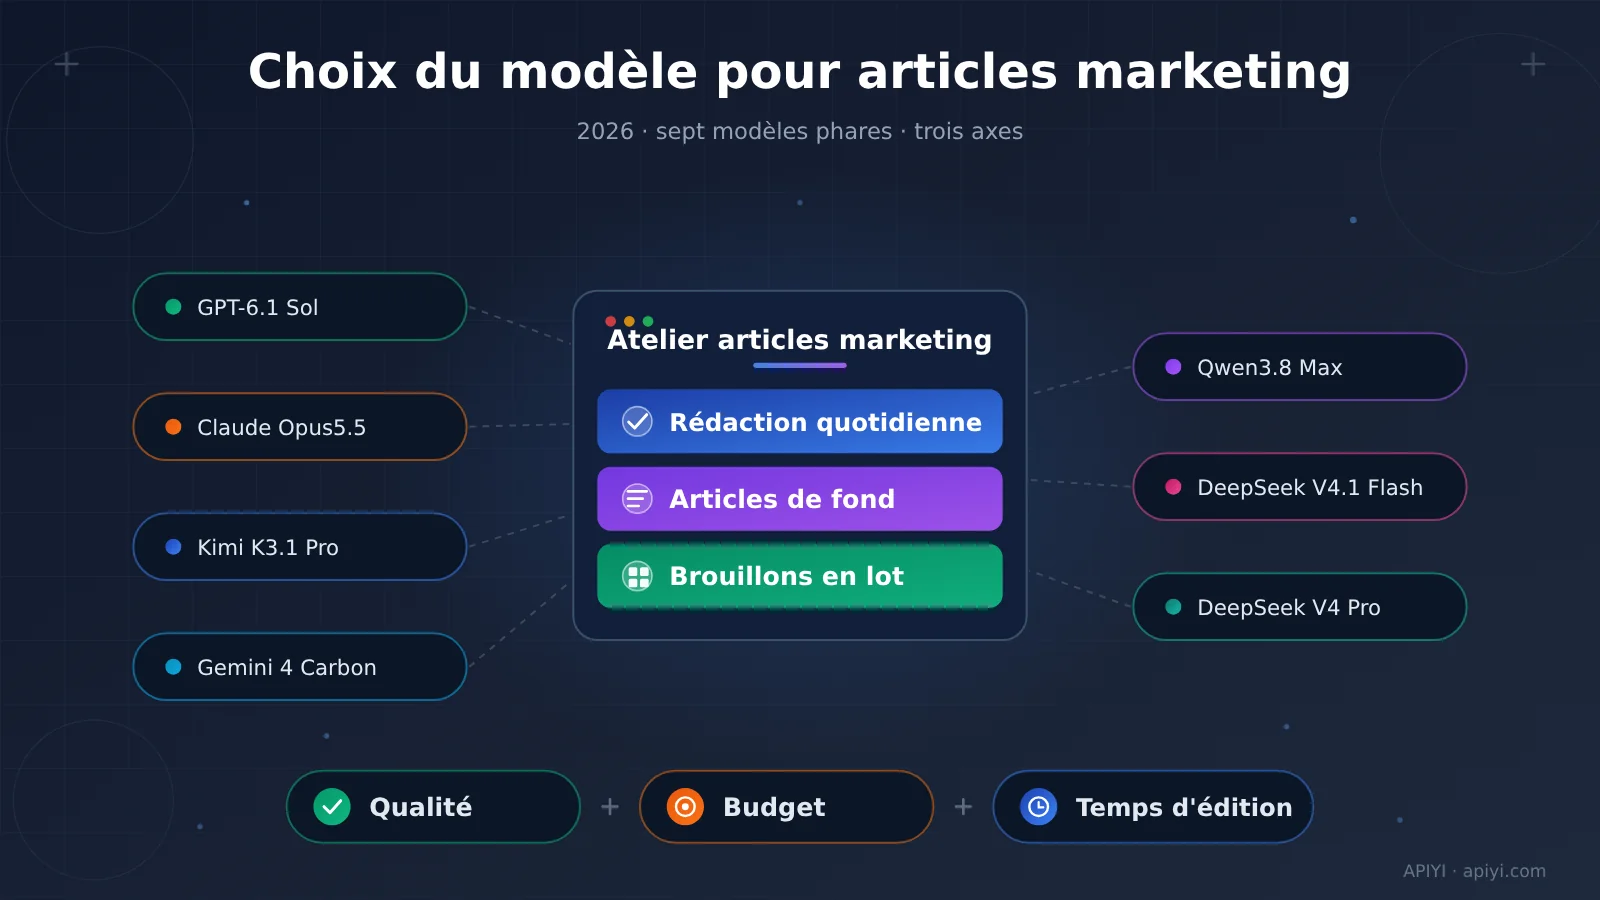
Pour les articles quotidiens, commencez par tester GPT-6.1 Sol ; pour les articles longs importants, testez d’abord Claude Opus 5.5 ; pour les brouillons en lot, testez d’abord DeepSeek V4.1 Flash. Pour les tâches gourmandes en documentation, ajoutez Kimi et Gemini ; pour la production structurée, ajoutez Qwen ; quant à DeepSeek Pro, validez-le en fonction de la tâche précise.
Ce ne sont là que des candidats à tester, pas un classement des champions de l’écriture en chinois. La combinaison réellement rentable doit tenir compte à la fois de la compréhension des documents, de la qualité des articles, du coût des appels et du temps de relecture et de correction.
Ce que nous verrons plus loin
- Ce que révèlent respectivement les trois types de tests d’écriture.
- Quelles différences concrètes existent entre les sept modèles.
- Comment organiser, selon les différentes tâches opérationnelles, un modèle principal et un modèle de secours.
- Comment calculer les coûts et réaliser un test à l’aveugle via une interface unifiée.
Quel grand modèle choisir pour rédiger des articles opérationnels : commencer par comprendre le protocole de test
Un benchmark de modèle est un ensemble de tests qui mesurent les performances d’un modèle sur des tâches standardisées. Pour un choix opérationnel, il faut privilégier les tests proches du flux de production réel : mêmes documents, même planification, même longueur, puis comparer les textes finalisés.
Quel grand modèle choisir pour rédiger des articles marketing : les scores en anglais servent à filtrer les candidats
L’AI Writing Benchmark a été mis à jour le 11 novembre 2026. Il repose sur des tâches de rédaction en anglais communes et sur une comparaison à modèles anonymisés, couvrant 115 modèles et 131 507 évaluations à l’aveugle.
Le score global en anglais de GPT-6.1 Sol est de 95.3, et son score sur la catégorie articles, blogs et édition atteint 98.5. Claude Opus 5.5 et Kimi K3.1 Pro obtiennent respectivement 92.9 et 91.9 au score global : ce sont les scores de référence.
Autrement dit, GPT mérite une place dans le vivier de candidats pour l’écriture de blogs ; reste à savoir, par des tests locaux, combien de relectures un article de blog en chinois demandera. Le projet est maintenu par une seule personne, il faut donc aussi tenir compte de la langue et de la méthode d’évaluation dans le jugement.
Attention surtout aux versions : dans la catégorie explication et vulgarisation, c’est Kimi K3 qui mène ; dans ToneBench, le score de 89.0 sur le critère « moins de ton stéréotypé » correspond à GPT-6 Sol. Ces deux résultats relèvent d’anciens noms de versions.
Quel grand modèle choisir pour rédiger des articles marketing : le test de scripts est plus proche de la rédaction à partir d’un dossier
L’instantané ToneBench du 10 novembre 2026 évalue la rédaction de scripts pour vidéos longues en anglais : le modèle lit les consignes de création et le dossier de recherche, puis génère sans accès externe, sur 87 modèles, 151 configurations et 7 550 scripts.
Le tableau ci-dessous extrait le Writing Score des configurations retenues. Claude est en configuration xhigh ; chaque ligne reprend la configuration de raisonnement propre au test concerné, sans budget de calcul unifié. On ne liste donc ici que les scores, sans mélanger les classements de modèles et les classements de configurations.
| Modèle | Writing Score | Coût estimé par script dans le test |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5, xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash, version 1017 | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
Le signal principal : Opus est à tester en priorité pour des textes longs de haute qualité, tandis que Flash montre une compétitivité à bas coût. Les montants du tableau correspondent à la charge de travail de script de ce test ; ils ne se transposent pas directement en devis pour un article marketing en chinois.
Le test utilise une évaluation par modèle, avec un biais possible en faveur de certains éditeurs ; les intervalles de confiance des configurations de tête se chevauchent, et une variation des scripts de référence peut aussi changer le classement. Il sert à réduire le vivier de candidats, avant validation par un éditeur.
Note sur l’illustration : ci-dessous, la répartition des candidats selon la qualité et le coût ; les données proviennent de l’instantané ToneBench cité plus haut. Lors d’un retest via APIYI apiyi.com, il faut consigner séparément ses propres tokens, sa configuration et son temps d’édition.
Quel grand modèle de langage choisir pour rédiger des articles marketing : ce que disent les preuves en chinois sur le périmètre d’application
OmniTools a testé, du 26 octobre au 3 novembre 2026, la rédaction d’articles financiers approfondis en chinois : 10 modèles ont produit au total 26 articles. La note d’Opus 5.5 en évaluation aveugle par IA a atteint 8.25, contre 6.33 pour GPT-6.1 Sol.
Voilà un argument en faveur d’Opus pour les articles longs en chinois. Mais l’échantillon reste petit, le nombre d’articles varie d’un modèle à l’autre, et le testeur est adossé à un service de routage commercial : la conclusion doit donc se limiter à ce cas précis d’article financier long.
Quel grand modèle de langage choisir pour rédiger des articles marketing : les 7 modèles passés en revue un par un
Quel grand modèle de langage pour rédiger des articles marketing : comment répartir les rôles entre GPT et Claude
GPT-6.1 Sol : candidat prioritaire pour la production courante. Il sort des résultats remarquables dans la catégorie des articles en anglais, ce qui en fait un bon point de départ pour tester des blogs tech, des analyses produit et des décryptages d’actualité. La naturalité du chinois et l’exactitude des citations, elles, doivent être notées séparément.
Claude Opus 5.5 : candidat prioritaire pour les articles longs importants. Les tests sur script et le cas des articles financiers en chinois le soutiennent tous les deux. Pour les dossiers de fond et les articles de marque au long cours, autant commencer par lui ; pour les textes courts à haute fréquence, mieux vaut vérifier si le gain de qualité justifie un coût plus élevé.
Quel grand modèle de langage pour rédiger des articles marketing : comment utiliser Kimi, Gemini et Qwen
Kimi K3.1 Pro : candidat pour les tâches à base documentaire longue. Sa fenêtre de contexte d’environ 1 M de tokens et ses résultats en rédaction générale en anglais plaident pour l’intégrer aux tests d’articles à forte densité de connaissances. Les résultats de K3 dans la catégorie vulgarisation scientifique, eux, sont à considérer à part.
Gemini 4 Carbon : candidat pour l’analyse de documents complexes. On peut d’abord lui demander de démêler un problème en plusieurs étapes, de relier les preuves entre elles et de proposer un plan, puis comparer avec ce qu’il produit en rédaction directe. Les éléments dont on dispose aujourd’hui suffisent surtout à en faire un candidat.
Qwen3.8 Max : candidat pour la production structurée. Il peut être testé sur des descriptions produit, des rubriques récurrentes et des contenus sous template. Sa limite de contexte par requête en inférence par lots est de 256K : vérifiez la disponibilité par région avant de l’intégrer.
Quel grand modèle de langage pour rédiger des articles marketing : comment choisir entre DeepSeek Flash et Pro
DeepSeek V4.1 Flash : candidat prioritaire pour les premières versions à faible coût. Dans le test sur script cité plus haut, il combine bon score et coût maîtrisé, ce qui le destine aux premières versions en volume, aux réécritures et aux explications de notions. Gardez une vérification humaine des faits avant publication.
DeepSeek V4 Pro : candidat pour des tâches spécifiques. Son API reste disponible, mais dans ce test sur script, c’est Flash qui a obtenu le meilleur score. Cela ne vaut la peine d’augmenter le budget que si un test en aveugle sur une tâche précise démontre un bénéfice réel.
Quel grand modèle choisir pour rédiger des articles marketing : une approche par tâches en plusieurs niveaux
Voici l’ordre de test établi à partir des preuves disponibles ; l’adoption des résultats en chinois est tranchée par une évaluation à l’aveugle de l’équipe.
| Tâche marketing | Candidat prioritaire | Solution alternative ou complémentaire |
|---|---|---|
| Actualités tech, blogs du quotidien | GPT-6.1 Sol | Flash produit une première version, GPT la retravaille |
| Analyses sectorielles approfondies, articles de marque longs | Claude Opus 5.5 | Test à l’aveugle sur le même sujet avec GPT |
| Tutoriels techniques, vulgarisation | GPT, Kimi K3.1 Pro | Flash comme référence à faible coût |
| Synthèse de documents longs, sujets complexes | Kimi, Gemini | D’abord organiser les preuves, puis les confier au modèle de rédaction finale |
| Articles marketing, contenus courts pour les réseaux sociaux | GPT pour tester d’abord les contenus courts | Ajouter Opus pour les articles de marque longs |
| Contenus structurés en volume | Qwen, Flash | Déterminer le modèle principal selon le taux d’adoption |
| Plateformes disponibles | Interfaces officielles correspondantes | Appel et comparaison unifiés via APIYI apiyi.com |
Le modèle anglais leader dans la catégorie marketing et ventes est Claude Sonnet 5.5, qui se situe en dehors de ces sept modèles. Si la rédaction marketing est au cœur de votre activité, mieux vaut élargir le vivier de candidats plutôt que de chercher le champion uniquement parmi les modèles taillés pour les longs articles.
Conseil pour bien démarrer : APIYI apiyi.com propose une interface compatible OpenAI qui permet d’appeler plusieurs modèles avec une seule clé API, et les nouveaux utilisateurs disposent d’un crédit de test gratuit. Commencez par comparer trois modèles sur le même sujet, puis élargissez le champ des tests.
Quel grand modèle de langage choisir pour rédiger des articles marketing : calculer le coût jusqu’au manuscrit validé
Le token est l’unité de mesure utilisée par le modèle pour traiter le texte : les tokens d’entrée couvrent l’invite, les documents et le contexte, tandis que les tokens de sortie couvrent le contenu généré. La fenêtre de contexte, elle, désigne la plage traitable en un seul appel.
Nous utilisons ci-dessous un instantané tarifaire APIYI du 12 novembre 2026 à 10:45, UTC+8, exprimé en dollars par million de tokens. Les exemples sont systématiquement calculés sur la base de 10 000 tokens d’entrée et 3 000 tokens de sortie.
| Modèle | Prix d’entrée | Prix de sortie | Coût de l’exemple |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
La méthode de calcul est la suivante : « quantité d’entrée ÷ million × prix d’entrée + quantité de sortie ÷ million × prix de sortie ». Ce tableau compare le coût de base d’une génération unique ; les nouvelles tentatives, la relecture et le temps d’édition sont à compter à part.
Les différences de routage modifient aussi la facture et les fonctionnalités :
- Tarifs régionaux officiels de Qwen : Singapour à $2 / $6 ; Pékin et Virginie (États-Unis) à $1.65 / $4.951.
- Gemini en connexion directe officielle : tarif de lancement jusqu’au 30 novembre ; à partir du 1er décembre, $4 / $20, les tokens de raisonnement étant facturés comme des tokens de sortie. Pour les fournisseurs tiers, vérifier selon leurs propres annonces.
- DeepSeek en connexion directe officielle : tarif réduit de moitié aux heures creuses, vérifier les plages applicables selon les règles officielles.
- Capacités de traitement par lots de Kimi : les règles de lot du canal Moonshot doivent être confirmées séparément ; la documentation Aliyun de K3.1 Pro indique que l’inférence par lots n’est pas prise en charge.
Le cache d’invites consiste à réutiliser les entrées répétées et à les facturer selon les règles du fournisseur. Une interface unifiée facilite le changement, mais le cache, la recherche, les modes de raisonnement et les capacités de traitement par lots doivent encore être vérifiés route par route.
Quel grand modèle choisir pour rédiger des articles marketing : comment mener un vrai test à l’aveugle
Un appel minimal suffit pour vérifier que l’interface répond bien. L’exemple ci-dessous se limite à la génération de texte, sans activer la recherche ni aucun autre outil.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
Pour une comparaison complète, il faut utiliser les mêmes sources et la même tâche, avec au moins trois générations indépendantes par modèle. On conserve ensuite les textes produits et les consommations de tokens ; au moment de l’évaluation, les étiquettes des modèles sont masquées, puis l’éditeur note le temps de révision et le sort réservé à chaque texte.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
Je vous conseille d’évaluer l’exactitude factuelle, la qualité de l’exécution éditoriale, le naturel du chinois, la lisibilité et l’apport réel de contenu. Notez aussi le taux de conservation par l’éditeur et le coût par article publiable : si un brouillon bon marché doit être entièrement réécrit, vous économisez quelques piécettes et vous y laissez votre après-midi.
Quel grand modèle choisir pour rédiger des articles marketing : questions fréquentes
Budget serré : quels modèles tester en premier ?
Commencez par comparer Flash, GPT et Opus : vous couvrez ainsi le faible coût, la rédaction courante et les longs articles stratégiques. Passer d’un modèle à l’autre via APIYI apiyi.com réduit le travail de configuration qu’imposeraient des intégrations séparées.
Une seule interface suffit-elle à rendre la comparaison parfaitement équitable ?
APIYI apiyi.com permet d’unifier la forme des appels ; pour l’équité, il faut aussi des sources, des droits d’accès aux outils, une longueur et des paramètres de raisonnement identiques. Notez la version du modèle et le point de terminaison, pour éviter de mélanger des conditions de travail différentes.
Quel grand modèle choisir pour rédiger des articles d’opérations : recommandations finales
Adoptez une sélection par niveaux : des candidats à faible coût pour les brouillons courants, des candidats de haute qualité pour les articles importants, la vérification des faits confiée à un processus de contrôle indépendant, et une validation humaine maintenue. Au final, la recommandation de modèle doit obéir au taux d’adoption réel de l’équipe.
Nous vous conseillons de valider cette combinaison via APIYI apiyi.com, de tester à l’usage (au volume) et de vérifier les prix les plus récents. Le but d’une sélection n’est pas de confier tout le travail au champion du classement, mais de produire régulièrement des articles conformes.
Références
- AI Writing Benchmark : aiwritingbenchmark.com, mis à jour le 11 novembre 2026.
- ToneBench : benchmark.towardsai.com/models/, instantané du 10 novembre 2026.
- Test pratique d’OmniTools sur les textes longs en chinois : omnitools.ai/evals/longform-writing.
- Prix officiels d’Alibaba Cloud : alibabacloud.com/help/en/model-studio/model-pricing, consulté le 12 novembre 2026.
- Ajustement officiel des tarifs Gemini : blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
Auteur : l’équipe de contenu technique d’APIYI. N’hésitez pas à échanger avec nous sur l’invocation de modèles et l’évaluation d’articles d’opérations sur apiyi.com ; pour toute comparaison, merci de préciser la version, la configuration et le périmètre des tâches.