Note de l’auteur : selon quatre catégories de tâches — terminal et dépôt de code, tâches bureautiques longues, documents longs multimodaux et coût — nous comparons les scores de benchmark, les spécifications, le tarif du cache et le coût de migration de Qwen4-Max et Claude Opus 5.5, avec des recommandations de choix opérationnelles.
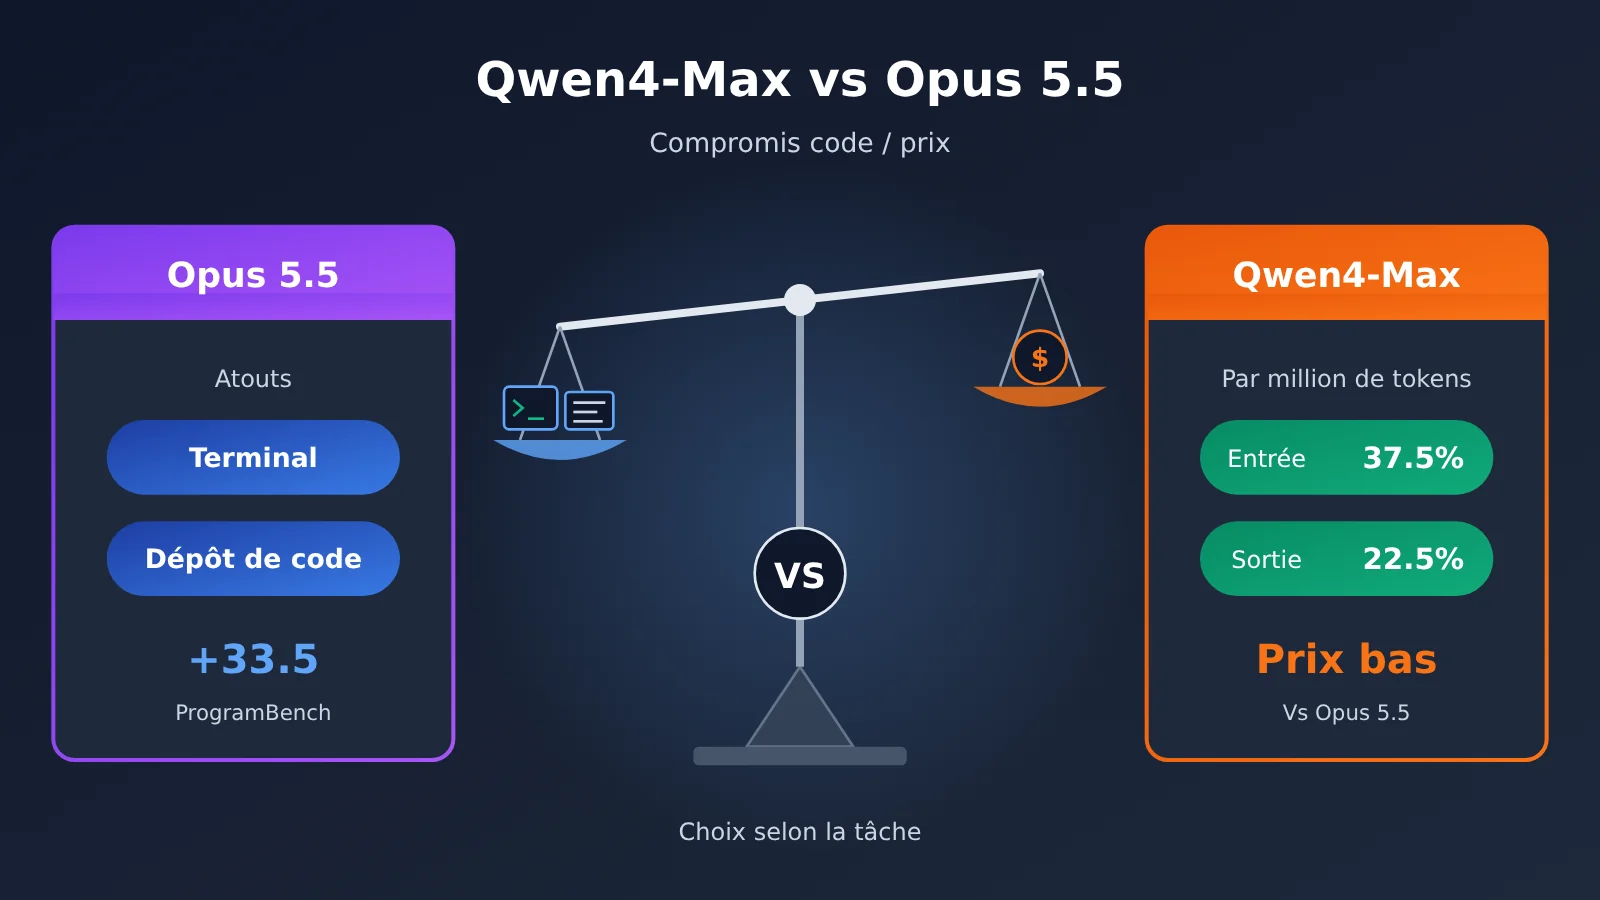
Si votre équipe a déjà fait de Claude Opus 5.5 son modèle principal, en production dans Claude Code ou dans vos propres agents, alors Qwen4-Max, publié le 2026-11-16, va vous obliger à refaire vos calculs : son tarif d’entrée ne représente que 37,5 % de celui d’Opus 5.5, et son tarif de sortie 22,5 %.
Le verdict d’abord, sans compromis : les opérations sur terminal et la refactorisation à l’échelle du dépôt restent sur Opus 5.5 — Qwen4-Max accuse un retard de 33,5 points sur ProgramBench, c’est la faiblesse la plus marquante de cette comparaison ; l’automatisation de workflows, les agents à forte concurrence et sensibles au coût, ainsi que les tâches documentaires à sortie très longue peuvent être testés en priorité sur Qwen4-Max ; les livrables bureautiques, les graphiques et la compréhension vidéo conservent un avantage net pour Opus 5.5.
L’essentiel : à la fin de cet article, vous disposerez d’un tableau d’arbitrage par type de tâche, et vous saurez précisément ce qui distingue les deux modèles en matière de tarif du cache, de niveau de raisonnement par défaut et d’étapes concrètes de migration.
Qwen4-Max vs Opus 5.5 : l’essentiel des différences
Commençons par clarifier la provenance des chiffres. Les données de cet article viennent de trois sources distinctes, qu’il ne faut pas mélanger :
- Comparaison sur la même figure, publiée par Qwen lui-même : dans son billet d’annonce, Alibaba présente sur une même image les scores de Qwen4-Max et d’Opus 5.5. Il s’agit de mesures réalisées par le fournisseur, et non d’une reproduction par un tiers.
- Instantané d’un classement public, 2026-11-14 : le classement Code Arena WebDev d’arena.ai, fondé sur des votes publics.
- Documentation Anthropic originale : les spécifications et les tarifs d’Opus 5.5 proviennent de la page modèle et de la grille tarifaire officielles d’Anthropic.
Le tableau ci-dessous condense les conclusions de l’article ; les sections suivantes détaillent les éléments qui les étayent, point par point.
| Type de tâche | Recommandation | Justification clé | Raison en une phrase |
|---|---|---|---|
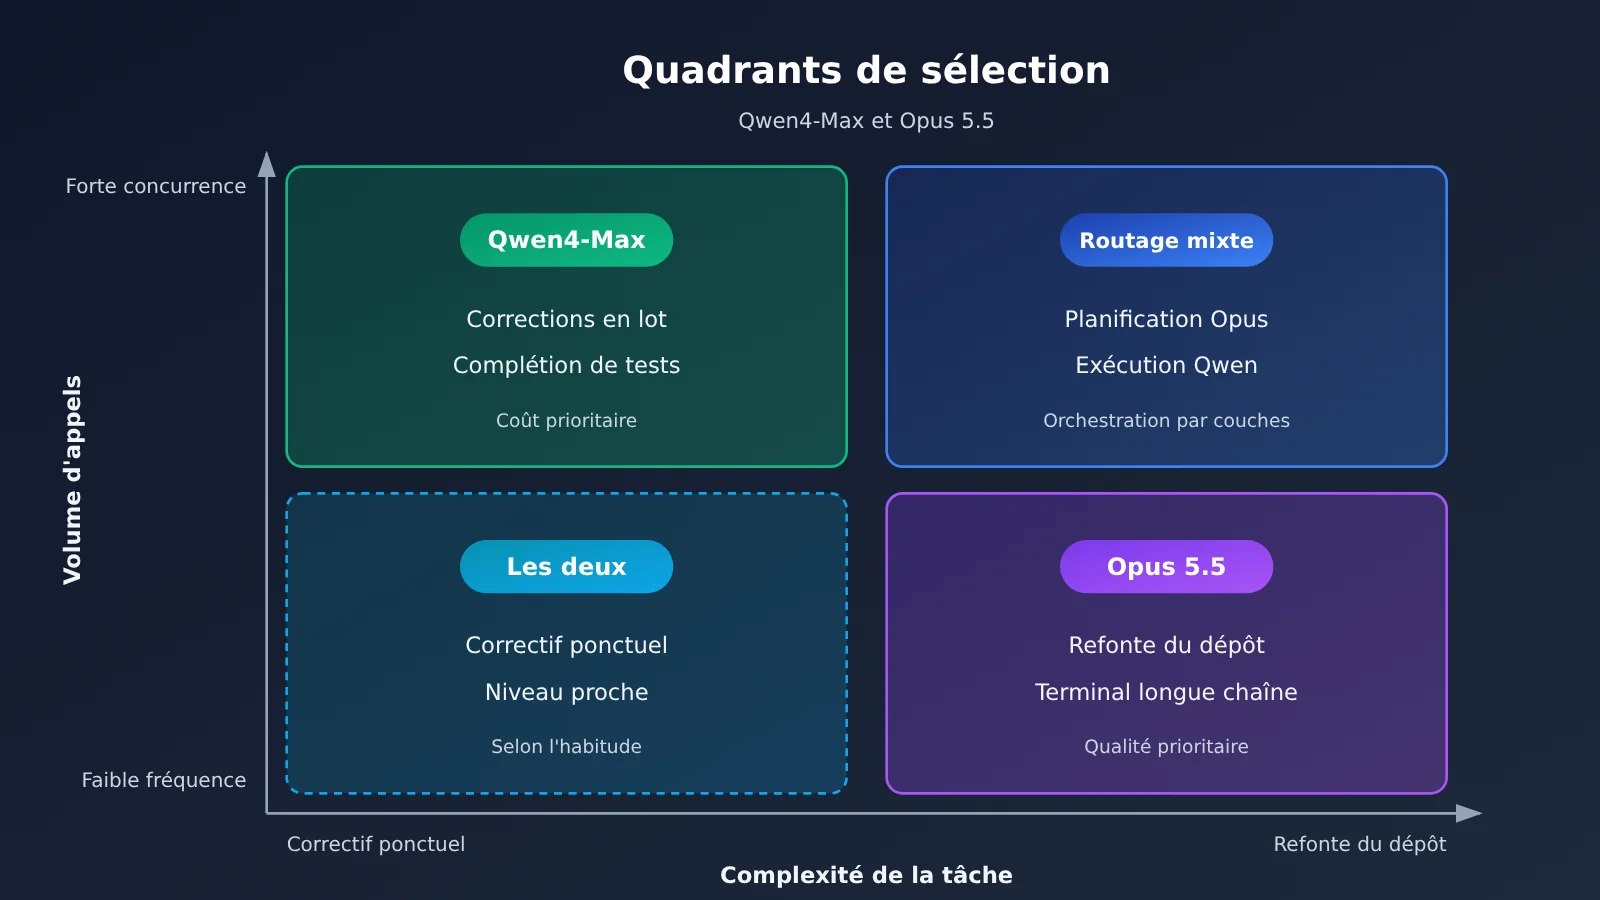
| Opérations en terminal et refactorisation à l’échelle du dépôt | Opus 5.5 | Terminal-Bench inférieur de 11,1 ; ProgramBench inférieur de 33,5 | Les chaînes de commandes multi-étapes et les modifications sur tout un dépôt sont le point le plus faible de Qwen4-Max |
| Codage sur la correction d’un ticket unique | Qwen4-Max, à essayer | DeepSWE supérieur de 1,5 | La capacité de correction locale est désormais à parité, avec un avantage tarifaire net |
| Livrables bureautiques et tâches longues | Opus 5.5 | AA-Briefcase inférieur de 115 Elo ; JobBench inférieur de 6,9 | L’écart de qualité sur les documents et les rapports est perceptible |
| Automatisation de workflows | Qwen4-Max | AutomationBench supérieur de 3,0 | Sur des tâches à règles claires, il ne se laisse pas distancer, et coûte moins cher |
| Compréhension de graphiques et de vidéos | Opus 5.5 | Chartography inférieur de 12,1 ; Video-Index inférieur de 6,7 | La lecture multimodale d’images conserve un écart |
| Agents haute concurrence sensibles au coût | Qwen4-Max | Entrée à 37,5 %, sortie à 22,5 % | À gros volume, l’écart de facture se multiplie |
Différences de spécifications entre Qwen4-Max et Opus 5.5
Côté spécifications, les deux modèles ont une fenêtre de contexte de 1M, mais leurs valeurs par défaut en sortie et en raisonnement divergent nettement :
- Qwen4-Max : tronc de 2,4 T, 71 B de paramètres activés, plus 328 B d’embeddings N-gram ; vision native ; sortie maximale de 393 K, chaîne de pensée maximale de 262 K ;
reasoning_effortpar défaut sur high. - Opus 5.5 (documentation Anthropic originale) : positionné sur le codage agentique et le travail de connaissance de longue haleine ; sortie maximale de 128 K ; effort par défaut sur medium ; connaissances à jour jusqu’en juin 2026.
Ce paramètre de niveau par défaut est facile à négliger. Qwen4-Max démarre directement en high, et le processus de réflexion est facturé comme de la sortie ; l’écart réel sur la facture est donc généralement inférieur aux 22,5 % affichés sur le tarif. La section sur les prix donnera plus loin un indice complémentaire tiré d’un classement public.
Qwen4-Max face à Opus 5.5 : tâches de terminal et de dépôt de code
C’est le point qui intéresse le plus les utilisateurs actuels d’Opus, et celui que Qwen4-Max doit aborder avec le plus de prudence.
| Benchmark (chiffres auto-déclarés par Qwen, comparaison sur le même graphique) | Qwen4-Max | Opus 5.5 | Écart |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen +1,5 |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen −66 |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen −11,1 |
| ProgramBench | 31.5 | 65.0 | Qwen −33,5 |
Voyons concrètement ce que chaque ligne signifie pour le travail réel :
- DeepSWE +1,5 : sur les tâches du type « corriger un point précis à partir d’une issue donnée », Qwen4-Max est déjà au même niveau qu’Opus 5.5. Un écart de 1,5 point revient pratiquement à une égalité, et le modèle convient donc bien pour alimenter une file de corrections de bugs à faible risque.
- WebDev −66 Elo : sur le rendu général des pages front-end, les votes des utilisateurs penchent plutôt vers Opus. La différence se voit à l’œil nu quand on produit des landing pages ou des prototypes de composants.
- Terminal-Bench −11,1 : la capacité à enchaîner des commandes dans le terminal, à lire les sorties puis à décider de l’étape suivante est nettement en retrait. Or c’est le quotidien des workflows du type Claude Code : passer à Qwen4-Max signifie davantage de blocages en cours de route ou d’interventions humaines nécessaires.
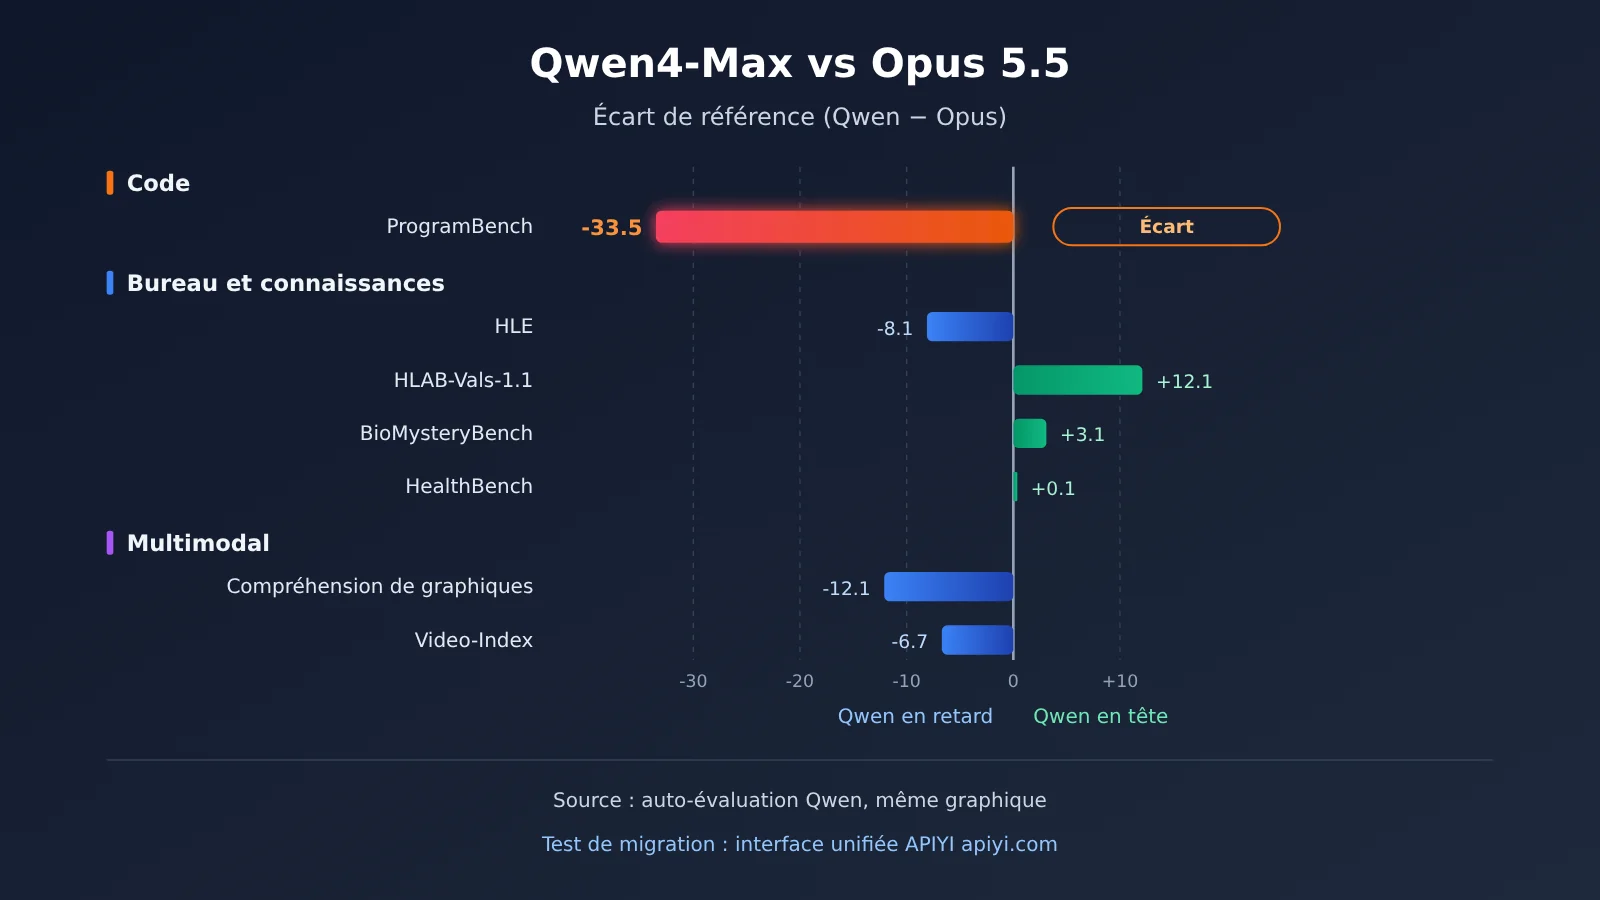
- ProgramBench −33,5 : c’est le point faible le plus marquant de cette comparaison, avec un score quasiment divisé par deux. Pour construire un programme de zéro ou le réécrire à grande échelle, Qwen4-Max n’est pas aujourd’hui un substitut approprié à Opus 5.5.
Les classements publics donnent des positions cohérentes. Selon l’instantané des classements publics du 14 novembre 2026, Code Arena WebDev d’arena.ai totalise 1 007 405 votes pour 159 modèles : Opus 5.5 (Max) est 2e avec 1816 points, Qwen4-Max (xHigh) 6e avec 1750 points — mais ce dernier ne compte que 1 814 votes et reste marqué « Preliminary », si bien que son rang peut encore évoluer.
Conseils d’usage de Qwen4-Max sur les scénarios de dépôt de code
Si votre agent sert surtout à refactoriser tout un dépôt, à migrer entre modules ou à enchaîner de longues séquences d’opérations dans le terminal, mieux vaut rester sur Opus 5.5. En revanche, si vous avez découpé la tâche en deux couches « planification + exécution », vous pouvez confier la planification et les modifications critiques à Opus 5.5, et répartir vers Qwen4-Max les tâches locales comme la correction d’un fichier unique ou la complétion de tests.
Qwen4-Max face à Opus 5.5 : bureautique et tâches longues
Les résultats sur les tâches bureautiques et les tâches d’agent longue durée sont plus contrastés que sur le codage : il y a des victoires et des défaites.
| Benchmark (comparaison sur la même base, chiffres rapportés par Qwen) | Qwen4-Max | Opus 5.5 | Écart |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen −115 |
| JobBench | 68.5 | 75.4 | Qwen −6.9 |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen −1.4 |
| AutomationBench-AA | 72.5 | 69.5 | Qwen +3.0 |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen −10.7 |
Concrètement, sur le terrain :
- AA-Briefcase : 115 points Elo de moins — pour les livrables bureautiques que sont les rapports, les propositions et les tableaux, les productions d’Opus 5.5 sont plus facilement utilisables telles quelles. C’est l’écart le plus important dans le domaine bureautique.
- JobBench : 6.9 de moins — sur le degré d’achèvement global de tâches proches du réel, Opus garde l’avantage, ce qui signifie qu’en livraison de bout en bout, le taux de reprise sera probablement plus élevé.
- APEX-Agents : 1.4 de moins — sur les tâches d’agent génériques, les deux modèles sont quasiment à égalité : changer de modèle ne devrait pas créer de différence d’expérience perceptible.
- AutomationBench : 3.0 de plus — l’automatisation de processus aux règles bien définies est en revanche le point fort de Qwen4-Max. Traitement de formulaires, transfert de données, orchestration de tâches planifiées : autant de cas à migrer en priorité.
- AgentArena Net Improvement : 10.7 de moins — la capacité à s’améliorer au fil des itérations est plus faible. Or, plus une tâche longue progresse, plus elle repose sur l’auto-correction du modèle : Opus est plus stable dans ce registre.
Autre point : la sortie maximale de 393K et la limite de chaîne de pensée de 262K de Qwen4-Max constituent un avantage bien réel pour les tâches longues qui exigent de produire d’un seul coup un contenu très volumineux. Opus 5.5, lui, plafonne à 128K de sortie maximale.
Qwen4-Max face à Opus 5.5 : chinois et documents longs multimodaux
Commençons par un avertissement : le tableau comparatif des sources ne comporte aucun benchmark dédié au chinois. Cet article ne peut donc pas répondre par des chiffres à la question « qui est le meilleur en chinois ? ». Si la qualité en chinois est votre critère principal, faites votre propre A/B sur votre propre jeu d’échantillons, sans vous appuyer sur des conclusions de seconde main.
Ce qui, en revanche, peut être chiffré, ce sont les tâches multimodales et de connaissance :
| Benchmark (comparaison à image identique, auto-déclarée par Qwen) | Qwen4-Max | Opus 5.5 | Écart |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen −12.1 |
| Video-Index | 68.1 | 74.8 | Qwen −6.7 |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen −8.1 |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen +12.1 |
| BioMysteryBench | 85.0 | 81.9 | Qwen +3.1 |
| HealthBench Professional | 60.0 | 59.9 | quasi égalité |
Ce que ces chiffres veulent dire concrètement : pour la lecture de graphiques et l’extraction de données visuelles dans les rapports financiers et les études d’analystes, Qwen4-Max est distancé de 12.1 points — il lui arrive de mal lire les axes ou de carrément sauter des valeurs ; la compréhension vidéo accuse également un retard de 6.7 points ; et sur les questions de connaissance générale très exigeantes (HLE), l’écart est de 8.1 points. À l’inverse, Qwen4-Max fait jeu égal, voire légèrement mieux, sur le raisonnement biologique et les questions médicales spécialisées, avec 12.1 points d’avance sur HLAB-Vals.
Il faut donc affiner selon le type de document long : pour un document essentiellement textuel qui demande une sortie très longue, Qwen4-Max est un candidat de premier choix ; pour un PDF saturé de graphiques ou un corpus contenant des éléments vidéo, mieux vaut encore passer par Opus 5.5.
Qwen4-Max et Opus 5.5 : prix par million de tokens et coûts de cache
Le prix est l’argument le plus solide de Qwen4-Max. Les valeurs du tableau ci-dessous sont exprimées pour 1M de tokens ; les tarifs officiels proviennent des textes originaux de QwenCloud et de la documentation Anthropic, et les tarifs actuels d’APIYI de docs.apiyi.com/models, relevés le 2026-11-16.
| Poste de facturation ($/1M tokens) | Qwen4-Max officiel | Opus 5.5 officiel | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Entrée | 1.5 | 4 | 37.5% | 1.65 | 4 |
| Sortie | 4.5 | 20 | 22.5% | 4.95 | 20 |
| Lecture du cache | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| Écriture du cache 5 minutes | 1.875 | 5 | 37.5% | selon la grille de la plateforme | selon la grille de la plateforme |
| Écriture du cache 1 heure | 3 | 8 | 37.5% | selon la grille de la plateforme | selon la grille de la plateforme |
Les structures de cache des deux modèles sont en fait parfaitement isomorphes : la lecture du cache vaut 5 % du prix d’entrée, l’écriture du cache 5 minutes vaut 1.25 fois le prix d’entrée, et l’écriture du cache 1 heure vaut 2 fois ce prix. Autrement dit, la stratégie de cache que vous avez conçue pour Opus peut être transposée telle quelle sur Qwen4-Max, la facture diminuant proportionnellement de 37.5 %. Un point à surveiller : sur APIYI, la lecture du cache de qwen3.8-max représente 12.5 % du prix d’entrée, un ratio différent de celui du Qwen4-Max officiel ; lors d’une migration, faites le calcul séparément pour le modèle réellement utilisé.
Un calcul concret
Prenons 100 millions de tokens d’entrée + 10 millions de tokens de sortie : Qwen4-Max revient à environ $195 (150 + 45), Opus 5.5 à environ $600 (400 + 200). L’écart est d’environ $405, soit deux tiers de la facture Opus.
Mais le prix affiché n’est pas ce que vous payez réellement. L’instantané du classement public du 2026-11-14 donne un coût par tâche en P50 : Opus 5.5 (Max) $8.99, Qwen4-Max (xHigh) $4.18, soit un rapport d’environ 46 %, et non les 22.5 % du prix affiché. La raison : les niveaux de raisonnement ne sont pas les mêmes ; Qwen4-Max est en high par défaut, la chaîne de pensée est facturée en sortie, ce qui consomme davantage de tokens. Les économies réelles dépendent de la longueur de vos tâches et du niveau de raisonnement ; je vous conseille de les mesurer en rejouant votre propre trafic.
💰 Conseil coût : pour comparer des factures, notez les quatre volumes de tokens — entrée, sortie, lecture et écriture du cache — plutôt que le seul prix unitaire. En appelant les deux modèles en parallèle depuis le même compte via APIYI apiyi.com, vous retrouvez les détails d’usage alignés au même endroit.
Qwen4-Max face à Opus 5.5 : recommandations de décision et migration en trois étapes
Faire migrer un agent d’Opus vers Qwen implique trois étapes incontournables : vérifier les modèles, comparer les prix et vérifier le protocole.
Première étape : vérifier les modèles. Au 2026-11-16, Qwen4-Max n’est pas encore disponible sur APIYI ; nous ajouterons ce modèle dès que possible. Côté Qwen, le modèle le plus puissant actuellement est qwen3.8-max. Côté Opus, claude-opus-5-5 est disponible, ainsi que claude-opus-5-5-thinking, au même prix. Les modèles et les prix font foi dans la liste des modèles du centre de documentation apiyi.com ; avant la mise en ligne, vous pouvez déjà utiliser qwen3.8-max pour mettre en place la chaîne de déploiement progressif.
Deuxième étape : comparer les prix. Selon la méthode de la section précédente, estimez les coûts des deux côtés à partir d’une semaine de trafic réel, puis comparez après avoir aligné les niveaux de raisonnement. La liste des modèles sur APIYI (apiyi.com) regroupe l’entrée, la sortie et la lecture du cache dans un même tableau récapitulatif, ce qui en fait une source de données pratique pour votre tableau de calcul.
Troisième étape : vérifier le protocole. APIYI propose une interface compatible OpenAI, avec le point de terminaison https://api.apiyi.com/v1. Pour changer de modèle, il suffit de modifier le champ model, par exemple de claude-opus-5-5 à qwen3.8-max, tandis que api_key et base_url restent inchangés. Deux points supplémentaires sont à vérifier : côté Qwen, le paramètre d’intensité de raisonnement s’appelle reasoning_effort et vaut high par défaut ; si vous voulez l’aligner sur le medium d’Opus, il faut le définir explicitement. La durée d’écriture du cache et les règles de correspondance doivent aussi être vérifiées à nouveau pour le modèle cible.
🎯 Conseil pour le déploiement progressif : ne basculez pas tout l’agent d’un seul coup. Je recommande de répartir le trafic sous le même
base_url(https://api.apiyi.com/v1) par type de tâche : migrez d’abord les tâches d’automatisation et de correction locale, puis laissez les tâches de terminal et de dépôt entier sur Opus 5.5, et surveillez le taux de reprise pendant deux semaines avant de décider de la suite.
FAQ — questions fréquentes
Q1 : Entre Qwen4-Max et Opus 5.5, lequel est le plus adapté comme coding agent ?
Tout dépend de la granularité de la tâche. Sur la correction d’un ticket isolé (DeepSWE), les deux se valent et Qwen4-Max permet de faire des économies ; sur les opérations multi-étapes en terminal et la construction d’un dépôt complet (Terminal-Bench, ProgramBench), Opus 5.5 est nettement devant, avec notamment 33.5 points d’écart sur ProgramBench — pour ce type de tâche, restez sur Opus.
Q2 : Peut-on comparer directement les scores du graphique d’Alibaba et ceux du classement arena ?
Non, ce n’est pas la même base de comparaison. Le premier est une comparaison à graphique identique déclarée par Qwen lui-même ; le second est un instantané d’un classement public (2026-11-14), et Qwen4-Max n’y totalise que 1,814 votes, avec un statut encore « Preliminary ». On peut croiser les tendances des deux, mais il ne faut pas en tirer une conclusion unique du type « X points d’avance ».
Q3 : Combien peut-on réellement économiser en passant à Qwen4-Max ?
Sur le tarif affiché, 62.5 % d’économie en entrée et 77.5 % en sortie. Mais sur le classement public, le ratio de coût par tâche au P50 est d’environ 46 %, car Qwen4-Max utilise par défaut un niveau de raisonnement plus élevé et consomme davantage de tokens de réflexion. Pour connaître l’économie réelle, il faut la mesurer en rejouant votre propre trafic.
Q4 : Peut-on déjà appeler Qwen4-Max depuis APIYI ?
Pas encore : Qwen4-Max n’est pas encore disponible, mais nous le mettrons en ligne dès que possible. En attendant, vous pouvez monter votre chaîne de migration avec `qwen3.8-max` ; une fois le modèle disponible, il suffira de changer le champ `model`. Pour l’état des modèles, référez-vous à la liste de modèles sur APIYI apiyi.com.
Q5 : Combien de code faut-il modifier pour passer d’Opus à Qwen ?
Si vous utilisez déjà une interface compatible OpenAI, il suffit de faire pointer `base_url` vers `https://api.apiyi.com/v1`, puis de changer le nom du modèle et de définir `reasoning_effort` selon vos besoins. Après inscription sur APIYI apiyi.com, vous pouvez utiliser le crédit de test gratuit réservé aux nouveaux utilisateurs pour lancer une première comparaison.
Q6 : Quelles sont les limites connues de Qwen4-Max ?
Le terminal et l’encodage sur dépôt complet sont ses principaux points faibles : la compréhension de graphiques accuse 12.1 points de retard, l’Elo sur les livrables bureautiques est inférieur de 115, et la capacité d’auto-amélioration sur plusieurs tours est elle aussi en retrait. Par ailleurs, tous les scores comparatifs sont déclarés par le constructeur, sans reproduction par un tiers à ce jour, et les capacités en chinois manquent encore de données de référence spécifiques.
Qwen4-Max face à Opus 5.5 : l’essentiel à retenir
- Principal point faible : 33.5 points de moins sur ProgramBench — pour construire et refactoriser un dépôt entier, restez sur Opus 5.5.
- Zones de parité : DeepSWE, APEX-Agents et HealthBench sont globalement à égalité, on peut donc y router les tâches en priorité.
- Les atouts de Qwen : automatisation des workflows, raisonnement biomédical, sorties ultra-longues jusqu’à 393K.
- Structure tarifaire : entrée à 37.5 %, sortie à 22.5 %, et les quatre paliers de cache exactement alignés sur ceux d’Opus.
- Écart de coût réel : avec le niveau de raisonnement par défaut (high), le coût des tâches issues des classements publics représente environ 46 % de celui d’Opus.
- Parcours de migration : sur APIYI apiyi.com, faites d’abord tourner
qwen3.8-maxsur le même endpoint ; quand Qwen4-Max sera disponible, il suffira de le remplacer.
En résumé
Le choix entre Qwen4-Max et Opus 5.5 se résume en trois points :
- Terminal et dépôts de code : on laisse Opus 5.5. L’écart sur Terminal-Bench et ProgramBench est trop grand, et la différence de prix ne couvre pas le coût des reprises.
- Automatisation et forte concurrence : on confie la main à Qwen4-Max. Sur les tâches où les capacités sont équivalentes ou supérieures, économiser 30 à 50 % de la facture, c’est du gain net.
- Router par tâche plutôt que remplacer en bloc. Une seule et même interface, avec un routage selon le type de tâche : c’est la manière de migrer la moins risquée.
Conseil : commencez par faire tourner qwen3.8-max et claude-opus-5-5 sur APIYI apiyi.com avec un rejeu de vos propres tâches, puis, une fois Qwen4-Max disponible, prenez la décision finale de bascule.
📚 Références
- Blog de lancement de Qwen4-Max : spécifications du modèle et comparaison avec les benchmarks officiels
- Lien :
qwen.ai/blog?id=qwen4-max -
Description : contient les paramètres d’architecture, la fenêtre de contexte et la limite de sortie, ainsi que les scores comparatifs présentés sur le même graphique
-
Présentation des modèles Anthropic : spécifications d’Opus 5.5
- Lien :
platform.claude.com/docs/en/about-claude/models/overview.md -
Description : fenêtre de contexte, sortie maximale, effort par défaut et date de coupure des connaissances
-
Page des tarifs Anthropic : prix d’entrée, de sortie et de cache pour Opus 5.5
- Lien :
platform.claude.com/docs/en/about-claude/pricing.md -
Description : inclut les prix d’écriture du cache pour 5 minutes et 1 heure
-
Liste des modèles APIYI : prix actuels et modèles disponibles sur la plateforme
- Lien :
docs.apiyi.com/models - Description : vérifier la disponibilité et les tarifs des modèles avant la migration
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com ; vous trouverez davantage de ressources d’intégration au centre de documentation docs.apiyi.com