Note de l’auteur : en partant des données usage d’une requête Responses, nous recalculons poste par poste l’entrée standard, la lecture et l’écriture du cache, ainsi que la sortie de raisonnement de GPT-6.2 Sol, avant d’expliquer comment la durée de vie du cache et l’état de la requête modifient la facture d’un même workflow.
La facture de GPT-6.2 Sol peut être recalculée selon une méthode fixe. Dans l’enregistrement de la requête, le champ usage décompose l’entrée en quatre catégories : entrée standard, lecture du cache, écriture du cache 30 minutes, écriture du cache 12 heures. Ces quatre catégories s’excluent mutuellement. La sortie constitue une catégorie à part, dans laquelle les tokens de raisonnement sont déjà comptés. Pour chaque catégorie, on multiplie le nombre de tokens par le tarif correspondant, puis on additionne : on obtient le coût modèle de cette requête. Les frais d’outils sont calculés séparément.
Trois conditions peuvent modifier le résultat. Premièrement, le volume total d’entrée d’une requête dépasse-t-il 272K ? Si oui, toute la requête bascule sur le tarif de contexte long. Deuxièmement, la durée de vie du cache et le nombre réel de hits : selon que le même préfixe est écrit pour 30 minutes ou pour 12 heures, le seuil de rentabilité n’est pas le même. Troisièmement, l’état de la requête : incomplete, les nouvelles tentatives et les tâches en arrière-plan influent sur la facture totale d’un workflow.
OpenAI a publié GPT-6.2 Sol le 17 novembre 2026 ; l’ID du modèle API est gpt-6.2-sol. Il peut être appelé via Responses et Chat Completions ; les appels de fonction et les outils intégrés passent par la voie Responses. Cet article se base sur les tarifs en dollars de la connexion directe officielle OpenAI et présente également la grille tarifaire publiée pour ce modèle dans l’interface de tarification publique d’APIYI apiyi.com. Tous les exemples de calcul de cet article reposent sur des usages synthétiques et ne constituent pas des factures mesurées.
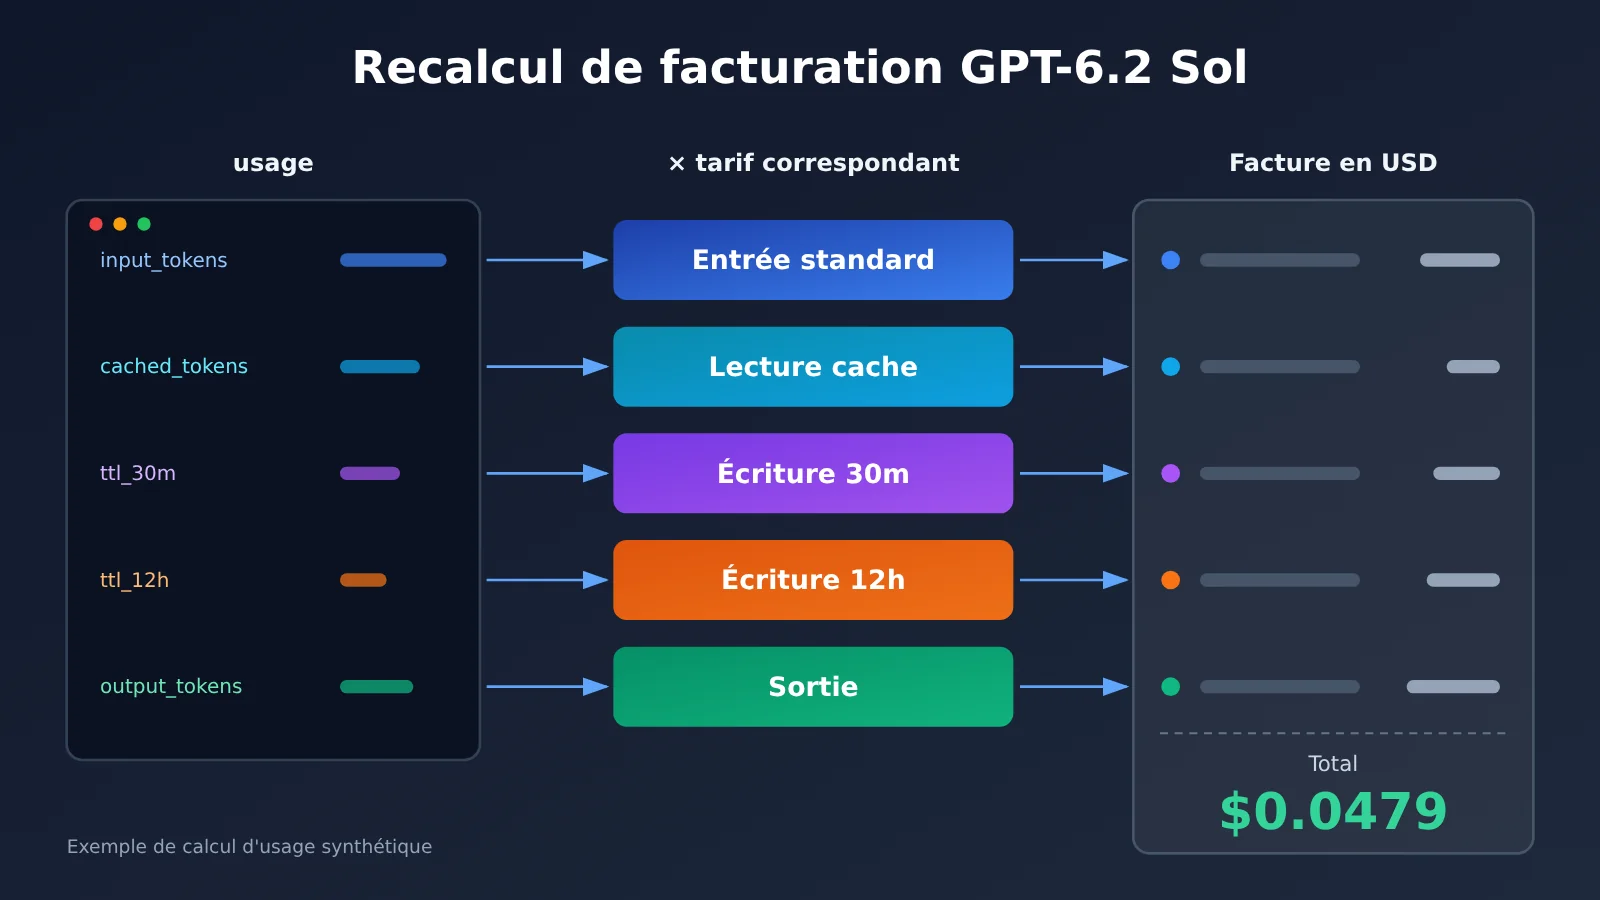
Carte des connaissances sur la facturation de GPT-6.2 Sol et ordre de lecture
L’ensemble de l’article suit l’ordre « champ → montant → décision de cache → rapprochement du workflow ». La sortie de chaque étape sert d’entrée à la suivante : commencez par repérer les différents postes présents dans usage, convertissez-les en dollars, puis utilisez cet algorithme pour comparer les scénarios de cache, et enfin regroupez les requêtes individuelles pour obtenir le coût du workflow.
Responses usage
 ├─ entrée totale input_tokens
 │   ├─ lecture du cache cached_tokens ──────────┐
 │   ├─ écriture 30m ttl_30m_tokens ────────────┤
 │   ├─ écriture 12h ttl_12h_tokens ────────────┼─→ × tarif correspondant → coût modèle par requête (section 2)
 │   └─ entrée normale = total − lectures − toutes les écritures ┤
 └─ sortie output_tokens (dont reasoning_tokens) ┘
                                          ↓
         choix de la durée de vie du cache (section 3) ← comparaison du prix total pour plusieurs requêtes sur un même préfixe
                                          ↓
         rapprochement du workflow (section 4) ← frais d'outils + nouvelles tentatives + incomplete + export des coûts
| N° | Question traitée | Dépend de la section précédente | Ce que vous saurez faire après lecture |
|---|---|---|---|
| 1 | Quels chiffres dans usage entrent dans la facturation |
— | Isoler les cinq postes facturables à partir d’une réponse |
| 2 | Combien valent ces volumes d’usage | Les cinq postes d’usage de la section 1 | Convertir les chiffres des logs en dollars et déterminer la tranche courte ou longue |
| 3 | Écrire le cache pour 30 minutes ou 12 heures | L’algorithme de prix unitaire de la section 2 | Choisir la durée de vie du cache selon l’intervalle entre appels et le nombre de hits |
| 4 | Combien a réellement coûté une tâche | Le calcul par requête des sections 2 et 3 | Mettre en place une table de logs minimale et traquer l’écart de facturation |
Si vous voulez simplement expliquer un écart de facturation, les sections 1 et 2 suffisent. Si vous êtes responsable de la stratégie de cache ou du registre des coûts, il est conseillé de lire les quatre sections dans l’ordre.
Terminologie de facturation GPT-6.2 Sol à connaître
| Terme | Explication |
|---|---|
| usage | Champ de la réponse API qui récapitule la consommation de tokens de la requête en cours |
| Entrée standard | La consommation restante une fois déduites de l’entrée totale les lectures de cache facturées et toutes les écritures de cache |
| Lecture de cache | La partie de l’entrée facturée au tarif de réutilisation dans la requête en cours |
| Point de rupture de cache | La frontière qui autorise le cache à enregistrer ou à réutiliser un préfixe d’entrée |
| TTL | Configuration de la durée minimale couverte par la facturation du cache ; Sol prend en charge deux modes d’écriture : 30 minutes et 12 heures |
| Tokens de raisonnement | Tokens produits par le modèle pendant la phase de réflexion et inclus dans le total de sortie facturé |
| ID de réponse | Identifiant qui relie les journaux de rapprochement, l’interrogation en arrière-plan et la réponse du modèle correspondant |
| Frais d’outils | Frais distincts engendrés par l’utilisation d’un outil hébergé spécifique |
1 Retrouver les cinq volumes facturés de GPT-6.2 Sol à partir de l’usage de Responses
1.1 Quatre types d’entrée et un type de sortie
L’objet usage de Responses sépare l’entrée et la sortie d’une requête. Côté entrée, il fournit un total et plusieurs détails ; côté sortie, un total et un sous-poste de raisonnement. Pour recalculer une facture, voici les champs à examiner :
| Catégorie de facturation | Champ lu | Explication |
|---|---|---|
| Total des entrées | usage.input_tokens |
Somme des quatre types d’entrée ; ce total ne se multiplie pas directement par le tarif |
| Lecture du cache | input_tokens_details.cached_tokens |
Volume lu au sens de la facturation |
| Total des écritures de cache | cache_write_tokens |
Somme des écritures pour les deux durées de vie |
| Écritures de 30 minutes | cache_write_tokens_details.ttl_30m_tokens |
À utiliser lorsque les détails de durée de vie sont renvoyés |
| Écritures de 12 heures | cache_write_tokens_details.ttl_12h_tokens |
À utiliser lorsque les détails de durée de vie sont renvoyés |
| Sortie | usage.output_tokens |
Contient déjà les tokens de raisonnement |
| Sous-poste de raisonnement | output_tokens_details.reasoning_tokens |
Sert à comprendre la composition de la sortie ; aucune majoration séparée ne s’y ajoute |
1.2 Formule de calcul pour l’entrée normale
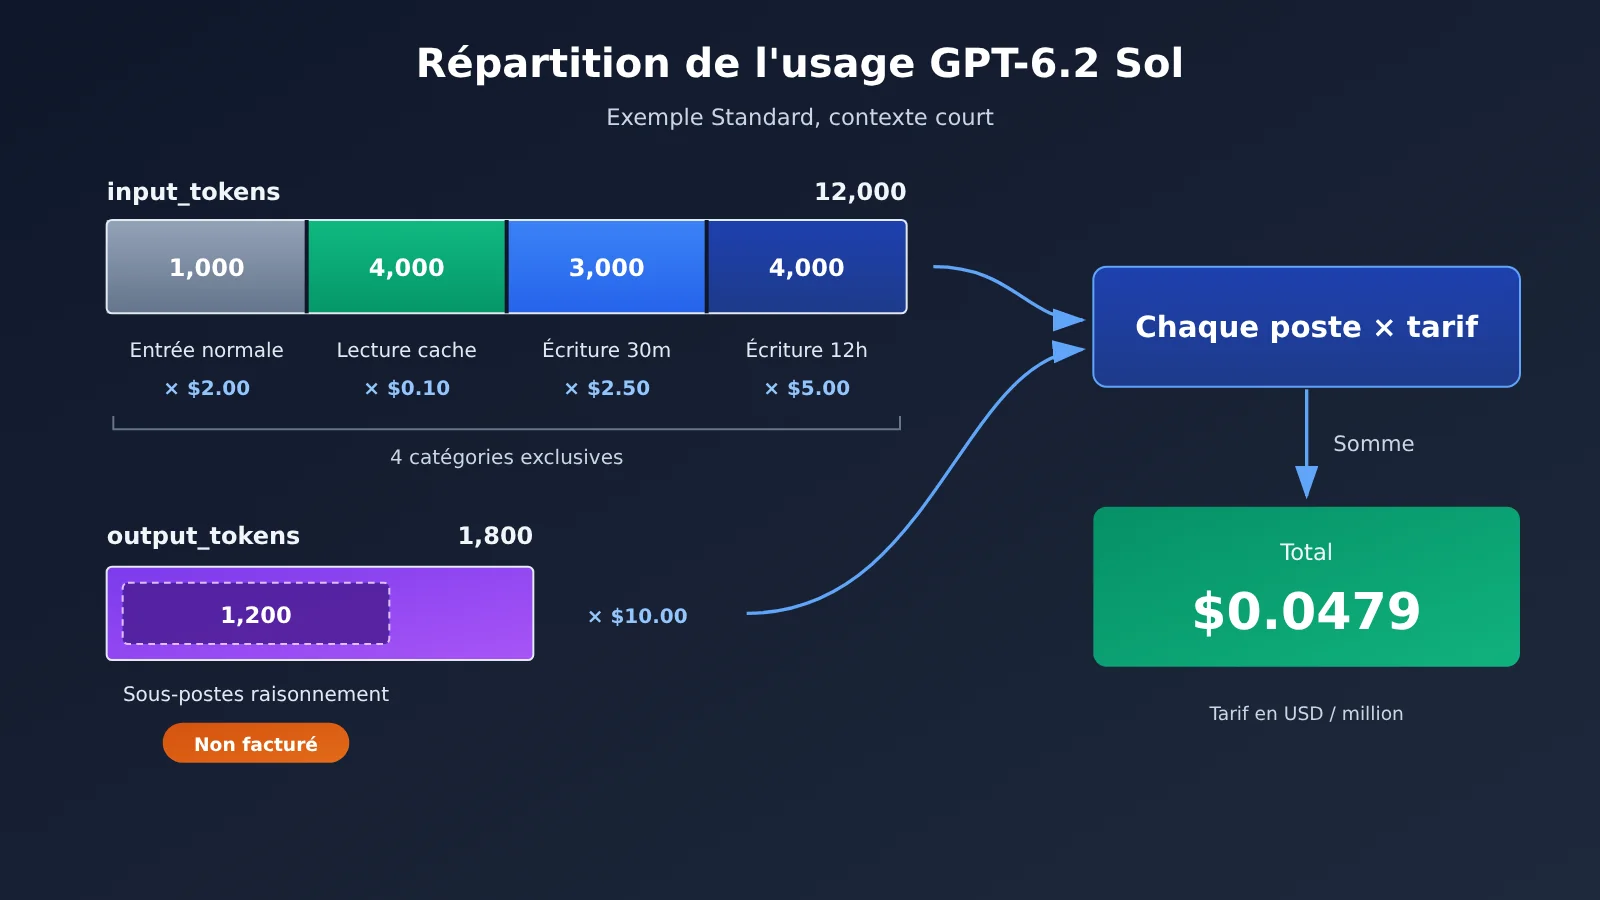
L’entrée normale n’a pas de champ dédié dans usage ; il faut l’obtenir par soustraction :
Entrée normale = input_tokens − cached_tokens − cache_write_tokens
Ce que l’on soustrait ici, c’est la totalité des écritures, autrement dit la somme des écritures de 30 minutes et de 12 heures. Les deux types d’écriture, la lecture et l’entrée normale sont mutuellement exclusifs : un même token ne tombe que dans l’une de ces catégories. Un token écrit dans le cache est facturé au tarif d’écriture et ne s’ajoute pas une seconde fois au prix d’entrée normale. C’est là que l’on se trompe le plus facilement : si l’on laisse les écritures dans l’entrée normale tout en facturant séparément les écritures, le total devient trop élevé.
Les tokens de raisonnement côté sortie sont eux aussi faciles à compter deux fois. reasoning_tokens est un sous-ensemble de output_tokens ; pour recalculer, il suffit de multiplier output_tokens par le tarif de sortie. Le sous-poste de raisonnement sert plutôt à analyser « pourquoi cette sortie est si longue » ; il ne doit pas devenir une ligne de facturation supplémentaire.
1.3 Utiliser les champs de facturation pour recalculer, les champs de diagnostic seulement pour enquêter
Les informations de diagnostic de Prompt Caching affichent aussi des chiffres comme « volume réutilisable » ou « estimation des non-hits ». Ils expliquent pourquoi le cache n’a pas été touché — par exemple parce que le préfixe a changé ou que la longueur est insuffisante — mais ils ne représentent pas la facturation réelle. Pour recalculer une facture, on ne prend que les champs de facturation effectifs présents dans usage.
Si un canal ne renvoie pas les détails de durée de vie, ou s’il manque cache_write_tokens, il ne faut pas déduire la facture à partir des champs absents. Dans ce cas, il faut se fier aux propres relevés de facturation de ce canal. L’exemple de calcul de la section suivante utilise un usage synthétique avec tous les champs présents, afin de montrer l’algorithme complet.
2 Convertir les chiffres des journaux de GPT-6.2 Sol en dollars
2.1 Grille tarifaire Standard officielle
Le tableau ci-dessous reprend la grille officielle en accès direct OpenAI, exprimée en USD par million de tokens. Le palier court/long est déterminé par le volume total d’entrée de chaque requête : au-delà de 272K, toute la requête bascule sur le tarif contexte long — les tarifs d’entrée et des différents caches sont ×2, la sortie ×1.5.
| Catégorie de facturation Standard | Contexte court (≤272K) | Contexte long (>272K) |
|---|---|---|
| Entrée standard | $2.00 | $4.00 |
| Lecture de cache | $0.10 | $0.20 |
| Écriture de cache 30 minutes | $2.50 | $5.00 |
| Écriture de cache 12 heures | $5.00 | $10.00 |
| Sortie (tokens de raisonnement inclus) | $10.00 | $15.00 |
Le tarif de base en contexte court est identique à celui de GPT-6.1 Sol. Par ailleurs, la fiche modèle annonce une fenêtre de contexte de 1 050 000 tokens, une entrée maximale de 922 000 tokens et une sortie maximale de 128 000 tokens. « Combien peut-on saisir au maximum » et « à partir de quel seuil on passe au tarif long » sont deux chiffres indépendants : une requête de 300K en entrée est parfaitement valide, mais elle sera facturée d’un bout à l’autre au tarif long.
2.2 Recalcul complet d’un usage synthétique
Imaginons qu’une requête Standard à contexte court renvoie l’usage suivant, sans appel d’outil et sans frais supplémentaires : 12 000 tokens d’entrée au total, dont 4 000 lus dans le cache, 3 000 écrits en cache avec une durée de 30 minutes, 4 000 écrits avec une durée de 12 heures, et 1 800 tokens en sortie (dont 1 200 de raisonnement).
On commence par isoler l’entrée ordinaire : 12 000 − 4 000 − 3 000 − 4 000 = 1 000. Puis on multiplie chaque poste par son tarif :
| Poste de facturation | Nombre de tokens | Tarif (USD/million) | Montant (USD) |
|---|---|---|---|
| Entrée ordinaire | 1 000 | 2,00 | 0,0020 |
| Lecture du cache | 4 000 | 0,10 | 0,0004 |
| Écriture 30 minutes | 3 000 | 2,50 | 0,0075 |
| Écriture 12 heures | 4 000 | 5,00 | 0,0200 |
| Sortie (dont 1 200 de raisonnement) | 1 800 | 10,00 | 0,0180 |
| Total | — | — | 0,0479 |
Dans ce calcul, l’écriture à 12 heures ne représente que 4 000 tokens, mais contribue à plus de 40 % du montant. La raison : son prix unitaire vaut 2,5 fois celui de l’entrée ordinaire, et l’écriture ne génère qu’un coût au moment où elle a lieu — le retour sur investissement n’arrive qu’aux lectures ultérieures qui touchent le cache. La section 3 reviendra spécifiquement sur ce point.
Je recommande de tenir un registre des coûts qui enregistre séparément, pour chaque poste de facturation, le nombre de tokens et le tarif, plutôt qu’un simple montant total. Ainsi, en cas d’écart de coût, on peut reprendre les valeurs réelles des logs dans le tableau ci-dessus et localiser ligne par ligne l’origine de la différence.
2.3 Contexte long : d’abord changer les tarifs, puis appliquer la même formule
Lorsque le total d’entrée dépasse 272K, l’algorithme reste inchangé : il suffit de remplacer toute la colonne de tarifs du tableau ci-dessus par les valeurs du contexte long. Attention, le basculement s’applique à l’ensemble de la requête : la lecture et l’écriture du cache sont elles aussi doublées, et la sortie est facturée 1,5 fois. Il faut donc déterminer le palier (court ou long) avant de procéder aux multiplications poste par poste.
Quand on passe par un canal tiers, il faut remplacer les tarifs par ceux de ce canal. Prenons APIYI (apiyi.com) : en relisant son interface de tarification publique le 2026-11-20, le billing_expr de gpt-6.2-sol bascule lui aussi sur 272 000 tokens d’entrée : palier court, entrée normale $2, lecture du cache $0.10, écriture dans le cache $2.50, sortie $10 ; palier long, respectivement $3, $0.15, $3.75 et $11.25 (USD par million de tokens). On constate que le multiplicateur du palier long diffère de celui de l’accès officiel direct, et que l’expression de l’interface ne liste qu’un seul prix d’écriture dans le cache. Pour les groupes, fonctionnalités et montants facturés réellement d’un projet, référez-vous à la configuration et à la facture actuelles de la plateforme.
Le code ci-dessous envoie une requête Responses via l’interface compatible OpenAI d’APIYI et affiche le usage tel quel, pour servir ensuite au recalcul :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "固定规则与公共资料(放在前部便于缓存复用)"},
        {"role": "user", "content": "本次请求的具体问题"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
Une fois le usage récupéré, une fonction convertit les cinq postes d’utilisation en montant. Le tableau de tarifs est passé en paramètre : pour basculer entre la grille officielle et celle d’un canal, il suffit de modifier la configuration :
Voir la fonction de recalcul complète
LONG_THRESHOLD = 272_000

# Tarifs Standard officiels d'OpenAI, USD / million de tokens
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # L'emplacement des champs d'écriture dépend de la structure réellement renvoyée ; on vérifie donc les deux endroits
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("缺少 cache_write_tokens,改用渠道出账记录,不要推定")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("缺少写入寿命明细,无法区分 30m/12h 费率")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# Vérification avec l'usage synthétique de la section 2.2
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
La fonction lève une erreur dès qu’un champ manque, au lieu de le traiter comme 0. L’objectif : éviter de facturer par erreur une requête dépourvue de détails d’écriture comme si « tout était de l’entrée standard ».
🎯 Conseil technique : pour tenir un registre de coûts, mieux vaut d’abord faire tourner la fonction de recalcul sur un usage synthétique, puis la brancher sur les journaux réels. Avec APIYI apiyi.com, vous pouvez lancer de petites requêtes de test avec la même clé API, comparer une à une l’usage renvoyé avec la facturation de la plateforme, et vérifier le périmètre des champs avant de mettre les statistiques en production.
3.1 Le calcul pour deux et trois accès au même préfixe
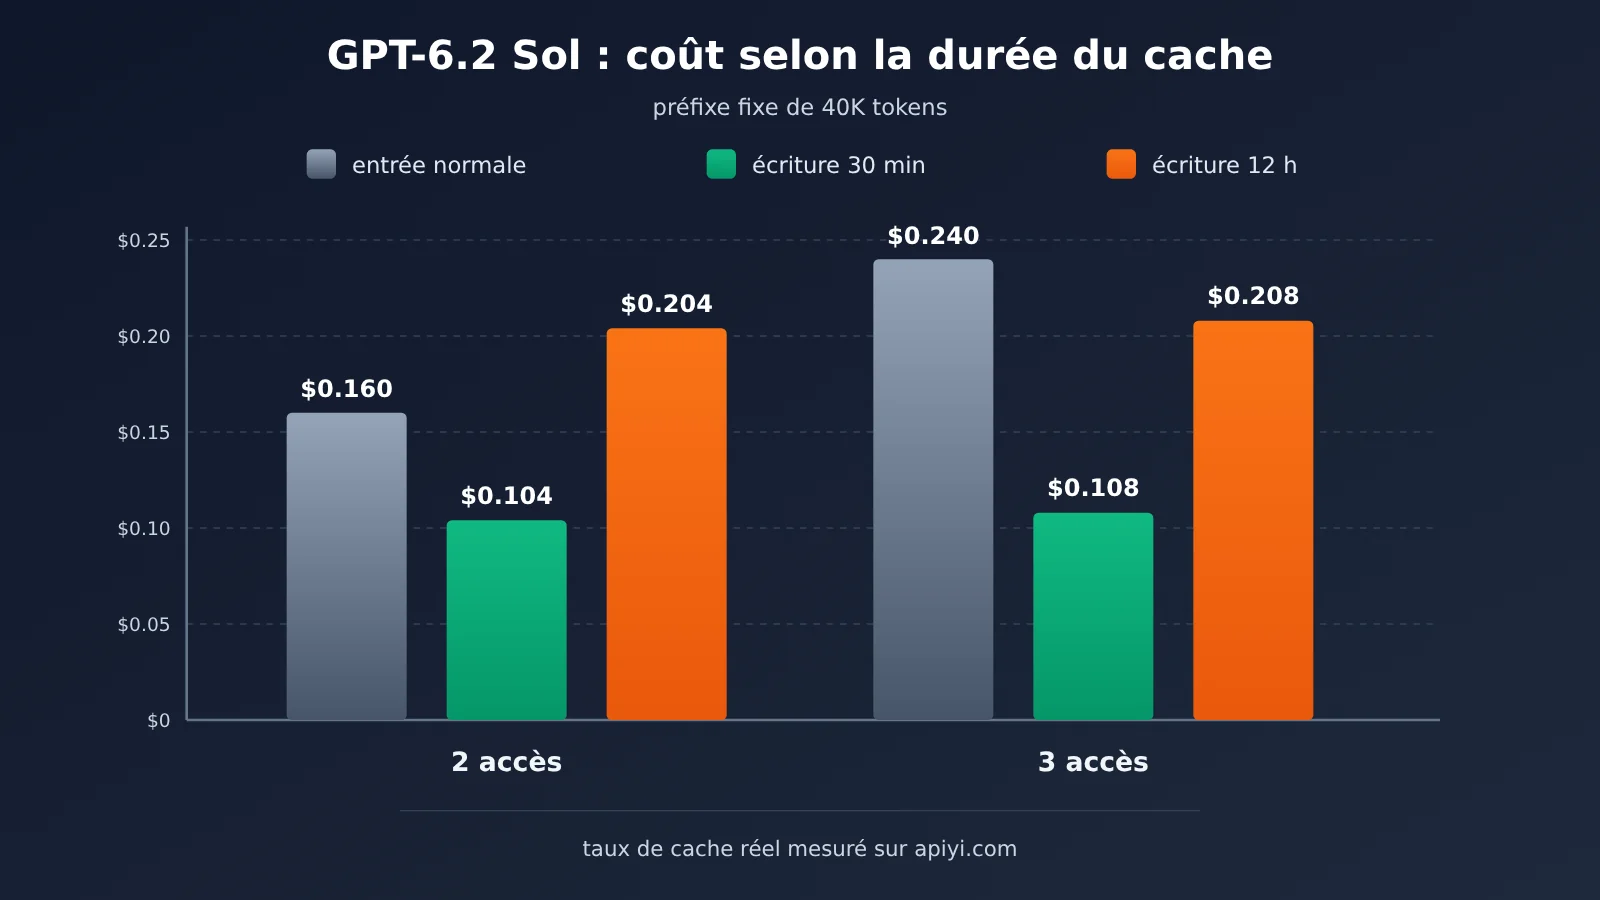
Imaginez un préfixe fixe de 40 000 tokens (règles système plus documentation partagée), facturé au tarif Standard en contexte court. Les coûts unitaires sont les suivants : en input normal, chaque appel revient à $0.08 ; la première écriture en cache avec une durée de vie de 30 minutes coûte $0.10 ; la première écriture avec une durée de vie de 12 heures coûte $0.20 ; une lecture avec correspondance complète coûte $0.004. Le tableau ci-dessous ne compare que la partie « préfixe fixe », sans le contenu variable ni la sortie de chaque requête.
| Mode d’accès | Input normal | Formule écriture 30 min | Formule écriture 12 h |
|---|---|---|---|
| 2 accès au total (1 écriture + 1 lecture) | $0.160 | $0.104 | $0.204 |
| 3 accès au total (1 écriture + 2 lectures, toutes dans la fenêtre) | $0.240 | $0.108 | $0.208 |
Avec deux accès, l’écriture 12 h coûte $0.044 de plus que l’absence de cache. Avec trois accès, les deux formules de cache sont moins chères que l’input normal, mais la formule 30 minutes reste à peu près la moitié de la formule 12 heures. Tout cela à condition que ces accès tombent bien dans la fenêtre de 30 minutes.
3.2 Point d’équilibre : combien de hits pour amortir le surcoût
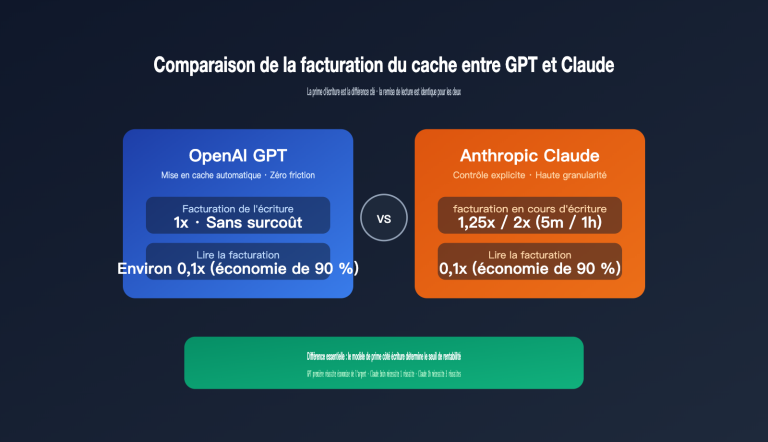
Regarder les chiffres ci-dessus sous un autre angle rend les choses plus intuitives (les estimations ci-dessous reposent sur les tarifs M3). Chaque hit complet permet d’économiser $0.076 par rapport à une entrée normale. Une écriture de 30 minutes coûte $0.02 de plus qu’une entrée normale : un seul hit suffit à amortir ce surcoût. Une écriture de 12 heures coûte $0.12 de plus : il faut au moins deux hits dans la fenêtre pour amortir.
La valeur d’une écriture de 12 heures ne réside donc pas dans le fait de « faire plus de hits au sein d’une même fenêtre », mais dans la possibilité de toucher le cache même lorsque l’intervalle entre deux appels dépasse 30 minutes. Si les requêtes successives qui utilisent le même préfixe arrivent généralement à quelques minutes d’intervalle, une écriture de 30 minutes suffit, et choisir 12 heures ne fait qu’ajouter des frais d’écriture. Si les requêtes arrivent toutes les une à deux heures, le cache de 30 minutes est expiré depuis longtemps et il faut réécrire à chaque fois : c’est là qu’une écriture de 12 heures combinée à plusieurs hits peut s’avérer plus économique.
Deux autres points peuvent modifier le raisonnement. Le TTL correspond à la durée minimale couverte par la facturation ; cela ne signifie pas que le cache survit forcément aussi longtemps. En dernière analyse, c’est le volume de lecture réel indiqué dans usage qu’il faut regarder. Une écriture de 30 minutes bénéficie de règles de rafraîchissement lors des lectures : dans les scénarios à haute fréquence, la couverture réelle peut dépasser les 30 minutes nominales. Après avoir choisi une option, il faut donc revenir sur les enregistrements de hits réels plutôt que de se fier uniquement à la configuration.
3.3 Disposition des points d’arrêt : placer le contenu stable en premier
Le cache ne s’applique qu’aux préfixes, et le préfixe minimal cachable est de 1 024 tokens d’entrée visibles. En pratique, on peut définir des points d’arrêt par couches selon le cycle de réutilisation :
- Documents publics à cycle long, comme les manuels produit ou les résumés de base de code : à placer en premier, avec une écriture envisagée sur 12 heures.
- Historique de session à cycle court, comme l’historique de la conversation en cours : à placer ensuite, avec une écriture envisagée sur 30 minutes.
- Instructions immédiates qui changent à chaque fois : à placer en dernier, sans entrer dans le cache.
GPT-6.2 présente un détail de positionnement facile à négliger : le champ instructions de niveau supérieur se trouve après le point d’arrêt cachable. Si l’on écrit des règles fixes dans instructions, cette partie ne peut pas être réutilisée. Les règles fixes ont plutôt intérêt à être placées dans un message developer en tête de input, tandis que instructions est réservé au contenu susceptible d’être ajusté à chaque requête.
💡 Conseil de choix : la durée de vie du cache doit être déterminée en fonction du trafic réel. Nous vous conseillons d’envoyer d’abord quelques requêtes sur APIYI apiyi.com avec le même préfixe, au rythme réel de votre trafic, en comptant les occurrences de
cached_tokens, avant de décider quelle couche utiliser 30 minutes et quelle couche utiliser 12 heures. Les différents canaux peuvent facturer différemment l’écriture du cache ; la facturation de la plateforme fait foi.
4 Agréger les coûts de GPT-6.2 Sol par workflow et traquer les écarts
4.1 Trois états de requête qui font diverger la facture de ce qu’on attend
Une requête unitaire peut être parfaitement calculée et le total du workflow ne pas tomber juste pour autant. Les causes habituelles viennent des états de requête :
- incomplete : quand la sortie atteint
max_output_tokens, la réponse peut se terminer enincomplete. À ce stade, il n’y a parfois encore aucun texte visible, mais les tokens d’entrée et de raisonnement ont déjà été produits et facturés. Si on ne compte que les requêtes « ayant renvoyé du contenu avec succès », on passe à côté de ce coût. - Tâches en arrière-plan : pour une tâche en arrière-plan qui possède déjà un ID de réponse, le polling se fait sur ce même ID. Il ne faut donc pas traiter chaque interrogation comme une nouvelle requête et la comptabiliser deux fois.
- Nouvelles tentatives : un appel indépendant relancé à cause d’un timeout ou d’un état
incompletegénère une nouvelle réponse, qu’il faut enregistrer séparément. Plus on relance, plus le coût d’entrée d’une même tâche est payé plusieurs fois.
4.2 Frais d’outils et tokens engendrés en aval par les outils
Responses prend en charge la recherche de fichiers, la recherche web, l’interpréteur de code et la génération d’images, entre autres. Avec la génération d’images, Sol déclenche un appel d’outil dans le déroulé, l’image est produite par un outil d’image distinct, et les frais suivent les règles de cet outil. Les frais d’outils se vérifient par type réel : la recherche web, par exemple, est facturée 10 $ / 1 000 requêtes, et les tokens du contenu renvoyé par la recherche sont facturés en plus au tarif du modèle.
Au moment de recalculer, il faut vérifier quels tokens la valeur usage couvre réellement. Quand le résultat d’un outil est réinjecté dans le tour de modèle suivant, cela se traduit par une hausse du volume d’entrée de la requête suivante : ce coût tombe sur la requête suivante, pas sur l’appel d’outil lui-même. Pour un workflow avec recherche, la facture se compose en général de deux blocs : « frais par appel d’outil + frais des multiples requêtes au modèle ».
4.3 Champs de journal minimaux
Pour qu’un workflow soit réconciliable, chaque réponse de modèle doit au minimum journaliser les champs suivants :
| Champ de journal | Rôle |
|---|---|
| ID de workflow | Rattacher plusieurs requêtes à une même tâche |
| ID de réponse | Relier le polling en arrière-plan, distinguer une relance d’une même requête |
| Modèle | Déterminer la grille tarifaire, par exemple gpt-6.2-sol |
| Niveau de service | Confirmer qu’on est bien sur le référentiel Standard |
| État final | Identifier completed, incomplete, etc. |
| Détail de l’usage | Entrée normale, lecture, écriture 30m, écriture 12h, sortie, raisonnement |
| Outils | Type d’outil et nombre d’appels |
| Coût | Montant recalculé par poste, avec le marqueur court/long |
Avec ce tableau, il suffit de regrouper par ID de workflow et de faire la somme pour obtenir le coût d’une tâche. La recherche d’écarts a aussi son ordre : on regarde d’abord s’il y a des incomplete et des relances, puis si les lectures de cache sont inférieures à ce qu’on attendait, et enfin on vérifie le nombre d’appels d’outils.
4.4 Recouper l’estimation requête par requête avec l’export officiel
L’estimation requête par requête convient au contrôle budgétaire en temps réel, mais elle dérive facilement dès qu’il y a des appels d’outils à plusieurs étapes, des relances ou des champs d’usage manquants. L’idéal est de comparer régulièrement le total des estimations avec l’export officiel d’usage ou de facturation, et de redescendre ligne par ligne dans les journaux dès que l’écart dépasse le seuil fixé. Si vous passez par un canal tiers, le point de comparaison devient les champs de décompte et la grille tarifaire de ce canal.
💰 Conseil coût : si votre équipe utilise plusieurs modèles en parallèle, vous pouvez passer par APIYI apiyi.com pour les appeler tous avec une seule clé API, puis les stocker en base selon les champs de journal minimaux décrits ici. Un point d’entrée unique permet de garder des ID de workflow et un référentiel de coûts cohérents, et ça fait une conversion de canal en moins au moment du rapprochement de fin de mois.
Méthode de vérification de la facture GPT-6.2 Sol
Pour n’importe quel enregistrement de requête Sol, vous pouvez vérifier la facture dans cet ordre : commencez par confirmer si le volume total d’entrée dépasse 272K, puis choisissez la colonne tarifaire correspondante ; soustrayez ensuite du input_tokens les lectures et l’ensemble des écritures pour obtenir l’entrée normale ; enfin, multipliez les cinq postes par leur tarif respectif et additionnez, puis comparez avec la facture. Si une requête individuelle est cohérente alors que le total du workflow ne l’est pas, cherchez dans les logs les mentions incomplete, les retries et les appels d’outils.
Pour savoir si le cache vaut le coup, on regarde en dernier ressort le volume réellement lu dans le usage et l’intervalle entre les appels. Une écriture avec un TTL de 30 minutes est rentabilisée dès un premier cache hit ; une écriture de 12 heures exige au moins deux hits dans la fenêtre, et son avantage ne se manifeste que si l’intervalle entre les appels dépasse 30 minutes.
Pour valider ces conclusions avec du trafic réel, vous pouvez demander un crédit de test gratuit sur APIYI apiyi.com et comparer ligne par ligne avec la facture de la plateforme à l’aide de la fonction de recalcul présentée dans l’article.
📚 Références
-
Annonce de lancement d’OpenAI GPT-6.2 Astra et Sol : date de sortie et positionnement produit
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Explication : comprendre le positionnement de Sol pour le travail quotidien et les agents à plusieurs étapes
- Lien :
-
Fiche modèle GPT-6.2 Sol : spécifications de contexte, tarifs et multiplicateur de contexte long
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol - Explication : source du barème tarifaire et de la règle de bascule à 272K présentés dans cet article
- Lien :
-
Guide Prompt Caching et diagnostic du cache : champs de cache, TTL et règles de points de rupture
- Lien :
developers.openai.com/api/docs/guides/prompt-caching - Explication : explique les
cached_tokens, la durée de vie des écritures et le préfixe minimum cachable
- Lien :
-
Guide Reasoning : tokens de raisonnement et état
incomplete- Lien :
developers.openai.com/api/docs/guides/reasoning - Explication : comprendre comment l’usage de raisonnement est comptabilisé dans la sortie
- Lien :
-
Guide de contrôle des coûts par workflow : agréger les coûts Responses par workflow
- Lien :
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - Explication : implémentation de référence pour le contrôle budgétaire au niveau du workflow
- Lien :
-
Table des modèles APIYI : informations sur les canaux et points d’entrée
- Lien :
docs.apiyi.com/models.md - Explication : consulter les points d’entrée et groupes disponibles pour gpt-6.2-sol
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; pour davantage de ressources d’intégration, consultez le centre de documentation docs.apiyi.com