Note de l’auteur : cet article s’appuie sur la grille tarifaire officielle consultée le 24 octobre 2026. Il détaille les cinq niveaux de prix de Kimi K3.1 Pro, la facturation du cache et les paliers de limitation de débit. Trois exemples de calcul réutilisables vous aideront à déterminer le coût réel d’une requête.
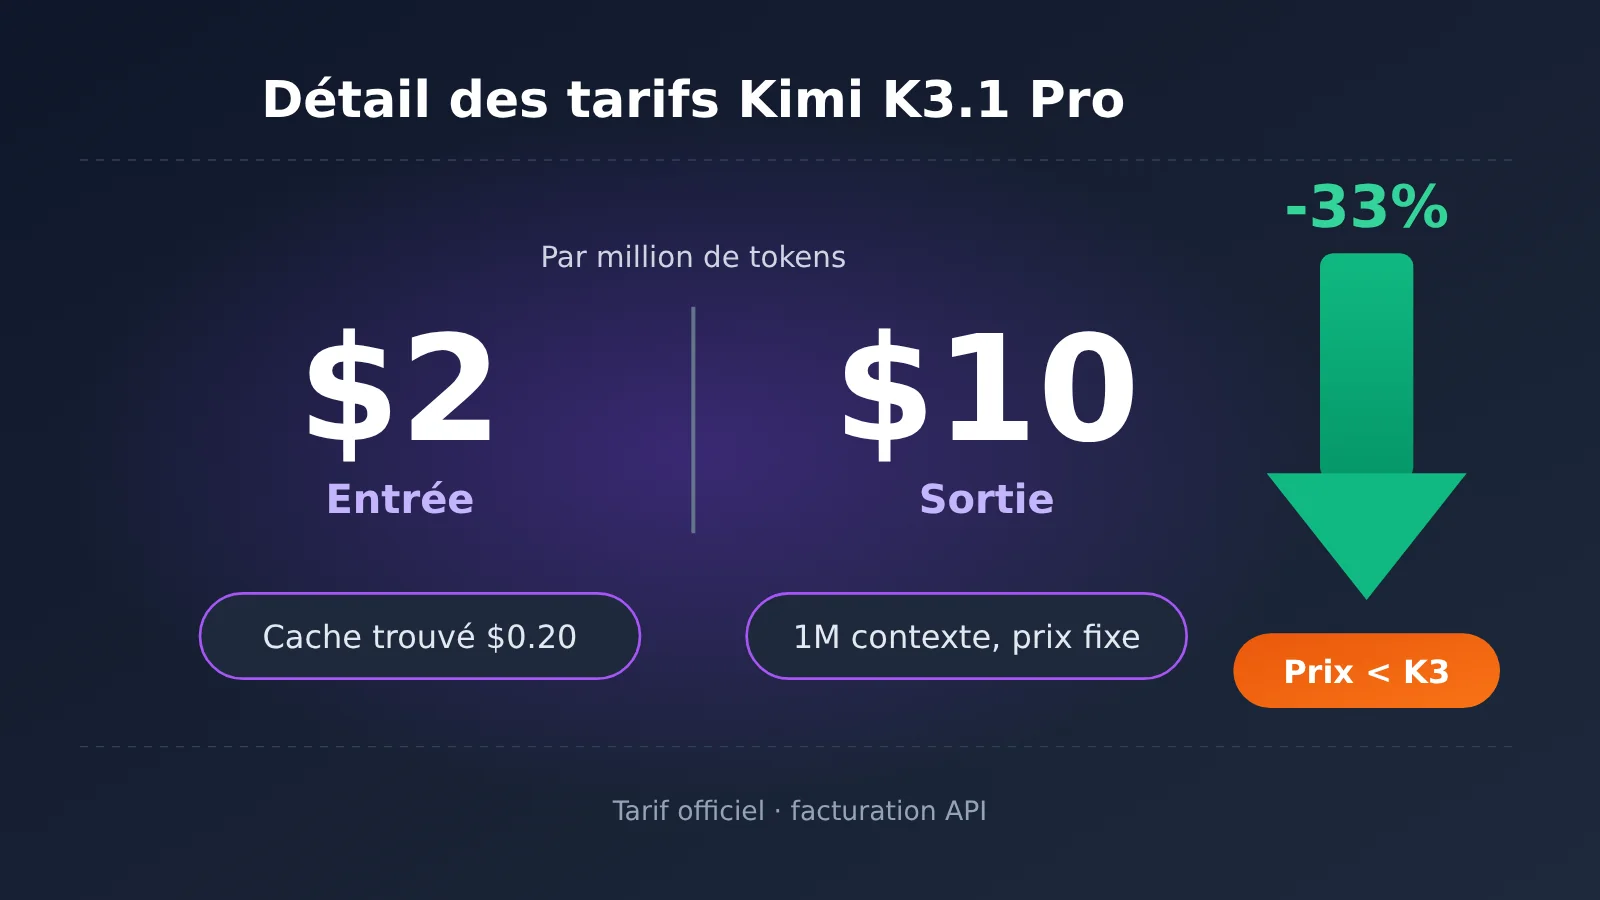
Le tarif officiel de Kimi K3.1 Pro est de 2 $ en entrée et 10 $ en sortie, avec seulement 0,20 $ en cas de cache (en dollars par million de tokens). C’est 33 % moins cher que la génération précédente, Kimi K3. Au même tarif que Claude Sonnet 5.5 et GPT-6.1 Sol, il coûte deux fois moins cher que Claude Opus 5.5.
Ces conclusions s’appuient sur la page de tarification officielle de Moonshot (la documentation tarifaire de platform.kimi.ai) et sur les calculs de l’organisme indépendant Artificial Analysis. La source de chaque chiffre est indiquée dans l’article : « officiel » désigne les données publiées par Moonshot dans ses billets de blog ou sa documentation ; « tiers » renvoie aux estimations externes, notamment celles d’Artificial Analysis. Les chiffres dont la source fiable n’a pas pu être trouvée sont signalés comme « non vérifiés ».
Cet article ne se contente pas de recopier une grille tarifaire. Une baisse de 33 % du prix unitaire ne signifie pas forcément que votre facture diminuera d’autant. Nous verrons aussi bien où vous pouvez faire des économies que les situations où ce ne sera pas le cas.
Ce que vous allez apprendre : à la fin de cet article, vous saurez calculer vous-même le coût d’une requête à Kimi K3.1 Pro, déterminer dans quels cas activer le cache et quand passer à l’avance à un palier supérieur de limitation de débit, et comprendre comment les développeurs en Chine peuvent payer et se connecter au service.
1. Kimi K3.1 Pro : les points clés sur les tarifs
Commençons par un tableau qui répond aux questions les plus fréquentes. Les sections suivantes détaillent chaque point.
| Point clé | Détails | Source | Ce que ça signifie pour vous |
|---|---|---|---|
| Tarif de base | Entrée : 2 $ / sortie : 10 $ / cache hit : 0,20 $ | Officiel | Même gamme de prix que Sonnet 5.5 et GPT-6.1 Sol |
| Comparaison avec la génération précédente | Les trois tarifs unitaires sont inférieurs de 33 % à ceux de K3 | Officiel / tiers | Une baisse notable des tarifs unitaires |
| Fenêtre de contexte | 1 048 576 tokens, tarif unique sans palier | Officiel | Les longs documents n’entraînent pas de hausse liée à leur longueur |
| Coût par tâche | Environ 1,98 $ (article publié) / 2,11 $ (page du modèle) | Tiers | Coût globalement équivalent à celui de K3 : il n’a pas baissé dans les mêmes proportions |
| Seuil de départ | Recharge minimale de 1 $, Tier 0 limité à 3 RPM | Officiel | Vous devrez passer à un niveau supérieur avant de monter en charge |
Commençons par expliquer deux termes qui reviendront souvent. Un token est l’unité de facturation minimale du modèle. On peut le voir comme un « fragment de mot ». Selon le repère fourni par le site officiel, environ 3 à 4 caractères anglais correspondent à 1 token. Un million de tokens (MTok) correspond à 1 000 000 de tokens : dans la grille tarifaire, les 2 $ indiqués correspondent au traitement d’un million de tokens en entrée.
1.1 Quels sont les éléments facturés pour Kimi K3.1 Pro ?
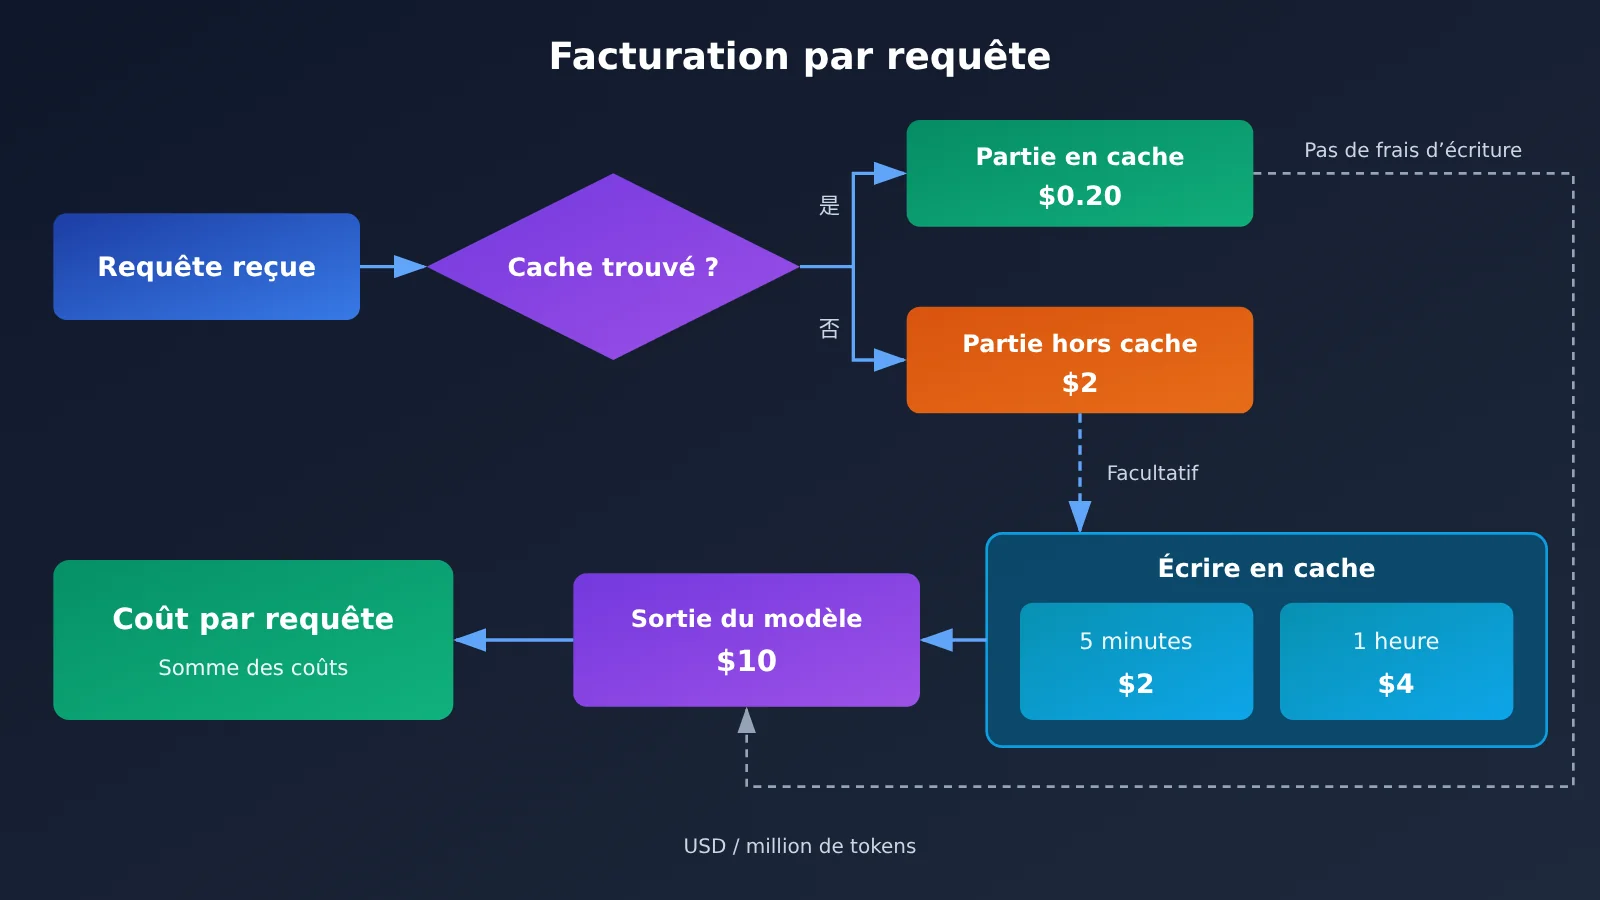
La documentation officielle recense trois types d’éléments facturables : l’écriture dans le cache (avec deux durées possibles, 5 minutes ou 1 heure), l’entrée (avec ou sans cache hit) et la sortie. Ils sont répartis en cinq tarifs dans la grille. Pour chaque requête, la facture correspond à la somme de ces éléments, calculés en fonction du nombre de tokens.
Le cache de contexte est l’un des aspects les plus importants de cette tarification. Si le début de plusieurs requêtes successives est identique — par exemple, un long prompt système — la plateforme peut enregistrer ce contenu et le réutiliser directement lors de la requête suivante. La partie réutilisée est alors facturée au tarif réduit de « cache hit ». Selon la documentation officielle, l’API Kimi active automatiquement la facturation du cache pour les préfixes de requêtes répétés. La durée de vie du cache (TTL) est de 5 minutes par défaut. Le TTL indique combien de temps le cache conserve le contenu.
La documentation officielle précise aussi plusieurs règles faciles à manquer : pour la série K3, un cache hit est facturé uniquement au tarif correspondant, sans frais d’écriture supplémentaires ; les API liées aux fichiers (extraction du contenu des documents et stockage des fichiers) sont actuellement gratuites, mais le contenu extrait est facturé en tokens lorsqu’il est envoyé au modèle ; enfin, les tarifs sont hors taxes et le montant final dépend des règles applicables dans votre région de paiement.
2. Kimi K3.1 Pro : grille tarifaire complète, avec les cinq niveaux de prix
Le tableau ci-dessous présente les tarifs des cinq principaux modèles Kimi pour vous permettre de les comparer facilement. « Non indiqué » signifie que le tarif correspondant ne figure pas sur la page officielle — cela ne veut pas dire que le service est gratuit.
| Modèle | Entrée (sans cache) | Sortie | Entrée avec cache | Écriture du cache (5 min) | Écriture du cache (1 h) |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3(上一代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | Non indiqué | Non indiqué |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | Non indiqué | Non indiqué |
Remarque : données récupérées le 24 octobre 2026. Tarifs en dollars américains par million de tokens, hors taxes. Source : page officielle des tarifs.
Le tableau fait ressortir plusieurs tendances. D’abord, pour K3.1 Pro, l’écriture du cache pendant 5 minutes coûte le même prix que l’entrée standard, soit $2 : activer ce cache n’entraîne donc pratiquement aucun surcoût. L’écriture pendant 1 heure coûte $4, soit deux fois le tarif d’entrée. Ensuite, tous les tarifs de la version Highspeed sont deux fois plus élevés que ceux de la version standard, à l’exception de l’entrée avec cache, qui reste à $0.20. L’écart entre les deux versions se réduit donc lorsqu’on réutilise de longs préfixes. Enfin, les tarifs unitaires de K2.7 Code et K2.6 représentent moins de la moitié de ceux de K3.1 Pro. Pour les tâches qui n’exigent pas les meilleures capacités de raisonnement, ces modèles restent les options les plus économiques.
2.1 Comparaison de Kimi K3.1 Pro avec les modèles de prix comparable
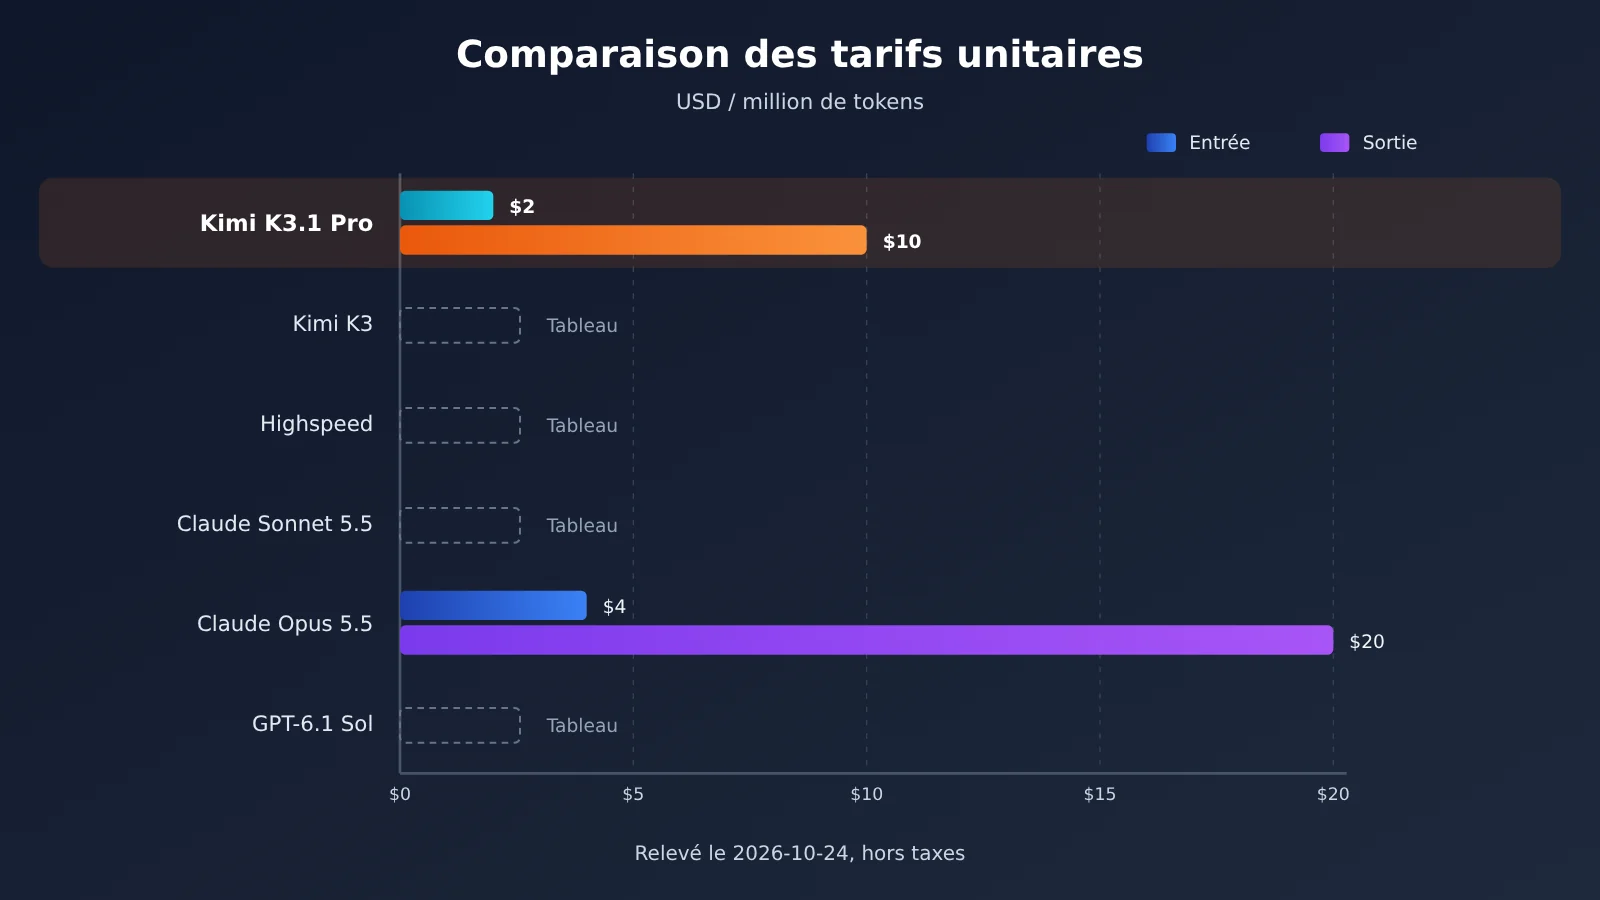
En comparant plusieurs modèles majeurs selon la même unité (dollars par million de tokens), on situe plus clairement K3.1 Pro.
| Modèle | Entrée / sortie | Entrée avec cache | Écriture du cache · courte durée | Écriture du cache · longue durée | Source |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2 (5 minutes) | $4 (1 heure) | Officiel |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4 (5 minutes) | $8 (1 heure) | Officiel |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50 (5 minutes) | $4 (1 heure) | Officiel |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5 (5 minutes) | $8 (1 heure) | Officiel |
| GPT-6.1 Sol (entrée ≤272K) | $2 / $10 | $0.10 | $2.50 (30 minutes) | $5 (12 heures) | Officiel |
| GPT-6.1 Sol (entrée >272K) | $4 / $15 | $0.20 | $5 (30 minutes) | $10 (12 heures) | Officiel |
| GPT-6 Astra (entrée ≤272K) | $10 / $50 | $1.00 | $12.50 (30 minutes) | $25 (12 heures) | Officiel |
| GPT-6 Astra (entrée >272K) | $20 / $75 | $2.00 | $25 (30 minutes) | $50 (12 heures) | Officiel |
Les données du tableau proviennent des pages de tarification officielles des différents fournisseurs. Elles ont été relevées le 24 octobre 2026 et sont exprimées en dollars par million de tokens, hors taxes. Les trois fournisseurs proposent des durées de cache différentes : Kimi et Claude utilisent des durées de 5 minutes et d’une heure, tandis qu’OpenAI propose 30 minutes et 12 heures. Les tarifs d’écriture du cache représentent respectivement 1,25 et 2,5 fois le tarif d’entrée sans cache ; pour la lecture, la plupart des modèles facturent 10 % du tarif d’entrée, sauf GPT-6.1 Sol, qui facture 5 %. OpenAI applique aussi des tarifs différents selon la longueur de l’entrée : jusqu’à 272K tokens inclus, le tarif court s’applique ; au-delà, c’est le tarif long qui entre en vigueur. Le tableau ne présente que les tarifs standards : les options Batch à moitié prix, Fast (anciennement Priority) et UltraFast, plus coûteuses, ne sont pas incluses.
La comparaison montre que Claude Sonnet 5.5 et GPT-6.1 Sol proposent un tarif plus bas pour les entrées lues depuis le cache (tous deux à $0.10), ce qui les rend plus intéressants lorsque de longs préfixes sont réutilisés fréquemment. En revanche, l’écriture du cache pour 5 minutes coûte $2.50 avec Sonnet 5.5, soit légèrement plus que les $2 de K3.1 Pro. De son côté, K3.1 Pro est mieux adapté aux tâches qui nécessitent de charger de gros documents en une seule fois, grâce à son coût d’écriture plus bas et à son tarif d’entrée uniforme, quelle que soit la longueur du contexte. L’entrée et la sortie de Claude Opus 5.5 coûtent toutes deux deux fois plus cher qu’avec K3.1 Pro : le choisir se justifie donc par ses capacités, et non par son prix. Le point faible de GPT-6.1 Sol est le coût d’écriture du cache : le tarif de $2.50 pour 30 minutes dépasse les $2 de K3.1 Pro pour 5 minutes. De plus, son prix varie selon la longueur de l’entrée : au-delà de 272K tokens, l’entrée passe à $4 et la sortie à $15. Pour les tâches portant sur de longs documents, il faut donc se référer à la ligne correspondant au long contexte.
Conseil : à prix égal, les performances réelles varient selon la tâche. Le mieux est de tester les modèles avec la même série d’invites avant de faire votre choix. Le catalogue de modèles d’APIYI (apiyi.com) propose notamment claude-sonnet-5-5, claude-opus-5-5 et kimi-k3. Vous pouvez les comparer avec une seule clé API. Pour connaître le nom exact et le prix de K3.1 Pro, consultez la liste des modèles de la plateforme. Nous proposerons ce modèle dès que possible.
3. Combien coûte une requête avec Kimi K3.1 Pro ? 3 exemples de calcul
Une fois le tableau des tarifs compris, la vraie question est : « Combien me coûte cette requête ? » Les trois exemples ci-dessous couvrent des cas typiques : une courte conversation, la réutilisation d’une longue invite et la lecture d’un long document. Les calculs sont détaillés : il vous suffit de remplacer les nombres de tokens par les vôtres. La formule générale est : coût = nombre de tokens × tarif unitaire ÷ 1,000,000.
3.1 Exemple 1 : coût d’une requête courte avec Kimi K3.1 Pro
Scénario : une question-réponse classique, avec 2 000 tokens en entrée (sans cache) et 500 tokens en sortie.
- Entrée :
2000 × 2 ÷ 1000000 = $0.004 - Sortie :
500 × 10 ÷ 1000000 = $0.005 - Total :
$0.004 + $0.005 = $0.009
Une courte conversation de ce type coûte donc moins d’un centime. À noter : le tarif de sortie est cinq fois supérieur à celui de l’entrée. Pour les requêtes courtes, la sortie représente souvent plus de la moitié du coût. Réduire la longueur de la réponse est donc plus efficace que raccourcir l’entrée.
3.2 Exemple 2 : réutilisation d’une longue invite et mise en cache avec Kimi K3.1 Pro
Scénario : une invite système de 20 000 tokens, puis 10 questions posées en cinq minutes. Chaque fois, on ajoute 1 000 nouveaux tokens en entrée et on obtient 800 tokens en sortie.
Sans cache, chaque requête facture l’invite complète au tarif normal :
- Par requête :
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - Pour 10 requêtes :
$0.05 × 10 = $0.50
Avec le cache, la première requête enregistre l’invite système ; les neuf suivantes réutilisent le cache :
- 1re requête : écriture de
20000 × 2 ÷ 1000000 = $0.04, plus$0.002pour la nouvelle entrée et$0.008pour la sortie, soit$0.05au total - De la 2e à la 10e requête : cache utilisé,
20000 × 0.2 ÷ 1000000 = $0.004, plus$0.002 + $0.008, soit$0.014par requête - Total des neuf dernières requêtes :
$0.014 × 9 = $0.126 - Total :
$0.05 + $0.126 ≈ $0.18
Pour les mêmes 10 conversations, le coût passe de 0,50 $ à environ 0,18 $, soit une économie d’environ 60 %. Cette structure — une longue invite fixe suivie de plusieurs questions — est très courante dans les robots de service client, les assistants de programmation et les frameworks d’agents. C’est là que le cache est le plus utile.
3.3 Exemple 3 : lecture d’un long document avec Kimi K3.1 Pro
Scénario : lire un document de 300 000 tokens et produire un résumé de 3 000 tokens.
- Entrée :
300000 × 2 ÷ 1000000 = $0.60 - Sortie :
3000 × 10 ÷ 1000000 = $0.03 - Total : environ
$0.63
Si vous posez une autre question sur le même document dans les cinq minutes, la partie correspondant au document utilisera le cache. Le coût d’entrée ne sera alors que de 300000 × 0.2 ÷ 1000000 = $0.06, auquel il faudra ajouter le coût de la sortie. Pour analyser plusieurs fois un même contrat, rapport financier ou dépôt de code, regrouper les questions pendant la durée de validité du cache permet de réduire nettement les coûts.
4. Prix unique pour la fenêtre de contexte de 1M de Kimi K3.1 Pro : que signifie l’absence de paliers ?
On peut comprendre le contexte comme « la quantité totale de contenu que le modèle peut voir en une seule fois » : cela comprend votre invite, l’historique de la conversation et les documents que vous téléversez. La documentation officielle indique que tous les modèles de la série K3 prennent en charge une fenêtre de contexte de 1 048 576 tokens et que K3.1 Pro applique une tarification à l’usage uniforme, sans paliers selon la longueur du contexte.
En substance, la FAQ officielle précise que K3.1 Pro offre une fenêtre de contexte de 1M avec une tarification à l’usage uniforme : l’écriture dans le cache, les entrées (avec ou sans cache) et les sorties sont toutes facturées au même tarif. Autrement dit, que vous envoyiez 2 000 tokens ou 800 000 tokens, le prix par million de tokens reste le même : 2 $. La longueur de la requête ne fait pas basculer le tarif vers un palier plus cher.
C’est un point important à prendre en compte dans les comparaisons, car tous les fournisseurs ne facturent pas de la même manière. La série GPT-6 d’OpenAI applique des paliers selon la longueur des entrées : jusqu’à 272K tokens, le tarif du contexte court s’applique ; au-delà, le tarif du contexte long, plus élevé, entre immédiatement en vigueur. Par exemple, pour GPT-6 Astra, le prix des entrées passe de 10 $ à 20 $, celui des sorties de 50 $ à 75 $ et celui des entrées réutilisées depuis le cache de 1,00 $ à 2,00 $. Claude suit une autre approche : sa page de tarification officielle indique que les modèles Claude 4.6 et ultérieurs (à l’exception de Claude Haiku 5.5) sont facturés au tarif standard sur toute leur fenêtre de contexte de 1M. Une requête de 900 000 tokens coûte donc le même prix unitaire qu’une requête de 9 000 tokens. Seul Claude Haiku 5.5 augmente ses tarifs lorsque l’invite dépasse 100 000 tokens. K3.1 Pro n’est donc pas le seul à ne pas appliquer de paliers : Claude Sonnet 5.5 et Opus 5.5 ne facturent pas davantage en fonction de la longueur. Ce sont les modèles de la série GPT-6 qui changent de palier.
Pour les développeurs, un tarif uniforme présente deux avantages directs :
- Le budget se calcule de façon linéaire : si le nombre de tokens double, le coût double aussi. Pas de hausse brutale à partir d’une certaine longueur ; vous pouvez donc calculer le coût d’un document de 300 000 tokens comme dans l’exemple 3 en appliquant directement le tarif unitaire.
- Inutile de découper les documents à tout prix : avec les modèles qui appliquent des paliers, certains découpent les longs documents en plusieurs parties pour éviter le tarif supérieur. Avec K3.1 Pro, cette méthode ne permet pas de faire des économies et peut même nuire aux résultats en réduisant le contexte disponible.
5. Pourquoi Kimi K3.1 Pro permet de faire des économies — et dans quels cas ce n’est pas le cas
Dans cette section, faisons les comptes sans enjoliver les choses. Le prix unitaire a bien baissé, mais le coût réel dépend aussi de la longueur des réponses.
| Critère | Détail | Source | Impact sur le coût |
|---|---|---|---|
| Baisse des prix unitaires | Les tarifs des entrées, des sorties et des accès au cache ont tous baissé de 33 % par rapport à K3 | Officiel / tiers | Économies |
| Prix des accès au cache | $0.20, soit un dixième du prix des entrées | Officiel | Économies importantes lorsque les longs préfixes sont réutilisés |
| Écriture dans le cache pendant 1 heure | $4, soit le double du prix des entrées | Officiel | Plus avantageux pour les tâches espacées dans le temps ; inutile pour les tâches courtes |
| Réflexion toujours activée | Impossible de désactiver la réflexion ; la sortie moyenne atteint 55K tokens, soit 14 % de plus que K3 | Officiel / tiers | Compense une partie de la baisse des prix |
| Coût par tâche | $1.98 (selon l’article de lancement) / $2.11 (coût pondéré affiché sur la page du modèle) | Tiers | Globalement comparable à K3 |
5.1 Les trois sources d’économies de Kimi K3.1 Pro
La première est la baisse directe de 33 % des prix unitaires : ils passent de $3/$15 pour K3 à $2/$10, et le prix des accès au cache descend de $0.30 à $0.20. Les tarifs officiels et les données d’Artificial Analysis concordent sur ce point. Deuxième avantage : un accès au cache coûte seulement un dixième du prix des entrées. Comme nous l’avons vu dans l’exemple 2, pour une conversation à plusieurs tours avec une longue invite fixe, cela peut réduire les coûts d’environ 60 %. Enfin, l’écriture dans le cache pendant 1 heure coûte certes deux fois plus cher, mais prolonge sa durée de conservation. Cette option est intéressante lorsque plus de 5 minutes séparent deux appels, par exemple pour un agent qui s’exécute toutes les quelques minutes ou pour une session de questions-réponses sur un long document, où l’utilisateur prend le temps de réfléchir avant de poser une autre question. Si le cache est réutilisé au moins deux fois en une heure, le surcoût de l’écriture est généralement amorti.
5.2 Dans quels cas Kimi K3.1 Pro ne permet pas de faire des économies
La réflexion désigne le processus par lequel le modèle élabore une réponse en interne avant de la fournir. Ces étapes de raisonnement sont elles aussi facturées comme des sorties. D’après la documentation officielle, il est impossible de désactiver la réflexion dans K3.1 Pro ; on peut seulement réduire son ampleur en réglant reasoning_effort sur low.
Selon les estimations d’Artificial Analysis (source tierce), K3.1 Pro produit en moyenne environ 55K tokens par tâche dans leur Intelligence Index, contre 48K pour K3, soit 14 % de plus. Le tarif des sorties étant le plus élevé, ces tokens supplémentaires absorbent une partie des économies réalisées grâce à la baisse des prix. Au final, le coût par tâche estimé par le tiers est d’environ $1.98 (selon l’article de lancement). La page du modèle affiche un coût pondéré par tâche de $2.11 (avec une remise de 90 % sur le cache), soit un coût globalement comparable à celui de K3.
En résumé : si votre activité repose surtout sur de longues entrées et la réutilisation du contexte sur plusieurs tours, la baisse des prix de K3.1 Pro se verra clairement sur la facture. En revanche, pour les tâches de raisonnement complexe qui génèrent de longues réponses, le coût par tâche ne sera pas forcément inférieur à celui de K3. Il vaut mieux commencer par tester le modèle sur un petit échantillon de tâches réelles, puis examiner la facture obtenue.
6. Seuils de recharge et niveaux de limitation du débit de Kimi K3.1 Pro
L’API officielle fonctionne à l’usage : il n’y a pas d’abonnement. Kimi API et les offres Kimi Member et Kimi Code sont facturées séparément ; un abonnement ne couvre donc pas les frais d’API. Il faut recharger au moins 1 $ sur son compte pour commencer à faire des appels. À partir de 5 $ de recharges cumulées, un bon d’achat de 5 $ est offert. Ce bon ne compte pas dans le montant cumulé des recharges (source officielle).
Le niveau de limitation du débit dépend du montant cumulé des recharges. Voici quelques abréviations utiles : la concurrence correspond au nombre de requêtes pouvant être traitées simultanément ; RPM désigne le nombre maximal de requêtes par minute ; TPM, le nombre maximal de jetons traités par minute ; et TPD, le nombre maximal de jetons traités par jour.
| Niveau | Recharges cumulées | Concurrence | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | 1 $ | 1 | 3 | 500 000 | 1 500 000 |
| Tier1 | 10 $ | 15 | 100 | 2 000 000 | Illimité |
| Tier2 | 20 $ | 40 | 100 | 3 000 000 | Illimité |
| Tier3 | 100 $ | 50 | 200 | 3 000 000 | Illimité |
| Tier4 | 1 000 $ | 60 | 200 | 4 000 000 | Illimité |
| Tier5 | 3 000 $ | 100 | 300 | 5 000 000 | Illimité |
Remarque : ces informations proviennent de la documentation officielle sur les limites de débit (page pricing/limits de platform.kimi.ai), consultée le 24 octobre 2026.
Les limites de Tier0 sont très strictes : seulement 3 requêtes par minute et 1,5 million de jetons au total par jour. Avec un document de 300 000 jetons, comme dans l’exemple 3, il suffit de le traiter 5 fois dans la journée pour atteindre la limite. De plus, avec un TPM de 500 000, il est impossible de traiter deux documents de cette taille en une minute. Pour du traitement par lots ou une mise en service auprès d’utilisateurs, mieux vaut passer au moins au Tier1 dès la phase de test.
Un autre point à ne pas négliger : selon les indications officielles, une limitation déclenchée par le système de contrôle des risques ne peut pas être levée. Avant la mise en service, prévoyez côté client un contrôle du débit des requêtes et une stratégie de nouvelle tentative avec temporisation progressive. Évitez d’utiliser des scripts parallèles pour tester les limites.
7. Comment payer et se connecter à Kimi K3.1 Pro depuis la Chine
Les canaux officiels affichent les prix en dollars et appliquent les règles de facturation liées à la région de paiement. Même si le paiement est possible directement depuis la Chine, les développeurs locaux se heurtent souvent à quelques difficultés : les moyens de paiement internationaux, les factures et la gestion des clés de plusieurs fournisseurs. Une autre solution consiste à passer par une plateforme d’agrégation d’API, qui permet d’appeler plusieurs modèles avec un seul compte et une seule clé.
APIYI (apiyi.com) est une plateforme d’agrégation d’API de grands modèles de langage. Une seule clé API permet d’appeler des modèles majeurs comme OpenAI, Claude et Gemini. Les interfaces sont compatibles avec le format OpenAI, la facturation se fait à l’usage et les nouveaux utilisateurs disposent d’un quota de test gratuit. D’après la vérification du catalogue de modèles de la plateforme, docs.apiyi.com/models, effectuée le 24 octobre 2026, les modèles Kimi actuellement disponibles sont les suivants :
kimi-k3: entrée à 3 $ / sortie à 15 $ / lecture du cache à 0,3 $kimi-k2.7-code: entrée à 0,95 $ / sortie à 3,99 $ / lecture du cache à 0,19 $kimi-k2.6: entrée à 0,6 $ / sortie à 2,4 $ / lecture du cache à 0,1 $kimi-k2.5: entrée à 0,6 $ / sortie à 3,15 $ / lecture du cache à 0,1 $
Au moment de cette vérification, kimi-k3.1-pro ne figurait pas encore dans le catalogue d’APIYI. Nous n’indiquons donc pas son prix sur la plateforme dans cet article. Pour connaître le nom exact du modèle, son prix et sa date de disponibilité, consultez la liste des modèles dans la console. Nous proposerons ce modèle dès que possible. D’ici là, vous pouvez tester le processus avec kimi-k3 : une fois K3.1 Pro disponible, il vous suffira de modifier le nom du modèle.
7.1 Premiers pas avec Kimi K3.1 Pro
Que vous passiez par le canal officiel ou par une plateforme d’agrégation, les étapes d’intégration sont à peu près les mêmes. Voici un exemple avec un format compatible avec OpenAI :
- Créez un compte et récupérez une clé API. Avec le canal officiel, vous devez d’abord ajouter au moins 1 $ de crédit.
- Dans le SDK ou le client OpenAI que vous utilisez, définissez
base_urlsurhttps://api.apiyi.com/v1si vous passez par APIYI. Si votre projet utilise le format Anthropic, indiquezhttps://api.apiyi.comcomme adresse de base. - Définissez
api_keyavec votre clé et renseignez dansmodelle nom indiqué dans la liste des modèles de la plateforme, par exemplekimi-k3, actuellement disponible. Lorsque K3.1 Pro sera proposé, utilisez le nom affiché dans la liste. - Pour réduire les coûts liés aux réponses de raisonnement, ajoutez
reasoning_effortaux paramètres de la requête et réglez-le surlow(selon la documentation officielle, K3.1 Pro permet uniquement de réduire le niveau de raisonnement, pas de le désactiver). - Placez votre long message système fixe au début des messages et ne le modifiez pas, afin que le préfixe répété puisse être automatiquement mis en cache.
- Après l’appel, vérifiez dans la facture ou dans les champs d’utilisation de la réponse le nombre de jetons en entrée, en cache et en sortie, puis refaites le calcul à l’aide de la formule de la section 3.
Conseil pour démarrer rapidement : utilisez d’abord le quota de test gratuit d’APIYI sur apiyi.com pour exécuter l’exemple 2 de la section 3. Comparez les données d’utilisation avec et sans préfixe fixe : c’est le moyen le plus rapide de vérifier que le cache fonctionne. Le nom du modèle et le prix de K3.1 Pro sur la plateforme dépendront de la liste des modèles. Nous proposerons ce modèle dès que possible.
Foire aux questions (FAQ)
Q1 : Quel est le prix exact de Kimi K3.1 Pro ?
Le tarif officiel est de 2 $ en entrée, 10 $ en sortie, 0,20 $ pour les tokens issus du cache, 2 $ pour l’écriture dans le cache de 5 minutes et 4 $ pour celle dans le cache d’une heure. Les prix sont en dollars par million de tokens, hors taxes. Données relevées le 24 octobre 2026.
Q2 : Kimi K3.1 Pro coûte-t-il 33 % moins cher que K3 ? La facture baisse-t-elle vraiment de 33 % ?
Les trois tarifs unitaires sont inférieurs de 33 % (selon les tarifs officiels). Cependant, K3.1 Pro active toujours le mode réflexion et génère en moyenne 14 % de tokens supplémentaires. Selon les estimations du tiers Artificial Analysis, le coût par tâche passe d’environ 1,98 $ à 2,11 $, soit un montant globalement comparable à celui de K3. Les économies sont plus importantes avec de longues entrées et la réutilisation du contexte sur plusieurs tours.
Q3 : Entre Kimi K3.1 Pro et Claude Sonnet 5.5, lequel revient le moins cher ?
Les deux modèles facturent l’entrée et la sortie au même tarif : 2 $/10 $. Sonnet 5.5 propose un tarif inférieur pour les tokens issus du cache (0,10 $), tandis que l’écriture dans le cache de 5 minutes est moins chère avec K3.1 Pro (2 $ contre 2,50 $). Le tarif reste le même pour une fenêtre de contexte de 1 M de tokens. Sonnet convient mieux à la réutilisation fréquente de préfixes courts ; K3.1 Pro, à l’envoi ponctuel de longs documents. Le mieux est de comparer les deux modèles avec vos tâches réelles.
Q4 : Le cache d’une heure de Kimi K3.1 Pro vaut-il le coût ?
L’écriture dans le cache d’une heure coûte 4 $, soit 2 $ de plus que celle dans le cache de 5 minutes. Cette option est généralement intéressante si le même préfixe est réutilisé au moins deux fois entre 5 minutes et 1 heure après sa première utilisation. Si vos appels sont concentrés sur quelques minutes, le cache de 5 minutes par défaut suffit.
Q5 : Comment les développeurs en Chine peuvent-ils appeler Kimi K3.1 Pro via une API ?
Vous pouvez passer par le canal officiel ou utiliser l’interface compatible avec OpenAI d’APIYI, sur apiyi.com. Renseignez `https://api.apiyi.com/v1` dans `base_url`. La plateforme propose déjà des modèles comme `kimi-k3` et `kimi-k2.7-code`. Consultez la liste des modèles de la plateforme pour connaître le nom et le tarif de K3.1 Pro ; nous proposerons ce modèle dès que possible.
Q6 : L’abonnement Kimi permet-il de déduire les frais d’API ?
Non. D’après les informations officielles, l’API Kimi est facturée à l’usage, sans abonnement. La facturation de l’API est distincte de celle de Kimi et de Kimi Code.
Q7 : Quels pièges tarifaires faut-il connaître pour Kimi K3.1 Pro ?
– Le mode réflexion ne peut pas être désactivé, ce qui peut augmenter le nombre de tokens générés. Vous pouvez atténuer cet effet en définissant `reasoning_effort` sur `low`.
– Le niveau Tier 0 est limité à 3 RPM et 1,5 million de TPD. Si vos besoins sont importants, demandez une montée en gamme à l’avance.
– Une fois le contrôle des risques déclenché, la limitation de débit ne peut pas être levée.
– L’extraction de fichiers est gratuite, mais le contenu extrait est facturé comme une entrée lorsqu’il est envoyé au modèle.
Q8 : Que peut-on préparer dès maintenant sur les plateformes qui ne proposent pas encore K3.1 Pro ?
Vous pouvez commencer par configurer votre flux d’appels, la structure du cache et le suivi de l’utilisation avec `kimi-k3` sur APIYI, apiyi.com. Lorsque K3.1 Pro sera disponible, il suffira de remplacer le nom du modèle. Consultez la liste des modèles de la plateforme pour connaître le nom et le tarif exacts ; nous proposerons ce modèle dès que possible.
Points clés sur le prix de Kimi K3.1 Pro
- Tarif de base : 2 $ en entrée / 10 $ en sortie / 0,20 $ pour les tokens issus du cache. Tarifs officiels, hors taxes.
- Cinq tarifs disponibles : 2 $ pour une écriture avec cache de 5 minutes et 4 $ pour une écriture avec cache d’une heure ; les coûts d’écriture sont très faibles.
- Positionnement : au même prix que Sonnet 5.5 et GPT-6.1 Sol, et deux fois moins cher qu’Opus 5.5.
- Tarif uniforme : le contexte de 1M tokens n’est pas facturé par tranches de longueur, ce qui permet d’estimer le budget de façon linéaire.
- Coût réel : le modèle réfléchit en permanence et génère 14 % de contenu en plus. Le coût par tâche reste donc globalement comparable à celui de K3 (selon une source tierce).
- Seuil d’entrée : recharge à partir de 1 $, avec seulement 3 RPM au niveau Tier 0. Les limitations de débit liées au contrôle des risques ne peuvent pas être levées.
- Accès depuis la Chine : vous pouvez passer par APIYI pour utiliser une interface compatible avec OpenAI. Le nom du modèle et son prix sur la plateforme sont ceux indiqués dans la liste des modèles ; nous proposerons ce modèle dès que possible.
Résumé
Voici les points clés sur le prix de Kimi K3.1 Pro :
- Tarif unitaire : 2 $ en entrée / 10 $ en sortie / 0,20 $ pour les tokens issus du cache, soit 33 % de moins que K3. Le contexte de 1M tokens est facturé à un tarif uniforme.
- Pour réduire les coûts : placez les préfixes fixes et longs au début et tirez parti du cache. Dans une conversation à plusieurs tours, vous pouvez économiser environ 60 % sur les coûts d’entrée.
- À prévoir côté coûts : la réflexion permanente allonge les réponses. Pour les tâches de raisonnement complexes, le coût par tâche reste proche de celui de K3 ; ne partez donc pas du principe que votre budget baissera de 33 %.
- Avant la mise en production : faites évoluer à l’avance votre niveau de limitation de débit et contrôlez le rythme des requêtes pour éviter les restrictions liées au contrôle des risques, qui ne peuvent pas être levées.
Commencez par estimer vos coûts à l’aide de la formule de la section 3 et de la répartition de vos propres tokens, puis vérifiez le résultat sur quelques tâches réelles. Si vous souhaitez comparer Kimi, Claude, GPT et d’autres modèles depuis la Chine avec une seule clé, vous pouvez demander un crédit gratuit sur APIYI, à l’adresse apiyi.com, pour effectuer des tests. Le nom du modèle et son prix pour K3.1 Pro sur la plateforme sont ceux indiqués dans la liste des modèles ; nous proposerons ce modèle dès que possible.
Références
- Plateforme développeur Kimi – Tarification des modèles : tarifs des cinq niveaux de K3.1 Pro et des autres modèles, ainsi que règles de facturation
- Lien :
platform.kimi.ai/docs/pricing/chat -
Remarque : source officielle de la grille tarifaire de cet article et des règles de facturation unifiées pour les contextes de 1M
-
Plateforme développeur Kimi – Rechargement et limitation du débit : niveaux Tier0 à Tier5 et informations sur la gestion des risques
- Lien :
platform.kimi.ai/docs/pricing/limits -
Remarque : source officielle concernant les seuils de rechargement et les limites RPM/TPM/TPD
-
Artificial Analysis – Kimi K3.1 Pro : estimation du coût par tâche et du nombre de jetons en sortie par un tiers
- Lien :
artificialanalysis.ai -
Remarque : source des données de cet article sur le coût par tâche de 1,98 $ / 2,11 $ et les 55K jetons en sortie
-
Liste des modèles APIYI : modèles actuellement disponibles sur la plateforme et leurs tarifs
- Lien :
docs.apiyi.com/models - Remarque : disponibilité effective des modèles Kimi, Claude et d’autres sur la plateforme
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour en savoir plus, consultez le centre de documentation sur docs.apiyi.com.