Note de l’auteur : comparer séparément Gemini 4 Neon et GPT-6.2 Sol sur trois axes — codage, graphiques et contexte long — puis vérifier le coût par tâche, le temps d’exécution, le tarif officiel et le prix catalogue APIYI, en indiquant la source de chaque chiffre.
Beaucoup d’équipes considèrent GPT-6.2 Sol comme l’option la moins chère. Gemini 4 Neon est sorti le 2026-11-18 ; la page modèle d’Artificial Analysis lui attribue un score d’intelligence de 61, contre 57 pour Sol. Savoir sur quelles tâches se répartissent ces 4 points détermine ce que cela vaut pour votre charge de travail. Cet article examine séparément le codage, les graphiques et le contexte long, puis divise le coût par tâche et le tarif unitaire en deux séries de chiffres.
Chaque chiffre de l’article porte une étiquette de source : chiffres communiqués par l’éditeur, fiche modèle, page modèle d’Artificial Analysis, article d’Artificial Analysis, tableau récapitulatif APIYI, endpoint de tarification. Lorsque deux bases de calcul ne concordent pas, les chiffres sont conservés côte à côte : pas de moyenne, pas de nouvel indicateur synthétique.
À retenir : à la fin de la lecture, vous saurez sur quels éléments se concentrent les points supplémentaires de Neon, sur quel axe Sol obtient finalement un meilleur score, de combien les deux modèles diffèrent en coût par tâche et en temps d’exécution, et comment appeler gpt-6.2-sol, déjà référencé sur APIYI.
Gemini 4 Neon et GPT-6.2 Sol : l’essentiel des différences
Commençons par regrouper les sept lignes les plus importantes. Attention aux niveaux : sur la page du modèle Artificial Analysis, le score de 61 pour Neon provient du niveau xhigh, tandis que le 57 de Sol provient du niveau max. Les deux correspondent au niveau le plus élevé indiqué sur leur page respective, mais les noms et la signification des niveaux diffèrent.
| Axe de comparaison | Gemini 4 Neon | GPT-6.2 Sol | Source |
|---|---|---|---|
| Score d’intelligence global | 61 (xhigh) | 57 (max) | Page du modèle Artificial Analysis |
| Codage : Terminal-bench 4.1 (précision après ajustement pour triche) | 65,2 % | 61,5 % | Fiche modèle |
| Graphiques : Chartography | 73,5 % | 75,1 % | Fiche modèle |
| Contexte long : GraphWalks (de 256k à 1M, F1 pour BFS) | 95,2 % | 80,1 % | Fiche modèle |
| Coût par tâche | 6,44 $ | 1,01 $ | Page du modèle Artificial Analysis |
| Temps par tâche | 21,5 minutes | 8,5 minutes | Page du modèle Artificial Analysis |
| Tarif (entrée/sortie, par million de tokens) | 3 / 15 $ | 2 / 10 $ | Auto-déclaration officielle / page du modèle Artificial Analysis |
Trois précisions de cadrage avant de lire le tableau comparatif Gemini 4 Neon / GPT-6.2 Sol
Premier point : la nature de la fiche modèle. Le tableau comparatif de la fiche modèle DeepMind ne comporte que trois colonnes : Gemini 4 Neon, Claude Opus 5.5 et GPT-6.2 Sol. Le PDF explicatif de l’évaluation qui l’accompagne précise que les résultats des modèles autres que Gemini proviennent par défaut des auto-déclarations de chaque éditeur. La colonne Sol de la fiche modèle correspond donc à des chiffres officiels compilés par Google, et non à un retest réalisé le même jour par le même laboratoire.
Deuxième point : la cohérence du score d’intelligence. Le chiffre 61 est identique dans le blog de Google (auto-déclaré), sur la fiche modèle (la ligne AA Index v5.0.1 indique 61 / 59 / 57) et sur la page du modèle Artificial Analysis. Les 57 de Sol concordent également entre la fiche modèle et la page du modèle Artificial Analysis. Les indices liés au codage sont moins homogènes ; nous les présenterons séparément ci-dessous.
Troisième point : la base de calcul des coûts. Le coût par tâche d’Artificial Analysis correspond au montant réparti par tâche après exécution de l’ensemble de la suite d’indices ; il dépend à la fois du prix unitaire et du nombre de tokens de sortie. Ce chiffre et le prix d’un appel unique facturé au token par une plateforme relèvent de deux comptabilités distinctes et ne sont pas interchangeables.
Comparaison des capacités de codage : Gemini 4 Neon vs GPT-6.2 Sol
Côté codage, parmi les cinq sous-scores fournis dans les fiches techniques, Neon dépasse Sol sur tous ceux pour lesquels des données existent, mais les écarts sont très inégaux. Le tableau ci-dessous provient uniquement des fiches techniques ; les chiffres de Sol sont, d’après les notes d’évaluation, auto-déclarés par OpenAI.
| Sous-score de codage (fiche technique) | Gemini 4 Neon | GPT-6.2 Sol | Écart |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | Aucune donnée | Non comparable |
| Terminal-bench 4.1 (après ajustement pour triche) | 65.2% | 61.5% | 3.7 points de pourcentage |
| FrontierCode 2.0 | 46.2% | 43.8% | 2.4 points de pourcentage |
| SWE-sweep (harness du fournisseur) | 39.0% | 8.3% | 30.7 points de pourcentage |
| SWE-sweep (harness mini-SWE) | 12.8% | 11.6% | 1.2 point de pourcentage |
Les deux harness de SWE-sweep doivent être lus séparément
SWE-sweep est la ligne la plus facile à mal interpréter. Les 39.0% de Neon viennent d’Antigravity de Google, le harness du fournisseur ; avec le harness mini-SWE commun, on retombe à 12.8%. Le blog de Google (auto-déclaré) présente l’écart entre 12.8 et 39.0 comme ce que le harness permet de débloquer. Ces chiffres décrivent donc l’effet combiné « modèle + chaîne d’outils ».
Avec le même harness mini-SWE, Neon est à 12.8% contre 11.6% pour Sol, soit seulement 1.2 point de pourcentage d’écart. Dans le harness de son propre fournisseur, Sol est à 8.3%, donc moins que son score mini-SWE. Si votre agent de codage ne tourne pas dans Antigravity, c’est la ligne mini-SWE qui se rapproche le plus des conditions que vous pouvez reproduire.
Les deux chiffres du Coding Agent Index
Le blog de Google (auto-déclaré) indique que Neon obtient 58.6 au Coding Agent Index d’Artificial Analysis et affirme qu’il est premier au classement général. L’article d’Artificial Analysis mentionne, lui, 59 pour Neon xhigh sur Antigravity CLI. Les deux chiffres viennent de sources différentes ; nous les conservons tous les deux, sans les fusionner. Les références ne donnent pas le score de Sol à cet index, donc impossible de comparer les deux modèles sur ce point. Par ailleurs, le 46.2% de FrontierCode 2.0 a été mesuré, selon les données auto-déclarées, avec le niveau high par défaut.
Comparaison des capacités graphiques de Gemini 4 Neon et GPT-6.2 Sol
Les graphiques constituent le domaine où Sol est le plus à son avantage des trois. Sur la ligne Chartography de la fiche modèle, Neon affiche 73,5 % et Sol 75,1 %, soit 1,6 point de pourcentage d’avance pour Sol. Le blog Google (chiffres auto-déclarés par l’éditeur) donne le même 73,5 % pour Neon : les deux sources concordent.
Sur LVBench, qui relève elle aussi de la compréhension multimodale, la fiche modèle indique 89,0 % pour Neon et 87,6 % pour Sol, soit 1,4 point d’avance pour Neon. Les deux résultats vont dans des directions opposées et les écarts restent modestes : difficile de résumer en une phrase « qui est le meilleur sur les graphiques et les tâches visuelles ». Tout dépend si votre tâche ressemble davantage à la lecture d’un graphique ou à l’analyse de longues vidéos.
Côté modalités d’entrée, la fiche modèle précise que Neon accepte le texte, les images, l’audio et la vidéo. Les sources consultées ne donnent pas la liste des modalités d’entrée de Sol ; si votre pipeline dépend d’entrées audio ou vidéo, vérifiez d’abord dans la documentation officielle OpenAI si Sol les prend en charge.
Comparaison du contexte long entre Gemini 4 Neon et GPT-6.2 Sol
Pour le contexte long, cet article s’appuie uniquement sur les données GraphWalks des fiches modèles. Sur un parcours BFS dans la plage allant de 256k à 1M de tokens, le score F1 atteint 95,2 % pour Neon contre 80,1 % pour Sol, soit 15,1 points d’écart : c’est la différence la plus marquée des trois.
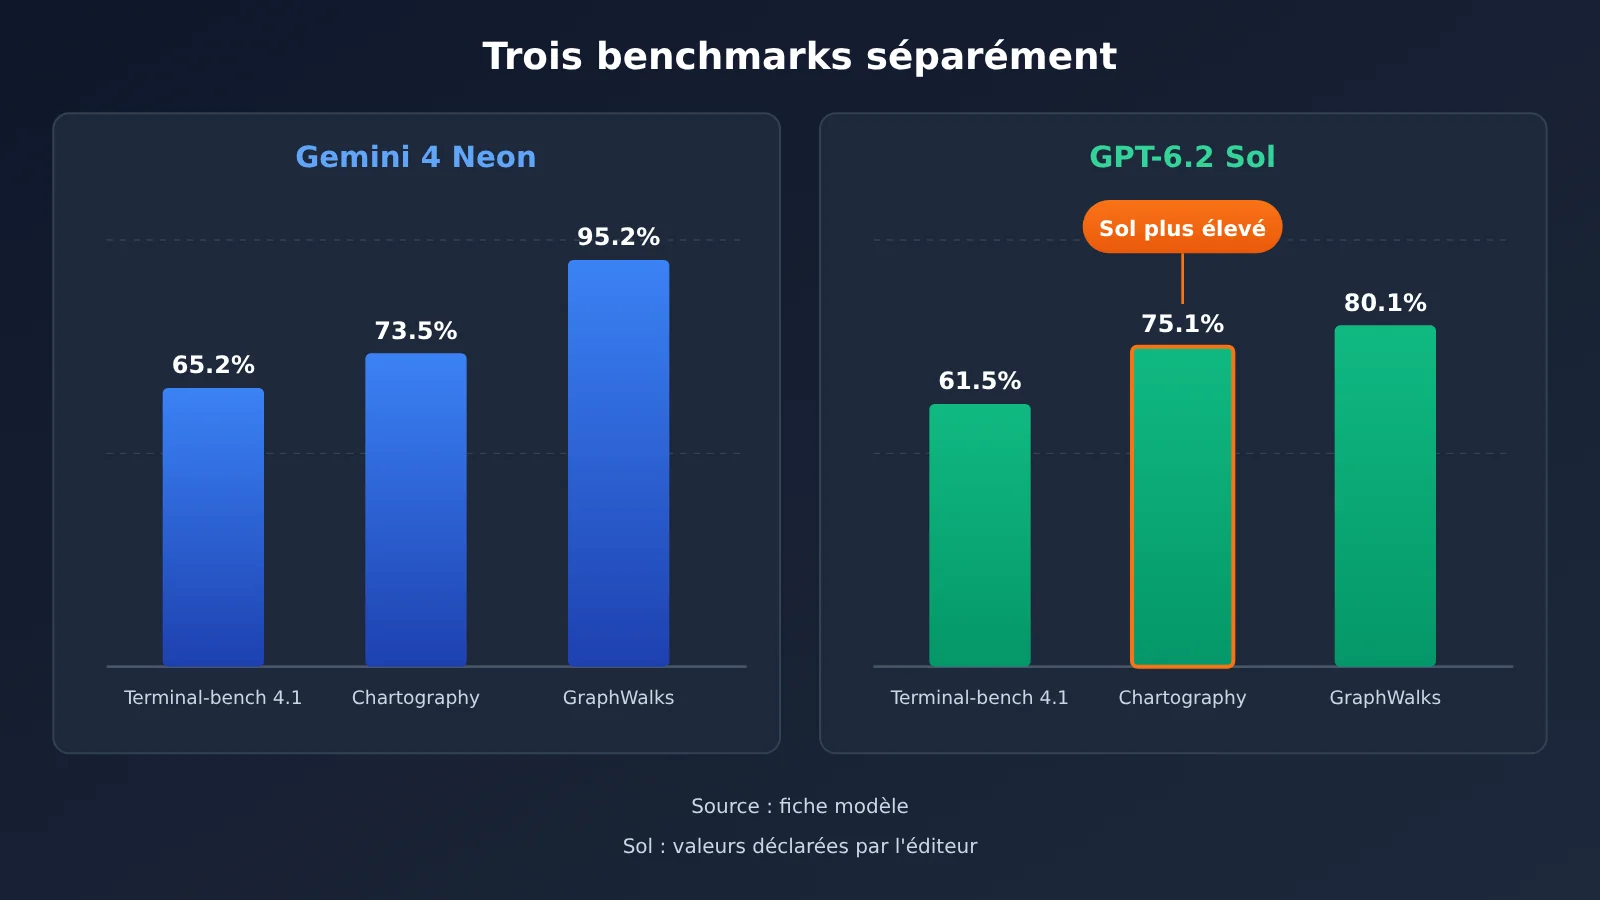
📊 Note sur le graphique : tous les chiffres ci-dessus proviennent des fiches modèles, et la colonne Sol relève, selon les notes d’évaluation, d’une auto-déclaration du fournisseur. Pour vérifier vous-même les performances de Sol sur vos propres documents longs, vous pouvez lancer directement une requête
gpt-6.2-solavec la même clé via APIYI apiyi.com.
Les paramètres de contexte long de Gemini 4 Neon
Côté Neon, la spécification de la fenêtre est entièrement documentée. La fiche modèle indique une fenêtre unifiée allant jusqu’à 1 million de tokens, une sortie synchrone de 64 000 tokens maximum par défaut, et un décodage long en arrière-plan jusqu’à 1 million. Le guide développeur de Google Cloud donne les valeurs exactes : limite unifiée de 1048576 tokens, englobant à la fois l’entrée et la sortie, la sortie comprenant elle-même la réflexion, les appels de fonction et la réponse finale ; un segment unique est par défaut plafonné à 65536 tokens, le décodage long pouvant monter jusqu’à 1048576 moins la taille de l’entrée.
Du côté du cache, le guide développeur précise que Neon ne prend pas en charge le cache de contexte explicite. Le cache implicite s’active automatiquement sur les préfixes partagés de plus de 4096 tokens, et le cache persistant est activé par défaut. Pour les cas où vous interrogez un long document à répétition, cela signifie qu’il faut garder un préfixe partagé stable pour profiter du tarif de cache à 0,15 dollar indiqué sur la page tarifs d’AI Studio.
Les informations de contexte long de GPT-6.2 Sol
Les sources consultées ne fournissent pas la limite supérieure de la fenêtre de contexte de Sol ; cet article ne compare donc pas la taille des fenêtres. Ce qui est confirmé, c’est la facturation : le tableau récapitulatif d’APIYI montre que gpt-6.2-sol change de palier dès que l’entrée dépasse 272000 tokens, ce que nous détaillerons dans la partie consacrée aux prix. Sur les tâches à contexte long, ce seuil influence directement la structure de votre facture.
Comparaison des coûts et des durées entre Gemini 4 Neon et GPT-6.2 Sol
L’écart de coût par tâche est bien plus marqué que l’écart de prix unitaire. La page modèle d’Artificial Analysis indique que Neon xhigh coûte 6,44 dollars par tâche, contre 1,01 dollar pour Sol max, soit environ 6,4 fois plus ; or, le rapport de prix d’entrée entre les deux est de 3 à 2, et celui de prix de sortie de 15 à 10, soit 1,5 fois dans les deux cas.
Le surplus vient du volume de sortie. Sur la même page, Neon xhigh a généré 283 millions de tokens sur l’indice, contre 60,9 millions pour Sol max, soit environ 4,6 fois plus pour le premier. Un prix unitaire supérieur de moitié et un volume de sortie plusieurs fois plus élevé : c’est la combinaison des deux qui aboutit au résultat de 6,44 contre 1,01.
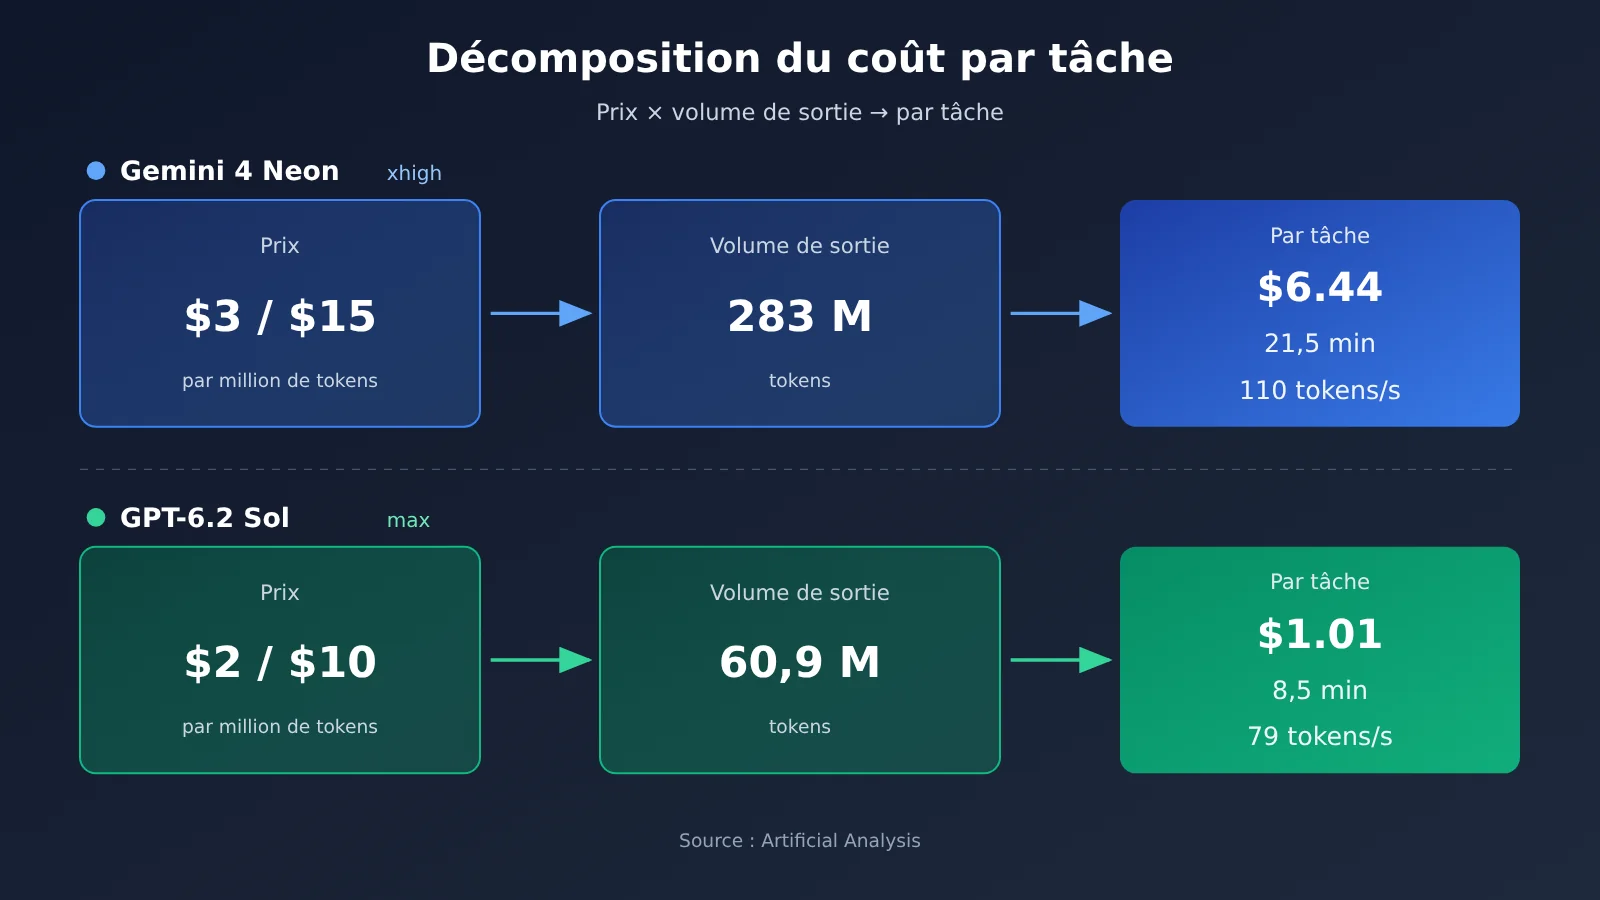
Il en va de même pour la durée. Neon xhigh produit à environ 110 tokens/seconde, soit plus que les 79 tokens/seconde de Sol max, mais son volume de sortie est plus important, d’où un temps par tâche de 21,5 minutes contre 8,5 minutes. Pour le temps jusqu’au premier token de réponse, Neon xhigh est à 56,51 secondes et Sol max à 75,06 secondes : sur ce point, Neon est plus rapide.
Les scores d’intelligence et le temps par tâche selon le niveau
Les deux modèles ont plusieurs niveaux de réflexion ; le tableau ci-dessous provient de la page modèle d’Artificial Analysis. Seule la ligne du niveau le plus élevé donne un coût par tâche ; pour les autres niveaux, la page fournit le score, le temps et la vitesse.
| Niveau | Score d’intelligence Neon | Temps par tâche Neon | Vitesse de sortie Neon | Score d’intelligence Sol | Temps par tâche Sol | Vitesse de sortie Sol |
|---|---|---|---|---|---|---|
| max | Niveau inexistant | — | — | 57 | 8,5 minutes | 79 tokens/seconde |
| xhigh | 61 | 21,5 minutes | 110 tokens/seconde | 56 | 5,3 minutes | 76 tokens/seconde |
| high | 60 | 14,8 minutes | 101 tokens/seconde | 55 | 4,6 minutes | 73 tokens/seconde |
| medium | 55 | 8,3 minutes | 101 tokens/seconde | 53 | 3,2 minutes | 70 tokens/seconde |
| low | 44 | 3,7 minutes | 97 tokens/seconde | 41 | 1,5 minutes | 65 tokens/seconde |
Ce tableau se lit de deux façons. Si l’on compare les niveaux de même nom, le niveau high de Neon obtient 60 points contre 55 pour Sol, avec 14,8 minutes contre 4,6 minutes. Si l’on regarde le temps, les 8,3 minutes de Neon medium sont proches des 8,5 minutes de Sol max, avec un score de 55 contre 57. Le niveau par défaut de Neon est high (c’est ce qu’indiquent le guide du développeur et la dernière page modèle d’AI Studio), et c’est aussi la ligne sur laquelle beaucoup d’intégrations se retrouvent par défaut. Les temps du premier token pour les trois derniers niveaux de Neon sont indiqués séparément dans la FAQ de la page modèle : high 40,64 secondes, medium 20,14 secondes, low 13,93 secondes ; ces valeurs ne figurent pas dans la même colonne que le tableau récapitulatif.
Comparatif de prix Gemini 4 Neon vs GPT-6.2 Sol : tarifs officiels et prix pratiqués par APIYI
Côté prix unitaire, il faut distinguer deux niveaux : le tarif affiché par le fournisseur du modèle ou par des pages tierces, et le prix « rayon » chez APIYI (apiyi.com).
| Élément | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| Prix d’entrée affiché (par million de tokens) | 3,00 USD (déclaré par l’éditeur / page de tarification AI Studio) | 2,00 USD (page modèle d’Artificial Analysis) |
| Prix de sortie affiché (par million de tokens) | 15,00 USD, tokens de réflexion inclus | 10,00 USD |
| Cache | 0,15 USD, cache implicite uniquement | Remise de 95 % sur le cache (page modèle d’Artificial Analysis) |
| Offre gratuite | Aucune (page de tarification AI Studio) | Non mentionnée dans les sources |
| ID de modèle chez APIYI | Pas encore disponible | gpt-6.2-sol |
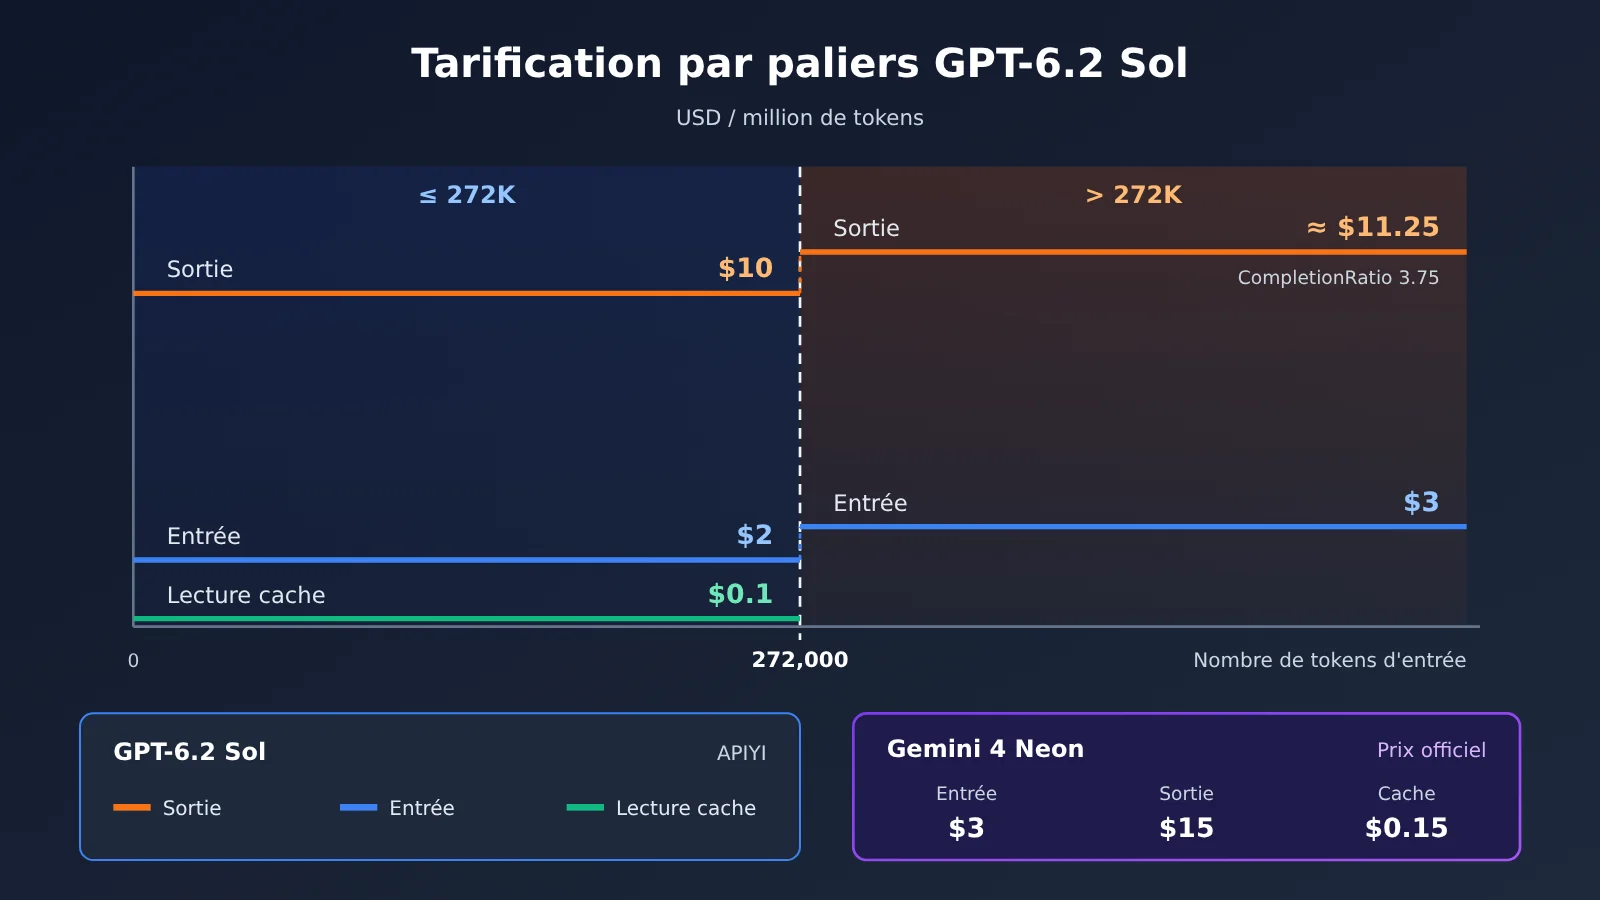
| Premier palier APIYI (0 à 272 000 tokens d’entrée) | — | Entrée 2 / lecture de cache 0,1 / sortie 10 USD |
| Palier supérieur APIYI (plus de 272 000 tokens d’entrée) | — | Entrée 3 USD ; sortie d’environ 11,25 USD selon l’API de tarification |
| Endpoints APIYI | — | responses (recommandé), chat |
| Plateformes disponibles | Canaux officiels tels que l’API Gemini de Google AI Studio | APIYI apiyi.com, entre autres |
gemini-4-neon n’apparaît ni dans le tableau récapitulatif d’APIYI ni dans l’API de tarification : le modèle n’est pas encore en ligne. Nous le publierons dès que possible ; les identifiants et les prix font foi selon la liste des modèles de la plateforme.
Les nuances du changement de palier de gpt-6.2-sol chez APIYI
Le tableau récapitulatif d’APIYI (mise à jour indiquée sur la page : 2026-11-16 09:39, UTC+8) annonce pour gpt-6.2-sol un premier palier à 2 USD en entrée, 0,1 USD en lecture de cache et 10 USD en sortie — cohérent avec les tarifs 2/10 de la page modèle d’Artificial Analysis. Au-delà de 272 000 tokens d’entrée, le corps du tableau précise seulement que l’entrée passe de 2 à 3 USD.
L’API de tarification interrogée le 2026-11-19 (version shell-api-modelmak-v1, 285 modèles au total) donne des informations plus complètes. Dans cette API, model_ratio à 1 correspond à 2 USD par million de tokens en entrée, et completion_ratio à 5 signifie que la sortie coûte 5 fois l’entrée ; au-delà de 272 000 tokens, CompletionRatio passe de 5 à 3,75, ce qui, sur une base de 3 USD en entrée, donne une sortie d’environ 11,25 USD par million de tokens, et non 10 USD comme on pourrait le penser.
Les noms de groupes diffèrent légèrement d’un endroit à l’autre : le tableau récapitulatif écrit CodexResponses, Codex_Reverse, Default, SVIP, tandis que l’API de tarification écrit CodexResponses, CodexReverse, default, svip. Autre point à souligner : le 1,01 USD d’Artificial Analysis correspond au coût d’un passage de l’indice réparti sur chaque tâche, ce qui n’a rien à voir avec les frais de tokens réellement générés par un appel sur la plateforme.
Comparaison des scénarios entre Gemini 4 Neon et GPT-6.2 Sol
Voici, par type de tâche, les chiffres les plus pertinents, pour vous aider à faire correspondre les évaluations à votre propre charge de travail. Lequel est le plus adapté dépend de la répartition de vos tâches et de votre budget ; il ne s’agit ici que d’une mise en regard, sans conclusion.
Les chiffres liés aux agents de codage
- Exécuté dans Google Antigravity : regardez la ligne SWE-sweep du harness de l’éditeur, Neon 39,0 %, Sol 8,3 %, en gardant en tête que Google attribue lui-même cet écart au harness.
- Exécuté dans un harness générique : regardez la ligne mini-SWE, 12,8 % contre 11,6 %, ainsi que Terminal-bench 4.1 avec 65,2 % contre 61,5 %.
- Petites modifications fréquentes : le temps par tâche compte davantage ; comparez les durées du tableau des paliers pour une même tranche de score.
Les chiffres liés aux graphiques et aux documents longs
- Questions-réponses sur des graphiques financiers et des captures d’écran de tableaux de bord : Chartography donne Sol 75,1 %, Neon 73,5 %, une tendance inverse de celle du score global.
- Parcours de structures de graphe ou de documents de l’ordre de plusieurs centaines de milliers de tokens : GraphWalks donne Neon 95,2 %, Sol 80,1 %, tout en intégrant dans le coût le changement de palier de Sol sur APIYI au-delà de 272 000 tokens.
- Compréhension de vidéos longues : LVBench donne Neon 89,0 %, Sol 87,6 %, et la fiche du modèle précise que Neon prend en charge l’entrée vidéo.
Gemini 4 Neon vs GPT-6.2 Sol : conseils de décision — vérifiez d’abord, choisissez ensuite
Avant de faire votre choix, je vous conseille de passer en revue votre situation dans l’ordre ci-dessous, plutôt que de trancher directement sur le 61 contre 57.
- Comptez la part de chacune de vos trois catégories de tâches — codage, graphiques, contexte long — puis reportez-vous aux trois tableaux détaillés plus haut.
- Estimez le volume de sortie moyen par tâche. Les données d’Artificial Analysis montrent que l’écart de coût par tâche entre les deux modèles vient essentiellement du volume de sortie : plus vos sorties sont longues, plus cet écart se creuse.
- Vérifiez si la longueur d’entrée dépasse 272 000 tokens. Au-delà, les prix d’entrée et de sortie de
gpt-6.2-solsur APIYI changent tous les deux. - Vérifiez le niveau de réflexion. Neon ne prend en charge que quatre niveaux : low, medium, high et xhigh ; passer
thinking_budgetouMINIMALrenvoie une erreur HTTP400(guide du développeur). - Faites tourner un petit lot comparatif sur votre propre jeu d’échantillons, en notant les scores, les temps d’exécution et la consommation de tokens.
💡 Conseil de choix : chaque modèle a ses points forts et ses points faibles selon les catégories, et la décision finale dépend de la répartition de vos tâches et de votre budget. Je vous suggère de commencer par brancher
gpt-6.2-sol, déjà disponible sur APIYI apiyi.com, de noter la consommation de tokens et les temps d’exécution sur vos propres échantillons, puis de rejouer la comparaison avec le même script une fois Neon disponible.
Comment appeler rapidement GPT-6.2 Sol via APIYI
APIYI recommande le point de terminaison responses pour gpt-6.2-sol ; l’URL de base compatible OpenAI est https://api.apiyi.com/v1. L’intégration se fait en quatre étapes :
- Préparer la clé : générez une clé API dans la console de la plateforme, placez-la dans la variable d’environnement
APIYI_API_KEY, et lisez-la uniquement depuis cette variable dans le code — jamais en clair. - Définir l’adresse de requête : le point de terminaison Responses est
POST https://api.apiyi.com/v1/responses, avec les en-têtesAuthorization: Bearer $APIYI_API_KEYetContent-Type: application/json. - Construire le corps de requête : le corps minimal est
{"model": "gpt-6.2-sol", "input": "请总结这份季度报告里的三张图表"}. - Appeler avec le SDK OpenAI : initialisez
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"]), puis appelezclient.responses.create(model="gpt-6.2-sol", input=...), et lisez le résultat dansoutput_textde l’objet retourné.
Si votre code existant s’appuie sur Chat Completions, vous pouvez aussi envoyer le même ID de modèle au point de terminaison chat, dont le chemin est /v1/chat/completions. Le protocole natif Gemini passe par https://api.apiyi.com avec la version v1beta, pour les modèles Gemini déjà disponibles sur la plateforme.
Pour les tests de contexte long, je vous conseille de consigner aussi le nombre de tokens d’entrée de chaque requête dans les logs, afin de voir facilement si vous franchissez le palier de 272000. Pour les valeurs précises des paramètres de niveau de raisonnement, référez-vous à la documentation officielle OpenAI et à la page du modèle sur la plateforme.
🚀 Démarrage rapide : les nouveaux utilisateurs peuvent récupérer un quota d’essai gratuit sur APIYI (apiyi.com) et utiliser une seule clé pour appeler en même temps les modèles OpenAI, Claude, Gemini, etc. déjà disponibles. Commencez par faire fonctionner la chaîne responses de
gpt-6.2-sol; ensuite, pour changer de modèle, il suffit de modifier le champmodel.
FAQ — Questions fréquentes
Q1 : Quelles sont les positionnements respectifs de Gemini 4 Neon et GPT-6.2 Sol ?
Neon est dérivé de Gemini 4 Carbon (fiche modèle), et le guide développeurs de Google le situe entre Hydrogen (boucle quotidienne rapide) et Carbon (traitement long et complexe). GPT-6.2 Sol est affiché à 2/10 dollars sur la page modèle d’Artificial Analysis, avec un score d’intelligence maximal de 57 dans le palier le plus élevé (max).
Q2 : Où se concentrent les 4 points d’avance de Neon sur Sol ?
Si l’on regarde le détail par sous-test de la fiche modèle, les écarts les plus marqués sont le GraphWalks en contexte long (95,2 % contre 80,1 %) et le SWE-sweep sous le harness du constructeur (39,0 % contre 8,3 %). Sur le test Chartography, c’est Sol qui devance (75,1 % contre 73,5 %).
Q3 : Quand Gemini 4 Neon sort-il, et sur quels canaux est-il disponible ?
La date de publication du blog Google est le 2026-11-18. D’après le post d’annonce de Sundar Pichai, le modèle est disponible le jour même sur la Gemini API de Google AI Studio, sur Gemini for business, sur Google Antigravity pour les offres payantes Google AI Pro et Ultra, ainsi que sur l’application Gemini pour les offres Pro et Ultra. L’identifiant du modèle est `gemini-4-neon`.
Q4 : Peut-on utiliser le 1,01 dollar par tâche de Sol comme budget d’appel ?
Ce chiffre correspond au coût par tâche obtenu par Artificial Analysis en répartissant le coût total sur l’ensemble de l’indice ; Sol max génère 60,9 millions de tokens en sortie dans ce test. Votre dépense réelle dépendra de votre propre volume de tokens d’entrée et de sortie ainsi que de votre palier tarifaire. Nous vous conseillons d’estimer à partir du premier palier 2 / 0,1 / 10 dollars du tableau récapitulatif d’APIYI, et de faire attention au changement de palier au-delà de 272000 tokens.
Q5 : Comment appeler rapidement ces deux modèles via API ?
`gpt-6.2-sol` est déjà disponible sur APIYI. Inscrivez-vous sur apiyi.com, récupérez vos crédits de test, puis définissez `base_url` sur `https://api.apiyi.com/v1` et appelez l’endpoint `responses`. Pour l’instant, `gemini-4-neon` n’apparaît ni dans le tableau récapitulatif ni dans l’interface de tarification : il n’est pas encore disponible, mais nous le mettrons en ligne dès que possible. Les modèles et les prix font foi selon la liste des modèles de la plateforme.
Q6 : Quelles sont les limites de ces données comparatives ?
Il y en a principalement trois :
– **Méthodologie** : dans la fiche modèle, les scores de Sol relèvent, selon les notes d’évaluation, d’une auto-déclaration du constructeur, et non d’un retest effectué le même jour.
– **Paliers** : sur Artificial Analysis, le palier le plus élevé de Neon est xhigh, tandis que celui de Sol est max ; les paliers ne sont donc pas totalement équivalents.
– **Chiffres divergents** : le Coding Agent Index affiche 58,6 sur le blog Google et 59 dans l’article d’Artificial Analysis ; WebExploitBench v1.2 est indiqué à 51,26 % sur le blog et à 51,3 % dans la fiche modèle. Cet article conserve les valeurs telles quelles.
Gemini 4 Neon et GPT-6.2 Sol : points clés
- Score global : sur la page du modèle d’Artificial Analysis, Neon xhigh obtient 61 points et Sol max 57 points.
- Codage : sur la fiche modèle, Terminal-bench 4.1 est à 65.2% contre 61.5% ; pour l’écart sur SWE-sweep, il faut regarder harness par harness.
- Graphiques : sur Chartography, c’est Sol qui est devant, avec 75.1% contre 73.5%.
- Contexte long : sur GraphWalks, de 256k à 1M, le F1 est de 95.2% contre 80.1%, soit l’écart le plus important.
- Coût et durée : par tâche, 6.44 USD contre 1.01 USD, et 21.5 contre 8.5 minutes ; la principale raison est un volume de sortie plusieurs fois supérieur.
- Prix unitaire : Neon 3/15 USD, Sol 2/10 USD ; sur APIYI,
gpt-6.2-solpasse à la tranche tarifaire supérieure au-delà de 272000 tokens d’entrée.
En résumé
Les différences entre Gemini 4 Neon et GPT-6.2 Sol, une fois décomposées, sont bien plus claires que le score global :
- Codage : Neon est devant sur les sous-scores pour lesquels la fiche modèle contient des données, mais avec le même harness mini-SWE, l’écart n’est que de 1.2 point de pourcentage.
- Graphiques : sur Chartography, c’est Sol qui l’emporte ; sur LVBench, Neon est légèrement devant.
- Contexte long : sur GraphWalks, Neon devance Sol de 15.1 points de pourcentage ; c’est l’écart le plus marqué des trois.
- Coût : le prix unitaire diffère d’un facteur 1.5, et le coût par tâche d’environ 6.4 ; cet écart s’explique par le nombre de tokens de sortie.
Pour choisir, il faut revenir à votre propre répartition des tâches et à la longueur de vos sorties. Je recommande de commencer par connecter gpt-6.2-sol via APIYI apiyi.com, de noter la consommation et le temps d’exécution sur de vrais échantillons, puis, une fois Neon disponible, de compléter la comparaison avec le même protocole.
📚 Références
-
Blog Google « Introducing Gemini 4 Neon » : annonce officielle et évaluations auto-déclarées
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Note : les scores de synthèse, de codage, de science et le positionnement tarifaire sont tous auto-déclarés par Google
- Lien :
-
Fiche modèle DeepMind Gemini 4 Neon : source des tableaux comparatifs à trois colonnes
- Lien :
deepmind.google/models/model-cards/gemini-4-neon - Note : données détaillées pour Chartography, GraphWalks, SWE-sweep, etc.
- Lien :
-
Guide développeur Google Cloud Gemini 4 Neon : règles sur la fenêtre, les niveaux de réflexion et le cache
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Note : limite unifiée de 1048576 tokens, règle du HTTP 400, explications sur le cache implicite
- Lien :
-
Page tarifaire Google AI Studio : prix unitaires officiels de Neon
- Lien :
aistudio.google.com/docs/pricing - Note : entrée à 3, sortie à 15, cache à 0,15 USD par million de tokens
- Lien :
-
Pages modèles Artificial Analysis : données par paliers pour Neon et Sol
- Liens :
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-sol - Note : score d’intelligence, coût par tâche, temps, vitesse de sortie
- Liens :
-
Article Artificial Analysis : lecture des mesures tierces sur Neon
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Note : données telles que Coding Agent Index 59
- Lien :
-
Tableau général et interface de tarification APIYI : modèles déjà disponibles et prix par paliers
- Liens :
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Note : premier palier de
gpt-6.2-solet règle de changement de palier à 272000 tokens
- Liens :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Pour davantage de modèles et d’instructions d’intégration, consultez le centre de documentation docs.apiyi.com