Nota del autor: partiendo del usage de una llamada a Responses, recalculamos uno por uno la entrada normal, las lecturas y escrituras de caché y la salida de razonamiento de GPT-6.2 Sol, y después explicamos cómo la vida útil de la caché y el estado de la solicitud modifican la factura de un mismo flujo de trabajo.
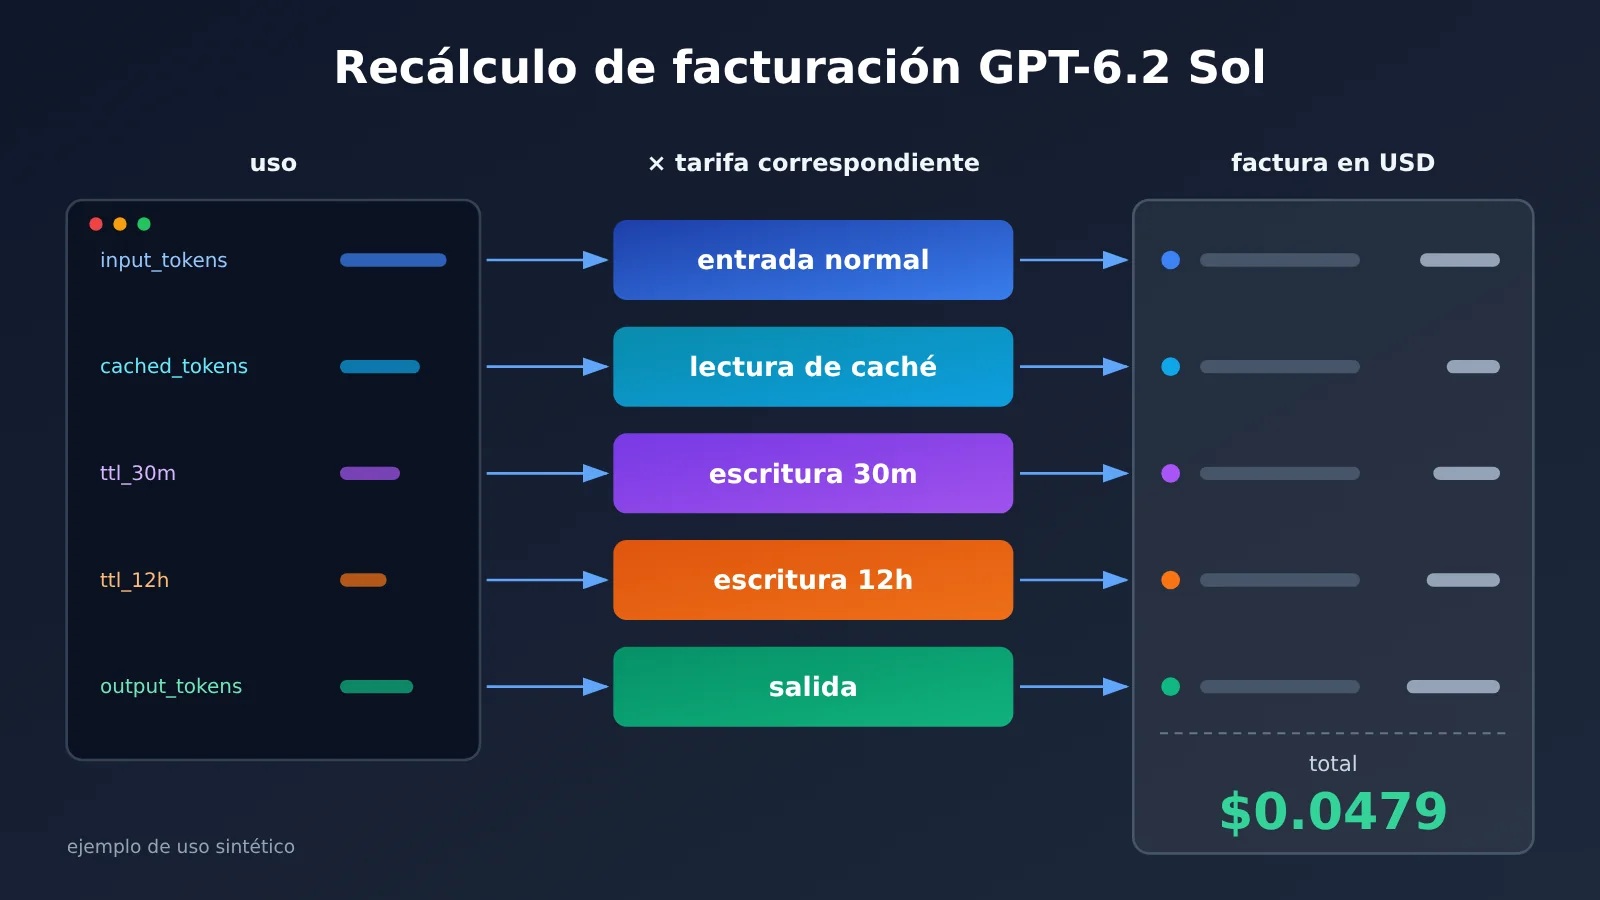
La factura de GPT-6.2 Sol se puede recalcular con un método fijo. El campo usage del registro de la solicitud desglosa la entrada en cuatro categorías mutuamente excluyentes: entrada normal, lectura de caché, escritura de caché de 30 minutos y escritura de caché de 12 horas. La salida constituye otra categoría aparte, y los tokens de razonamiento ya están incluidos en ella. Sumar el número de tokens de cada categoría multiplicado por su tarifa correspondiente nos da el costo del modelo para esa solicitud. La tarifa de herramientas se calcula por separado.
Hay tres condiciones que alteran el resultado. La primera es si el volumen total de entrada de una sola solicitud supera los 272K, ya que a partir de ese punto toda la solicitud pasa a la tarifa de contexto largo. La segunda es la vida útil de la caché y el número real de aciertos: que el mismo prefijo se escriba para 30 minutos o para 12 horas cambia el punto de equilibrio. La tercera es el estado de la solicitud: incomplete, los reintentos y las tareas en segundo plano influyen en la cuenta total de un flujo de trabajo.
OpenAI lanzó GPT-6.2 Sol el 17 de noviembre de 2026, con el ID de modelo de API gpt-6.2-sol, invocable mediante Responses y Chat Completions, donde las llamadas a funciones y las herramientas integradas usan la ruta de Responses. Este artículo toma como base el precio en dólares de la conexión directa oficial de OpenAI y, al mismo tiempo, explica cómo queda listado este modelo en la interfaz pública de precios de APIYI apiyi.com. Todos los ejemplos de cálculo de este artículo se basan en consumos sintéticos, no en facturas reales.
Mapa de conocimiento de facturación de GPT-6.2 Sol y orden de lectura
El artículo completo se desarrolla en el orden «campos → importes → decisión de caché → conciliación del flujo de trabajo». La salida de cada paso es la entrada del siguiente: primero identifica qué elementos hay en usage, luego conviértelos a dólares, después usa este algoritmo para comparar opciones de caché y, por último, resume las solicitudes individuales en el coste del flujo de trabajo.
Responses usage
 ├─ Entrada total input_tokens
 │   ├─ Lectura de caché cached_tokens ─────────────┐
 │   ├─ Escritura 30m ttl_30m_tokens ───────────────┤
 │   ├─ Escritura 12h ttl_12h_tokens ───────────────┼─→ × tarifa correspondiente → coste de modelo por solicitud (sección 2)
 │   └─ Entrada normal = total − lectura − todas las escrituras ┤
 └─ Salida output_tokens (incluye reasoning_tokens) ┘
                                          ↓
         Selección de vida útil de caché (sección 3) ← comparación del precio total de varias solicitudes con el mismo prefijo
                                          ↓
         Conciliación del flujo de trabajo (sección 4) ← coste de herramientas + reintentos + incomplete + exportación de costes
| N.º | Pregunta que responde | Depende de la sección anterior | Después de leer, podrás |
|---|---|---|---|
| 1 | Qué cifras de usage participan en la facturación |
— | Desglosar cinco usos facturables a partir de una respuesta |
| 2 | Cuánto valen estas cifras de uso | Los cinco usos de la sección 1 | Convertir las cifras del registro a dólares y distinguir tramos cortos y largos |
| 3 | ¿Escribir caché durante 30 minutos o 12 horas? | El algoritmo de precios unitarios de la sección 2 | Elegir la vida útil de la caché según el intervalo entre llamadas y el número de aciertos |
| 4 | Cuánto costó realmente una tarea | La contabilidad por solicitud de las secciones 2 y 3 | Crear una tabla de registros mínima y rastrear la diferencia en la factura |
Los lectores que solo quieren explicar una diferencia de coste pueden leer las secciones 1 y 2. Quienes están a cargo de la estrategia de caché o del registro de costes, mejor leer las cuatro secciones en orden.
Términos de facturación de GPT-6.2 Sol que debes conocer
| Término | Explicación |
|---|---|
| usage | Campo de la respuesta de la API que resume el consumo de tokens de la solicitud actual |
| Entrada normal | El consumo restante después de descontar del total de entrada las lecturas de caché facturables y todas las escrituras de caché |
| Lectura de caché | La parte de la entrada de la solicitud actual que se factura a precio de reutilización |
| Punto de corte de caché | El límite que permite guardar o reutilizar el prefijo de entrada en caché |
| TTL | Configuración del tiempo mínimo de cobertura de facturación de la caché; Sol admite dos tipos de escritura: 30 minutos y 12 horas |
| Token de razonamiento | Tokens generados por el modelo durante la fase de razonamiento e incluidos en el total de salida facturable |
| ID de respuesta | Identificador que vincula los registros de conciliación, el sondeo en segundo plano y la respuesta correspondiente del modelo |
| Tarifa de herramientas | Cargo independiente generado por el uso de herramientas alojadas específicas |
1 Cómo encontrar las cinco partidas facturables de GPT-6.2 Sol en el usage de Responses
1.1 Cuatro tipos de entrada y un tipo de salida
El objeto usage de Responses registra por separado la entrada y la salida de una solicitud. En el lado de la entrada se indica el total y varios desgloses; en el lado de la salida se indica el total y la subpartida de razonamiento. Para recalcular, hay que localizar estos campos:
| Categoría de facturación | Campo leído | Descripción |
|---|---|---|
| Entrada total | usage.input_tokens |
Suma de las cuatro entradas; no se multiplica directamente por la tarifa |
| Lectura de caché | input_tokens_details.cached_tokens |
Volumen leído a efectos de facturación |
| Total de escrituras en caché | cache_write_tokens |
Suma de las escrituras con ambas duraciones |
| Escritura de 30 minutos | cache_write_tokens_details.ttl_30m_tokens |
Se usa cuando se devuelve el desglose por duración |
| Escritura de 12 horas | cache_write_tokens_details.ttl_12h_tokens |
Se usa cuando se devuelve el desglose por duración |
| Salida | usage.output_tokens |
Ya incluye los tokens de razonamiento |
| Subpartida de razonamiento | output_tokens_details.reasoning_tokens |
Sirve para entender la composición de la salida; no se cobra por separado |
1.2 Fórmula de cálculo para la entrada normal
La entrada normal no tiene un campo propio en usage; se obtiene por resta:
Entrada normal = input_tokens − cached_tokens − cache_write_tokens
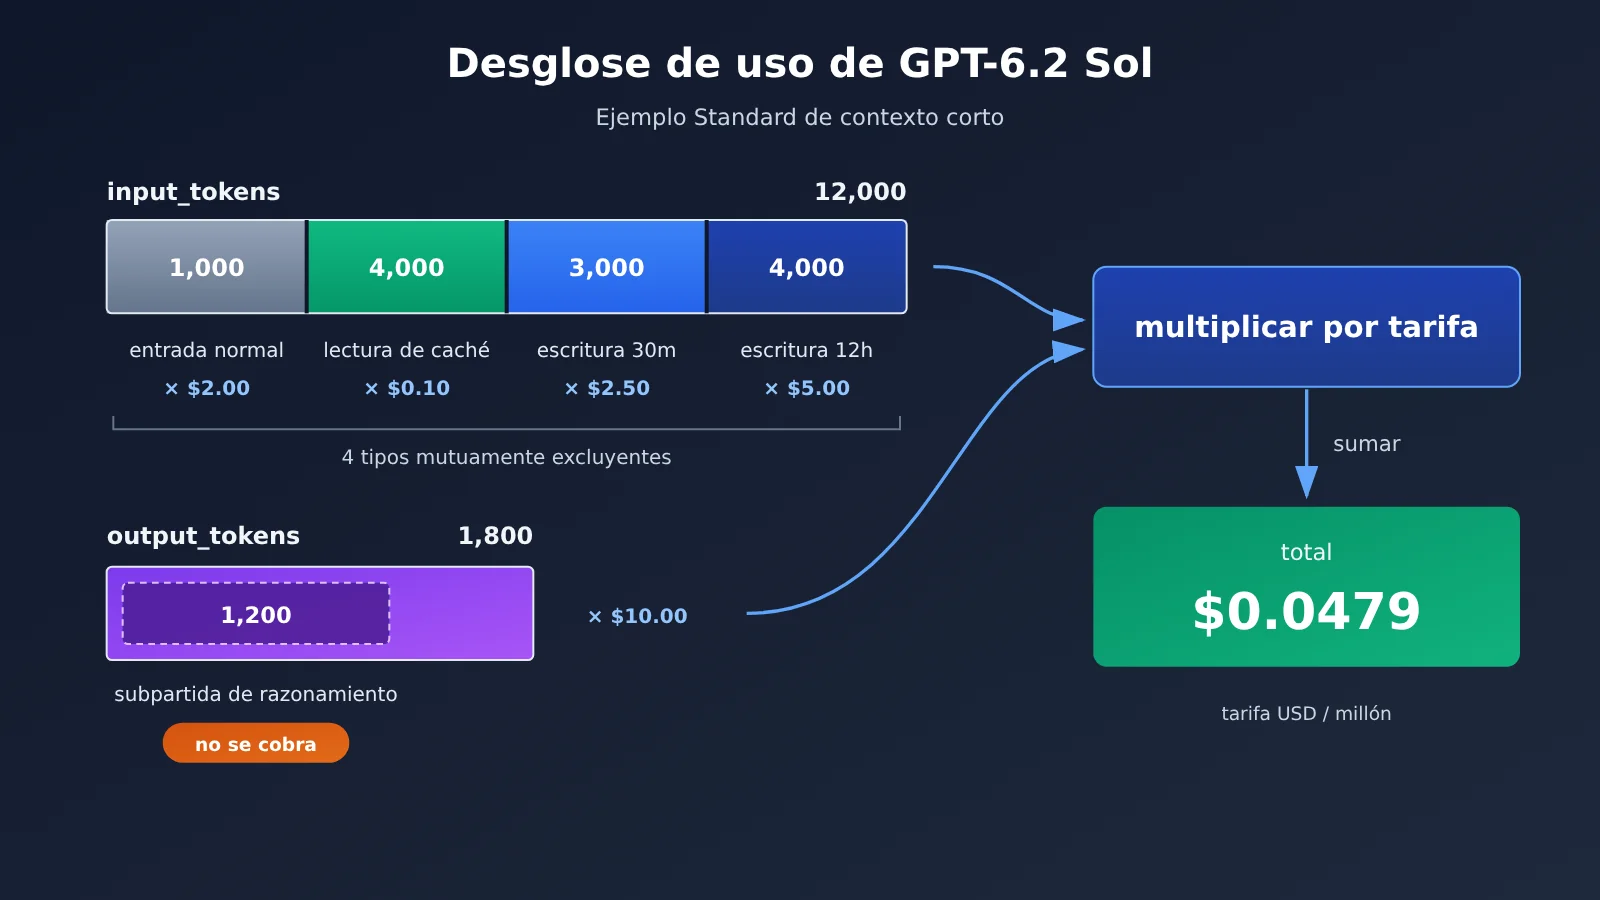
Aquí se restan todas las escrituras, es decir, la suma de las de 30 minutos y las de 12 horas. Las dos clases de escritura, la lectura y la entrada normal son mutuamente excluyentes: un mismo token solo cae en una de ellas. Los tokens escritos en caché se facturan según la tarifa de escritura y no se suman otra vez al precio de entrada normal. Este es el punto donde es más fácil equivocarse: si se deja el volumen escrito dentro de la entrada normal y además se cobra la escritura, el total quedará inflado.
Los tokens de razonamiento del lado de la salida también se prestan a duplicarse. reasoning_tokens es un subconjunto de output_tokens; al recalcular, basta multiplicar output_tokens por la tarifa de salida. La subpartida de razonamiento sirve para analizar «por qué esta vez la salida fue tan grande», no como una partida facturable adicional.
1.3 Para recalcular, usa los campos de facturación; los campos de diagnóstico solo sirven para investigar
En la información de diagnóstico de Prompt Caching también aparecen cifras como «cantidad reutilizable» o «estimación de no aciertos». Explican por qué falló la caché —por ejemplo, porque cambió el prefijo o porque la longitud era insuficiente—, pero no representan el cargo real. Al recalcular una factura, usa solo los campos de facturación reales del usage.
Si un canal no devuelve el desglose por duración o le falta cache_write_tokens, no conviene inferir la factura a partir de los campos ausentes. En ese caso, toma como referencia el registro de cargos del propio canal. El ejemplo de cálculo de la sección siguiente usa un usage sintético con todos los campos completos, para mostrar el algoritmo completo.
2 Convertir a dólares las cifras del registro de GPT-6.2 Sol
2.1 Tabla oficial de tarifas Standard
La tabla siguiente recoge las tarifas oficiales de conexión directa de OpenAI, en USD por millón de tokens. La distinción entre tarifa corta y larga se decide según la cantidad total de entrada de cada solicitud: cuando se superan los 272K, toda la solicitud pasa a la tarifa de contexto largo, con las tarifas de entrada y de los distintos tipos de caché ×2 y la de salida ×1.5.
| Categoría de facturación Standard | Contexto corto (≤272K) | Contexto largo (>272K) |
|---|---|---|
| Entrada normal | $2.00 | $4.00 |
| Lectura de caché | $0.10 | $0.20 |
| Escritura de caché de 30 minutos | $2.50 | $5.00 |
| Escritura de caché de 12 horas | $5.00 | $10.00 |
| Salida (incluye tokens de razonamiento) | $10.00 | $15.00 |
El precio base del contexto corto es el mismo que el de GPT-6.1 Sol. Además, la ficha del modelo indica una ventana de contexto de 1,050,000 tokens, una entrada máxima de 922,000 tokens y una salida máxima de 128,000 tokens. «Cuánto se puede introducir como máximo» y «a partir de qué punto se empieza a cobrar la tarifa larga» son dos cifras independientes: una solicitud con 300K de entrada es totalmente válida, pero se facturará entera según la tarifa larga.
2.2 Recálculo completo de un uso sintético
Supongamos que una solicitud Standard de contexto corto devuelve el siguiente uso, sin usar herramientas ni recargos: entrada total 12,000, lectura de caché 4,000, escritura de 30 minutos 3,000, escritura de 12 horas 4,000, salida 1,800 (de los cuales 1,200 son de razonamiento).
Primero calculamos la entrada normal: 12,000 − 4,000 − 3,000 − 4,000 = 1,000. Después multiplicamos cada concepto por su tarifa:
| Concepto de facturación | Cantidad de tokens | Tarifa (USD/millón) | Importe (USD) |
|---|---|---|---|
| Entrada normal | 1,000 | 2.00 | 0.0020 |
| Lectura de caché | 4,000 | 0.10 | 0.0004 |
| Escritura de 30 minutos | 3,000 | 2.50 | 0.0075 |
| Escritura de 12 horas | 4,000 | 5.00 | 0.0200 |
| Salida (incluye 1,200 de razonamiento) | 1,800 | 10.00 | 0.0180 |
| Total | — | — | 0.0479 |
En esta cuenta, la escritura de 12 horas solo representa 4,000 tokens, pero aporta más del 40% del importe. La razón es que su precio unitario es 2.5 veces el de la entrada normal, y en el momento de la escritura solo genera costo; el retorno llega cuando se produce un acierto de caché posterior. La sección 3 tratará este punto en detalle.
Para el registro de costos, recomiendo anotar por separado la cantidad de tokens y la tarifa de cada concepto de facturación, en lugar de guardar únicamente un importe total. Así, cuando aparezca una diferencia de costos, se pueden introducir directamente los valores reales del log en la tabla anterior y localizar línea por línea el origen de la diferencia.
2.3 Contexto largo: primero cambiar las tarifas, luego aplicar la misma fórmula
Cuando el volumen total de entrada supera los 272K, el algoritmo no cambia: basta con reemplazar toda la columna de tarifas de la tabla anterior por los valores de contexto largo. Ojo: el cambio aplica a solicitud completa, y la lectura y escritura de caché también se duplican en paralelo, mientras la salida se calcula a 1.5x. Por eso, determinar si estamos en tramo corto o largo debe hacerse antes de multiplicar concepto por concepto.
Cuando se invoca a través de canales de terceros, hay que cambiar las tarifas por las de ese canal. Tomemos como ejemplo APIYI apiyi.com: al releer su interfaz pública de precios el 2026-11-20, el billing_expr de gpt-6.2-sol también corta en 272.000 tokens de entrada: tramo corto con entrada normal $2, lectura de caché $0.10, escritura de caché $2.50 y salida $10; tramo largo con $3, $0.15, $3.75 y $11.25 respectivamente (USD / millón de tokens). Se ve que el multiplicador del tramo largo no coincide con el de la conexión directa oficial, y la expresión de la interfaz solo lista un precio de escritura de caché. Los grupos, funciones y facturación reales de un proyecto dependen de la configuración vigente y de la factura de la plataforma.
El siguiente código lanza una solicitud Responses a través de la interfaz compatible con OpenAI de APIYI, e imprime el usage tal cual, para usarlo luego en el recálculo:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "固定规则与公共资料(放在前部便于缓存复用)"},
        {"role": "user", "content": "本次请求的具体问题"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
Una vez obtenido el usage, con una función convertimos los cinco conceptos de consumo en importes. La tabla de tarifas se deja como parámetro, de modo que al cambiar entre criterio oficial o criterio del canal solo se toca la configuración:
Ver la función completa de recálculo
LONG_THRESHOLD = 272_000

# Tarifas oficiales Standard de OpenAI, USD / millón de tokens
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # La ubicación de los campos de escritura depende de la estructura real que se devuelve; aquí se consultan los dos sitios
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("缺少 cache_write_tokens,改用渠道出账记录,不要推定")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("缺少写入寿命明细,无法区分 30m/12h 费率")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# Validación con el usage sintético de la sección 2.2
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
Si a la función le falta un campo, no lo trata como 0: lanza un error directamente. La idea es evitar que una solicitud a la que le faltan los detalles de escritura se calcule por error como si todo fuera «entrada normal».
🎯 Recomendación técnica: a la hora de montar el registro de costes, conviene probar primero la función de recálculo con un usage sintético y solo después conectarla a los logs reales. Con APIYI apiyi.com puedes lanzar solicitudes de prueba de bajo volumen usando la misma clave API, comparar una por una el usage devuelto con la facturación de la plataforma y, cuando tengas claro el criterio de los campos, poner en marcha las estadísticas.
3 Cómo elegir la vida útil de la caché de GPT-6.2 Sol según el patrón de llamadas
3.1 Cuentas para dos y tres accesos con el mismo prefijo
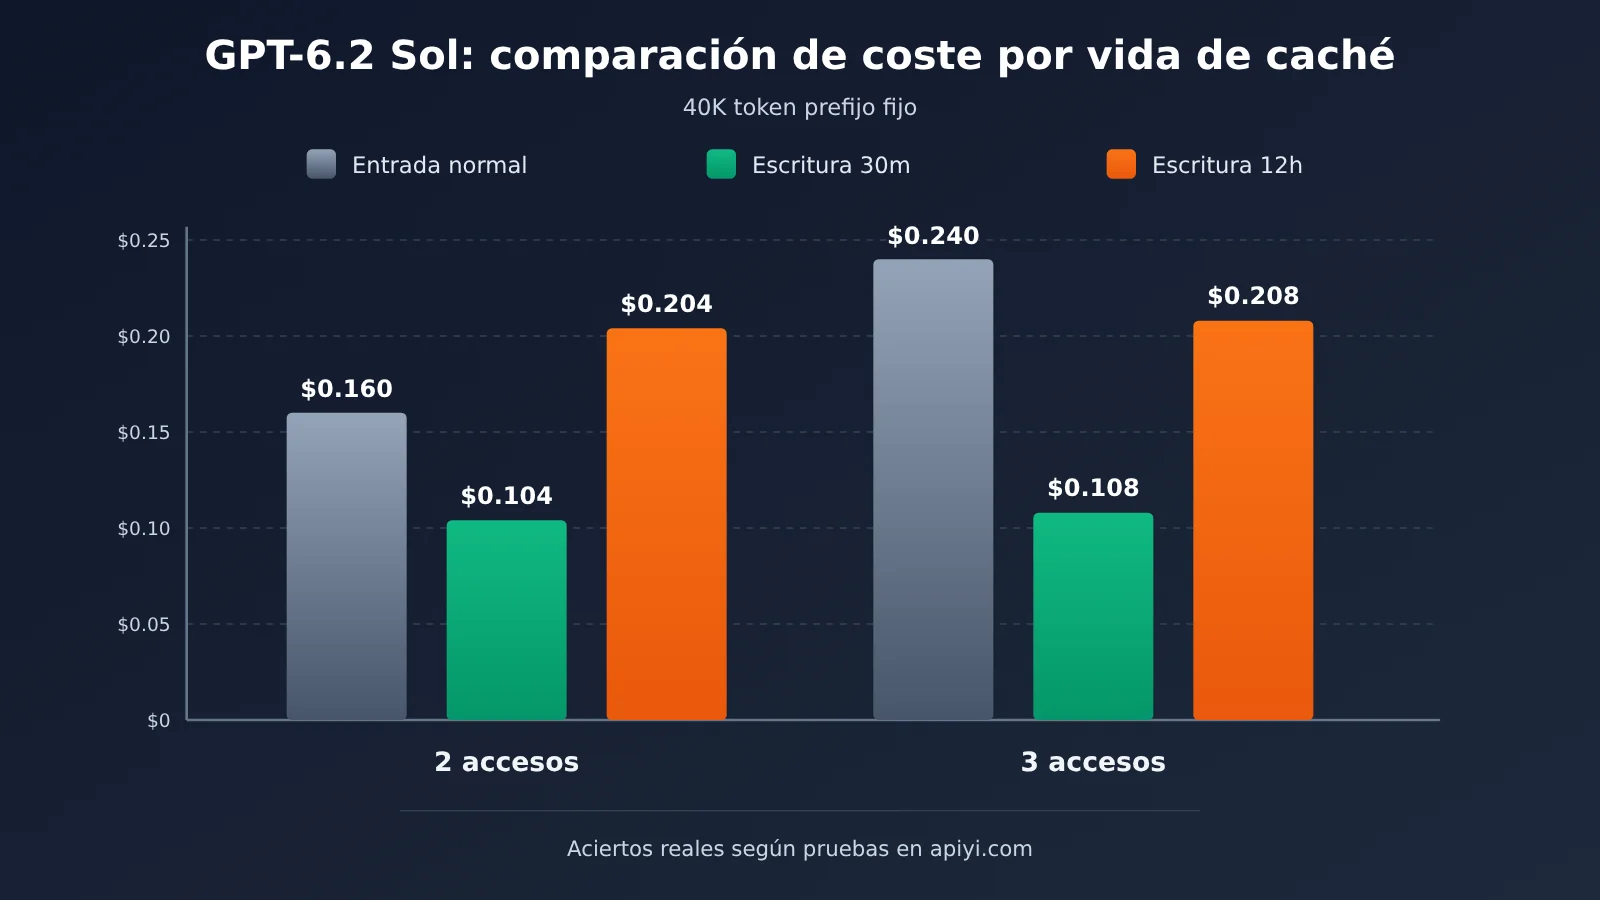
Imaginemos un prefijo fijo de 40,000 tokens (reglas del sistema más material compartido), tarificado como contexto corto Standard. Los costes por invocación son estos: entrada normal, $0.08; primera escritura de 30 minutos, $0.10; primera escritura de 12 horas, $0.20; lectura con acierto completo, $0.004. La tabla siguiente compara solo la parte del prefijo fijo, sin el contenido variable ni la salida de cada solicitud.
| Modo de acceso | Entrada normal | Plan de escritura 30m | Plan de escritura 12h |
|---|---|---|---|
| Total de 2 accesos (1 escritura + 1 lectura) | $0.160 | $0.104 | $0.204 |
| Total de 3 accesos (1 escritura + 2 lecturas, todas dentro de la ventana) | $0.240 | $0.108 | $0.208 |
Con dos accesos, la escritura de 12 horas cuesta $0.044 más que no usar caché. Con tres accesos, ambas cachés salen más baratas que la entrada normal, pero el plan de 30 minutos sigue costando alrededor de la mitad del plan de 12 horas. Eso sí, siempre que todos esos accesos caigan dentro de la ventana de 30 minutos.
3.2 Punto de equilibrio: ¿cuántos aciertos hacen falta para amortizar?
Si miramos las cifras anteriores desde otro ángulo, resulta más intuitivo (los siguientes cálculos se basan en la tarifa de M3). Cada acierto completo ahorra $0.076 frente a una entrada normal. La escritura de 30 minutos cuesta $0.02 más que una entrada normal, así que basta un acierto para recuperar esa diferencia. La escritura de 12 horas cuesta $0.12 adicionales y requiere al menos dos aciertos dentro de la ventana para amortizarse.
Por eso, el valor de la escritura de 12 horas no está en «acertar más dentro de la misma ventana», sino en poder acertar cuando el intervalo entre invocaciones supera los 30 minutos. Si dos solicitudes consecutivas que usan el mismo prefijo suelen llegar con unos minutos de diferencia, la escritura de 30 minutos es suficiente; elegir 12 horas solo hará que pagues más por escritura. Si las solicitudes llegan cada una o dos horas, la caché de 30 minutos ya habrá expirado y tendrás que reescribirla cada vez; en ese caso, la escritura de 12 horas, combinada con varios aciertos, puede salir más barata.
Además, hay dos puntos que cambian la decisión. El TTL es el tiempo mínimo que cubre el cobro, no significa que la caché viva necesariamente tanto tiempo; al final, lo que importa es la cantidad real de lecturas registrada en usage. La escritura de 30 minutos tiene reglas de refresco al leer, de modo que, en escenarios de alta frecuencia, la cobertura real puede ser mayor que esos 30 minutos nominales. Por eso, después de elegir una opción, conviene revisar los registros reales de aciertos en lugar de fijarse solo en la configuración.
3.3 Diseño de puntos de corte: coloca primero el contenido estable
La caché solo se aplica al prefijo, y el prefijo mínimo cacheable es de 1.024 tokens de entrada visibles. En la práctica, puedes establecer puntos de corte por capas según el ciclo de reutilización:
- Material público de ciclo largo, como manuales de producto o resúmenes de repositorios de código: colócalo al principio y plantéate 12 horas de escritura.
- Registros de sesión de ciclo corto, como el historial de esta conversación: colócalos justo después y plantéate 30 minutos de escritura.
- Indicaciones instantáneas que cambian cada vez: colócalas al final, sin entrar en caché.
GPT-6.2 tiene un detalle de posición en el que es fácil tropezar: el campo de nivel superior instructions queda después del punto de corte cacheable. Si escribes reglas fijas dentro de instructions, esa parte no se puede reutilizar. Las reglas fijas encajan mejor en el mensaje developer al inicio de input, y instructions conviene reservarlo para contenido que puede ajustarse en cada solicitud.
💡 Sugerencia de elección: la vida útil de la caché debe determinarse según el tráfico real. Se recomienda primero enviar varias rondas de solicitudes con el mismo prefijo al ritmo real en APIYI apiyi.com, revisar las estadísticas de aciertos de
cached_tokensy luego decidir qué capa usar durante 30 minutos y qué capa usar durante 12 horas. El precio de escritura de caché puede variar según el canal; toma como referencia la facturación de la plataforma.
4 Resumir los costos de GPT-6.2 Sol por flujo de trabajo y rastrear las discrepancias
4.1 Tres estados de solicitud que pueden desviar la factura de lo esperado
Aunque una solicitud individual esté bien calculada, el total del flujo de trabajo todavía puede no cuadrar. Las causas más comunes vienen del estado de la solicitud:
- incomplete: cuando la salida alcanza
max_output_tokens, la respuesta puede terminar comoincomplete. En ese momento puede que aún no haya ningún texto visible, pero los tokens de entrada y de razonamiento ya se generaron y se facturaron. Si solo contabilizas las solicitudes que «devuelven contenido con éxito», te faltará esa parte del costo. - Tareas en segundo plano: una tarea en segundo plano que ya tiene un ID de respuesta debe seguirse con ese mismo ID durante el sondeo; no conviene tratar cada sondeo como una solicitud nueva y volver a contabilizarlo.
- Reintentos: una llamada independiente lanzada de nuevo por timeout o por
incompletegenera otra respuesta y debe registrarse aparte. Cuantos más reintentos haya, más veces se paga el costo de entrada de la misma tarea.
4.2 Tarifas de herramientas y tokens posteriores que estas generan
Responses admite herramientas como búsqueda de archivos, búsqueda web, intérprete de código y generación de imágenes. Al usar generación de imágenes, Sol inicia una llamada a herramienta dentro del flujo; la imagen la completa una herramienta de imagen independiente y el costo también se calcula según las reglas de herramientas. La tarifa de la herramienta se verifica según el tipo real; por ejemplo, la búsqueda web cuesta $10 por cada mil búsquedas, y los tokens del contenido devuelto por la búsqueda se facturan aparte según la tarifa del modelo.
Al recalcular, confirma qué tokens cubre usage. Cuando el resultado de la herramienta se incorpora de vuelta en la siguiente ronda de solicitud al modelo, aparece como un aumento de la entrada de la solicitud posterior; ese costo recae en la solicitud siguiente, no en la llamada a la herramienta en sí. En un flujo de trabajo con búsqueda, la factura suele componerse de dos partes: «tarifa por número de llamadas a herramientas + tarifa por solicitudes multipaso al modelo».
4.3 Campos mínimos del registro
Para que un flujo de trabajo se pueda conciliar, cada respuesta del modelo debe registrar al menos los siguientes campos:
| Elemento de registro | Función |
|---|---|
| ID de flujo de trabajo | Agrupa varias solicitudes bajo una misma tarea |
| ID de respuesta | Vincula el sondeo en segundo plano y distingue los reintentos de una misma solicitud |
| Modelo | Determina la tabla de tarifas, p. ej. gpt-6.2-sol |
| Nivel de servicio | Confirma si se aplica el criterio Standard |
| Estado final | Identifica completed, incomplete, etc. |
| Desglose de uso | Entrada normal, lectura, escritura 30m, escritura 12h, salida, razonamiento |
| Herramientas | Tipo de herramienta y número de llamadas |
| Costo | Importe recalculado por partida e indicador de tramo largo/corto |
Con esta tabla, agrupar y sumar por ID de flujo de trabajo permite obtener el costo de una tarea. La investigación de discrepancias también tiene un orden: primero revisa si hay incomplete y reintentos, luego si la lectura de caché es inferior a la esperada y, por último, verifica el número de llamadas a herramientas.
4.4 Verificación cruzada entre la estimación por solicitud y la exportación oficial
La estimación por solicitud es útil para controlar el presupuesto en tiempo real, pero puede desviarse cuando hay llamadas a herramientas de varios pasos, reintentos o campos de uso faltantes. Se recomienda comparar periódicamente el resumen de estimaciones con la exportación oficial de uso o de costos, y cuando la diferencia supere el umbral establecido, volver a los registros y revisar línea por línea. Cuando se enruta a través de un servicio proxy de API de terceros, el objeto de comparación deben ser los campos de liquidación y las tarifas de ese canal.
💰 Consejo de costos: Si el equipo usa varios modelos a la vez, puede llamarlos con una sola clave API a través de APIYI apiyi.com y luego guardar en la base de datos los campos mínimos de registro de este artículo. Un punto de entrada unificado mantiene coherentes el ID de flujo de trabajo y el criterio de costos, y a fin de mes reduce una capa de conversión de canales al conciliar.
Métodos para verificar la factura de GPT-6.2 Sol
Al recibir cualquier registro de solicitud de Sol, puede verificar la factura en este orden: primero confirme si el total de entrada supera los 272K y seleccione la columna de tarifa correspondiente; luego reste las lecturas de caché y todas las escrituras de input_tokens para obtener la entrada normal; después multiplique cada uno de los cinco conceptos por la tarifa y súmelos, comparándolos con la factura. Si una sola solicitud coincide pero el total del flujo de trabajo no, busque incomplete, reintentos y llamadas a herramientas en los registros.
Si el caché resulta rentable depende, en última instancia, de la cantidad real de lecturas y del intervalo entre llamadas en el usage. Una escritura de 30 minutos se amortiza con solo un acierto, mientras que una escritura de 12 horas requiere al menos dos aciertos dentro de la ventana, y solo muestra ventaja cuando el intervalo entre llamadas supera los 30 minutos.
Cuando necesite verificar estas conclusiones con tráfico real, puede solicitar una cuota de prueba gratuita en APIYI apiyi.com y usar las funciones de recálculo del artículo para comparar línea por línea con la factura de la plataforma.
📚 Referencias
-
Anuncio de lanzamiento de OpenAI GPT-6.2 Astra y Sol: fecha de lanzamiento y posicionamiento del producto
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Descripción: comprender el posicionamiento de Sol para el trabajo diario y los agentes de múltiples pasos
- Enlace:
-
Ficha del modelo GPT-6.2 Sol: especificaciones de contexto, tarifas y multiplicador de contexto largo
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol - Descripción: origen de la tabla de tarifas de este artículo y de la regla de corte en 272K
- Enlace:
-
Guía de Prompt Caching y diagnóstico de caché: campos de caché, TTL y reglas de puntos de interrupción
- Enlace:
developers.openai.com/api/docs/guides/prompt-caching - Descripción: explica cached_tokens, la vida útil de escritura y el prefijo mínimo cacheable
- Enlace:
-
Guía de Reasoning: tokens de razonamiento y estado incomplete
- Enlace:
developers.openai.com/api/docs/guides/reasoning - Descripción: comprender cómo el uso de razonamiento se contabiliza en la salida
- Enlace:
-
Guía de control de costes por ejecución de flujo de trabajo: agregación de costes de Responses por flujo de trabajo
- Enlace:
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - Descripción: implementación de referencia para el control de presupuesto a nivel de flujo de trabajo
- Enlace:
-
Tabla general de modelos de APIYI: información de listado de canales y puntos de entrada
- Enlace:
docs.apiyi.com/models.md - Descripción: consultar los puntos de entrada disponibles y grupos de gpt-6.2-sol
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: No dude en contactarnos desde la página principal de APIYI apiyi.com; más materiales de integración están disponibles en el centro de documentación docs.apiyi.com