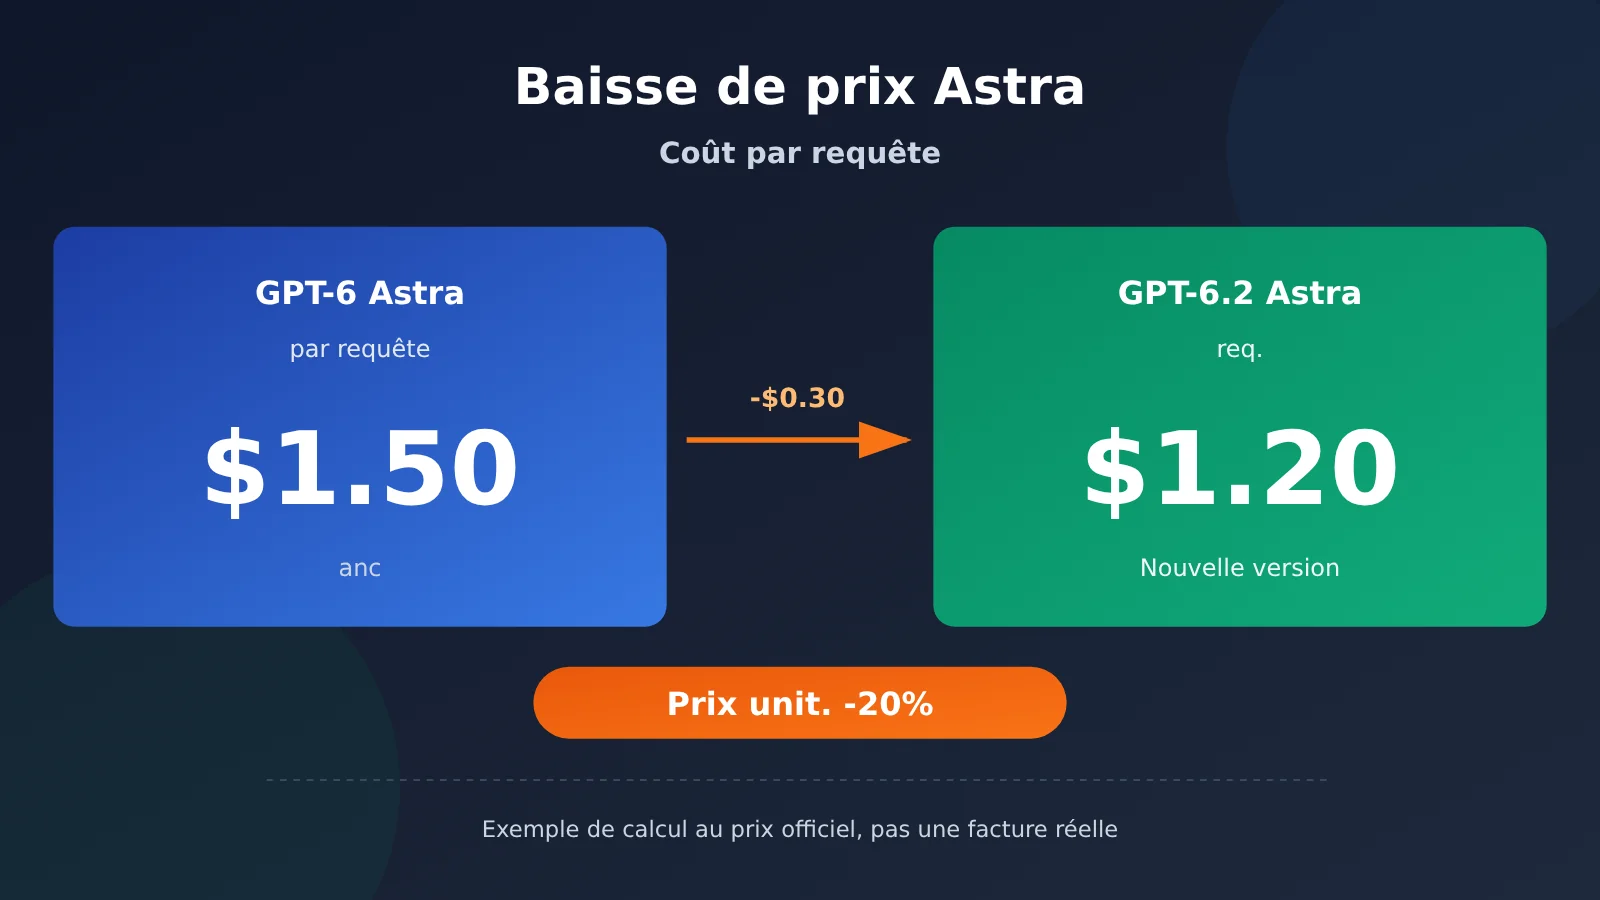
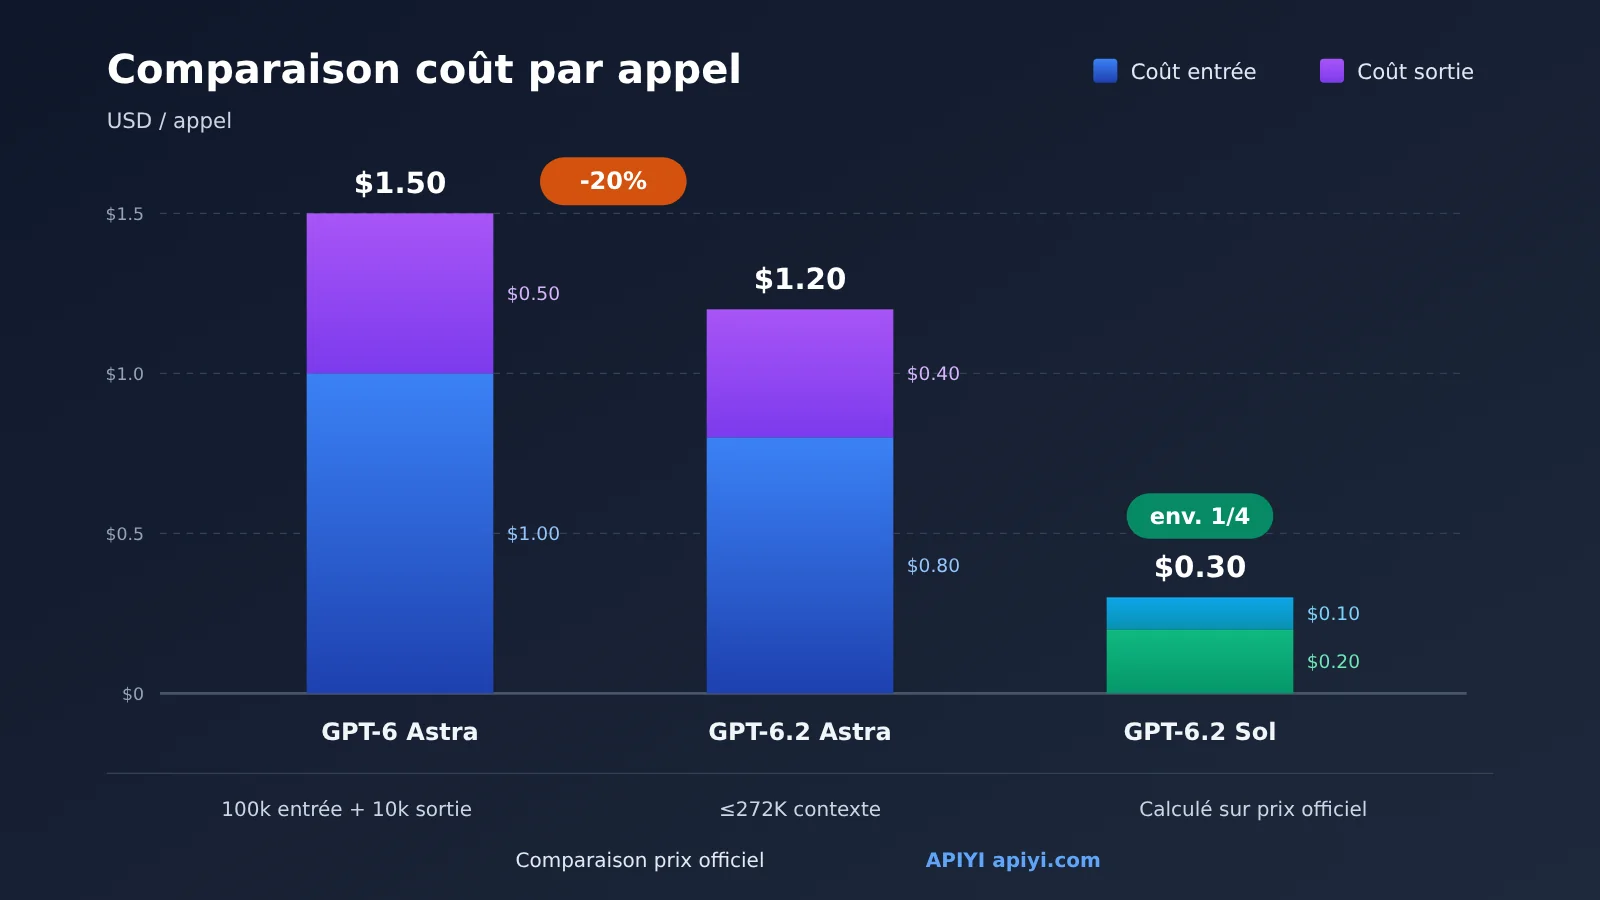
Prenons une requête standard « 100 000 tokens d’entrée non mis en cache + 10 000 tokens de sortie, entrée ≤ 272K » : en appliquant le tarif officiel standard, GPT-6 Astra coûte environ $1.50, GPT-6.2 Astra environ $1.20, soit $0.30 de moins à chaque fois — exactement 20 %. Pour le même volume de tokens, GPT-6.2 Sol ne coûte qu’environ $0.30. Attention : on parle bien d’une « baisse de 20 % du prix unitaire ». Le cache, les paliers de contexte long, le volume de sortie de raisonnement, les appels d’outils et autres facteurs influencent tous le coût final : la facture réelle ne diminuera pas nécessairement de 20 % dans les mêmes proportions.
Ce que vous apprendrez à la lecture de cet article
- Les prix standard officiels de GPT-6.2 Astra et Sol, publiés par OpenAI le 17 novembre 2026.
- Comment se calcule le coût d’une requête API : chaque multiplication, les conversions d’unités et les hypothèses de départ.
- Dans quelle mesure la lecture de cache, le contexte long au-delà de 272K et les variations de tokens de sortie éloignent le coût réel de la « baisse de 20 % ».
- Comment les développeurs et les responsables budgétaires devraient réévaluer leurs coûts d’appel.
Sommaire : cet article commence par un tableau conceptuel et un récapitulatif des impacts pour poser le contexte ; la première partie, « Faits objectifs », rassemble les informations de la publication officielle, la grille tarifaire et les évaluations officielles, puis propose trois exemples de calcul fondés sur les prix unitaires officiels ; la deuxième partie, « Analyse et interprétation », explique l’écart entre la baisse du prix unitaire et celle de la facture, donne des recommandations adaptées à chaque profil et inclut un bloc de code de calcul des coûts directement exécutable.
GPT-6.2 Astra : les concepts à connaître avant la baisse des prix
| Concept | Explication rapide |
|---|---|
| Token | Unité de base utilisée par le modèle pour facturer et traiter le texte ; l’API facture « par million de tokens » |
| Entrée non mise en cache | Dans cet article, il s’agit de la partie d’entrée ordinaire qui n’est facturée ni comme lecture de cache ni comme écriture de cache |
| Lecture du cache | Partie de la requête qui touche le cache d’invites ; son prix unitaire est bien inférieur à celui de l’entrée non mise en cache |
| Écriture dans le cache | Les tokens écrits dans le cache appliquent un tarif global distinct ; le même token ne se cumule pas avec les frais d’entrée ordinaire |
| Paliers de contexte long | Lorsque l’entrée dépasse 272 K tokens, les tarifs d’entrée et de cache de toute la requête passent à ×2, et le tarif de sortie à ×1,5 |
| Niveaux de raisonnement | Intensité de raisonnement investie par le modèle avant de répondre ; plus le niveau est élevé, plus la consommation de tokens est généralement importante |
| GDPval v2 / ALE / FrontierCode 2.0 | Trois évaluations citées par OpenAI dans son annonce ; leurs objets et leurs méthodologies diffèrent, et les résultats ne sont pas convertibles entre eux |
Aperçu rapide de l’impact de la baisse de 20 % des prix de GPT-6.2 Astra
| Public | Impact principal |
|---|---|
| Développeurs d’API | Pour les requêtes de longueur standard, les prix unitaires d’entrée et de sortie d’Astra baissent de 20 %, et le coût d’un volume d’appels identique diminue d’autant ; les requêtes à contexte très long doivent être calculées à part |
| Responsables budgétaires | On peut réévaluer le budget unitaire d’Astra sur la base de -20 %, mais la baisse réelle dépend du taux de succès du cache, de la longueur du contexte et du volume de sortie : à vérifier avec les données de facturation |
| Équipes en phase de sélection | Le prix standard de Sol représente environ un quart de celui d’Astra ; les tâches sensibles au coût disposent donc d’une option supplémentaire à évaluer |
| Utilisateurs grand public de ChatGPT | Ce déploiement concerne principalement ChatGPT Work, Codex et l’API, ouverts progressivement ; le Chat grand public n’est pas concerné par cette vague |
I. Baisse de 20 % du prix de GPT-6.2 Astra : les faits objectifs
Les informations ci-dessous proviennent de la page de publication officielle d’OpenAI, de la documentation du modèle et de la page de tarification. Date de vérification : 18 novembre 2026. Toutes les données d’évaluation sont issues de rapports officiels ; elles ne proviennent pas de tests réalisés par notre équipe.
1.1 Informations de base sur la sortie de GPT-6.2 Astra et Sol
OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. En entrée, les deux modèles acceptent du texte et des images ; en sortie, ils produisent du texte et ne peuvent pas générer de vidéo nativement.
Concernant le périmètre de déploiement, OpenAI précise que les nouveaux modèles seront progressivement mis à disposition des utilisateurs de ChatGPT Work, de Codex et de l’API. Le Chat standard n’est pas concerné par cette première vague. Le calendrier précis de déploiement est à consulter dans la documentation d’aide d’OpenAI.
1.2 Tarification standard de l’API officielle GPT-6.2 Astra
Le tableau ci-dessous présente les tarifs du niveau Standard officiel d’OpenAI, pour une entrée ne dépassant pas 272K tokens. Les montants sont exprimés en dollars par million de tokens et ne correspondent pas aux tarifs APIYI. Le volume de sortie est calculé à partir du total de sortie facturé indiqué dans usage, y compris les tokens de raisonnement ; il ne correspond pas à la longueur du texte visible.
| Modèle | Entrée non mise en cache | Lecture du cache | Sortie | Source des données |
|---|---|---|---|---|
| GPT-6 Astra (génération précédente) | $10 | $1.00 | $50 | Page modèle OpenAI |
| GPT-6.2 Astra | $8 | $0.4 | $40 | Page modèle OpenAI / page de tarification |
| GPT-6.2 Sol | $2 | $0.1 | $10 | Page modèle OpenAI / page de tarification |
Deux règles de facturation officielles méritent également votre attention :
- Les écritures dans le cache sont facturées selon un tarif global distinct : pour Astra avec un contexte court en Standard, les frais d’écriture dans le cache sont de $10 par million de tokens pour 30 minutes et de $20 par million de tokens pour 12 heures. Ces frais ne s’ajoutent pas au tarif de $8 de l’entrée normale. Un même token d’entrée doit relever d’une seule catégorie : entrée normale, lecture du cache ou écriture dans le cache de durée correspondante. Il ne doit pas être facturé deux fois.
- Lorsque l’entrée dépasse 272K tokens, les tarifs d’entrée et de cache sont multipliés par 2 pour l’ensemble de la requête, et le tarif de sortie par 1.5.
Par rapport à la génération précédente, l’entrée non mise en cache d’Astra passe de $10 à $8 et sa sortie de $50 à $40, soit une baisse de 20 % dans les deux cas. C’est exactement ce que signifie « réduction de 20 % » : une baisse de 20 % du prix unitaire standard.
1.3 Données d’évaluation officielles de GPT-6.2 Astra (non mesurées par notre équipe)
Lors de l’annonce, OpenAI a publié plusieurs résultats d’évaluation. Les benchmarks n’utilisent pas la même méthodologie, il ne faut donc pas les interpréter en les mélangeant :
- GDPval v2 : GPT-6.2 Astra dépasse GPT-6 Astra de 6,2 points de pourcentage, avec 22 % de tokens de sortie en moins ; GPT-6.2 Sol dépasse GPT-6.1 Sol de 5,3 points de pourcentage.
- ALE : GPT-6.2 Astra gagne 5,2 points. C’est un autre benchmark : ces points ne s’additionnent pas aux points de pourcentage de GDPval, et on ne peut pas les comparer directement.
- FrontierCode 2.0 : au niveau de raisonnement max, le score de Sol est inférieur de 0,5 point à celui d’Astra, pour un coût par tâche d’environ 1/5 de celui d’Astra. Cela ne vaut que pour ce test et ce niveau de raisonnement ; on ne peut pas en tirer une conclusion générale sur les coûts.
1.4 Exemple de calcul manuel du coût d’une requête unique avec GPT-6.2 Astra
Les trois exemples de calcul ci-dessous sont nos propres calculs, effectués à partir des tarifs standard publiés sur le site officiel ; ils ne proviennent pas de mesures réelles via l’API et ne représentent en rien la facture réelle d’un compte quelconque. La formule de calcul est la suivante :
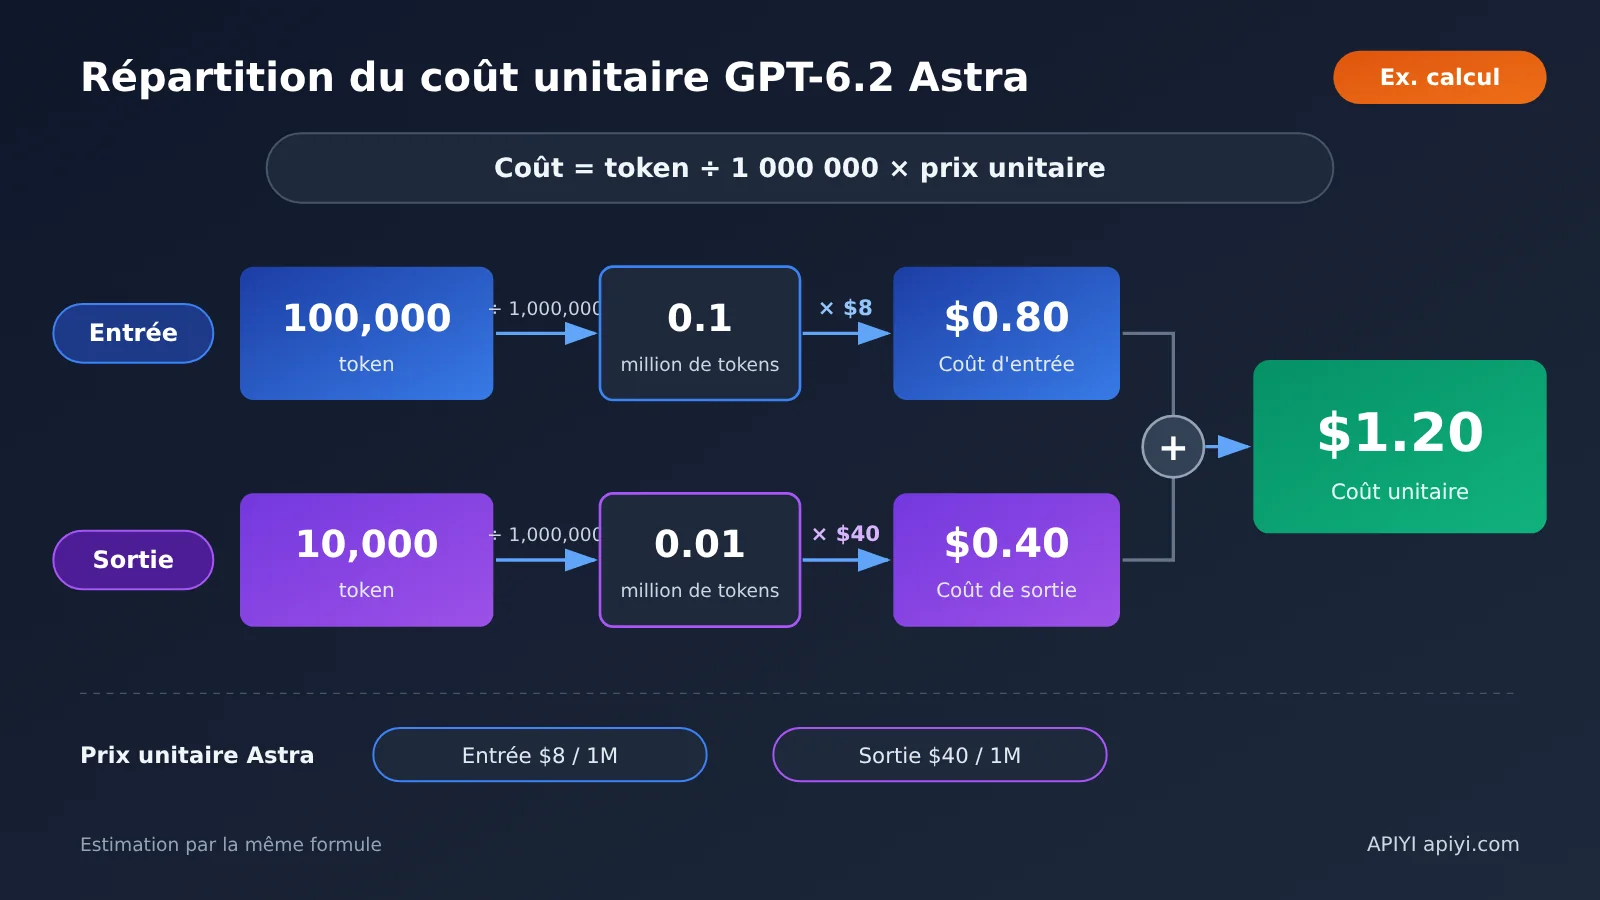
Coût = nombre de tokens ÷ 1,000,000 × prix unitaire par million de tokens
Exemple 1 : requête standard, comparaison entre l’ancien et le nouveau Astra, et avec Sol
Hypothèses : entrée non mise en cache de 100,000 tokens, sortie de 10,000 tokens, entrée ne dépassant pas 272K, aucune lecture ni écriture de cache, aucun appel d’outil, facturation au tarif standard.
| Élément | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Coût d’entrée | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| Coût de sortie | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| Total par requête | $1.50 | $1.20 | $0.30 |
| Par rapport à GPT-6 Astra | Référence | $0.30 de moins (-20 %) | $1.20 de moins (-80 %) |
Dans le tableau, « 0.1 » correspond à 100,000 ÷ 1,000,000 et « 0.01 » à 10,000 ÷ 1,000,000. Si vous envoyez 10,000 requêtes identiques par mois, selon ces hypothèses, GPT-6 Astra coûterait environ $15,000 et GPT-6.2 Astra environ $12,000. Ce résultat n’est qu’une extrapolation linéaire et ne constitue aucun engagement de coût.
Exemple 2 : requête GPT-6.2 Astra avec lecture dans le cache
Hypothèses : entrée totale de 100,000 tokens, dont 80,000 tokens lus depuis le cache et 20,000 tokens d’entrée ordinaire non écrits dans le cache, sortie de 10,000 tokens ; la quantité de cache écrite pour cette requête est fixée à zéro et le coût de création du cache historique n’est pas compté dans cet exemple.
- Entrée non mise en cache : 0.02 × $8 = $0.16
- Lecture du cache : 0.08 × $0.4 = $0.032
- Sortie : 0.01 × $40 = $0.40
- Total : environ $0.592
Le prix de lecture du cache de la génération précédente, GPT-6 Astra, était de $1.00 par million de tokens ; la nouvelle version est à $0.40, soit une baisse de 60 %. Pour le même ensemble de tokens, le coût de la génération précédente s’élève à $0.20 + $0.08 + $0.50 = $0.78 ; la nouvelle version à $0.592, soit $0.188 de moins, environ 24.1 % de baisse. Les deux ne prennent pas en compte l’écriture du cache, les outils ni les autres frais, et ne peuvent donc pas être considérés comme une facture complète.
Exemple 3 : requête GPT-6.2 Astra en contexte long dépassant 272K
Hypothèses : entrée ordinaire de 300,000 tokens (au-delà de 272K), sortie de 10,000 tokens, quantités de lecture et d’écriture du cache toutes deux nulles.
- Entrée : 0.3 × ($8 × 2) = $4.80
- Sortie : 0.01 × ($40 × 1.5) = $0.60
- Total : $5.40
Attention : les paliers sont calculés sur l’ensemble de la requête. Dès que l’entrée dépasse 272K, toutes les entrées de cette requête sont facturées au taux doublé (×2), et non uniquement la portion qui dépasse le seuil.
La durée de vie du cache se configure via prompt_cache_options.ttl de l’API Responses : "30m" par défaut, avec la possibilité de choisir "12h", et un point d’arrêt explicite individuel peut être surchargé par prompt_cache_breakpoint.ttl. Cette valeur indique une durée de vie minimale du cache, pas une limite de suppression des données ; elle ne doit pas être confondue avec l’ancien paramètre prompt_cache_retention des modèles précédents.
Lorsque l’entrée dépasse 272K, pour le palier Standard d’Astra, les tarifs de l’entrée normale, de la lecture du cache, de l’écriture 30 minutes, de l’écriture 12 heures et de la sortie sont respectivement de $16, $0.80, $20, $40 et $60 par million de tokens ; le multiplicateur s’applique à l’ensemble de la requête, pas seulement à la partie excédentaire.
1.5 Sources officielles de GPT-6.2 Astra
-
Annonce officielle d’OpenAI : openai.com/index/introducing-gpt-6-2-astra-sol/
- Documentation du modèle GPT-6 Astra : prix officiels de l’ancien modèle
- Documentation du modèle GPT-6.2 Astra : prix officiels du nouveau modèle et conditions tarifaires
- Documentation du modèle GPT-6.2 Sol : developers.openai.com/api/docs/models/gpt-6.2-sol
- Page de tarification de l’API OpenAI : developers.openai.com/api/docs/pricing
- Documentation d’aide ChatGPT Work et Codex : help.openai.com/en/articles/20001275-chatgpt-work-and-codex
II. Analyse et interprétation de la baisse de 20 % du prix de GPT-6.2 Astra
Ce qui suit est une lecture de la rédaction fondée sur les faits exposés plus haut : il s’agit d’une analyse et d’un jugement, et non d’une conclusion officielle.
2.1 Le prix unitaire baisse de 20 %, mais pourquoi la facture ne baisse pas forcément de 20 %
Si l’exemple de calcul 1 aboutit à un 20 % strict, c’est uniquement parce qu’il ne contient que deux postes — les entrées non mises en cache et les sorties standard — et que ces deux postes baissent précisément de 20 %. Les factures d’une activité réelle se composent généralement de plusieurs types de coûts, et toute variation de proportion sur l’un d’eux fait dévier la baisse globale de ces 20 %.
| Facteur de coût | Impact possible sur la facture réelle | Base de l’évaluation |
|---|---|---|
| Lecture et écriture du cache | Le prix unitaire de lecture du cache baisse de 60 %, différemment des 20 % des entrées non mises en cache ; il faut calculer selon le nombre de tokens de chaque catégorie, sans présumer de la baisse globale ; l’écriture du cache applique un tarif global distinct et ne s’ajoute pas aux frais d’entrée ordinaires | Tableau des prix officiel |
| Paliers de contexte long | Au-delà de 272K, le tarif de l’ensemble de la requête est majoré, et le coût d’une requête dans un scénario de document long peut être nettement supérieur à celui de l’exemple de calcul 1 | Règles de facturation officielles |
| Nombre de tokens de sortie / de raisonnement | L’évaluation officielle GDPval v2 rapporte 22 % de tokens de sortie en moins ; si votre tâche présente une variation similaire, l’économie peut dépasser 20 % ; si le niveau de raisonnement est plus élevé, cela peut aussi coûter plus cher | Évaluation officielle (tâche spécifique) |
| Appels d’outils et niveaux de vitesse | Le mode Fast de GPT-6.2 Astra correspond au double du tarif Standard à contexte identique, et le mode Batch à 50 % ; les frais d’outils sont calculés séparément selon l’outil utilisé | Page officielle du modèle et page de tarification |
| Canal d’invocation | Lors d’un appel via des plateformes tierces comme APIYI apiyi.com, la facturation réelle annoncée par la plateforme fait foi ; on ne peut pas appliquer directement le prix officiel | Différence de canal |
Un point facile à négliger est celui des « 22 % de sorties en moins ». Ce chiffre provient de l’évaluation GDPval v2 ; si on l’applique directement à toutes les activités et qu’on en tire la conclusion d’« économies réelles supérieures à 30 % », on transforme un résultat officiel obtenu sur une évaluation spécifique en règle générale. L’approche plus prudente consiste à réaliser un test sur un petit échantillon avec ses propres requêtes réelles, à relever le nombre de tokens dans le champ usage, puis à se prononcer.
2.2 Choisir entre GPT-6.2 Astra et Sol
À première vue, chaque tarif de Sol est environ quatre fois moins élevé que celui d’Astra. Dans le premier exemple de calcul, le coût par appel de Sol ne représente qu’un quart de celui d’Astra. Les résultats de FrontierCode 2.0 montrent que, sur le niveau de raisonnement max, l’écart entre Sol et Astra est faible, mais la documentation officielle ne précise pas si cette conclusion vaut pour d’autres tâches.
Notre avis : pour les cas où le coût compte et où la difficulté est moyenne, Sol mérite d’être évalué en priorité ; pour les cas exigeant une qualité élevée ou des tâches complexes, la baisse du prix d’Astra a aussi abaissé le seuil. Pour trancher, le mieux est de faire un test A/B sur votre propre jeu de tâches.
💡 Conseil de choix : si vous voulez comparer, dans le même code, la consommation de tokens et la qualité des sorties de plusieurs modèles, vous pouvez passer par une interface agrégée compatible OpenAI comme APIYI apiyi.com pour changer de modèle. Pour savoir si la série GPT-6.2 est déjà disponible sur la plateforme et à quel prix, référez-vous à la liste des modèles et à la page de facturation.
2.3 Code d’estimation des coûts de GPT-6.2 Astra
Le script ci-dessous ne fait que des calculs locaux, il n’appelle aucune API. Il décompose l’entrée en quatre catégories qui ne se chevauchent pas : entrée ordinaire, lecture du cache, écriture de 30 minutes et écriture de 12 heures ; le volume total d’entrée sert à déterminer le palier de 272K. Les tarifs d’écriture sont des tarifs globaux : on n’ajoute pas en plus le tarif d’entrée ordinaire aux tokens écrits.
# Tarifs OpenAI Standard, USD par million de tokens ; hors outils, taxes et autres frais de palier
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# Les mêmes 100 000 tokens d’entrée sont tous facturés en écriture 30 min : ce n’est pas 1,2 plus 1,0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
Pour l’usage de Responses, il faut d’abord identifier le volume lu depuis le cache et le volume écrit, puis soustraire ces deux volumes du total d’entrée pour obtenir l’entrée ordinaire. Quand les durées de 30 minutes et de 12 heures sont mélangées, il faut aussi répartir les volumes d’écriture selon le détail de facturation réel ; on ne peut pas appliquer un seul tarif à toutes les écritures. Si le canal ne fournit pas le détail des écritures ou utilise une autre convention de facturation, vérifiez avec la facture de ce canal et ne partez pas du principe que le volume d’écriture est nul. Si la sortie facturée inclut des tokens de raisonnement, ne rajoutez pas encore une fois le volume de raisonnement. Cet article n’appelle pas réellement l’API ; pour savoir si une plateforme tierce prend en charge ces configurations et comment elle facture, reportez-vous à sa documentation.
2.4 Recommandations face à la baisse de prix de GPT-6.2 Astra
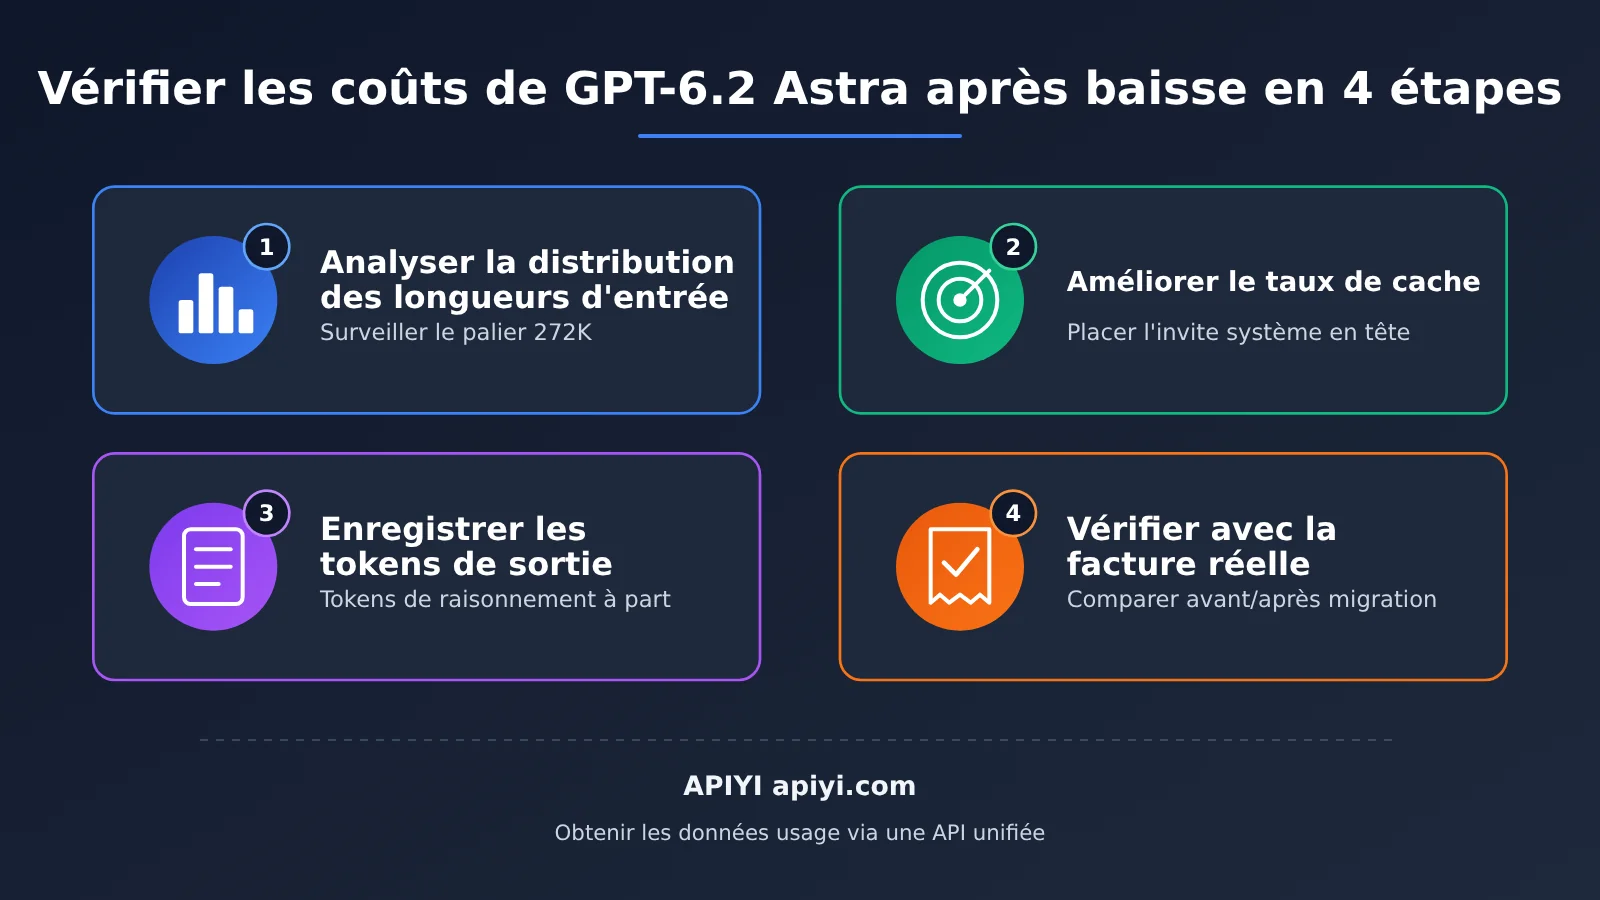
Pour les développeurs : commencez par analyser la distribution des longueurs d’entrée de vos requêtes existantes, pour voir combien d’entre elles approchent ou dépassent 272K. Si la part des requêtes à long contexte est élevée, vous pouvez ramener l’entrée sous les paliers grâce au découpage par recherche, à la compression par résumé, etc. — l’économie réalisée peut alors dépasser les 20 % de la baisse. En parallèle, placez les invites système fixes en tête de requête pour améliorer le taux de succès du cache.
Pour les responsables budgétaires : vous pouvez prendre la « baisse de 20 % du tarif standard d’Astra » comme référence budgétaire, à volume d’entrée et de sortie non mis en cache équivalent — et non comme un plafond de baisse réelle ou une économie garantie. Comparez les factures réelles sur une période avant et après migration, en détaillant séparément l’évolution du cache, du long contexte et des tokens de sortie. Les équipes qui passent par des plateformes comme APIYI apiyi.com doivent aussi se fier à la méthode de facturation de la facture de la plateforme.
Changements ultérieurs à surveiller : la mise à jour officielle des prix, la progression de l’ouverture des canaux, et la capacité des évaluations indépendantes tierces à reproduire les données officielles. L’officiel a déjà précisé les tarifs d’écriture de cache et de niveau de vitesse ; lors de l’estimation, vérifiez le niveau choisi au lieu de les considérer comme non publiés. Pour le nouveau Astra en Standard et contexte court, l’écriture de cache avec rétention de 30 minutes est de 10 $/million de tokens, et de 20 $/million de tokens pour 12 heures ; les trois exemples de calcul principaux de cet article supposent tous un volume d’écriture de cache nul pour cette fois, ce qui ne signifie pas qu’une requête API par défaut n’a pas nécessairement d’écriture.
Si vous voulez d’abord tester le processus de vérification de facturation, vous pouvez comparer les données d’usage de différents modèles sur APIYI apiyi.com avec le même code. Une fois la série GPT-6.2 disponible sur votre canal, vous pourrez directement substituer les nombres réels de tokens dans la fonction d’estimation ci-dessus.
La baisse de 20 % est un signal clair, mais le chiffre sur la facture dépend de la longueur d’entrée de chaque requête, du taux de succès du cache et du volume de sortie. Bien calculer chaque multiplication est plus utile que de retenir un pourcentage.
« Beware of little expenses; a small leak will sink a great ship. »
— Benjamin Franklin, Poor Richard’s Almanack
(Attention aux petites dépenses ; une petite fuite suffit à couler un grand navire.)