Примечание автора: отправной точкой служит один usage из Responses — постатейно пересчитываем обычный ввод, чтение и запись кэша, а также вывод рассуждений для GPT-6.2 Sol, а затем объясняем, как срок жизни кэша и состояние запроса меняют счёт в одном и том же рабочем процессе.
Счёт за GPT-6.2 Sol можно пересчитать по фиксированной методике. В записи запроса usage разбивает ввод на обычный ввод, чтение кэша, запись в 30-минутный кэш и запись в 12-часовой кэш — эти четыре категории взаимоисключающие. Вывод образует отдельную категория, и токены рассуждений уже включены в неё. Число токенов каждой категории умножается на соответствующий тариф, после чего значения складываются — это и есть стоимость модели за данный запрос. Плата за инструменты рассчитывается отдельно.
Есть три условия, которые меняют результат. Первое — превышает ли общий объём ввода одного запроса 272K; после превышения весь запрос переходит на тариф длинного контекста. Второе — срок жизни кэша и фактическое число попаданий: если один и тот же префикс записывается на 30 минут или на 12 часов, точка окупаемости различается. Третье — состояние запроса: incomplete, повторные попытки и фоновые задачи влияют на общий счёт рабочего процесса.
OpenAI выпустила GPT-6.2 Sol 17 ноября 2026 года. ID модели в API — gpt-6.2-sol, её можно вызывать через Responses и Chat Completions; вызов функций и встроенные инструменты идут через путь Responses. В этой статье за основу берутся официальные долларовые цены OpenAI при прямом подключении, а также описывается, как эта модель указана в публичном интерфейсе цен APIYI apiyi.com. Все расчёты в статье основаны на синтетическом использовании, а не на реальных счетах.
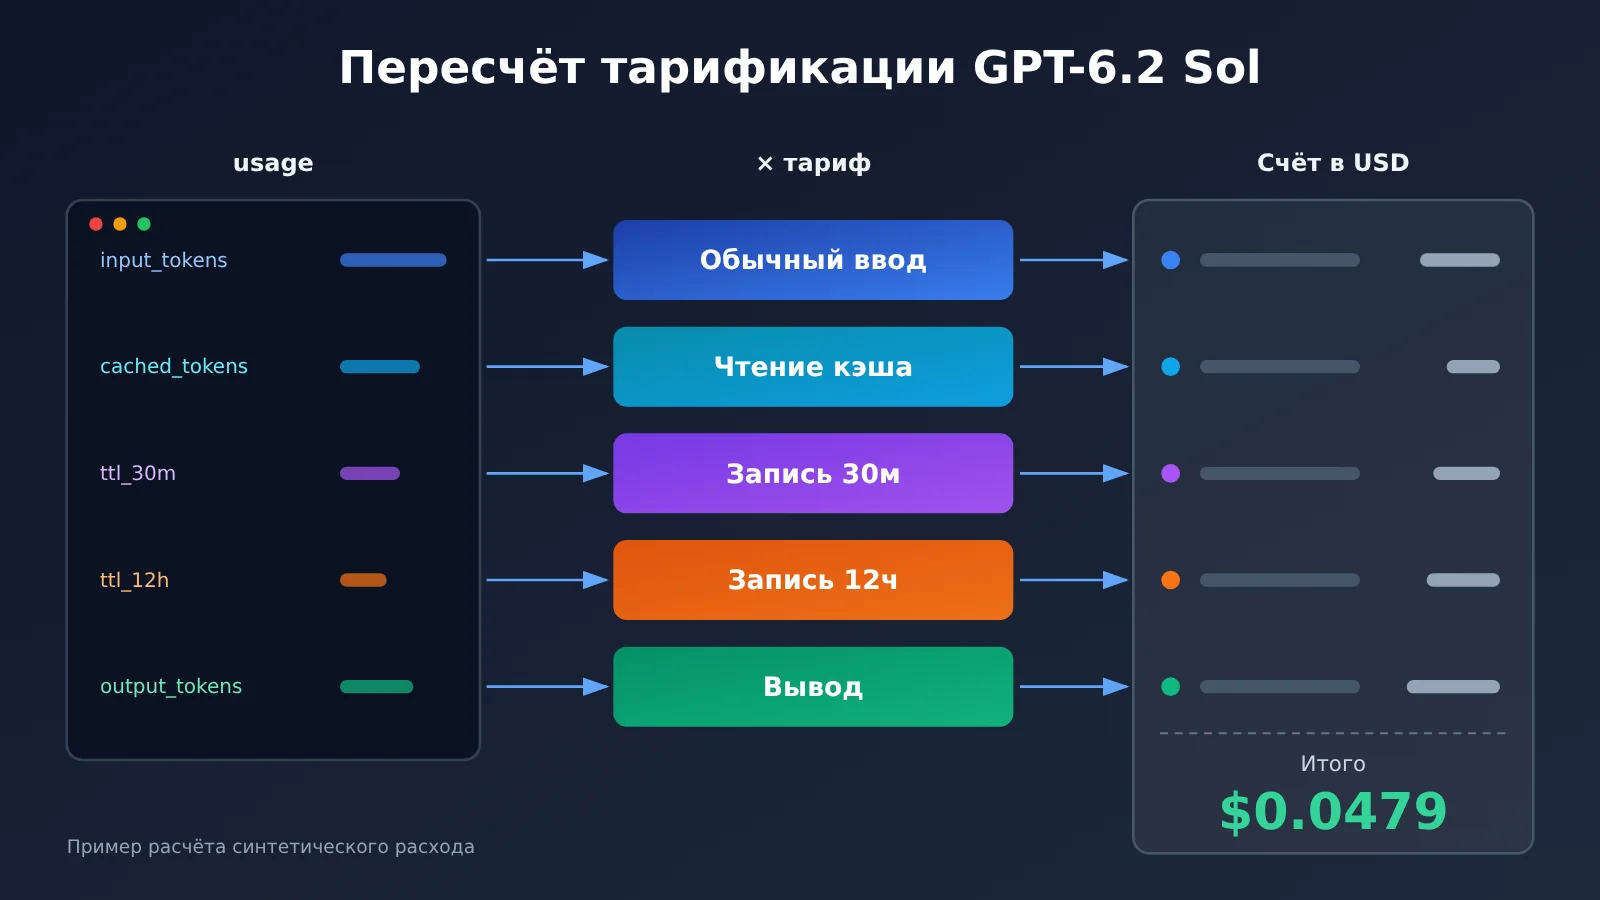
Карта знаний по тарификации GPT-6.2 Sol и порядок чтения
Весь материал построен в порядке «поля → суммы → решение о кэшировании → сверка рабочего процесса». Выход каждого шага служит входом для следующего: сначала разберитесь, какие пункты есть в usage, затем переведите их в доллары, потом с помощью этого алгоритма сравните варианты кэширования и, наконец, сведите стоимость отдельных запросов в стоимость рабочего процесса.
Responses usage
 ├─ Общий объём ввода input_tokens
 │   ├─ Чтение из кэша cached_tokens ──────────┐
 │   ├─ Запись 30m ttl_30m_tokens ─────────────┤
 │   ├─ Запись 12h ttl_12h_tokens ─────────────┼─→ ×соответствующий тариф → стоимость модели за один запрос (раздел 2)
 │   └─ Обычный ввод = всего − чтение − все записи ┤
 └─ Вывод output_tokens (включая reasoning_tokens)┘
                                          ↓
         Выбор срока жизни кэша (раздел 3) ← сравнение общей цены при многократных запросах с одним префиксом
                                          ↓
         Сверка рабочего процесса (раздел 4) ← плата за инструменты + повторные попытки + incomplete + выгрузка расходов
| Номер | Отвечает на вопрос | Зависит от предыдущего раздела | Что можно сделать после прочтения |
|---|---|---|---|
| 1 | Какие числа в usage участвуют в тарификации | — | Разложить один ответ на пять единиц тарифицируемого объёма |
| 2 | Сколько стоят эти объёмы | Пять объёмов из раздела 1 | Переводить числа из логов в доллары, определять длинный или короткий тариф |
| 3 | Кэш писать на 30 минут или на 12 часов | Алгоритм расчёта цены из раздела 2 | Выбирать срок жизни кэша по интервалу между вызовами и числу попаданий |
| 4 | Сколько же на самом деле стоил один задача | Расчёт одного запроса из разделов 2 и 3 | Строить минимальную таблицу логов и находить расхождение в счёте |
Если вам нужно лишь объяснить одну разницу в стоимости, достаточно прочитать разделы 1 и 2. Тем, кто отвечает за стратегию кэширования или учёт затрат, советуем читать все четыре раздела по порядку.
Термины биллинга GPT-6.2 Sol, которые нужно знать
| Термин | Объяснение |
|---|---|
| usage | поле в ответе API, где суммируется расход токенов текущего запроса |
| обычный ввод | объём, оставшийся от общего ввода после вычета чтения из кэша по тарифу и всех записей в кэш |
| чтение из кэша | та часть ввода текущего запроса, которая тарифицируется по цене повторного использования |
| точка останова кэша | граница, позволяющая сохранить или переиспользовать префикс ввода |
| TTL | настройка минимального времени, которое покрывается тарификацией кэша; Sol поддерживает запись на 30 минут и на 12 часов |
| токены рассуждения | токены, которые модель создаёт на этапе размышления и которые входят в общий оплачиваемый объём вывода |
| ID ответа | идентификатор, связывающий журнал сверки, фоновый опрос и соответствующий ответ модели |
| плата за инструменты | отдельная плата за использование отдельных хостинговых инструментов |
1 Пять категорий тарифицируемого объёма GPT-6.2 Sol из usage объекта Responses
1.1 Четыре вида входа и один вид выхода
Объект usage в Responses раздельно записывает вход и выход одного запроса. На стороне входа даётся общий объём и несколько детализаций, на стороне выхода — общий объём и подкатегория рассуждений. При пересчёте нужно искать следующие поля:
| Категория тарификации | Читаемое поле | Пояснение |
|---|---|---|
| Общий объём входа | usage.input_tokens |
Сумма четырёх видов входа; сам по себе напрямую не умножается на ставку |
| Чтение из кэша | input_tokens_details.cached_tokens |
Объём чтения в биллинговом смысле |
| Суммарная запись в кэш | cache_write_tokens |
Сумма записей с двумя сроками жизни |
| Запись на 30 минут | cache_write_tokens_details.ttl_30m_tokens |
Используется при возврате детализации по сроку жизни |
| Запись на 12 часов | cache_write_tokens_details.ttl_12h_tokens |
Используется при возврате детализации по сроку жизни |
| Выход | usage.output_tokens |
Уже включает токены рассуждений |
| Подкатегория рассуждений | output_tokens_details.reasoning_tokens |
Нужна для понимания структуры выхода, отдельно не тарифицируется |
1.2 Формула расчёта обычного входа
Для обычного входа в usage нет отдельного поля — его нужно получить вычитанием:
обычный вход = input_tokens − cached_tokens − cache_write_tokens
Здесь вычитается вся запись, то есть сумма обоих сроков — 30 минут и 12 часов. Две записи, чтение и обычный вход — четыре взаимоисключающие категории: один и тот же токен попадает только в одну из них. Токены, записанные в кэш, тарифицируются по ставке записи и больше не накладываются на цену обычного входа. Именно здесь чаще всего ошибаются: если оставить объём записи в обычном входе и дополнительно начислить плату за запись, итог получится завышенным.
На стороне выхода тоже легко случайно учесть токены рассуждений дважды. reasoning_tokens — это подмножество output_tokens, при пересчёте достаточно умножить output_tokens на ставку выхода. Подкатегория рассуждений подходит для анализа «почему в этот раз такой большой выход», но не как отдельная статья тарификации.
1.3 Для пересчёта — биллинговые поля, диагностические только для поиска проблем
В диагностической информации Prompt Caching также встречаются числа вроде «объём для повторного использования» или «оценка промахов». Они объясняют, почему кэш не сработал — например, изменился префикс или не хватило длины, — но не отражают фактическое списание. При пересчёте счёта используйте только фактические биллинговые поля из usage.
Если какой-то канал не вернул детализацию по сроку жизни или в нём отсутствует cache_write_tokens, не стоит по отсутствующим полям восстанавливать счёт. В такой ситуации ориентируйтесь на собственные записи о списаниях этого канала. В примере расчёта из следующего раздела используется синтетический usage — все поля заполнены, чтобы удобно показать полный алгоритм.
2 Переводим числа из логов GPT-6.2 Sol в доллары
2.1 Официальная таблица тарифов Standard
В таблице ниже — официальные тарифы OpenAI при прямом подключении, единица измерения — USD за миллион токенов. Короткий или длинный тариф определяется по общему объёму входных данных каждого запроса: если он превышает 272K, весь запрос переключается на тариф длинного контекста — ставки на вход и все виды кэша ×2, на выход ×1.5.
| Категория тарификации Standard | Короткий контекст (≤272K) | Длинный контекст (>272K) |
|---|---|---|
| Обычный вход | $2.00 | $4.00 |
| Чтение кэша | $0.10 | $0.20 |
| Запись кэша на 30 минут | $2.50 | $5.00 |
| Запись кэша на 12 часов | $5.00 | $10.00 |
| Выход (включая токены рассуждений) | $10.00 | $15.00 |
Базовая цена короткого контекста такая же, как у GPT-6.1 Sol. Кроме того, в карточке модели указано контекстное окно 1,050,000 токенов, максимальный вход 922,000 токенов и максимальный выход 128,000 токенов. «Сколько максимум можно подать на вход» и «с какого момента начинается тарификация по длинному тарифу» — два независимых числа: запрос с 300K входных данных вполне допустим, но оплачиваться он будет целиком по длинному тарифу.
2.2 Полный пересчёт синтетического usage
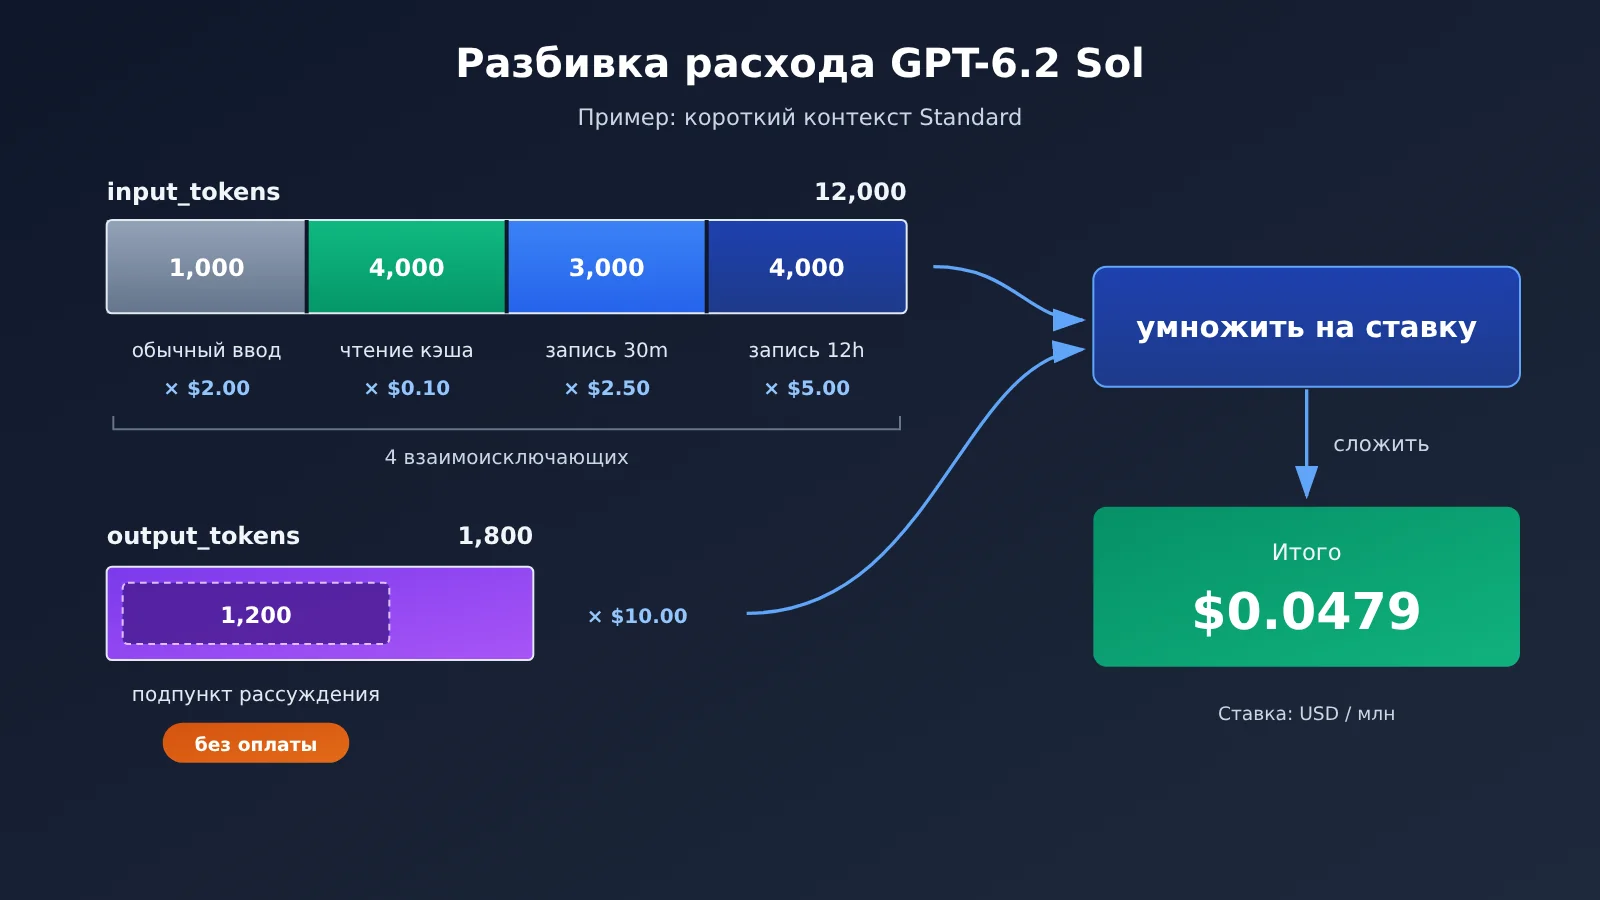
Предположим, один запрос Standard с коротким контекстом возвращает следующий usage, инструменты не использовались, доплат нет: общий объём ввода 12 000, чтение из кэша 4 000, запись 30 минут 3 000, запись 12 часов 4 000, вывод 1 800 (из них рассуждение 1 200).
Сначала найдём обычный ввод: 12 000 − 4 000 − 3 000 − 4 000 = 1 000. Затем умножим каждую позицию на тариф:
| Статья биллинга | Кол-во токенов | Тариф (USD/миллион) | Сумма (USD) |
|---|---|---|---|
| Обычный ввод | 1 000 | 2.00 | 0.0020 |
| Чтение из кэша | 4 000 | 0.10 | 0.0004 |
| Запись 30 минут | 3 000 | 2.50 | 0.0075 |
| Запись 12 часов | 4 000 | 5.00 | 0.0200 |
| Вывод (включая рассуждение 1 200) | 1 800 | 10.00 | 0.0180 |
| Итого | — | — | 0.0479 |
В этом счёте запись на 12 часов занимает всего 4 000 токенов, но даёт больше сорока процентов суммы. Причина в том, что её цена за единицу в 2,5 раза выше, чем у обычного ввода: сама запись несёт только затраты, а отдача наступает лишь при последующих попаданиях. В разделе 3 разберём это отдельно.
Совет: в реестре затрат лучше хранить количество токенов и тариф отдельно по каждой статье биллинга, а не только одну итоговую сумму. Тогда при расхождении в стоимости можно подставить фактические значения из логов прямо в таблицу выше и построчно найти источник разницы.
2.3 Длинный контекст: сначала меняем тарифы, потом применяем ту же формулу
Когда общий объём ввода превышает 272 тыс. токенов, сам алгоритм не меняется — достаточно заменить весь столбец тарифов из таблицы выше на значения для длинного контекста. Важно: переключение действует на весь запрос целиком, чтение и запись кэша тоже удваиваются синхронно, а вывод считается с коэффициентом 1,5. Поэтому определять, короткий у вас диапазон или длинный, нужно до того, как начнёте перемножать по пунктам.
При вызове через сторонние каналы тарифы нужно брать по их собственной сетке. Возьмём для примера APIYI apiyi.com: при повторном чтении их публичного интерфейса цен 2026-11-20 выражение billing_expr для gpt-6.2-sol тоже переключается на пороге 272 000 входных токенов: короткий диапазон — обычный ввод $2, чтение кэша $0.10, запись в кэш $2.50, вывод $10; длинный диапазон — $3, $0.15, $3.75 и $11.25 соответственно (USD за миллион токенов). Как видите, множители для длинного диапазона отличаются от официального прямого подключения, а выражение в интерфейсе указывает только одну цену записи в кэш. Фактические группы, возможности и выставление счетов в реальном проекте определяются текущей конфигурацией платформы и её счетами.
Код ниже отправляет один запрос Responses через OpenAI-совместимый интерфейс APIYI и печатает usage как есть — чтобы потом можно было пересчитать вручную:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "固定规则与公共资料(放在前部便于缓存复用)"},
        {"role": "user", "content": "本次请求的具体问题"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
Получив usage, переводим пять показателей расхода в деньги одной функцией. Тарифную таблицу делаем параметром: чтобы переключиться на официальную сетку или на сетку канала, достаточно поменять конфигурацию:
Посмотреть полную функцию пересчёта
LONG_THRESHOLD = 272_000

# Официальный тариф OpenAI Standard, USD / миллион токенов
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # Расположение полей записи зависит от фактической структуры ответа — здесь проверяем оба места
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("缺少 cache_write_tokens,改用渠道出账记录,不要推定")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("缺少写入寿命明细,无法区分 30m/12h 费率")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# Проверка на синтетическом usage из раздела 2.2
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
При отсутствии поля функция сразу выбрасывает ошибку, а не подставляет 0. Это сделано для того, чтобы не обсчитать запрос без детализации записи как «всё по обычному входу».
🎯 Технический совет: когда ведёте учёт затрат, сначала прогоните функцию пересчёта на синтетическом usage и только потом подключайте реальные логи. Через APIYI apiyi.com можно тем же API-ключом отправить тестовые запросы с небольшим трафиком, сопоставить возвращённый usage со счётом платформы строка за строкой и, убедившись в трактовке полей, запускать статистику в продакшене.
3 Выбор срока жизни кэша GPT-6.2 Sol в зависимости от ритма вызовов
3.1 Расчёт для одного и того же префикса при двух и трёх обращениях
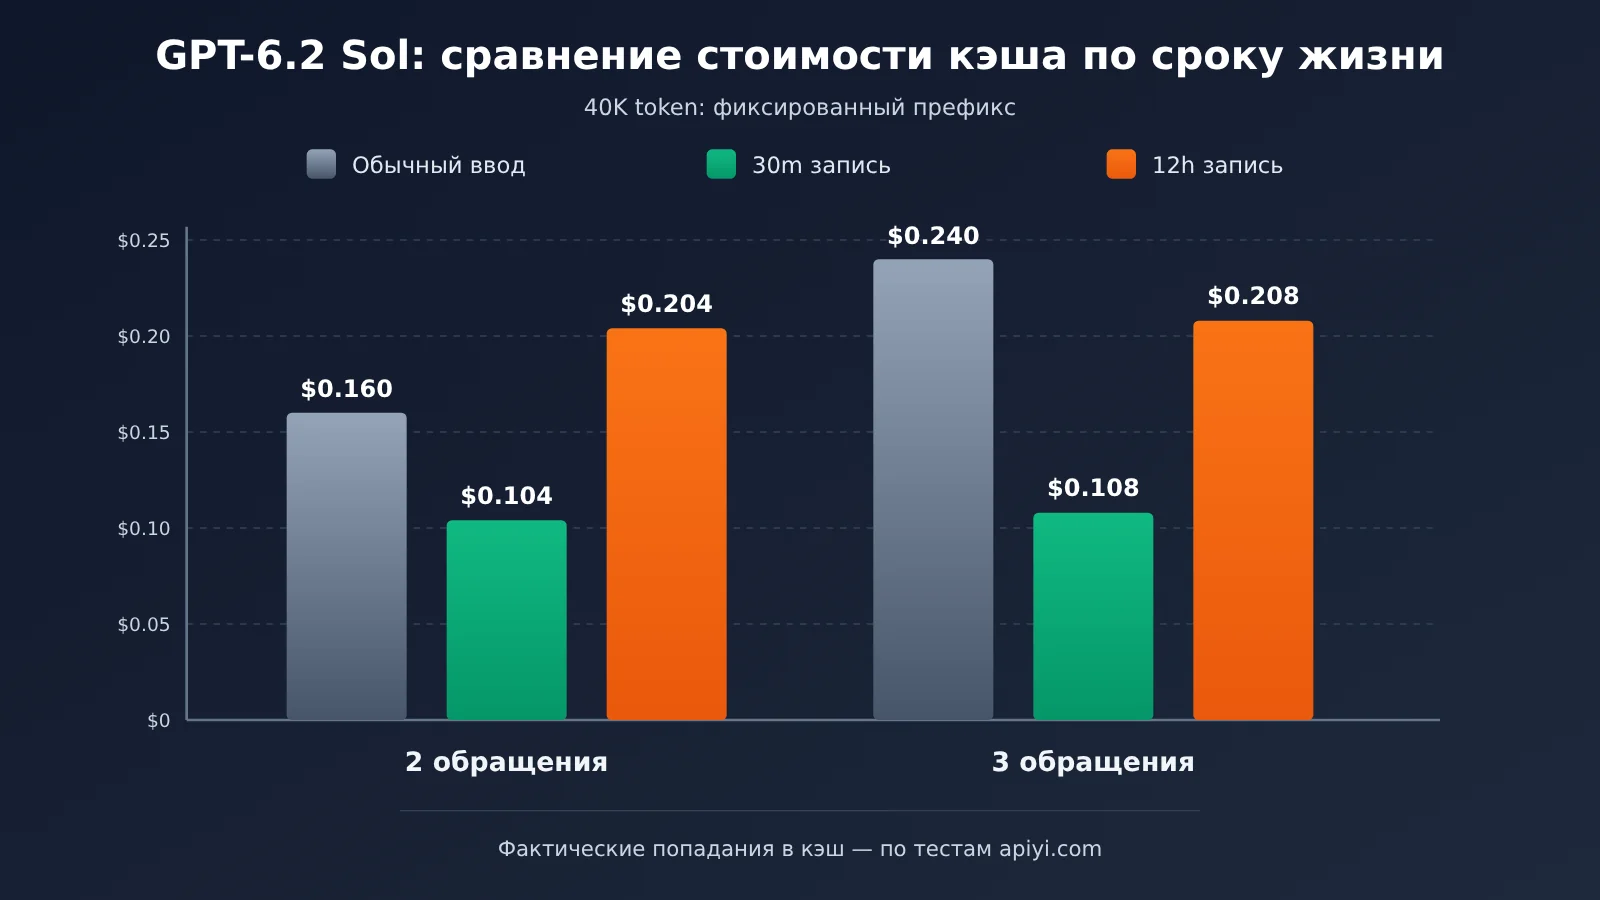
Предположим, есть фиксированный префикс на 40 000 токенов (системные правила плюс общие материалы), тарифицируется по Standard для короткого контекста. Стоимость каждого типа операции за один раз следующая: обычный ввод — $0.08, первая запись на 30 минут — $0.10, первая запись на 12 часов — $0.20, чтение при полном попадании в кэш — $0.004. В таблице ниже сравнивается только часть с фиксированным префиксом, без переменного содержимого каждого запроса и вывода.
| Режим доступа | Обычный ввод | Схема записи 30m | Схема записи 12h |
|---|---|---|---|
| Всего 2 раза (1 запись + 1 чтение) | $0.160 | $0.104 | $0.204 |
| Всего 3 раза (1 запись + 2 чтения, все в пределах окна) | $0.240 | $0.108 | $0.208 |
При двух обращениях запись на 12 часов оказывается на $0.044 дороже, чем без кэширования. При трёх обращениях оба варианта кэширования дешевле обычного ввода, но 30-минутная схема всё ещё составляет примерно половину стоимости 12-часовой. При условии, что все эти обращения укладываются в 30-минутное окно.
3.2 Точка окупаемости: сколько попаданий нужно, чтобы отбить затраты
Если взглянуть на эти цифры под другим углом, картина станет нагляднее (расчёты ниже — по тарифам M3). Каждое полное попадание экономит $0.076 по сравнению с обычным вводом. Запись с TTL 30 минут стоит на $0.02 дороже обычного ввода — хватает одного попадания, чтобы её отбить. Запись с TTL 12 часов дороже на $0.12, и для окупаемости нужно минимум два попадания внутри окна.
Так что ценность 12-часовой записи не в том, что «внутри одного окна больше попаданий», а в том, что попадание срабатывает даже при интервале между вызовами больше 30 минут. Если два соседних запроса с одинаковым префиксом обычно идут с разницей в несколько минут, 30-минутной записи достаточно, а выбор 12 часов лишь добавит плату за запись. Если же запросы приходят раз в один-два часа, 30-минутный кэш давно истекает и каждый раз приходится писать заново — вот тогда 12-часовая запись вместе с несколькими попаданиями может оказаться выгоднее.
Есть ещё два момента, которые меняют картину. TTL — это минимальное время, за которое берётся плата, и оно не означает, что кэш обязательно живёт именно столько; в итоге смотреть надо на фактический объём чтения в usage. У 30-минутной записи при чтении действует правило продления, так что в высокочастотных сценариях фактическое покрытие может оказаться дольше номинальных 30 минут. Поэтому после выбора конфигурации стоит оглянуться на реальные записи о попаданиях, а не смотреть только на настройки.
3.3 Схема точек кэширования: стабильный контент — в начало
Кэш действует только на префикс, а минимальный кэшируемый префикс — 1,024 видимых входных токена. На практике точки кэширования можно расставлять послойно, ориентируясь на период повторного использования:
- Долгоживущие общие материалы, например руководства по продукту или сводки кодовой базы: размещайте в самом начале и рассматривайте запись на 12 часов.
- Короткоживущие записи сеанса, например историю текущего диалога: размещайте после них и рассматривайте запись на 30 минут.
- Мгновенные инструкции, которые меняются каждый раз: размещайте в конце, вне кэша.
У GPT-6.2 есть один нюанс, на котором легко споткнуться: верхнеуровневый instructions находится после точки кэширования. Если записать фиксированные правила в instructions, эта часть не будет переиспользована. Фиксированные правила лучше поместить в developer-сообщение в начале input, а instructions оставить для содержимого, которое может меняться от запроса к запросу.
💡 Совет по выбору: срок жизни кэша стоит определять по реальному трафику. Рекомендую сначала на APIYI apiyi.com отправить несколько запросов с одним и тем же префиксом в реальном темпе, посмотреть статистику попаданий
cached_tokens, а затем решить, для какого слоя использовать 30 минут, а для какого — 12 часов. Разные каналы могут по-разному тарифицировать запись в кэш; ориентируйтесь на счёт платформы.
4. Как суммировать затраты GPT-6.2 Sol по рабочему процессу и отследить расхождение
4.1. Три статуса запросов, из-за которых счёт может не совпасть с ожиданиями
Даже если отдельный запрос посчитан правильно, итоговая сумма по рабочему процессу всё равно может не сходиться. Обычно причина кроется в статусах запросов:
- incomplete: когда вывод достигает
max_output_tokens, ответ может завершиться со статусомincomplete. В этот момент видимого текста может ещё не быть, но входные токены и токены рассуждения уже созданы и оплачены. Если учитывать только запросы, которые «успешно вернули контент», эти затраты выпадут из расчёта. - Фоновые задачи: если у фоновой задачи уже есть ID ответа, при опросе отслеживайте её по тому же ID. Не считайте каждый опрос новым запросом, иначе затраты задвоятся.
- Повторы: отдельные вызовы, которые запускаются заново из-за таймаута или статуса
incomplete, создают новый ответ, и их нужно учитывать отдельно. Чем больше повторов, тем больше раз вы снова платите за входные токены одной и той же задачи.
4.2 Стоимость инструментов и дополнительные токены, которые они порождают
Responses поддерживает такие инструменты, как поиск по файлам, веб-поиск, интерпретатор кода и генерация изображений. При использовании генерации изображений Sol в ходе процесса инициирует вызов инструмента, само изображение создаётся отдельным инструментом, и оплата идёт по правилам для инструментов. Плата за инструменты сверяется по фактическому типу: например, веб-поиск считается как $10 за тысячу вызовов, а токены контента, возвращённого поиском, тарифицируются отдельно по ставке модели.
При пересчёте нужно проверить, какие именно токены покрывает usage. Когда результаты инструмента подставляются в следующий запрос к модели, это выглядит как рост входного объёма последующих запросов — такая часть затрат приходится на последующие запросы, а не на сам вызов инструмента. В рабочем процессе с поиском счёт обычно состоит из двух частей: «плата за количество вызовов инструмента + плата за несколько раундов запросов к модели».
4.3 Минимальный набор полей журнала
Чтобы рабочий процесс можно было сверять, для каждого ответа модели нужно фиксировать как минимум следующие поля:
| Поле журнала | Назначение |
|---|---|
| ID рабочего процесса | объединяет несколько запросов в одну задачу |
| ID ответа | связывает с фоновым опросом, отличает повторную попытку от того же запроса |
| Модель | определяет тарифную таблицу, например gpt-6.2-sol |
| Уровень сервиса | проверить, что используется Standard |
| Финальный статус | распознать completed, incomplete и т. п. |
| Статьи расхода | обычный вход, чтение, запись 30m, запись 12h, выход, рассуждения |
| Инструменты | тип инструмента и количество вызовов |
| Стоимость | сумма, пересчитанная по статьям, с пометкой короткого/длинного тарифа |
С такой таблицей достаточно группировать записи по ID рабочего процесса и суммировать — получится стоимость одной задачи. Появляется и порядок разбора расхождений: сначала смотрим, нет ли incomplete и повторных попыток, затем проверяем, не ниже ли ожидаемого чтение из кэша, и в конце сверяем количество вызовов инструментов.
4.4 Перекрёстная сверка оценки по каждому запросу с официальным экспортом
Оценка по каждому запросу подходит для контроля бюджета в реальном времени, но при многошаговых вызовах инструментов, повторных попытках или отсутствии полей использования легко возникают отклонения. Рекомендуется регулярно сверять сводку оценок с официальным экспортом использования или затрат, а если расхождение превышает заданный порог — возвращаться к логам и проверять их построчно. При работе через сторонний канал сверять нужно уже с полями биллинга и тарифами этого канала.
💰 Совет по стоимости: если команда одновременно использует несколько моделей, можно через APIYI apiyi.com вызывать их единым API-ключом и сохранять в базу по минимальному набору полей лога из этой статьи. Единая точка входа позволяет держать идентификаторы рабочих процессов и методику расчёта затрат согласованными, а при сверке в конце месяца избавляет от лишнего слоя пересчёта по каналам.
Методика проверки счёта GPT-6.2 Sol
Получив любую запись запроса Sol, можно проверить счёт в таком порядке: сначала убедитесь, превышает ли общий объём ввода 272K, и выберите колонку тарифов; затем вычтите из input_tokens чтение и все записи, чтобы получить обычный ввод; после этого умножьте пять пунктов на соответствующие тарифы, сложите и сравните со счётом. Если отдельный запрос совпадает, а сумма по рабочему процессу — нет, ищите в логах incomplete, повторные попытки и вызовы инструментов.
Окупается ли кеш, в итоге определяется фактическим объёмом чтения в usage и интервалом между вызовами. Кеш-запись на 30 минут окупается одним попаданием, запись на 12 часов требует минимум двух попаданий в пределах окна, и преимущество проявляется только при интервале между вызовами больше 30 минут.
Если нужно проверить эти выводы на реальном трафике, можно запросить бесплатную тестовую квоту в APIYI apiyi.com и построчно сверять счёты платформы с помощью функции пересчёта из статьи.
📚 Справочные материалы
-
Анонс релиза OpenAI GPT-6.2 Astra и Sol: дата выхода и позиционирование продукта
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol - Описание: узнать о позиционировании Sol для повседневной работы и многошаговых агентов
- Ссылка:
-
Карточка модели GPT-6.2 Sol: спецификации контекста, тарифы и множитель для длинного контекста
- Ссылка:
developers.openai.com/api/docs/models/gpt-6.2-sol - Описание: источник таблицы тарифов в этой статье и правила ступени 272K
- Ссылка:
-
Руководство по Prompt Caching и диагностике кэша: поля кэша, TTL и правила контрольных точек
- Ссылка:
developers.openai.com/api/docs/guides/prompt-caching - Описание: объясняет cached_tokens, время жизни записи и минимальный кэшируемый префикс
- Ссылка:
-
Руководство по Reasoning: токены рассуждений и статус incomplete
- Ссылка:
developers.openai.com/api/docs/guides/reasoning - Описание: как понять, каким образом расход рассуждений учитывается в выводе
- Ссылка:
-
Руководство по контролю затрат на один запуск рабочего процесса: агрегирование затрат Responses по рабочим процессам
- Ссылка:
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - Описание: референсная реализация бюджетного контроля на уровне рабочего процесса
- Ссылка:
-
Сводная таблица моделей APIYI: доступные каналы и информация о входных точках
- Ссылка:
docs.apiyi.com/models.md - Описание: доступные входы и группы для gpt-6.2-sol
- Ссылка:
Автор: техническая команда APIYI
Обратная связь: будем рады, если вы свяжетесь с нами через главную страницу APIYI apiyi.com; больше материалов по подключению — в центре документации docs.apiyi.com