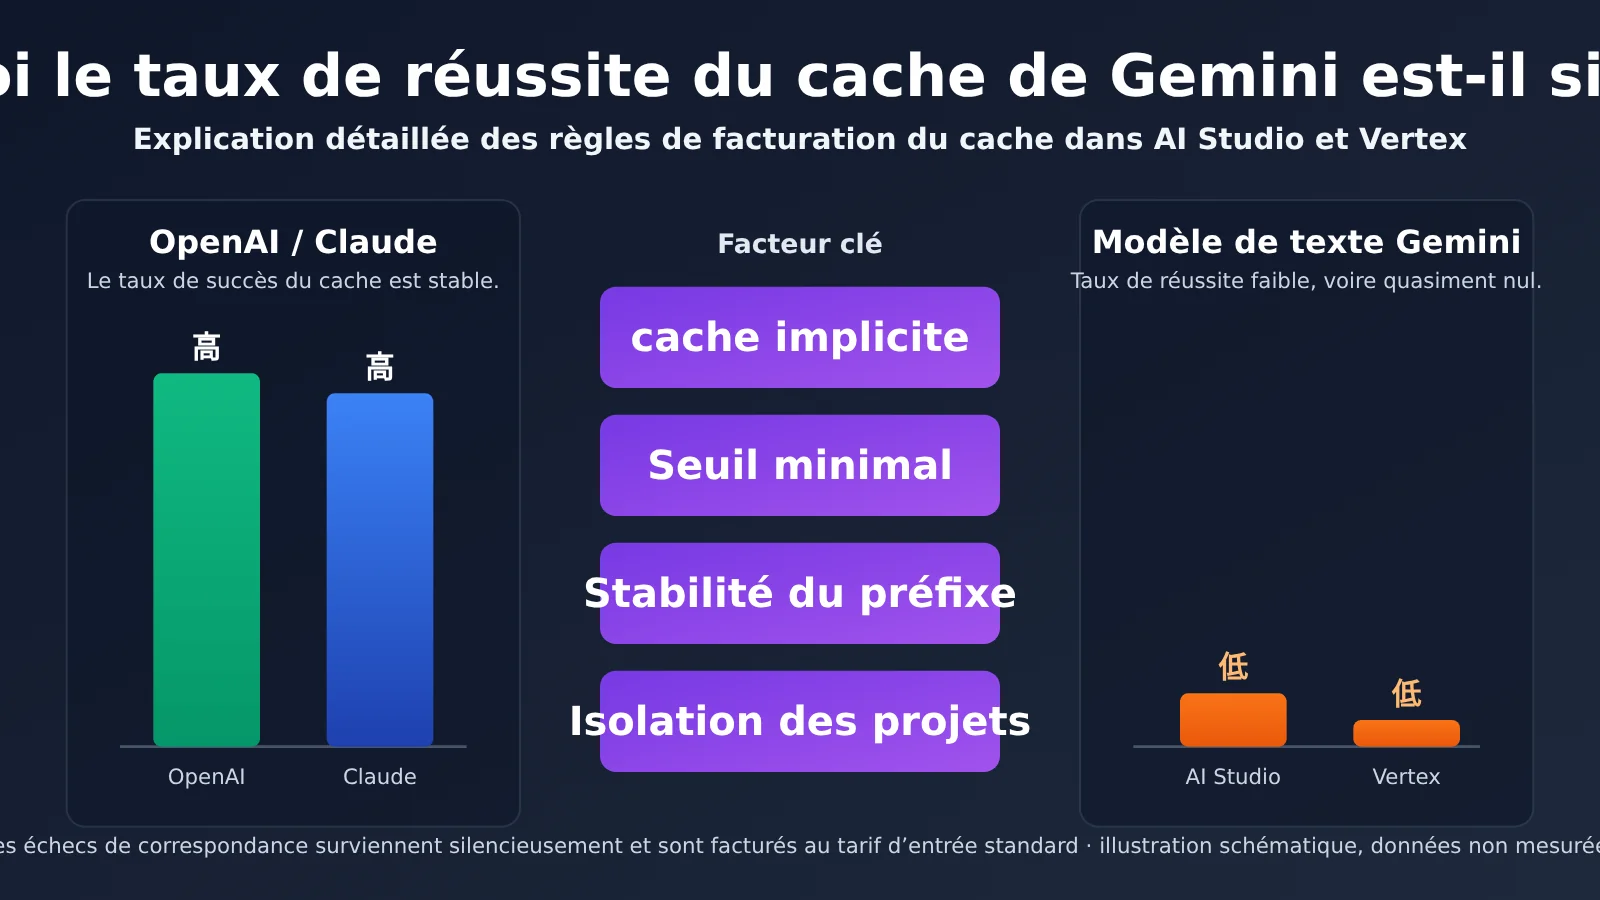
Dans la pratique, avec APIYI, la mise en cache et les succès du cache fonctionnent normalement pour les séries OpenAI et Claude, avec un taux de succès élevé. Les modèles de texte Gemini, eux, se comportent différemment : leur taux de succès du cache est faible, voire presque nul. C’est un constat que l’on peut vérifier dans les factures et les détails de consommation, et qui déroute beaucoup de développeurs lorsqu’ils rapprochent leurs comptes.
À partir de la documentation officielle de Google, à jour au 20 octobre 2026, cet article examine les 5 catégories de causes d’un faible taux de succès du cache Gemini et explique comment la facturation du cache est définie dans AI Studio (Gemini Developer API) et Vertex AI.
Il ne s’agit pas d’une analyse qui cherche un bouc émissaire. Google n’indique nulle part dans sa documentation officielle que « l’utilisation d’un service proxy réduit le taux de succès du cache Gemini ». Et sans accès aux enregistrements des requêtes en amont, nous ne pouvons pas affirmer qu’une cause précise s’applique forcément à un cas donné. Nous allons donc commencer par expliquer les règles officielles, puis présenter les conditions qui peuvent les rendre inopérantes et, enfin, proposer une méthode de diagnostic et de vérification des comptes que vous pourrez appliquer vous-même.
Ce que vous allez apprendre : vous saurez quand le cache Gemini est utilisé — ou non —, vous comprendrez le principe de facturation selon lequel « le total des entrées inclut la partie mise en cache » et vous pourrez vérifier vos factures de façon autonome à l’aide des champs de réponse officiels.
Les points essentiels sur le taux de succès du cache Gemini
Commençons par les conclusions. Pour comprendre le cache Gemini, il faut distinguer deux mécanismes : le cache implicite et le cache explicite. Ils ne se déclenchent pas de la même façon et leur facturation est complètement différente.
| Type | Fonctionnement | Comment bénéficier du tarif cache | Frais de stockage |
|---|---|---|---|
| Cache implicite (Implicit caching) | Activé automatiquement sur les modèles compatibles, sans créer d’objet de cache | Seule la partie effectivement récupérée du cache est facturée au tarif cache ; le succès n’est pas garanti à chaque requête | Non |
| Cache explicite (Explicit caching) | Créer un objet de cache, puis le référencer dans les requêtes suivantes | Les entrées du cache référencé et encore valide bénéficient du tarif cache | Oui |
La documentation officielle précise au sujet du cache implicite de la Developer API qu’il ne garantit pas de réduire les coûts. Le cache explicite offre une meilleure prévisibilité, mais demande du travail de développement supplémentaire : créer les objets de cache, gérer leur durée de validité et les référencer dans les requêtes suivantes.
Pourquoi Gemini ne fonctionne-t-il pas comme OpenAI ou Claude ?
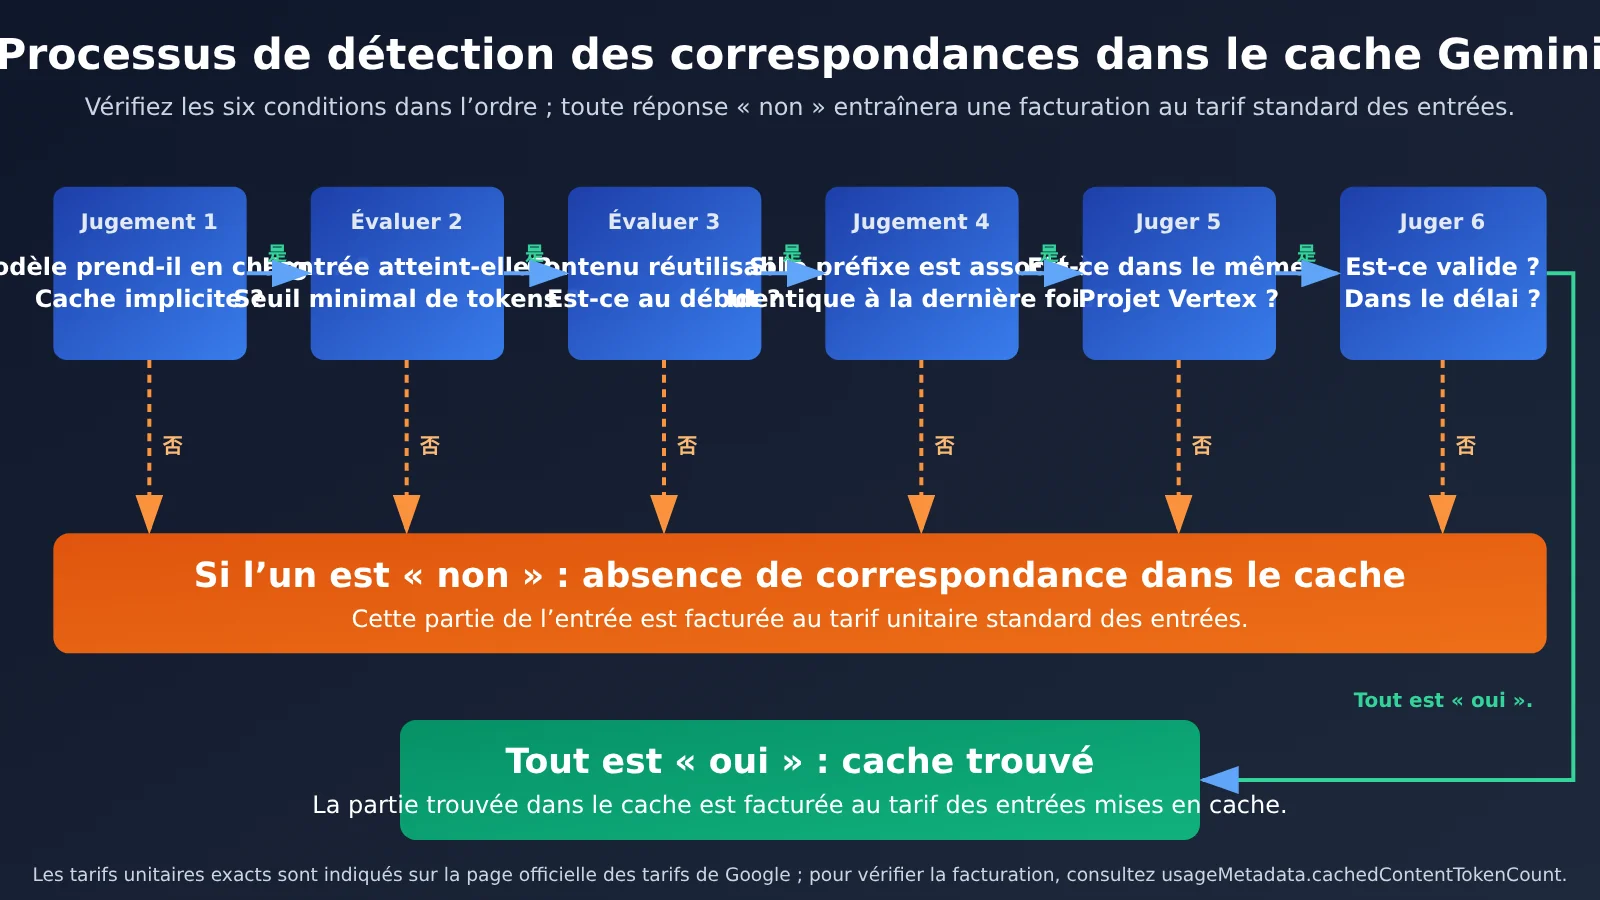
Du point de vue de l’utilisateur, les séries OpenAI et Claude sur APIYI semblent suivre cette règle : « Envoyer le même long préfixe suffit pour voir régulièrement des écritures et des succès du cache. » Avec Gemini, plusieurs conditions doivent être réunies : le modèle doit prendre en charge le cache implicite, la requête doit atteindre le seuil minimal de tokens propre au modèle, le contenu réutilisable doit se trouver au début de l’invite, les requêtes similaires doivent être envoyées dans un intervalle de temps assez court et, sur Vertex, elles doivent aussi appartenir au même projet Google Cloud.
Si une seule de ces conditions n’est pas remplie, la requête est facturée au tarif standard des entrées. Aucun message d’erreur ni avertissement ne s’affiche. C’est pourquoi un faible taux de succès du cache passe souvent inaperçu : l’absence de succès survient silencieusement.
Une précision sur ce que désigne AI Studio
Dans cet article, l’expression « canal AI Studio » désigne la Gemini Developer API, c’est-à-dire la voie d’accès qui utilise une clé API générée dans AI Studio, à comparer à Vertex AI, sur Google Cloud. Les deux reposent sur des principes similaires pour la mise en cache, mais diffèrent par le seuil minimal, le périmètre d’isolation et les règles de frais de stockage. Nous allons détailler ces différences dans la suite de l’article.
5 raisons pour lesquelles le taux de succès du cache Gemini est faible
L’analyse se divise en deux parties : les deux premières raisons correspondent à des règles explicitement indiquées dans la documentation officielle. Les trois suivantes sont des explications conditionnelles liées à des règles qui peuvent être contournées par un service proxy ou dans la pratique. Le simple fait d’utiliser un service proxy ne permet pas de déterminer laquelle s’applique : il faut consulter les projets en amont et les journaux des requêtes.
Raison 1 : la requête n’atteint pas le seuil minimal de jetons requis pour le cache
Le cache implicite impose un seuil minimal de jetons. Les requêtes dont l’entrée est trop courte ne sont pas mises en cache. En outre, le seuil n’est pas exactement le même selon la plateforme. Voici quelques valeurs indiquées dans la documentation actuelle :
| Modèle | Seuil du cache implicite de l’API Developer | Seuil du cache implicite de Vertex |
|---|---|---|
| Gemini 3.8 Flash | 4 096 | 6 144 |
| Gemini 3.1 Pro Preview | 4 096 | 6 144 |
| Gemini 2.5 Pro (ancienne génération, à titre de comparaison) | 2 048 | 2 048 |
Deux pièges sont faciles à manquer. Premièrement, les modèles de nouvelle génération, comme Gemini 3.8 Flash, ont un seuil plus élevé que ceux de la série 2.5. Estimer le seuil à partir de l’ancienne valeur de 2 048 peut donc induire en erreur. Deuxièmement, le seuil d’un même modèle peut être plus élevé sur Vertex : une requête de 5 000 jetons suffit sur l’API Developer, mais pas sur Vertex.
Les requêtes de conversation courantes ne contiennent généralement que quelques centaines à un ou deux milliers de jetons, soit naturellement moins que le seuil. C’est l’une des raisons les plus directes du faible taux de succès du cache Gemini dans les scénarios de chat. À noter : atteindre le seuil est une condition nécessaire, mais ne garantit pas que la requête sera mise en cache.
Raison 2 : le contenu réutilisable ne se trouve pas au début de l’invite
Google recommande la même chose pour les deux plateformes : placer au début de l’invite les contenus longs qui seront réutilisés, puis envoyer dans un intervalle de temps assez court des requêtes ayant un préfixe similaire. Le cache repose sur un préfixe commun, et non sur le simple fait que « la requête contient le même document ».
Autrement dit, inclure le même document dans deux requêtes ne suffit pas à garantir que le cache sera utilisé. Sa position dans la requête compte, tout comme la stabilité du contenu qui le précède. Une structure comme celle-ci peut facilement briser le préfixe :
# Contre-exemple : le contenu variable est placé au début
[Heure actuelle : 2026-10-20 10:31:07]
[ID de requête : a8f3...]
{instructions système}
{long document}
{question de l’utilisateur}
Il suffit qu’un seul caractère au début soit différent pour que le long document ne forme plus de préfixe commun avec la requête précédente. Cette observation découle des recommandations officielles, mais ce problème est très courant en pratique.
Raison 3 : la couche proxy modifie le préfixe (sous certaines conditions)
Si la couche proxy insère au début de l’invite une heure, un identifiant ou un champ de suivi qui change d’une requête à l’autre, ou si elle réorganise, compresse ou tronque le contexte sur plusieurs tours, le préfixe commun est modifié et les chances d’utiliser le cache diminuent. Il s’agit d’une analyse conditionnelle : on ne peut pas en conclure directement qu’un service donné adopte ces comportements.
Lors du diagnostic, il faut distinguer deux niveaux : le préfixe de la requête que vous envoyez au service proxy est-il stable, et celui de la requête que le service transmet à Google l’est-il aussi ? Vous pouvez contrôler le premier vous-même ; pour le second, il faut consulter les journaux des requêtes en amont.
Raison 4 : les requêtes sont réparties entre plusieurs projets Vertex (sous certaines conditions)
Vertex indique explicitement que le cache est isolé par projet Google Cloud et n’est pas partagé entre les projets. Si plusieurs requêtes d’une même session sont distribuées à tour de rôle entre différents projets Vertex, le projet B ne peut pas utiliser le cache créé par le projet A.
Il faut toutefois rester prudent : savoir si « changer de clé » entraîne la perte du cache dépend du fait que le projet change lui aussi. On ne peut pas affirmer que chaque changement de clé fait perdre le cache sans vérifier au préalable à quel projet chaque clé est associée.
Raison 5 : seules les requêtes de génération sont relayées, sans recours au cache explicite
Si le circuit d’appel se contente de relayer les requêtes generateContent, sans créer d’objet de cache ni le référencer dans les requêtes suivantes, toute la chaîne dépend uniquement du cache implicite. Celui-ci n’offre aucune garantie de résultat : il ne permet pas de bénéficier de la stabilité du cache explicite, qui consiste à « créer une fois, puis réutiliser plusieurs fois ».
Le tableau ci-dessous met en regard ces différents scénarios de service proxy et les règles officielles correspondantes :
| Comportement observé | Impact possible | Règle officielle correspondante |
|---|---|---|
| Une même session est répartie entre plusieurs projets Vertex | Impossible de réutiliser le cache existant d’un autre projet | Le cache est isolé par projet |
| Une heure ou un identifiant variable est inséré au début, ou le contexte est réorganisé | Le préfixe commun est brisé, ce qui réduit les chances d’utiliser le cache | Placer les contenus longs au début et conserver un préfixe similaire |
| Les requêtes sont courtes et contiennent peu de contenu fixe réutilisable | Le seuil minimal de jetons n’est pas atteint | Seuil minimal de jetons |
| Seules les requêtes de génération sont relayées, sans création ni référence à un objet de cache explicite | La chaîne dépend uniquement du cache implicite, sans garantie de résultat | Le cache explicite doit être créé et référencé |
🎯 Conseil technique : pour diagnostiquer un problème de cache Gemini, vous pouvez commencer par envoyer plusieurs requêtes successives avec le même long préfixe fixe via APIYI (apiyi.com), puis comparer le champ des jetons mis en cache dans chaque réponse. Commencez par des requêtes contrôlées afin d’écarter les problèmes de préfixe et de seuil, puis vérifiez si le problème vient du circuit d’appel.
Sans les projets en amont ni les journaux des requêtes, le simple fait d’utiliser un service proxy ne permet pas de déterminer la cause. Rien ne permet non plus d’affirmer officiellement que le taux de succès du cache est nécessairement plus élevé sur Vertex que sur l’API Developer.
Comment se définit la facturation du cache dans AI Studio et Vertex
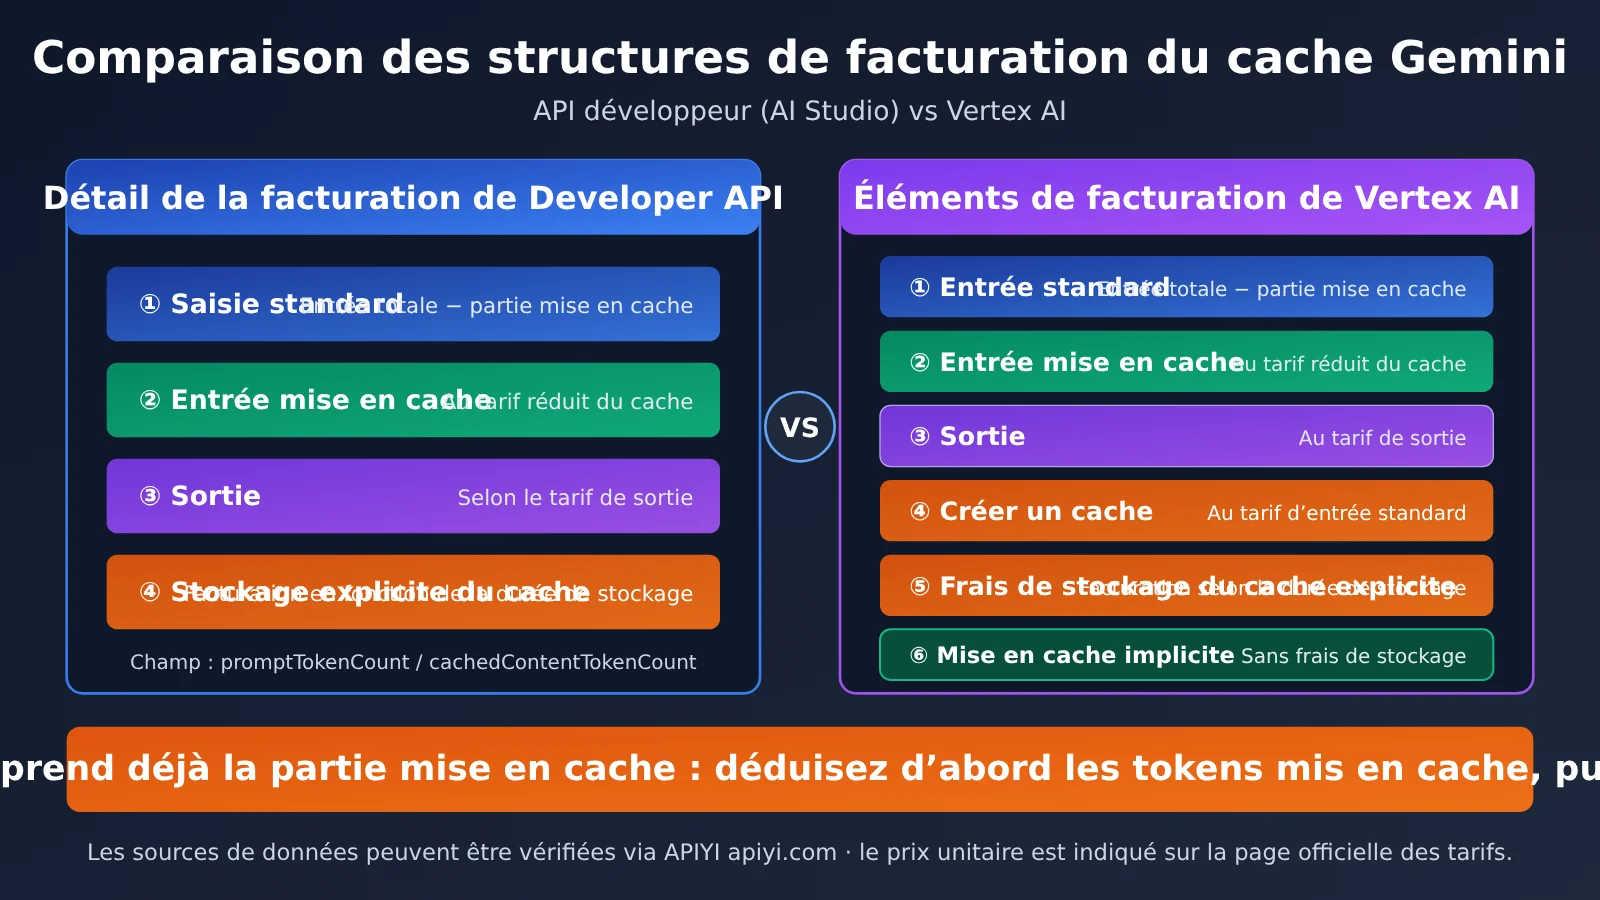
Beaucoup pensent qu’un « cache hit » signifie que la requête est gratuite ou que toute la requête bénéficie d’une remise uniforme. C’est faux. Dans les deux environnements, la facturation distingue quatre éléments : les entrées classiques, les entrées issues du cache, les sorties et les frais de stockage du cache explicite.
Comparaison des règles de facturation
| Élément facturé | Developer API (AI Studio) | Vertex AI |
|---|---|---|
| Entrées classiques (partie non mise en cache) | Au tarif unitaire des entrées classiques | Au tarif unitaire des entrées classiques |
| Entrées issues du cache (partie mise en cache) | Au tarif unitaire des entrées issues du cache, indiqué séparément sur la page des tarifs | Au tarif unitaire des entrées issues du cache, indiqué séparément sur la page des tarifs |
| Sorties | Facturées séparément | Facturées séparément |
| Entrées utilisées pour créer le cache | Comptabilisées dans les frais d’utilisation des tokens du cache | Facturées au tarif standard des entrées |
| Frais de stockage du cache implicite | Aucun | Aucun |
| Frais de stockage du cache explicite | Facturés selon la durée de stockage | Des frais de stockage s’appliquent |
La documentation de la Developer API indique que la facturation dépend de l’utilisation des tokens du cache, de la durée de stockage, des entrées non mises en cache et des sorties. Vertex précise en plus deux points : les entrées utilisées pour créer le cache sont facturées au tarif standard des entrées, et le cache implicite n’entraîne aucuns frais de stockage, contrairement au cache explicite. Pour les tarifs exacts, consultez les pages officielles en vigueur : ils varient selon le modèle et sa version.
Formule de calcul des frais d’entrée
Pour une requête classique de génération de texte, vous pouvez calculer les frais d’entrée comme suit :
输入费用 =
(总输入 tokens − 缓存命中 tokens)× 普通输入单价
+ 缓存命中 tokens × 缓存输入单价
Les frais de sortie sont calculés séparément. Si vous utilisez un cache explicite, ajoutez aussi les frais de stockage. Prenons un exemple hypothétique : une requête comporte 10 000 tokens en entrée, dont 8 000 proviennent du cache. Les 2 000 tokens restants sont facturés au tarif normal, et les 8 000 tokens mis en cache au tarif du cache.
Le point le plus facile à mal calculer : le total des entrées inclut la partie mise en cache
Pour vérifier votre facture, consultez la réponse brute de Google plutôt que de vous fier uniquement au « taux de cache hit » affiché dans l’interface du service proxy API. Dans usageMetadata de la réponse generateContent, deux champs sont essentiels :
| Champ | Signification | Point à vérifier |
|---|---|---|
usageMetadata.promptTokenCount |
Nombre total de tokens en entrée | Inclut la partie mise en cache |
usageMetadata.cachedContentTokenCount |
Nombre de tokens mis en cache | Quantité ayant bénéficié du cache |
Vous ne devez donc pas facturer promptTokenCount en totalité au tarif normal, puis ajouter les frais des entrées mises en cache : cela reviendrait à facturer deux fois une partie des tokens. Commencez par soustraire la partie mise en cache du total des entrées pour obtenir la quantité à facturer au tarif normal. Si vous utilisez la nouvelle Interactions API, le champ de statistiques de cache indiqué par Google est usage.total_cached_tokens.
Deux choses à ne pas confondre
Il faut distinguer deux éléments : la quantité réellement mise en cache en amont par Google et la manière dont le service proxy API répercute cette réduction sur votre facture. Le premier peut être mesuré à l’aide des champs officiels. Le second dépend des règles de facturation propres au service proxy API ; la documentation officielle de Google ne peut pas les confirmer à sa place. Pour vérifier vos comptes, comparez donc les champs de cache renvoyés par le service en amont avec le mode de calcul détaillé sur votre facture.
💡 Conseil : pour vérifier vos comptes, consultez d’abord les champs de tokens mis en cache au niveau de la requête, puis le récapitulatif de la facture. Pour comparer OpenAI, Claude et Gemini sur une même base, vous pouvez utiliser APIYI apiyi.com afin d’envoyer la même invite à chaque modèle et de passer rapidement de l’un à l’autre.
Différences de facturation du cache entre Gemini, Claude et OpenAI
Les trois fournisseurs abordent le cache différemment, et les règles à appliquer pour vérifier la facturation varient aussi. Le tableau ci-dessous compare les modes d’activation et de facturation. Les taux de réduction et les durées peuvent changer selon la version du modèle. Les indications ci-dessous correspondent aux pratiques générales au moment de la rédaction ; consultez les pages tarifaires officielles de chaque fournisseur pour les valeurs exactes.
| Élément de comparaison | Gemini | Claude | OpenAI |
|---|---|---|---|
| Mode d’activation | Cache implicite automatique + objets de cache explicite | Explicite : le paramètre cache_control de la requête permet de marquer un point de rupture du cache |
Automatique, sans modification du code |
| Frais d’écriture du cache | Aucun pour le cache implicite ; les entrées sont facturées lors de la création du cache explicite, avec des frais de stockage en plus | Oui : le tarif d’écriture est supérieur à celui des entrées classiques (tarif différent selon une durée de 5 minutes ou de 1 heure) | Pas de frais d’écriture distincts |
| Tarif de lecture du cache (cache hit) | Inférieur à celui des entrées classiques ; la réduction dépend du modèle | Environ un dixième du tarif normal des entrées | Inférieur à celui des entrées classiques ; la réduction dépend du modèle |
| Frais de stockage | Cache explicite uniquement, facturé selon la durée de stockage | Aucun : la durée de validité est définie au moment de l’écriture | Aucun |
| Seuil minimal | Variable selon le modèle et le canal ; sur Vertex, il peut être supérieur à celui de la Developer API | Variable selon le modèle ; souvent 1 024 tokens ou plus | Généralement à partir de 1 024 tokens |
| Garantie de cache hit | Non pour le cache implicite ; plus prévisible pour le cache explicite | Une fois le point de rupture marqué, le cache hit est généralement stable pendant la durée de validité | Correspondance automatique des préfixes, sans garantie |
| Champs d’utilisation | cachedContentTokenCount (inclus dans promptTokenCount) |
cache_creation_input_tokens, cache_read_input_tokens, indiqués séparément des tokens d’entrée classiques |
prompt_tokens_details.cached_tokens (inclus dans prompt_tokens) |
Trois points du tableau prêtent souvent à confusion :
- Frais d’écriture : Claude facture davantage l’écriture dans le cache, tandis que la lecture coûte moins cher. Écrire beaucoup et lire peu peut donc revenir plus cher que de ne pas utiliser le cache. OpenAI ne facture pas l’écriture : un cache miss n’engendre pas de frais supplémentaires. Le cache implicite de Gemini ne comporte pas non plus de frais d’écriture ; seuls le cache explicite et ses coûts de création et de stockage sont facturés.
- Qui décide de la mise en cache ? Avec Claude, c’est l’appelant qui marque explicitement le point de rupture, ce qui rend les cache hits plus prévisibles. Pour les caches implicites d’OpenAI et de Gemini, la décision revient à la plateforme. Les développeurs peuvent seulement améliorer les chances de correspondance en gardant un préfixe stable. Cela explique en partie pourquoi le cache semble plus fiable avec Claude et OpenAI qu’avec Gemini : chez Gemini, le seuil, le préfixe et l’isolation entre canaux entrent aussi en jeu.
- Calcul du total des entrées : chez Gemini et OpenAI, le total des entrées inclut la partie mise en cache ; il faut la soustraire avant le calcul. Chez Claude,
input_tokensn’inclut pas les lectures et écritures du cache : les trois éléments doivent être tarifés séparément, puis additionnés. Appliquer la formule d’un fournisseur à un autre fausse le calcul. Pour comparer les coûts de plusieurs modèles via APIYI apiyi.com, vérifiez d’abord la signification des champs renvoyés par chaque fournisseur.
Prise en main rapide du taux de cache de Gemini : lancer un test
Après la théorie, rien ne vaut un test concret. L’idée est de construire un préfixe fixe suffisamment long pour dépasser le seuil minimal, de placer la question variable à la fin, puis d’envoyer plusieurs requêtes à la suite pour observer l’évolution des champs de tokens mis en cache.
Exemple minimal
Le code ci-dessous utilise le format compatible avec OpenAI et affiche les informations d’utilisation renvoyées. Les noms des champs dépendent de la réponse réelle et peuvent varier selon le mode d’intégration :
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Utiliser l’interface unifiée d’APIYI
)

# Préfixe long et fixe : dépasser impérativement le seuil minimal de cache du modèle cible
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
Afficher le code complet de test et de vérification
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Utiliser l’interface unifiée d’APIYI
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """Tente de lire dans usage le nombre de tokens mis en cache ; le nom du champ dépend de la réponse réelle"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    Estime le coût des entrées selon la méthode officielle :
    le total des entrées inclut déjà la partie mise en cache ; la partie normale = total des entrées - partie mise en cache
    Saisissez les tarifs actuels indiqués sur la page officielle (par million de tokens)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 Pour commencer rapidement : nous vous recommandons d’utiliser APIYI apiyi.com pour mettre en place ce test comparatif. Il suffit de remplacer le paramètre
modeldans le même script pour tester successivement les modèles Gemini, OpenAI et Claude et comparer directement leur comportement en matière de cache.
Variables à contrôler pendant le test
Pendant le test, passez en revue cette liste pour éviter de confondre un problème lié à votre configuration avec un problème de chaîne de traitement :
| Point à vérifier | Méthode | Objectif |
|---|---|---|
| Longueur du préfixe | Vérifier qu’elle dépasse le seuil minimal actuel du modèle cible | Écarter un problème de seuil |
| Stabilité du préfixe | Ne pas placer d’horodatage ni d’identifiant de requête au début | Éviter de modifier le préfixe |
| Emplacement du contenu variable | Placer la question de l’utilisateur à la fin | Garantir un préfixe commun aussi long que possible |
| Intervalle entre les requêtes | Envoyer les requêtes à la suite, dans un délai court | Respecter les recommandations officielles |
| Groupe témoin | Tester le même invite avec OpenAI ou Claude | Déterminer si l’écart vient du modèle ou de la chaîne de traitement |
Comment interpréter les résultats
Si le préfixe est suffisamment long, que sa structure reste stable et que les requêtes sont rapprochées, mais que Gemini affiche toujours très peu de cache réutilisé, alors que le même invite fonctionne normalement avec OpenAI ou Claude, la différence vient probablement du mécanisme de cache propre à Gemini et des conditions de la chaîne en amont, et non de la façon dont vous avez rédigé l’invite. Vous pouvez alors envisager d’utiliser le cache explicite : fixez le contenu long à réutiliser, créez un objet de cache, puis référencez-le dans vos requêtes.
Si votre application repose surtout sur de courtes conversations, mieux vaut accepter que le cache de Gemini apporte peu dans ce type de scénario plutôt que de chercher à tout prix à augmenter le taux d’utilisation du cache. Concentrez plutôt vos efforts d’optimisation des coûts sur le choix du modèle et la longueur des réponses.
Questions fréquentes
Q1 : Pourquoi le taux d’utilisation du cache de Gemini est-il nettement inférieur à celui d’OpenAI et de Claude ?
Le cache implicite de Gemini dépend de plusieurs conditions : le modèle doit être compatible, le seuil minimal de tokens doit être atteint, le préfixe doit rester stable et les requêtes doivent être rapprochées dans le temps. Du côté de Vertex, le cache est également isolé par projet, et la documentation officielle précise qu’aucune utilisation du cache n’est garantie. Si l’une de ces conditions n’est pas remplie, la requête est facturée comme une entrée normale, sans avertissement. Pour déterminer la cause sur une chaîne donnée, il faut examiner les journaux de requêtes en amont.
Q2 : Google a-t-il indiqué officiellement que le recours à un service proxy réduit le taux d’utilisation du cache ?
Non. La documentation officielle indique seulement les conditions dont dépend le cache : un préfixe réutilisable, un seuil minimal de tokens et une portée déterminée. Si la chaîne de traitement modifie ces conditions, le taux d’utilisation du cache peut diminuer. Pour comparer le comportement de différents modèles, vous pouvez effectuer un test contrôlé avec le même invite via APIYI apiyi.com.
Q3 : Les tokens mis en cache sont-ils gratuits ?
Non. La partie mise en cache est facturée au tarif des entrées mises en cache. Ce tarif est inférieur à celui des entrées normales, mais il n’est pas nul. Les pages tarifaires des deux plateformes indiquent séparément les prix des entrées normales et des entrées mises en cache. Le cache explicite entraîne également des frais de stockage.
Q4 : Faut-il ajouter séparément les tokens mis en cache au nombre de tokens d’entrée indiqué sur la facture ?
Non. `promptTokenCount` correspond au total des entrées et inclut déjà la partie mise en cache. Soustrayez `cachedContentTokenCount` du total pour obtenir la partie facturée au tarif normal, puis calculez séparément le coût de la partie mise en cache.
Q5 : Les seuils de cache sont-ils les mêmes dans AI Studio et Vertex ?
Pas tout à fait. Selon la documentation actuelle, les seuils de Gemini 3.1 Pro Preview et Gemini 3.8 Flash sont de 4 096 tokens dans l’API Developer et de 6 144 dans Vertex. Pour l’ancienne génération Gemini 2.5 Pro, le seuil est de 2 048 tokens sur les deux plateformes. Ces seuils peuvent évoluer avec les versions des modèles ; référez-vous aux valeurs figurant dans la documentation officielle à jour.
Q6 : Le cache est-il perdu si je change de clé API ?
Cela dépend si vous changez de projet. Dans Vertex, le cache est isolé par projet Google Cloud et n’est pas partagé entre projets. Une clé associée à un autre projet entraînera donc la perte d’accès au cache. En revanche, on ne peut pas conclure automatiquement que le cache est perdu lorsque les clés diffèrent mais appartiennent au même projet.
Q7 : Dois-je utiliser le cache implicite ou le cache explicite ?
Si vous devez réutiliser régulièrement un contenu long et fixe — un long document ou de longues instructions système, par exemple — le cache explicite offre davantage de prévisibilité, mais implique des coûts de développement et des frais de stockage. Pour des réutilisations occasionnelles, le cache implicite ne demande aucun effort, mais ses bénéfices sont incertains. Vous pouvez commencer par effectuer un test comparatif à petite échelle via APIYI apiyi.com avant de décider si le développement d’un cache explicite en vaut la peine.
Q8 : Puis-je utiliser directement le taux d’utilisation du cache affiché dans le tableau de bord du service proxy pour vérifier ma facture ?
Ce n’est pas recommandé. Fiez-vous aux champs de cache de la réponse brute officielle. Par ailleurs, le nombre de tokens réellement mis en cache en amont par Google et la façon dont le service proxy les facture sont deux choses différentes. Pour vérifier la facture, vous devez consulter les règles de facturation propres au service proxy.
Points clés sur le taux de cache hit
- Le constat est établi : le cache fonctionne de manière stable avec OpenAI et la série Claude. Avec Gemini, le taux de cache hit est faible, voire proche de zéro ; il faut donc analyser ce cas séparément.
- Aucune garantie officielle de cache hit : le cache implicite de Gemini ne garantit pas de réduction des coûts. Pour utiliser le cache explicite, il faut créer un objet de cache et le référencer.
- Le seuil varie selon le modèle : les modèles de nouvelle génération ont des seuils plus élevés. Les valeurs peuvent aussi différer entre Vertex et l’API Developer.
- Le préfixe détermine le cache hit : placez les contenus longs au début et évitez d’y insérer des éléments variables, comme une date ou un identifiant, car ils brisent le préfixe commun.
- Vertex isole les caches par projet : un cache n’est pas partagé entre plusieurs projets. Répartir les requêtes entre différents projets peut donc entraîner une perte de cache.
- Le total des entrées inclut le cache :
promptTokenCountinclut la partie mise en cache. Pour vérifier la facturation, il faut d’abord la déduire, puis calculer le coût de chaque partie séparément. - Vérifiez les champs de réponse : fiez-vous aux champs de cache de la réponse officielle et comparez plusieurs modèles avec la même invite via APIYI (apiyi.com).
Résumé
Le faible taux de cache hit de Gemini s’explique par plusieurs facteurs combinés : le cache implicite ne garantit pas de cache hit, le nombre minimal de tokens requis augmente selon le modèle, le préfixe doit rester stable, le cache Vertex est isolé par projet et le cache explicite doit être créé manuellement. Si les derniers éléments sont modifiés au niveau du flux de requêtes, le taux de cache hit peut baisser. Pour en déterminer la cause précise, il faut toutefois examiner les projets en amont et l’historique des requêtes.
Pour la facturation, retenez trois points : un cache hit n’est pas gratuit ; le total des entrées comprend la partie mise en cache, qui ne doit donc pas être facturée deux fois ; enfin, le cache explicite entraîne des frais de stockage, contrairement au cache implicite. Pour vérifier les comptes, fiez-vous aux champs de la réponse officielle et contrôlez séparément la méthode de facturation du service proxy API.
Pour la suite, utilisez le script de test de cet article avec un long préfixe fixe afin de comparer Gemini à OpenAI et Claude, puis décidez si le cache explicite est pertinent. APIYI (apiyi.com) permet de vérifier rapidement les résultats : plusieurs modèles utilisent la même interface, ce qui facilite la comparaison des coûts.
Références
- Documentation sur la mise en cache de l’API Gemini : explications officielles sur la mise en cache implicite et explicite
- Lien :
ai.google.dev/gemini-api/docs/caching -
Remarque : présente les seuils minimaux de tokens et les facteurs de facturation
-
Page des tarifs de l’API Gemini : tarifs des entrées standard, des entrées mises en cache, des sorties et du stockage
- Lien :
ai.google.dev/gemini-api/docs/pricing -
Remarque : permet de vérifier les tarifs unitaires en vigueur
-
Présentation de la mise en cache du contexte dans Vertex AI : isolation des projets et règles de facturation du cache
- Lien :
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
Remarque : précise que le cache Vertex n’est pas partagé entre les projets
-
Référence de la méthode generateContent de l’API Gemini : champ
usageMetadatadans la réponse - Lien :
ai.google.dev/api/generate-content - Remarque : indique les champs de tokens mis en cache à consulter pour vérifier la facturation
Auteur : équipe APIYI
Échanges techniques : n’hésitez pas à partager dans les commentaires vos conseils pour diagnostiquer les problèmes liés au cache Gemini. Pour en savoir plus, consultez le centre de documentation APIYI sur docs.apiyi.com.