Note de l’auteur : à partir d’un retour sur l’expérience où Astra a modifié les poids de Qwen3.5-0.8B, cet article explique la différence entre « répondre faux » et « ne pas terminer sa réponse » lors de l’évaluation d’un modèle de raisonnement, ainsi qu’une méthode pour analyser les résultats selon qu’ils ont été tronqués ou non.
Le 2 novembre, quatre chercheurs du MIT CSAIL ont publié un billet intitulé « Les étincelles de la programmation dans l’espace des poids ». Ils y indiquent que GPT-6 Astra n’a modifié qu’environ 0,016 % des paramètres de Qwen3.5-0.8B, mais que son score sur MATH-500 est passé de 7,9 % à 48,1 %. Les résultats sur GSM8K et IFEval ont également fortement progressé. L’annonce a rapidement été relayée comme un événement marquant : une IA aurait modifié le « cerveau » d’une autre IA.
Il ne s’agit pas de remettre en cause cette recherche. Le dépôt public contient les journaux détaillés de 1 125 appels. En reprenant les résultats question par question, une analyse publiée dans les médias est arrivée à une conclusion plus modeste : la hausse des scores vient presque entièrement du fait que « le modèle arrive enfin à terminer ses réponses », et non du fait qu’« il est devenu meilleur en maths ».
L’intérêt principal : cet article ne revient pas sur la question de savoir si la RSI est avérée. Nous tirons plutôt de cette analyse une méthode réutilisable pour évaluer les modèles de raisonnement. Elle vous aidera, lors du choix, du réglage ou avant la mise en production d’un modèle, à déterminer si une variation de score reflète une différence de capacité ou des réponses tronquées à cause de boucles de répétition.
L’essentiel de l’évaluation du modèle de raisonnement
Commençons par les faits clés liés à l’évaluation. Les données ci-dessous proviennent du billet de blog original et des analyses du dépôt public publiées dans les médias.
| Élément | Détails |
|---|---|
| Date de publication | 2 novembre 2026, sur le blog de chercheurs du MIT CSAIL |
| Modèle modifié | Qwen3.5-0.8B, avec 131 072 poids modifiés, soit environ 0,016 % |
| Résultats annoncés | MATH-500 : 7,9 % → 48,1 % ; GSM8K : 13,8 % → 67,1 % ; IFEval : 21,0 % → 62,3 % |
| Paramètres d’évaluation | Mode réflexion activé, limite de sortie de 32 768 tokens, température de 0,6 |
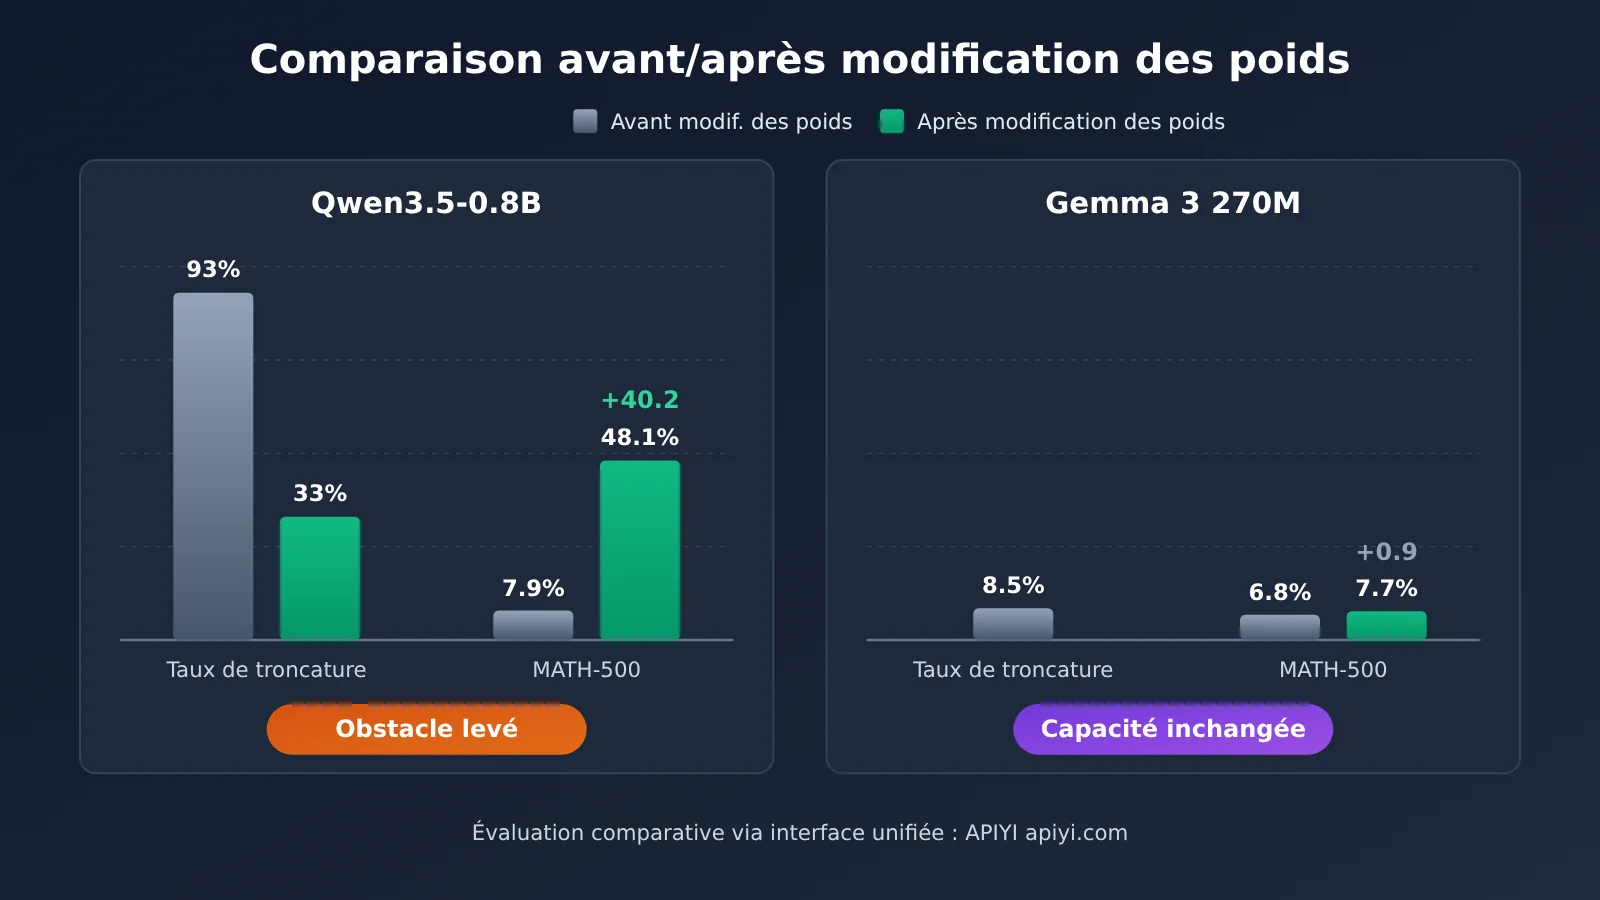
| Résultat initial | Environ 93 % des réponses atteignaient la limite sans s’arrêter |
| Après modification | La proportion de réponses atteignant la limite est passée de 93 % à 33 % |
| Conclusion de l’analyse | Le correctif a surtout éliminé des boucles de répétition, sans améliorer les capacités en mathématiques |
D’où vient la « troncature » dans l’évaluation des modèles de raisonnement ?
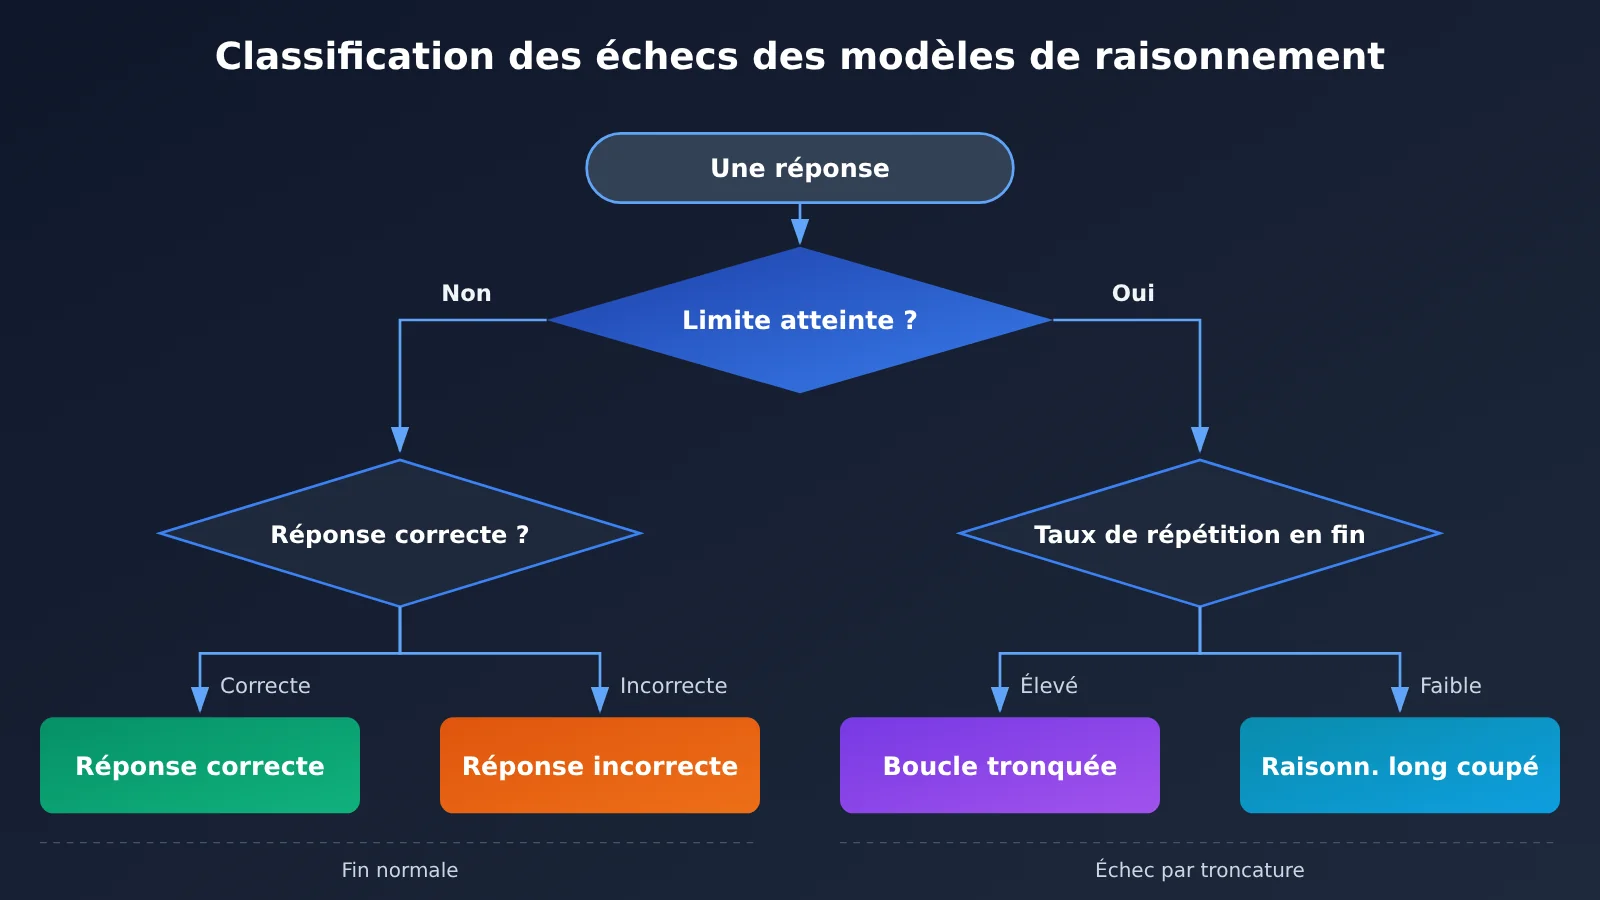
Lors du premier test d’Astra, Qwen a répondu correctement à seulement 11 des 96 exercices. Les 85 autres réponses n’étaient pas fausses : elles avaient toutes atteint la limite de longueur sans s’arrêter. Une analyse de leur fin, par segments de huit mots, a montré qu’environ 95 % du contenu était répétitif. Les 11 réponses qui s’étaient terminées normalement étaient toutes correctes.
Cela indique que le faible score initial tenait surtout au fait que le modèle ne parvenait pas à rendre sa réponse, et non qu’il ne savait pas résoudre les problèmes. À noter que, dans la première invite adressée à Astra, les chercheurs avaient déjà cité la « troncature à la limite de tokens, souvent due à des répétitions pendant le raisonnement » parmi les types d’échec. Ils donnaient aussi comme exemple d’amélioration efficace le fait de « corriger ce qui provoque les répétitions ». Le rapport final d’Astra précisait lui aussi que l’intervention visait les répétitions, et non les connaissances mathématiques.
Analyse des résultats d’évaluation : toute la progression vient des réponses tronquées
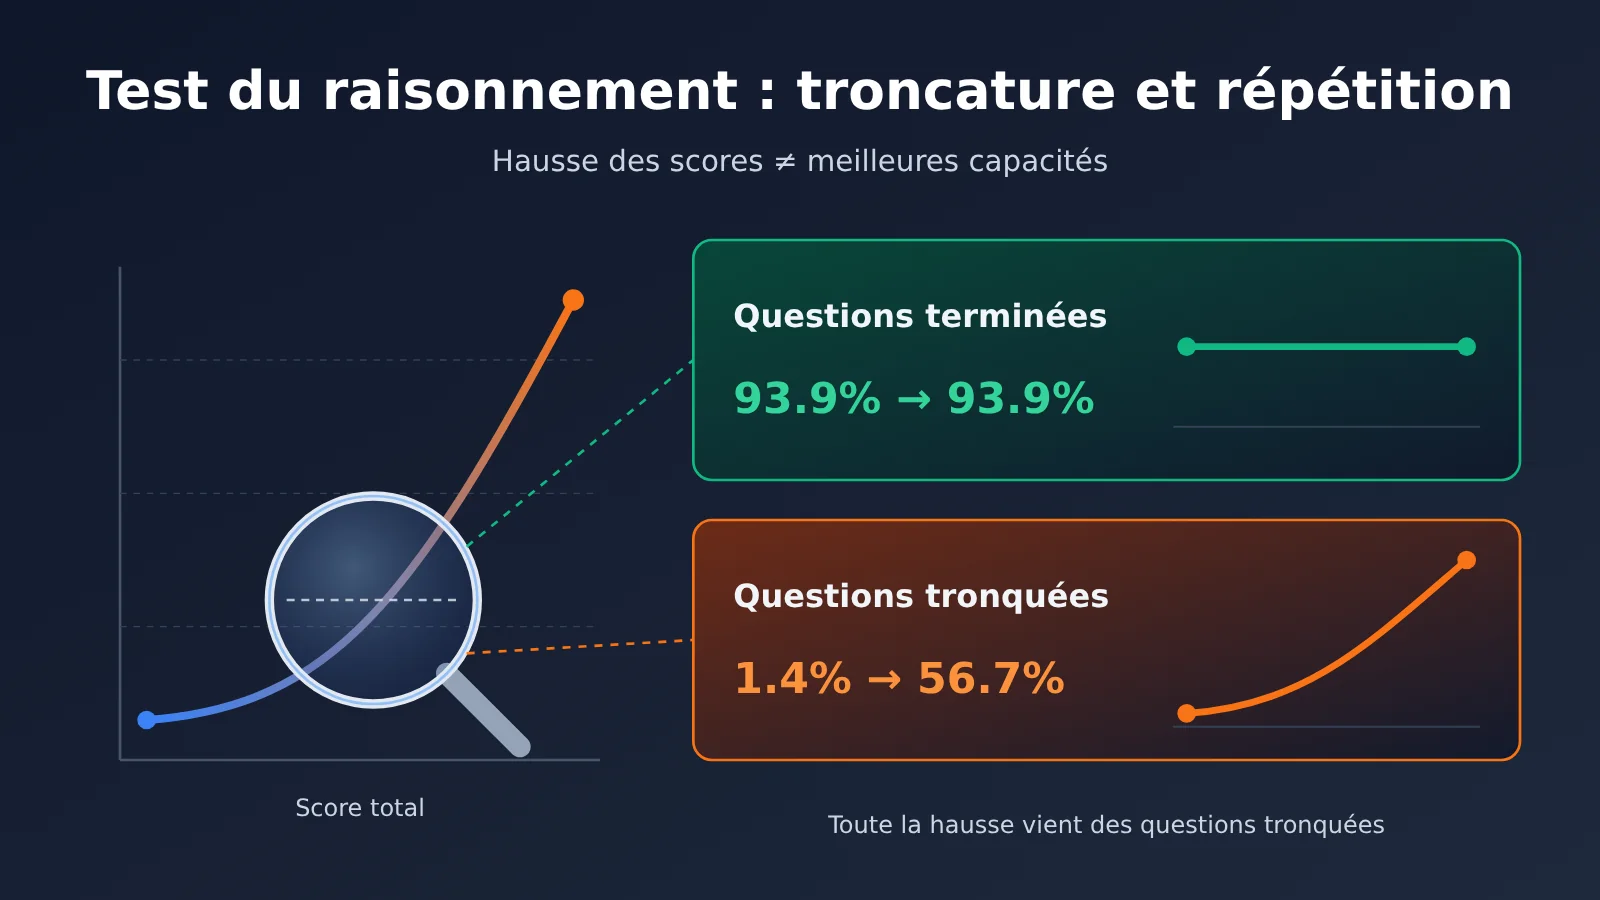
L’élément le plus convaincant de cette analyse est un test apparié avant et après modification, réalisé sur 1 152 exercices mis de côté. Il suffit de les répartir selon que leur réponse avait été tronquée ou non au départ pour voir apparaître une conclusion claire.
| Groupe d’exercices | Nombre | Taux de réussite avant modification | Taux de réussite après modification | Évolution |
|---|---|---|---|---|
| Réponse initialement terminée | 114 | 93,9 % | 93,9 % | Aucun changement |
| Réponse initialement tronquée | 1 038 | 1,4 % | 56,7 % | Source de toute la progression |
| Réponse passée d’incorrecte à correcte | 579 | — | — | Dont 576 initialement tronquées |
| Réponse passée de correcte à incorrecte | 5 | — | — | De l’ordre du bruit statistique |
Un autre détail passe facilement inaperçu : avant la modification, seules 7 réponses étaient terminées mais incorrectes. Après la modification, ce nombre est passé à 245. Une fois les boucles répétitives arrêtées, les véritables erreurs de calcul du modèle sont devenues visibles. Sur le benchmark officiel MATH-500, la longueur moyenne des réponses est passée de 30 868 à 22 037 tokens. Cette baisse concernait elle aussi surtout les réponses qui atteignaient auparavant la limite.
Vérifier les conclusions avec un modèle de comparaison
Les chercheurs en étaient conscients : ils ont donc mené la même expérience sur Gemma 3 270M. La comparaison des deux expériences montre bien qu’« enlever un obstacle » et « accroître les capacités » sont deux choses différentes.
| Critère | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| Proportion de réponses atteignant la limite | Environ 93 % | Environ 8,5 % |
| Principaux types d’échec | Boucles répétitives, réponse inachevée | Erreurs arithmétiques, étapes de raisonnement invalides |
| Résultat sur MATH-500 après modification des poids | 7,9 %→48,1 % | 6,8 %→7,7 % au maximum |
| Nature de l’amélioration | Supprime un obstacle qui masquait les capacités du modèle | Ne permet presque pas d’ajouter des capacités absentes au départ |
Le billet de blog original le reconnaît aussi : modifier les poids peut supprimer un obstacle qui masque les capacités du modèle, mais ne peut pas lui donner des capacités qu’il n’a pas. Pour les personnes qui évaluent les modèles, cela signifie qu’une même « forte hausse du score » peut avoir un sens complètement différent selon la nature des échecs.
Les pièges des paramètres dans l’évaluation des modèles de raisonnement : température et mode réflexion
Un élément important est souvent passé sous silence dans cette controverse : la configuration de l’évaluation peut elle-même favoriser les boucles. Les informations de la fiche officielle du modèle Qwen3.5-0.8B, citées dans l’analyse a posteriori, diffèrent des paramètres utilisés par les chercheurs.
| Paramètre | Indications de la fiche du modèle | Configuration de l’évaluation | Effet |
|---|---|---|---|
| Mode réflexion | Désactivé par défaut pour le modèle 0.8B | Activation forcée | Le petit modèle risque davantage de rester bloqué dans une boucle de réflexion |
| Température (tâches textuelles en mode réflexion) | Valeur recommandée : 1.0 | 0.6 | Dans la fiche du modèle, 0.6 correspond aux tâches d’analyse d’images et de programmation |
| Recommandations pour gérer les boucles | Ajuster les paramètres d’échantillonnage et interrompre rapidement la sortie en streaming | Génération jusqu’à la limite de 32 768 tokens | De nombreuses réponses ont été considérées comme des échecs |
Précisons que ces informations proviennent d’une analyse publiée dans les médias : avant toute évaluation, mieux vaut consulter directement la fiche officielle de Qwen. L’essentiel est la méthode : pour un même modèle, une autre série de paramètres d’échantillonnage peut donner une « référence de base » complètement différente. Si cette référence a été mesurée dans des conditions favorisant les boucles, toute modification qui permet au modèle de « s’arrêter » peut donner l’impression d’un bond de ses capacités.
Liste de vérification pour évaluer un modèle de raisonnement : isoler les réponses tronquées avant de conclure
Les leçons de cette analyse permettent de construire une méthode d’évaluation applicable à tout modèle de raisonnement. Que vous choisissiez un modèle, ajustiez ses paramètres ou testiez une modification du fine-tuning ou des invites, vous pouvez vérifier chaque point du tableau.
| Point à vérifier | Méthode | Signal à interpréter |
|---|---|---|
| 1. Séparer les réponses tronquées | Calculer la proportion de finish_reason == "length", puis le taux de réponses correctes par groupe |
Si le taux de troncature dépasse 10 %, les scores globaux ne sont pas directement comparables |
| 2. Vérifier le taux de répétition | Calculer les répétitions de n-grammes en fin de réponse pour les réponses tronquées | Un taux élevé indique une boucle plutôt qu’un raisonnement trop long |
| 3. Vérifier les paramètres d’échantillonnage | Comparer la température, top_p et l’activation du raisonnement aux indications de la fiche du modèle | Signaler séparément tout écart par rapport aux recommandations officielles |
| 4. Comparer les résultats par paire | Comparer chaque question avant et après la modification, et compter les réponses passées de fausses à correctes et inversement | Si le gain se concentre dans le groupe tronqué, il s’agit d’une « levée d’obstacle » |
| 5. Comparer avec un modèle témoin | Ajouter un modèle témoin à faible taux de troncature, avec les mêmes invites et paramètres | Si le modèle témoin ne progresse pas, l’amélioration ne correspond pas à un gain de capacité |
🎯 Conseil d’évaluation : pour comparer plusieurs modèles, le plus fastidieux est d’écrire un code d’appel propre à chacun. Avec l’interface compatible OpenAI d’APIYI, apiyi.com, vous pouvez utiliser le même script, les mêmes invites et les mêmes paramètres pour appeler plusieurs modèles courants et inclure systématiquement le « taux de troncature » comme colonne de statistiques.
Script d’évaluation des modèles de raisonnement : exemple minimaliste
Le code ci-dessous calcule la proportion de questions dont la réponse a été tronquée par la limite de longueur. Lorsque finish_reason vaut length, la limite max_tokens a été atteinte :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d’APIYI
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # Remplacer par le nom réel du modèle
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
Voir le code complet (avec taux de réponses correctes par groupe et taux de répétition en fin de texte)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """Calcule la proportion de n-grammes répétés en fin de texte (pour le chinois, on peut découper par caractère)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: fonction qui vérifie si la réponse est correcte"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
Attention : les paramètres d’activation ou de désactivation du mode de raisonnement varient selon les modèles. Certains utilisent un champ de la requête, d’autres se distinguent par leur nom, et d’autres encore passent par le modèle d’invite. Selon le modèle, le contenu du raisonnement peut ou non être comptabilisé dans max_tokens et renvoyé séparément. Consultez la documentation de chaque modèle avant de lancer l’évaluation.
🚀 Pour commencer rapidement : si vous souhaitez simplement vérifier cette méthode de répartition, inscrivez-vous sur APIYI apiyi.com et utilisez le crédit de test gratuit. Faites tourner deux ou trois modèles de raisonnement sur quelques dizaines de questions, comparez leurs taux de troncature, puis décidez si vous souhaitez élargir l’évaluation.
Analyse des conséquences de l’incident d’évaluation du modèle de raisonnement
Pour les développeurs
- Le score global ne suffit plus : se limiter au taux global de réponses correctes revient à confondre les réponses inachevées avec les réponses incorrectes. Avant la mise en production, le rapport d’évaluation devrait au minimum inclure le taux de troncature et le taux de réponses correctes par groupe.
- Les gains liés aux réglages peuvent être mal interprétés : augmenter la limite de sortie, ajuster la température ou ajouter une pénalité de répétition peut nettement améliorer le score. Mais cela revient à « lever un obstacle » : le modèle lui-même n’a pas changé.
- La production est également concernée : en ligne, les troncatures observées lors de l’évaluation peuvent se traduire par des réponses trop longues, des coûts incontrôlés et une attente accrue pour les utilisateurs. La fiche du modèle recommande elle-même de combiner la sortie en continu avec une détection des boucles et une interruption anticipée.
Pour la recherche sur l’évaluation des modèles
- Une « amélioration majeure » doit être étayée par une analyse détaillée : ce retour sur l’incident montre qu’un résultat apparemment lié à un bond des capacités peut, une fois les troncatures prises en compte, se résumer à la correction d’un bug. À l’avenir, toute annonce d’amélioration concernant un petit modèle ou un modèle de raisonnement mérite qu’on examine aussi l’évolution du taux de troncature.
- La conception des groupes témoins devient plus importante : les expériences complémentaires sur Gemma 3 270M et le test témoin à direction aléatoire réalisé par Astra elle-même, où le score n’a varié que d’environ 1,5 point de pourcentage, montrent tous deux que les tests témoins sont essentiels pour distinguer un véritable signal du bruit.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que le « piège de la troncature » dans l’évaluation des modèles de raisonnement ?
C’est le cas d’un modèle qui tourne en boucle pendant son raisonnement et continue à générer du texte jusqu’à atteindre la limite de tokens, sans fournir de réponse. Le système d’évaluation considère alors sa réponse comme incorrecte. Le score faible reflète le fait que le modèle n’a pas terminé, et non qu’il est incapable de résoudre le problème.
Q2 : Comment distinguer un score faible dû à la troncature d’un score faible dû à un manque de capacité ?
Répartissez les questions en deux groupes selon que la limite de tokens a été atteinte ou non, puis calculez le taux de réponses correctes pour chaque groupe. Si les réponses terminées sont largement correctes et que le groupe tronqué obtient un score proche de zéro, le problème vient de la boucle. Si les réponses terminées contiennent elles-mêmes beaucoup d’erreurs, cela indique plutôt un manque de capacité. La comparaison entre Qwen et Gemma illustre ces deux cas.
Q3 : Quand l’expérience d’Astra sur la modification de Qwen a-t-elle été publiée ?
L’article de blog original a été publié le 2 novembre 2026. L’article de presse qui analyse l’expérience à partir des journaux du dépôt public a été publié le 5 novembre. Les données de cet article s’appuient sur cette analyse ; pour les détails de la carte du modèle, il est conseillé de consulter le document officiel de Qwen.
Q4 : Dans quels cas cette méthode d’évaluation est-elle utile ?
– **Choix du modèle** : comparer les performances de différents modèles de raisonnement sur des tâches de mathématiques ou de programmation
– **Ajustement des paramètres** : évaluer l’effet réel des changements de température, de limite de tokens ou d’activation du raisonnement
– **Vérification des améliorations** : déterminer si un ajustement fin, une modification des invites ou une édition des poids améliore les capacités du modèle ou élimine simplement un obstacle
Q5 : Comment comparer plusieurs modèles de raisonnement à l’aide d’une interface unifiée ?
1. Créez un compte sur APIYI apiyi.com et obtenez une clé API
2. Définissez le paramètre base_url du script de cet article sur `https://api.apiyi.com/v1`
3. Gardez les mêmes invites, température et valeur de max_tokens, changez uniquement le nom du modèle, puis affichez le taux de troncature et le taux de réponses correctes par groupe
La façon d’activer le raisonnement varie selon les modèles. Adaptez les paramètres de la requête en suivant la documentation de chacun.
Q6 : Quelles sont les limites de cette méthode de répartition ?
La répartition selon la troncature permet seulement de repérer les réponses inachevées : elle ne permet pas de savoir si une réponse terminée est correcte par chance. Le seuil de répétition en fin de réponse doit être adapté à la langue et à la tâche ; pour le chinois, il est recommandé de découper le texte par caractère plutôt que par espace. De plus, certains modèles ne renvoient pas l’intégralité de leur raisonnement : il faut alors tenir compte des statistiques de tokens dans usage. Si votre budget est limité, vous pouvez commencer par un essai sur un petit échantillon avec APIYI apiyi.com, puis élargir l’évaluation une fois les critères de calcul confirmés.
Points clés pour évaluer les modèles de raisonnement
- Origine du gain : sur les 114 questions auxquelles Qwen a répondu jusqu’au bout, le score reste à 93,9 % avant comme après la modification. Toute la hausse vient des réponses tronquées.
- Type d’échec : dans la configuration de référence, 93 % des réponses atteignent la limite de tokens, et environ 95 % de leur fin se compose de répétitions.
- Différence de paramètres : la température de 0,6 utilisée pour l’évaluation ne correspond pas à celle de 1,0 recommandée dans la fiche du modèle pour le texte de raisonnement.
- Résultat du modèle témoin : Gemma 3 270M présente un faible taux de troncature et, après modification de ses poids, son score sur MATH-500 progresse de moins d’un point de pourcentage.
- Principe de la méthode : isoler d’abord les réponses tronquées à l’aide de
finish_reason, puis comparer les taux de réussite. - Pour commencer : utiliser l’interface unifiée d’APIYI apiyi.com pour mesurer le taux de troncature de plusieurs modèles avec les mêmes paramètres.
Conclusion
La controverse autour de la modification des poids de Qwen par Astra rappelle quelques précautions à toute personne qui évalue des modèles de raisonnement :
- Décomposer les hausses spectaculaires : regrouper les réponses selon qu’elles ont atteint ou non la limite de tokens, puis identifier d’où vient le gain.
- Les paramètres font partie de la référence : vérifier la température, l’activation du raisonnement et la limite de sortie par rapport à la fiche du modèle, puis les consigner dans le rapport.
- Distinguer la levée d’un obstacle d’un gain de capacité : utiliser un modèle témoin à faible taux de troncature pour vérifier la nature réelle de l’amélioration.
La prochaine fois que vous lirez qu’une modification a multiplié un score, posez-vous d’abord cette question : de combien le taux de troncature a-t-il changé ? Elle en dit souvent plus que le score global.
Si vous préparez une évaluation de plusieurs modèles de raisonnement avant leur mise en production, vous pouvez utiliser APIYI apiyi.com pour mesurer leurs taux de troncature avec les mêmes scripts et paramètres, puis orienter votre choix.
📚 Références
- Analyse de Silicon Star Pro (republiée par 36Kr) : L’histoire virale d’« Astra qui reprogramme le cerveau de Qwen » n’a pas grand-chose à voir avec le RSI que nous recherchons
- Lien :
36kr.com/p/4056494372181124 -
À propos : données de tests appariés recalculées à partir des résultats de chaque question dans le dépôt public ; principale source de données de cet article
-
Blog du chercheur au MIT CSAIL : Sparks of Weight-Space Programming
-
À propos : description originale de l’expérience et tableaux de résultats ; nous vous conseillons de consulter le texte original pour les paramètres de l’expérience 8
-
Fiche officielle du modèle Qwen3.5-0.8B : paramètres d’échantillonnage et explications sur le mode de réflexion
- À propos : pour vérifier l’état par défaut du mode de réflexion, la température recommandée et les conseils pour gérer les boucles
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous sur le site officiel d’APIYI, apiyi.com. Pour plus de détails sur l’invocation du modèle, consultez le centre de documentation docs.apiyi.com.