Note de l’auteur : GPT-6.2 Sol reprend le tarif Standard de la génération précédente, tout en améliorant ses résultats sur plusieurs tests publics ou en réduisant le coût par tâche. Avant de mettre à jour un système existant, il reste indispensable de vérifier séparément les questions-réponses sur base de code, l’analyse complexe et les conversations multi-tours.
Commençons par la conclusion : le prix Standard en contexte court de GPT-6.2 Sol est exactement le même que celui de GPT-6.1 Sol ; il obtient de meilleurs scores dans les évaluations globales et un coût par tâche plus faible, mais il perd clairement des points sur les questions-réponses autour d’une base de code et sur quelques problèmes difficiles. Pour les deux modèles, le prix par million de tokens est identique : entrée normale $2, lecture de cache $0.10, sortie $10. Le score global d’Artificial Analysis dans le palier Max passe de 55 à 57, et le coût moyen par tâche de $1.27 à $1.01. Mais dans le test d’agent de code de la même organisation, la sous-épreuve « questions-réponses sur base de code » chute de 60 à 46, et le test d’analyse de données Plotly passe d’un 43/43 parfait à 40/43.
Cette montée de version est donc à déployer progressivement, en fonction du type de tâche ; mieux vaut éviter un remplacement global d’un seul coup. Les modifications de code vérifiables, les opérations dans le terminal et l’analyse courante peuvent être testées en priorité. En revanche, les questions-réponses sur base de code, les problèmes difficiles du type « règle cachée » et le traitement par lots qui dépend de Flex demandent d’abord des tests de régression. Par ailleurs, la Responses API de GPT-6.2 change de comportement sur les conversations multi-tours et sur la position des instructions : une application multi-tours existante ne peut pas se contenter de changer l’identifiant du modèle.
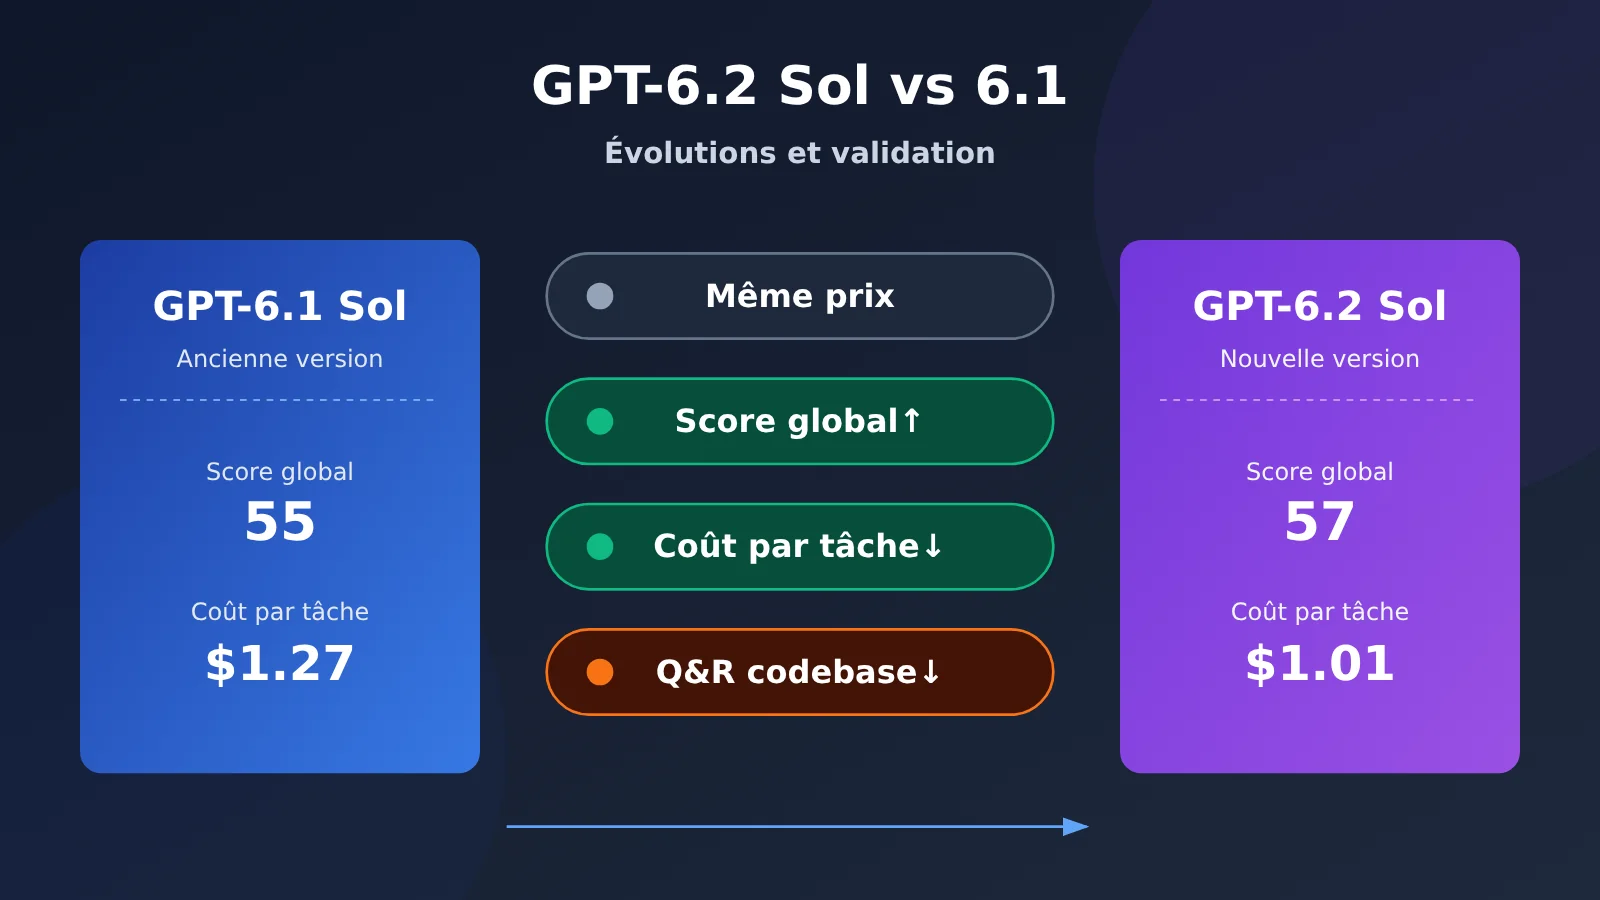
Aperçu comparatif : GPT-6.2 Sol vs GPT-6.1 Sol
Le tableau ci-dessous ne présente que les dimensions utiles pour décider d’une mise à niveau. Les spécifications et les prix proviennent de la fiche modèle officielle, de la page de tarification et du journal des modifications d’OpenAI ; tous les prix sont en USD / million de tokens.
| Dimension | GPT-6.1 Sol | GPT-6.2 Sol | Ce que cela change |
|---|---|---|---|
| ID du modèle / date de lancement | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
Modèle tout juste lancé : prévoir une période d’observation |
| Contexte / sortie maximale | 1,050,000 / 128,000 | 1,050,000 / 128,000 | Capacité inchangée |
| Entrée maximale | Non détaillée séparément dans la fiche modèle | 922,000 | Pour les tâches à entrée très longue, vérifier la nouvelle limite |
| Date de coupure des connaissances | 2026-04-30 | 2026-06-01 | Repoussée d’environ un mois |
| Tarif Standard en contexte court | Entrée $2 / lecture du cache $0.10 / sortie $10 | Identiques | À combinaison de tokens identique, facture identique |
| Traitement Flex | Pris en charge | Non pris en charge | Les utilisateurs de l’ancienne version de Flex doivent passer à un autre mode de traitement |
| Fenêtre de réduction pour traitement en arrière-plan | Non abordée dans les sources de cette comparaison | Fenêtre de 2 h : -30 % ; fenêtre de 8 h : -40 % | Les tâches qui tolèrent la latence ont une nouvelle option d’économie |
| Score global (AA, Max) | 55 | 57 | Un peu meilleur globalement |
| Questions-réponses sur base de code (AA, Codex + Max) | 60 | 46 | Net recul : une validation dédiée est nécessaire |
🚀 Comparaison rapide : les deux générations peuvent être comparées en basculant sur la même interface API. Le tableau public des modèles d’APIYI apiyi.com inclut déjà
gpt-6.2-solet indique les deux points d’entrée responses et chat, pratique pour lancer une comparaison de régression entre ancienne et nouvelle version avec la même clé API.
Ordre de lecture conseillé : dans la section 1 de l’article, commencez par vérifier les prix et les options de traitement, car cela détermine la base de facturation. La section 2 compare les progrès et les régressions dans les tests publics, pour déterminer quelles tâches justifient une mise à niveau. La section 3 examine les changements de comportement de l’API et si les services existants peuvent basculer en douceur. La section 4 propose un plan de validation par type de tâche. Si vous ne vous intéressez qu’aux agents de codage, allez directement aux sections 2.2 et 4.
Termes à connaître avant de comparer GPT-6.2 Sol
| Terme | Explication concise |
|---|---|
| Tarif Standard par token | Tarification publique d’OpenAI, palier Standard, pour chaque million de tokens d’entrée, de sortie et de lecture de cache, selon les volumes de cache |
| Coût d’une tâche | Coûts de modèle et d’outils générés par la réalisation d’une tâche ; lors de la validation métier, on peut aussi ajouter les relances et la revue humaine |
| Niveau de raisonnement | Réglage qui contrôle le budget de raisonnement du modèle ; valeurs courantes : Low, Medium, High, Xhigh, Max ; les tests comparatifs doivent aligner le niveau |
| GDPval v2 | Évaluation interne d’OpenAI sur le travail de connaissance complexe, centrée sur des livrables de bout en bout issus de types de projets réels |
| Coding Agent Index | Indicateur composite d’agent calculé par Artificial Analysis à partir de sous-indicateurs comme la modification de code, les opérations dans le terminal et les questions-réponses sur base de code |
| SWE-Atlas-QnA-AA | Sous-indicateur de questions-réponses sur base de code dans l’indicateur ci-dessus, qui vérifie si les faits nécessaires à la réponse sont tous réunis |
| Préfixe de conversation / lecture du cache | Contenu identique et dans le même ordre au début de requêtes multi-tours ; une fois que le service identifie un préfixe réutilisable, la partie correspondante est facturée au tarif de lecture du cache |
1. GPT-6.2 Sol face à GPT-6.1 Sol : spécifications de base et tarifs
1.1 Les spécifications du GPT-6.2 Sol prolongent largement celles de la génération précédente
Les deux générations de modèles sont accessibles via Responses et Chat Completions ; les appels de fonctions et les outils intégrés passent par le chemin Responses. Toutes deux acceptent du texte et des images en entrée, produisent nativement du texte, disposent d’une fenêtre de contexte de 1 050 000 tokens et d’une sortie maximale de 128 000 tokens. La fiche modèle du 6.2 Sol mentionne séparément une entrée maximale de 922 000 tokens.
Le positionnement présente de légères différences. La page modèle du 6.1 Sol met l’accent sur l’exécution de code complexe, les opérations informatiques et les tâches professionnelles à un coût inférieur à Astra ; celle du 6.2 Sol privilégie le code du quotidien et le travail d’agent à grande échelle. Autrement dit, le 6.2 Sol cible plus clairement les scénarios à haute fréquence et en volume.
1.2 Les tarifs Standard du GPT-6.2 Sol sont identiques à ceux de la génération précédente
La facturation Standard officielle est la suivante. Pour les deux générations, la limite est fixée à 272K tokens d’entrée par requête : au-delà, les tarifs d’entrée et de lecture du cache de toute la requête sont multipliés par 2, et ceux de sortie par 1,5.
| Catégorie de facturation Standard | Contexte court (≤272K) | Contexte long (>272K) |
|---|---|---|
| Entrée standard | $2.00 | $4.00 |
| Lecture du cache | $0.10 | $0.20 |
| Écriture de cache 30 minutes | $2.50 | $5.00 |
| Écriture de cache 12 heures | $5.00 | $10.00 |
| Sortie (tokens de raisonnement inclus) | $10.00 | $15.00 |
Un prix unitaire identique ne signifie pas une facture identique. Pour une même tâche, les tokens de sortie, le nombre d’appels d’outils et les hits de cache du 6.2 Sol peuvent varier ; le coût réel doit donc être évalué tâche par tâche. L’écriture de cache doit être calculée selon son tarif complet, sans ajouter le prix d’entrée standard sur les mêmes tokens. Le volume total de sortie peut être lu dans usage.output_tokens de Responses ; l’usage de raisonnement figure généralement dans le sous-champ output_tokens_details.reasoning_tokens.
Concernant les appels depuis la Chine : au 20 novembre 2026, dans l’interface de tarification publique d’APIYI apiyi.com, le prix de gpt-6.2-sol sur le palier court est identique au tarif officiel. Sur le palier long, l’entrée standard, la lecture du cache, l’écriture du cache et la sortie sont respectivement à $3, $0.15, $3.75 et $11.25. Il s’agit d’expressions tarifaires publiquement affichées ; la facturation réelle dépend du groupe de compte et de la configuration actuelle de la plateforme.
1.3 Arbitrer entre Flex et les fenêtres de remise en arrière-plan
Le changement le plus facile à négliger concerne les options de traitement. Le 6.1 Sol figure encore dans la liste d’éligibilité à Flex, tandis que le 6.2 Sol ne prend pas Flex en charge. En remplacement, le 6.2 Sol peut utiliser les fenêtres de remise en arrière-plan de Responses : pour les requêtes admissibles, le tarif des tokens du modèle est inférieur de 30 % au Standard sur une fenêtre de 2 heures, et de 40 % sur une fenêtre de 8 heures.
Si un ancien système dépend de Flex pour du traitement par lots hors ligne, il faut réévaluer la solution lors de la migration en fonction des délais de livraison et des conditions d’accès. Les tâches pouvant être livrées en quelques heures peuvent être évaluées avec les fenêtres en arrière-plan ; celles qui exigent une réponse immédiate ne peuvent être facturées qu’au Standard.
2. GPT-6.2 Sol face à GPT-6.1 Sol : progrès et régressions dans les tests publics
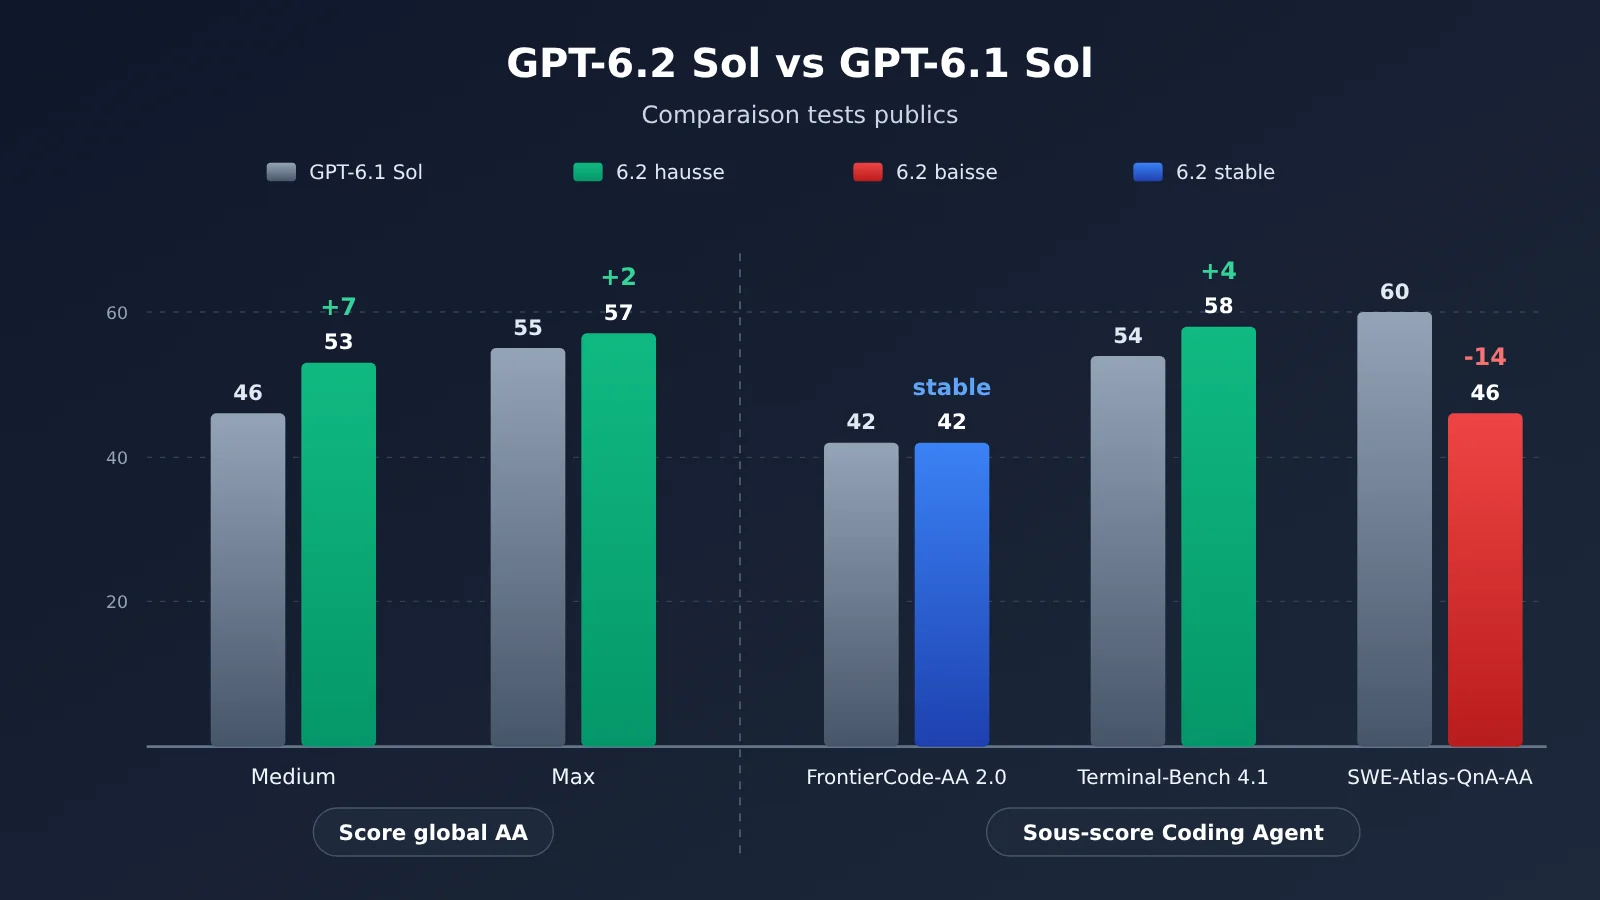
Le graphique ci-dessus regroupe des données publiques de tiers : le vert indique une amélioration de 6.2 Sol, le rouge une baisse. Ces chiffres proviennent d’organismes et de frameworks de test différents ; ils ne sont comparables que dans des conditions équivalentes. Pour reproduire ces mesures sur vos propres tâches, vous pouvez appeler les deux générations de modèles via APIYI apiyi.com, en utilisant le même canal et le même palier.
2.1 Travail intellectuel et capacités générales : GPT-6.2 Sol progresse régulièrement
Données officielles : dans son annonce de lancement du 17 novembre 2026, OpenAI indique que 6.2 Sol dépasse 6.1 Sol de 5,3 points sur son évaluation interne GDPval v2. GDPval v2 évalue des tâches intellectuelles à plusieurs étapes dans des domaines tels que le conseil, la finance et le design ; cette conclusion ne s’applique donc qu’aux tests internes publiés par OpenAI. L’annonce mentionne aussi une « réduction de 22 % des tokens de sortie », mais la comparaison concerne GPT-6.2 Astra et GPT-6 Astra : elle ne s’applique pas entre les deux générations de Sol.
Mesures indépendantes : le score composite d’Artificial Analysis couvre le travail intellectuel, la programmation, les sciences et les connaissances générales. De 6.1 Sol à 6.2 Sol, le palier Medium passe de 46 à 53, et le palier Max de 55 à 57. Le coût moyen par tâche du palier Max baisse de 1,27 $ à 1,01 $, soit environ 20 % de moins d’après les valeurs arrondies publiées.
Les deux ensembles de données concordent : 6.2 Sol est plus performant sur les tâches générales et plus économique par tâche. À noter : la hausse du palier Medium (+7) est nettement plus forte que celle du palier Max (+2). Pour les équipes qui utilisent quotidiennement un palier de raisonnement moyen, cette mise à niveau devrait être plus perceptible.
2.2 Modification de code, terminal et questions-réponses sur la base de code : GPT-6.2 Sol, des hausses et des baisses
Dans le Coding Agent Index v2.1 d’Artificial Analysis, les deux générations de modèles utilisent le framework de test Codex et le niveau de raisonnement Max, avec un protocole identique :
| Indicateur (Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | Variation |
|---|---|---|---|
| Coding Agent Index (score global) | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | stable |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA (Q&R sur base de code) | 60 | 46 | -14 |
| Coût API moyen par tâche | $1.51 | $1.22 | env. -19% |
| Temps d’exécution moyen de l’agent | 21.9 minutes | 17.5 minutes | -4.4 minutes |
La baisse du score global vient principalement des 14 points perdus sur la sous-catégorie questions-réponses sur base de code, qui annulent les 4 points gagnés sur le terminal, tandis que la sous-catégorie modification de code reste stable. Le temps d’exécution exclut les coûts de démarrage de l’environnement, de revue et de validation ; il ne reflète que la durée d’exécution de l’agent proprement dit. Par ailleurs, le FrontierCode-AA 2.0 cité ici est la version d’Artificial Analysis et ne doit pas être confondu avec les classements homonymes publiés par d’autres organismes.
Le comparatif à un seul tour du DataAnalyticsBench publié par Plotly le 2026-11-17 offre une référence sur un autre type de tâches indépendantes. De 6.1 Sol à 6.2 Sol, le score total passe de 43/43 à 40/43, le coût d’un tour complet descend de $2.61 à $1.22, et le temps médian par question de 17.6 à 10.5 secondes. Le nombre d’appels d’outils passe de 258 à 158, et le volume de sortie d’environ 70,000 tokens à 45,000 tokens. Les trois questions ratées par 6.2 Sol portent toutes sur des problèmes de motifs cachés.
Ces résultats présentent deux limites. Premièrement, les tests passent par OpenRouter et par le framework fixe de Plotly ; les coûts correspondent aux tarifs du canal à ce moment-là. Deuxièmement, chaque modèle n’a tourné qu’une seule fois, et Plotly a observé, en réexécutant d’autres modèles, des variations pouvant atteindre trois questions. Ces données illustrent donc surtout une tendance : 6.2 Sol agit moins, plus vite et à moindre coût, mais sur les problèmes difficiles qui demandent d’aller en profondeur, il peut « s’arrêter trop tôt ».
3. Comment le comportement de l’API de GPT-6.2 Sol affecte les services existants
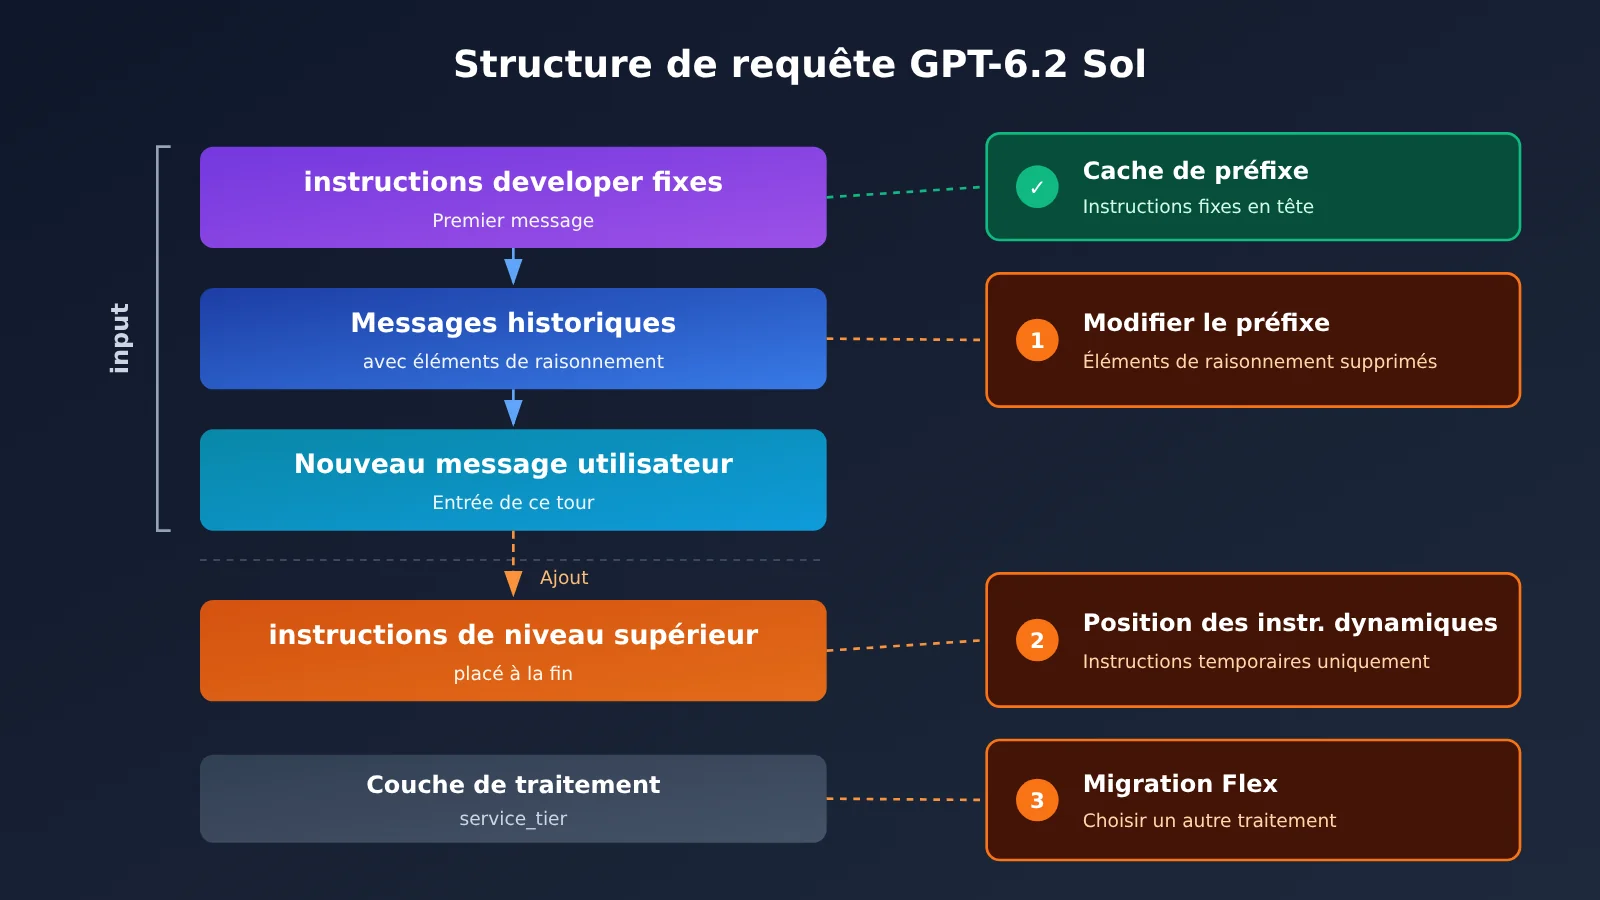
Pour les applications multi-tours qui utilisent déjà 6.1 Sol, les risques se concentrent principalement sur trois aspects. Le schéma ci-dessus présente la structure recommandée des requêtes GPT-6.2 Responses ; vous pouvez la vérifier directement via le point d’accès responses d’APIYI apiyi.com en suivant cette structure.
- Réécriture du préfixe de conversation : l’API Responses de GPT-6.2 supprime les éléments de raisonnement précédents lorsqu’on édite un préfixe de conversation existant, lors de certains changements de modèle, ou lors du changement d’utilisateur final ou d’organisation. Si votre système possède une logique du type « réécrire l’historique puis reprendre la conversation », il faut vérifier si la qualité de la reprise et les hits de cache ne sont pas affectés.
- Position des instructions : les
instructionsde niveau supérieur de GPT-6.2 sont ajoutées aprèsinput. Les instructions fixes que vous souhaitez réutiliser et faire bénéficier du cache doivent être placées dans le premier messagedeveloperdeinput; les instructions temporaires qui changent à chaque fois peuvent continuer à utiliser lesinstructionsde niveau supérieur. - Migration Flex : voir la section 1.3 ; les requêtes qui passaient par Flex doivent désormais choisir un autre mode de traitement.
De plus, aucun des deux points de terminaison n’accepte le niveau de raisonnement none. Lors du remplacement de l’ID de modèle, il convient également de vérifier, conformément au guide de migration officiel, la réécriture de l’historique, les paramètres d’échantillonnage, le niveau de raisonnement, la couche de traitement et les données de cache.
3.1 Exemple d’invocation minimaliste avec GPT-6.2 Sol
Voici une vérification minimale avec Chat Completions :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI : interface unifiée
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
Voir le code de comparaison entre l’ancienne et la nouvelle version de l’API Responses (instructions fixes en amont + suivi de l’usage)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # L'ancienne et la nouvelle version passent par le même canal, pour une comparaison équitable
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # Aucun des deux endpoints n'accepte "none"
        input=[
            # Les instructions fixes vont dans le premier message developer de input, ce qui favorise le cache de préfixe
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # Les instructions temporaires peuvent aller dans instructions au niveau supérieur ; elles seront ajoutées après input
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 Conseil technique : lors de la migration d’applications multi-tours, je vous conseille de conserver un jeu de requêtes réelles « préfixe inchangé, on ajoute seulement des messages », puis de les envoyer aux deux générations pour comparer les réponses et l’usage de lecture du cache. APIYI apiyi.com permet d’appeler les deux générations en parallèle, ce qui facilite l’intégration de ces tests comparatifs dans la CI.
4. Validation tâche par tâche avant le basculement vers GPT-6.2 Sol
Le plan ci-dessous est une conception de test proposée à partir des preuves publiques mentionnées ci-dessus ; il ne s’agit pas d’une exigence officielle. Le principe central : hormis le modèle, tous les autres paramètres restent identiques, notamment le même canal API, le même niveau de raisonnement, les mêmes matériaux d’entrée, la même liste d’outils, les mêmes réglages de délai d’attente et les mêmes règles de notation, tout en conservant 6.1 Sol comme groupe témoin.
| Type de tâche | Priorité de test préliminaire | Principaux éléments de preuve | Conditions de validation |
|---|---|---|---|
| Modification de code | À tester en priorité | FrontierCode-AA 2.0 stable, coût et durée en baisse | Taux de réussite des tests au moins égal à celui de l’ancienne version, coût par livraison conforme en baisse |
| Terminal / opérations sur ordinateur | À tester en priorité | Terminal-Bench 4.1 +4 | Taux de réussite et temps de bout en bout P50, P95 |
| Analyse courante | À tester en priorité | Score global en hausse, durée et coût Plotly en baisse | Taux d’acceptation au premier passage, nombre d’éléments manquants |
| Questions-réponses sur base de code | Validation dédiée | SWE-Atlas-QnA-AA -14 | Taux de couverture des faits obligatoires annotés à l’avance |
| Analyse complexe peu fréquente / cas difficiles | Validation dédiée | Perte de points sur les questions à motifs cachés de Plotly | Coût des livraisons conformes après réexamen |
| Processus multi-tours | Validation dédiée | Abandon d’éléments de raisonnement, changement de position des instructions | Cohérence des résultats après rejeu, complétion de l’historique et reprise après échec |
Lors de l’exécution, on peut avancer selon la liste suivante :
- Questions-réponses sur base de code : annoter à l’avance, pour chaque question, les appelants, les options de configuration, les conditions de branchement et les chemins de fichiers qui doivent être couverts, puis vérifier point par point que les preuves sont complètes, sans se contenter de juger si la réponse « semble correcte ».
- Consigner les indicateurs : par type de tâche, enregistrer le taux d’acceptation au premier passage, les éléments manquants, le nombre de retouches, le temps de bout en bout, ainsi que la consommation du modèle et des outils ; lorsque l’échantillon est suffisant, examiner aussi P50 et P95.
- Calculer les coûts : estimer le coût par livraison conforme à l’aide de la formule « coût total pendant l’évaluation ÷ nombre de tâches acceptées », en intégrant au coût total les frais de réexamen et de nouvelle exécution. Une exécution de 6.2 Sol est moins chère, mais si les cas difficiles nécessitent davantage de reprises, le coût par livraison conforme peut au contraire augmenter.
- Décider de l’augmentation du volume : seuls les types de tâches qui atteignent les trois seuils — qualité, coût par livraison conforme et latence — voient leur trafic augmenter ; ceux qui ne les atteignent pas restent sur 6.1 Sol en attendant le prochain cycle de retest.
💰 Conseil pour le calcul des coûts : le prix unitaire doit être identique sur le même canal pour que la comparaison ait du sens. Avec une seule clé APIYI sur apiyi.com, on peut faire tourner les deux générations de modèles en parallèle, et la facturation est enregistrée séparément par modèle, ce qui permet de calculer directement le coût par livraison conforme.
GPT-6.2 Sol face à GPT-6.1 Sol : comment choisir
Si votre charge de travail se compose surtout de modifications de code, d’agents de terminal et d’analyses de routine, GPT-6.2 Sol est, à prix égal, le choix le plus rapide et le plus économique : vous pouvez basculer dessus en priorité. Si en revanche les questions sur une base de code et les cas difficiles du type « trouver la règle cachée » pèsent lourd, ou si votre activité dépend de Flex, commencez par la validation spécifique de la section 4 ; tant que les indicateurs correspondants ne sont pas au niveau, laissez GPT-6.1 Sol continuer à absorber ce trafic. La variable décisive, c’est la composition des tâches : plus la part de cas difficiles est élevée, plus les avantages de GPT-6.2 Sol en prix unitaire et en vitesse risquent d’être annulés par les reprises.
Je vous conseille de commencer par utiliser le crédit de test gratuit réservé aux nouveaux utilisateurs sur APIYI apiyi.com : sélectionnez des échantillons représentatifs de chaque type de tâche, faites un premier comparatif, puis décidez de l’ampleur de la bascule en fonction des résultats.
Références
- Annonce d’OpenAI : notes de version de GPT-6.2 Astra et Sol, et conclusions de GDPval v2
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol
- Lien :
- Fiche modèle et tarification de l’API OpenAI : specs, prix et options de traitement des deux générations de Sol
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol - Lien :
developers.openai.com/api/docs/pricing
- Lien :
- Guide d’utilisation de GPT-6.2 : changements de comportement de Responses et points de contrôle pour la migration
- Lien :
developers.openai.com/api/docs/guides/latest-model
- Lien :
- Artificial Analysis : scores globaux et données détaillées du Coding Agent Index
- Lien :
artificialanalysis.ai/agents/coding-agents/codex
- Lien :
- Plotly DataAnalyticsBench : comparatif en un seul passage de GPT-6.2 Sol et explications des réponses ratées
- Lien :
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Lien :
Auteur : l’équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI apiyi.com, et pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com