Note de l’auteur : cet article présente séparément, pour GPT-6.2 Sol et Claude Opus 5.5, le score composite tiers, le prix catalogue officiel, le prix de lecture du cache et la disponibilité sur APIYI, afin de vous aider à choisir un modèle en fonction de vos tâches plutôt qu’à partir d’un score global unique.
OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Beaucoup d’équipes utilisaient déjà Claude Opus 5.5 et doivent aujourd’hui décider s’il faut migrer ou non. Cet article compare GPT-6.2 Sol et Claude Opus 5.5 et formule des recommandations sous plusieurs angles : score composite, prix catalogue, lecture du cache, protocole et disponibilité actuelle à l’invocation.
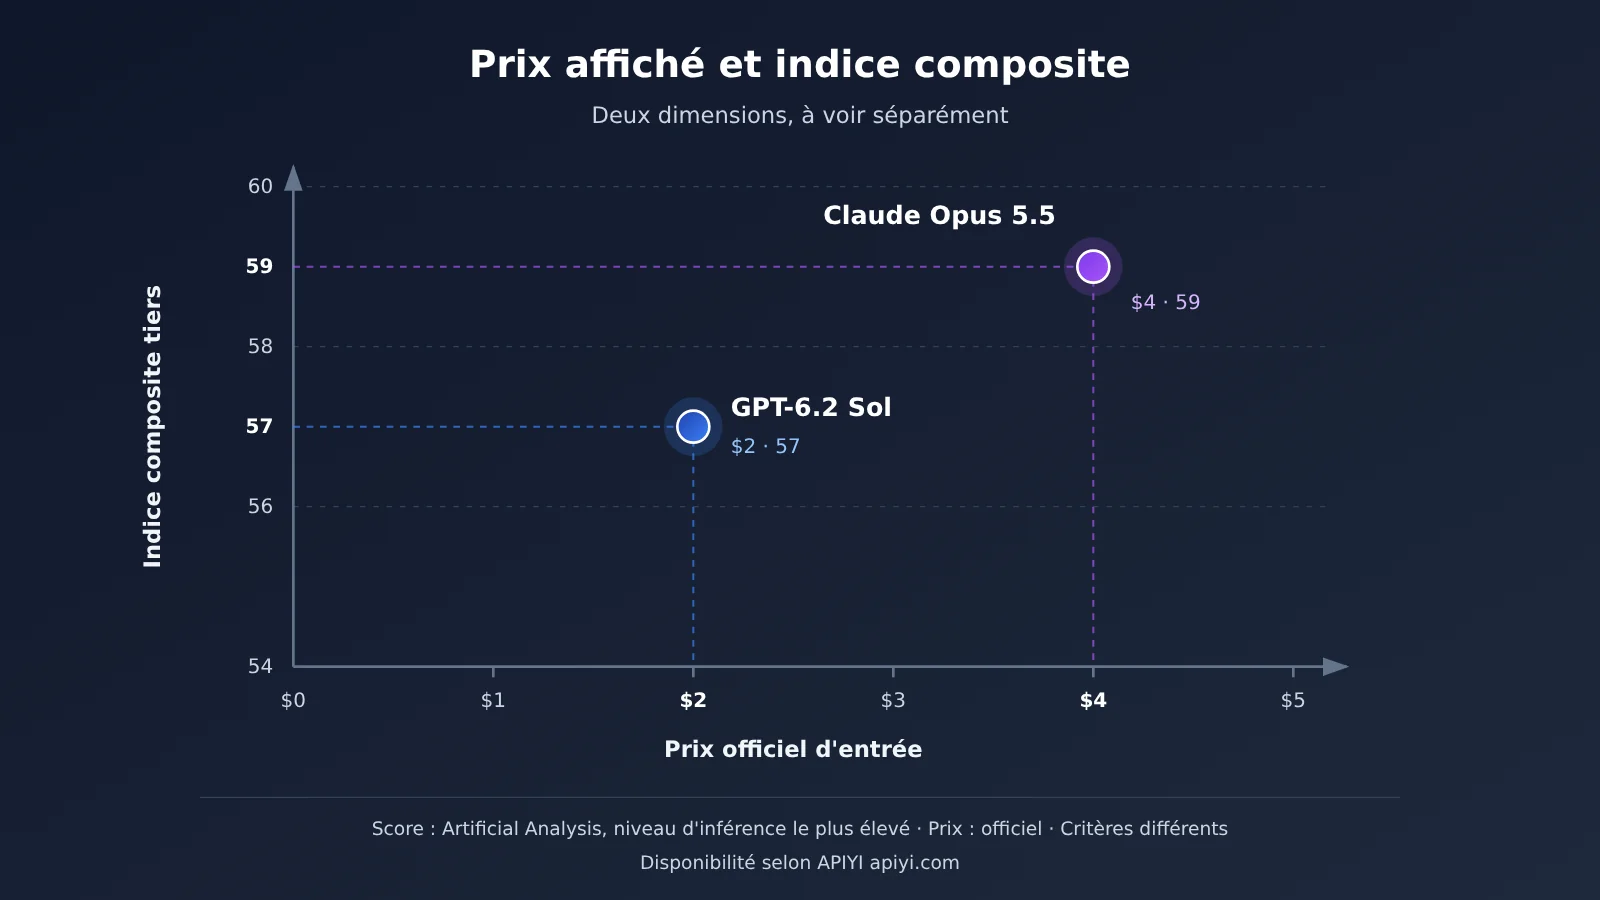
Ce n’est pas un article qui déclare qui est le plus puissant ni qui est le moins cher. Dans les indices composites tiers, le palier le plus élevé de Sol obtient 2 points de moins que celui d’Opus. Selon les prix catalogue officiels pour une fenêtre de contexte courte, les prix unitaires de Sol en entrée, en sortie et en lecture du cache représentent environ la moitié de ceux d’Opus. Ces deux faits doivent être lus ensemble : pris isolément, aucun des deux ne suffit pour trancher.
Ce que vous allez y gagner : à la fin de cet article, vous connaîtrez le score composite, le prix catalogue et le coût de lecture du cache de chacun des deux modèles, vous saurez quels chiffres sont auto-déclarés par l’éditeur et lesquels sont mesurés par des tiers, et vous saurez lequel des deux vous pouvez invoquer dès maintenant sur APIYI.
GPT-6.2 Sol et Claude Opus 5.5 : les différences clés en un coup d’œil
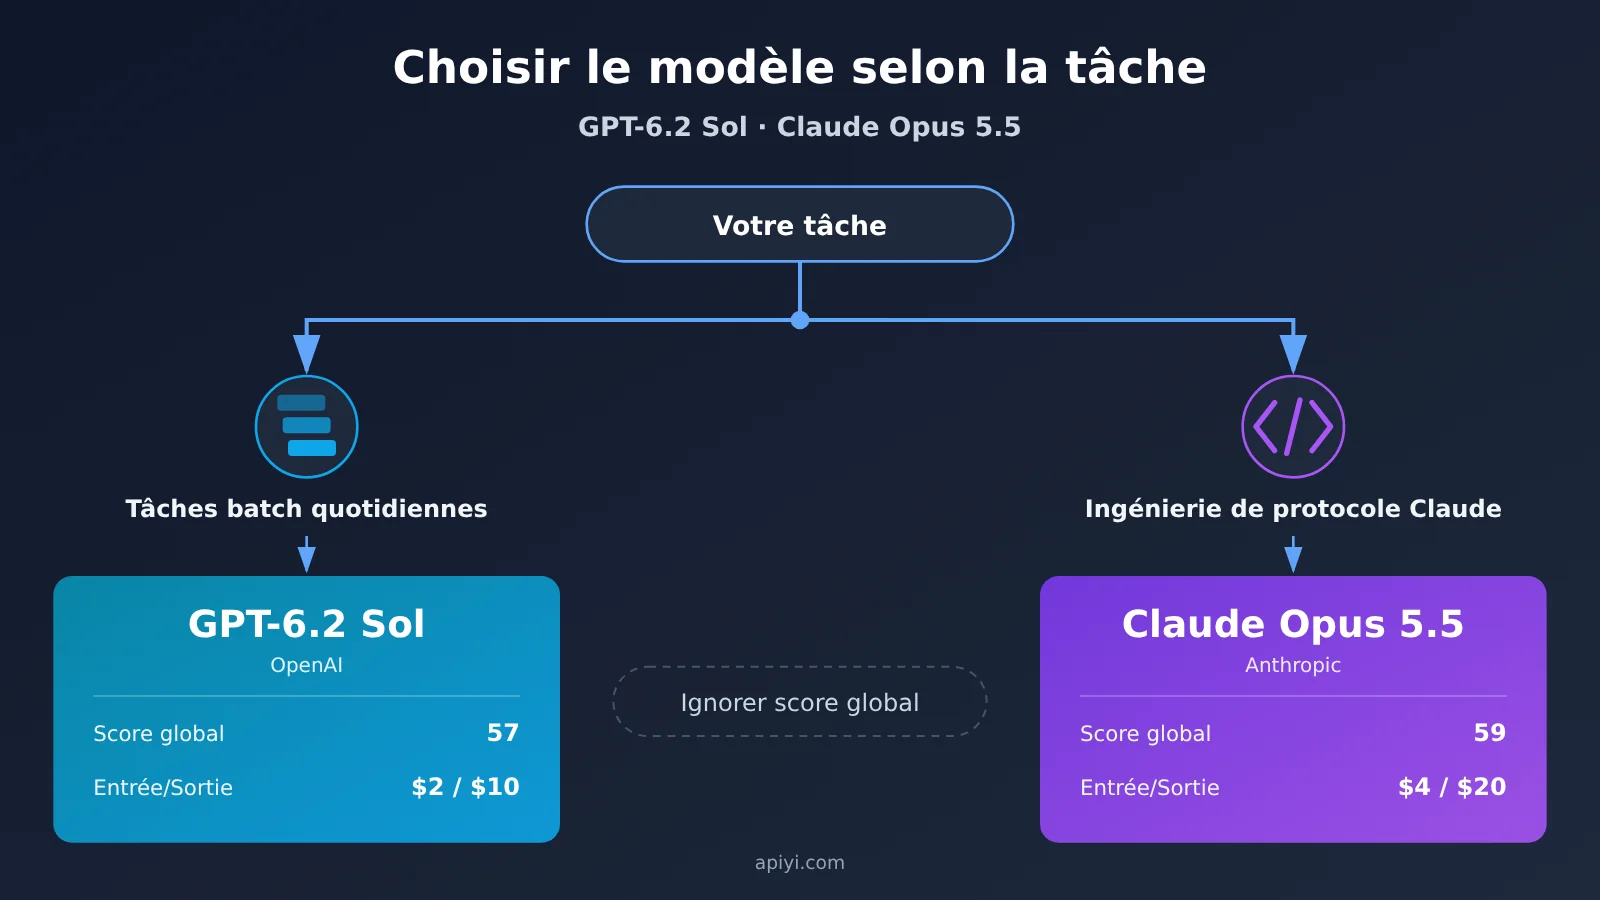
Commençons par regrouper dans un tableau les cinq séries d’informations les plus utiles pour choisir un modèle. Chaque ligne indique la source des chiffres, et les sections suivantes les détaillent une par une.
| Critère de comparaison | GPT-6.2 Sol | Claude Opus 5.5 | Source des chiffres |
|---|---|---|---|
| Indice composite tiers (niveau de raisonnement maximal) | 57 (palier Max) | 59 (niveau le plus élevé) | Artificial Analysis, source tierce |
| Tarifs d’entrée / sortie en contexte court | $2 / $10 | $4 / $20 | Tarifs officiels de chaque fournisseur, par million de tokens |
| Tarif de lecture du cache | $0.10 | $0.20 | Page du modèle OpenAI ; pour Opus, chiffres repris de la grille tarifaire d’Anthropic |
| Contexte / sortie maximale | 1,050,000 / 128,000 | 1M / 128K | Pages modèles officielles et documentation |
| Disponibilité sur APIYI | Pas encore référencé | Disponible, claude-opus-5-5 |
Tableau général des modèles et interface de tarification d’APIYI |
Un score inférieur de 2 points et un prix environ deux fois plus bas : pourquoi les lire ensemble
Si vous ne regardez que le score composite, vous concluez qu’« Opus est plus performant » ; si vous ne regardez que le tarif officiel, vous concluez que « Sol coûte moins cher au token ». Ces deux conclusions sont exactes, mais chacune ne raconte qu’une moitié de l’histoire. Le score composite reflète la performance moyenne sur un mélange de tâches, le tarif officiel indique un prix par million de tokens, et votre facture réelle dépendra surtout du nombre de tokens que consomme chaque tâche.
Par ailleurs, cet écart de 2 points provient des tests d’Artificial Analysis réalisés au niveau de raisonnement maximal. Si votre activité utilise l’intensité de raisonnement par défaut, ou si vos types de tâches s’écartent nettement de ceux de cet indice, ces 2 points ne se transposent pas forcément tels quels. L’approche de cet article est donc la suivante : d’abord poser clairement les chiffres, puis choisir selon le type de tâche.
GPT-6.2 Sol vs Claude Opus 5.5 : prix affichés et lecture de cache
Le prix est sans doute le point le plus souvent mal interprété dans ce choix de modèle. Le tableau ci-dessous présente séparément les prix officiels et les prix de la plateforme APIYI ; tous les chiffres sont donnés pour 1 million de tokens, avec par défaut le palier standard à contexte court.
| Poste de tarification | Prix officiel GPT-6.2 Sol | Prix officiel Claude Opus 5.5 | Claude Opus 5.5 sur APIYI | GPT-6.2 Sol sur APIYI |
|---|---|---|---|---|
| Entrée | $2 | $4 | $4 | Pas encore référencé |
| Sortie | $10 | $20 | $20 | Pas encore référencé |
| Lecture de cache | $0.10 | $0.20 | $0.2 | Pas encore référencé |
| Écriture de cache | 30 min : $2.50 ; 12 h : $5 | 5 min : $5 ; 1 h : $8 (barème relayé) | Voir la liste de la plateforme | Pas encore référencé |
| Règle pour entrées très longues | Supplément sur toute la commande au-delà de 272K | Non couvert par les sources de référence | Voir la liste de la plateforme | Pas encore référencé |
Le tarif officiel de GPT-6.2 Sol en contexte court s’établit à $2 en entrée, $10 en sortie et $0.10 en lecture de cache ; selon l’annonce de lancement, il reprend simplement les prix API par token de GPT-6.1 Sol. Sur APIYI, GPT-6.2 Sol n’est pas encore référencé, mais nous le mettrons en ligne dès que possible ; pour les références et les prix, seule la liste des modèles de la plateforme fait foi.
Côté Claude Opus 5.5, le prix officiel est de $4 en entrée et $20 en sortie. La lecture de cache à $0.20 ainsi que les prix d’écriture de cache (5 min : $5 ; 1 h : $8) proviennent du barème relayé par Anthropic ; pour l’écriture de cache, c’est la page officielle d’Anthropic qui fait foi. Dans la table globale des modèles d’APIYI (données du 2026-11-17 à 15:54, UTC+8), claude-opus-5-5 et claude-opus-5-5-thinking sont déjà référencés, au prix plateforme de $4 / $20 / $0.2. Vous pouvez vérifier ces éléments directement dans la liste des modèles sur APIYI (apiyi.com).
Un point mérite particulièrement votre attention : dans la table globale d’APIYI, les modèles actuellement visibles, gpt-6.1-sol ($2 / $10 / $0.1) et gpt-6-sol ($2 / $10 / $0.2), ne sont pas des versions 6.2. Leurs prix ne peuvent donc pas être considérés comme les prix plateforme de GPT-6.2 Sol, et ils ne reflètent pas davantage les capacités de la version 6.2.
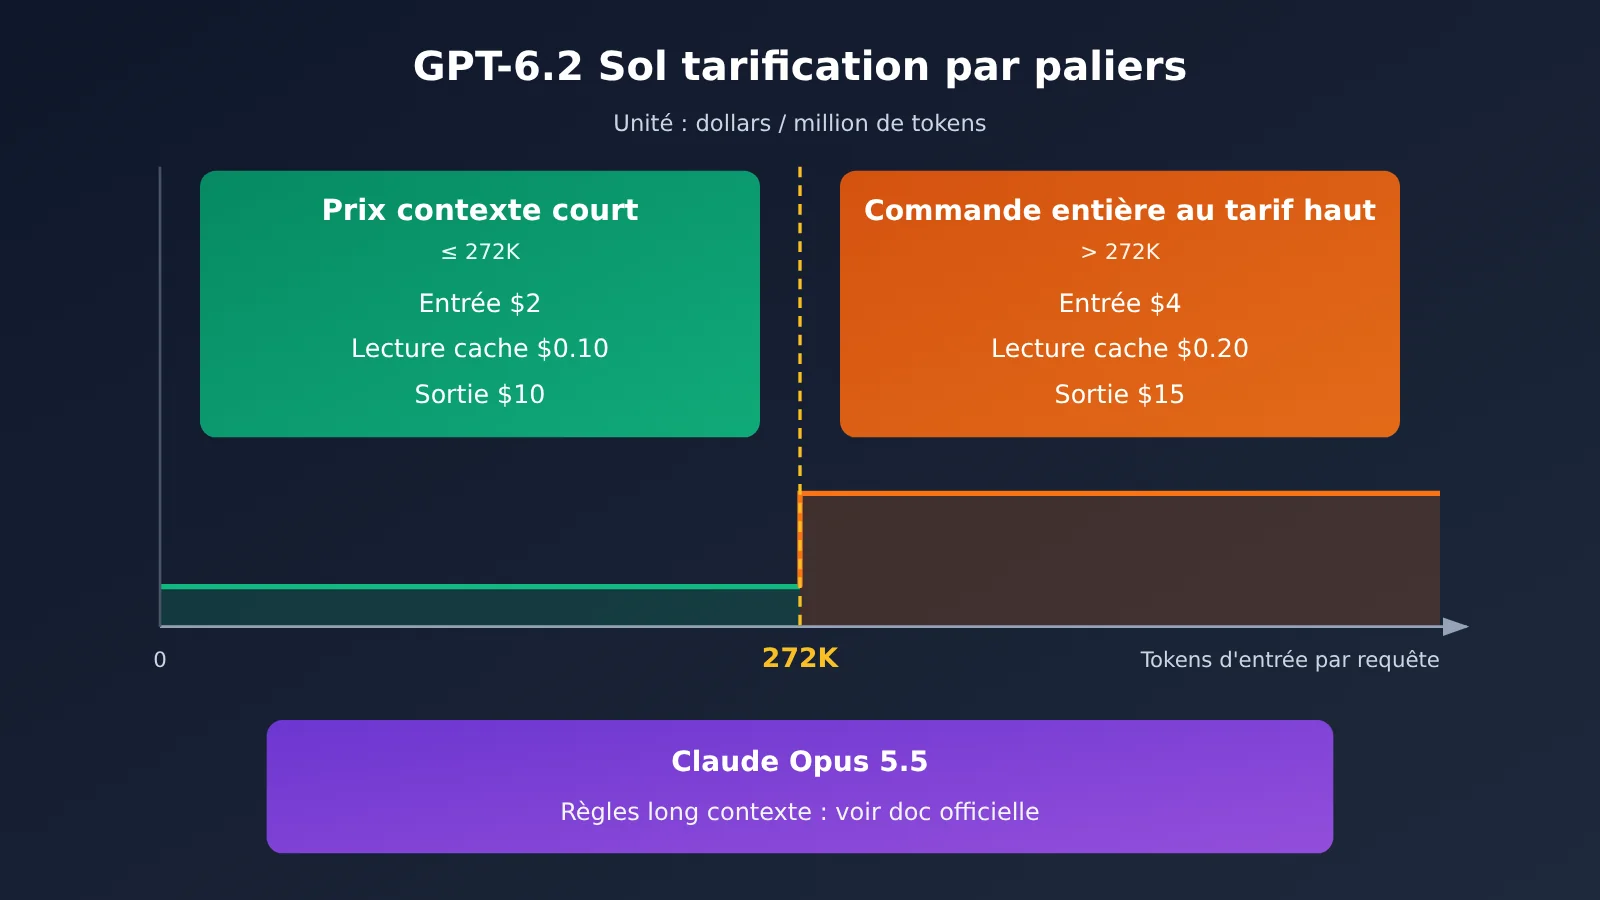
GPT-6.2 Sol : la règle de facturation 272K sur l’ensemble de la requête
La page des modèles d’OpenAI est explicite : dès que l’entrée d’une requête dépasse 272K tokens, les prix unitaires de l’entrée et du cache doublent, la sortie est facturée 1,5 fois le prix du contexte court, et surtout, ces nouveaux tarifs s’appliquent à l’ensemble de la requête — pas seulement à la partie qui dépasse. Converti pour Sol, cela donne : entrée à $4, lecture du cache à $0.20, sortie à $15.
Cette règle pèse lourd pour les tâches portant sur de longs documents. Si vos requêtes types tournent régulièrement autour de 272K, l’avantage « environ moitié prix » des tarifs affichés fond sensiblement. Opus 5.5 applique-t-il une règle similaire pour les longs contextes ? Les références de cet article ne le couvrent pas : mieux vaut consulter directement la documentation d’Anthropic avant de comparer.
Par ailleurs, le mode Batch de Sol est facturé 50 % du prix standard, et Fast 2 fois le prix standard pour une même longueur de contexte. Ultrafast est à 3 fois le prix standard jusqu’au 2027-02-28 (heure du Pacifique), puis passe à 6 fois à partir du 2027-03-01.
Exemple de requête unique calculé aux tarifs affichés
Pour être plus concret, voici une illustration purement mathématique basée sur les tarifs officiels — elle ne correspond à aucune facture réelle. Prenons une requête avec 100 000 tokens en entrée, 10 000 tokens en sortie, sans cache : Sol revient à environ $0.20 + $0.10 = $0.30, Opus à environ $0.40 + $0.20 = $0.60.
Cette illustration repose sur deux hypothèses : les deux modèles consomment le même nombre de tokens sur une même tâche, et la requête ne dépasse pas 272K. En pratique, la consommation de tokens de raisonnement varie selon le modèle, l’intensité de raisonnement et la tâche ; pour connaître votre coût réel, il faut faire tourner vos propres tâches et mesurer le résultat.
GPT-6.2 Sol et Claude Opus 5.5 : deux jeux de chiffres à lire séparément
Les chiffres de performance présentés ici proviennent de deux sources : d’un côté, les évaluations tierces d’Artificial Analysis ; de l’autre, les données officielles auto-déclarées par OpenAI dans sa note de publication et sur la page du modèle. Tâches évaluées, niveaux de raisonnement, méthode de calcul des coûts : les deux ensembles ne parlent pas de la même chose. Nous les listons donc séparément, sans les fondre en une conclusion unique.
Indice composite tiers d’Artificial Analysis (Intelligence Index v5.0.1)
| Modèle et niveau de raisonnement | Indice composite | Coût par tâche (indice composite) | Remarques |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 57 | 1,01 $ | 2 points de plus que GPT-6.1 Sol |
| GPT-6.2 Sol (Xhigh) | 56 | Non publié séparément | Source tierce |
| GPT-6.2 Sol (High) | 55 | Non publié séparément | Source tierce |
| GPT-6.2 Sol (Medium) | 53 | Non publié séparément | Source tierce |
| GPT-6.2 Sol (Low) | 41 | Non publié séparément | Source tierce |
| Claude Opus 5.5 (niveau le plus élevé) | 59 | Non couvert par les sources de cet article | Issu du même article |
Les 1,01 $ de Sol correspondent uniquement au coût moyen d’une tâche au sein de cet indice composite : ce n’est pas un tarif applicable à toutes les tâches, et on ne peut pas s’en servir pour établir des ratios avec les chiffres de coûts issus d’autres sources. Quant au coût par tâche d’Opus 5.5 dans ce même indice, les sources de référence ne le mentionnent pas — cet article ne se hasarde donc pas à l’estimer.
Le même article tiers livre aussi quelques résultats détaillés qui méritent l’attention. Dans le Coding Agent Index (Codex harness, Max), Sol fait 3 points de moins que GPT-6.1 Sol, essentiellement à cause d’un score inférieur de 14 points sur SWE-Atlas-QnA-AA, ce qui le rend plus enclin à omettre des faits essentiels. Sur le taux d’hallucination AA-Omniscience (Max), Sol affiche 55 %. Dans l’aperçu de recherche AA-Robotics v0.1, Sol obtient 78. Ces sous-scores ne sont accompagnés d’aucune valeur de référence pour Opus 5.5 : ils servent donc uniquement à cerner les points forts et les limites propres à Sol.
Chiffres officiels auto-déclarés par OpenAI pour GPT-6.2 Sol
Tous les chiffres qui suivent proviennent de la note de publication d’OpenAI : ce sont des données officielles auto-déclarées, dont les points de comparaison sont pour l’essentiel les propres modèles d’OpenAI, et non Claude Opus 5.5 :
- FrontierCode 2.0 (développé par Cognition, qui évalue si les modifications apportées à de vraies bases de code peuvent être fusionnées par les mainteneurs) : Sol et GPT-6.2 Astra sont à moins de 0,5 point d’écart, pour un coût environ cinq fois moindre, les deux modèles étant évalués au niveau Max.
- LifeVal (ensemble de tâches du quotidien constitué par OpenAI) : Sol obtient un score supérieur à celui de GPT-6 Astra, pour un coût environ sept fois moindre.
- GDPval v2 (évaluation interne officielle) : Sol dépasse GPT-6.1 Sol de 5,3 points.
- Elo de l’évaluation humaine à l’aveugle AA-3D (d’après les données officielles) : Sol obtient 1259.
Pourquoi ces deux jeux de chiffres ne peuvent pas être combinés
L’indice composite des tiers est calculé en exécutant un ensemble fixe de tâches au niveau de raisonnement maximal ; les chiffres officiels, eux, se présentent surtout sous forme de comparaisons relatives — « de combien de points on dépasse la génération précédente », « pour une fraction seulement du coût ». Benchmarks, niveaux de raisonnement, façon de comptabiliser les coûts : rien n’est aligné. Accoler « 2 points de moins à l’indice composite » et « presque au niveau d’Astra sur un test officiel » ne permet en aucun cas de conclure que « Sol est globalement plus fort » ou que « Opus est globalement plus fort ».
Une lecture plus utile : le score composite des tiers situe approximativement les deux modèles sur des tâches mixtes généralistes ; les chiffres officiels vous indiquent, eux, sur quels scénarios OpenAI a particulièrement optimisé Sol — les tâches du quotidien ou la fusion de code, par exemple. Au final, c’est quand même la performance sur vos propres tâches qui doit trancher.
GPT-6.2 Sol et Claude Opus 5.5 : différences de spécifications et de protocoles
Au-delà des scores et des prix, c’est souvent le mode d’intégration qui détermine si vous pouvez basculer immédiatement. Le tableau ci-dessous récapitule les spécifications et les différences d’endpoints entre les deux modèles.
| Spécification | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Modalités d’entrée | Texte, image (pas d’audio ni de vidéo) | Non précisées dans la documentation de référence |
| Fenêtre de contexte | 1 050 000 (entrée maximale 922 000) | 1M |
| Sortie maximale | 128 000 | 128K |
| Date de coupure des connaissances | 2026-06-01 | 2026-06 |
| Intensité de raisonnement | Prend en charge les tokens de raisonnement ; l’API n’accepte pas effort défini sur none | effort défini par défaut sur medium |
| Endpoints officiels | Chat Completions, Responses, Batch | Anthropic Messages |
| Endpoints APIYI | Pas encore disponible | chat, messages |
Si votre chaîne d’outils dépend du protocole Messages de Claude — par exemple Claude Code ou un Agent développé avec le SDK Anthropic — sachez qu’Opus 5.5 sur APIYI propose à la fois les endpoints chat et messages, avec des groupes incluant ClaudeCode, Claude_Reverse, Claude_Enterprise, Default et SVIP. Le coût de la bascule se réduit alors pratiquement à modifier le base URL et la clé API.
GPT-6.2 Sol, de son côté, s’appuie sur Chat Completions et Responses d’OpenAI. La page officielle du modèle précise que Realtime, Assistants, le fine-tuning, la génération d’images, la vidéo et la voix ne sont pas pris en charge : pour ces besoins précis, il ne faut pas compter sur lui.
Recommandations par scénario : GPT-6.2 Sol ou Claude Opus 5.5
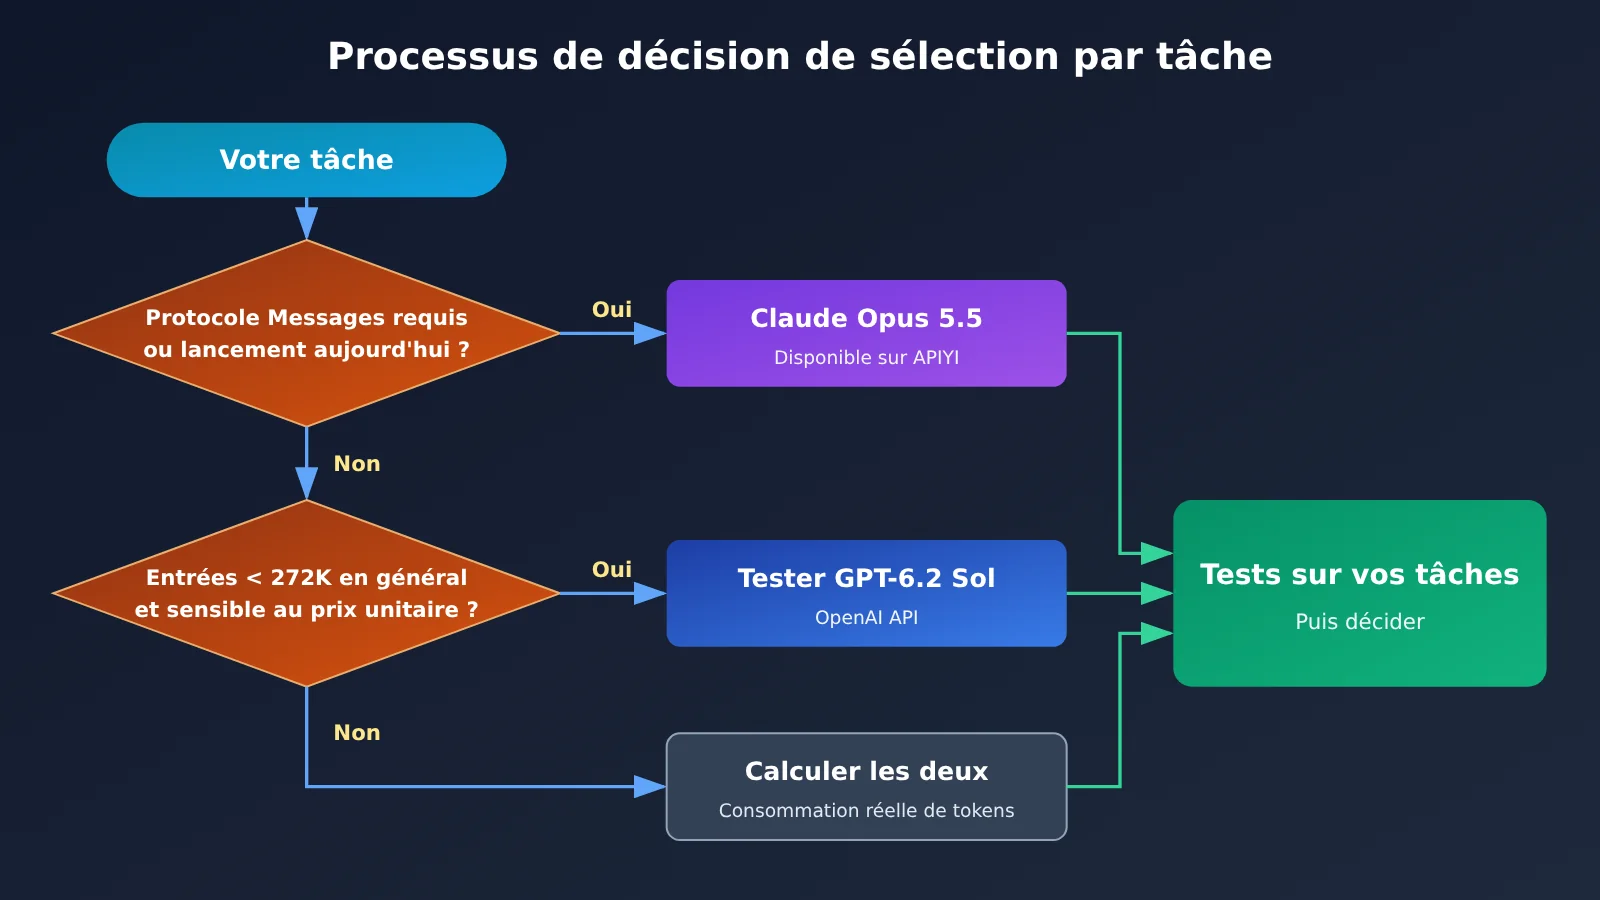
Choisir en fonction de la tâche reste plus fiable que de se fier au score global. Voici deux grandes catégories de scénarios, puis un tableau pour résumer.
Scénarios où choisir Claude Opus 5.5
- Vous avez besoin du protocole Claude : votre code existant repose sur Anthropic Messages, ou dépend d’outils comme Claude Code. Dans ce cas, le coût d’adaptation à un changement de protocole dépasse l’écart de prix unitaire.
- Vous devez mettre en production maintenant : Opus 5.5 est déjà disponible chez APIYI, vous pouvez l’intégrer immédiatement, sans attendre la mise en ligne d’un nouveau modèle.
- Le score global est un critère incontournable : votre tâche ressemble fortement aux benchmarks mixtes généralistes, et les 2 points d’écart au niveau de raisonnement le plus élevé ont un impact réel sur les résultats.
Scénarios où regarder d’abord GPT-6.2 Sol
- Vos tâches quotidiennes en lot sont sensibles au prix unitaire : le tarif officiel en contexte court représente environ la moitié de celui d’Opus, et il en va de même pour la lecture du cache. Idéal pour un usage à haute fréquence avec beaucoup de réutilisation d’invites.
- Vos requêtes restent majoritairement sous 272K : c’est la condition pour bénéficier de façon fiable du tarif contexte court et éviter la majoration sur l’ensemble de la requête.
- Vous êtes déjà dans l’écosystème du protocole OpenAI : avec Responses ou Chat Completions, la migration ne demande que peu de modifications.
À noter : « regarder d’abord Sol » ne signifie pas que Sol obtient un meilleur score global — les chiffres tiers indiquent même le contraire. Cela veut dire que, dans des scénarios sensibles au prix unitaire et axés sur des tâches du quotidien, il vaut la peine de faire d’abord tourner vos propres tâches sur Sol.
| Type de tâche | À privilégier | Raison principale | Plateformes disponibles |
|---|---|---|---|
| Tâches d’ingénierie sur protocole Claude Code / Messages | Claude Opus 5.5 | Protocole natif, aucune adaptation nécessaire | APIYI apiyi.com, déjà en ligne |
| Tâches de production à déployer immédiatement | Claude Opus 5.5 | Appelable dès maintenant | APIYI, déjà en ligne |
| Tâches quotidiennes à haute fréquence, réutilisation du cache d’invites | GPT-6.2 Sol | Tarifs officiels d’entrée, de sortie et de lecture de cache environ deux fois moindres | API OpenAI ; pas encore disponible chez APIYI |
| Tâches sur documents longs au-delà de 272K | Estimer avec les tokens réels pour les deux modèles | Sol applique une majoration sur l’ensemble de la requête | Se référer à la liste des modèles de chaque plateforme |
| Questions-réponses très sensibles à l’omission de faits clés | Commencer par une évaluation ciblée | Sol affiche un repli sur SWE-Atlas-QnA-AA (chiffres tiers) | Se référer à la liste des modèles de chaque plateforme |
Prise en main rapide de GPT-6.2 Sol et Claude Opus 5.5
Actuellement, Claude Opus 5.5 est le modèle que vous pouvez invoquer directement sur APIYI. Les étapes d’intégration sont les suivantes : tout se résume à des modifications de configuration, sans aucune dépendance supplémentaire.
- Inscrivez-vous sur APIYI et créez une clé API ; les nouveaux utilisateurs bénéficient d’un quota de test gratuit.
- Définissez la base URL de votre client sur
https://api.apiyi.com/v1— c’est l’adresse de l’API compatible OpenAI. - Renseignez le nom de modèle
claude-opus-5-5; si vous avez besoin d’un raisonnement explicite, utilisez plutôtclaude-opus-5-5-thinking. - Si vous travaillez avec un client au format Anthropic, passez directement par l’endpoint messages ; avec le SDK OpenAI, c’est l’endpoint chat qu’il faut utiliser.
- Lancez une évaluation avec 5 à 10 requêtes métier réelles, en notant le nombre de tokens d’entrée, de sortie et de hits de cache, puis calculez le coût par tâche à partir du tarif plateforme de $4 / $20 / $0.2.
L’identifiant du modèle GPT-6.2 Sol est gpt-6.2-sol. Officiellement, il est accessible via l’API OpenAI, et il est déjà ouvert aux offres Plus, Pro, Enterprise et Edu dans ChatGPT Work et Codex. Sur APIYI, il n’est pas encore disponible : nous allons le référencer dès que possible ; pour les modèles et les prix, la liste des modèles de la plateforme fait foi. En attendant sa mise en ligne, n’utilisez pas gpt-6.1-sol à sa place pour vos évaluations — ce ne sont pas le même modèle.
🚀 Démarrage rapide : nous vous conseillons de commencer par faire tourner
claude-opus-5-5sur APIYI (apiyi.com) avec le quota gratuit, en notant la consommation de tokens de vos tâches. Une foisgpt-6.2-soldisponible, relancez le même lot de requêtes avec la même base URL en changeant uniquement le nom du modèle — vous pourrez ainsi comparer coûts et résultats des deux modèles dans un même tableau.
GPT-6.2 Sol ou Claude Opus 5.5 : nos recommandations pour choisir
💡 Conseil de choix : pour le protocole Claude et une disponibilité dès aujourd’hui, choisissez Claude Opus 5.5 ; pour un modèle du quotidien au tarif officiel plus bas, GPT-6.2 Sol mérite votre attention — sans prétendre pour autant que son score global est supérieur. En fin de compte, évaluez avec vos propres tâches : via l’interface unifiée d’APIYI (apiyi.com), les deux modèles partagent le même code d’invocation, il suffit de changer le nom du modèle pour basculer.
Concrètement, trois points méritent votre attention. Premièrement, alignez l’intensité de raisonnement des deux modèles lors de l’évaluation : les scores globaux des tiers sont obtenus au niveau maximal, alors qu’Opus tourne par défaut en medium — à niveaux différents, les scores comme la consommation de tokens changent. Deuxièmement, pour les tâches dont le préfixe d’invite est stable, intégrez le cache dans vos calculs : la lecture du cache coûte un vingtième du prix d’entrée des deux côtés, et un taux de succès élevé peut amplifier ou réduire l’écart sur la facture. Troisièmement, pour les tâches sur documents longs, chiffrez toujours à part les cas au-delà de 272K.
Questions fréquentes (FAQ)
Q1 : Quel est le positionnement respectif de GPT-6.2 Sol et de Claude Opus 5.5 ?
GPT-6.2 Sol est un modèle publié par OpenAI le 2026-11-17 : il prend du texte et des images en entrée, produit du texte et offre une fenêtre de contexte de 1 050 000. Son positionnement officiel mise sur l’efficacité pour le quotidien et les tâches de travail concrètes. Claude Opus 5.5 est un modèle d’Anthropic : fenêtre de contexte de 1M, sortie maximale de 128K et intensité de raisonnement par défaut réglée sur medium.
Q2 : Lequel est le plus performant, GPT-6.2 Sol ou Claude Opus 5.5 ?
Aucun score global ne permet de trancher. Dans l’indice composite d’Artificial Analysis (un tiers indépendant), Sol atteint 57 au niveau Max, tandis qu’Opus obtient 59 à son niveau le plus élevé. Du côté des résultats annoncés par OpenAI, Sol se distingue sur des benchmarks comme FrontierCode 2.0 ou LifeVal, mais les modèles de comparaison sont surtout ceux d’OpenAI eux-mêmes. Notre conseil : évaluez selon votre tâche, pas selon un score global.
Q3 : Peut-on déjà invoquer GPT-6.2 Sol via APIYI ?
Pas encore. Ni la liste complète des modèles d’APIYI (2026-11-17 15:54, UTC+8) ni l’endpoint public de tarification ne mentionnent `gpt-6.2-sol`. GPT-6.2 Sol n’est pas encore référencé ; nous le mettrons en ligne dès que possible. Pour les références et les prix, la liste des modèles de la plateforme fait foi.
Q4 : Quels sont le prix et les endpoints de Claude Opus 5.5 sur APIYI ?
`claude-opus-5-5` et `claude-opus-5-5-thinking` sont tous deux disponibles. Les tarifs affichés par la plateforme : 4 $ en entrée, 20 $ en sortie et 0,2 $ en lecture de cache (par million de tokens), avec prise en charge des endpoints chat et messages. Une seule et même clé API chez APIYI (apiyi.com) suffit pour les invoquer ; indiquez `https://api.apiyi.com/v1` comme base URL.
Q5 : Peut-on utiliser directement le coût de 1,01 $ par tâche de Sol pour faire ses calculs ?
Non. Les 1,01 $ correspondent au coût moyen mesuré par Artificial Analysis sur les tâches de l’indice composite, avec l’intensité de raisonnement Max ; ce chiffre ne vaut que pour ce benchmark précis. Vos tâches n’auront ni la même longueur ni la même consommation de raisonnement, votre coût sera donc différent. Le coût par tâche d’Opus 5.5 sur ce même indice n’apparaît dans aucune donnée de cet article : impossible donc de diviser l’un par l’autre.
Q6 : Quel est le lien entre GPT-6.2 Astra et Sol, et faut-il aussi l’envisager ?
Astra est un autre modèle issu de la même vague de lancement. Prix officiels en contexte court : 8 $ en entrée, 0,40 $ en lecture de cache et 40 $ en sortie ; son score à l’indice composite tiers dépasse celui de Sol. Chez APIYI, GPT-6.2 Astra n’est pas encore référencé ; nous le mettrons en ligne dès que possible. Pour les références et les prix, la liste des modèles de la plateforme fait foi. Cet article compare Sol et Opus 5.5, et la gamme de prix d’Astra se situe sur un autre segment.
Q7 : Existe-t-il d’autres modèles de comparaison dans la même gamme de prix ?
Vous pouvez regarder du côté de Gemini 4 Carbon. APIYI référence déjà `gemini-4-carbon` ; la page de la plateforme indique des tarifs de lancement : 2 $ en entrée, 0,1 $ en lecture de cache et 10 $ en sortie. Attention : à partir du 2026-12-01, les tarifs officiels de Google passent à 4 $ en entrée, 20 $ en sortie et 0,20 $ en lecture de cache. La page de la plateforme ne mentionne pas encore cette révision ; après le 1er décembre, fiez-vous à la liste des modèles d’APIYI (apiyi.com).
Q8 : Quelles sont les limites connues de GPT-6.2 Sol ?
La fiche officielle du modèle précise noir sur blanc qu’il ne prend pas en charge les entrées audio et vidéo, ni Realtime, ni Assistants, ni le fine-tuning, la génération d’images ou la synthèse vocale ; l’API refuse également de fixer l’effort de raisonnement sur none. D’après les données de tierces parties, il décroche 14 points de moins que GPT-6.1 Sol sur SWE-Atlas-QnA-AA et laisse passer plus facilement des faits essentiels. L’évaluation d’alignement officielle note elle aussi que la série 6.2, sur deux tests, omet plus souvent de signaler des problèmes bloquants comme un fichier manquant ou un outil de recherche indisponible.
GPT-6.2 Sol et Claude Opus 5.5 : les points clés (Key Takeaways)
- Score global : au niveau de raisonnement le plus élevé des benchmarks tiers, Sol (Max) obtient 57, Opus 5.5 obtient 59 — un écart de 2 points.
- Tarifs officiels : Sol facture $2 en entrée, $10 en sortie et $0.10 en lecture de cache ; Opus, $4, $20 et $0.20.
- Long contexte : dès que l’entrée d’une requête Sol dépasse 272K, l’ensemble de la facturation est majoré — entrée et cache au double, sortie à 1,5 fois le prix.
- Méthodologies distinctes : les auto-évaluations officielles et les benchmarks de tierces parties ne portent ni sur les mêmes tâches ni sur les mêmes niveaux de raisonnement — impossible de tout fusionner en une seule conclusion.
- Disponibilité actuelle : Opus 5.5 est déjà en vente sur APIYI ; Sol n’y figure pas encore — fiez-vous à la liste des modèles de la plateforme.
- Comment choisir : pour le protocole Claude et une disponibilité immédiate, prenez Opus ; pour les tâches courantes sensibles au prix unitaire, évaluez d’abord Sol.
Résumé
Le choix entre GPT-6.2 Sol et Claude Opus 5.5 peut se résumer en trois points :
- Regardez les scores et les prix ensemble : Sol affiche un score composite inférieur de 2 points dans les évaluations tierces, et son prix officiel en contexte court représente environ la moitié de celui d’Opus ; aucun de ces deux éléments, pris isolément, ne suffit à trancher.
- Choisissez selon la tâche et le protocole : pour les tâches qui reposent sur le protocole Claude ou qui doivent être mises en production sans attendre, optez pour Opus 5.5 ; pour les tâches du quotidien sensibles au prix unitaire, dont les requêtes restent le plus souvent sous 272K, il vaut la peine d’évaluer d’abord Sol.
- Faites le calcul avec vos propres tâches : le coût par tâche des évaluations tierces ne vaut que pour ce banc d’essai précis ; votre coût réel dépend de votre consommation de tokens, de votre taux de hits en cache et de l’intensité de raisonnement.
À ce stade, l’approche la plus pragmatique consiste à mettre en place votre processus d’évaluation avec Opus 5.5, puis à compléter avec une passe comparative sur le même lot de requêtes dès que Sol sera disponible. Nous recommandons de passer par APIYI (apiyi.com) pour gérer plusieurs modèles à la fois avec une seule clé API : le quota gratuit suffit largement pour boucler une première validation.
📚 Références
-
Annonce officielle d’OpenAI : notes de publication de GPT-6.2 Astra et Sol, ainsi que les évaluations officielles auto-déclarées
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Détails : synthèse des tarifs affichés, périmètre de disponibilité et différentes comparaisons officielles auto-déclarées
- Lien :
-
Page du modèle gpt-6.2-sol d’OpenAI : spécifications, endpoints et règles tarifaires complètes
- Lien :
platform.openai.com/docs/models/gpt-6.2-sol - Détails : prix d’écriture en cache, règle des 272K applicable à l’ensemble de la requête, multiplicateurs de prix Batch / Fast / Ultrafast
- Lien :
-
System Card d’OpenAI : évaluations de sécurité et d’alignement
- Lien :
deploymentsafety.openai.com/gpt-6-2-astra-sol - Détails : niveaux du Preparedness Framework et conclusions des tests d’alignement
- Lien :
-
Article d’évaluation tiers d’Artificial Analysis : résultats de l’Intelligence Index v5.0.1
- Lien :
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Détails : scores composites par palier de raisonnement, indices détaillés et comparaison avec le palier maximal d’Opus 5.5
- Lien :
-
Page du modèle GPT-6.2 Sol d’Artificial Analysis : coût par tâche et autres métriques
- Lien :
artificialanalysis.ai/models/gpt-6-2-sol - Détails : coût par tâche de l’indice composite : $1.01 (palier Max)
- Lien :
-
Documentation des modèles Claude : spécifications d’Opus 5.5 et tarifs officiels
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - Détails : prix d’entrée et de sortie d’Opus 5.5, fenêtre de contexte et intensité de raisonnement par défaut
- Lien :
Auteur : équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; les informations les plus récentes sur les modèles et leurs tarifs figurent dans le tableau récapitulatif des modèles du centre de documentation docs.apiyi.com