Note de l’auteur : en prenant pour exemple une demande de contrôle qualité du service client, nous décortiquons la validation des sorties, la conservation de l’état de session et la récupération des résultats en arrière-plan de GPT-6.2 Sol dans la Responses API.
Commençons par la conclusion : pour brancher GPT-6.2 Sol dans un système de production, il faut découper une même tâche métier en quatre comportements et définir pour chacun des critères d’acceptation. Ces quatre comportements sont le retour immédiat dans l’interface, le résultat exploitable par la machine et stockable en base, le contexte entre les tours et l’état final. Les événements en streaming ne servent qu’à l’affichage ; avant toute écriture en base, il faut obtenir la réponse complète et réussir la validation du schéma et les contrôles métier. Pour les informations échangées entre les tours, il faut d’abord décider qui détient l’état. Les tâches en arrière-plan ne s’appuient que sur l’ID de réponse et l’état terminal ; les notifications pouvant être dupliquées, l’écriture doit être idempotente.
Pour respecter ces quatre points, il y a deux prérequis. Premièrement, si vous avez besoin d’outils intégrés ou personnalisés, suivez les notes de migration GPT-6.2 pour adopter la Responses API ; cet article ne traite lui aussi que du comportement d’exécution de Responses. Deuxièmement, si vous passez par une plateforme d’agrégation, la disponibilité du mode arrière-plan, des Webhooks et d’autres capacités dépend de la configuration actuelle de la plateforme. Sur APIYI apiyi.com, gpt-6.2-sol est déjà référencé publiquement avec deux entrées, responses et chat.
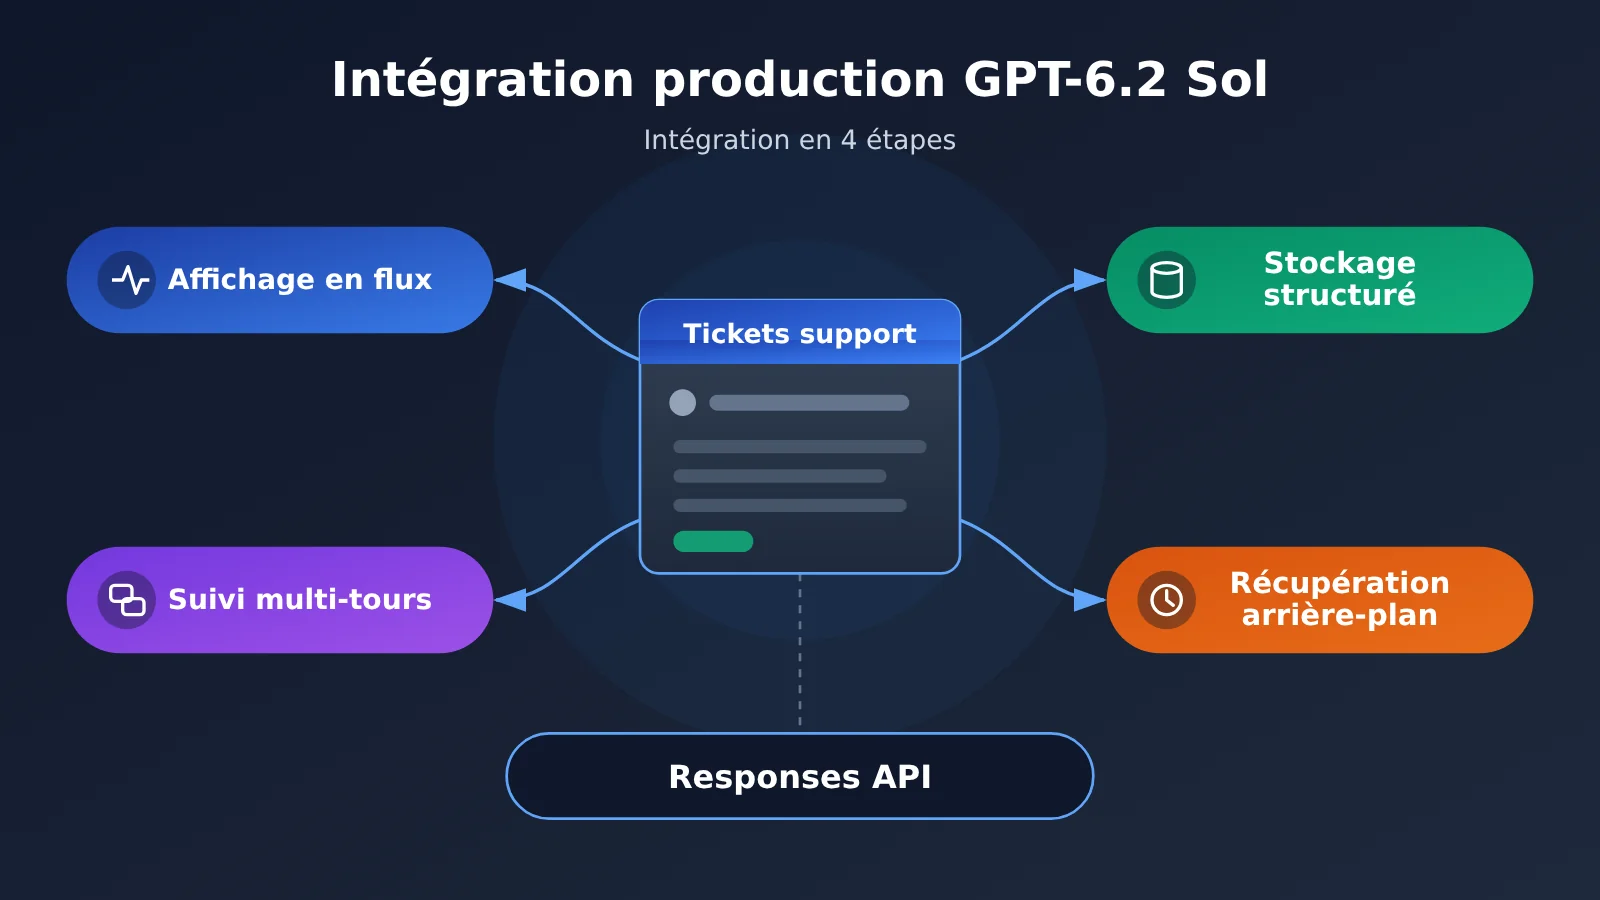
Carte des connaissances pour l’intégration en production de GPT-6.2 Sol
Tout l’article s’articule autour d’un seul flux : lancer la requête → afficher → poursuivre → relire → valider. Le diagramme ci-dessous indique les productions de chaque étape ainsi que le numéro de section correspondant dans le texte.
Lancer la requête (model=gpt-6.2-sol, Responses API)
  │
  ├─▶ Afficher【section 1】
  │     événements incrémentaux → la page affiche en temps réel les avis de contrôle qualité
  │     événement final → fin du chargement ; réponse complète → Schema + validation métier → écriture en base / revue manuelle
  │
  ├─▶ Poursuivre【section 2】
  │     historique auto-géré / previous_response_id / Conversation
  │     séparation entre règles permanentes (developer) et consignes du tour (instructions)
  │
  ├─▶ Relire【section 3】
  │     soumission background → enregistrer l'ID de réponse → Webhook : vérification de signature et déduplication → relecture par ID → enregistrer l'état final
  │
  └─▶ Valider【section 4】
        succès / incomplet / notification en double / coupure client / changement de Schema
Index d’intégration GPT-6.2 Sol
| Section | Question à laquelle elle répond | Ce qu’elle apporte à la suite | Ce que vous saurez faire après lecture |
|---|---|---|---|
| 1. Streaming et structuration | Comment la page lit le flux, comment la machine récupère le résultat | Définit le critère de « terminé » et de « stockable » | Distinguer le chemin d’affichage du chemin d’écriture en base |
| 2. État multi-tours | Comment la requête suivante se raccroche au tour précédent | Détermine qui détient l’état et les conditions de conservation | Ne modifier que le focus du tour sans casser le préfixe |
| 3. Tâches en arrière-plan | Comment le résultat est enregistré en base une fois l’utilisateur parti | Correspondance entre ID de réponse, ID de tâche et état final | Mettre en place vérification de signature, déduplication et écriture idempotente |
| 4. Validation de mise en production | Quels comportements doivent être vérifiés à l’avance | Rassemble les critères des trois premières sections | Produire un journal de régression traçable |
Les sections 1 à 3 correspondent chacune à un chemin d’exécution. Si vous n’en implémentez qu’un seul, consultez celle qui vous concerne. La section 4 dépend des états définis dans les trois premières : il vaut mieux la lire en dernier.
Termes à connaître pour GPT-6.2 Sol
| Terme | Explication |
|---|---|
| SSE | Protocole par lequel le serveur pousse des événements au client dans l’ordre, sur une seule connexion HTTP. |
| Structured Outputs | Fonctionnalité de l’API qui exige que le contenu structuré renvoyé en cas de succès respecte un JSON Schema pris en charge. |
| Réponse de refus | Élément de contenu renvoyé lorsque le modèle refuse explicitement d’accomplir la tâche ; il nécessite un traitement séparé. |
| État de conversation | Contexte conservé pour les requêtes suivantes : messages, résultats d’outils, etc. |
| Élément de raisonnement chiffré | Élément de réponse chiffré servant à poursuivre l’état de raisonnement, qui peut être renvoyé avec le contexte. |
| Préfixe | La séquence de contexte, au début de la requête courante, strictement identique à celle du tour précédent. |
| Fenêtre d’achèvement | Plage de temps cible fixée par le service pour l’achèvement de cette réponse, après acceptation d’une requête en arrière-plan. |
| Webhook | Notification signée que le serveur envoie activement à une URL désignée par l’application. |
| État final | État d’une tâche après achèvement, échec, incomplétude ou annulation. |
| Idempotence | Propriété d’un rappel ou d’une tâche qui, même traité plusieurs fois, ne produit qu’un seul effet métier. |
1. Sortie en streaming et validation structurée de GPT-6.2 Sol
1.1 Les deux chemins de sortie de GPT-6.2 Sol
Commençons par un scénario de contrôle qualité du service client. Un agent de permanence ouvre un ticket, et la page doit afficher immédiatement l’avis de supervision produit par le modèle. Le résultat de la même analyse doit aussi être enregistré dans la base de contrôle qualité, pour les statistiques de fin de journée. Ces deux besoins ont une définition différente de ce que signifie « terminé », il faut donc les traiter via deux chemins distincts.
| Chemin | Consommateur | Signal utilisé | Condition pour considérer « terminé » | Que faire en cas d’échec |
|---|---|---|---|---|
| Chemin d’affichage | Page de l’agent | Événements incrémentaux response.output_text.delta |
Réception de response.completed ou d’un événement terminal d’échec |
Message sur la page, on conserve le contenu déjà affiché |
| Chemin d’enregistrement | Base de données de contrôle qualité | Objet de réponse complet | Validation du schéma et validation métier réussies | Rejet, réponse incomplète et format invalide passent respectivement en revue manuelle |
Quand une requête en streaming définit stream=true, le serveur pousse les événements successivement via HTTP SSE. La page n’a qu’à ajouter à l’affichage le texte contenu dans response.output_text.delta. L’état de chargement doit attendre l’événement terminal pour se terminer : l’arrêt du texte ne signifie pas que la tâche est terminée.
1.2 Exemple d’affichage en streaming avec GPT-6.2 Sol
L’exemple ci-dessous sert uniquement à la démonstration. Il transmet le texte incrémental au frontend et met fin à l’attente lors de l’état final :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Point d'entrée compatible OpenAI d'APIYI
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # Ajout en temps réel à la page
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # Terminer le chargement avec l'état final
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # Signaler séparément les échecs et les réponses incomplètes
push_to_page, finish_loading et autres sont des fonctions côté métier. Pour la liste complète des événements d’état final, la documentation officielle sur les réponses en streaming fait référence.
1.3 Ordre de validation des sorties structurées avec GPT-6.2 Sol
Dans la Responses API, les sorties structurées se déclarent dans text.format, et non dans les messages. Une fois la réponse complète reçue, le chemin d’ingestion applique l’ordre de décision suivant :
- Vérifier l’état de la réponse. Une réponse incomplète (
statusvalantincomplete) part directement en revue manuelle ; on n’essaie pas de parser un JSON tronqué. - Vérifier les éléments de contenu. Si un élément de contenu de type refus apparaît, suivre le processus de refus et ne pas le traiter comme une erreur de format.
- Parser le JSON et effectuer la validation du schéma.
- Effectuer les contrôles métier : le ticket d’origine existe, les champs manquants doivent être clairement visibles et ne doivent pas être complétés silencieusement.
Voir le code complet d’ingestion structurée pour GPT-6.2 Sol
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
À noter : la validation du schéma indique seulement que la structure est correcte, pas que le contenu l’est. La présence du numéro de ticket, le fait que les champs manquants soient signalés fidèlement, etc. : tous ces contrôles doivent être effectués dans la couche métier.
🎯 Conseil technique : dans un environnement de test, vous pouvez lancer simultanément des requêtes en streaming et non streaming via APIYI apiyi.com, puis comparer l’état final et le résultat d’ingestion du même ticket sur les deux chemins. Cela permet de vérifier à l’avance que la logique de chargement côté frontend et les branches d’ingestion n’interfèrent pas entre elles.
2. Persistance de l’état des conversations multi-tours avec GPT-6.2 Sol
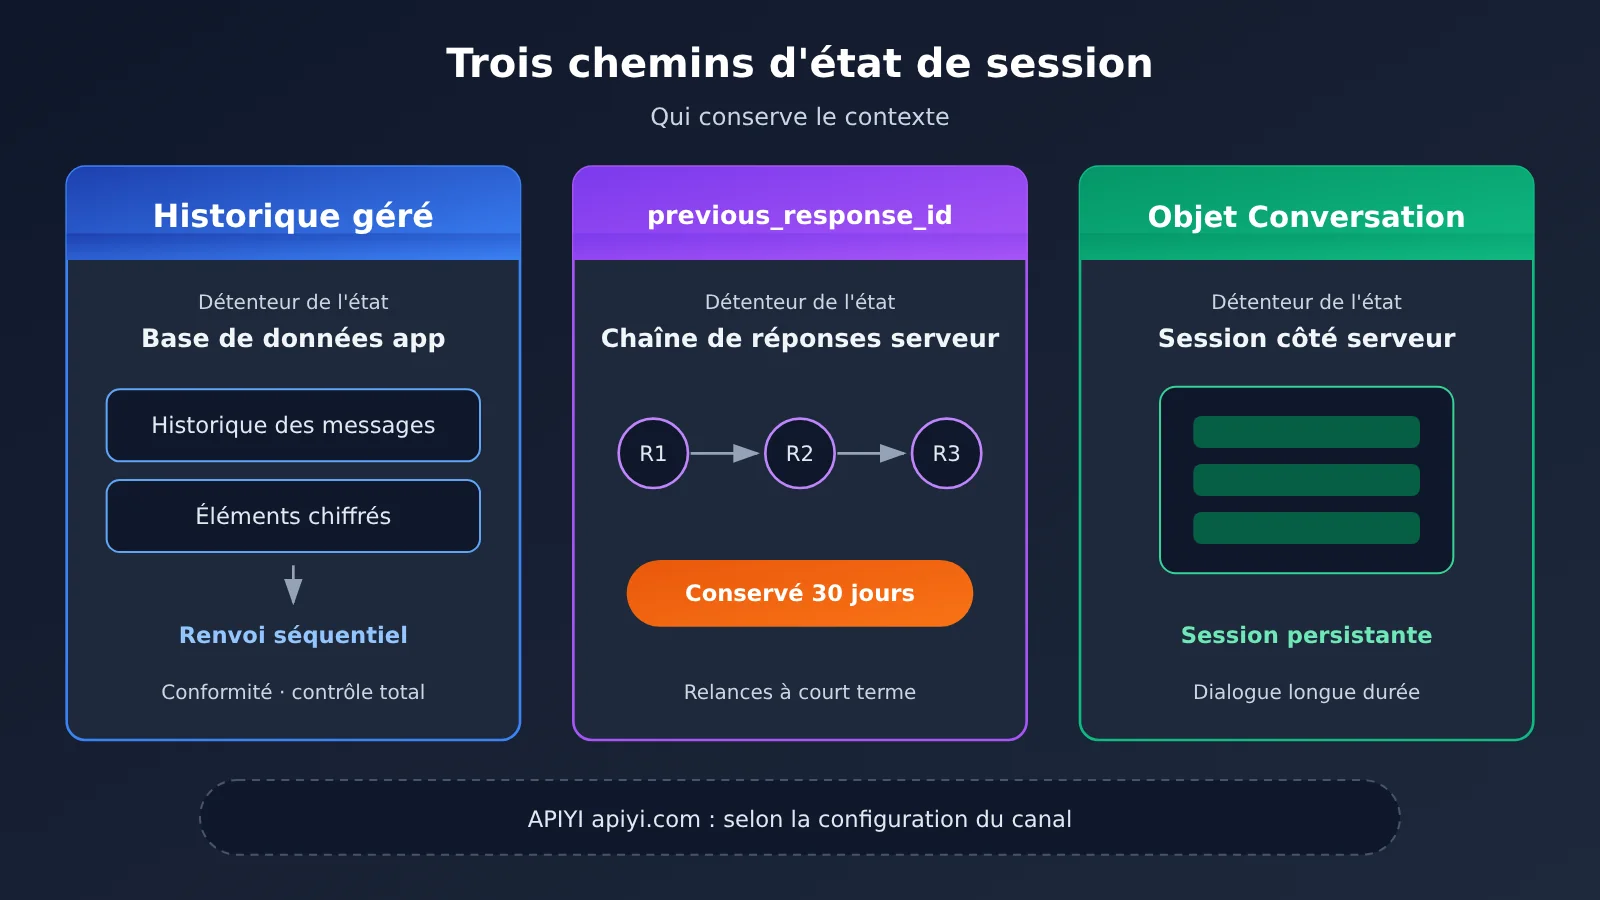
2.1 Comparaison des trois chemins d’état de GPT-6.2 Sol
L’agent ajoute de nouveaux faits sur le même ticket et souhaite que le modèle poursuive l’analyse là où le tour précédent s’était arrêté. La première question à trancher est alors : qui conserve le contexte ?
| Chemin | Détenteur de l’état | Conditions de conservation | Cas d’usage | Plateformes disponibles |
|---|---|---|---|---|
| Historique auto-géré | L’application elle-même | Décidé par l’application ; il faut renvoyer les messages et les éléments de réponse nécessaires dans l’ordre d’origine | Exigences de conformité, ou besoin de contrôler entièrement le contexte | API officielle, APIYI apiyi.com |
previous_response_id |
Chaîne de réponses côté serveur | La reprise n’est possible que tant que la réponse est disponible ; les objets de réponse sont conservés 30 jours par défaut | Questions de suivi sur un cycle court | Selon la configuration actuelle du canal |
| Objet Conversation | Objet de session côté serveur | Les entrées rattachées à une Conversation suivent les règles de conservation de cet objet | Conversations nécessitant une conservation plus durable | Selon la configuration actuelle du canal |
Si vous optez pour l’historique auto-géré tout en voulant que le raisonnement reste continu, vous ne pouvez pas vous contenter de renvoyer le texte. Tous les éléments de réponse nécessaires doivent être conservés et rejoués dans l’ordre, y compris les éléments de raisonnement chiffrés.
2.2 GPT-6.2 Sol : modifier uniquement le point focal de l’audit
Imaginons qu’au deuxième tour, vous vouliez seulement déplacer le point focal de l’audit de la « rapidité de réponse » vers la « conformité des scripts ». La bonne méthode : placez les règles de contrôle qualité génériques dans le premier message developer de la chaîne, et écrivez le focus propre à ce tour dans instructions, au niveau supérieur. instructions ne s’applique qu’à la requête qui le fournit et ne pollue pas les tours suivants.
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # ne s'applique qu'à cette requête
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
Cette approche présente un autre avantage : la première règle reste inchangée, et le préfixe reste stable lui aussi.
2.3 GPT-6.2 Sol : le risque de changement de préfixe
GPT-6.2 peut effacer les éléments de raisonnement concernés dans plusieurs situations : réécriture de l’historique existant, changement partiel de modèle (par exemple un passage à une version inférieure), ou changement d’utilisateur ou d’organisation. Pour une session Standard à agent unique que vous souhaitez poursuivre, si vous devez ajuster le niveau de raisonnement ou le schéma de sortie, ajoutez plutôt un élément configuration_update applicable, au lieu de revenir modifier l’ancienne configuration. Pour les champs exacts de cet élément, référez-vous au guide de migration GPT-6.2.
Quand une règle de long terme doit être mise à jour, ajoutez un nouveau message developer à la fin du contexte : ne modifiez pas l’ancienne règle, et ne touchez pas non plus à la configuration précédente des outils et du schéma. Même si le préfixe reste stable, le fait qu’un cache soit touché dépend toujours de la requête précise et des conditions de traitement — on ne peut pas le considérer comme un résultat garanti.
3. Persistance des tâches en arrière-plan de GPT-6.2 Sol
3.1 Soumission en arrière-plan et fenêtre de complétion de GPT-6.2 Sol
Le résumé des tickets en attente de validation en fin de journée peut prendre du temps, et les agents ne restent pas devant la page. Pour ce type de tâche, soumettez avec background: true. Enregistrez immédiatement l’ID de réponse renvoyé et faites-le correspondre un à un avec l’ID de tâche métier.
Choisissez la fenêtre de complétion en fonction du temps d’attente acceptable ; la valeur par défaut est soonest. 2h et 8h sont des fenêtres à tarif réduit sous Standard ; elles sont actuellement en bêta publique et ne permettent pas d’activer le streaming au moment de la soumission. Les noms de paramètres et les exigences de stockage de la fenêtre de complétion suivent la documentation du mode arrière-plan.
| Fenêtre de complétion | Positionnement | Streaming | Tâches de contrôle qualité adaptées |
|---|---|---|---|
soonest (par défaut) |
Finalisation dès que possible | Voir la doc du mode arrière-plan | Vérifications à revoir pendant le service |
2h |
Fenêtre à tarif réduit Standard, en bêta publique | Non activé | Récapitulatif de fin de service |
8h |
Fenêtre à tarif réduit Standard, en bêta publique | Non activé | Résumés par lots de fin de journée |
3.2 Vérification de signature, déduplication et relecture des Webhooks GPT-6.2 Sol
Lorsque la tâche est en file d’attente ou en cours, il suffit d’interroger régulièrement le même ID. Si vous recevez un événement de complétion, procédez dans l’ordre suivant :
- Vérifiez la signature. En cas d’échec, ignorez directement.
- Dédupliquez avec
webhook-id. Une même notification peut être rediffusée. - Relisez la réponse complète à partir de
event.data.id. La notification elle-même ne sert pas de résultat. - Écrivez l’état final et le résultat de manière idempotente, par ID de tâche.
Voir le code de récupération des tâches en arrière-plan de GPT-6.2 Sol
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# soumission
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# traitement du webhook
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # vérification de la signature, lève une exception en cas d'échec
    if db.seen_webhook(headers["webhook-id"]):         # déduplication
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # relecture de la réponse complète
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # écriture idempotente par ID de tâche
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
Quand l’utilisateur ferme la page puis revient, le front-end n’a qu’à interroger la base locale avec l’ID de tâche métier. Si l’état n’est pas encore final, le serveur continue d’interroger avec l’ID de réponse déjà enregistré.
Faites particulièrement attention à la conservation des données. Pour permettre la relecture, le mode arrière-plan conserve temporairement les données de réponse. Et cela ne change pas même si vous avez défini store: false ou si l’organisation a activé ZDR : vérifiez donc dans la documentation sur le contrôle des données si c’est acceptable.
💡 Conseil d’intégration : l’adresse de callback Webhook et le mode arrière-plan nécessitent le support du côté du canal. Avant de vous connecter via APIYI apiyi.com, vérifiez d’abord si le groupe de compte actuel ouvre bien le mode arrière-plan et les capacités de callback. Si ce n’est pas encore disponible, vous pouvez d’abord faire tourner la machine d’état avec un polling sur l’ID de réponse.
4. Liste de vérification avant mise en production de GPT-6.2 Sol
4.1 Tableau d’acceptation synthétique de GPT-6.2 Sol
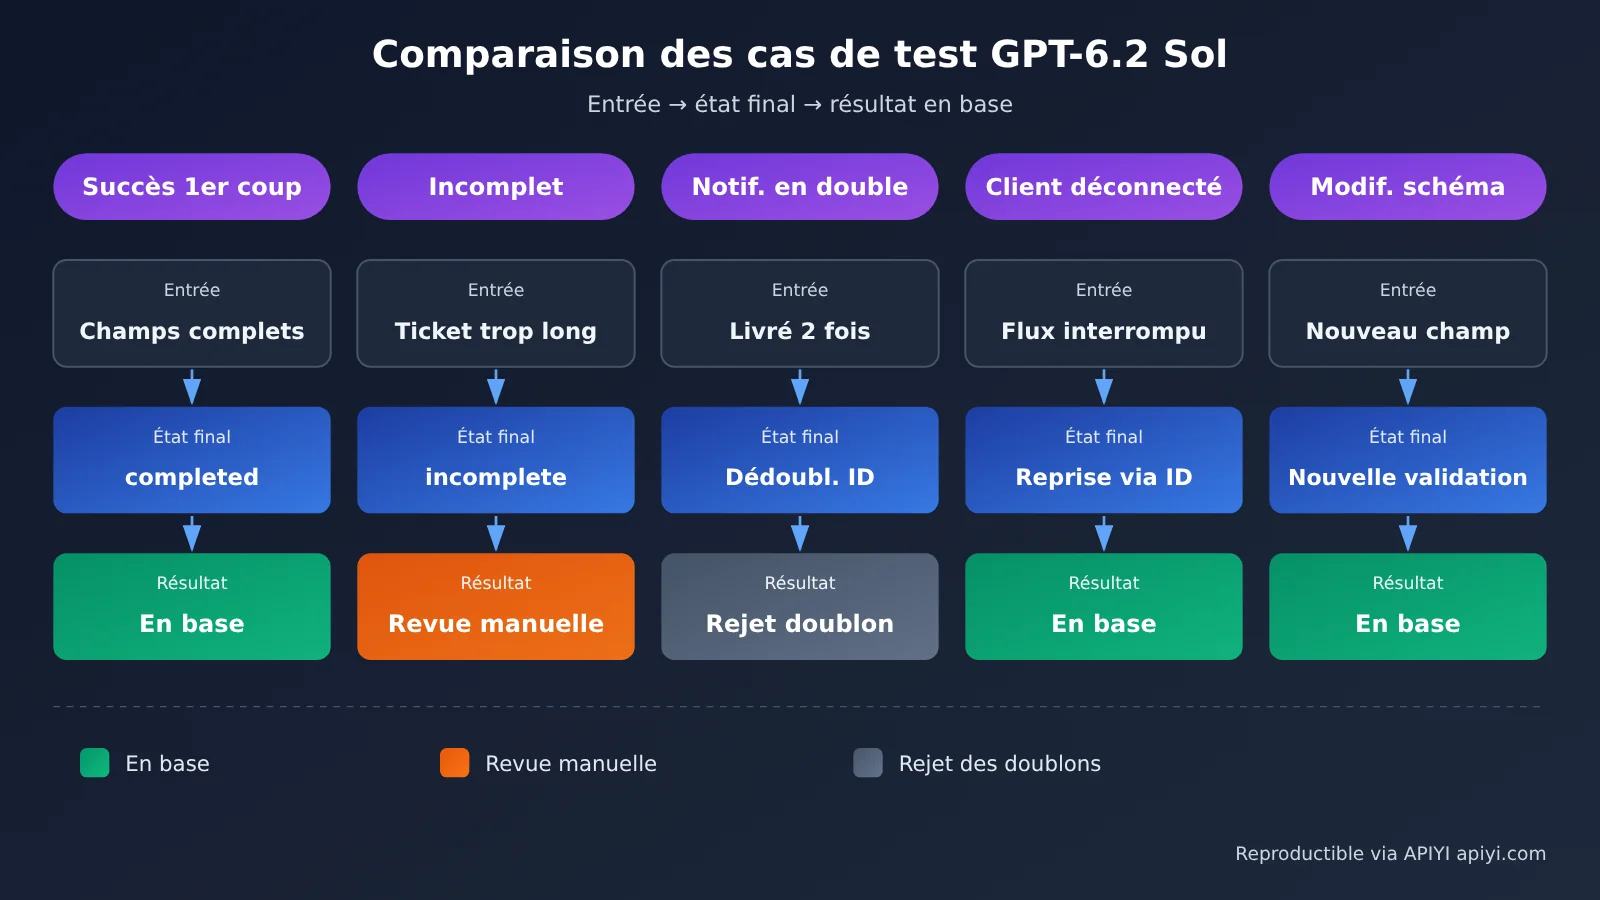
Le tableau d’acceptation reprend le cas synthétique de contrôle qualité du service client et décline les critères des trois sections précédentes en cas de test exécutables.
| Cas de test | Condition d’entrée | État ou résultat attendu |
|---|---|---|
| Succès au premier essai | Ticket réel existant, champs complet | État final completed ; validation du schéma et des règles métier réussie ; écriture d’un résultat par ID de tâche |
| Réponse incomplète | Plafond de sortie artificiellement réduit, ou ticket très long | État incomplete ; aucun parsing JSON ; passage en revue humaine avec motif consigné |
| Notification en double | Même webhook-id livré deux fois |
Deuxième occurrence dédupliquée ; une seule ligne dans la table de résultats |
| Déconnexion du client | Connexion du navigateur coupée pendant le flux | État restauré via l’ID de réponse enregistré ; le résultat en base ne dépend pas de la page |
| Modification du schéma | Ajout d’un champ obligatoire en cours de session | Ajustement via une mise à jour de configuration additive, sans réécrire l’ancienne configuration ; les nouveaux résultats sont validés selon le nouveau schéma |
Chaque cas de test doit conserver quatre informations : l’ID du modèle appelé (gpt-6.2-sol), les paramètres d’exécution, l’ID de réponse et la version de configuration côté application. En cas de problème, ces quatre éléments permettent d’identifier la requête précise.
4.2 Cadre de référence pour les régressions de GPT-6.2 Sol
| Élément | Contenu à enregistrer | Explication |
|---|---|---|
| Modèle | gpt-6.2-sol |
Référencer l’ID public de la fiche modèle |
| Point de terminaison | Responses | Les appels de fonction et les outils intégrés passent par ce chemin |
| Niveau de raisonnement | Niveau effectivement utilisé | Responses et Chat Completions n’acceptent pas none |
| Consommation | usage.output_tokens et la sous-composante des tokens de raisonnement |
La facturation de sortie inclut déjà les tokens de raisonnement |
| Changement de palier de facturation | Si l’entrée d’une requête dépasse 272K | L’interface de tarification publique d’APIYI applique un changement de palier à 272,000 tokens d’entrée ; la facture réelle fait foi |
Lors de la migration d’un ancien système, vérifier séparément le point de terminaison, les paramètres de requête, les entrées multi-tours, le contexte de raisonnement et le cache. Une fois ces vérifications terminées, faire régresser ensemble les requêtes d’exemple et les requêtes de production sur la même série de cas.
🚀 Conseil de validation : les cinq catégories de cas peuvent être ajoutées à la CI et exécutées automatiquement à chaque modification du schéma ou changement de canal. Avec la clé API unifiée d’APIYI apiyi.com, vous pouvez comparer les différences de comportement entre groupes sur la même série de cas.
Si les cinq cas du tableau d’acceptation passent tous et que chacun peut être retracé par son ID de réponse, la chaîne de contrôle qualité est prête pour la mise en production.
Références
- Fiche modèle GPT-6.2 Sol : ID du modèle, fenêtre de contexte et règles de facturation
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol
- Lien :
- Guide de migration GPT-6.2 : choix des endpoints, changements de préfixe et mise à jour de la configuration
- Lien :
developers.openai.com/api/docs/guides/latest-model
- Lien :
- Réponses en streaming et sortie structurée : événements SSE et
text.format- Lien :
developers.openai.com/api/docs/guides/streaming-responses
- Lien :
- État de la session :
previous_response_idet Conversations- Lien :
developers.openai.com/api/docs/guides/conversation-state
- Lien :
- Mode arrière-plan et Webhook : fenêtre d’achèvement, vérification de signature et déduplication
- Lien :
developers.openai.com/api/docs/guides/background
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com