Note de l’auteur : ce texte sépare clairement les scores composites tiers, les tarifs officiels, la lecture du cache et les comparaisons individuelles entre GPT-6.2 Sol et Claude Fable 5.2, en expliquant quels chiffres se comparent directement et lesquels ne peuvent pas se résumer à un « qui est le plus fort ».
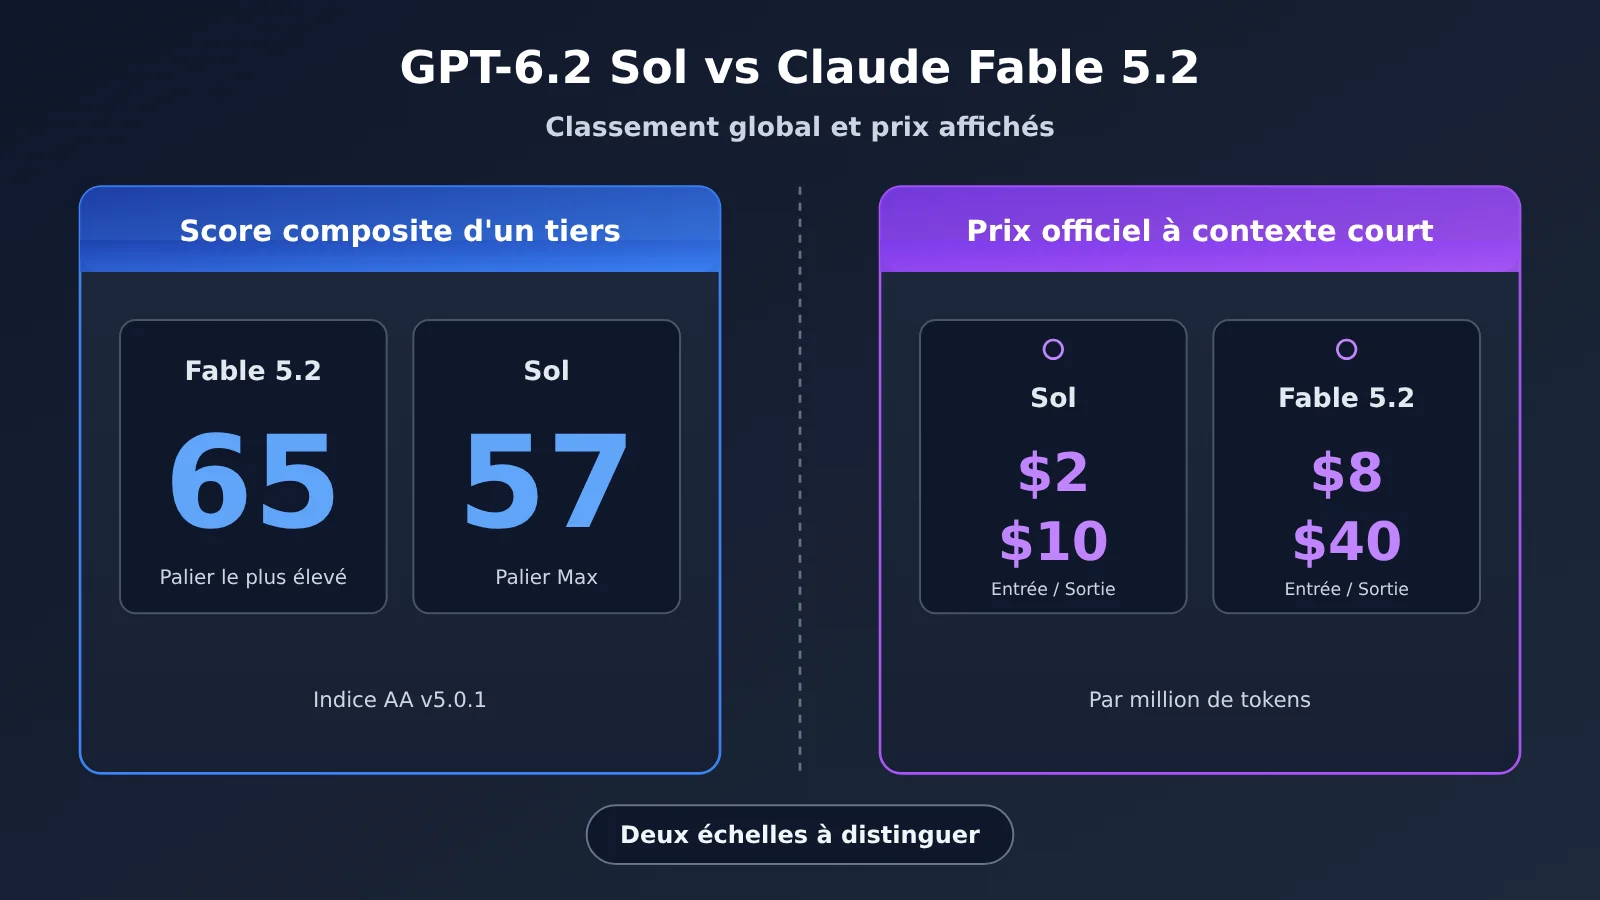
Quand on compare GPT-6.2 Sol et Claude Fable 5.2, le piège le plus courant consiste à faire passer tous les chiffres sous un unique « qui est le plus fort ». Le 17 novembre 2026, OpenAI a lancé GPT-6.2 Astra et GPT-6.2 Sol, et l’organisme indépendant Artificial Analysis a actualisé le classement composite le jour même : Claude Fable 5.2 obtient 65 points dans son niveau de raisonnement le plus élevé, GPT-6.2 Sol atteint 57 points au niveau Max. En parallèle, d’après les tarifs officiels en contexte court des deux fournisseurs, les prix unitaires d’entrée comme de sortie de Sol représentent le quart de ceux de Fable.
L’écart de score est grand, l’écart de prix l’est aussi : les deux sont réels, mais ils ne se compensent pas et ne peuvent pas être réduits à une seule conclusion. Cet article n’est pas là pour prendre parti à votre place. Chiffres officiels auto-déclarés, classements tiers et grilles tarifaires des éditeurs relèvent de trois méthodologies distinctes ; nous les démêlons couche par couche et listons à part les tests individuels qui, en réalité, ne disposent d’aucune comparaison officielle directe entre Sol et Fable.
Valeur ajoutée : à la fin de cet article, vous aurez en main trois jeux de chiffres vérifiables — score composite, tarifs, lecture du cache —, vous saurez quels tests individuels ne doivent pas servir de comparaison Sol contre Fable, et vous pourrez décider, selon votre tâche, quel côté consulter en premier.
Points essentiels de GPT-6.2 Sol et Claude Fable 5.2
Le tableau ci-dessous livre d’abord les chiffres au niveau des conclusions ; chaque ligne précise la source et la façon de la lire. Les sections suivantes reviennent sur chaque ligne en détail.
| Point clé | Chiffre | Source et lecture |
|---|---|---|
| Score composite | Fable 5.2 obtient 65, Sol (Max) 57 | Indice tiers Artificial Analysis Intelligence Index v5.0.1, au palier de raisonnement le plus élevé de chacun |
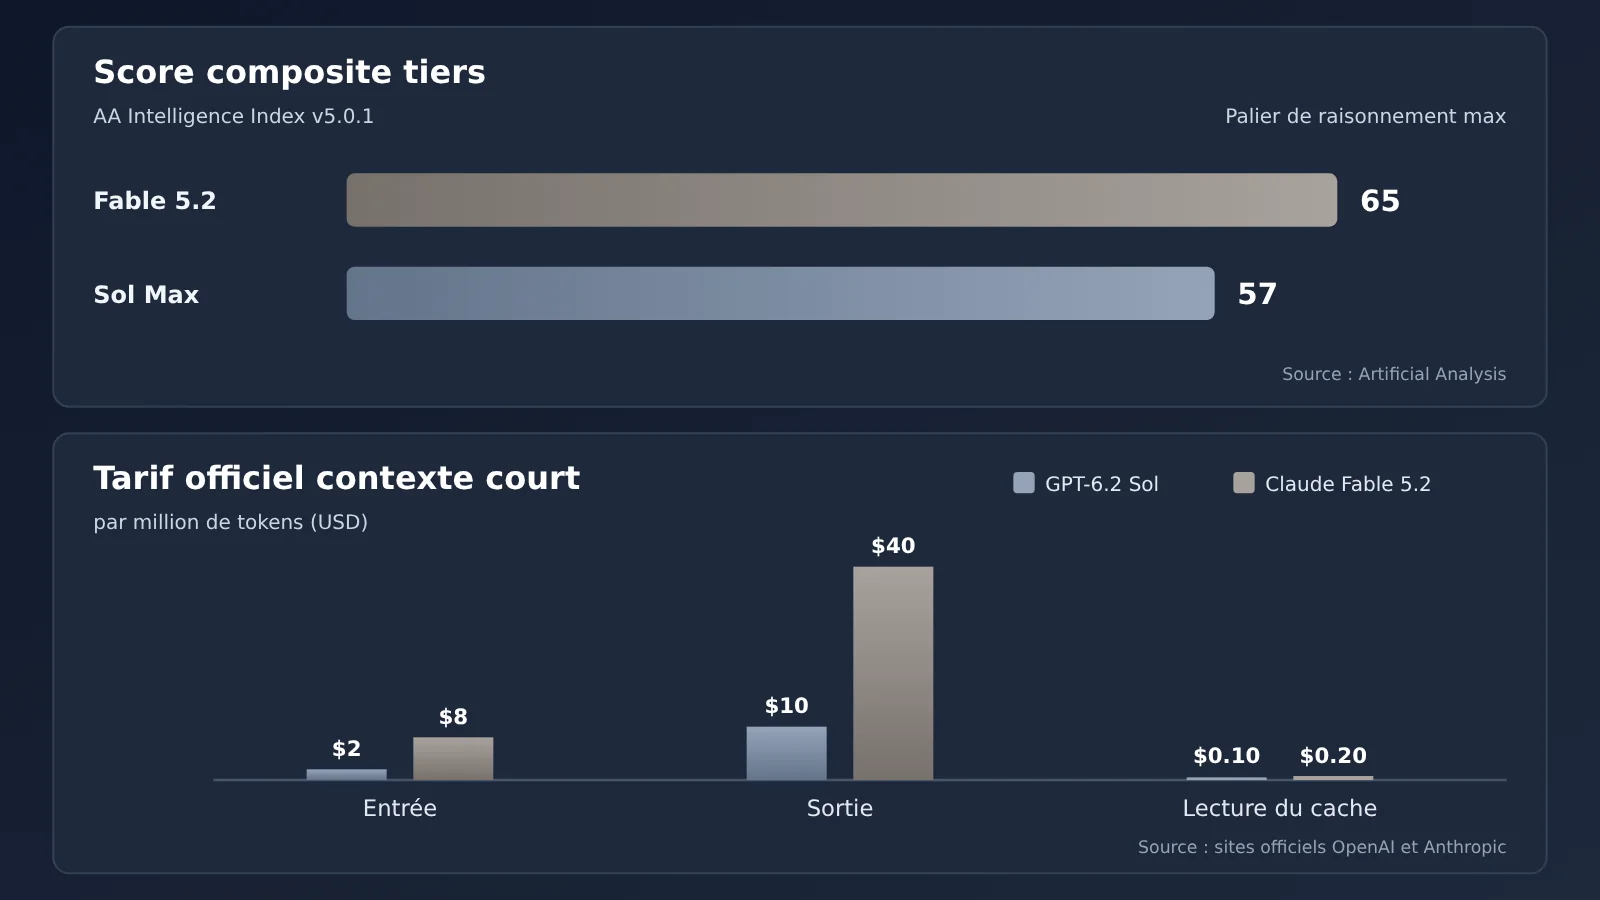
| Tarifs entrée/sortie en contexte court | Sol $2 / $10, Fable $8 / $40 (par million de tokens) | Tarifs officiels des deux fournisseurs ; Sol revient à un quart de Fable, mais uniquement pour ces deux postes |
| Tarif de lecture du cache | Sol $0.10, Fable $0.20 | Tarifs officiels ; Sol coûte la moitié de Fable, pas un quart |
| Comparaison directe dans les documents officiels | Elo de l’évaluation humaine en aveugle AA-3D : Sol 1259, Fable 1271 | Retranscription officielle ; les autres résultats officiels comparent le plus souvent Astra à Fable, ou Sol aux anciens modèles maison |
| Disponibilité chez APIYI | claude-fable-5-2 est déjà en ligne ; gpt-6.2-sol ne l’est pas encore |
La liste des modèles de la plateforme fait foi |
Concernant le tarif de GPT-6.2 Sol mentionné dans le tableau : il s’agit des tarifs officiels d’OpenAI ; le modèle n’est pas encore proposé sur notre plateforme, nous l’ajouterons dès que possible ; seuls les modèles et les prix listés sur la plateforme font foi.
Pourquoi la comparaison entre GPT-6.2 Sol et Claude Fable 5.2 doit se faire par niveaux
Un indice composite condense des dizaines de tâches en un seul score : il répond à la question « à quel niveau global se situent-ils à peu près », mais pas à « lequel convient mieux à ma tâche ». Les tarifs indiquent combien coûte un million de tokens, ce qui ne dit rien du coût réel d’une tâche, car le palier de raisonnement, le nombre de tokens de réflexion et le taux de hits du cache changent la facture finale des deux côtés.
Les tâches individuelles, elles, constituent un troisième niveau. Dans le communiqué d’OpenAI, les résultats individuels cités pour Fable sont comparés pour la plupart à GPT-6.2 Astra, et non à Sol. Attribuer à Sol les résultats d’Astra est l’erreur d’interprétation la plus fréquente dans ce type de comparaison ; cet article prendra soin de les distinguer clairement.
GPT-6.2 Sol vs Claude Fable 5.2 : les différences clés
Le score composite indépendant de GPT-6.2 Sol et de Claude Fable 5.2
Artificial Analysis est un organisme d’évaluation tiers ; les chiffres ci-dessous ne sont donc pas auto-déclarés par OpenAI ou Anthropic. L’organisme attribue à chaque modèle un score sur l’Intelligence Index v5.0.1 selon son niveau de raisonnement — quand vous comparez, précisez toujours quel niveau est utilisé.
| Modèle | Niveau de raisonnement | Intelligence Index v5.0.1 | Coût par tâche sur l’indice composite (d’après la page de chaque modèle) |
|---|---|---|---|
| Claude Fable 5.2 | Niveau de raisonnement le plus élevé | 65 (1re place du classement) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00 (Max) |
| Gemini 4 Carbon | Niveau le plus élevé | 60 | — |
| Claude Opus 5.5 | Niveau le plus élevé | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
Selon Artificial Analysis, Sol gagne 2 points par rapport à GPT-6.1 Sol et atteint 57, à égalité avec GPT-6 Astra, avec un coût par tâche d’environ 15 % de celui de ce dernier. Le « coût par tâche » du tableau correspond à ce que le tiers a dépensé en exécutant cet indice : il reflète la combinaison du niveau de raisonnement, de la longueur de réflexion et du tarif affiché — et non le prix API officiel.
À noter : OpenAI indique officiellement que le coût d’Astra sur Agents’ Last Exam représente environ 5 % de celui de Fable — mais il s’agit d’un autre ensemble de tâches. Impossible donc de convertir $26.54 en ce « 5 % » officiel (ou l’inverse), et encore moins d’appliquer ce chiffre à Sol.
Tarifs officiels et cache de GPT-6.2 Sol et Claude Fable 5.2
Commençons par GPT-6.2 Sol. Sur la page des modèles d’OpenAI, la tarification standard en contexte court s’établit comme suit : entrée à 2 $, lecture du cache à 0,10 $, écriture du cache (rétention de 30 minutes) à 2,50 $, écriture du cache 12 heures à 5 $ et sortie à 10 $. Ce modèle n’est pas encore disponible, nous l’ajouterons dès que possible ; les identifiants et les tarifs font foi tels qu’indiqués dans la liste des modèles de la plateforme. L’article d’annonce précise que Sol reprend les prix par token API de GPT-6.1 Sol.
Du côté de Claude Fable 5.2, la documentation d’Anthropic affiche : entrée à 8 $, sortie à 40 $, écriture du cache 5 minutes à 10 $, écriture du cache 1 heure à 16 $ et lecture du cache à 0,20 $. Dans le tableau global des modèles d’APIYI (apiyi.com), les entrées claude-fable-5-2 et claude-fable-5-2-thinking indiquent 8 $ / 40 $ / 0,2 $ pour l’entrée, la sortie et la lecture du cache, conformément aux tarifs officiels ; les pages de présentation de ces deux modèles renvoient actuellement une erreur 404, le tableau global fait donc foi pour les prix.
| Poste de facturation (par million de tokens) | GPT-6.2 Sol (officiel OpenAI) | Claude Fable 5.2 (officiel Anthropic) | Comparaison |
|---|---|---|---|
| Entrée (contexte court) | 2 $ | 8 $ | Un quart |
| Sortie (contexte court) | 10 $ | 40 $ | Un quart |
| Lecture du cache | 0,10 $ | 0,20 $ | La moitié |
| Écriture du cache | 30 minutes : 2,50 $ ; 12 heures : 5 $ | 5 minutes : 10 $ ; 1 heure : 16 $ | Durées de rétention différentes, le rapport ne se calcule pas directement |
| Batch | 50 % du prix standard | Entrée et sortie à moitié prix | Règles similaires |
| Palier accéléré | Fast : 2× le prix standard ; Ultrafast : 3× jusqu’au 28 février 2027, puis 6× à partir du 1er mars 2027 | Fast mode : entrée à 16 $, sortie à 80 $, vitesse allant jusqu’à environ 2,5× | Mécanismes différents |
Les tarifs de GPT-6.2 Sol présentés dans le tableau correspondent aux prix officiels d’OpenAI. Ce modèle n’est pas encore disponible, nous l’ajouterons dès que possible ; les identifiants et les tarifs font foi tels qu’indiqués dans la liste des modèles de la plateforme.
« Sol coûte un quart de Fable » ne vaut que pour l’entrée et la sortie en contexte court. La page des modèles d’OpenAI mentionne en effet une autre règle : dès qu’une requête dépasse 272K tokens en entrée, le prix unitaire de l’entrée et du cache double, la sortie est facturée à 1,5 fois le tarif du contexte court, et le calcul s’effectue sur l’ensemble de la requête. Dans ce cas, le prix unitaire de sortie de Sol n’est plus de 10 $, et une estimation basée sur le facteur un quart conduit à une erreur ; pour la facturation en contexte long côté Fable, référez-vous à la documentation d’Anthropic.
Spécifications et interfaces de GPT-6.2 Sol et Claude Fable 5.2
Les deux modèles affichent une fenêtre de contexte de l’ordre du million, avec une sortie maximale de 128K dans les deux cas. Les différences se situent au niveau des modalités d’entrée, des options de raisonnement et des interfaces — autant de points qui influencent la façon de les intégrer.
| Élément | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| Contexte / Sortie maximale | 1,050,000 (entrée maximale 922,000) / 128,000 | 1M / 128K |
| Entrée / Sortie | Texte, images / Texte | Voir la documentation Anthropic |
| Coupure des connaissances | 2026-06-01 | 2026-06 |
| Paramètres de raisonnement | L’API ne permet pas de définir le reasoning effort sur none | Effort par défaut à high, réflexion activée et impossible à désactiver |
| Points de terminaison officiels | Chat Completions, Responses, Batch | API Anthropic |
| APIYI | Pas encore disponible | claude-fable-5-2, claude-fable-5-2-thinking, points de terminaison chat et messages |
Chez APIYI, pour invoquer Fable (déjà disponible), la base URL en mode compatible OpenAI est https://api.apiyi.com/v1, avec claude-fable-5-2 comme nom de modèle ; si votre projet repose nativement sur le protocole Anthropic Messages, vous pouvez aussi passer par le point de terminaison messages de la plateforme. Côté groupes, le tableau général recense ClaudeCode, Claude_Reverse, Claude_Enterprise, Default et SVIP.
GPT-6.2 Sol et Claude Fable 5.2 : les épreuves examinées une par une
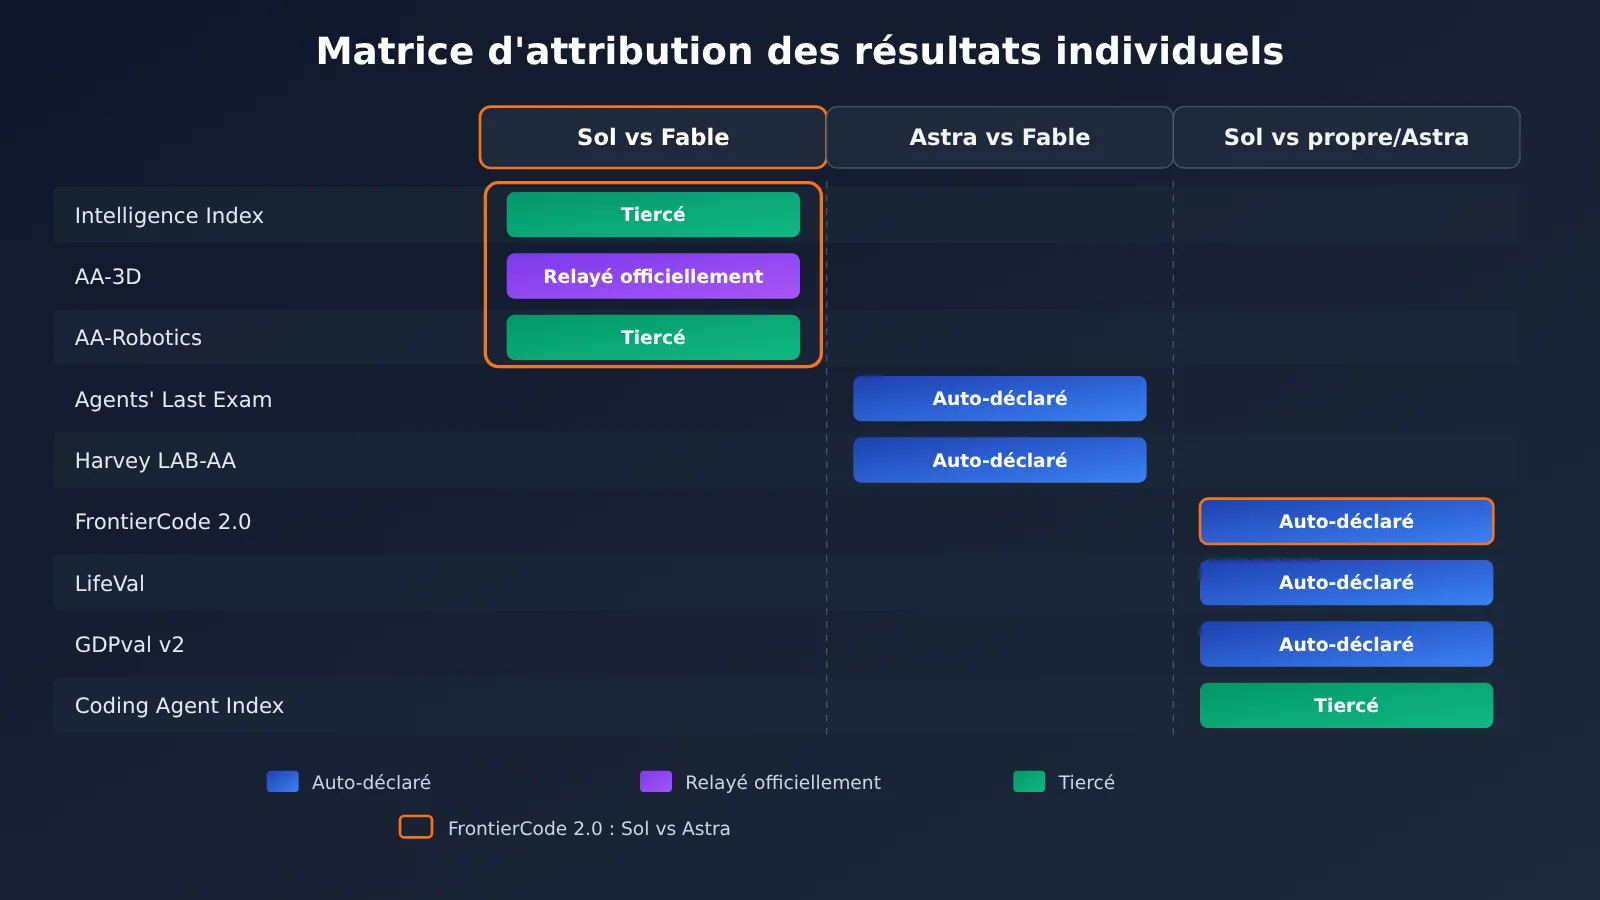
C’est la section la plus importante de cet article. Le communiqué de publication d’OpenAI regorge de résultats par épreuve, mais les face-à-face directs « Sol vs Fable » y sont rares. Le tableau ci-dessous les passe en revue une à une, en précisant la source et les deux modèles comparés.
| Épreuve | Source | Modèles comparés et résultats | Face-à-face direct Sol vs Fable ? |
|---|---|---|---|
| Intelligence Index v5.0.1 | AA (tierce partie), niveau de raisonnement le plus élevé | Fable 65, Sol (Max) 57 | Oui (score composite d’un tiers) |
| AA-3D, Elo d’évaluation humaine à l’aveugle | Reprise par les sources officielles | Sol 1259, Fable 1271 | Oui (seule épreuve de ce type dans les documents officiels) |
| AA-Robotics v0.1 | AA (tierce partie), aperçu de recherche | Sol 78, Fable 75 | Oui (aperçu d’un tiers ; pour le niveau de raisonnement, se référer à la page AA) |
| Agents’ Last Exam | Auto-déclaration officielle | Astra devance Fable de 5,5 points, pour un coût d’environ 5 % | Non, il s’agit de Astra vs Fable |
| Harvey LAB-AA v1.1 | Auto-déclaration officielle | Le taux de réussite d’Astra est plus du double de celui de Fable, pour un coût d’environ un sixième | Non, il s’agit de Astra vs Fable |
| FrontierCode 2.0 | Auto-déclaration officielle | Sol et Astra à moins de 0,5 point d’écart, pour un coût d’environ un cinquième, les deux au niveau Max | Non, il s’agit de Sol vs Astra |
| LifeVal | Auto-déclaration officielle | Sol au-dessus de GPT-6 Astra, pour un coût d’environ un septième | Non |
| GDPval v2 | Auto-déclaration officielle | Sol surpasse GPT-6.1 Sol de 5,3 points | Non |
| Coding Agent Index | AA (tierce partie), niveau max | Sol inférieur de 3 points à GPT-6.1 Sol | Non |
Les scores de GPT-6.2 Sol sur FrontierCode 2.0 ne peuvent pas être transposés à Fable pour comparaison
FrontierCode 2.0 a été conçu par Cognition pour évaluer si les modifications apportées à de véritables dépôts de code peuvent être fusionnées par leurs mainteneurs. Les résultats auto-déclarés font état d’un écart de moins de 0,5 point entre Sol et Astra, pour un coût d’environ un cinquième de celui d’Astra, tous deux au niveau Max. Fable n’intervient nulle part ici : impossible d’écrire que « Sol est à moins de 0,5 point de Fable sur FrontierCode ».
Même logique : sur Agents’ Last Exam et Harvey LAB-AA, c’est Astra qui domine Fable. Quant à la performance de Sol face à Fable sur ces deux épreuves, l’article de lancement n’en dit rien — rien ne permet donc de le déduire.
Les épreuves de science et de code de GPT-6.2 Sol et de Claude Fable 5.2
Terminal-Bench-Science 0.1 mérite lui aussi de la prudence. Les chiffres auto-déclarés donnent Astra 9 points de pourcentage au-dessus de GPT-6 Astra ; en note de bas de page, deux valeurs figurent pour Fable 5.2 : l’une provient du test d’Artificial Analysis utilisant mini-swe-agent, l’autre correspond aux 74,6 % rapportés par Anthropic avec Claude Code, en intensité de raisonnement Max. Ces deux chiffres de Fable viennent de tests distincts : on ne peut pas les traiter comme une seule et même comparaison, et aucun des deux ne représente un score de Sol.
Du côté des mesures tierces, Artificial Analysis signale que Sol affiche 3 points de moins que GPT-6.1 Sol sur le Coding Agent Index (Codex harness, max), principalement en raison d’un score inférieur de 14 points sur SWE-Atlas-QnA-AA, un test où les faits clés sont plus faciles à laisser passer. Le taux d’hallucination AA-Omniscience qu’il mesure (Max) s’établit à 55 % pour Sol. Ces chiffres n’ont pas d’équivalent du côté de Fable et ne servent qu’à mieux cerner les points faibles propres à Sol.
Recommandations de scénarios : GPT-6.2 Sol et Claude Fable 5.2
Cette section ne choisit pas à votre place ; elle indique simplement, selon la tâche, quel ensemble de données consulter en priorité.
Tâches pour lesquelles consulter d’abord les données de Claude Fable 5.2
- Tâches globales de longue haleine, difficiles et multi-étapes : commencez par le score composite d’un tiers. Fable obtient 65 sur le palier de raisonnement le plus élevé de l’Intelligence Index v5.0.1, en tête du classement — c’est actuellement la donnée composite directement comparable avec Sol.
- Projets à intégrer sans attendre :
claude-fable-5-2est déjà référencé sur APIYI, vous pouvez le tester tout de suite avec vos propres échantillons. - Projets où le coût de la réflexion compte : la réflexion de Fable est activée par défaut et ne peut pas être désactivée, avec un effort par défaut réglé sur high ; pensez donc à inclure les tokens de réflexion dans votre budget.
Tâches pour lesquelles consulter d’abord les données de GPT-6.2 Sol
- Tâches quotidiennes et traitements par lots sensibles au tarif : commencez par le tarif officiel pour les contextes courts et les règles Batch, puis par les résultats auto-déclarés sur les tâches quotidiennes, comme LifeVal et GDPval v2.
- Requêtes se situant pour l’essentiel sous les 272K : c’est principalement dans cette plage que s’applique l’écart de prix de Sol, où l’entrée coûte un quart du prix de la sortie.
- Équipes travaillant déjà dans ChatGPT Work ou Codex : d’après l’annonce officielle, les offres Plus, Pro, Enterprise et Edu sont disponibles dès aujourd’hui, et le palier Pro 200 accède pour la première fois à l’Ultrafast, proposé à partir de Sol.
Prise en main rapide de GPT-6.2 Sol et Claude Fable 5.2
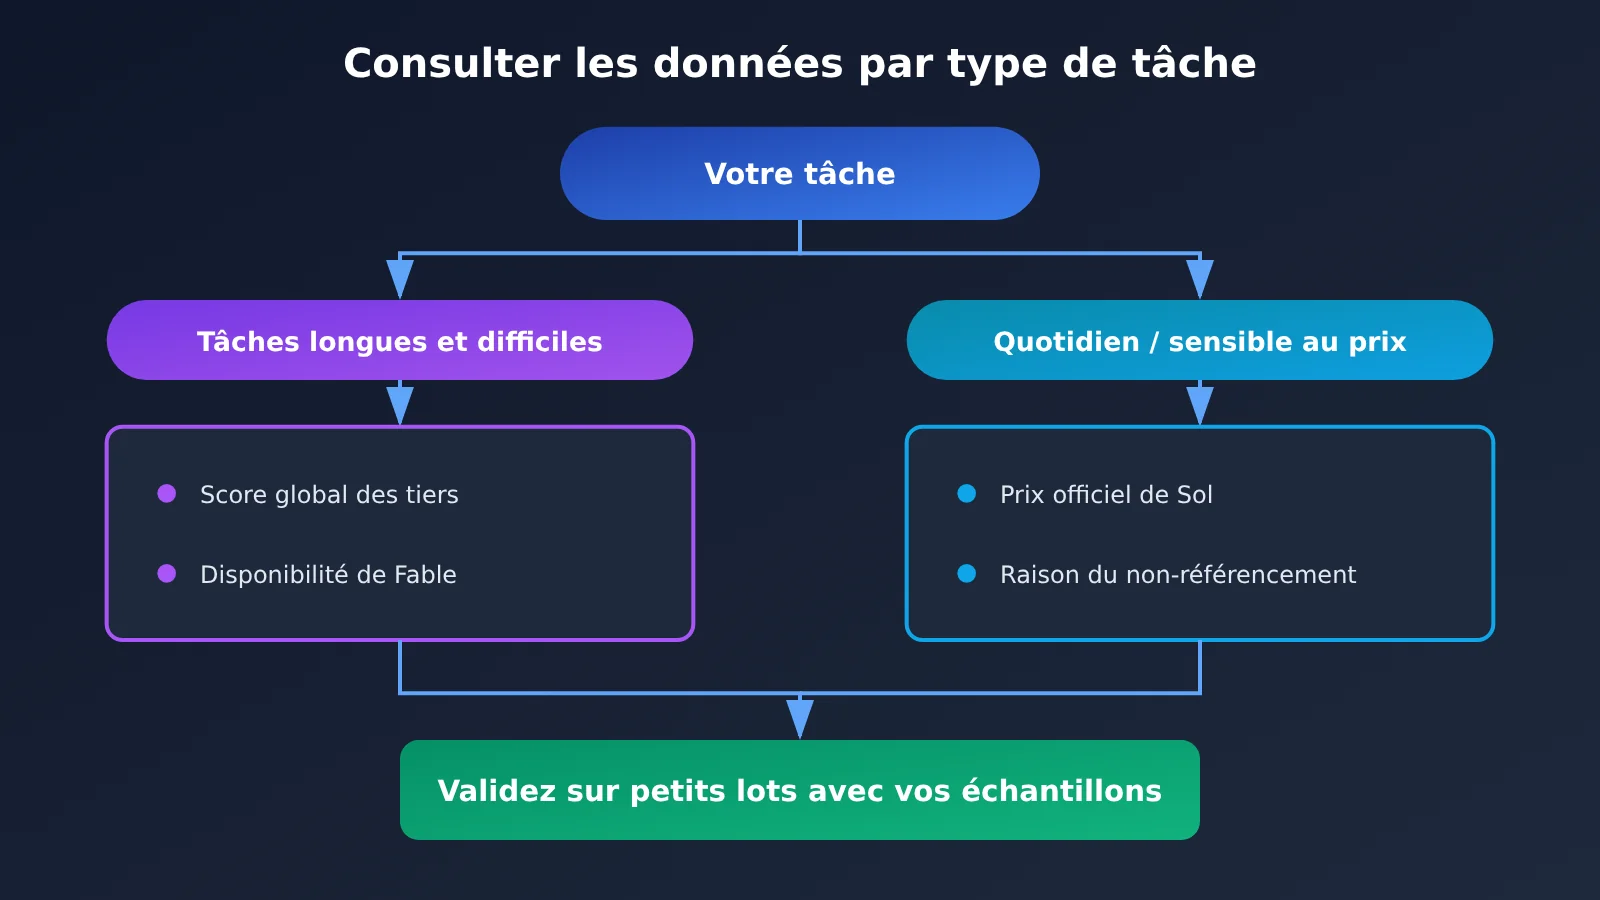
Cette section présente l’ordre des opérations selon le type de tâche. Aucun code dans cet article : les noms de modèles et les adresses sont indiqués directement dans les phrases.
Tâches longues et complexes : commencez par le score global de Fable et sa disponibilité. Créez une clé API dans la console APIYI, remplacez le base URL de votre SDK compatible OpenAI par https://api.apiyi.com/v1, puis renseignez claude-fable-5-2 comme valeur de model ; si vous préférez un nom de modèle qui indique explicitement le raisonnement, vous pouvez aussi utiliser claude-fable-5-2-thinking. Le tableau récapitulatif affiche un tarif de 8 $ en entrée, 40 $ en sortie et 0,2 $ en lecture du cache, identique aux prix officiels d’Anthropic. Nous vous recommandons de commencer par 20 à 50 de vos propres tâches réelles pour mesurer le taux de réussite et la consommation de tokens, avant de juger si ce score de 65 se manifeste réellement dans votre cas d’usage.
Tâches du quotidien sensibles aux tarifs : consultez ensuite les prix officiels de Sol et la mention de non-disponibilité. Les tarifs officiels d’OpenAI pour GPT-6.2 Sol sont de 2 $ en entrée, 0,10 $ en lecture du cache et 10 $ en sortie. Le modèle n’est pas encore disponible sur la plateforme ; nous le mettrons en ligne dès que possible. Les noms de modèles et les tarifs font foi selon la liste des modèles de la plateforme. En attendant, consultez régulièrement la liste des modèles sur apiyi.com, et n’utilisez pas gpt-6.1-sol ni gpt-6-sol comme substitut pour vos tests : ce ne sont pas des versions 6.2, et le tarif de lecture du cache de gpt-6-sol est différent.
Une fois Sol disponible, trois points méritent votre attention : le paramètre reasoning effort ne peut pas être réglé sur none ; au-delà de 272K tokens en entrée, une majoration s’applique à l’intégralité de la requête ; les endpoints officiels prennent en charge Chat Completions et Responses, les endpoints de la plateforme étant précisés dans la liste des modèles.
🚀 Démarrage rapide : une même clé API permet d’appeler les modèles de plusieurs fournisseurs disponibles sur la plateforme. Nous vous conseillons de d’abord valider Fable sur APIYI (apiyi.com) grâce au crédit de test gratuit, de préparer vos scripts d’évaluation et vos échantillons, puis, une fois Sol en ligne, de remplacer simplement le nom du modèle pour effectuer une comparaison sur les mêmes échantillons.
GPT-6.2 Sol et Claude Fable 5.2 : comment choisir
Voici une liste de vérification pour vous aider à remettre ces chiffres dans le contexte de vos propres tâches.
- Vérifiez d’abord l’origine des chiffres : s’agit-il de scores globaux fournis par des tiers, de résultats ponctuels auto-déclarés par les éditeurs, ou de tarifs officiels ? N’additionnez pas ces trois catégories et ne les convertissez pas de l’une à l’autre.
- Vérifiez le niveau de raisonnement : le 57 de Sol correspond au niveau Max, le niveau High affiche 55, et le niveau Low seulement 41. Regardez toujours le score du niveau que vous utiliserez réellement.
- Faites vos comptes selon la longueur des requêtes : en dessous de 272K, vous pouvez estimer les entrées et sorties au quart ; au-delà de 272K, il faut tout recalculer selon la règle de facturation d’ensemble d’OpenAI.
- Facturez le cache à part : la lecture en cache coûte $0.10 contre $0.20, soit un écart du simple au double ; la durée de rétention des écritures en cache n’est pas la même non plus, estimez-les donc séparément selon votre propre stratégie de cache.
- Vérifiez que la comparaison point par point existe : si la donnée qui vous intéresse n’est disponible qu’en Astra contre Fable ou en Sol contre Astra, vous ne pouvez pas en tirer de conclusion sur le duel Sol contre Fable.
- Tenez compte de la politique de sécurité : selon les données officielles, les deux modèles 6.2 atteignent le niveau « critique » en cybersécurité du cadre de préparation ; les protections sont donc plus strictes, et certaines demandes de recherche de vulnérabilités parfaitement légitimes seront refusées.
💡 Conseil de choix : le modèle à retenir dépend de la longueur de vos tâches, du niveau de raisonnement et de votre taux d’utilisation du cache. Vous pouvez utiliser un même lot d’échantillons pour invoquer les deux modèles séparément sur la plateforme APIYI, et laisser parler les factures et les taux de complétion, plutôt que de vous fier à un seul classement.
Questions fréquentes (FAQ)
Q1 : Que sont GPT-6.2 Sol et Claude Fable 5.2 ?
GPT-6.2 Sol est un modèle publié par OpenAI le 17 novembre 2026 aux côtés de GPT-6.2 Astra. Son identifiant de modèle est `gpt-6.2-sol` : il prend du texte et des images en entrée, produit du texte, et dispose d’une fenêtre de contexte de 1 050 000. Claude Fable 5.2 est un modèle publié par Anthropic le 9 novembre 2026, avec une fenêtre de contexte de 1M, une sortie maximale de 128K, et une réflexion activée par défaut qui ne peut pas être désactivée.
Q2 : Avec 65 contre 57 au classement général, peut-on dire que Claude Fable 5.2 domine GPT-6.2 Sol sur tous les plans ?
Non. Ce 65 contre 57 est le résultat obtenu sur un indice tiers, l’Artificial Analysis Intelligence Index v5.0.1, où Fable utilisait le niveau de raisonnement le plus élevé et Sol le niveau Max. Ce chiffre reflète le score global de cet indice et n’implique pas que cet écart se retrouve sur chaque épreuve individuelle. Dans l’évaluation AA-3D en aveugle par des humains relayée par les sources officielles, Sol obtient 1259 contre 1271 pour Fable, soit un écart nettement plus faible ; dans la préversion de recherche tierce AA-Robotics v0.1, Sol marque 78 contre 75.
Q3 : Le prix de GPT-6.2 Sol est-il vraiment le quart de celui de Claude Fable 5.2 ?
Ce rapport ne vaut que pour les entrées et sorties en contexte court. Selon les tarifs officiels, Sol coûte $2 en entrée et $10 en sortie, contre $8 et $40 pour Fable. Le modèle n’est pas encore référencé ; nous l’ajouterons dès que possible, les identifiants et les prix affichés dans la liste des modèles de la plateforme faisant foi. La lecture du cache coûte $0.10 contre $0.20, soit la moitié ; au-delà de 272K en entrée, Sol applique une majoration à l’ensemble de la requête et la sortie passe à 1,5 fois son tarif en contexte court — l’estimation « au quart » ne tient alors plus.
Q4 : Quel est l’écart entre GPT-6.2 Sol et Claude Fable 5.2 dans FrontierCode 2.0 ?
Les documents officiels ne proposent pas cette comparaison. Le « moins de 0,5 point d’écart » mentionné dans FrontierCode 2.0 compare GPT-6.2 Sol et GPT-6.2 Astra, tous deux au niveau Max, Sol coûtant environ cinq fois moins cher. Fable ne fait pas partie de cette comparaison.
Q5 : Comment invoquer GPT-6.2 Sol et Claude Fable 5.2 via l’API ?
Voici les étapes :
1. Inscrivez-vous sur APIYI (apiyi.com) pour obtenir une clé API et des crédits de test gratuits.
2. Définissez la base URL du SDK compatible OpenAI sur l’adresse de la plateforme, puis renseignez `claude-fable-5-2` dans le champ model pour invoquer Fable.
3. `gpt-6.2-sol` n’est pas encore référencé ; une fois disponible, reportez-vous à la liste des modèles de la plateforme pour les identifiants et les prix, puis effectuez vos tests avec le même jeu d’échantillons.
Q6 : Quelles sont les limites connues de GPT-6.2 Sol et de Claude Fable 5.2 ?
Côté Sol : les tests tiers d’AA mesurent un taux d’hallucination de 55 % au niveau Max, et le Coding Agent Index est inférieur de 3 points à celui de GPT-6.1 Sol, principalement parce qu’il omet plus facilement des faits essentiels ; le reasoning effort ne peut pas être réglé sur none ; les garde-fous de cybersécurité sont plus stricts et une partie des recherches légitimes sur les vulnérabilités peut être refusée. Côté Fable : la réflexion ne peut pas être désactivée, l’effort par défaut est high et les tokens de réflexion sont comptabilisés dans le coût ; le Fast mode est facturé $16 en entrée et $80 en sortie.
Q7 : D’après les chiffres officiels, le coût d’Astra ne représente que 5 % de celui de Fable — peut-on le croiser avec les 26,54 $ mesurés par un tiers ?
Non. Ce « environ 5 % » est un coût auto-déclaré pour le benchmark Agents’ Last Exam, où la comparaison porte sur Astra et Fable ; les 26,54 $, eux, correspondent au coût par tâche de Fable lorsque Artificial Analysis fait tourner son indice composite. Ni les tâches ni les sources ne coïncident : impossible de diviser l’un par l’autre, ni d’en déduire le coût de Sol. Si vous cherchez simplement un ordre de grandeur, le plus fiable reste de consigner la facturation réelle de vos propres échantillons sur la plateforme APIYI.
GPT-6.2 Sol et Claude Fable 5.2 : les points clés à retenir
- Score composite : dans l’indice AA d’un tiers, Fable atteint 65 au niveau de raisonnement le plus élevé, contre 57 pour Sol en niveau Max — une confrontation directe sur un même classement.
- Prix affichés : en contexte court, l’entrée et la sortie de Sol coûtent le quart de Fable (2 $ contre 8 $, 10 $ contre 40 $).
- Lecture de cache : 0,10 $ contre 0,20 $ — seulement la moitié du prix ; le rapport d’un quart ne s’applique pas ici.
- Contexte long : chez Sol, au-delà de 272K en entrée, la majoration s’applique à la requête entière — le ratio initial ne vaut plus.
- Peu de comparaisons directes : dans les documents officiels, Sol n’est confronté à Fable que sur AA-3D, avec 1259 contre 1271.
- Ne pas transposer les scores : FrontierCode 2.0 oppose Sol à Astra, tandis qu’ALE et Harvey opposent Astra à Fable.
- Disponibilité : Fable peut être invoqué directement via APIYI (apiyi.com) ; Sol n’est pas encore proposé — la liste des modèles fait foi.
En résumé
Pour comparer GPT-6.2 Sol et Claude Fable 5.2, l’essentiel est de bien distinguer les trois couches de chiffres :
- Score composite tiers : Fable 65, Sol (Max) 57 — sert à situer le niveau global de chaque modèle.
- Tarifs officiels : à contexte court, les entrées et sorties varient d’un quart, la lecture du cache de moitié ; le contexte long fait l’objet d’un calcul séparé selon les règles propres à chaque modèle.
- Tâches individuelles : la plupart des évaluations officielles par tâche ne comparent pas directement Sol à Fable ; vérifiez toujours qui est comparé à qui avant de citer un chiffre.
Impossible de fusionner l’écart de scores et l’écart de prix en une seule phrase du type « lequel offre le meilleur rapport qualité-prix ». La démarche la plus fiable consiste à utiliser vos propres échantillons, à figer le niveau de raisonnement, puis à consigner séparément le taux de réussite et la facture. Fable est d’ores et déjà testable sur APIYI (apiyi.com) ; GPT-6.2 Sol n’est pas encore en ligne, nous l’ajouterons dès que possible — les modèles et les prix affichés sur la liste des modèles de la plateforme font foi.
📚 Références
-
Annonce d’OpenAI : notes de publication de GPT-6.2 Astra et Sol et évaluations officielles par tâche
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Description : synthèse des résultats officiels auto-déclarés par tâche, de la disponibilité et des tarifs
- Lien :
-
Page du modèle OpenAI – GPT-6.2 Sol : spécifications, tarifs et règles de facturation 272K
- Lien :
platform.openai.com/docs/models/gpt-6.2-sol - Description : la référence pour le prix d’écriture du cache, la majoration du contexte long et les multiplicateurs du mode accéléré
- Lien :
-
Fiche système d’OpenAI : évaluation de sécurité de GPT-6.2 Astra et Sol
- Lien :
deploymentsafety.openai.com/gpt-6-2-astra-sol - Description : niveaux du cadre de préparation et évaluations d’alignement
- Lien :
-
Article et pages de modèles d’Artificial Analysis : Intelligence Index v5.0.1 tiers
- Lien :
artificialanalysis.ai/models/claude-fable-5-2 - Description : scores composites par niveau, coût par tâche et Coding Agent Index
- Lien :
-
Documentation d’Anthropic – Claude Fable 5.2 : tarifs et spécifications officiels
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - Description : écriture du cache, lecture du cache, Fast mode et réglages d’effort
- Lien :
-
Tableau général des modèles d’APIYI : modèles disponibles et tarifs sur la plateforme
- Lien :
docs.apiyi.com/models.md - Description : données au 2026-11-17 15:54 (UTC+8) ; les modèles et les prix affichés sur la liste des modèles de la plateforme font foi
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour découvrir davantage de modèles et de détails sur les interfaces, consultez le centre de documentation docs.apiyi.com