Nota del autor: Un mismo grupo de modelos chinos de código abierto aparece en orden casi inverso en el ranking de gasto de Menlo Ventures y en el ranking de solicitudes de OpenRouter. En este artículo analizamos cómo se elaboró cada lista y proponemos un método de selección de 5 pasos que puedes aplicar directamente.
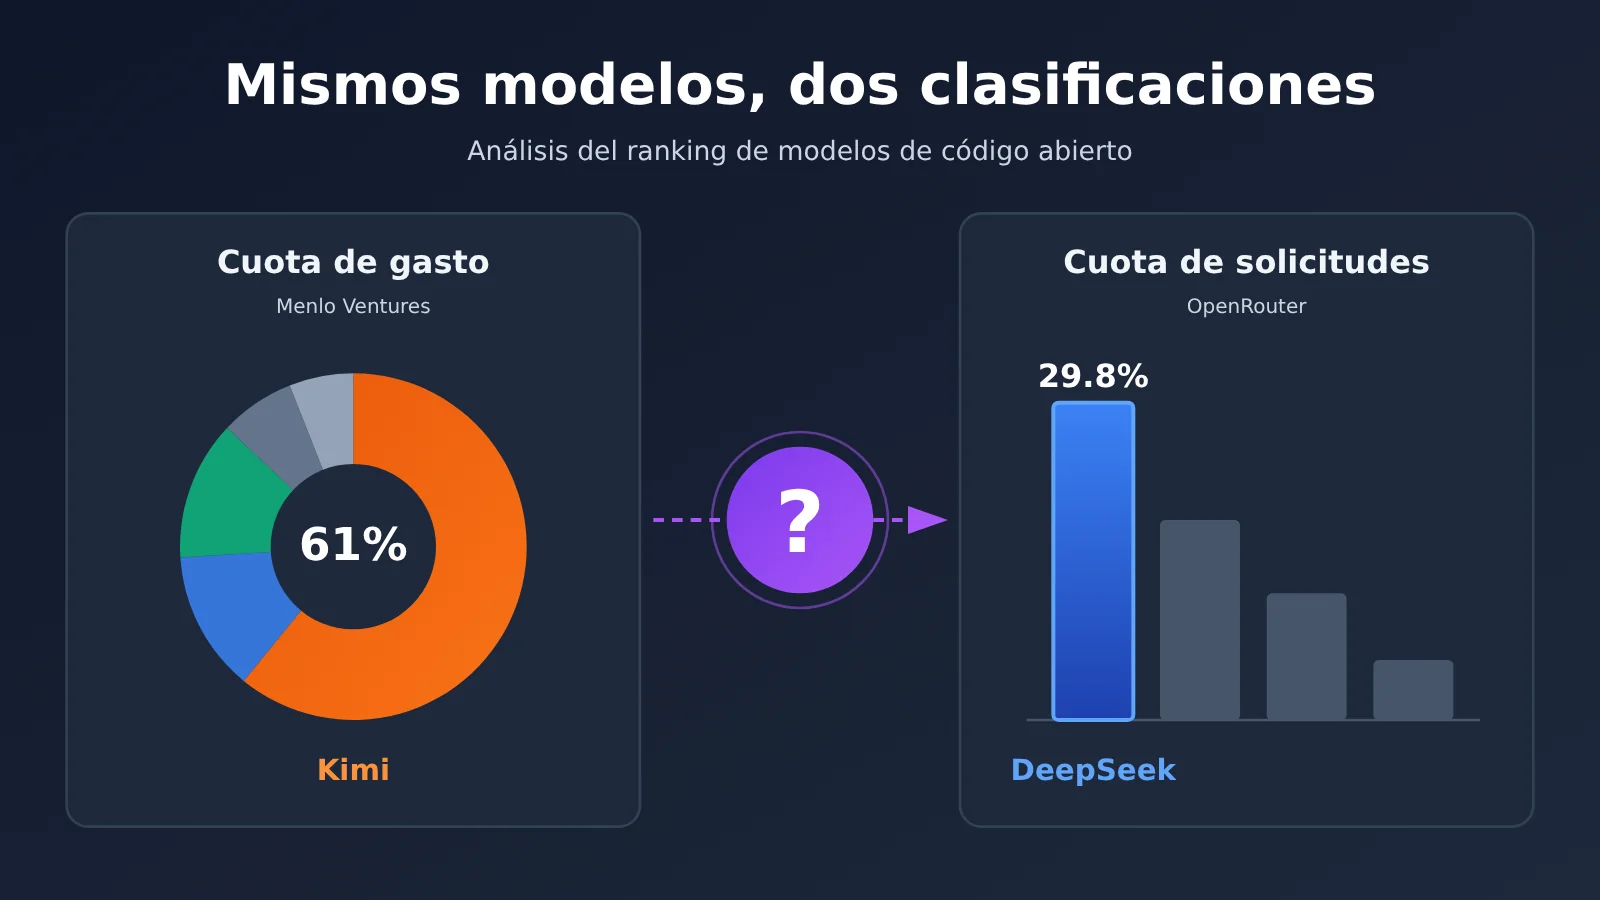
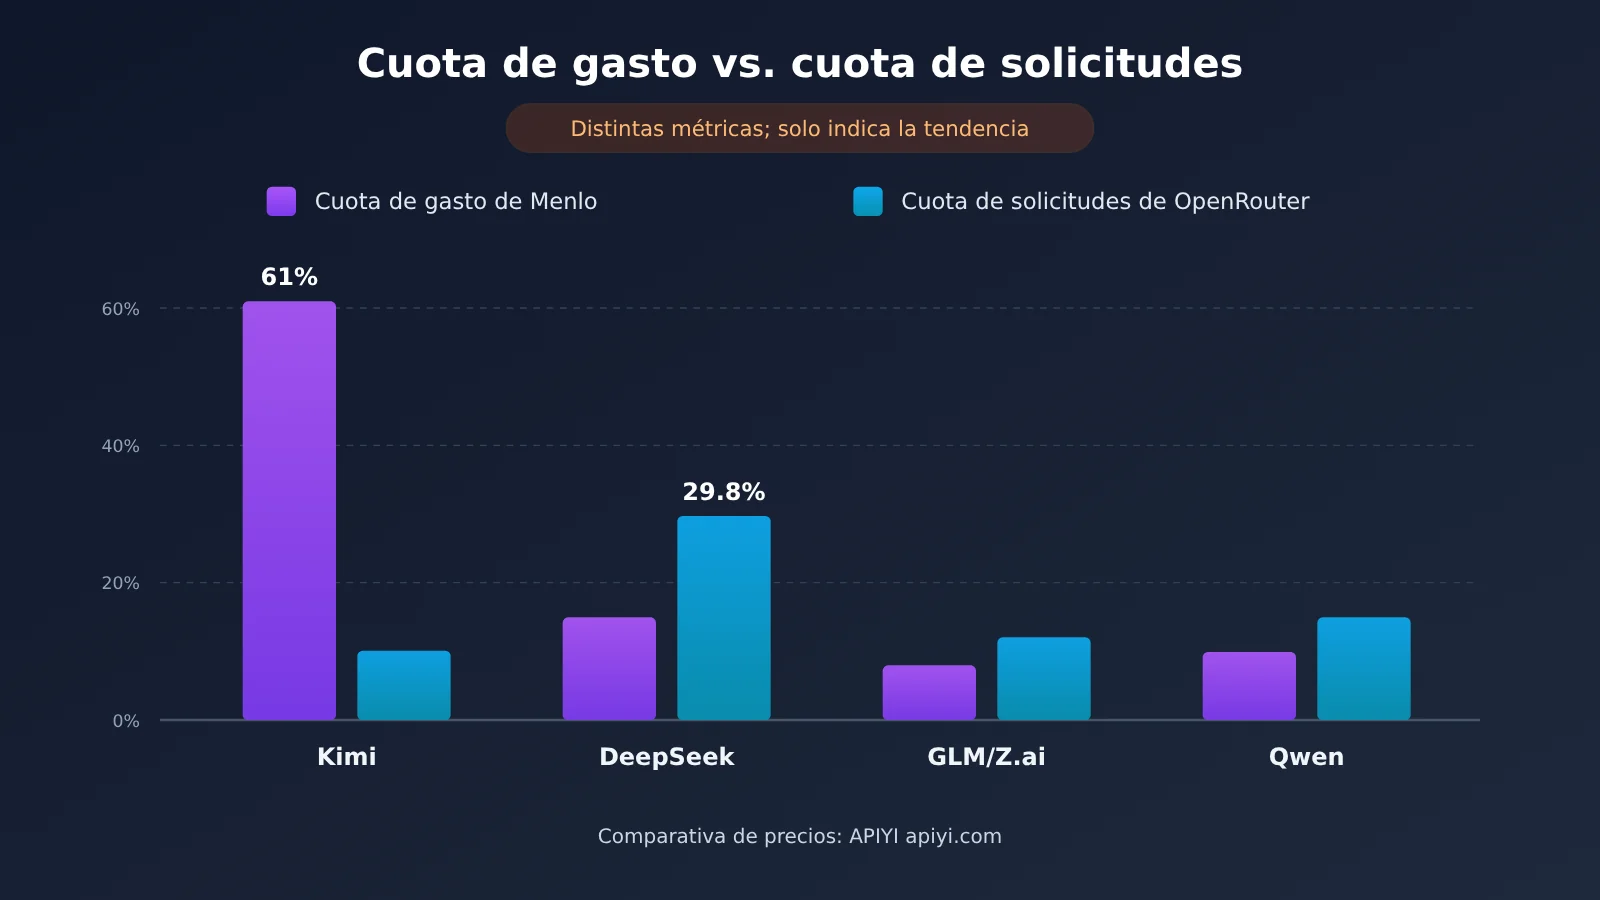
A principios de noviembre se publicaron dos conjuntos de datos. El informe de Menlo Ventures muestra que Kimi concentra el 61% del gasto de las empresas estadounidenses en modelos de código abierto. El ranking semanal de OpenRouter muestra que DeepSeek concentra el 29.8% de las solicitudes de texto de la plataforma. Los líderes son distintos y el orden de las posiciones es casi inverso. La primera reacción de muchos responsables técnicos es: ¿en cuál de los dos hay que confiar?
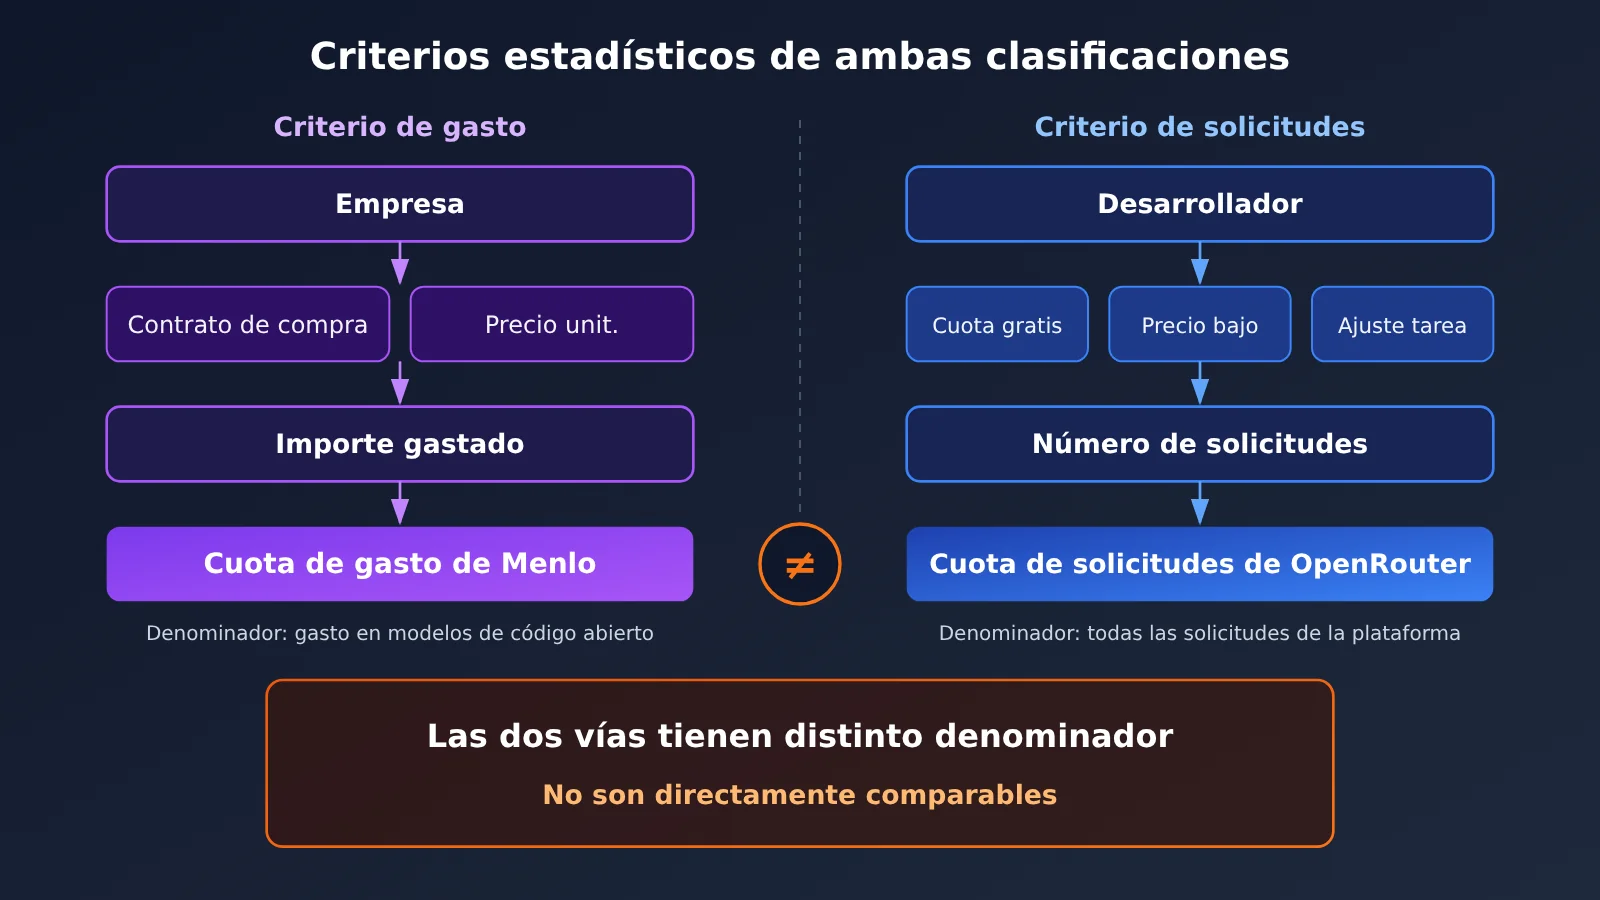
La respuesta es que las dos listas no se contradicen: miden cosas diferentes. El ranking de gasto muestra «a quién pagan las empresas», mientras que el de solicitudes muestra «a qué modelos recurren los desarrolladores en una plataforma concreta». Para elegir un modelo no basta con copiar una lista: hay que evaluar los tipos de tareas y los costos propios. Los rankings solo sirven para acotar la lista de candidatos; no pueden elegir por ti.
Esto no es otro resumen de rankings. Explicaremos la muestra, el período y los límites de aplicación de cada lista. Después veremos cómo afecta a la estructura de costos que «baje el precio unitario y suba el uso» y, por último, presentaremos una lista de 5 pasos para elegir un modelo.
Claves de las clasificaciones de modelos de código abierto: por qué Kimi y DeepSeek lideran cada una
La conclusión: Menlo Ventures mide el gasto empresarial; OpenRouter mide las solicitudes en su plataforma. Las muestras, los períodos y lo que se contabiliza son distintos.
A menudo se comentan ambos conjuntos de datos juntos, pero sus «denominadores» son completamente diferentes. Los datos de Menlo Ventures proceden de una encuesta a responsables de IA de empresas estadounidenses: son estimaciones, no facturas auditadas. Los de OpenRouter provienen de las solicitudes registradas en su propia plataforma, por lo que solo reflejan el comportamiento de sus usuarios y no representan todo el mercado.
| Clasificación | Qué mide | Muestra/período | Posiciones clave | Para qué sirve |
|---|---|---|---|---|
| Informe de Menlo Ventures sobre el estado de la IA empresarial en 2026 | Cuota de gasto de las empresas estadounidenses en modelos de código abierto | Cerca de 400 responsables de IA de empresas estadounidenses; encuesta realizada del 8 al 26 de septiembre de 2026 y publicada el 3 de noviembre | Kimi 61%, DeepSeek 15%, GLM 11%, Meta Llama 7%, Qwen 3% | Identificar preferencias de compra, destino de los presupuestos y modelos incluidos en contratos formales |
| Clasificación semanal de OpenRouter | Cuota de solicitudes de texto en la plataforma | Plataforma OpenRouter, del 26 de octubre al 1 de noviembre | DeepSeek 29.8%, OpenAI 18.8%, Z.ai 11.9%, Qwen 5.6% (sexto lugar) | Evaluar la actividad de los desarrolladores, las invocaciones sensibles al precio y el interés de la comunidad |
La tabla muestra que ni siquiera compiten los mismos participantes. Menlo solo contabiliza modelos de código abierto, mientras que OpenRouter también incluye proveedores de código cerrado como OpenAI y Google. Comparar directamente los porcentajes supone mezclar métricas distintas.
Cómo leer el ranking de gasto de Menlo Ventures: Kimi concentra el 61 % del gasto en modelos de código abierto
La conclusión: los datos de Menlo Ventures indican que los modelos chinos de código abierto ya forman parte de los presupuestos de las empresas estadounidenses, pero son estimaciones de una encuesta, no una clasificación de capacidades.
La cifra que más atención ha generado en el informe es que los modelos chinos concentran el 89 % del gasto de las empresas estadounidenses en modelos de código abierto. Kimi, por sí solo, representa el 61 %; DeepSeek, el 15 %; GLM, el 11 %, y Qwen, el 3 %. Entre los modelos no chinos, Meta Llama alcanza el 7 %.
| Modelo | Porcentaje del gasto de empresas estadounidenses en modelos de código abierto | Clave de lectura |
|---|---|---|
| Kimi | 61 % | Tiene la mayor cuota, posiblemente por sus canales de compra empresarial y su precio unitario |
| DeepSeek | 15 % | Ocupa el segundo lugar en gasto, pero registra más actividad en las invocaciones |
| GLM | 11 % | Mantiene una presencia estable en los presupuestos empresariales |
| Meta Llama | 7 % | Tiene la mayor cuota entre los modelos de código abierto no chinos |
| Qwen | 3 % | Su cuota de gasto es menor, aunque tiene cierta presencia en las invocaciones |
Las cifras se entienden mejor en contexto. El informe estima que el gasto anualizado mundial de las empresas en despliegues de IA ronda los 176 800 millones de dólares, más de 100 veces la cifra de hace tres años. Los laboratorios de modelos de vanguardia concentran el 69 % del gasto en despliegues, mientras que los modelos de código abierto representan solo el 4 % del gasto total en modelos. Así que cuando se dice que «Kimi concentra el 61 %», se habla del 61 % de esa pequeña porción de código abierto, no del 61 % de todo el mercado empresarial de IA.
Además, los datos de la encuesta dependen de las estimaciones que hacen los participantes sobre los presupuestos de sus empresas, y las casi 400 respuestas solo cubren empresas estadounidenses. La lectura razonable es que estos datos muestran una tendencia general en las compras empresariales; los porcentajes concretos son estimaciones de la encuesta que necesitan validarse con más datos.
Cómo leer el ranking de solicitudes de OpenRouter: DeepSeek concentra el 29.8%
La conclusión: el ranking semanal de OpenRouter refleja la popularidad de los modelos entre los desarrolladores de esta plataforma. Sirve para observar tendencias, pero no representa la cuota de todo el mercado.
En la semana del 26 de octubre al 1 de noviembre, DeepSeek ocupó el primer puesto con el 29.8% de las solicitudes de texto, un aumento del 7% respecto a la semana anterior. OpenAI quedó segundo con el 18.8%; la cuota de Google bajó desde el 14.4%; Z.ai ocupó el cuarto puesto con el 11.9%, y Qwen el sexto con el 5.6%.
| Posición | Proveedor | Cuota de solicitudes | Cambio |
|---|---|---|---|
| 1.º | DeepSeek | 29.8% | +7% semanal |
| 2.º | OpenAI | 18.8% | — |
| En descenso | Bajó desde el 14.4% | Pérdida de cuota | |
| 4.º | Z.ai | 11.9% | — |
| 6.º | Qwen | 5.6% | — |
También hay otras dos tendencias que vale la pena observar. El volumen de tokens procesados por modelos chinos lleva 27 semanas consecutivas por encima del de los modelos estadounidenses. Además, cuatro de los cinco modelos individuales con mayor volumen semanal de uso son chinos. Durante ese mismo periodo, DeepSeek actualizó su modelo a DeepSeek V4.1-Flash-1017 sin cambiar la forma de invocarlo mediante la API ni el precio. Esto reduce el costo de migración para los desarrolladores que ya lo tienen integrado.
También conviene prestar atención a la estabilidad. El 3 de noviembre, la web y la API de DeepSeek sufrieron una interrupción parcial de alrededor de 1 hora. Un alto volumen de uso no garantiza que un servicio esté siempre disponible: por eso, más adelante hablaremos de la importancia de tener un modelo de respaldo. Tras el lanzamiento de la nueva versión, consulta la lista de modelos en la consola de APIYI apiyi.com para confirmar el ID del modelo y la facturación.
Por qué se invierte el ranking de gasto y solicitudes de modelos abiertos
La conclusión: la diferencia en el orden se debe principalmente a cinco factores: el precio unitario, la forma de compra, las cuotas gratuitas, la adecuación a las tareas y el alcance de cada plataforma. No significa que uno de los rankings esté «equivocado».
La cuota de gasto equivale aproximadamente al «volumen de invocaciones × precio unitario», con el añadido de factores contractuales y de compra. La cuota de solicitudes solo cuenta las invocaciones, sin importar cuánto cuesta cada una. Si un modelo tiene un precio unitario más alto y las empresas están dispuestas a firmar contratos de compra, aparecerá más arriba en el ranking de gasto. Si tiene un precio bajo y muchos desarrolladores lo usan, aparecerá más arriba en el ranking de solicitudes.
| Factor | Efecto en la cuota de gasto | Efecto en la cuota de solicitudes |
|---|---|---|
| Precio unitario | Un precio más alto implica mayor gasto con el mismo uso, lo que amplía la cuota de gasto | Un precio bajo atrae más pruebas y aumenta el volumen de solicitudes |
| Compras empresariales | Los contratos, los despliegues privados y los acuerdos de servicio cuentan como gasto | No necesariamente pasan por OpenRouter, por lo que la plataforma no los registra |
| Cuotas gratuitas | Las invocaciones gratuitas no generan gasto | Las invocaciones gratuitas cuentan como solicitudes |
| Adecuación a las tareas | Los documentos largos, los agentes y otras tareas que consumen muchos tokens elevan el gasto | Las conversaciones cortas y los lotes de tareas pequeñas elevan el número de solicitudes |
| Alcance de la plataforma | Solo cubre las empresas estadounidenses encuestadas | Solo cubre a los usuarios de OpenRouter |
Visto así, Kimi podría tener ventaja en los canales de compra empresarial y en el precio unitario, lo que explicaría su alta cuota de gasto. DeepSeek tiene un precio más bajo y una comunidad de desarrolladores activa, de ahí su gran volumen de solicitudes. Es una hipótesis razonable basada en el alcance de cada medición: ninguno de los dos informes ofrece un desglose por factor.
Hay otro detalle que suele pasarse por alto: las distintas versiones de un mismo modelo, los canales de acceso y las tasas de aciertos de caché también pueden generar diferencias entre las cifras de gasto e invocaciones. Si un equipo obtiene muchos aciertos de caché, las solicitudes siguen contando, pero el gasto real será mucho menor.
Precios y uso de modelos de código abierto: ¿qué significan una caída del 70 % en el precio unitario y un aumento de 22,5 veces en el uso?
La conclusión primero: que baje el precio unitario no significa que baje el costo total. Comparar el costo de completar una tarea es más fiable que comparar el precio por millón de tokens.
El informe de Menlo recoge unas cifras clave: el precio promedio por token pasó de 0,45 dólares/millón de tokens a 0,13 dólares/millón de tokens, una caída de alrededor del 70 %, mientras que el uso se multiplicó por 22,5 en el mismo período. Si hacemos un cálculo aproximado con estas dos cifras, el gasto total no solo no baja, sino que sube hasta unas 6,5 veces el original. Es solo un cálculo ilustrativo basado en los promedios del informe; la situación real varía según el equipo.
El caso de los modelos de código abierto es aún más revelador. Representan el 19 % del consumo empresarial de tokens, pero solo el 4 % del gasto en modelos. Es decir, una gran cantidad de tokens se procesa en modelos de código abierto económicos, pero la mayor parte del dinero sigue destinándose a modelos punteros de código cerrado.
Para los desarrolladores, la caída del precio unitario incentiva más llamadas, especialmente en agentes y tareas por lotes. El costo real también depende de estas variables:
- Aciertos de caché: que las indicaciones de sistema repetidas y los contextos largos se encuentren o no en caché determina directamente el precio efectivo.
- Longitud del contexto: en tareas con documentos largos, los tokens de entrada suelen superar con creces a los de salida.
- Número de reintentos: los reintentos causados por respuestas inestables o errores de formato pueden multiplicar el costo.
- Rondas de llamadas a herramientas: una tarea de agente puede requerir más de una decena de rondas de ida y vuelta; el precio unitario puede ser bajo, pero el número de rondas es alto.
Al comparar precios, conviene revisar primero en la consola de APIYI apiyi.com los precios de lista y las modalidades de facturación de los modelos candidatos, para confirmar cómo se cobran la entrada, la salida y la caché. Después, ejecuta una pequeña muestra de tus propias tareas y calcula cuánto cuesta completar cada una. Esa cifra es más útil que el precio unitario de lista.
Cómo elegir un modelo de código abierto: usa las clasificaciones para acotar opciones y decide según la tarea
En resumen: las clasificaciones sirven para elaborar una lista de candidatos; la decisión final depende de su adecuación a la tarea, el costo, la estabilidad y la validación con una muestra pequeña.
Puedes seguir este orden: «tarea → costo → estabilidad → validación → alternativa». La siguiente tabla recoge las preguntas y los métodos de comprobación para cada dimensión.
| Dimensión | Qué preguntar | Cómo comprobarlo | Impacto en el costo |
|---|---|---|---|
| Adecuación a la tarea | ¿Se usará principalmente para programación, documentos extensos, tareas multimodales o llamadas a herramientas por parte de agentes? | Preparar entre 30 y 100 muestras de tareas reales y evaluar las respuestas manualmente | Una mala adecuación aumenta los reintentos y las correcciones manuales |
| Precio unitario y caché | ¿Cuánto cuestan la entrada, la salida y los aciertos de caché? | Consultar la lista de modelos y la información de facturación en la consola, y calcular la tasa de aciertos de caché | Determina el precio real por millón de tokens |
| Contexto | ¿Cuál es la longitud máxima de entrada? ¿Baja el rendimiento con entradas muy largas? | Probar el truncamiento y la recuperación de información con los documentos reales más extensos | Un contexto largo aumenta directamente los tokens de entrada |
| Límites de solicitudes | ¿Son suficientes los límites de concurrencia y solicitudes por minuto? | Realizar pruebas de carga con el tráfico máximo previsto | Al alcanzar el límite, hay que poner solicitudes en cola o cambiar de modelo, lo que afecta a la latencia |
| Disponibilidad regional | ¿Se puede acceder de forma estable desde la región de despliegue? | Realizar invocaciones reales desde la región de producción | Si no está disponible, hay que buscar otra vía de acceso |
| Estabilidad | ¿Ha habido interrupciones recientes? ¿Cuánto tarda la recuperación? | Consultar el historial de incidencias y revisar los registros de tasa de errores | Las interrupciones generan costos por reintentos y pérdidas para el negocio |
Comparar varios modelos es la parte que más tiempo consume. Si tienes que registrarte y conectar el SDK por separado para cada candidato, solo la integración puede llevar varios días. Con APIYI apiyi.com, una sola clave API permite invocar modelos de OpenAI, Claude, Gemini, DeepSeek, Kimi y otros proveedores. La interfaz es compatible con el formato de OpenAI: basta con establecer base_url en https://api.apiyi.com/v1 y cambiar el parámetro model de la solicitud para alternar entre modelos. Así puedes ejecutar rápidamente la misma muestra en todos ellos y comparar los resultados.
Para evaluar la estabilidad, no basta con revisar los comunicados del proveedor. La interrupción de DeepSeek del 3 de noviembre nos recuerda que cualquier modelo puede quedar temporalmente fuera de servicio. En la consola de APIYI apiyi.com puedes consultar el uso y los registros de invocación por modelo. Se registran la tasa de errores, la latencia y el consumo de tokens, lo que resulta útil para observar el rendimiento real de los candidatos durante la fase canary. La plataforma utiliza un despliegue multinodo y enrutamiento inteligente, y ofrece degradación automática. Si además configuras un modelo alternativo en tu aplicación, podrás cambiar a él cuando falle el principal y limitar el impacto de un punto único de fallo.
Para el despliegue canary, conviene empezar con entre el 1 % y el 5 % del tráfico real y observar durante varios días la tasa de errores, la latencia y el costo por tarea. Si los datos se mantienen estables, aumenta el tráfico de forma gradual. No hagas el cambio completo de una sola vez basándote únicamente en las clasificaciones.
Preguntas frecuentes sobre los rankings de modelos de código abierto
En resumen: estas 5 preguntas cubren los errores más habituales al interpretar los rankings de modelos de código abierto.
P1: Si Kimi concentra el 61% del gasto, ¿significa que sus modelos son mejores?
No. La cuota de gasto refleja a quién va el dinero y depende del precio unitario, los contratos de compra empresariales y los canales de distribución. No se corresponde directamente con las capacidades de los modelos. Además, los datos de Menlo son estimaciones basadas en una encuesta que solo cubre el gasto de empresas estadounidenses en modelos de código abierto. «Primero en gasto» no significa «primero en capacidad»: evalúa las capacidades con tus propias tareas.
P2: ¿El ranking de solicitudes de OpenRouter representa las compras empresariales?
No. OpenRouter registra la proporción de solicitudes en su propia plataforma, cuyos usuarios son principalmente desarrolladores y equipos pequeños y medianos. Los contratos directos de las empresas, los despliegues privados y otros canales quedan fuera de esas estadísticas. El ranking sirve para observar la popularidad entre desarrolladores y las tendencias de uso sensibles al precio, pero no para deducir cómo se distribuyen los presupuestos empresariales.
P3: ¿Un modelo con un precio unitario bajo siempre tiene un costo total menor?
No necesariamente. Si un modelo más barato necesita más reintentos, indicaciones más largas o más rondas de invocación de herramientas, el consumo total de tokens podría ser mayor. Conviene calcular el costo por «completar una tarea»: revisa el uso de tokens y los registros de costos de cada invocación en la consola de APIYI apiyi.com, y compara el gasto total de distintos modelos al completar el mismo conjunto de tareas.
P4: ¿Pueden los modelos de código abierto sustituir por completo a los de código cerrado?
Depende de la tarea. Los datos de Menlo muestran que los modelos de código abierto procesan el 19% de los tokens de las empresas, pero representan solo el 4% del gasto. Esto indica que muchos equipos les confían tareas rutinarias y por lotes, mientras reservan las tareas complejas para modelos de código cerrado de última generación. Una opción prudente es combinar ambos: con APIYI apiyi.com puedes acceder a modelos de código abierto y cerrado con la misma clave y asignarles tareas según su dificultad.
P5: ¿Con qué frecuencia conviene consultar los rankings de modelos de código abierto?
Puedes revisar los rankings semanales una vez al mes para observar tendencias, sin dejarte llevar por las fluctuaciones de una sola semana. Cuando se publiquen informes anuales o trimestrales, léelos con atención y comprueba si han cambiado los criterios o la muestra. Lo que realmente influye en tus decisiones es el seguimiento continuo de los indicadores de tu negocio, como la tasa de errores, el costo por tarea y los comentarios de los usuarios. Conviene revisarlos cada semana.
Resumen de los rankings de modelos de código abierto: lista de selección en 5 pasos
La conclusión primero: los dos rankings miden cosas distintas. Para interpretarlos bien, pregunta primero qué mide cada uno, revisa la muestra y, por último, valida los resultados con tus propias tareas.
Puntos clave:
- Gasto ≠ invocaciones: Menlo mide el gasto empresarial y OpenRouter, las solicitudes en su plataforma. Los denominadores son distintos, así que no se pueden comparar directamente.
- Encuesta ≠ auditoría: los datos de Menlo son estimaciones basadas en una encuesta a casi 400 responsables de decisiones de empresas estadounidenses; los de OpenRouter solo representan su plataforma.
- Barato ≠ ahorro: el precio unitario cayó alrededor de un 70 %, pero el uso se multiplicó por 22,5 y el gasto total aumentó. Hay que calcular el costo por tarea.
- Popular ≠ estable: incluso el modelo con más invocaciones puede sufrir interrupciones. Conviene preparar una alternativa de antemano.
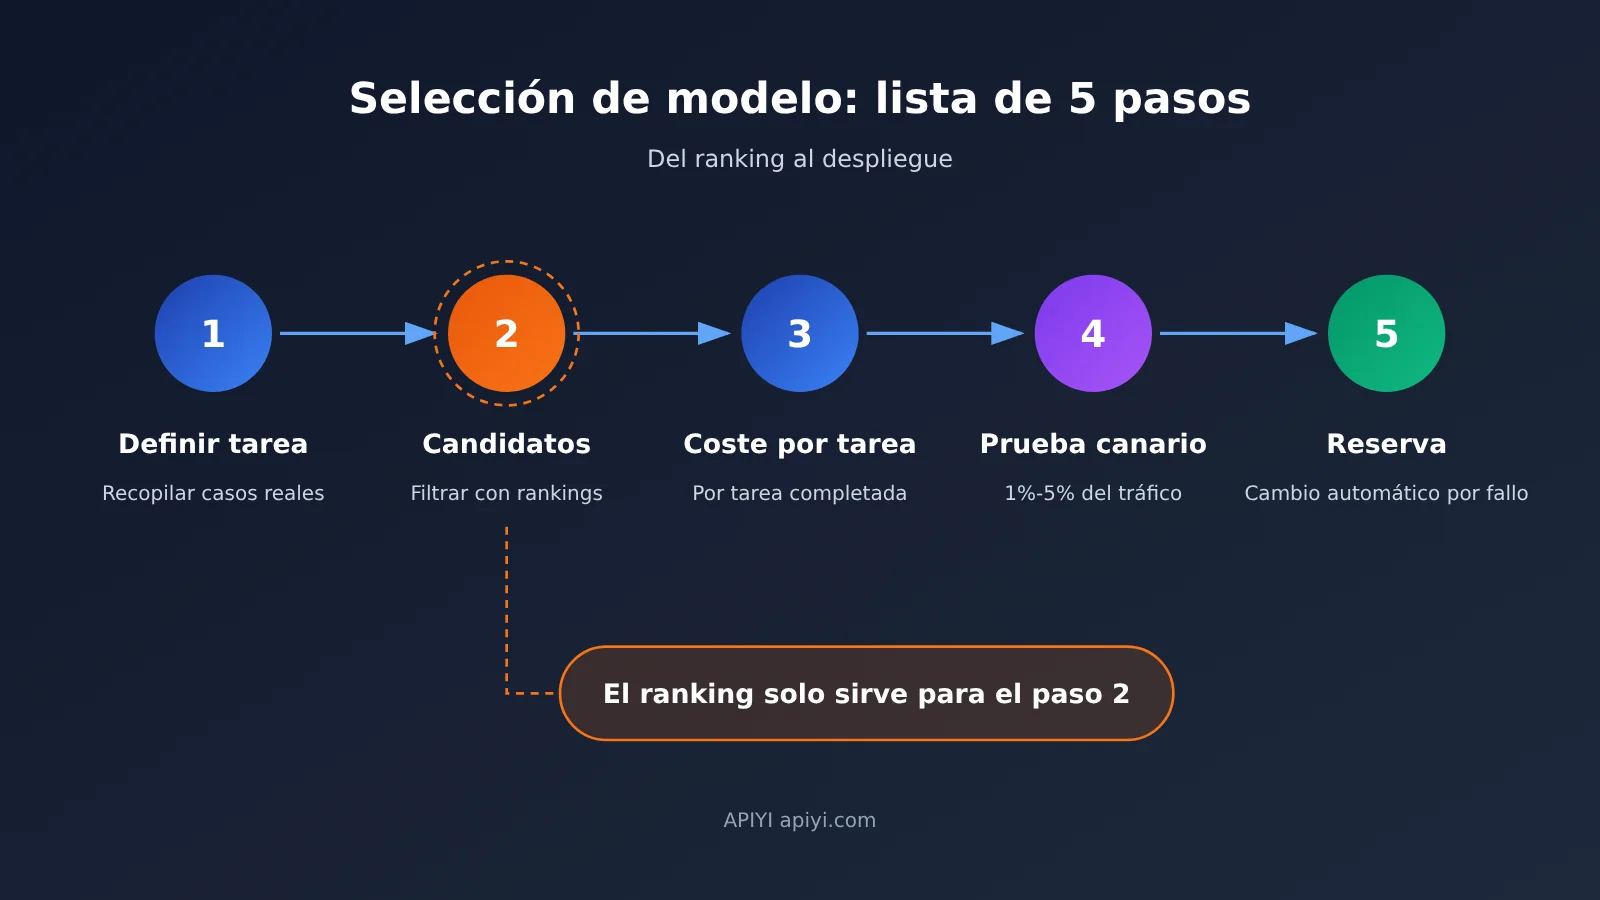
- Los rankings sirven para reducir la lista de candidatos, pero no pueden elegir por ti.
Puedes usar esta lista directamente para tu próxima selección de modelos:
- Define la tarea: especifica los tipos de tareas principales (programación, documentos extensos, multimodal o agentes), reúne entre 30 y 100 ejemplos reales y define los criterios de evaluación.
- Elabora una lista de candidatos: toma como referencia 2 o 3 modelos de cada ranking, el de gasto y el de solicitudes, y añade 1 modelo de código cerrado como punto de comparación. Mantén la lista entre 3 y 5 candidatos.
- Calcula el costo por tarea: ejecuta todos los candidatos con el mismo conjunto de ejemplos, registra el consumo de tokens, los aciertos de caché y el número de reintentos, y calcula el costo y la puntuación de calidad por tarea.
- Haz una prueba canario: dirige primero entre el 1 % y el 5 % del tráfico real al modelo elegido y observa durante unos días la tasa de errores, la latencia y el costo. Si cumple los criterios, aumenta el tráfico.
- Prepara una alternativa: configura al menos un modelo de respaldo de otro proveedor, define las reglas de cambio y ensaya el procedimiento periódicamente.
Si quieres completar los pasos 3 a 5 desde un mismo punto de acceso, puedes usar APIYI apiyi.com para acceder a los modelos candidatos con una sola clave, comparar precios, consumo y registros en la consola, y configurar el cambio al modelo de respaldo mediante la función de degradación automática de la plataforma. Los usuarios nuevos tienen crédito gratuito para pruebas, ideal para empezar con una muestra pequeña.
Fuentes de datos del artículo
- Informe de Menlo Ventures sobre el estado de la IA empresarial en 2026: publicado el 3 de noviembre de 2026
- Enlace:
menlovc.com -
Nota: el gasto en IA empresarial, la cuota de gasto en modelos de código abierto y los cambios en los precios de los tokens son estimaciones basadas en una encuesta
-
Ranking de modelos de OpenRouter: clasificación semanal del 26 de octubre al 1 de noviembre de 2026
- Enlace:
openrouter.ai/rankings - Nota: la cuota de solicitudes de texto y las tendencias de consumo de tokens solo representan esa plataforma
Autor: Equipo técnico de APIYI
Consultas técnicas: si tienes dudas sobre precios, límites de solicitudes o cambio de modelos durante el proceso de selección, puedes contactarnos desde la página principal de APIYI apiyi.com. Encontrarás más recursos de integración en el centro de documentación docs.apiyi.com.