Nota del autor: los precios en hora pico son iguales, pero cada modelo destaca en tareas distintas. Este artículo usa cuatro tablas —parámetros, precios, pruebas de rendimiento y reparto de tareas— para ayudarte a decidir qué modelo asignar a cada trabajo.
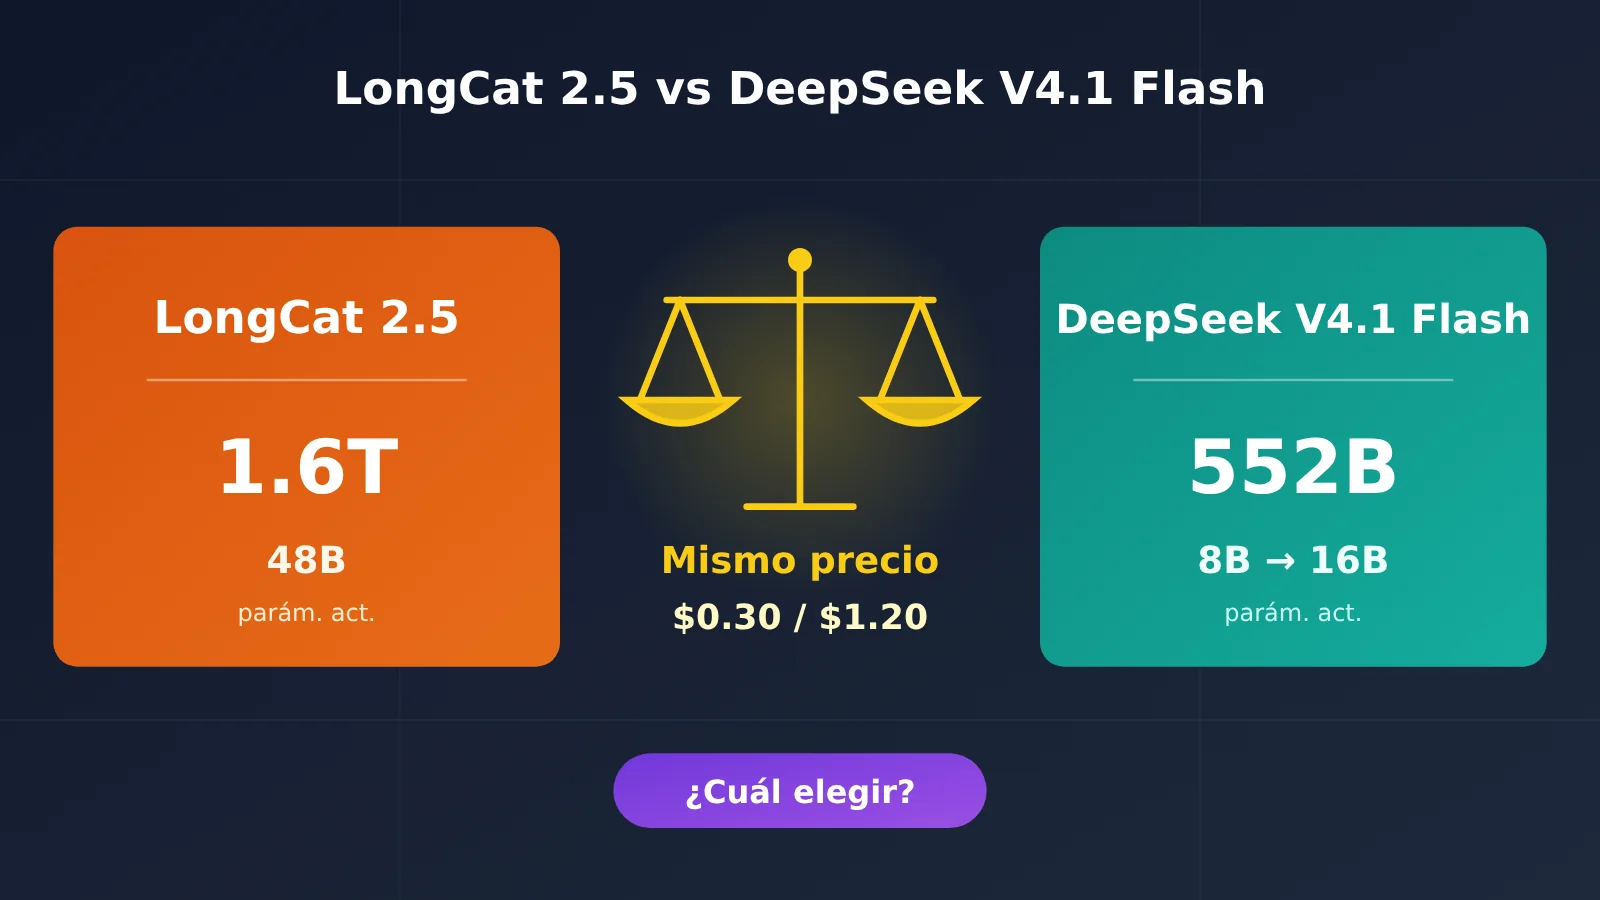
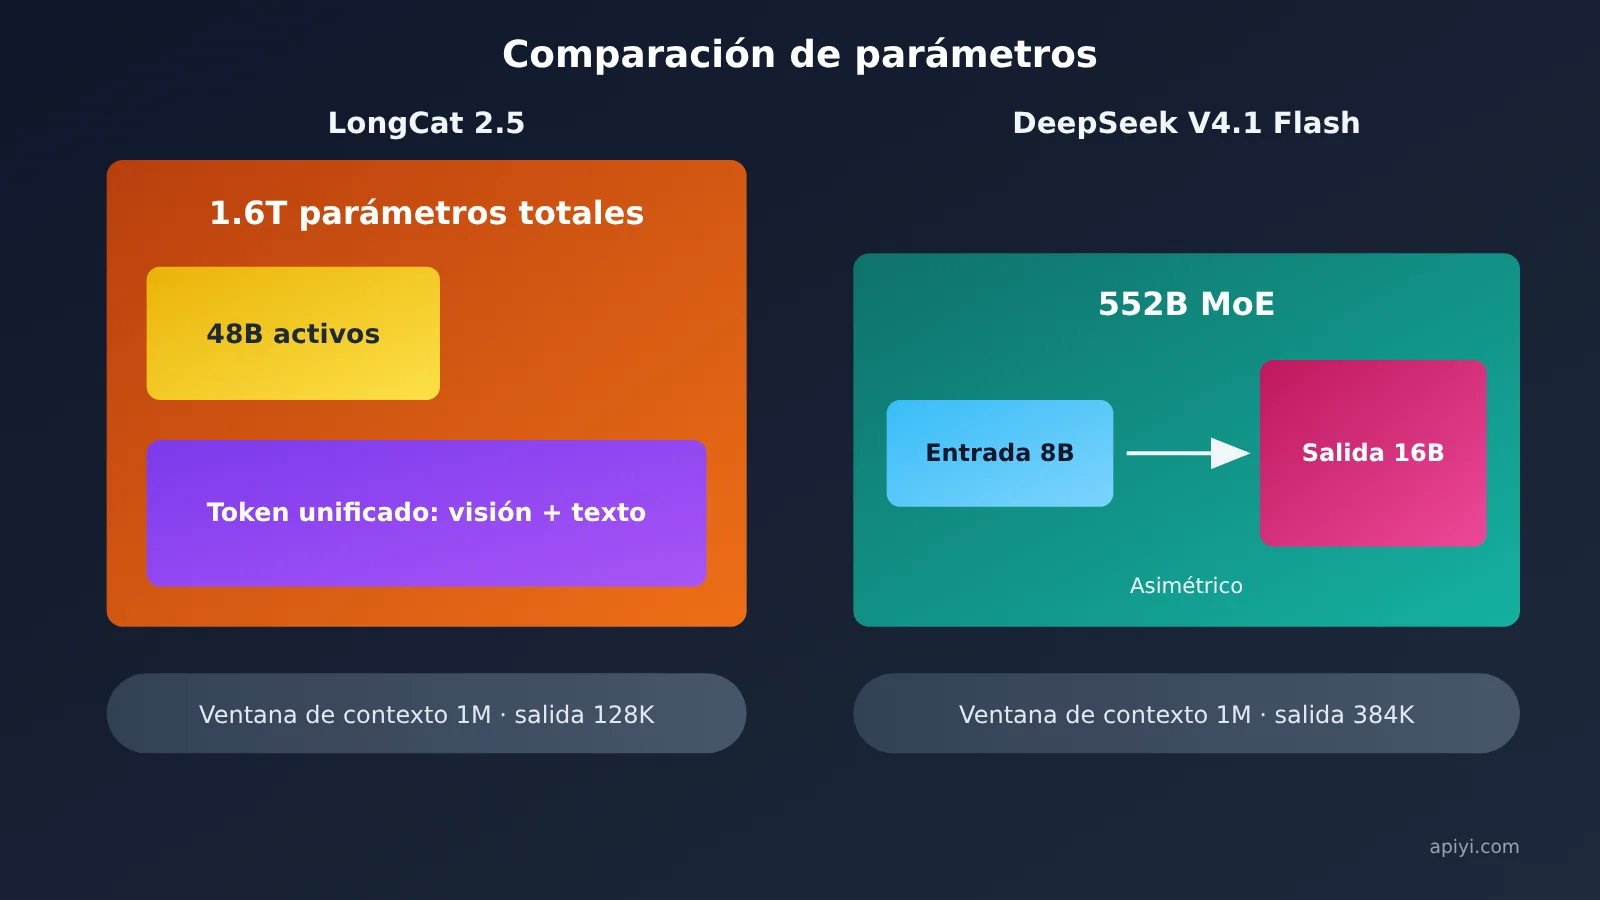
Ambos tienen exactamente el mismo precio en hora pico: entrada $0.30, caché $0.006 y salida $1.20 (por cada millón de tokens). La diferencia está en las tareas que mejor resuelven: la elección depende de lo que necesites hacer. LongCat 2.5 es un modelo multimodal nativo con 1.6T de parámetros totales y unos 48B activos por token. DeepSeek V4.1 Flash es un MoE asimétrico de 552B, que activa 8B en la entrada y 16B en la salida; sus pesos ya son de código abierto.
Este no es un artículo de compromiso que concluye que «cada uno tiene sus puntos fuertes». Todas las cifras que siguen proceden de los blogs oficiales, informes técnicos y páginas de precios de ambas compañías. Los resultados de las pruebas son autoevaluaciones de cada una; aquí solo se usan como referencia comparable, sin establecer una clasificación general ni atribuirles pruebas prácticas que no hemos realizado.
Qué te llevas: al terminar el artículo, podrás comparar cada tarea de tu proyecto, decidir qué modelo usar como principal y cuál como complemento, y calcular cuánto ahorrarías al trasladar las tareas por lotes a horas de menor demanda.
LongCat 2.5 frente a DeepSeek V4.1 Flash: dos fichas de modelo
La conclusión: LongCat 2.5 tiene más parámetros y activa más en cada invocación. DeepSeek V4.1 Flash es más pequeño, activa menos parámetros, permite respuestas más largas y ofrece sus pesos para descarga directa. Ambos tienen una ventana de contexto de 1M. Para elegir entre ellos, los tres factores clave son la salida máxima de 128K frente a 384K, si los pesos son abiertos y la cantidad de parámetros activados.
| Dimensión | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Parámetros totales | 1.6T (1,6 billones) | 552B |
| Parámetros activados | Aproximadamente 48B por token | 8B en la entrada y 16B en la salida |
| Arquitectura | Modelo multimodal nativo orientado a agentes, con un sistema unificado de tokens para visión y texto | MoE, con arquitectura asimétrica Causal-Encoder-Decoder |
| Ventana de contexto | 1M | 1M |
| Salida máxima | 128K | 384K |
| Visión nativa | Sí, las señales visuales se representan como tokens discretos de varios niveles | Sí (Vision) |
| Pesos abiertos | No se han publicado; tanto en GitHub como en HuggingFace figuran como «próximamente» | Abiertos; los pesos están publicados en HuggingFace junto con un informe técnico |
| Modo de razonamiento | Los resultados oficiales se obtuvieron con thinking activado | Activado por defecto; se puede ajustar con reasoning_effort |
Puntos clave de la arquitectura de LongCat 2.5
LongCat 2.5 tiene un objetivo claro: tareas de agentes de larga duración. Frente a la versión 2.0, refuerza principalmente la comprensión visual nativa y la programación de agentes. En la parte visual, discretiza las imágenes en su resolución nativa (SAE+RVQ), las preprocesa previamente para convertirlas en tokens visuales y después las entrena junto con la arquitectura principal. Esta procesa imágenes y texto con el mismo sistema de tokens, de ahí que se considere multimodal nativa.
Para el entrenamiento, LongCat 2.5 utiliza una gran cantidad de datos de trayectorias largas y aprendizaje por refuerzo (RL) de larga duración a gran escala. El blog oficial menciona varios detalles: convierte las trayectorias fallidas de agentes reales en tareas verificables; el RL asíncrono usa partial rollouts y filtra los grupos de muestras con todos los resultados correctos o todos incorrectos, que generan gradientes nulos; y penaliza el razonamiento y las llamadas a herramientas repetitivos. Este último punto es especialmente importante para quienes desarrollan agentes: el modelo se queda atrapado con menos frecuencia en bucles de llamadas a herramientas y desperdicia menos tokens.
En cuanto a la ingeniería de inferencia, W4A4 frente a W8A8 INT8 aumenta el rendimiento de prefill un 43,3 % y el de decode un 42,77 %, además de reducir el TTFT un 15,91 % y el TPOT un 19,72 %. En el entrenamiento, FSDP con doble particionado mejora el rendimiento por GPU del SFT con secuencias largas un 86 % frente a la referencia basada en DDP. Estas cifras indican que se ha aplicado una compresión específica para servir un modelo de 1,6 billones de parámetros, aunque el equipo oficial no ha publicado los límites de tasa.
Características clave de la arquitectura de DeepSeek V4.1 Flash
DeepSeek V4.1 Flash es el modelo más pequeño de la nueva familia. Su característica principal es la asimetría entre entrada y salida: activa solo 8B de parámetros al leer la entrada y 16B al generar la salida. En los escenarios con agentes, la entrada suele ser mucho mayor que la salida: por ejemplo, al leer repositorios, registros o respuestas de herramientas. Este diseño reduce precisamente el cómputo necesario para la lectura.
En cuanto a los costos, el cambio es aún mayor. La nueva generación de KV Cache ocupa mucho menos: los requisitos de HBM se reducen a 1/4 y los de SSD a 1/8 frente a la generación anterior. En comparación con el modelo de primera generación, la KV Cache se ha reducido 437 veces en total. Hay otro cambio importante: después del 14 de septiembre de 2026 a las 12:00, las solicitudes a deepseek-v4-pro se dirigirán a V4.1 Flash y se facturarán con la tarifa de Flash. Esta medida se mantendrá hasta el lanzamiento de V4.1 Pro. Los proyectos que sigan usando el nombre del modelo anterior ya estarán invocando Flash.
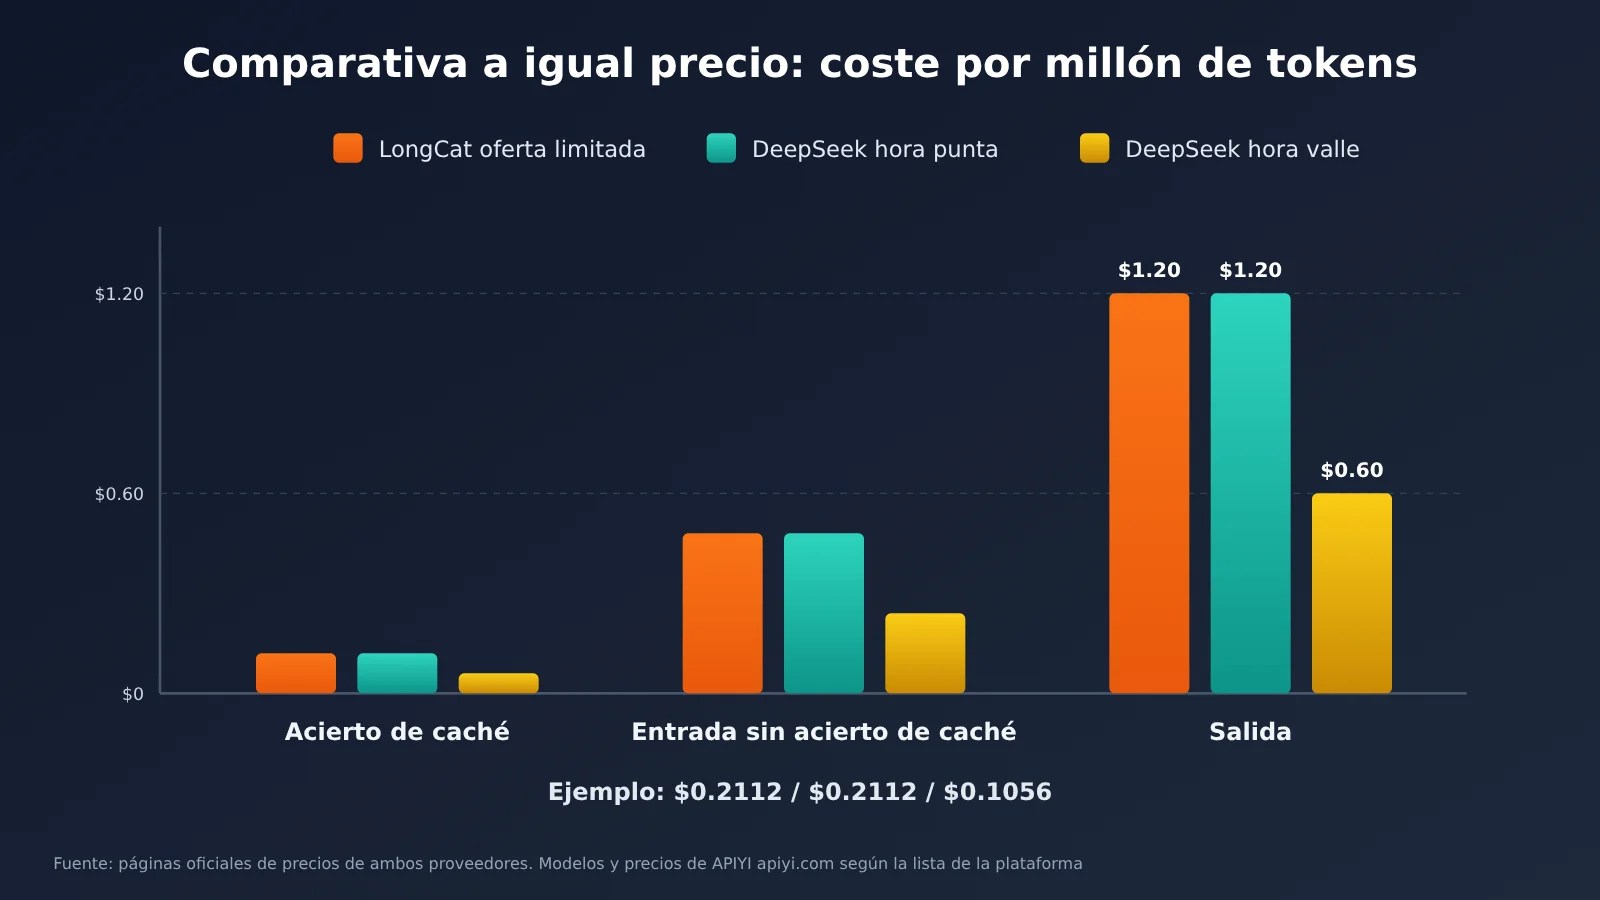
Precios de LongCat 2.5 y DeepSeek V4.1 Flash: solo coinciden en horario punta
En resumen: el precio promocional por tiempo limitado de LongCat 2.5 coincide, partida por partida, con el de DeepSeek V4.1 Flash en horario punta. Fuera de ese horario, DeepSeek aplica un descuento del 50 %, así que la misma tarea cuesta la mitad. Por tanto, solo tienen el mismo precio durante el horario punta de los días laborables.
| Por millón de tokens (USD) | LongCat 2.5 (descuento por tiempo limitado) | DeepSeek en horario punta | DeepSeek en horario valle |
|---|---|---|---|
| Entrada con acierto de caché | $0.006 | $0.006 | $0.003 |
| Entrada sin acierto de caché | $0.30 | $0.30 | $0.15 |
| Salida | $1.20 | $1.20 | $0.60 |
Hagamos una cuenta. Supongamos que una tarea de un agente consume 500.000 tokens de entrada (300.000 sin acierto de caché y 200.000 con acierto) y 100.000 tokens de salida:
- LongCat 2.5 (descuento por tiempo limitado): 0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek en horario punta: el cálculo es el mismo, $0.2112
- DeepSeek en horario valle: 0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
La diferencia por tarea es de unos 10 centavos de dólar, lo que no parece mucho. Pero, con 1.000 tareas del mismo tamaño al día, LongCat y DeepSeek en horario punta cuestan $211.2, frente a los $105.6 de DeepSeek en horario valle. Para un equipo que procesa lotes, la diferencia al cabo de un mes es considerable.
El horario punta de DeepSeek es de 09:00 a 12:00 y de 14:00 a 18:00, hora de Pekín, en días laborables. Esto corresponde a los periodos de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excepto los festivos oficiales de China. El resto del tiempo se aplica el precio reducido del horario valle: al mediodía, por la noche y de madrugada entre semana, así como durante todo el día los fines de semana y festivos. En otras palabras, de las 168 horas de la semana, el horario punta solo ocupa 7 horas por día laborable.
También conviene tener en cuenta algunos detalles de la facturación de LongCat 2.5:
- Solo se cobra cuando la respuesta es HTTP 200. Los códigos 401, 403, 429 y 500 no se facturan, así que los reintentos fallidos no cuestan nada.
- Paquetes de cuota: se ofrecen en ventas relámpago con unidades limitadas todos los días a las 10:00, 16:00, 21:00 y 23:00, hora de Pekín. Son válidos durante 30 días y la parte no consumida se puede reembolsar íntegramente. Los aciertos de caché no consumen tokens del paquete.
- Cuota gratuita: 10M de tokens para usuarios nuevos y 5M para usuarios existentes. Se acredita automáticamente y los aciertos de caché no la consumen.
- El precio figura como descuento por tiempo limitado; para cualquier cambio posterior, consulta la página oficial de precios.
En DeepSeek, la búsqueda en internet y la extracción de páginas web son API que se facturan por separado, a $0.75 por cada 1.000 solicitudes exitosas. Ambas tienen el mismo precio. Si tu agente accede a internet con frecuencia, tendrás que incluir este gasto por separado en el presupuesto.
💰 Nota sobre costos: si invocas DeepSeek V4.1 Flash a través de APIYI apiyi.com, la facturación depende de la lista de modelos de la plataforma y no tiene por qué coincidir con las tarifas oficiales de horas pico y valle. Para obtener una estimación más precisa, ejecuta primero un pequeño lote de tareas desde la consola de la plataforma y revisa la factura antes de decidir cómo procesarlas en masa.
LongCat 2.5 frente a DeepSeek V4.1 Flash: resultados oficiales
En resumen: en la mayoría de los benchmarks de agentes, la diferencia entre ambos es inferior a 3 puntos, así que están prácticamente al mismo nivel. LongCat 2.5 va por delante en Terminal Bench v4.0, Program Bench, JobBench y generación 3D; DeepSeek V4.1 Flash lidera en DeepSWE, NL2Repo y AutomationBench, con una ventaja mayor.
| Benchmark | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(texto a 3D) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
Sobre las condiciones de evaluación (lectura obligatoria): todas las cifras proceden de pruebas realizadas por cada compañía. Los resultados de LongCat 2.5 se obtuvieron con su propio harness, con el modo de razonamiento activado, temperature=1.0 y top_p=0.95. La mayoría de los resultados de DeepSeek proceden de su informe técnico público y se obtuvieron con su propio harness y el nivel de razonamiento Max. Como el harness, las fechas de evaluación y los niveles de razonamiento son distintos, esta tabla solo sirve como referencia entre modelos de una categoría similar y no constituye una clasificación.
Cómo interpretar los resultados
Las dos mayores diferencias apuntan en direcciones opuestas. En Terminal Bench v4.0, LongCat 2.5 supera a DeepSeek por 7,3 puntos (38,5 frente a 31,2); en DeepSWE v1.1, DeepSeek supera a LongCat por 9,6 puntos (74,2 frente a 64,6). El primero evalúa tareas de terminal más difíciles y largas; el segundo, la corrección de errores en repositorios reales. Ahí se distinguen las fortalezas de cada modelo: uno destaca en operaciones de terminal con secuencias largas, y el otro en modificaciones precisas dentro de bases de código existentes.
En la versión anterior, Terminal Bench v2.1, DeepSeek obtiene 2,2 puntos más. Esto indica que la ventaja de LongCat aparece cuando aumenta la dificultad. En Program Bench, LongCat lleva 5,2 puntos de ventaja; en NL2Repo, DeepSeek lleva 4,9. NL2Repo evalúa la generación de un repositorio completo a partir de una descripción en lenguaje natural, algo más cercano a la capacidad de ingeniería para crear un proyecto desde cero.
Las diferencias son pequeñas en las pruebas relacionadas con visión. En Vision2Web, DeepSeek supera a LongCat por 0,6 puntos; en 3DCodeBench, LongCat lleva 2,1 puntos de ventaja. En la tabla oficial de CharXiv-RQ w/tools, LongCat obtiene 90,2 frente a 87,7; en MathVision w/tools, DeepSeek obtiene 97,4 frente a 96,5. Si nos fijamos solo en la comprensión visual, ambos están bastante parejos. La ventaja de LongCat está sobre todo en combinar esa comprensión con la generación de contenido 3D y páginas interactivas. Entre sus ocho demostraciones oficiales hay una simulación de fluidos en tiempo real, una exhibición interactiva de piezas históricas en 3D, una maqueta urbana y recursos para escenas en miniatura: la orientación es clara.
En BrowseComp, HLE w/tools y MCP Atlas, las diferencias no superan los 1,3 puntos. En capacidades generales de agente, como la búsqueda en internet y la invocación de herramientas MCP, se puede considerar que están empatados.
Los niveles de razonamiento de DeepSeek son una palanca para controlar costos
La sección 5.3.3 del informe técnico de DeepSeek ofrece datos muy útiles. Al subir el nivel de razonamiento de 25 a 100, el Pass@1 promedio en ocho benchmarks de razonamiento aumenta del 67,1 % al 76,3 %, y el resultado en DeepSWE v1.1 pasa de 66,0 a 74,2. A cambio, los tokens de salida se multiplican aproximadamente por 2,5. Los niveles de 60 a 80 ya se acercan a la precisión máxima, pero consumen menos de la mitad del presupuesto de tokens; al subir hasta 100, la longitud de las trayectorias del agente aumenta entre 1,6 y 1,8 veces más, a cambio de una mejora marginal.
También hay que tener en cuenta que reasoning_effort está configurado en high por defecto en la API de DeepSeek, mientras que los resultados oficiales se obtuvieron en el nivel Max. Para reproducir las puntuaciones de la columna de DeepSeek de la tabla anterior, hay que establecerlo explícitamente en max. Para las tareas cotidianas, usa un nivel intermedio y reserva el máximo para las más difíciles. Los tokens de salida son el concepto más caro en las facturas de ambos proveedores ($1.20), así que este ajuste determina directamente dónde se gasta el dinero.
LongCat 2.5 frente a DeepSeek V4.1 Flash: cómo repartir las tareas
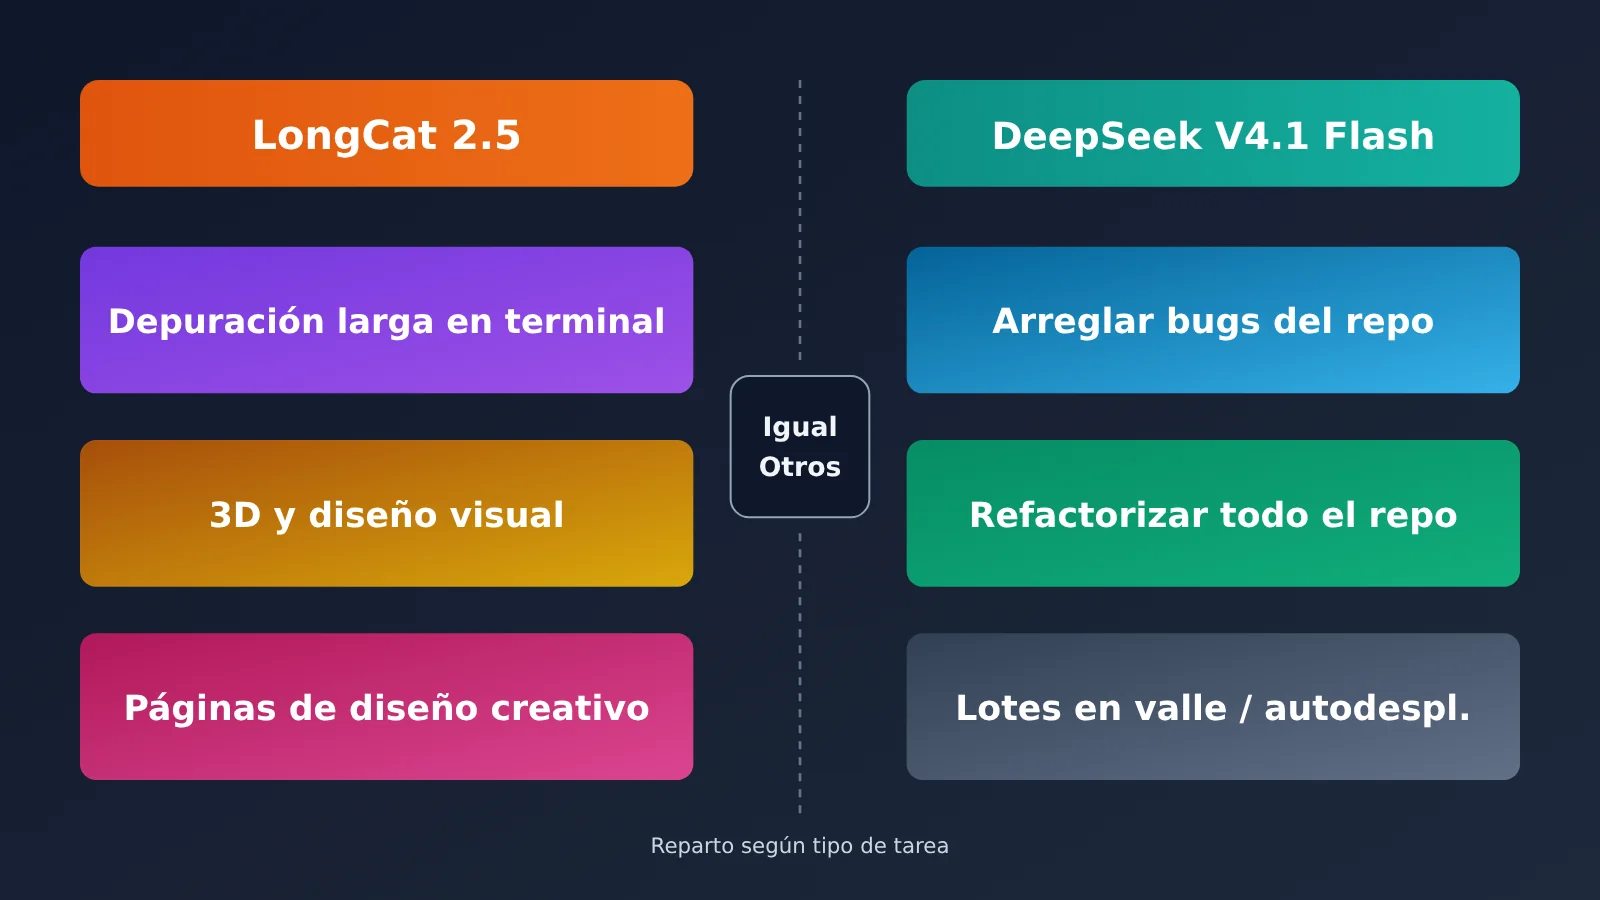
La conclusión: mismo precio, distintos trabajos. Para tareas largas en terminal, trabajos visuales y 3D, y páginas de diseño creativo, elige LongCat 2.5. Para modificar código en repositorios reales, corregir bugs de software, ejecutar flujos de automatización o desplegar el modelo por tu cuenta, elige DeepSeek V4.1 Flash.
| Más adecuado para LongCat 2.5 | Más adecuado para DeepSeek V4.1 Flash |
|---|---|
| Resolución de problemas prolongada en terminal: acceder a un servidor, revisar registros, cambiar configuraciones, reiniciar y verificar en varios pasos (7,3 puntos más en Terminal Bench v4.0) | Corrección de bugs en repositorios reales: leer una incidencia, localizar archivos, hacer cambios y superar las pruebas (9,6 puntos más en DeepSWE) |
| Recursos 3D y propuestas visuales: generar escenas 3D a partir de texto y páginas de presentación interactivas (55,4 en 3DCodeBench) | Refactorización de repositorios completos y creación desde cero: generar proyectos con varios archivos a partir de una descripción de requisitos (4,9 puntos más en NL2Repo) |
| Páginas de diseño creativo: invitaciones para eventos, páginas con colores estilizados e informes de visualización de datos (aplicaciones mostradas en las demostraciones oficiales) | Flujos de automatización y procesamiento por lotes: procesos nocturnos, limpieza de datos y generación de informes (3,0 puntos más en AutomationBench y mitad de precio en horas valle) |
| Construcción de programas tipo ejercicio y tareas profesionales integrales (ventaja en Program Bench y JobBench) | Escenarios que requieren despliegue propio o privado: los pesos están disponibles como código abierto en HuggingFace; salidas largas en una sola respuesta (hasta 384K) |
Por qué elegir LongCat 2.5
La cifra más convincente de LongCat 2.5 está en Terminal Bench: en v2.1 quedó 2,2 puntos por detrás, pero en v4.0 pasó a liderar por 7,3 puntos. Esto sugiere que su ventaja relativa aumenta cuanto más larga y difícil es la tarea. El resultado encaja con su entrenamiento, que hizo un uso intensivo de trayectorias largas y penalizó las llamadas repetitivas a herramientas. Si tu agente suele ejecutar decenas de pasos consecutivos en el terminal, merece la pena probar LongCat 2.5 primero.
La segunda razón son las tareas que combinan visión y generación. Su capacidad multimodal nativa y su entrenamiento orientado a 3D y páginas interactivas lo hacen más adecuado para trabajos como crear diseños a partir de imágenes o generar contenido 3D desde texto. Además, los nuevos usuarios reciben 10 millones de tokens gratis, y los aciertos de caché no se descuentan de esa cuota, por lo que probarlo cuesta muy poco.
Por qué elegir DeepSeek V4.1 Flash
La cifra más sólida de DeepSeek V4.1 Flash es su 74,2 en DeepSWE, donde presenta la mayor ventaja entre las pruebas comparadas de ambos modelos. Una de las tareas más habituales al programar es modificar un repositorio existente, y ahí es donde destaca. Su salida máxima de 384K es el triple de la de LongCat, así que es menos probable que se trunquen archivos largos o parches extensos.
La tercera razón es su estructura de costos. El precio se reduce a la mitad fuera de las horas pico y, además, permite ajustar el nivel de razonamiento. Al combinar ambas opciones, ofrece mucha más flexibilidad de costos para tareas por lotes que el precio fijo por tiempo limitado de LongCat. Su límite de 2500 solicitudes simultáneas también figura en la documentación oficial, lo que da una cifra clara para planificar la capacidad. Los equipos que necesiten un despliegue privado pueden descargar los pesos directamente, aunque la documentación oficial indica que un despliegue a gran escala requiere recursos del orden de 2000 GPU. Los equipos pequeños deberían evaluar su hardware antes de desplegarlo por su cuenta.
💡 Recomendación: La tabla sirve para acotar las opciones, pero la decisión final depende de tus propias tareas. Puedes elegir entre 10 y 20 tareas representativas de tu proyecto, ejecutarlas con ambos modelos y comparar la tasa de éxito y el consumo de tokens. Para probar DeepSeek V4.1 Flash, puedes acceder primero a través de APIYI apiyi.com y evitar abrir una cuenta por separado.
Cómo integrar LongCat 2.5 y DeepSeek V4.1 Flash
En resumen: ambos son compatibles con los formatos de API de OpenAI y Anthropic. Para conectarlos a Claude Code, solo hay que cambiar algunas variables de entorno en ~/.claude/settings.json. DeepSeek también admite la Responses API.
Integrar LongCat 2.5
- Formato OpenAI (cualquier SDK de OpenAI): configura
base_urlcomohttps://api.longcat.ai/openaiy el nombre del modelo comoLongCat-2.5. - Formato Anthropic (SDK de Anthropic): configura
base_urlcomohttps://api.longcat.ai/anthropic. - Claude Code (edita el campo env de
~/.claude/settings.json): debes incluir las cuatro variables: ANTHROPIC_AUTH_TOKEN: tu clave de LongCatANTHROPIC_BASE_URL:https://api.longcat.ai/anthropicANTHROPIC_MODEL:LongCat-2.5CLAUDE_CODE_MAX_OUTPUT_TOKENS:131072- Gestión de límites de tasa (en tu código de invocación): si superas el límite, se devuelve un error 429 (
rate_limit_exceeded,retry_after 60). La recomendación oficial es usar espera exponencial. La documentación no publica cifras de RPM/TPM y las respuestas 429 no se cobran.
Integrar DeepSeek V4.1 Flash
- Formato OpenAI (cualquier SDK de OpenAI): usa
deepseek-flashcomo nombre del modelo. Los nombres anterioresdeepseek-v4-flashydeepseek-v4-flash-vision-expsiguen funcionando: se redirigen a V4.1-Flash-1017 y se cobran con la tarifa de Flash. - Claude Code (edita el campo env de
~/.claude/settings.json): ANTHROPIC_AUTH_TOKEN: tu clave de DeepSeekANTHROPIC_BASE_URL:https://api.deepseek.com/anthropicANTHROPIC_MODEL:deepseek-flash- Nivel de razonamiento (parámetro de solicitud del SDK de OpenAI): para el uso diario, configura
reasoning_efforten el nivel medio; para problemas difíciles, usamax. - Herramientas listas para usar: WorkBuddy (incluido CodeBuddy) y OpenCode son herramientas asociadas oficialmente y ya cuentan con integración completa.
Invocación unificada a través de APIYI
Si necesitas ejecutar varios modelos a la vez para compararlos, con APIYI puedes cambiar entre ellos usando una sola cuenta y una clave API, sin tener que registrarte por separado en cada proveedor.
- Configuración del SDK de OpenAI (en el código de tu proyecto): configura
base_urlcomohttps://api.apiyi.com/v1yapi_keycon la clave generada en la consola de APIYI. - Nombre del modelo (cámbialo en el mismo parámetro de solicitud): para DeepSeek V4.1 Flash, usa
deepseek-v4.1-flashodeepseek-v4.1-flash-1017. La facturación se basa en la lista de modelos de la plataforma. - Pruebas comparativas (con el mismo código): cambia solo el parámetro
modelpara ejecutar el mismo conjunto de tareas con otros modelos de la plataforma y comparar los resultados.base_urlsigue siendohttps://api.apiyi.com/v1.
Consulta la lista de modelos de la plataforma para conocer los modelos y precios vigentes. APIYI todavía no ofrece LongCat-2.5, pero lo incorporará pronto. Hasta entonces, usa el endpoint oficial para LongCat 2.5; DeepSeek, por su parte, puedes gestionarlo desde APIYI en apiyi.com.
🚀 Inicio rápido: los usuarios nuevos reciben crédito gratuito para pruebas al registrarse en APIYI, en apiyi.com. Integra primero DeepSeek V4.1 Flash en tu proyecto actual con el SDK de OpenAI: basta con cambiar una línea de
base_urlpara empezar.
Preguntas frecuentes sobre LongCat 2.5 y DeepSeek V4.1 Flash
Q1: ¿Los dos cuestan realmente lo mismo?
Solo durante las horas punta de DeepSeek. El precio promocional por tiempo limitado de LongCat 2.5 es de $0.30 / $0.006 / $1.20, idéntico al de DeepSeek en horas punta para cada concepto. Fuera de las horas punta, DeepSeek aplica un descuento del 50 % a todo. Ese horario abarca todas las horas excepto de 09:00 a 12:00 y de 14:00 a 18:00 en días laborables. Además, el precio de LongCat es una oferta temporal y podría cambiar más adelante.
Q2: ¿La tabla de benchmarks permite saber cuál es mejor?
No permite establecer una clasificación directa. Ambos publicaron resultados de sus propias pruebas, pero usaron distintos entornos de evaluación, fechas y niveles de razonamiento. Además, la columna de DeepSeek muestra los resultados del nivel Max. Lo más útil es fijarse en las pruebas con diferencias amplias: LongCat supera a DeepSeek por 7.3 puntos en Terminal Bench v4.0, mientras que DeepSeek aventaja a LongCat por 9.6 puntos en DeepSWE. En las pruebas con diferencias de 1 o 2 puntos, se puede considerar que hay un empate.
Q3: ¿Cuándo se publicará LongCat 2.5 como código abierto?
No hay un calendario oficial. Por ahora, tanto GitHub como HuggingFace muestran «Próximamente» y no se han publicado los pesos. Para proyectos que necesitan despliegue propio, de momento la única opción es DeepSeek V4.1 Flash, cuyos pesos e informe técnico ya son públicos.
Q4: ¿Se pueden invocar ambos modelos en APIYI?
Por ahora solo se puede invocar DeepSeek V4.1 Flash, con los identificadores `deepseek-v4.1-flash` y `deepseek-v4.1-flash-1017`. La facturación sigue la lista de modelos de la plataforma. APIYI todavía no ofrece LongCat-2.5, pero lo incorporará lo antes posible. Consulta la lista de modelos de APIYI en apiyi.com para conocer los identificadores y precios vigentes.
Q5: ¿Cómo reducir el costo de las tareas por lotes?
Al usar DeepSeek, aprovecha dos ajustes: programa las tareas fuera de las horas punta para reducir el precio unitario a la mitad y configura reasoning_effort en un nivel medio. Según el informe, los niveles de 60 a 80 ya se acercan a la precisión del nivel máximo, con menos de la mitad de su presupuesto de tokens. El precio cuando hay acierto de caché es solo 1/50 del precio sin acierto. Colocar las indicaciones de sistema y las definiciones de herramientas fijas al principio de la solicitud puede mejorar la tasa de aciertos.
Resumen: cómo elegir entre LongCat 2.5 y DeepSeek V4.1 Flash
La conclusión es clara: precios similares, tareas distintas. Reparte el trabajo según las fortalezas de cada modelo y ejecuta los lotes en horario valle.
- Escala: LongCat tiene 1,6T de parámetros, con 48B activos; DeepSeek tiene 552B, con 8B activos para la entrada y 16B para la salida. Ambos tienen una ventana de contexto de 1M.
- Límite de salida: 128K para LongCat y 384K para DeepSeek. Para tareas que requieren respuestas largas, elige DeepSeek.
- Precio: el precio promocional de LongCat equivale al precio de DeepSeek en horario punta. DeepSeek cuesta la mitad en horario valle: $0.2112 frente a $0.1056 en el ejemplo de cálculo.
- Evaluaciones: LongCat supera por 7,3 puntos a DeepSeek en tareas prolongadas de terminal; DeepSeek lleva una ventaja de 9,6 puntos al corregir errores en repositorios. En la mayoría de las demás pruebas, están empatados.
- Código abierto: DeepSeek ya es de código abierto; LongCat no ha publicado sus pesos.
- Integración: ambos son compatibles con los formatos de OpenAI y Anthropic. En Claude Code basta con cambiar las variables de entorno para alternar entre ellos.
En pocas palabras: elige un modelo principal según la tabla de tareas y deja el otro como complemento; procura ejecutar los lotes en horario valle. Para probar DeepSeek V4.1 Flash, puedes usar primero la interfaz unificada de APIYI apiyi.com a pequeña escala y después decidir cuál será tu opción principal.
📚 Referencias
- Blog oficial de LongCat-2.5: posicionamiento del modelo, arquitectura, entrenamiento y detalles de ingeniería
- Enlace:
longcat.ai/blog/longcat-2.5 -
Descripción: escala de parámetros, solución de tokens visuales, datos de inferencia W4A4 y tabla oficial de evaluaciones
-
Documentación de la plataforma abierta de LongCat: precios, endpoints e integración con Claude Code
- Enlace:
longcat.ai/platform/docs -
Descripción: precio promocional por tiempo limitado, gestión de errores 429, paquetes de cuota y condiciones de las bonificaciones
-
Anuncio de DeepSeek V4.1 Flash: arquitectura, código abierto y cambios en la API
- Enlace:
deepseek.com/news/deepseek-v4-1-flash -
Descripción: MoE asimétrico, compresión de la caché KV y guía de migración de nombres de modelos
-
Página de precios de la API de DeepSeek: precios en horario punta y valle y límites de concurrencia
- Enlace:
api-docs.deepseek.com/quick_start/pricing -
Descripción: definición de los horarios punta y valle, concurrencia de 2500 y facturación separada para búsquedas y extracción de contenido
-
Repositorio de pesos de DeepSeek-V4.1-Flash: pesos abiertos e informe técnico
- Enlace:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - Descripción: resultados de la tabla 3 y análisis de los niveles de inferencia en la sección 5.3.3
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal de APIYI apiyi.com. Para consultar más recursos de integración, visita el centro de documentación en docs.apiyi.com.