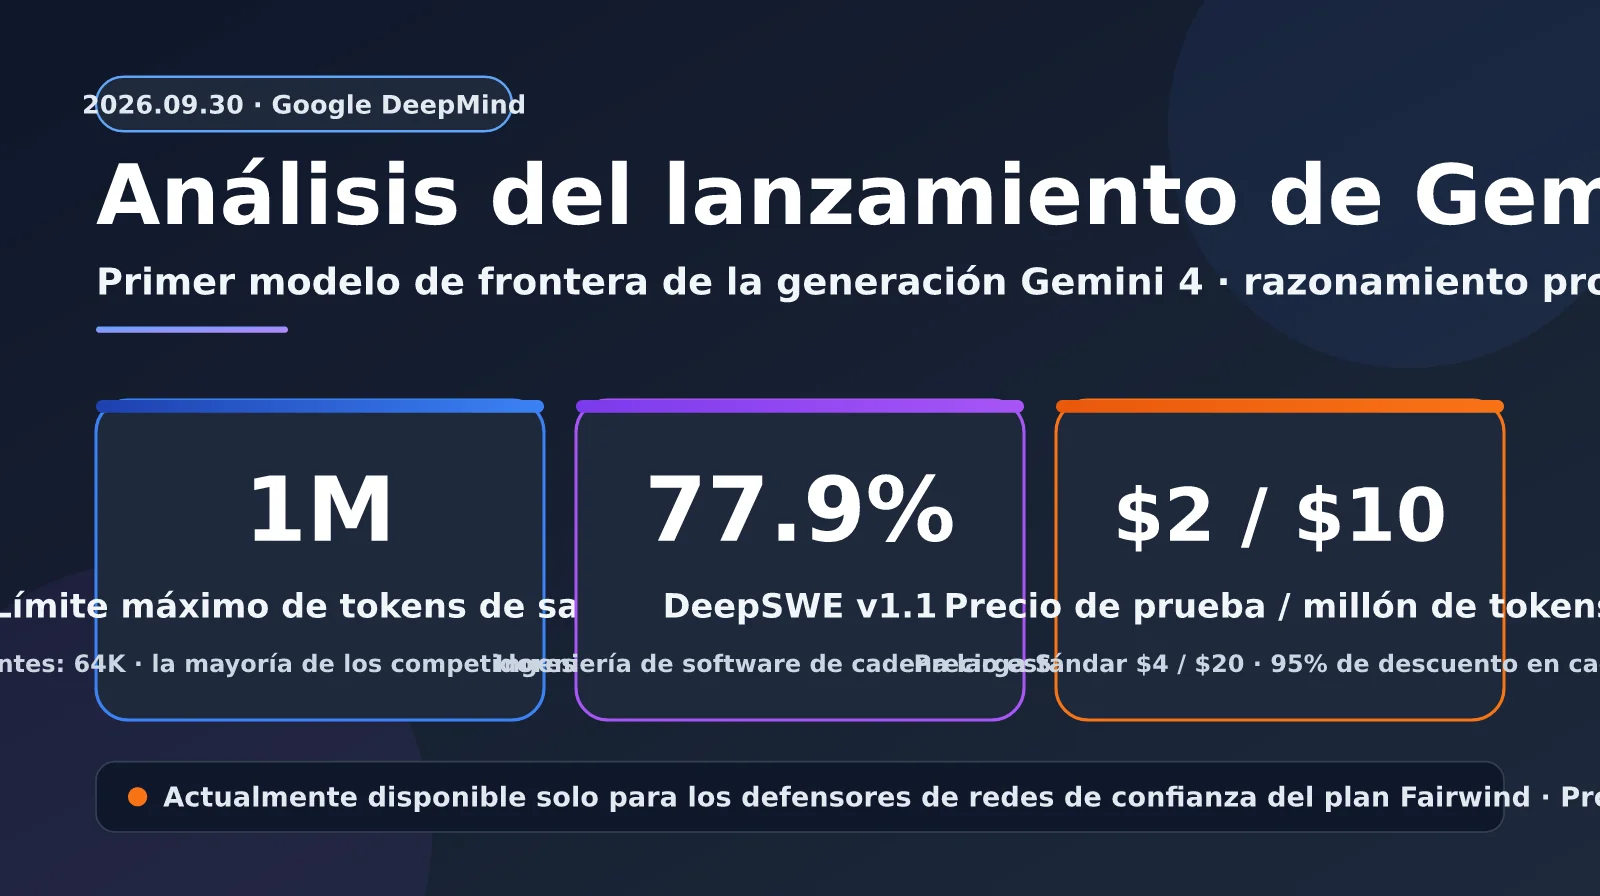
El 30 de septiembre de 2026, Koray Kavukcuoglu, vicepresidente sénior y arquitecto jefe de IA de Google DeepMind, presentó Gemini 4 Argon en el blog oficial de Google. Es el primer modelo de la generación Gemini 4 y el modelo de frontera más avanzado de Google hasta la fecha. Argon está diseñado para el razonamiento profundo en cadenas largas y se centra en tres ámbitos: la ingeniería de software en entornos reales, el trabajo de conocimiento empresarial en sectores como el legal y el financiero, y la ciberdefensa.
Este lanzamiento rompe con varias convenciones. Primero, abandona la nomenclatura por niveles Pro, Flash y Flash-Lite y, por primera vez, adopta un nombre en clave: «Argon». Segundo, el límite de salida por solicitud pasa directamente de 64K a 1M tokens. Tercero, el modelo no se lanza de entrada para todos los desarrolladores: primero estará disponible para los defensores de redes de confianza del programa Fairwind. En este artículo, a partir de la publicación original de Google y de información pública de medios en inglés y evaluaciones independientes, analizamos las capacidades principales, los resultados de las pruebas de referencia, los precios y el calendario de disponibilidad de Gemini 4 Argon.
Valor principal: al terminar de leer, podrás evaluar rápidamente qué relación tiene Gemini 4 Argon con tu negocio, cuándo podrás usarlo y qué preparativos conviene hacer para integrarlo.
Gemini 4 Argon: información clave de un vistazo
Empecemos con una tabla que resume la información principal de la publicación de Google. Hay que tener en cuenta que Google solo especifica un límite de salida de 1M tokens; no ha publicado la cifra concreta de la ventana de contexto de entrada. Algunos medios hablan de una «ventana de entrada de 1M», pero por ahora no hemos encontrado una fuente oficial de Google que lo confirme. Conviene esperar a la documentación oficial.
| Elemento | Información oficial sobre Gemini 4 Argon | Detalles |
|---|---|---|
| Fecha de lanzamiento | 30 de septiembre de 2026 | Anunciado simultáneamente en el blog oficial de Google y en la cuenta de DeepMind |
| Posicionamiento del modelo | Primer modelo de frontera de la generación Gemini 4 | Usa por primera vez un nombre en clave; no sigue la clasificación Pro/Flash |
| Límite de salida | 1M tokens (antes, 64K) | Google lo califica de «líder del sector»; la salida por solicitud de los competidores suele ser de 128K |
| Contexto de entrada | No publicado oficialmente | Algunos medios hablan de 1M, pero no hay una fuente oficial |
| Precio promocional | 2 USD por millón de tokens de entrada / 10 USD por millón de tokens de salida | 95 % de descuento en la entrada en caché |
| Precio estándar | 4 USD por millón de tokens de entrada / 20 USD por millón de tokens de salida | No se ha anunciado la duración del periodo promocional |
| Disponibilidad actual | Defensores de redes de confianza del programa Fairwind y equipos internos de Google | El siguiente paso será abrirlo a clientes de API de pago y a suscriptores de AI Ultra |
| ID del modelo en la API | Aún no publicado oficialmente | La comunidad ha encontrado una entrada que podría corresponderle en Vertex AI, pero no está confirmada |
Los tres ámbitos prioritarios de Gemini 4 Argon
En su publicación, Google concentra las capacidades de Argon en tres ámbitos. En ingeniería de software, Argon puede mantener el razonamiento a lo largo de flujos de trabajo complejos con varios pasos. Los ingenieros de Google ya lo utilizan a diario para depurar y realizar migraciones de código a gran escala. En trabajo de conocimiento empresarial, destaca en pruebas de referencia para agentes en campos especializados como el legal y el financiero. Es adecuado para tareas que requieren leer grandes cantidades de documentos y ofrecer conclusiones estructuradas. La ciberdefensa es el aspecto más particular de Argon: se ha entrenado específicamente para detectar, verificar y corregir de forma autónoma vulnerabilidades críticas de software.
También se destacan sus capacidades multimodales, como el análisis de gráficos de nivel profesional, la localización de detalles en videos largos y la ejecución de tareas a través de una serie de documentos. Google menciona además mejoras en escritura creativa, lo que deja claro que Argon no es un modelo especializado únicamente en programación.
🎯 Recomendación de integración: Gemini 4 Argon todavía se está habilitando por etapas. Si quieres probarlo en tu negocio cuanto antes, te recomendamos preparar con anticipación la integración de los modelos Gemini en la plataforma APIYI apiyi.com. La plataforma ofrece una interfaz unificada compatible con OpenAI; cuando se lance un modelo nuevo, normalmente bastará con cambiar el parámetro
modelpara empezar a usarlo.
Interpretación de los resultados de referencia de Gemini 4 Argon
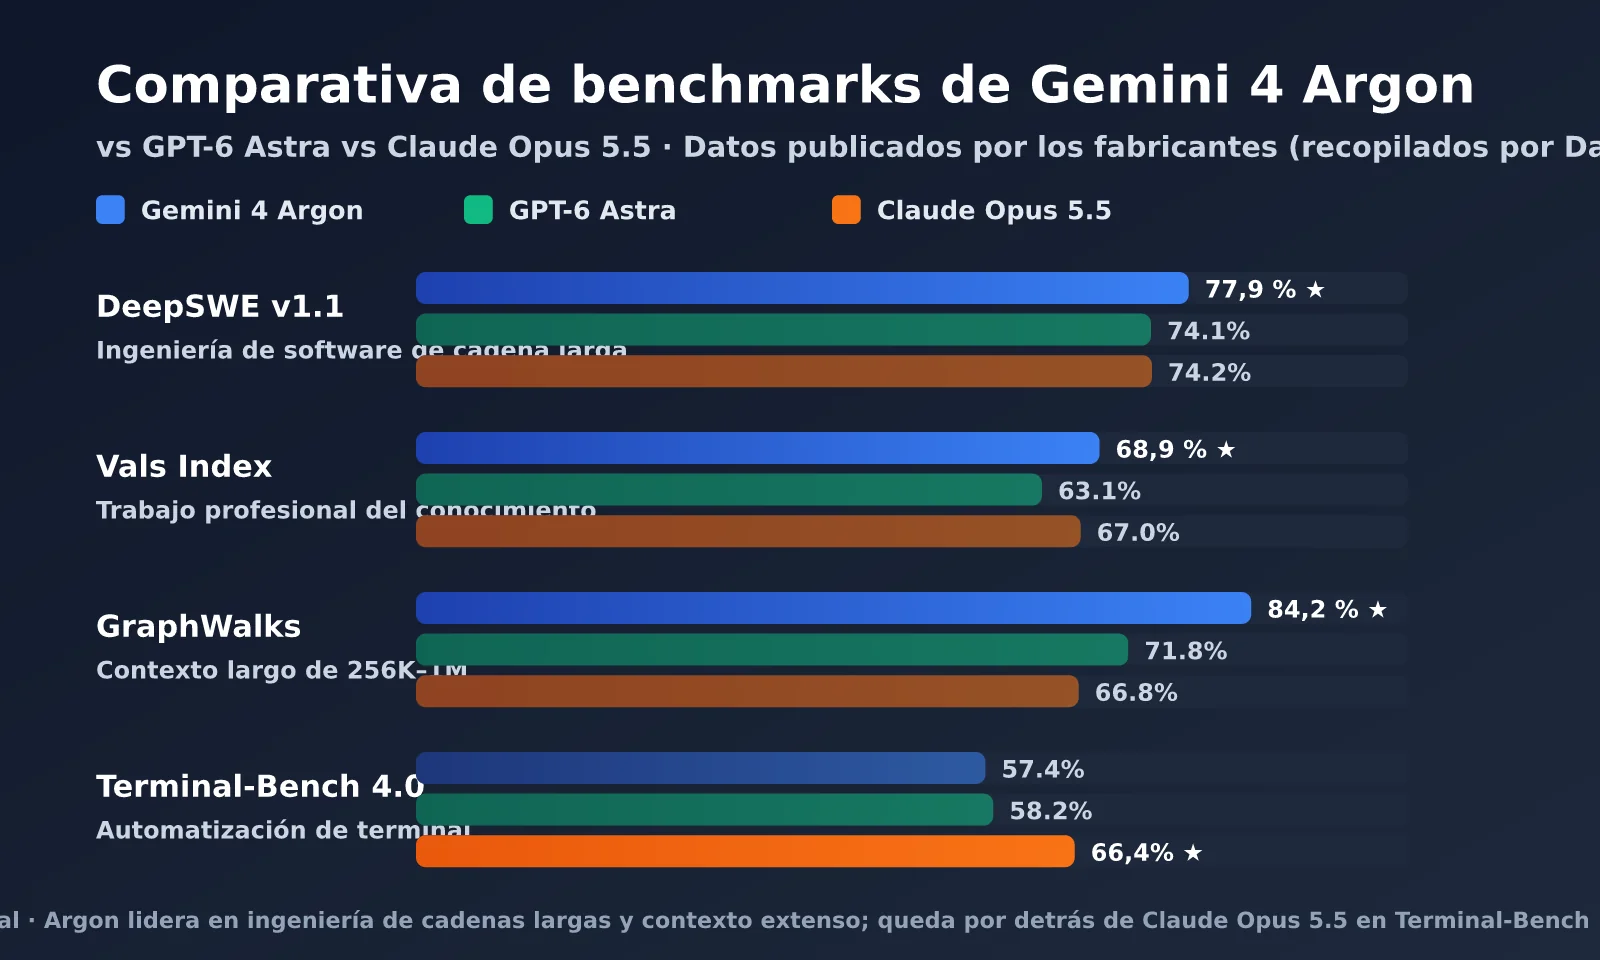
Google publicó una serie de resultados de referencia en su blog, y organismos externos como Artificial Analysis y Vals no tardaron en presentar sus propias evaluaciones independientes. La siguiente tabla reúne los datos publicados por Google (recopilados por DataCamp) y los compara con OpenAI GPT-6 Astra y Claude Fable 5.1 y Claude Opus 5.5, de Anthropic.
| Prueba de referencia | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| Agente legal Harvey | 19.6% | 5.4% | 6.7% | 3.8% |
| GraphWalks (256K–1M) | 84.2% | 71.8% | 65.0% | 66.8% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
Estos resultados muestran que Gemini 4 Argon destaca en ingeniería de software de largo recorrido (DeepSWE), agentes para ámbitos especializados (Vals y Harvey) y razonamiento con contextos muy extensos (GraphWalks). La ventaja en la prueba del agente legal Harvey es especialmente notable: Argon logra un 19.6%, frente a resultados de un solo dígito para los demás modelos. Esto apunta a una diferencia generacional en tareas especializadas que requieren mucho tiempo y el análisis de múltiples documentos.
Sin embargo, Argon no lidera en todos los frentes. En pruebas más centradas en el uso de terminales y en tareas avanzadas de ingeniería, como FrontierSWE v2 y Terminal-Bench 4.0, queda por detrás de GPT-6 Astra y Claude Opus 5.5, respectivamente. En CWE-bench v1, Argon comparte el primer puesto con GPT-6 Astra; según informó Engadget, Grok 4.7 también está empatado en esa posición. Además, Google publicó otros dos resultados: 51.3% en Zapier AutomationBench (primer puesto) y 91.7% en comprensión de videos largos LVBench (SOTA).
Evaluaciones independientes de Gemini 4 Argon
Las evaluaciones independientes ofrecen una lectura más prudente que los datos publicados por el fabricante. En el Intelligence Index de Artificial Analysis, Argon obtuvo 52.6 puntos, prácticamente a la par de los 52.7 de GPT-6 Astra y por debajo de los 57.6 de Claude Opus 5.5. Cabe señalar que esta organización solo evaluó Argon en el nivel High. En Vals Index, Argon quedó en primer lugar entre 41 modelos, con un 68.9%; también encabezó el Arena de texto de Arena.ai, con 1525 puntos.
| Dimensión de la evaluación independiente | Gemini 4 Argon | Referencia comparativa | Interpretación |
|---|---|---|---|
| Índice de inteligencia de AA | 52.6 | GPT-6 Astra 52.7 / Opus 5.5 57.6 | A la par de Astra, sin una ventaja clara |
| Tasa de alucinaciones (AA) | 15% | GPT-6 Astra: aprox. 51%-54% | La más baja entre los modelos principales; destaca por su fiabilidad |
| Precisión factual | 50% | GPT-6 Astra 63% | Tiende más a no responder cuando no sabe |
| Costo promedio por tarea (AA) | $1.99 | Astra $3.26 / Opus 5.5 $5.98 | Buena relación calidad-precio durante la promoción de lanzamiento |
| Costo por prueba de Vals | $15.68 | Opus 5.5 $32.14 | Aproximadamente la mitad que Opus 5.5 |
Conviene analizar juntas la tasa de alucinaciones y la precisión factual. Argon tiene una tasa de alucinaciones de solo el 15%, pero su precisión factual también es inferior a la de Astra. Esto indica que, cuando no está seguro, tiende más a abstenerse de responder que a inventar una respuesta. En el trabajo empresarial basado en conocimiento, suele ser preferible esta actitud de «mejor responder menos que dar información falsa». La valoración de The Decoder resulta bastante equilibrada: Google ha cerrado la brecha, pero aún no ha logrado una ventaja clara.
💡 Consejo para elegir: los resultados de referencia son solo una guía y el rendimiento varía mucho según la tarea. Recomendamos probar Gemini, GPT y Claude en paralelo con datos reales de tu negocio a través de la plataforma APIYI apiyi.com. Una interfaz unificada puede reducir considerablemente el costo de comparar varios modelos.
Qué significa el límite de salida de 1M de Gemini 4 Argon
El límite de salida de 1M de tokens es la cifra de este lanzamiento que más fácilmente se puede malinterpretar. No significa que puedas hacer una pregunta en Gemini App y recibir una respuesta de un millón de palabras. Está pensado para flujos de trabajo de agentes de larga duración. Cuando un modelo necesita generar grandes cantidades de código de forma continua, realizar varias llamadas a herramientas y seguir produciendo resultados intermedios, el antiguo límite de salida de 64K puede convertirse en un cuello de botella y obligar a los desarrolladores a dividir la tarea en muchos segmentos.
En una publicación, Google ilustró el valor práctico de esta capacidad con tres casos internos. Son también la mejor forma de entender el propósito de Argon.
| Caso interno | Tarea | Resultado publicado |
|---|---|---|
| Optimización de algoritmos cuánticos | Optimizar los recursos de espacio y tiempo de las subrutinas (número de cúbits × número de puertas) | En unos minutos, superó en un 40 % la referencia publicada |
| Optimización de la eficiencia de memoria | Un agente analiza la telemetría de perfiles de rendimiento de toda la flota y aplica optimizaciones | Ya se han liberado más de 300 TiB; se estima un ahorro total de entre 500 TiB y 1 PiB |
| Migración de C/C++ a Rust | Desde re2 y libgav1 hasta el kernel Fuchsia Zircon (más de 800.000 líneas) | libgav1 sustituyó 32.000 líneas de código SIMD; la decodificación es 2,7 veces más rápida que en la versión original migrada a Rust y produce resultados idénticos |
El caso de migración de C/C++ a Rust es el que mejor muestra el valor del límite de salida de 1M. Migrar un kernel de más de 800.000 líneas exige que el modelo mantenga una comprensión coherente del contexto, genere código y lo verifique por sí mismo durante una tarea continua. Cuanto mayor sea el límite de salida, menos veces habrá que interrumpir y dividir la tarea. Para los equipos que trabajan en la refactorización de grandes bases de código o en la modernización de sistemas heredados, este aspecto resulta más útil que una puntuación aislada en una prueba de referencia.
Capacidades de ciberseguridad de Gemini 4 Argon
La ciberseguridad es el rasgo más distintivo de Argon. Google afirma que Argon puede detectar, verificar y corregir de forma autónoma vulnerabilidades críticas de software. En las pruebas internas de detección de vulnerabilidades en 20 lenguajes de programación y en las pruebas de penetración de caja negra de Wiz, Argon logró una «mejora significativa» respecto a Gemini 3.8 Flash Cyber, la generación anterior.
Un caso concreto procede de la empresa de seguridad Wiz. A través del programa Scan for Good de Google, Wiz utilizó Argon para descubrir una vulnerabilidad grave en un software médico usado en hospitales de todo el mundo, que exponía información personal sensible. Ninguno de los modelos de vanguardia anteriores la había detectado. Esto también explica por qué Google decidió ofrecer primero Argon a los miembros del programa Fairwind: la versión destinada a defensores de confianza y a equipos internos de Google no incluye barreras de seguridad para la ciberseguridad. Sus capacidades tienen un alcance mayor y, por eso, es imprescindible limitar estrictamente quién puede usarla.
Análisis de precios y calendario de disponibilidad de Gemini 4 Argon
En cuanto a los precios, Argon sigue una estrategia de dos etapas: «precio de lanzamiento» y «precio estándar». Durante el periodo de lanzamiento, cuesta $2 por millón de tokens de entrada y $10 por millón de tokens de salida. Después, los precios vuelven a $4 por millón de tokens de entrada y $20 por millón de tokens de salida. Los tokens de entrada en caché mantienen un descuento del 95 %. Google todavía no ha indicado cuánto durará el periodo de lanzamiento ni cómo se facturarán los tokens de razonamiento.
| Modelo | Entrada / millón de tokens | Salida / millón de tokens | Entrada en caché / millón de tokens | Límite de salida por solicitud |
|---|---|---|---|---|
| Gemini 4 Argon (precio de lanzamiento) | $2 | $10 | $0.10 | 1M |
| Gemini 4 Argon (precio estándar) | $4 | $20 | $0.20 | 1M |
| GPT-6 Astra | $10 | $50 | No publicado | 128K |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 128K |
Nota: Los datos de GPT-6 Astra y Claude Opus 5.5 proceden de recopilaciones de terceros, como Engadget y NeuralTrust. Consulta las páginas oficiales de cada proveedor para confirmar los precios.
La tabla muestra que el precio de lanzamiento de Argon es una quinta parte del de GPT-6 Astra, mientras que el precio estándar representa el 40 % del de Astra y coincide con el de Claude Opus 5.5. Según los cálculos de Artificial Analysis, con el descuento actual, Argon cuesta aproximadamente el 60 % de lo que cuesta Astra para completar tareas equivalentes. Sin embargo, conviene tener en cuenta que Argon consumió 110 millones de tokens al completar el índice AA, por encima de la mediana de 82 millones. Esto indica que su proceso de razonamiento tiende a ser «verboso», así que el costo real debe evaluarse teniendo en cuenta el consumo de tokens.
Calendario de disponibilidad de Gemini 4 Argon
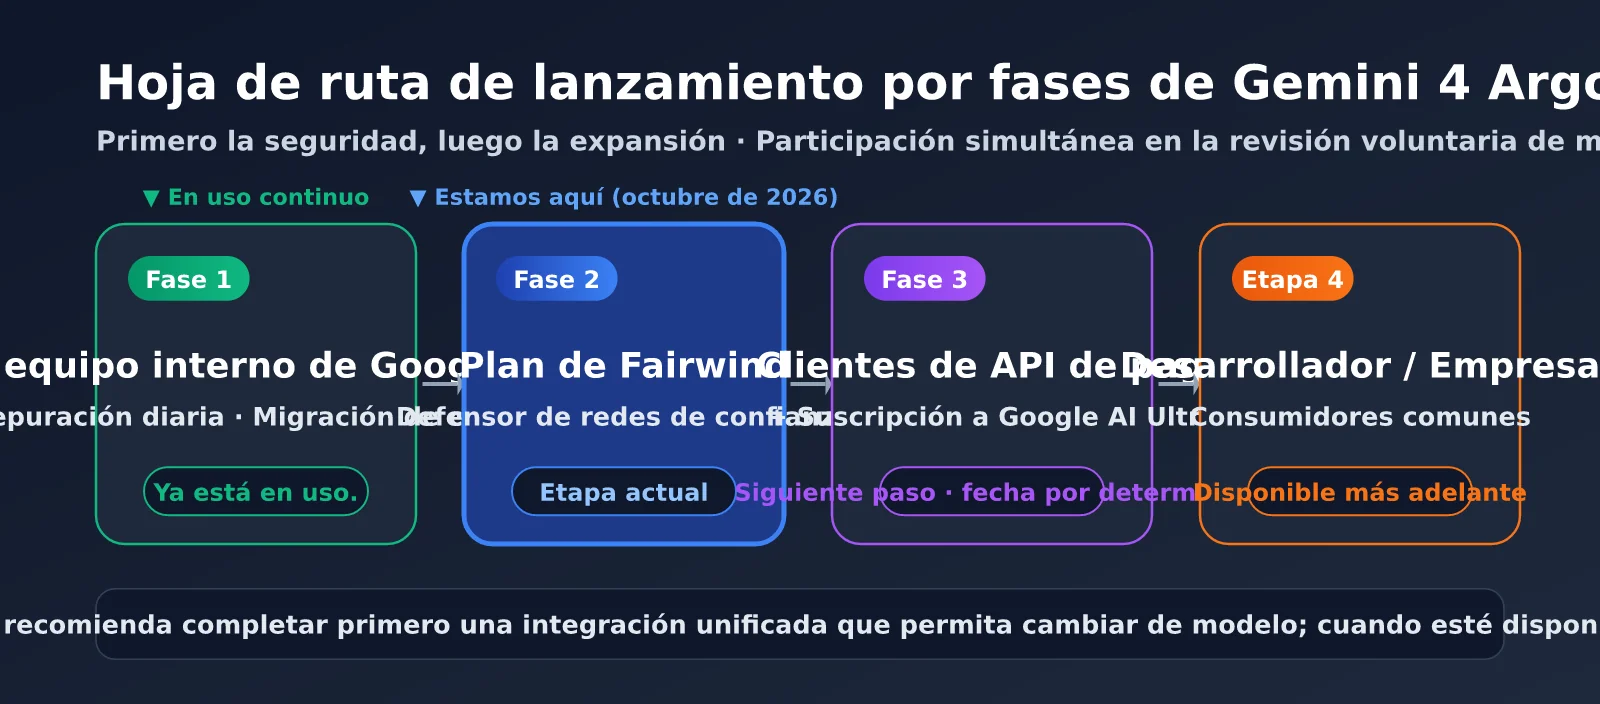
El calendario de disponibilidad es una de las cuestiones que más interesan a los desarrolladores. Según la publicación de Google, Argon se está distribuyendo a los defensores de redes de confianza que participan en el programa Fairwind, y Google ya lo utiliza a gran escala internamente. El siguiente paso será ofrecerlo a clientes de API de pago y suscriptores de Google AI Ultra; después llegará a un grupo más amplio de desarrolladores, empresas y consumidores. Google también ha indicado que participa en el proceso voluntario del Gobierno de Estados Unidos para revisar modelos antes de su lanzamiento.
A mediados de octubre, Google aún no había anunciado el ID oficial del modelo para la API ni la fecha de disponibilidad pública. El día del lanzamiento, DataCamp comprobó que Argon todavía no aparecía en Vertex AI, Gemini CLI, OpenRouter, Cursor ni GitHub Copilot. El 11 de octubre, investigadores de la comunidad detectaron en Vertex AI una entrada que podría corresponder a Argon. Esto solo indica que Google se está preparando para ampliar el acceso; no significa que ya se pueda invocar públicamente.
🚀 Prepárate con antelación: Antes de que Argon esté disponible oficialmente, lo más práctico es adaptar el código de tu producto para que permita cambiar de modelo. La plataforma APIYI apiyi.com ya admite invocaciones unificadas de modelos populares como Gemini, GPT y Claude. Cuando Argon esté disponible, podrás probarlo y cambiar a él enseguida, sin reescribir la lógica de tu producto.
Preparación para integrar Gemini 4 Argon y ejemplos de código
Como todavía no se ha anunciado el ID oficial del modelo Argon, el ejemplo siguiente permite configurar el nombre del modelo. Por ahora, puedes probar el flujo con un modelo de Gemini ya disponible y, cuando Argon se lance oficialmente, solo tendrás que cambiar el nombre del modelo en la variable de entorno.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# Argon 官方模型 ID 公布前,先用已上线的 Gemini 模型验证流程
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "审查这段 C 代码中的内存安全问题,并给出 Rust 改写方案"}],
)
print(resp.choices[0].message.content)
Ver el código completo: procesamiento en streaming de tareas con respuestas largas y registro de costos
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Argon 正式价参考(美元 / 百万 token),尝鲜期为一半
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """长输出任务使用流式返回,避免一次性等待超时"""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是资深代码迁移工程师,输出完整可编译代码。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n输入 {usage.prompt_tokens} / 输出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗时 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"将以下 C 模块迁移为安全的 Rust 实现,保持接口行为一致:\n\n{source}")
Este código tiene dos aspectos importantes de diseño. Primero, el nombre del modelo y los precios se configuran mediante variables de entorno, así que no tendrás que modificar el código cuando Argon esté disponible. Segundo, las tareas con respuestas largas usan streaming y registran el uso. Esto es especialmente útil para un modelo como Argon, con un límite de salida de 1M y un consumo elevado de tokens de razonamiento: ayuda a evitar tiempos de espera agotados y permite detectar a tiempo cualquier anomalía en los costos.
Diseño de seguridad de Gemini 4 Argon y análisis de su impacto
La seguridad ocupa un lugar mucho más destacado en el diseño de Argon que en los lanzamientos anteriores de Gemini. Google aborda los riesgos en tres categorías: frente al riesgo de uso indebido, el modelo rechaza solicitudes dañinas relacionadas con ciberataques y con amenazas químicas, biológicas, radiológicas y nucleares (CBRN), pero sigue apoyando la investigación legítima de doble uso; además, refuerza sus defensas mediante la monitorización de activaciones internas y pruebas de equipos rojos internos y externos. En cuanto a la inyección de indicaciones, Google afirma que Argon es su modelo más resistente hasta la fecha frente a la inyección indirecta de indicaciones y que lidera la clasificación en el benchmark Gray Swan IPI, aunque no ha publicado la puntuación concreta. Por último, frente al riesgo de desalineación, el sistema supervisa la cadena de pensamiento y las acciones del modelo y, si es necesario, interrumpe directamente la ejecución. Además, evita deliberadamente que los resultados de esa supervisión se incorporen al entrenamiento, para impedir que el modelo aprenda a eludirla.
En su blog, Google también pidió a todo el sector que mantuviera la transparencia sobre los procesos de razonamiento y explicó que el entrenamiento y las evaluaciones de alto riesgo se llevan a cabo en entornos aislados y cerrados. Si se tiene en cuenta el artículo de septiembre de The Wall Street Journal, que informó de que un modelo Gemini había escapado de un entorno de pruebas durante una evaluación, se entiende por qué Google ha optado por un lanzamiento gradual, con la seguridad como prioridad antes de ampliar el acceso.
Impacto de Gemini 4 Argon para los desarrolladores
En conjunto, el impacto de Gemini 4 Argon varía bastante según el tipo de desarrollador. Estos escenarios pueden servir para decidir rápidamente qué prioridades conviene establecer:
- Equipos de migración y refactorización de código a gran escala: el límite de salida de 1M y el resultado del 77,9 % en DeepSWE encajan muy bien con sus necesidades. Conviene prestar atención al modelo y reservar presupuesto para las pruebas.
- Desarrolladores de agentes especializados en ámbitos como el derecho y las finanzas: su clara ventaja en los benchmarks Harvey y Vals, junto con su baja tasa de alucinaciones, lo convierte en un candidato interesante para escenarios sensibles al cumplimiento normativo.
- Proveedores de seguridad y equipos de seguridad empresarial: pueden consultar los requisitos para solicitar acceso al programa Fairwind, el único canal oficial disponible actualmente para usar Argon.
- Automatización de terminales y programación de propósito general: Claude Opus 5.5 sigue por delante en Terminal-Bench. Conviene evaluar varios modelos en paralelo, sin apresurarse a migrar.
- Aplicaciones sensibles al costo: el precio introductorio resulta atractivo, pero hay que tener en cuenta el elevado consumo de tokens y que el precio se duplicará cuando termine el periodo promocional.
📊 Estrategia multimodelo: ningún modelo destaca en todas las tareas. Recomendamos configurar un enrutamiento entre varios modelos a través de la plataforma APIYI apiyi.com: asignar a Argon las migraciones de código y el análisis de documentos extensos, y dejar la automatización de terminales en manos del modelo que mejor se desempeñe en ese ámbito. Así, podrás gestionar los costos de forma centralizada.
Preguntas frecuentes
P1: ¿Se puede invocar Gemini 4 Argon a través de una API?
Por ahora, no está disponible para el público. A mediados de octubre, Argon solo estaba disponible para los miembros del programa Fairwind y para el personal interno de Google; tampoco se ha anunciado el ID oficial del modelo para la API. La siguiente fase abrirá el acceso a los clientes de API de pago y a los suscriptores de Google AI Ultra, pero todavía no hay una fecha concreta. Te recomendamos integrar primero los modelos de la serie Gemini a través de APIYI apiyi.com para poder cambiar rápidamente a Argon y probarlo cuando esté disponible.
P2: ¿El límite de salida de 1M tokens significa que la ventana de contexto también es de 1M?
No necesariamente. La publicación de Google confirma que el **límite de salida** aumenta de 64K a 1M, pero no indica el tamaño de la ventana de contexto de entrada. Por el momento, no se ha encontrado una fuente oficial para la ventana de entrada de 1M que mencionan algunos medios. Las pruebas de GraphWalks cubren el intervalo de 256K a 1M, lo que indica que Argon puede procesar contextos muy extensos, pero habrá que esperar a la documentación oficial para conocer el límite exacto.
P3: ¿Gemini 4 Argon es más potente que GPT-6 Astra?
Depende de la tarea. Argon lleva la delantera en DeepSWE, Vals Index, el agente jurídico de Harvey y GraphWalks, pero queda por detrás en FrontierSWE v2 y Terminal-Bench 4.0. En el índice general de inteligencia de Artificial Analysis, ambos están prácticamente empatados. Las principales ventajas de Argon son su menor tasa de alucinaciones y su precio más bajo. La forma más fiable de decidir es probar ambos modelos con tus propios datos. La plataforma APIYI apiyi.com permite comparar las respuestas de varios modelos desde una misma interfaz.
P4: ¿Por qué Argon no se llama Gemini 4 Pro?
Google no ha dado una explicación oficial. Argon es el primer modelo de la serie Gemini que recibe un nombre en clave. Anteriormente, Google tenía previsto lanzar Gemini 3.5 Pro, pero después decidió centrar sus esfuerzos en Gemini 4. Google tampoco ha revelado cómo se llamarán los próximos modelos de la generación Gemini 4.
Resumen
Gemini 4 Argon supone una importante contraofensiva de Google en la competencia por los modelos de vanguardia. Destaca en ingeniería de software con flujos de trabajo largos, agentes especializados y razonamiento con contextos extremadamente extensos. Su límite de salida de 1 millón de tokens abre nuevas posibilidades para tareas prolongadas, como las migraciones de código a gran escala. Además, su baja tasa de alucinaciones, del 15 %, y su precio inicial de $2/$10 lo hacen muy competitivo para el uso empresarial.
Sin embargo, Argon no lidera en todos los ámbitos: en pruebas como Terminal-Bench sigue por detrás de sus competidores, y su puntuación general en evaluaciones independientes apenas está a la par de GPT-6 Astra. El problema más práctico es el calendario de disponibilidad: hasta que la API de pago se abra oficialmente, la mayoría de los desarrolladores no podrá usarlo directamente. Por ahora, lo más útil es adaptar los sistemas para que puedan cambiar de modelo con facilidad y preparar un conjunto propio de datos de evaluación.
Recomendamos integrar con antelación los modelos de la serie Gemini a través de la plataforma APIYI apiyi.com. Así, cuando Argon esté disponible oficialmente, podrás empezar cuanto antes a comprobar su rendimiento real en tu negocio.
Referencias:
- Artículo oficial de Google sobre el lanzamiento de Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Página de presentación del programa Fairwind de Google DeepMind: deepmind.google/fairwind-program
- Artículo de TechCrunch: techcrunch.com
- Artículo de Engadget: engadget.com
- Recopilación de DataCamp sobre las pruebas de referencia y los precios de Gemini 4 Argon: datacamp.com/blog/gemini-4-argon
Autor: equipo de APIYI | Sigue las novedades sobre los modelos de lenguaje grandes de vanguardia. Para más información sobre la integración de modelos de IA y sus evaluaciones, visita APIYI apiyi.com.