Примечание автора: в часы пик цены у обеих моделей одинаковые, но справляются они лучше с разными задачами. В статье четыре таблицы — с параметрами, ценами, результатами тестов и распределением задач, — которые помогут выбрать подходящую модель.
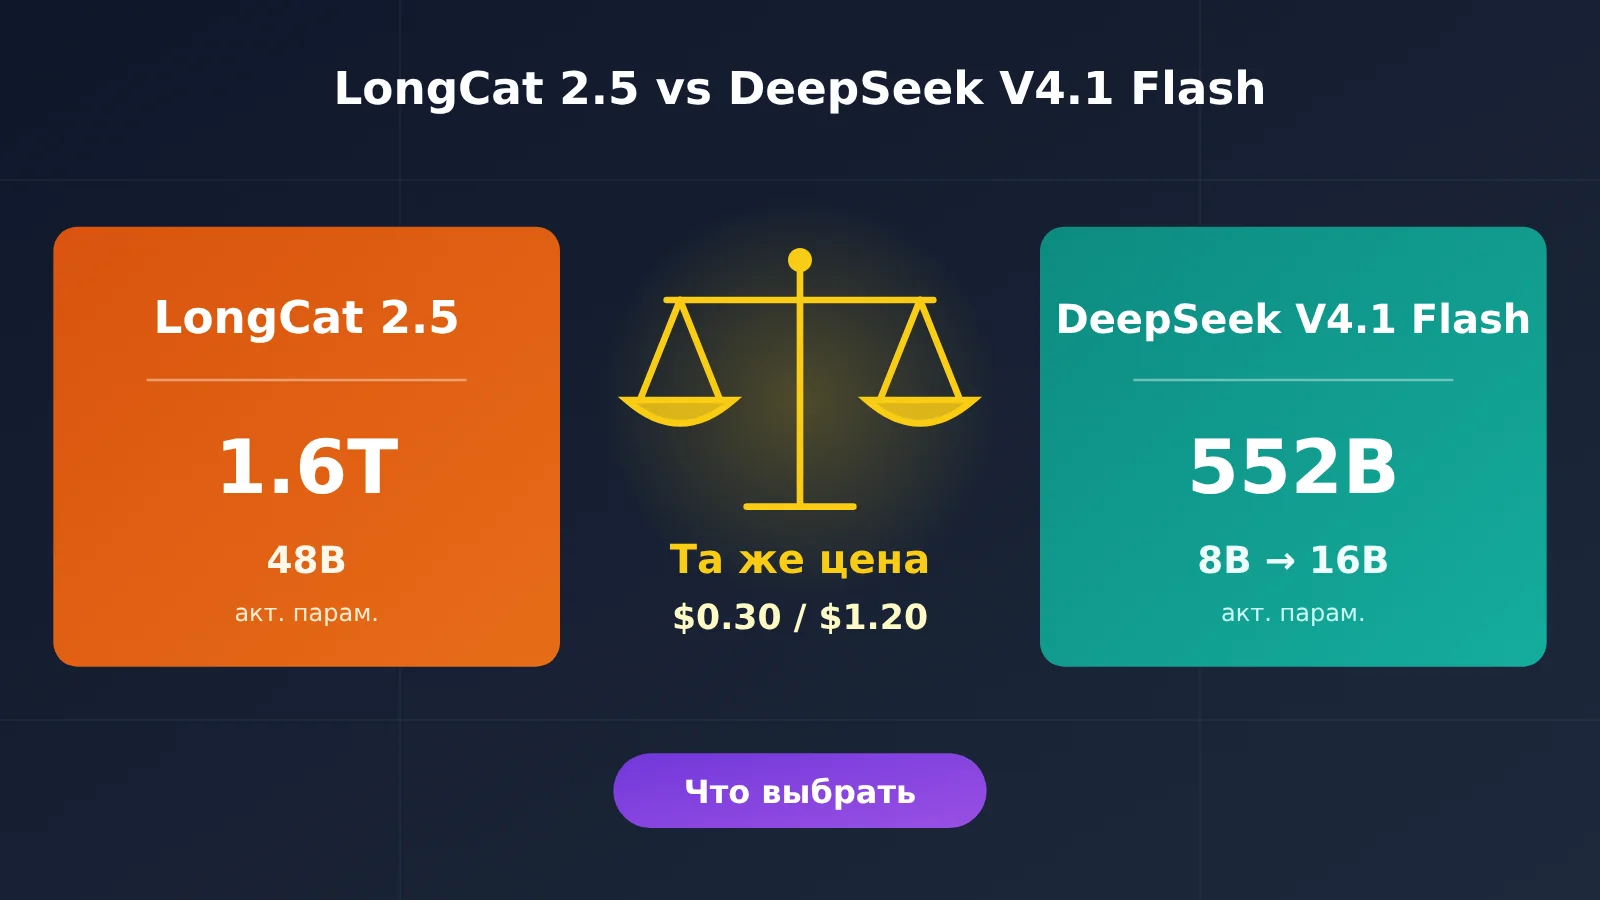
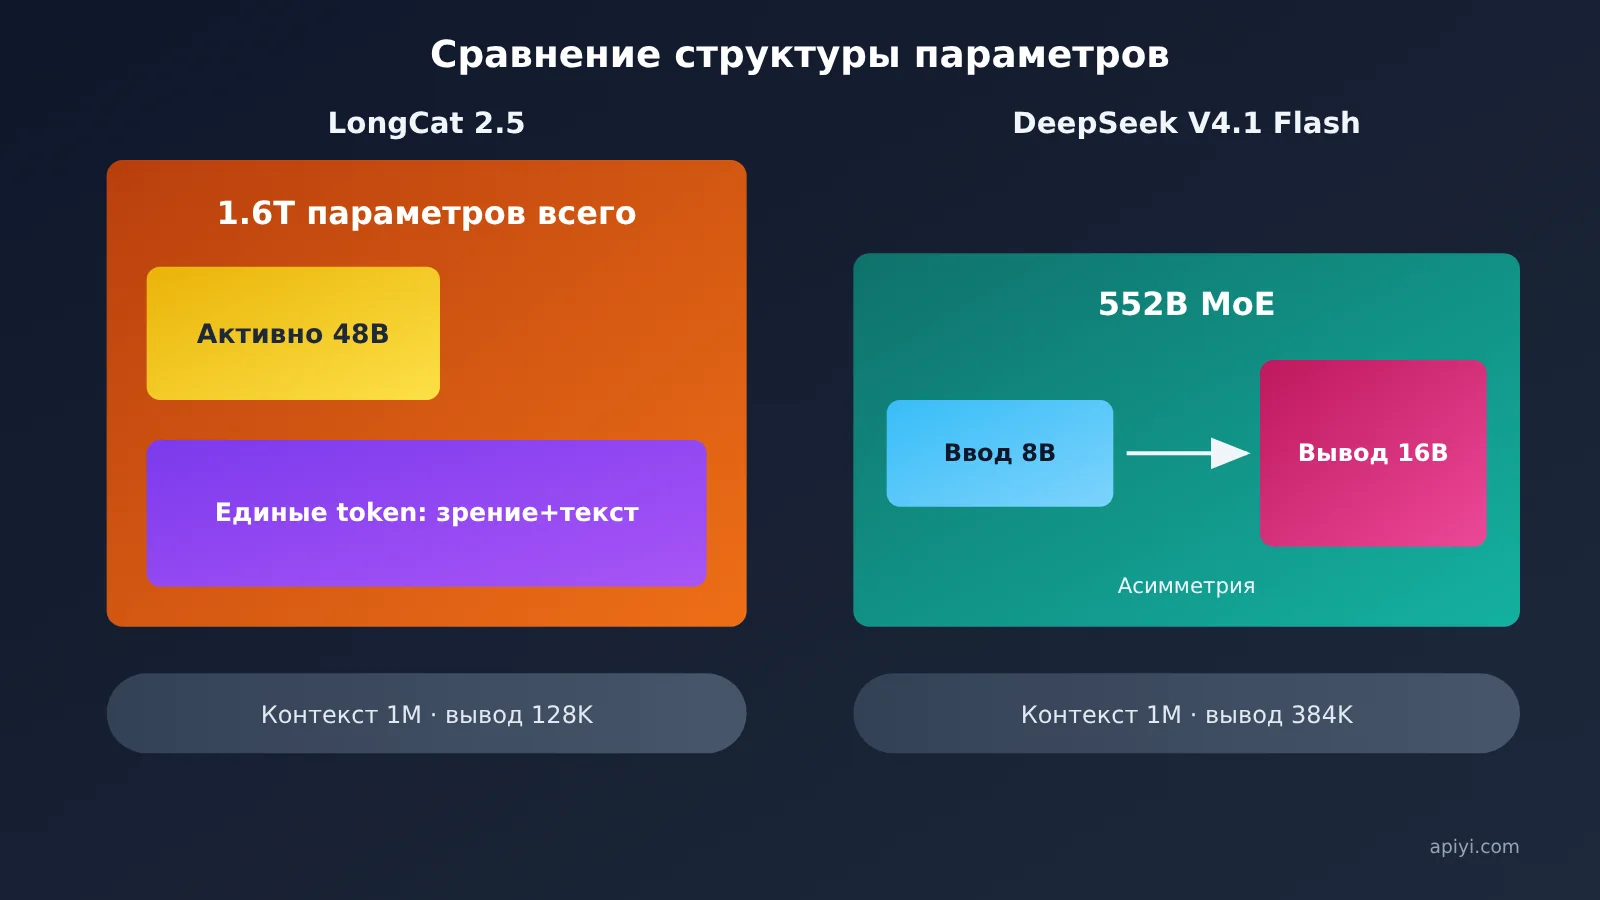
В часы пик цены полностью совпадают: ввод — $0.30, кэш — $0.006, вывод — $1.20 за миллион токенов. Разница в том, какие задачи модели решают лучше, поэтому выбор зависит от вашей работы. LongCat 2.5 — нативная мультимодальная модель с 1,6 трлн параметров, из которых около 48 млрд активируются на каждый токен. DeepSeek V4.1 Flash — асимметричная MoE-модель с 552 млрд параметров: 8 млрд активируются на вводе и 16 млрд на выводе. Её веса уже открыты.
Это не компромиссная статья в духе «у каждого свои сильные стороны». Все цифры ниже взяты из официальных блогов, технических отчётов и страниц с ценами обеих компаний. Каждая из них тестировала свои модели самостоятельно, поэтому мы используем результаты только для сравнения аналогичных показателей, не составляем общий рейтинг и не выдаём непроведённые тесты за реальные.
Главное: прочитав статью, вы сможете сопоставить модели с задачами своего проекта, решить, какую использовать как основную, а какую — как дополнительную, и подсчитать, сколько сэкономите, если перенесёте пакетные задачи на часы вне пика.
LongCat 2.5 и DeepSeek V4.1 Flash: краткое сравнение моделей
Сразу к выводам: у LongCat 2.5 больше параметров — как общих, так и активируемых при обработке. DeepSeek V4.1 Flash компактнее и активирует меньше параметров, при этом её максимальная длина ответа больше, а веса можно скачать. Контекстное окно обеих моделей — 1M. При выборе стоит обратить внимание на три различия: максимальный объём вывода — 128K против 384K, доступность весов и число активируемых параметров.
| Характеристика | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Всего параметров | 1.6T (1,6 трлн) | 552B |
| Активируемые параметры | Около 48B на токен | 8B для входа, 16B для вывода |
| Архитектура | Нативная мультимодальная модель для ИИ-агентов: изображения и текст обрабатываются с помощью единого формата токенов | MoE, асимметричная архитектура Causal-Encoder-Decoder |
| Контекстное окно | 1M | 1M |
| Максимальный вывод | 128K | 384K |
| Нативная поддержка изображений | Есть: визуальные сигналы представлены дискретными токенами нескольких уровней | Есть (Vision) |
| Открытые веса | Не опубликованы: на GitHub и HuggingFace указано «скоро» | Опубликованы на HuggingFace вместе с техническим отчётом |
| Режим рассуждений | Результаты официальных тестов получены с включённым режимом thinking | Включён по умолчанию, уровень можно настроить через reasoning_effort |
Ключевые особенности архитектуры LongCat 2.5
Назначение LongCat 2.5 сформулировано прямо: модель рассчитана на длительные агентные задачи. По сравнению с версией 2.0 в ней особенно усилили две области: нативное понимание изображений и агентное программирование. Изображения дискретизируются в исходном разрешении с помощью SAE+RVQ: сначала при предварительной обработке они превращаются в визуальные токены, а затем используются для совместного обучения с основной моделью. Она обрабатывает изображения и текст с помощью единого набора токенов — поэтому подход и называют нативно мультимодальным.
При обучении LongCat 2.5 активно использовали данные длинных траекторий и масштабное обучение с подкреплением на длительных задачах. В официальном блоге упоминаются несколько деталей: неудачные траектории реальных агентов преобразуют в задачи с проверяемым результатом; в асинхронном RL используют частичное развёртывание траекторий (partial rollout) и отфильтровывают группы примеров, где все ответы верны или все неверны и градиент равен нулю; за повторные рассуждения и вызовы инструментов вводят штрафы. Последний пункт особенно важен для разработчиков агентов: модель реже зацикливается на вызовах инструментов и тратит меньше токенов впустую.
Что касается инференса, по сравнению с W8A8 INT8 формат W4A4 повышает пропускную способность на этапе prefill на 43,3%, а на этапе decode — на 42,77%. TTFT снижается на 15,91%, TPOT — на 19,72%. При обучении FSDP с двойным шардированием повышает пропускную способность SFT на длинных последовательностях в расчёте на одну видеокарту на 86% по сравнению с базовым вариантом на DDP. Эти цифры показывают, что модель размером 1,6 трлн параметров специально оптимизировали для работы на сервере, однако официальных данных о лимитах запросов нет.
Особенности архитектуры DeepSeek V4.1 Flash
DeepSeek V4.1 Flash — самая компактная модель в новой линейке. Её особенность — асимметрия обработки входных и выходных данных: при чтении входных данных активируется 8 млрд параметров, а при генерации ответа — 16 млрд. В сценариях с агентами входных данных обычно гораздо больше, чем выходных: например, когда агент читает репозиторий, логи или результаты работы инструментов. Такая архитектура позволяет сократить вычислительные затраты именно на этапе чтения.
Ещё заметнее изменения в затратах на инфраструктуру. KV-кеш нового поколения значительно компактнее: потребность в HBM снизилась до 1/4 от предыдущего поколения, а в SSD — до 1/8. По сравнению с моделью первого поколения KV-кеш уменьшился в общей сложности в 437 раз. Есть и ещё одно изменение: после 14 сентября 2026 года, 12:00 запросы к deepseek-v4-pro будут перенаправляться на V4.1 Flash и тарифицироваться по цене Flash. Так будет до выхода V4.1 Pro. Проекты, которые продолжают использовать старое имя модели, фактически уже вызывают Flash.
LongCat 2.5 и DeepSeek V4.1 Flash: цены совпадают только в пиковые часы
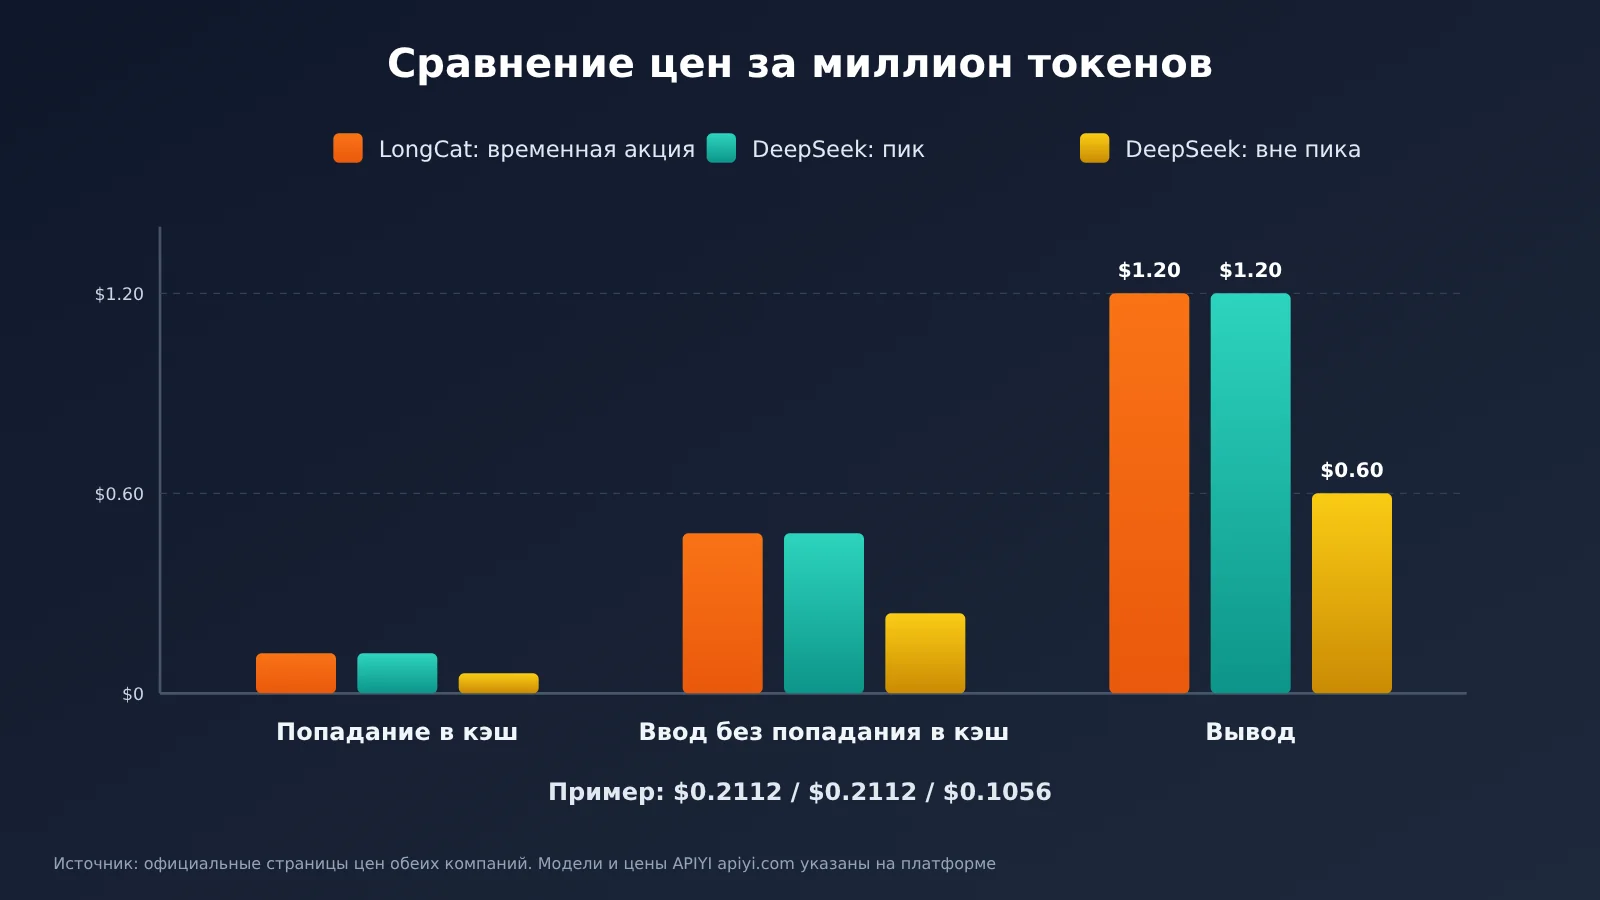
Вывод: цена LongCat 2.5 с ограниченной по времени скидкой по всем позициям совпадает с ценой DeepSeek V4.1 Flash в пиковые часы. В остальное время DeepSeek стоит вдвое дешевле. Так что говорить об одинаковой цене можно только применительно к пиковым часам в рабочие дни.
| За 1 млн токенов, долл. США | LongCat 2.5 (временная скидка) | DeepSeek, пиковые часы | DeepSeek, непиковые часы |
|---|---|---|---|
| Входные токены из кеша | $0.006 | $0.006 | $0.003 |
| Входные токены вне кеша | $0.30 | $0.30 | $0.15 |
| Выходные токены | $1.20 | $1.20 | $0.60 |
Посчитаем. Допустим, задача AI-агента расходует 500 тысяч входных токенов (300 тысяч вне кеша и 200 тысяч из кеша) и 100 тысяч выходных токенов:
- LongCat 2.5 (временная скидка): 0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek в пиковые часы: расчёт тот же, $0.2112
- DeepSeek в непиковые часы: 0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
Разница на одной задаче — около 10 центов, вроде бы немного. Но если выполнять по 1000 таких задач в день, LongCat и DeepSeek в пиковые часы обойдутся в $211.2, а DeepSeek в непиковые — в $105.6. Для команды, которая запускает пакетную обработку, за месяц разница набежит вполне ощутимая.
Пиковые часы DeepSeek — с 09:00 до 12:00 и с 14:00 до 18:00 по пекинскому времени в рабочие дни. По UTC это 01:00–04:00 и 06:00–10:00 с понедельника по пятницу, за исключением государственных праздников Китая. Всё остальное время действует тариф с 50-процентной скидкой: в обед, вечером и ночью в рабочие дни, а также круглосуточно в выходные и праздники. Иными словами, из 168 часов в неделе пиковыми считаются только 7 часов в каждый рабочий день.
У тарификации LongCat 2.5 тоже есть несколько особенностей:
- Оплачиваются только запросы с ответом HTTP 200. Ответы 401, 403, 429 и 500 не тарифицируются, поэтому неудачные повторные запросы ничего не стоят.
- Пакеты токенов продаются в ограниченном количестве во время коротких распродаж каждый день в 10:00, 16:00, 21:00 и 23:00 по пекинскому времени. Срок действия — 30 дней, за неиспользованную часть можно получить полный возврат. Токены из кеша не расходуют лимит пакета.
- Бонусные токены: новым пользователям начисляют 10 млн токенов, существующим — 5 млн. Начисление происходит автоматически, токены из кеша бонусный лимит не расходуют.
- Цена указана как временная скидка. Актуальные условия после её изменения нужно проверять на официальной странице с ценами.
У DeepSeek поиск в интернете и извлечение содержимого веб-страниц оплачиваются отдельно через API: $0.75 за 1000 успешных запросов, цена для поиска и извлечения одинакова. Если ваш AI-агент часто обращается к интернету, эти расходы нужно отдельно заложить в бюджет.
💰 О расходах: если вы вызываете DeepSeek V4.1 Flash через APIYI apiyi.com, оплата рассчитывается по списку моделей платформы и не обязательно совпадает с официальными тарифами для пиковых и непиковых часов. Чтобы точнее оценить расходы, сначала запустите небольшую партию задач в консоли платформы и проверьте счёт. После этого можно планировать массовый запуск.
LongCat 2.5 и DeepSeek V4.1 Flash: официальные результаты тестов
Вывод: в большинстве бенчмарков для агентов разница между моделями составляет менее 3 баллов — в целом они выступают на сопоставимом уровне. LongCat 2.5 лидирует в Terminal Bench v4.0, Program Bench, JobBench и генерации 3D. DeepSeek V4.1 Flash впереди в DeepSWE, NL2Repo и AutomationBench, причём с более заметным отрывом.
| Бенчмарк | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(текст-в-3D) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
Как проводились тесты — важно прочитать: все цифры получены в собственных тестах компаний. LongCat 2.5 тестировалась с использованием собственной тестовой среды, с включённым режимом thinking, при temperature=1.0 и top_p=0.95. Большинство результатов DeepSeek взяты из её общедоступного технического отчёта: там использовались собственная тестовая среда DeepSeek и режим рассуждений Max. Тестовые среды, даты оценок и режимы рассуждений различаются, поэтому таблица даёт лишь приблизительное представление о сравнительном уровне моделей и не является рейтингом.
Как читать результаты бенчмарков
В двух тестах с самым большим отрывом лидируют разные модели. В Terminal Bench v4.0 LongCat 2.5 опережает DeepSeek на 7,3 балла (38,5 против 31,2), а в DeepSWE v1.1 DeepSeek обходит LongCat на 9,6 балла (74,2 против 64,6). Первый тест проверяет выполнение более сложных и длительных задач в терминале, второй — исправление багов в реальных репозиториях. Здесь и проявляется разница: одна модель сильнее в длинных цепочках операций в терминале, другая — в точечных изменениях существующей кодовой базы.
В более старом Terminal Bench v2.1, наоборот, DeepSeek впереди на 2,2 балла. Похоже, преимущество LongCat проявляется именно на более сложных задачах. В Program Bench LongCat набирает на 5,2 балла больше, а в NL2Repo DeepSeek лидирует с отрывом в 4,9 балла. NL2Repo проверяет генерацию целого репозитория по описанию на естественном языке — это ближе к созданию проекта с нуля.
В тестах, связанных с визуальными задачами, разница небольшая. В Vision2Web DeepSeek впереди на 0,6 балла, в 3DCodeBench LongCat лидирует с отрывом в 2,1 балла. В официальной таблице для CharXiv-RQ w/tools результат LongCat составляет 90,2 против 87,7 у DeepSeek, а в MathVision w/tools лидирует DeepSeek — 97,4 против 96,5. Если говорить только о понимании изображений, модели примерно на одном уровне. Преимущество LongCat — в сочетании визуального понимания с созданием 3D-контента и интерактивных страниц. Среди восьми официальных демо есть симуляция жидкости в реальном времени, интерактивная 3D-демонстрация артефактов, макет города и ассеты для миниатюрных сцен — направление выбрано вполне определённое.
В BrowseComp, HLE w/tools и MCP Atlas разрыв не превышает 1,3 балла. Можно считать, что в общих агентных навыках, таких как поиск в интернете и работа с инструментами MCP, модели идут наравне.
Уровень рассуждений DeepSeek помогает управлять расходами
В разделе 5.3.3 технического отчёта DeepSeek приведены полезные данные. При повышении reasoning effort с 25 до 100 средний показатель Pass@1 по восьми бенчмаркам на рассуждение вырос с 67,1% до 76,3%, а результат DeepSWE v1.1 — с 66,0 до 74,2. Плата за это — примерно в 2,5 раза больше выходных токенов. Уровни 60–80 уже дают точность, близкую к максимальной, при этом расход токенов составляет меньше половины от максимального. При переходе на уровень 100 длина траектории агента дополнительно увеличивается в 1,6–1,8 раза, а прирост качества остаётся небольшим.
Также важно учитывать, что в DeepSeek API параметр reasoning_effort по умолчанию установлен в high, а официальные результаты получены на уровне Max. Чтобы воспроизвести показатели DeepSeek из таблицы выше, нужно явно задать значение max. Для повседневных задач используйте средний уровень, а максимальный включайте для самых сложных. Выходные токены — самая дорогая позиция в тарифах обоих сервисов ($1,20), поэтому настройка этого параметра напрямую влияет на расходы.
LongCat 2.5 и DeepSeek V4.1 Flash: как распределить задачи
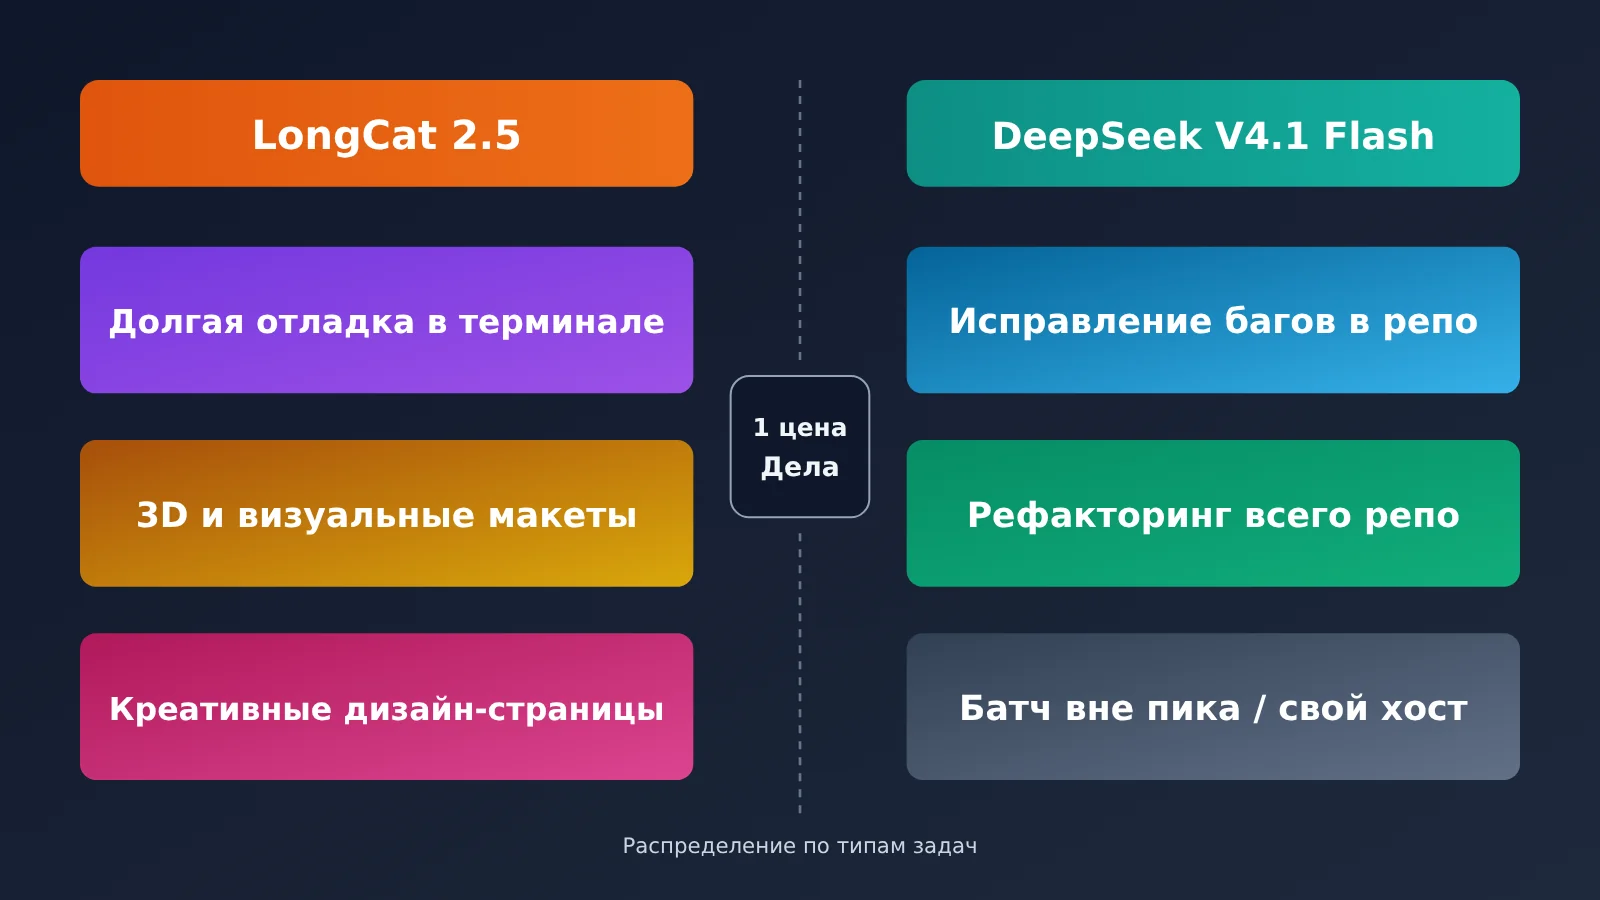
Вывод: цена одинаковая, задачи разные. Длительные задачи в терминале, работу с визуальными материалами и 3D, а также креативные страницы стоит доверить LongCat 2.5. Изменение кода в реальных репозиториях, исправление багов в SWE-задачах, автоматизированные конвейеры и сценарии с самостоятельным развёртыванием — DeepSeek V4.1 Flash.
| Лучше подходит LongCat 2.5 | Лучше подходит DeepSeek V4.1 Flash |
|---|---|
| Длительный поиск и устранение неполадок в терминале: вход на сервер, проверка логов, изменение конфигурации, перезапуск и проверка результата (на 7,3 балла выше в Terminal Bench v4.0) | Исправление багов в реальных репозиториях: изучение issue, поиск нужных файлов, внесение изменений и прохождение тестов (на 9,6 балла выше в DeepSWE) |
| 3D-ресурсы и визуальные материалы: создание 3D-сцен по текстовому описанию, интерактивные страницы для их демонстрации (55,4 в 3DCodeBench) | Рефакторинг всего репозитория и создание проекта с нуля: генерация многофайлового проекта по описанию требований (на 4,9 балла выше в NL2Repo) |
| Креативные страницы: приглашения на мероприятия, стилизованные страницы с цветовой палитрой, отчёты с визуализацией данных (направления из официальных демо) | Автоматизированные конвейеры и пакетная обработка: ночные задания, очистка данных, создание отчётов (на 3,0 балла выше в AutomationBench, в часы низкой нагрузки — половина цены) |
| Создание программ в формате задач по программированию и комплексные профессиональные задачи (лидирует в Program Bench и JobBench) | Сценарии, требующие самостоятельного развёртывания или работы в частной инфраструктуре: веса модели открыто опубликованы на HuggingFace; длинный ответ за один вызов (до 384K) |
Почему стоит выбрать LongCat 2.5
Самый убедительный показатель LongCat 2.5 — результат в Terminal Bench v4.0. В версии v2.1 модель отставала на 2,2 балла, а в v4.0 вышла вперёд на 7,3 балла. Это говорит о том, что её относительное преимущество растёт с длиной и сложностью задачи. Результат согласуется с подходом к обучению: в нём активно использовали длинные траектории и штрафовали модель за повторные вызовы инструментов. Если вашему агенту часто приходится последовательно выполнять в терминале десятки шагов, LongCat 2.5 стоит попробовать в первую очередь.
Второй аргумент — задачи, которые сочетают работу с визуальной информацией и генерацию. Благодаря нативной мультимодальности и обучению на задачах с 3D и интерактивными страницами модель лучше подходит для работы в духе «создать макет по картинке» или «создать 3D по тексту». Кроме того, новые пользователи получают 10 млн токенов в подарок, а при попадании в кэш подарочный лимит не расходуется. Так что попробовать модель можно с минимальными затратами.
Почему стоит выбрать DeepSeek V4.1 Flash
Самый весомый показатель DeepSeek V4.1 Flash — 74,2 балла в DeepSWE: здесь разница между моделями самая большая. В повседневной разработке чаще всего приходится вносить изменения в существующий репозиторий, а это как раз сильная сторона модели. Максимальная длина вывода — 384K, в три раза больше, чем у LongCat, поэтому длинные файлы и большие патчи реже будут обрываться.
Ещё один аргумент — структура расходов. В часы низкой нагрузки цена снижается вдвое, а уровень рассуждений можно настраивать. Вместе эти две возможности дают гораздо больше гибкости в стоимости пакетных задач, чем фиксированная временная цена LongCat. Лимит в 2500 одновременных запросов указан в официальной документации, поэтому при планировании пропускной способности есть на что опереться. Команды, которым нужно локальное развёртывание, могут напрямую скачать веса модели. Правда, по данным разработчиков, для масштабного развёртывания нужны ресурсы порядка 2 тысяч GPU, так что небольшим командам сначала стоит оценить требования к оборудованию.
💡 Совет по выбору: таблица поможет сузить круг вариантов, но окончательное решение зависит от ваших задач. Выберите в проекте 10–20 типичных задач и прогоните их через обе модели, затем сравните долю успешных решений и расход токенов. Для тестирования DeepSeek V4.1 Flash можно подключить через APIYI apiyi.com — так не придётся отдельно регистрировать аккаунт.
Как подключить LongCat 2.5 и DeepSeek V4.1 Flash
Коротко: оба сервиса совместимы с форматами API OpenAI и Anthropic. Для подключения к Claude Code достаточно изменить несколько переменных окружения в ~/.claude/settings.json. DeepSeek дополнительно поддерживает Responses API.
Подключение LongCat 2.5
- Формат OpenAI (любой OpenAI SDK): укажите
https://api.longcat.ai/openaiв base_url иLongCat-2.5в качестве имени модели. - Формат Anthropic (Anthropic SDK): укажите
https://api.longcat.ai/anthropicв base_url. - Claude Code (отредактируйте поле env в
~/.claude/settings.json): необходимо указать все четыре переменные: ANTHROPIC_AUTH_TOKEN— ваш API-ключ LongCatANTHROPIC_BASE_URL—https://api.longcat.ai/anthropicANTHROPIC_MODEL—LongCat-2.5CLAUDE_CODE_MAX_OUTPUT_TOKENS—131072- Обработка ограничений частоты запросов (в коде вашего приложения): при превышении лимита возвращается ошибка 429 (
rate_limit_exceeded,retry_after 60). Разработчики рекомендуют повторять запросы с экспоненциальным увеличением интервала. Лимиты RPM/TPM в документации не указаны, запросы с ошибкой 429 не тарифицируются.
Подключение DeepSeek V4.1 Flash
- Формат OpenAI (любой OpenAI SDK): укажите имя модели
deepseek-flash. Старые именаdeepseek-v4-flashиdeepseek-v4-flash-vision-expпо-прежнему работают: запросы направляются на V4.1-Flash-1017 и тарифицируются по цене Flash. - Claude Code (отредактируйте поле env в
~/.claude/settings.json): ANTHROPIC_AUTH_TOKEN— ваш API-ключ DeepSeekANTHROPIC_BASE_URL—https://api.deepseek.com/anthropicANTHROPIC_MODEL—deepseek-flash- Уровень рассуждений (параметр запроса OpenAI SDK): для повседневных задач задавайте средний уровень
reasoning_effort, а для сложных —max. - Готовые инструменты: WorkBuddy (включая CodeBuddy) и OpenCode — официальные партнёрские инструменты с полной поддержкой модели.
Единый доступ через APIYI
Если вам нужно сравнить несколько моделей, в APIYI можно переключаться между ними с одной учётной записью и одним API-ключом — не придётся регистрироваться у каждого провайдера отдельно.
- Настройка OpenAI SDK (в коде вашего проекта): укажите
https://api.apiyi.com/v1в base_url, а в api_key — ключ, созданный в консоли APIYI. - Имя модели (переключается в параметрах запроса): для DeepSeek V4.1 Flash используйте
deepseek-v4.1-flashилиdeepseek-v4.1-flash-1017. Тарификация зависит от модели в списке платформы. - Сравнительное тестирование (с одним и тем же кодом): меняйте только параметр model, чтобы запускать один и тот же набор задач на разных моделях платформы. base_url остаётся прежним:
https://api.apiyi.com/v1.
Актуальные модели и цены смотрите в списке платформы. LongCat-2.5 пока недоступна в APIYI, но её планируют добавить в ближайшее время. До этого используйте официальный эндпоинт LongCat 2.5, а DeepSeek можно централизованно управлять через APIYI на apiyi.com.
🚀 Быстрый старт: новые пользователи получают бесплатную квоту для тестирования при регистрации в APIYI на apiyi.com. Подключите DeepSeek V4.1 Flash к существующему проекту на OpenAI SDK — для запуска достаточно изменить одну строку с base_url.
LongCat 2.5 и DeepSeek V4.1 Flash: частые вопросы
Q1: Цены у двух моделей действительно одинаковые?
Только в часы пик DeepSeek. Временная цена LongCat 2.5 со скидкой — $0.30 / $0.006 / $1.20 — по каждому пункту совпадает с ценой DeepSeek в часы пик. В непиковое время DeepSeek даёт скидку 50% на все тарифы. Это всё время за исключением рабочих дней с 09:00 до 12:00 и с 14:00 до 18:00. Кроме того, скидка LongCat действует ограниченное время, и в будущем цены могут измениться.
Q2: Можно ли по результатам тестов определить, какая модель сильнее?
Напрямую расставить модели по местам не получится. Обе компании проводили тесты самостоятельно, причём использовали разные инструменты тестирования, даты и уровни рассуждения. К тому же в таблице приведены результаты DeepSeek на уровне Max. Лучше обращать внимание на отдельные тесты с большим разрывом: в Terminal Bench v4.0 LongCat лидирует на 7,3 пункта, а в DeepSWE DeepSeek опережает её на 9,6 пункта. Разницу в пределах 1–2 пунктов можно считать ничьей.
Q3: Когда LongCat 2.5 станет доступна с открытым исходным кодом?
Официальных сроков пока нет. На GitHub и HuggingFace сейчас указано «скоро», а веса модели ещё не опубликованы. Для проектов, которым обязательно нужно собственное развёртывание, на данном этапе остаётся DeepSeek V4.1 Flash: её веса и технический отчёт уже опубликованы.
Q4: Можно ли вызывать обе модели через APIYI?
Пока доступна только DeepSeek V4.1 Flash под именами `deepseek-v4.1-flash` и `deepseek-v4.1-flash-1017`. Оплата рассчитывается по тарифам из списка моделей платформы. LongCat-2.5 на APIYI пока недоступна, но её планируют добавить как можно скорее. Актуальные модели и цены указаны в списке моделей на платформе APIYI apiyi.com.
Q5: Как снизить расходы на пакетные задачи?
При работе с DeepSeek используйте два способа: планируйте задачи на непиковое время, когда цена вдвое ниже, и устанавливайте `reasoning_effort` на средний уровень. Согласно отчёту, уровни 60–80 уже обеспечивают точность, близкую к максимальной, при бюджете токенов меньше половины от максимального. Цена при попадании в кэш составляет всего 1/50 от цены без попадания. Чтобы повысить долю попаданий, размещайте неизменные системные промпты и определения инструментов в начале запроса.
Итоги: что выбрать — LongCat 2.5 или DeepSeek V4.1 Flash
Вывод простой: при одинаковой цене модели подходят для разных задач, а пакетные задания выгоднее запускать в часы низкой нагрузки.
- Масштаб: у LongCat 1,6T параметров, из которых активируется 48B; у DeepSeek — 552B, из которых активируется 8B на входе и 16B на выходе. Контекстное окно у обеих моделей — 1M.
- Максимальная длина ответа: 128K у LongCat и 384K у DeepSeek. Для длинных ответов выбирайте DeepSeek.
- Цена: временная цена LongCat равна цене DeepSeek в часы пик. В часы низкой нагрузки DeepSeek стоит вдвое дешевле: в примере расчёта — $0.2112 против $0.1056.
- Результаты тестов: LongCat опережает на 7,3 балла в длительных задачах в терминале, а DeepSeek — на 9,6 балла в исправлении багов в репозитории. В большинстве остальных тестов результаты примерно равны.
- Открытый исходный код: DeepSeek уже открыт, а веса LongCat пока не опубликованы.
- Подключение: обе модели совместимы с форматами OpenAI и Anthropic. Чтобы переключиться в Claude Code, достаточно изменить переменные окружения.
Главное: выберите основную модель по таблице распределения задач, а вторую оставьте в качестве дополнения. Пакетные задания по возможности запускайте в часы низкой нагрузки. DeepSeek V4.1 Flash можно сначала проверить на небольшом объёме через единый интерфейс APIYI на apiyi.com, а затем решить, какую модель использовать в качестве основной.
📚 Источники
- Официальный блог LongCat-2.5: назначение модели, архитектура, обучение и технические детали
- Ссылка:
longcat.ai/blog/longcat-2.5 -
Содержание: количество параметров, схема визуальных токенов, данные об инференсе W4A4 и таблица официальных результатов тестирования
-
Документация открытой платформы LongCat: цены, эндпоинты и подключение Claude Code
- Ссылка:
longcat.ai/platform/docs -
Содержание: временные скидки, обработка ошибок 429, пакеты квот и правила начисления бонусов
-
Анонс DeepSeek V4.1 Flash: архитектура, открытый исходный код и изменения API
- Ссылка:
deepseek.com/news/deepseek-v4-1-flash -
Содержание: асимметричная MoE, сжатие KV Cache и переход на новые имена моделей
-
Страница цен DeepSeek API: тарифы в пиковые и внепиковые часы и ограничения параллельных запросов
- Ссылка:
api-docs.deepseek.com/quick_start/pricing -
Содержание: определение пиковых и внепиковых часов, лимит в 2500 параллельных запросов, отдельная оплата поиска и извлечения данных
-
Репозиторий весов DeepSeek-V4.1-Flash: открытые веса и технический отчёт
- Ссылка:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - Содержание: результаты тестов в таблице 3 и анализ режимов инференса в разделе 5.3.3
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com