Nota del autor: análisis del lanzamiento de LongCat 2.5. Repasamos sus parámetros y arquitectura, los 8 ejemplos oficiales, los resultados de 25 pruebas realizadas por el equipo, el coste con el descuento temporal y cómo integrarlo en Claude Code y Cline.
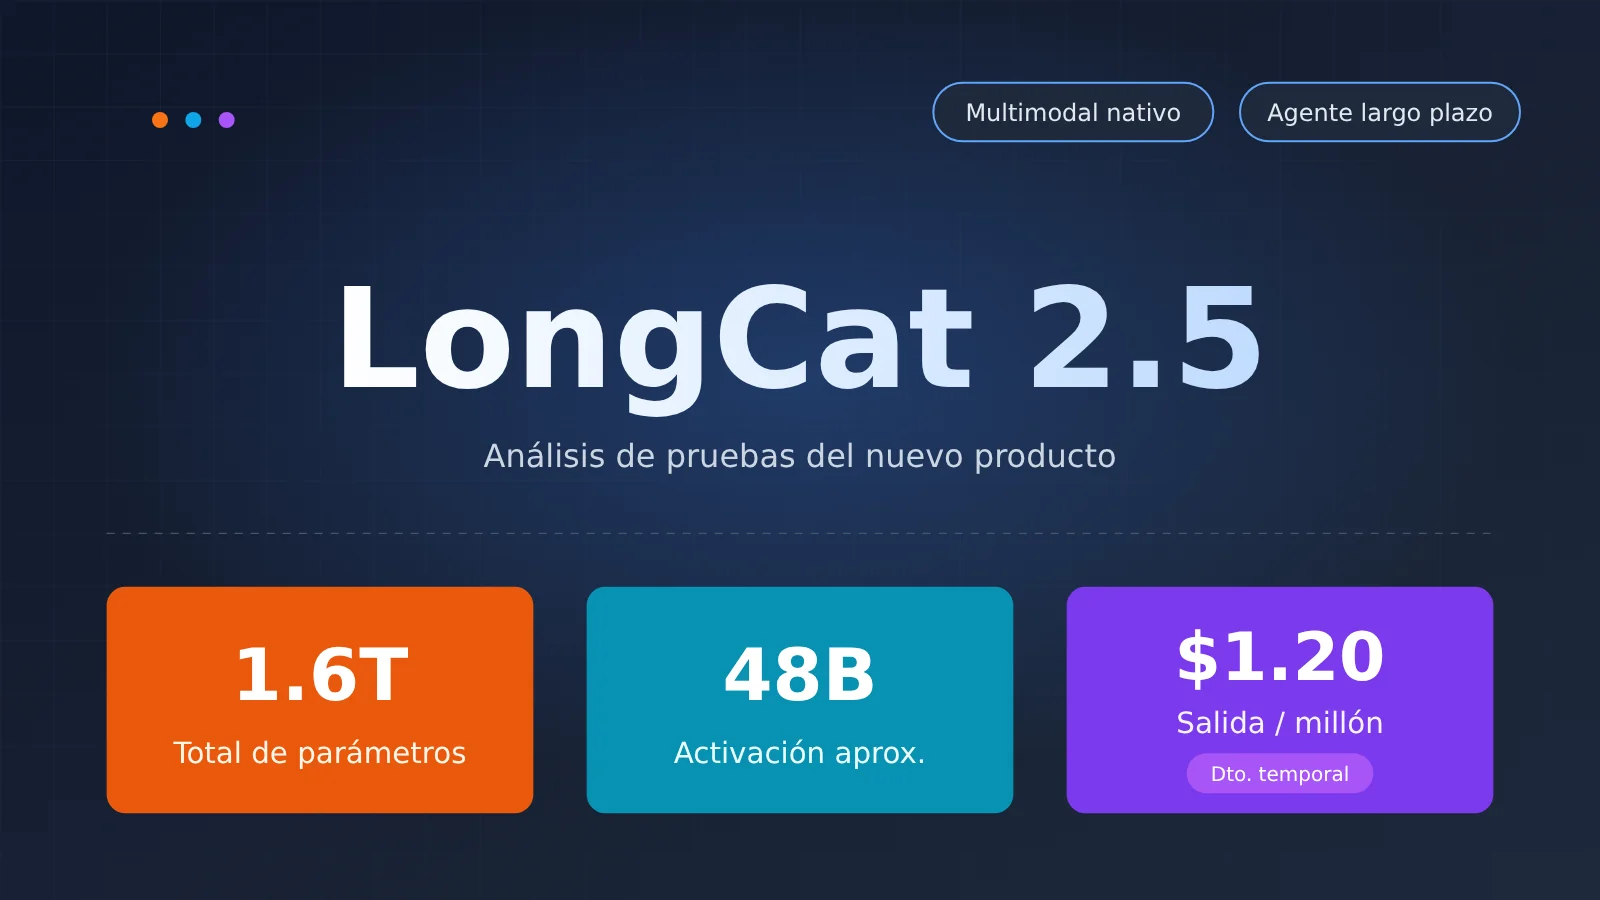
El 1 de noviembre, el equipo de LongCat de Meituan (como se le conoce en la comunidad) lanzó LongCat-2.5. Tiene 1,6 billones de parámetros en total y activa unos 48.000 millones por token. Es un modelo multimodal nativo orientado a tareas de agentes de larga duración. Frente a la versión 2.0, las principales mejoras están en la comprensión visual nativa y la programación mediante agentes. El precio tiene un descuento temporal: 1,20 USD por millón de tokens de salida, 0,30 USD por millón de tokens de entrada sin acierto de caché y 0,006 USD por millón con acierto de caché.
Esto no es una comparativa para elegir modelo. Aquí nos centraremos en tres cosas: qué es, para qué tareas destaca y cuánto cuesta usarlo. Las puntuaciones sirven solo como referencia comparativa, sin concluir que un modelo sustituya a otro.
Qué te llevarás: un mapa de capacidades, una cuenta clara de los costes y la ruta más corta para empezar a usarlo.
LongCat 2.5 de un vistazo
| Información | Detalles |
|---|---|
| Fecha de lanzamiento | 2026-11-01 (blog oficial) |
| Enfoque | Modelo multimodal nativo para tareas de agentes de larga duración |
| Tamaño | 1.6T de parámetros totales, con unos 48B activos por token |
| Mejoras respecto a 2.0 | Comprensión visual nativa y programación con agentes |
| Contexto / salida máxima | 1M tokens / 128K tokens |
| Interfaz | Compatible con los formatos de OpenAI y Anthropic |
| Precio (descuento por tiempo limitado) | Entrada: $0.30 (sin caché) / $0.006 (con caché); salida: $1.20, por millón de tokens |
| Pesos | Tanto GitHub como HuggingFace indican «próximamente»; aún no se han publicado |
Hay un detalle sobre los parámetros activos que puede generar confusión. El día del lanzamiento, algunas publicaciones de la comunidad indicaron 440B, pero el blog oficial habla de unos 48.000 millones por token, es decir, 48B. En este artículo usamos 48B en todos los casos.
Qué es LongCat 2.5: parámetros, arquitectura y capacidades multimodales nativas
Escala y estrategia de entrenamiento de LongCat 2.5
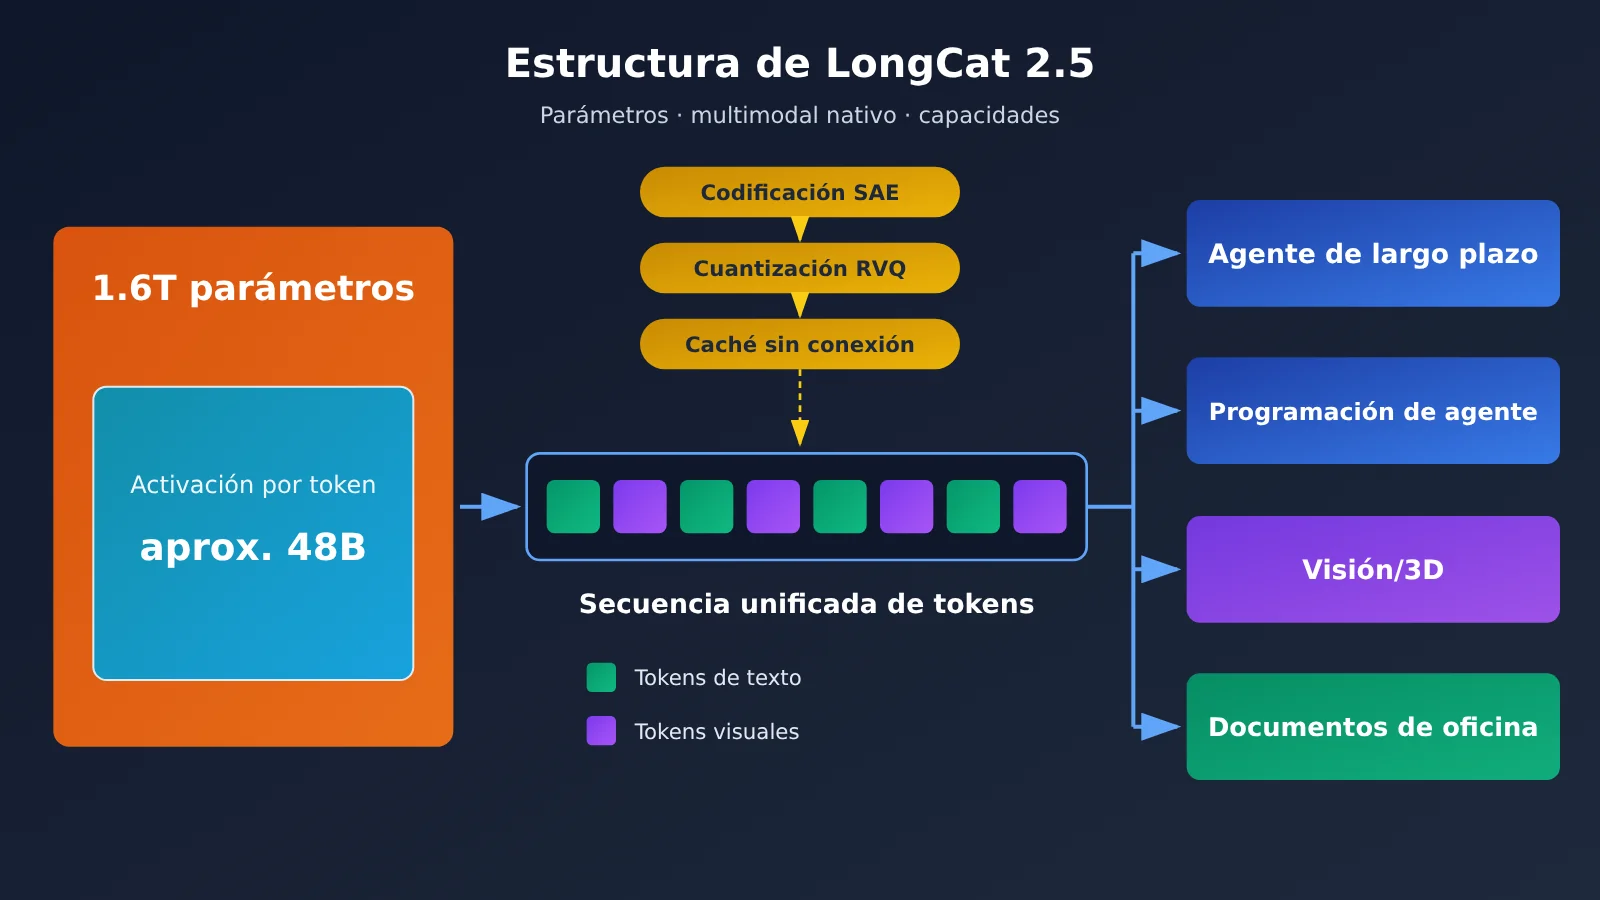
Con 1,6 billones de parámetros en total y unos 48.000 millones activados, LongCat 2.5 es un Modelo de Lenguaje Grande de activación dispersa: tiene una capacidad enorme, pero en cada inferencia solo utiliza una pequeña parte de sus parámetros. Esta estructura deja margen para equilibrar la capacidad de conocimiento y el costo de inferencia, y es una de las razones por las que puede ofrecer precios más bajos.
En cuanto al entrenamiento, el equipo de LongCat destacó varias prácticas directamente relacionadas con las «tareas de larga duración»:
- Más datos de trayectorias de larga duración: se incorporan más trayectorias largas al entrenamiento con secuencias extensas y después se aplica aprendizaje por refuerzo a gran escala para entrenar tareas de ingeniería de principio a fin, como desarrollar bases de código complejas o construir proyectos completos.
- Convertir trayectorias de fallo reales en tareas de entrenamiento: se amplían en paralelo la síntesis de datos, la creación de entornos y el entrenamiento mixto con distintos harnesses para convertir los fallos de agentes reales en tareas reproducibles y verificables.
- Reducir el «pensar demasiado» y las «llamadas repetidas»: se penalizan las reflexiones y llamadas a herramientas repetitivas. Además, cuando el modelo piensa en exceso o la longitud de la respuesta crece demasiado rápido, se redistribuyen las recompensas de los ejemplos positivos.
El tercer punto es especialmente práctico para los agentes. En las tareas de larga duración, uno de los mayores gastos suele venir de que el modelo use una y otra vez la misma herramienta sin avanzar. Reducir este comportamiento durante el entrenamiento se traduce directamente en un ahorro de tokens.
Cómo funciona la multimodalidad nativa de LongCat 2.5
«Multimodalidad nativa» tiene aquí un significado concreto. Las señales visuales se representan como tokens discretos de varios niveles, y el modelo principal procesa tanto las imágenes como el texto en un formato unificado de tokens. No recurre a un codificador visual externo cuyas características se incorporan después.
El equipo oficial lo divide en tres etapas:
- Discretización visual a resolución nativa: un codificador alineado semánticamente (SAE) y la cuantización vectorial residual (RVQ) convierten las imágenes en tokens discretos.
- Preprocesamiento offline de tokens visuales: una vez fijado el tokenizador, los ID de los tokens visuales pueden calcularse y almacenarse en caché por adelantado.
- Aprendizaje conjunto: los embeddings visuales se entrenan junto con el modelo principal.
Según el equipo oficial, este diseño permite que el modelo destaque en programación visual y sea compatible con tareas como el diseño creativo y el 3D. Las pruebas 3DCodeBench y Vision2Web, que aparecen más adelante en la tabla de benchmarks, evalúan precisamente este tipo de capacidades.
Por qué LongCat 2.5 puede ofrecerse a este precio
El blog oficial dedica bastante espacio a la eficiencia de ingeniería, que ayuda a explicar el precio. El entrenamiento se ejecutó en hardware de cómputo chino, con menos de 80 GB de memoria por tarjeta. Para reducir el consumo de memoria, el equipo utilizó técnicas como FSDP con doble fragmentación, paralelismo mixto del vocabulario y replicación dinámica de expertos. En tareas de SFT con secuencias largas, esta configuración de FSDP logró un rendimiento por tarjeta un 86% superior al de la referencia DDP.
Para la inferencia se usa W4A4: tanto los pesos de los expertos como las activaciones se cuantizan a 4 bits. En las pruebas oficiales de carga en producción, frente a la referencia W8A8 INT8, el rendimiento de prefill aumentó un 43,3% y el de decode un 42,77%; la latencia del primer token (TTFT) bajó un 15,91% y la latencia por token (TPOT), un 19,72%. Con un rendimiento más de un 40% mayor, el costo por token se reduce.
En qué destaca LongCat 2.5: agentes de tareas largas y 8 casos oficiales
El salto de LongCat 2.0 a 2.5
Empecemos comparando las dos versiones. Las siguientes cifras proceden de las pruebas del equipo de LongCat; los elementos comparativos marcados con asterisco proceden de clasificaciones públicas. En esta sección solo se citan las puntuaciones de las dos generaciones de LongCat.
- Terminal Bench v4.0: 2.0 obtuvo 3.0 y 2.5 obtuvo 38.5.
- DeepSWE v1.1: 2.0 obtuvo 9.7 y 2.5 obtuvo 64.6.
- Program Bench Almost Resolved: 2.0 obtuvo 2.5 y 2.5 obtuvo 25.5.
- AutomationBench v1.0.6: 2.0 obtuvo 15.8 y 2.5 obtuvo 51.8.
Todas estas pruebas evalúan tareas largas, como operaciones de terminal de varios pasos, correcciones a nivel de repositorio y flujos de automatización. La versión 2.0 apenas puntuaba en ellas, mientras que la 2.5 alcanzó un nivel que permite compararla con otros modelos. Esto apunta a una mejora real en programación con agentes. El equipo también indica que todos los resultados de LongCat-2.5 se obtuvieron con thinking activado, temperature=1.0 y top_p=0.95.
Los 8 casos de demostración oficiales de LongCat 2.5
El equipo publicó 8 casos generados de principio a fin, divididos en dos grupos. Conviene aclarar que son demostraciones oficiales y que este artículo no las ha reproducido una por una.
| Categoría | Caso | Qué pone a prueba |
|---|---|---|
| Desarrollo de software | Simulación de fluidos en tiempo real | Cálculos físicos + renderizado en tiempo real en el frontend |
| Desarrollo de software | Presentación interactiva de piezas históricas en 3D | Construcción de escenas 3D y lógica de interacción |
| Desarrollo de software | Maqueta urbana | Distribución y organización de numerosos objetos |
| Desarrollo de software | Recursos para escenas en miniatura | Control de detalles en la generación de recursos 3D |
| Trabajo profesional | Análisis de operaciones empresariales | Lectura de datos, desglose de indicadores y redacción de conclusiones |
| Trabajo profesional | Informe de análisis de comentarios de clientes | Clasificación y resumen de textos no estructurados |
| Trabajo profesional | Página de estética cromática de estilo chino | Estética visual y diseño de página web |
| Trabajo profesional | Generador de invitaciones para eventos | Interacción con formularios + diseño de composición |
Tres de los cuatro casos de desarrollo de software están directamente relacionados con 3D, en línea con las capacidades visuales nativas y Visual Coding. Los casos de oficina, por su parte, se centran más en «leer materiales y producir un resultado final», una línea similar a la de pruebas como JobBench y GDPVal.
¿En qué posición queda LongCat 2.5 en los benchmarks?
La tabla oficial de evaluación incluye más de 25 pruebas, divididas en tres categorías: agentes de código, agentes generales y capacidades visuales. Aquí seleccionamos nueve para comparar cinco modelos.
| Benchmark | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
Los resultados marcados con * proceden de clasificaciones públicas o informes técnicos citados oficialmente. Los demás son pruebas realizadas por LongCat y sirven solo como referencia comparativa.
Si nos ceñimos a los datos, destacan varios puntos:
- Búsqueda de información: en BrowseComp obtiene 91.9, la puntuación más alta de los cinco modelos. Para la prueba, el equipo usó un harness ligero de desarrollo propio, con solo dos herramientas habilitadas, search y browse_with_goal, y un máximo de 1024 rondas.
- Generación 3D: alcanza 55.4 en 3DCodeBench Text to 3D, también el mejor resultado de los cinco. Sin embargo, ninguna de las puntuaciones de esta fila lleva asterisco: todas proceden de pruebas de LongCat.
- Tareas de terminal: en Terminal Bench v2.1, los cinco modelos se agrupan entre 88.2 y 89.1. En la versión v4.0, más difícil, LongCat-2.5 obtiene 38.5 frente a los 53.9 de Claude Opus 5: una diferencia de 15.4 puntos.
- Corrección de código a nivel de repositorio: en DeepSWE v1.1 obtiene 64.6, la puntuación más baja de los cinco; GPT-5.6-Sol alcanza 72.7.
- Uso de herramientas y tareas de oficina: obtiene 83.1 en MCP Atlas y 65.4 en JobBench, a 2.7 y 1.3 puntos de Opus 5, respectivamente.
También conviene fijarse en el harness. Las dos versiones de Terminal Bench usan el harness de Claude Code, con un max_seq_length de 512K; DeepSWE usa mini-swe-agent, con una longitud de secuencia de 1M. No conviene comparar directamente puntuaciones de pruebas distintas que usan diferentes harnesses.
Cómo se calcula el precio de LongCat 2.5: comparativa y factura por 1 millón de tokens
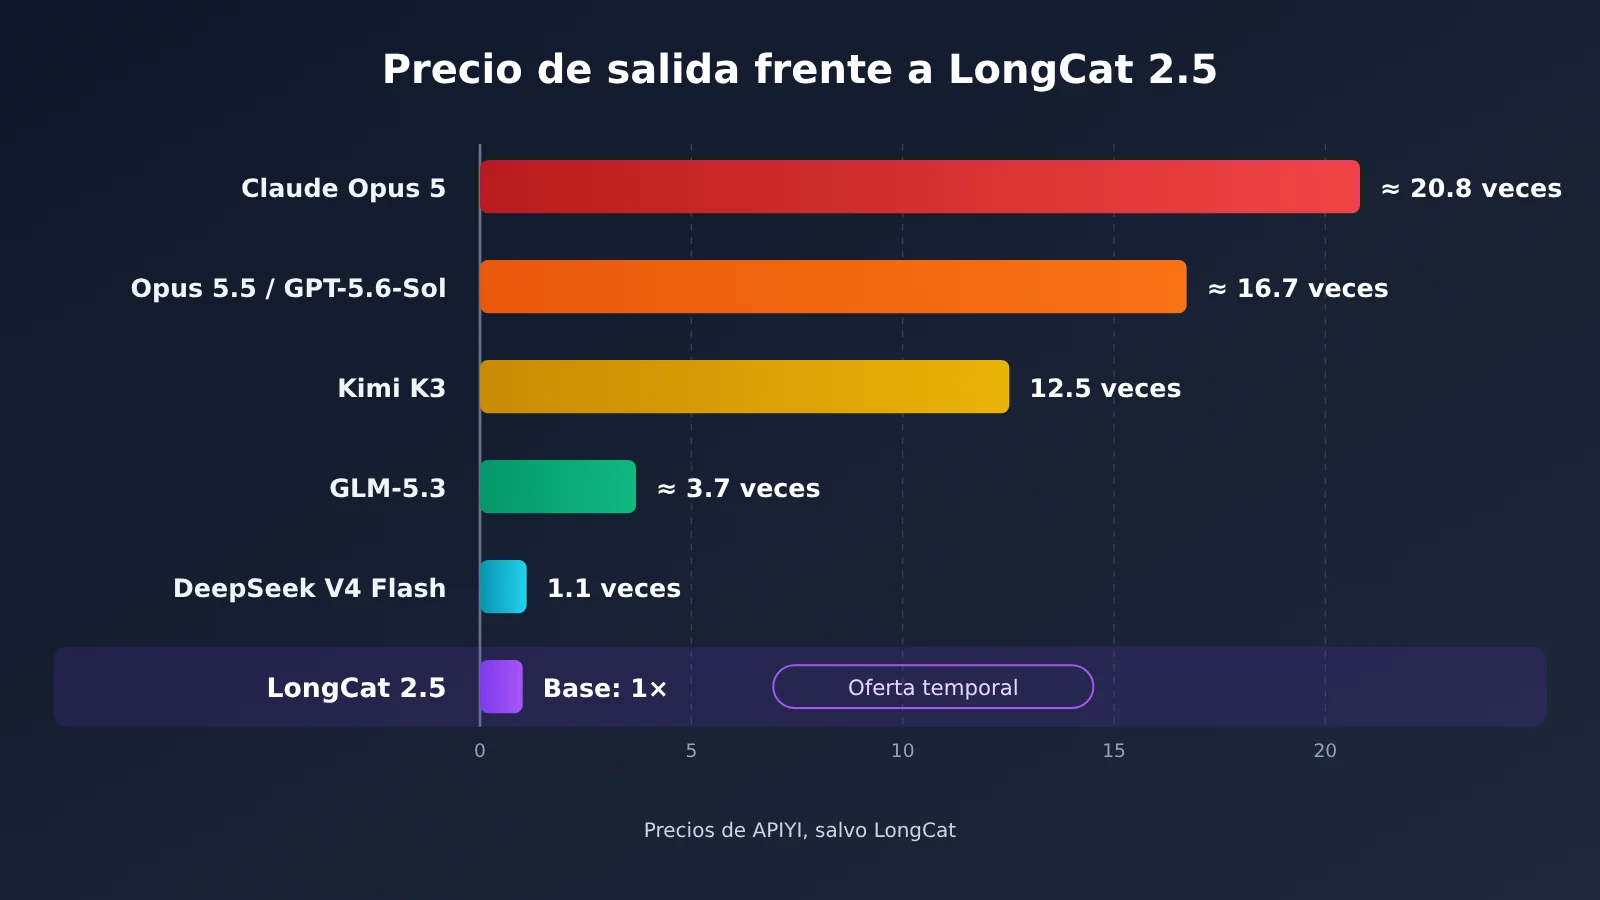
Nota: el precio de LongCat-2.5 es el descuento por tiempo limitado de la plataforma oficial de API. Los precios de los demás modelos se consultaron en la lista de modelos de APIYI, apiyi.com.
| Modelo | Entrada (por cada millón de tokens) | Salida (por cada millón de tokens) | Veces que el precio de salida supera al de LongCat |
|---|---|---|---|
| LongCat-2.5 (descuento por tiempo limitado, plataforma oficial) | $0.30 ($0.006 con caché) | $1.20 | 1 |
| Claude Opus 5 | $5 | $25 | aprox. 20,8 |
| Claude Opus 5.5 | $4 | $20 | aprox. 16,7 |
| GPT-5.6-Sol | $4 | $20 | aprox. 16,7 |
| Kimi K3 | $3 | $15 | 12,5 |
| GLM-5.3 | $1.4 | $4.396 | aprox. 3,7 |
| DeepSeek V4 Flash | $0.44 | $1.32 | aprox. 1,1 |
Los precios de APIYI, apiyi.com, se consultaron el 2026-11-02 y corresponden a los que mostraba la lista de modelos de la plataforma ese día. El precio de LongCat-2.5 procede de la plataforma LongCat API, que advierte que puede cambiar.
La cuenta de un millón de tokens
Supongamos que un trabajo por lotes utiliza un total de un millón de tokens: 800.000 de entrada y 200.000 de salida, sin tener en cuenta la caché.
- LongCat-2.5 (descuento por tiempo limitado): 0,8 × $0,30 + 0,2 × $1,20 = $0,48
- DeepSeek V4 Flash: $0,352 + $0,264 = $0,616
- GLM-5.3: $1,12 + $0,879 ≈ $2,00
- Kimi K3: $2,40 + $3,00 = $5,40
- GPT-5.6-Sol o Claude Opus 5.5: $3,20 + $4,00 = $7,20
- Claude Opus 5: $4,00 + $5,00 = $9,00
Para el mismo trabajo, Opus 5 cuesta unas 18,75 veces más que LongCat-2.5. Si parte de la entrada se encuentra en caché, la diferencia será aún mayor. El ejemplo oficial utiliza un millón de tokens de entrada (400.000 encontrados en caché y 600.000 no encontrados), más 500.000 de salida: la factura es de $0,18 + $0,0024 + $0,6 = $0,7824. La entrada encontrada en caché cuesta solo $0,006 por millón de tokens, 1/50 del precio de la que no se encuentra en caché.
Hay otros dos detalles de facturación que conviene recordar: solo se cobra cuando la respuesta es HTTP 200; las solicitudes fallidas con códigos como 401, 403, 429 o 500 no se cobran. Además, el saldo es prepago y no vence; si hay crédito promocional disponible, se descuenta primero.
Cómo simplificar la comparación entre varios modelos
En la práctica, los proyectos de agentes rara vez utilizan un solo modelo. Quizá quieras probar la misma indicación y comparar las respuestas de LongCat-2.5, Claude, GPT y GLM. En APIYI apiyi.com puedes cambiar de modelo con una sola cuenta y una sola clave API, sin tener que abrir cuentas ni recargar saldo por separado en cada proveedor.
📌 Nota: Consulta la lista de modelos de APIYI apiyi.com para conocer los modelos disponibles y sus precios. LongCat-2.5 aún no está disponible en APIYI, pero se incorporará próximamente.
Cómo empezar con LongCat 2.5: prueba en la web y conexión por API
Paso 1: pruébalo en la web
Puedes probarlo en la plataforma oficial: longcat.ai/chat. Según la publicación de la comunidad, durante el lanzamiento los usuarios nuevos reciben 10 millones de tokens y los usuarios existentes, 5 millones. La bonificación se acredita automáticamente y los aciertos de caché no consumen el saldo de regalo. La publicación también menciona un paquete promocional por tiempo limitado de 9,9 yuanes que «llegará pronto». Para empezar, conviene probar tareas de búsqueda y análisis de imágenes: son dos de las categorías en las que el modelo obtuvo buenos resultados en las pruebas.
Paso 2: usa la API y recuerda cuatro parámetros
- Endpoint en formato OpenAI:
https://api.longcat.ai/openai - Endpoint en formato Anthropic:
https://api.longcat.ai/anthropic - Campo model:
LongCat-2.5 - Contexto y salida: ventana de contexto de 1 millón de tokens y salida máxima de 128K tokens
Sobre los límites de solicitudes, la documentación oficial solo indica que, al superarlos, se devuelve HTTP 429, con el código de error rate_limit_exceeded y retry_after igual a 60. También recomienda que el cliente reintente con espera exponencial. Los valores concretos de RPM y TPM no se han publicado.
Si tu código ya usa el SDK de OpenAI para invocar otros modelos, solo tienes que cambiar base_url, api_key y model. Por ejemplo, si normalmente usas APIYI con base_url https://api.apiyi.com/v1, al pasar a la API oficial de LongCat basta con cambiarlo a https://api.longcat.ai/openai y establecer model en LongCat-2.5.
Paso 3: intégralo con Claude Code
- Claude Code, sección env de
~/.claude/settings.json: introduce la clave API de LongCat enANTHROPIC_AUTH_TOKEN - Sección env del mismo archivo: establece
ANTHROPIC_BASE_URLenhttps://api.longcat.ai/anthropic - Sección env del mismo archivo: establece
ANTHROPIC_MODELenLongCat-2.5 - Sección env del mismo archivo: establece
CLAUDE_CODE_MAX_OUTPUT_TOKENSen131072 - Sección env del mismo archivo (conviene cambiarlas también): establece
ANTHROPIC_SMALL_FAST_MODEL,ANTHROPIC_DEFAULT_SONNET_MODELyANTHROPIC_DEFAULT_OPUS_MODELenLongCat-2.5
Si no cambias estas tres últimas variables, es posible que las subtareas internas de Claude Code sigan solicitando los modelos predeterminados, lo que puede provocar errores o cargos inesperados.
Paso 4: intégralo con Cline
- Cline, panel de configuración de la barra lateral de VS Code: en API Provider, selecciona una opción compatible con OpenAI
- En el mismo panel: introduce
https://api.longcat.ai/openaien Base URL - En el mismo panel: introduce la clave de LongCat en API Key y
LongCat-2.5en Model ID
La documentación oficial de LongCat incluye una página específica para conectar Cline; consulta allí los nombres exactos de los campos. También ofrece páginas de integración para más de una decena de herramientas, como Codex, OpenCode, Kilo Code, Cherry Studio, Chatbox y CC Switch.
🚀 Consejo para empezar: usa primero el saldo gratuito oficial para comprobar que tus tareas funcionan y después decide si quieres integrar el modelo a largo plazo. Si también necesitas invocar Claude, GPT o Gemini para compararlos, puedes gestionarlos desde APIYI apiyi.com con una interfaz compatible con OpenAI. Cuando LongCat-2.5 esté disponible, también podrás cambiar a él desde la misma cuenta.
Para qué sirve LongCat 2.5
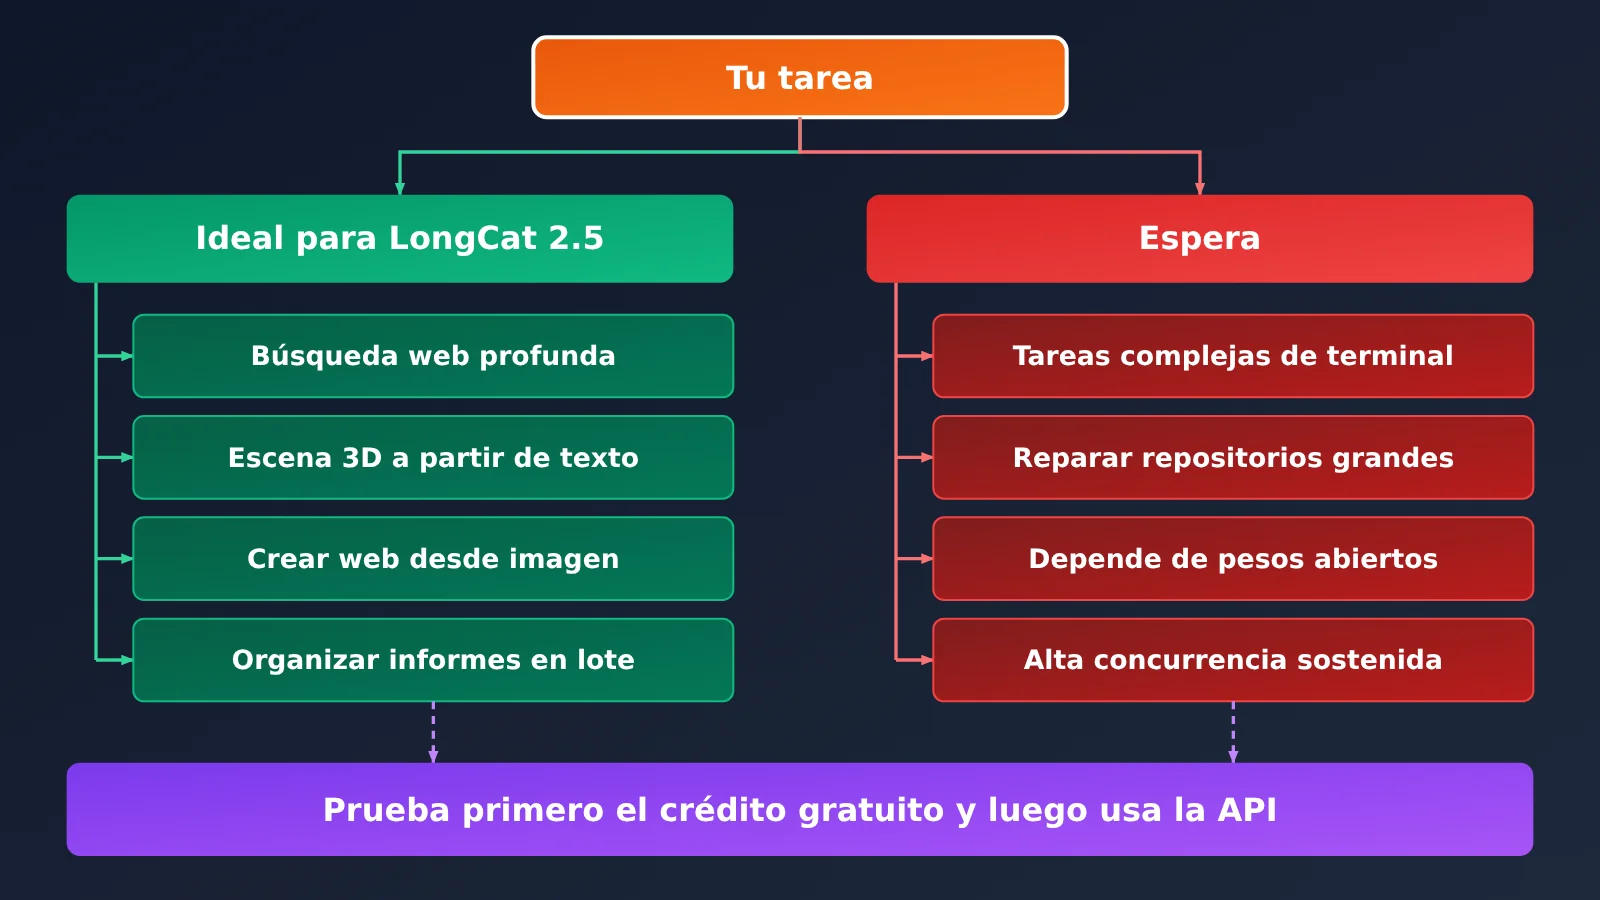
| Tareas ideales para LongCat 2.5 | Tareas con las que conviene esperar |
|---|---|
| Búsquedas web de varias rondas y recopilación de información (BrowseComp: 91,9) | Tareas complejas de administración en terminal con múltiples pasos (Terminal Bench v4.0: 38,5 frente a 53,9 de Opus 5) |
| Generar escenas 3D, por ejemplo con Three.js, a partir de descripciones de texto (3DCodeBench: 55,4) | Corregir bugs difíciles en repositorios grandes (DeepSWE v1.1: 64,6, la puntuación más baja de las cinco columnas) |
| Crear páginas web a partir de diseños o capturas de pantalla (Vision2Web: 78,6) | Proyectos que requieren despliegue privado y pesos locales (los pesos aún no se han publicado) |
| Organizar comentarios de clientes y datos de negocio por lotes y redactar informes (JobBench: 65,4; precio de salida con descuento por tiempo limitado: $1,20 por millón de tokens) | Servicios de producción que necesitan una cuota garantizada de alta concurrencia (no se han publicado oficialmente los límites de RPM/TPM) |
Las tareas de la izquierda tienen algo en común: son largas, consumen muchos tokens y el precio por token importa. En ellas, LongCat-2.5 ofrece una combinación sólida de puntuación y precio. Las de la derecha no son necesariamente imposibles para el modelo, pero existe una diferencia visible en las puntuaciones o aún no están claras las condiciones de despliegue y cuota. En esos casos, conviene empezar con una prueba a pequeña escala.
Preguntas frecuentes sobre LongCat 2.5
P1: ¿Las puntuaciones de LongCat 2.5 las evaluó un tercero?
No. Todas las puntuaciones de LongCat-2.5 en la tabla proceden de pruebas realizadas por el equipo oficial de LongCat. Entre los modelos de comparación, las puntuaciones con asterisco proceden de informes públicos o clasificaciones oficiales; las que no llevan asterisco también son de pruebas de LongCat. Conviene tomarlas como referencia comparativa.
P2: ¿El precio de $1.20 por millón de tokens es permanente?
No. LongCat lo indica como un precio promocional por tiempo limitado y advierte que puede cambiar. Consulta la página de la plataforma LongCat API y tu factura para conocer el precio aplicable. Al preparar un presupuesto a largo plazo, conviene tener un modelo alternativo y conservar la posibilidad de cambiar mediante una plataforma de agregación como APIYI, apiyi.com.
P3: ¿LongCat 2.5 es de código abierto?
Todavía no. Los botones de GitHub y HuggingFace en el blog oficial indican «Próximamente». Por ahora, solo están disponibles la versión en línea y el acceso mediante API; LongCat no ha anunciado una fecha para liberar el código.
P4: ¿Se puede usar LongCat 2.5 en APIYI?
Por ahora no, pero APIYI incorporará este modelo lo antes posible. Mientras tanto, puedes usar directamente la API oficial de LongCat. Si quieres comparar Claude, GPT y GLM, puedes probar esos modelos con una sola clave API en APIYI, apiyi.com. Consulta la lista de modelos de la plataforma para conocer las opciones y los precios disponibles.
P5: ¿Qué hago si aparece un error 429?
Significa que se ha alcanzado el límite de solicitudes. El cuerpo de la respuesta incluirá `retry_after` con un valor de 60. LongCat recomienda implementar reintentos con espera exponencial en el cliente. Además, las solicitudes que devuelven un error 429 no se facturan, por lo que no generan cargos adicionales.
Resumen: ¿vale la pena integrar LongCat 2.5?
Los puntos clave de LongCat 2.5:
- Enfoque: modelo multimodal nativo con 1,6 billones de parámetros totales y unos 48.000 millones activos por token, diseñado para tareas prolongadas con agentes.
- Mejoras: frente a la versión 2.0, Terminal Bench v4.0 pasa de 3,0 a 38,5 y DeepSWE v1.1, de 9,7 a 64,6.
- Puntos fuertes: obtiene 91,9 en BrowseComp y 55,4 en 3DCodeBench, las puntuaciones más altas entre los cinco modelos comparados en este artículo, según cifras oficiales.
- Brechas: todavía presenta diferencias visibles en Terminal Bench v4.0 y DeepSWE v1.1.
- Precio: con el descuento por tiempo limitado, la salida cuesta $1,20 por millón de tokens; una factura con 800.000 tokens de entrada y 200.000 de salida ronda los $0,48.
- Integración: compatible con los protocolos de OpenAI y Anthropic; basta con cambiar cuatro variables en Claude Code.
En pocas palabras: prueba primero las tareas de búsqueda y análisis de imágenes en longcat.ai/chat con los 10 millones de tokens gratuitos. Cuando todo funcione, pasa a la API; si necesitas alternar entre varios modelos a largo plazo, gestiónalos desde APIYI en apiyi.com.
📚 Referencias
- Blog oficial de LongCat: artículo de lanzamiento de LongCat-2.5, con arquitectura, entrenamiento y tablas de evaluación
- Enlace:
longcat.ai/blog/longcat-2.5 -
Detalles: fuente primaria sobre la escala de parámetros, los 8 casos de demostración y los criterios de evaluación
-
Documentación de la plataforma API de LongCat: interfaz, facturación e integración de herramientas
- Enlace:
longcat.ai/platform/docs -
Detalles: endpoints para ambos protocolos, precios con descuento por tiempo limitado y páginas de integración con Claude Code y Cline
-
Lista de modelos de APIYI: precios de las distintas plataformas de modelos
- Enlace:
docs.apiyi.com/models - Detalles: fuente de los precios comparados en este artículo; consulta los valores que se muestran ese día
Autor: equipo técnico de APIYI
Consultas técnicas: puedes contactarnos desde la página principal de APIYI. Encontrarás más recursos en el centro de documentación de docs.apiyi.com