Catatan penulis: Harga kedua model sama pada jam sibuk, tetapi tugas yang paling cocok untuk masing-masing berbeda. Artikel ini memakai empat tabel—parameter, harga, benchmark, dan pembagian tugas—untuk membantu menentukan model yang tepat untuk setiap pekerjaan.
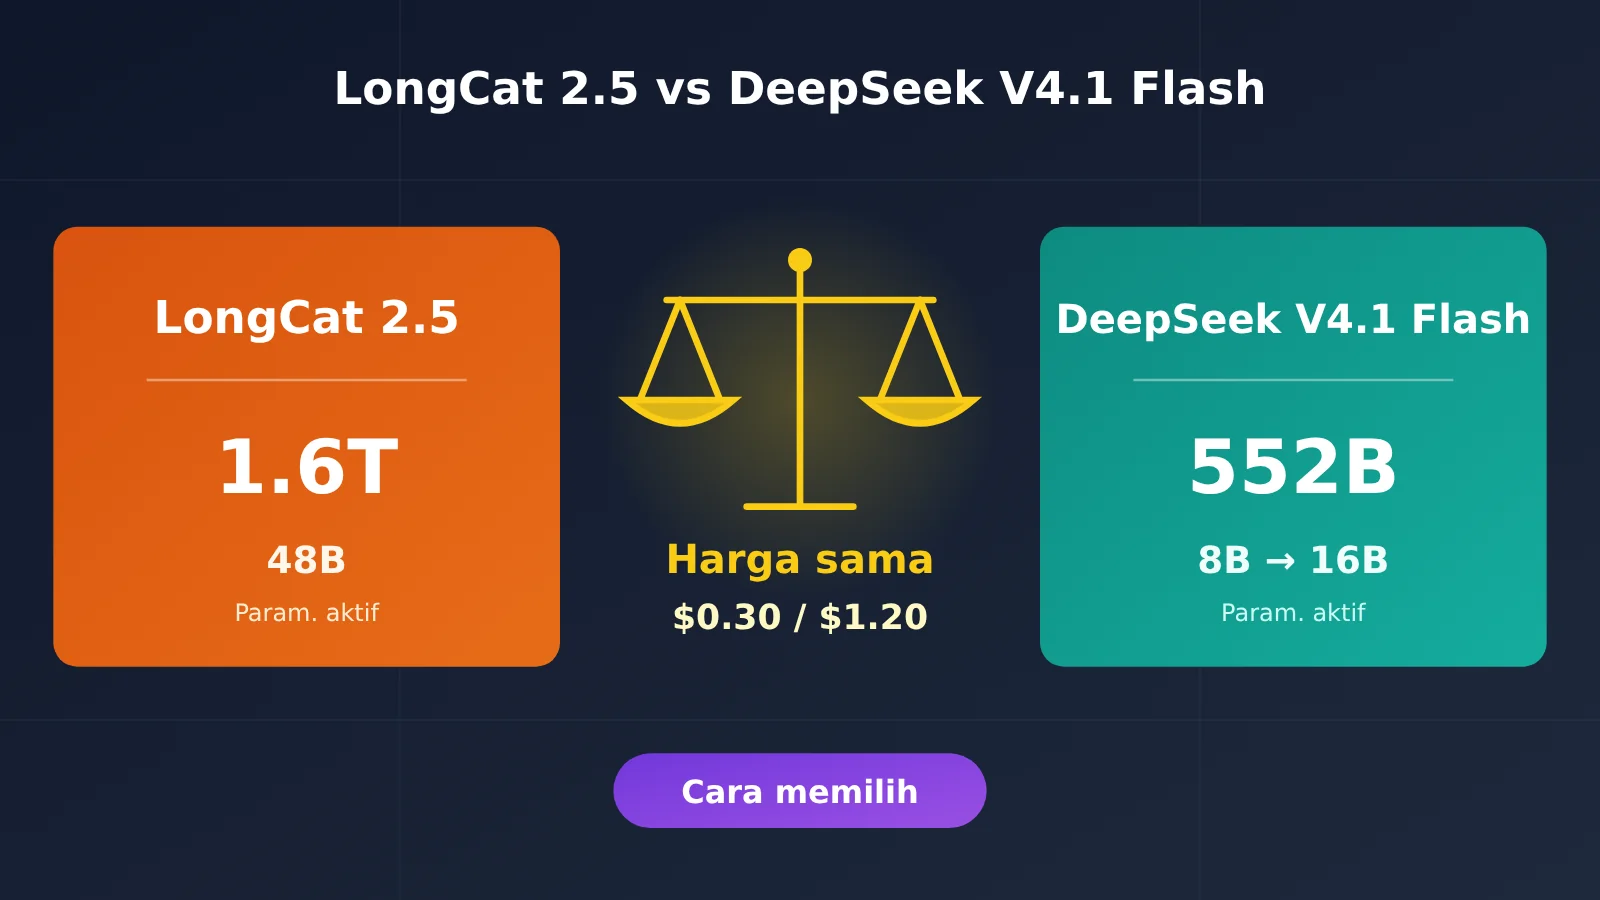
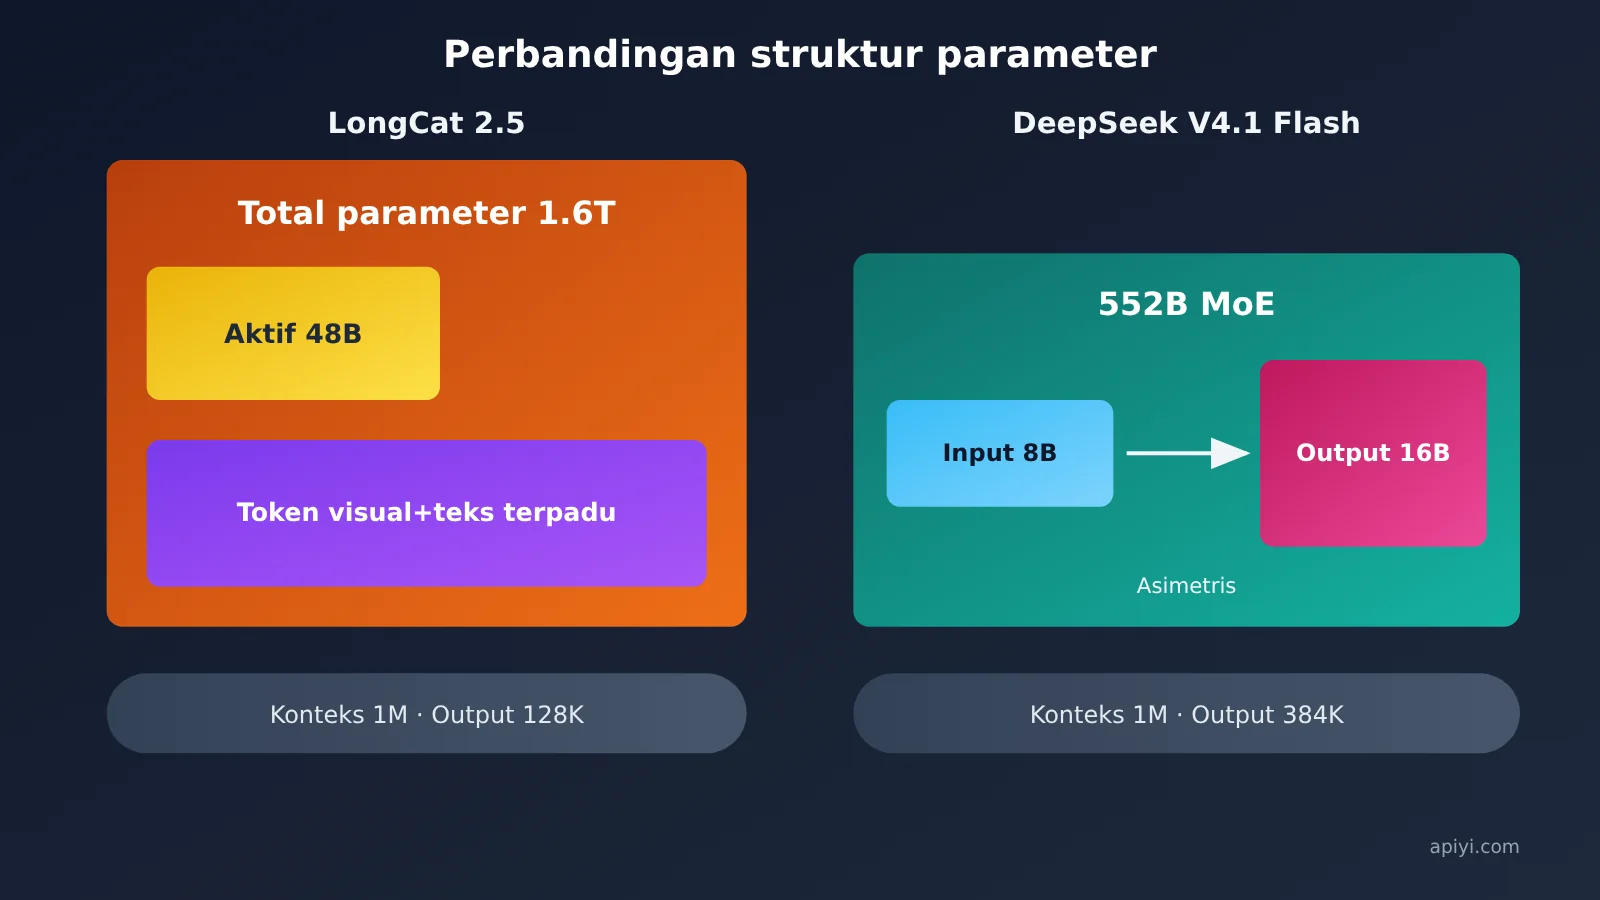
Harga kedua model pada jam sibuk sama persis: input $0.30, cache $0.006, dan output $1.20 (per 1 juta token). Perbedaannya terletak pada jenis tugas yang paling cocok, jadi pilihan bergantung pada pekerjaan yang kamu jalankan. LongCat 2.5 adalah model multimodal asli dengan total 1.6T parameter dan sekitar 48B parameter aktif per token. DeepSeek V4.1 Flash adalah MoE asimetris dengan 552B parameter, mengaktifkan 8B untuk input dan 16B untuk output, dengan bobot yang sudah dirilis secara terbuka.
Ini bukan artikel kompromi yang sekadar bilang「keduanya punya kelebihan masing-masing」. Semua angka di bawah berasal dari blog resmi, laporan teknis, dan halaman harga kedua penyedia. Skor benchmark masing-masing berasal dari pengujian mandiri, sehingga artikel ini hanya menggunakannya sebagai referensi pada kategori yang sebanding, tanpa membuat peringkat keseluruhan atau mengklaim hasil uji yang tidak pernah dilakukan.
Manfaat utama: Setelah membaca artikel ini, kamu bisa membandingkan tugas dalam proyek satu per satu, menentukan model utama dan model pelengkap, lalu menghitung berapa banyak yang bisa dihemat dengan memindahkan tugas batch ke luar jam sibuk.
LongCat 2.5 vs DeepSeek V4.1 Flash: profil singkat kedua model
Kesimpulannya: LongCat 2.5 punya lebih banyak parameter total dan parameter aktif per pemanggilan. DeepSeek V4.1 Flash lebih kecil dan lebih hemat parameter aktif, tetapi batas output-nya lebih panjang dan bobotnya bisa langsung diunduh. Keduanya memiliki jendela konteks 1M. Ada tiga hal yang paling menentukan pilihan: output maksimum 128K vs 384K, ketersediaan bobot sumber terbuka, dan jumlah parameter aktif.
| Aspek | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Total parameter | 1,6T (1,6 triliun) | 552B |
| Parameter aktif | Sekitar 48B per token | 8B untuk input, 16B untuk output |
| Arsitektur | Model multimodal native untuk agen, menggunakan token terpadu untuk visual dan teks | MoE, dengan arsitektur asimetris Causal-Encoder-Decoder |
| Panjang konteks | 1M | 1M |
| Output maksimum | 128K | 384K |
| Dukungan visual native | Mendukung, sinyal visual direpresentasikan sebagai token diskret bertingkat | Mendukung (Vision) |
| Bobot sumber terbuka | Bobot belum dirilis; GitHub dan HuggingFace sama-sama menampilkan keterangan “nantikan” | Sudah tersedia sebagai sumber terbuka; bobot dan laporan teknis dirilis di HuggingFace |
| Pengaturan berpikir | Hasil evaluasi resmi diperoleh dengan thinking aktif | Mode berpikir aktif secara default, tingkatnya dapat diatur dengan reasoning_effort |
Poin Utama Arsitektur LongCat 2.5
LongCat 2.5 dirancang untuk tugas agen jangka panjang. Dibandingkan versi 2.0, model ini terutama meningkatkan kemampuan pemahaman visual native dan pemrograman agen. Untuk pemrosesan visual, gambar didiskretisasi pada resolusi aslinya menggunakan SAE+RVQ, lalu dipraproses secara offline menjadi token visual sebelum dipelajari bersama dengan model utama. Model utama menggunakan satu sistem token untuk memproses visual dan teks, sehingga disebut multimodal native.
Dalam pelatihannya, LongCat 2.5 banyak menggunakan data lintasan jangka panjang dan reinforcement learning (RL) jangka panjang berskala besar. Blog resminya menyebut beberapa detail: lintasan kegagalan agen nyata diubah menjadi tugas yang dapat diverifikasi; RL asinkron menggunakan partial rollout dan menyaring kelompok sampel yang semuanya benar atau semuanya salah karena menghasilkan gradien nol; serta memberikan penalti untuk pemikiran dan pemanggilan alat yang berulang. Poin terakhir penting bagi pengembang agen: model akan lebih jarang terjebak dalam siklus pemanggilan alat, sehingga lebih sedikit token yang terbuang.
Dari sisi rekayasa inferensi, dibandingkan W8A8 INT8, W4A4 meningkatkan throughput prefill sebesar 43,3% dan throughput decode sebesar 42,77%, serta menurunkan TTFT sebesar 15,91% dan TPOT sebesar 19,72%. Di sisi pelatihan, FSDP dengan dual sharding meningkatkan throughput SFT untuk urutan panjang per GPU sebesar 86% dibandingkan baseline DDP. Angka-angka ini menunjukkan bahwa model berukuran 1,6T telah melalui optimasi khusus di sisi server, meski angka batas laju tidak dipublikasikan secara resmi.
Poin-poin struktur DeepSeek V4.1 Flash
DeepSeek V4.1 Flash adalah model terkecil dalam seri struktur baru ini. Ciri utamanya adalah pemrosesan input dan output yang asimetris: saat membaca input, model hanya mengaktifkan 8B parameter, sedangkan saat menghasilkan output, model mengaktifkan 16B. Dalam skenario agen, input biasanya jauh lebih banyak daripada output, misalnya saat membaca repositori, log, atau hasil dari tool. Desain ini membantu menekan beban komputasi di sisi pembacaan.
Perubahan di sisi biaya lebih besar lagi. KV Cache generasi baru jauh lebih kecil: kebutuhan HBM turun menjadi 1/4 dari generasi sebelumnya, sementara kebutuhan SSD turun menjadi 1/8. Dibandingkan model generasi pertama, KV Cache telah menyusut sebanyak 437 kali secara kumulatif.
Ada satu perubahan lain yang perlu diperhatikan: setelah 2026-09-14 pukul 12.00, permintaan ke deepseek-v4-pro akan diarahkan ke V4.1 Flash dan dikenai tarif Flash. Pengaturan ini berlaku sampai V4.1 Pro diluncurkan. Jadi, proyek yang masih menggunakan nama model lama sebenarnya sudah memanggil Flash.
Perbandingan harga LongCat 2.5 dan DeepSeek V4.1 Flash: sama hanya pada jam sibuk
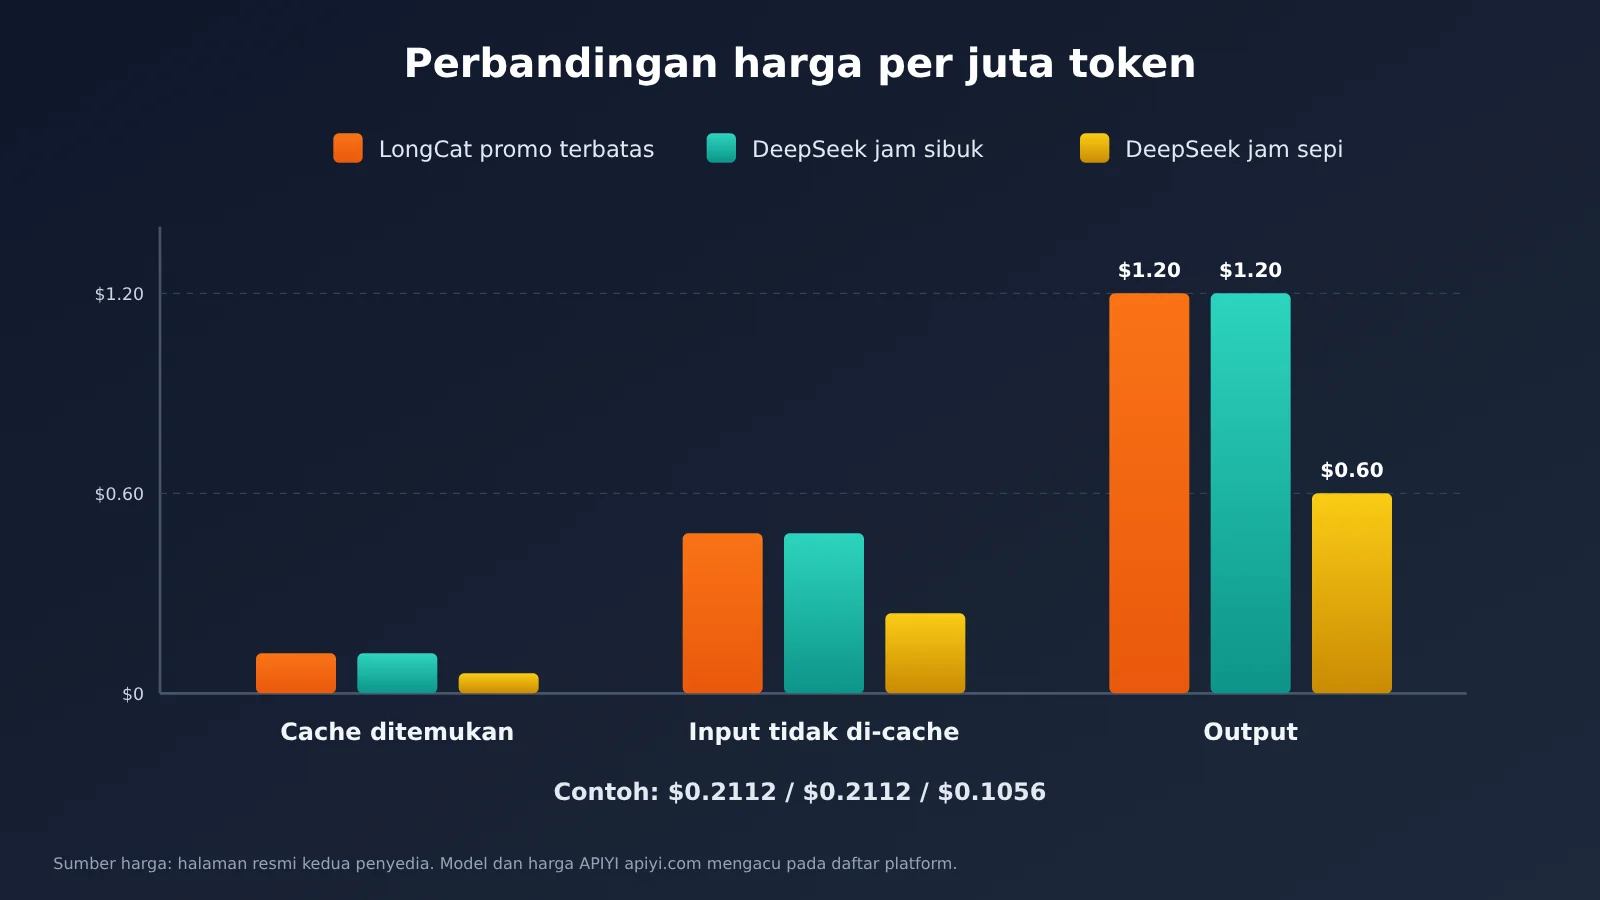
Kesimpulannya, harga diskon terbatas LongCat 2.5 sama persis dengan harga jam sibuk DeepSeek V4.1 Flash untuk setiap kategori. Di luar jam sibuk, DeepSeek memberikan diskon 50%, jadi tugas yang sama hanya membutuhkan setengah biaya. Dengan kata lain, harga keduanya sama hanya pada siang hari kerja.
| Per 1 juta token (dolar AS) | LongCat 2.5 (diskon terbatas) | DeepSeek jam sibuk | DeepSeek di luar jam sibuk |
|---|---|---|---|
| Input dengan cache hit | $0.006 | $0.006 | $0.003 |
| Input dengan cache miss | $0.30 | $0.30 | $0.15 |
| Output | $1.20 | $1.20 | $0.60 |
Mari hitung. Misalkan satu tugas Agent menggunakan 500.000 token input (300.000 cache miss dan 200.000 cache hit) serta 100.000 token output:
- LongCat 2.5 (diskon terbatas): 0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek jam sibuk: perhitungannya sama, $0.2112
- DeepSeek di luar jam sibuk: 0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
Selisih sekitar 10 sen dolar per tugas mungkin terlihat kecil. Namun, jika dijalankan 1.000 tugas dengan skala yang sama setiap hari, biaya LongCat dan DeepSeek pada jam sibuk masing-masing menjadi $211.2, sedangkan DeepSeek di luar jam sibuk menjadi $105.6. Bagi tim yang menjalankan tugas secara massal, selisihnya cukup besar dalam sebulan.
Jam sibuk DeepSeek adalah pukul 09.00–12.00 dan 14.00–18.00 waktu Beijing pada hari kerja, atau Senin hingga Jumat pukul 01.00–04.00 dan 06.00–10.00 UTC, tidak termasuk hari libur nasional Tiongkok. Di luar waktu tersebut, harga berlaku setengahnya, termasuk saat tengah hari, malam, dan dini hari pada hari kerja, serta sepanjang akhir pekan dan hari libur nasional. Dengan kata lain, dari 168 jam dalam seminggu, jam sibuk hanya mencakup 7 jam setiap hari kerja.
Ada beberapa detail penagihan LongCat 2.5 yang juga perlu dicatat:
- Biaya hanya dikenakan untuk HTTP 200. Respons 401, 403, 429, dan 500 tidak dikenai biaya, jadi percobaan ulang yang gagal tidak menghabiskan biaya.
- Paket kuota dijual secara terbatas melalui flash sale setiap hari pada pukul 10.00, 16.00, 21.00, dan 23.00 waktu Beijing. Masa berlakunya 30 hari, dan bagian yang belum digunakan dapat dikembalikan sepenuhnya. Cache hit tidak mengurangi token dalam paket.
- Kuota bonus: pengguna baru mendapat 10M token, pengguna lama mendapat 5M token. Kuota masuk secara otomatis, dan cache hit tidak mengurangi kuota bonus.
- Harga tersebut ditandai sebagai diskon terbatas. Untuk perubahan selanjutnya, periksa halaman harga resmi.
Di DeepSeek, pencarian internet dan pengambilan konten halaman web ditagih sebagai API terpisah, masing-masing seharga $0.75 per 1.000 permintaan yang berhasil. Jika Agent Anda sering mengakses internet, biaya ini perlu dihitung terpisah dalam anggaran.
💰 Tips biaya: Jika Anda memanggil DeepSeek V4.1 Flash melalui APIYI apiyi.com, penagihan mengacu pada daftar model di platform dan belum tentu sama dengan harga resmi jam sibuk dan di luar jam sibuk. Jalankan beberapa tugas terlebih dahulu di konsol platform dan periksa tagihannya sebelum menentukan rencana pemrosesan massal agar perhitungannya lebih akurat.
Perbandingan skor benchmark resmi LongCat 2.5 dan DeepSeek V4.1 Flash
Kesimpulannya, selisih kedua model pada sebagian besar benchmark Agent kurang dari 3 poin, sehingga keduanya pada dasarnya berada di kelas yang sama. LongCat 2.5 unggul pada Terminal Bench v4.0, Program Bench, JobBench, dan pembuatan 3D. Sementara itu, DeepSeek V4.1 Flash unggul pada DeepSWE, NL2Repo, dan AutomationBench, dengan selisih yang lebih besar.
| Benchmark | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(teks ke 3D) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
Catatan metodologi (wajib dibaca): Angka dari kedua pihak berasal dari pengujian resmi masing-masing. LongCat 2.5 menggunakan harness sendiri, dengan thinking aktif, temperature=1.0, dan top_p=0.95. Sebagian besar angka DeepSeek diambil dari laporan teknis publiknya, menggunakan harness DeepSeek dan tingkat penalaran Max. Harness, tanggal evaluasi, dan tingkat penalaran keduanya berbeda, jadi tabel ini hanya bisa menjadi referensi bahwa keduanya berada di kelas yang sama, bukan sebagai pemeringkatan.
Cara membaca hasil benchmark
Dua selisih terbesar menunjukkan keunggulan yang berlawanan. Di Terminal Bench v4.0, LongCat 2.5 unggul 7,3 poin dari DeepSeek (38,5 berbanding 31,2). Sementara itu, di DeepSWE v1.1, DeepSeek unggul 9,6 poin dari LongCat (74,2 berbanding 64,6). Benchmark pertama menguji tugas terminal yang lebih sulit dan panjang, sedangkan yang kedua menguji kemampuan memperbaiki bug di repositori nyata. Di sinilah kekuatan keduanya berbeda: LongCat unggul dalam operasi terminal dengan rangkaian langkah yang panjang, sedangkan DeepSeek unggul dalam membuat perubahan yang tepat pada basis kode yang sudah ada.
Di Terminal Bench v2.1 yang lebih lama, DeepSeek justru unggul 2,2 poin. Ini menunjukkan bahwa keunggulan LongCat baru terlihat ketika tingkat kesulitannya meningkat. Di Program Bench, LongCat unggul 5,2 poin, sedangkan di NL2Repo, DeepSeek unggul 4,9 poin. NL2Repo menguji pembuatan seluruh repositori dari deskripsi bahasa alami, sehingga lebih dekat dengan kemampuan membangun proyek dari nol.
Selisih pada pengujian terkait visual relatif kecil. Di Vision2Web, DeepSeek unggul 0,6 poin; di 3DCodeBench, LongCat unggul 2,1 poin. Dalam tabel resmi CharXiv-RQ w/tools, LongCat mencatat 90,2 berbanding 87,7; sedangkan di MathVision w/tools, DeepSeek mencatat 97,4 berbanding 96,5. Kalau hanya melihat pemahaman visual murni, keduanya hampir setara. Keunggulan LongCat terutama terletak pada kemampuannya menggabungkan pemahaman visual dengan pembuatan konten 3D dan halaman interaktif. Dari delapan demo resminya, ada simulasi fluida real-time, tampilan interaktif artefak 3D, maket kota, dan aset adegan miniatur. Arah pengembangannya cukup jelas.
Selisih di BrowseComp, HLE w/tools, dan MCP Atlas semuanya tidak lebih dari 1,3 poin. Jadi, kemampuan Agent umum seperti pencarian di internet dan pemanggilan alat MCP bisa dianggap seimbang.
Tingkat penalaran DeepSeek menentukan biaya
Bagian 5.3.3 laporan teknis DeepSeek menyajikan data yang berguna. Ketika reasoning effort dinaikkan dari 25 ke 100, rata-rata Pass@1 pada delapan benchmark penalaran naik dari 67,1% menjadi 76,3%, sementara skor DeepSWE v1.1 naik dari 66,0 menjadi 74,2. Konsekuensinya, jumlah token output meningkat sekitar 2,5 kali lipat. Tingkat 60–80 sudah mendekati akurasi tingkat maksimum, dengan anggaran token kurang dari separuhnya. Saat dinaikkan lagi ke 100, panjang jejak agent bertambah 1,6–1,8 kali lipat, tetapi peningkatan akurasinya hanya sedikit.
Perlu diperhatikan juga, nilai default reasoning_effort di API DeepSeek adalah high, sedangkan skor resmi diperoleh pada tingkat Max. Untuk mereproduksi skor DeepSeek pada tabel di atas, pengaturannya harus secara eksplisit diubah menjadi max. Gunakan tingkat menengah untuk tugas sehari-hari, lalu aktifkan tingkat maksimum untuk tugas tersulit. Token output merupakan komponen termahal dalam tagihan kedua model ($1,20), jadi pengaturan tingkat ini langsung menentukan ke mana biaya dialokasikan.
LongCat 2.5 vs DeepSeek V4.1 Flash: pembagian tugas
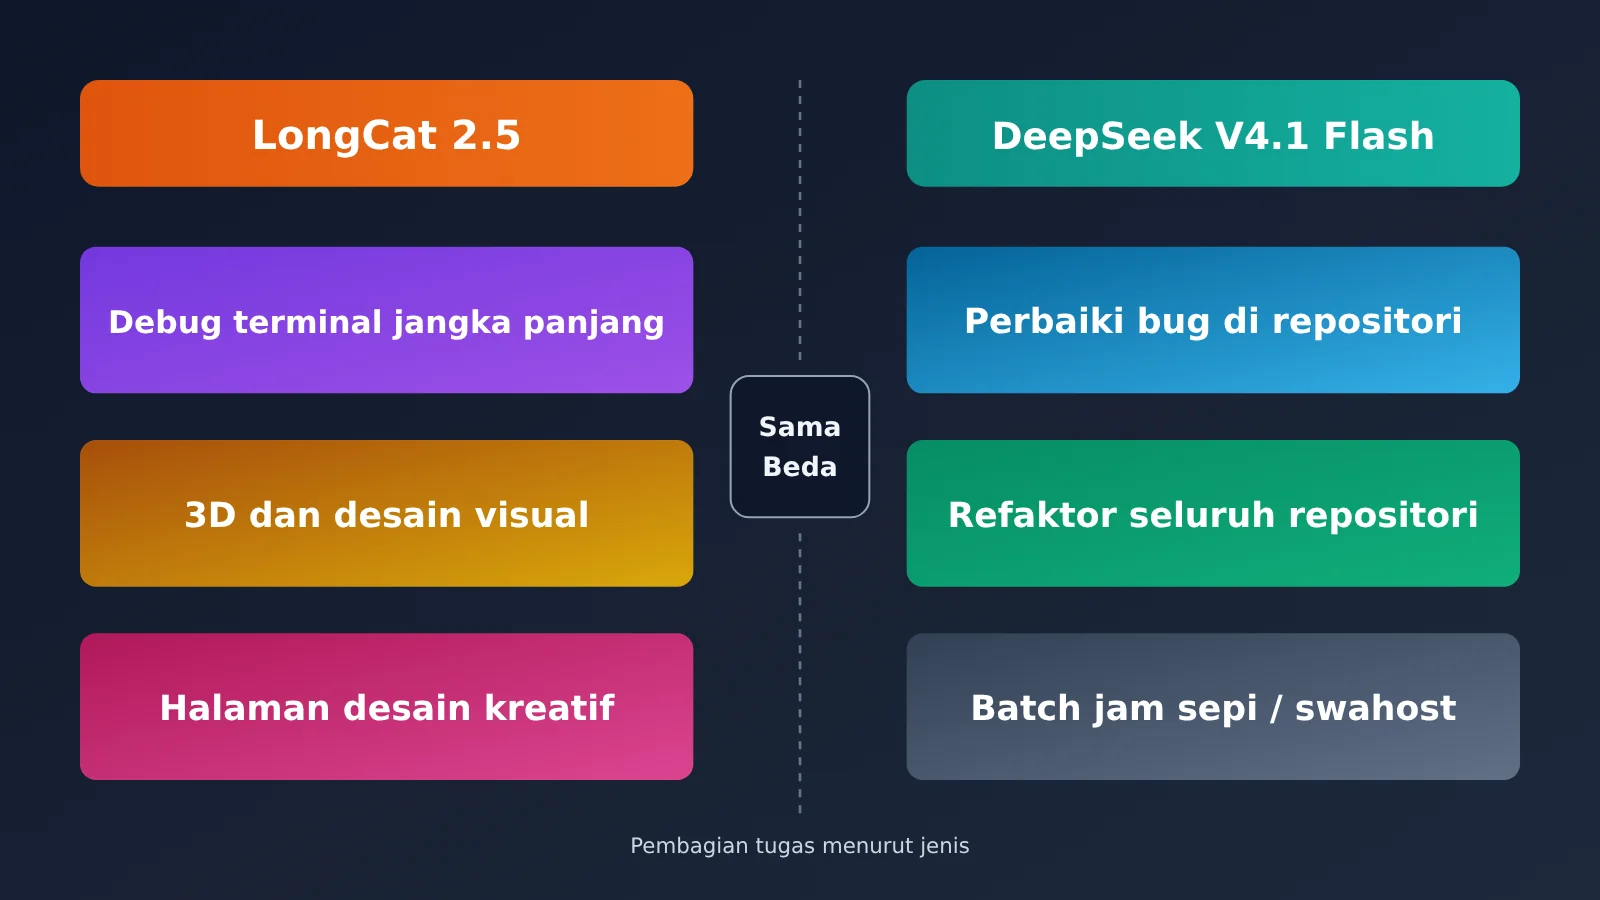
Kesimpulannya: harga sama, tugas berbeda. Serahkan tugas terminal jangka panjang, visual dan 3D, serta halaman desain kreatif kepada LongCat 2.5. Untuk mengubah kode di repositori nyata, memperbaiki bug SWE, menjalankan alur kerja otomatis, dan skenario yang membutuhkan deployment mandiri, pilih DeepSeek V4.1 Flash.
| Lebih cocok untuk LongCat 2.5 | Lebih cocok untuk DeepSeek V4.1 Flash |
|---|---|
| Pemecahan masalah terminal jangka panjang: login ke server melalui beberapa langkah, memeriksa log, mengubah konfigurasi, lalu memulai ulang untuk verifikasi (unggul 7,3 poin pada Terminal Bench v4.0) | Memperbaiki bug di repositori nyata: membaca issue, menemukan file, membuat perubahan, dan lolos pengujian (unggul 9,6 poin pada DeepSWE) |
| Aset 3D dan desain visual: membuat adegan 3D dari teks dan halaman presentasi interaktif (3DCodeBench 55,4) | Refaktor seluruh repositori dan membuat repositori dari nol: menghasilkan proyek dengan banyak file berdasarkan deskripsi kebutuhan (unggul 4,9 poin pada NL2Repo) |
| Halaman desain kreatif: undangan acara, halaman dengan warna bergaya khusus, dan laporan visualisasi data (contoh penggunaan dalam demo resmi) | Alur kerja otomatis dan pemrosesan batch: pemrosesan malam hari, pembersihan data, dan pembuatan laporan (unggul 3,0 poin pada AutomationBench, setengah harga di luar jam sibuk) |
| Pembuatan program seperti soal pemrograman dan tugas profesional terpadu (unggul pada Program Bench dan JobBench) | Kebutuhan deployment mandiri atau privat: bobot model sudah tersedia secara open source di HuggingFace; output panjang dalam satu kali pemanggilan (maksimum 384K) |
Alasan memilih LongCat 2.5
Angka yang paling meyakinkan untuk LongCat 2.5 berasal dari Terminal Bench v4.0. Pada v2.1, model ini tertinggal 2,2 poin, tetapi pada v4.0 justru unggul 7,3 poin. Ini menunjukkan bahwa semakin panjang dan sulit tugasnya, semakin besar keunggulan relatifnya. Hasil ini sejalan dengan pelatihannya yang banyak menggunakan rangkaian langkah panjang dan memberi penalti pada pemanggilan alat yang berulang. Jika Agent Anda sering menjalankan puluhan langkah berturut-turut di terminal, LongCat 2.5 layak dicoba lebih dulu.
Alasan kedua adalah tugas yang menggabungkan pemahaman visual dan pembuatan konten. Multimodal native serta pelatihan yang berfokus pada 3D dan halaman interaktif membuatnya lebih cocok untuk pekerjaan seperti membuat desain dari gambar atau membuat objek 3D dari teks. Pengguna baru juga mendapat 10 juta token gratis, dan penggunaan cache hit tidak mengurangi kuota tersebut, sehingga biaya untuk mencobanya rendah.
Alasan memilih DeepSeek V4.1 Flash
Angka terkuat DeepSeek V4.1 Flash adalah skor DeepSWE 74,2, dengan selisih terbesar di antara metrik yang dibandingkan untuk kedua model. Pekerjaan coding sehari-hari paling sering melibatkan perubahan pada repositori yang sudah ada, dan itulah keunggulannya. Output maksimalnya mencapai 384K, tiga kali lipat dari LongCat, sehingga hasilnya tidak mudah terpotong saat membuat file panjang atau patch besar.
Alasan ketiga adalah struktur biaya. Harga setengah saat jam sepi, ditambah tingkat penalaran yang bisa diatur, memberi fleksibilitas biaya yang jauh lebih besar untuk tugas batch dibandingkan harga tetap LongCat yang berlaku untuk waktu terbatas. Batas konkurensi 2.500 juga tercantum dalam dokumentasi resmi, sehingga ada angka yang jelas sebagai acuan untuk merencanakan throughput. Tim yang membutuhkan deployment privat dapat langsung mengunduh bobot model. Namun, menurut keterangan resmi, deployment skala besar membutuhkan sumber daya setingkat 2.000 kartu GPU, jadi tim kecil perlu mengevaluasi perangkat keras sebelum melakukan deployment sendiri.
💡 Saran memilih: Tabel hanya membantu mempersempit pilihan; keputusan akhir tetap bergantung pada tugas Anda. Pilih 10–20 tugas yang mewakili proyek Anda, jalankan pada kedua model, lalu bandingkan tingkat keberhasilan dan konsumsi token. Untuk menguji DeepSeek V4.1 Flash, Anda bisa mengaksesnya melalui APIYI apiyi.com tanpa perlu membuat akun terpisah.
Cara mengintegrasikan LongCat 2.5 dan DeepSeek V4.1 Flash
Kesimpulannya, keduanya kompatibel dengan format API OpenAI dan Anthropic. Untuk menghubungkannya ke Claude Code, cukup ubah beberapa variabel lingkungan di ~/.claude/settings.json. DeepSeek juga mendukung Responses API.
Mengintegrasikan LongCat 2.5
- Format OpenAI (SDK OpenAI apa pun): isi base_url dengan
https://api.longcat.ai/openaidan nama model denganLongCat-2.5. - Format Anthropic (SDK Anthropic): isi base_url dengan
https://api.longcat.ai/anthropic. - Claude Code (edit kolom env di
~/.claude/settings.json): keempat variabel ini wajib diisi: - Isi
ANTHROPIC_AUTH_TOKENdengan kunci LongCat Anda - Isi
ANTHROPIC_BASE_URLdenganhttps://api.longcat.ai/anthropic - Isi
ANTHROPIC_MODELdenganLongCat-2.5 - Isi
CLAUDE_CODE_MAX_OUTPUT_TOKENSdengan131072 - Penanganan batas laju (di kode pemanggilan Anda): saat batas terlampaui, API mengembalikan 429 (rate_limit_exceeded, retry_after 60). Pihak resmi menyarankan exponential backoff. Dokumentasinya tidak mencantumkan angka RPM/TPM, dan respons 429 tidak dikenakan biaya.
Mengintegrasikan DeepSeek V4.1 Flash
- Format OpenAI (SDK OpenAI apa pun): isi nama model dengan
deepseek-flash. Nama lamadeepseek-v4-flashdandeepseek-v4-flash-vision-expmasih bisa digunakan, akan diarahkan ke V4.1-Flash-1017, dan dikenakan tarif Flash. - Claude Code (edit kolom env di
~/.claude/settings.json): - Isi
ANTHROPIC_AUTH_TOKENdengan kunci DeepSeek Anda - Isi
ANTHROPIC_BASE_URLdenganhttps://api.deepseek.com/anthropic - Isi
ANTHROPIC_MODELdengandeepseek-flash - Tingkat penalaran (parameter permintaan SDK OpenAI): untuk penggunaan sehari-hari, atur
reasoning_effortke tingkat sedang. Untuk masalah yang sulit, gunakanmax. - Alat siap pakai: WorkBuddy (termasuk CodeBuddy) dan OpenCode adalah alat mitra resmi yang sudah terintegrasi sepenuhnya.
Pemanggilan terpadu melalui APIYI
Jika Anda ingin menjalankan beberapa model sekaligus untuk perbandingan, satu akun dan satu kunci APIYI sudah cukup untuk beralih antar-model, tanpa perlu membuat akun di setiap penyedia.
- Konfigurasi SDK OpenAI (di kode proyek Anda): isi base_url dengan
https://api.apiyi.com/v1dan api_key dengan kunci yang dibuat di konsol APIYI. - Nama model (beralih dalam parameter permintaan yang sama): untuk DeepSeek V4.1 Flash, gunakan
deepseek-v4.1-flashataudeepseek-v4.1-flash-1017. Biaya mengikuti daftar model di platform. - Pengujian perbandingan (dengan kode yang sama): cukup ubah parameter model untuk menjalankan kumpulan tugas yang sama pada model lain di platform sebagai perbandingan. base_url tetap
https://api.apiyi.com/v1.
Daftar model dan harga mengikuti informasi di platform. APIYI saat ini belum menyediakan LongCat-2.5, tetapi akan segera menghadirkannya. Sementara itu, gunakan endpoint resmi untuk LongCat 2.5, sedangkan DeepSeek dapat dikelola secara terpadu melalui APIYI di apiyi.com.
🚀 Mulai cepat: pengguna baru yang mendaftar di APIYI apiyi.com akan mendapat kuota uji coba gratis. Mulailah dengan menghubungkan DeepSeek V4.1 Flash ke proyek SDK OpenAI yang sudah ada; cukup ubah satu baris base_url untuk menjalankannya.
Pertanyaan Umum tentang LongCat 2.5 vs DeepSeek V4.1 Flash
Q1: Apakah harga kedua model benar-benar sama?
Hanya sama pada jam sibuk DeepSeek. Harga diskon terbatas LongCat 2.5 adalah $0.30 / $0.006 / $1.20, sama persis dengan harga DeepSeek pada jam sibuk untuk setiap komponen. Di luar jam sibuk, semua harga DeepSeek didiskon 50%. Jam sibuknya adalah hari kerja pukul 09.00–12.00 dan 14.00–18.00. Sementara itu, harga LongCat merupakan diskon terbatas dan bisa berubah nantinya.
Q2: Apakah tabel benchmark bisa menunjukkan model mana yang lebih unggul?
Tidak bisa langsung dijadikan peringkat. Keduanya menggunakan hasil pengujian resmi masing-masing, dengan harness, tanggal, dan tingkat penalaran yang berbeda. Hasil DeepSeek juga menggunakan tingkat Max. Cara yang lebih tepat adalah melihat pengujian dengan selisih besar: LongCat unggul 7,3 poin pada Terminal Bench v4.0, sedangkan DeepSeek unggul 9,6 poin pada DeepSWE. Untuk selisih dalam rentang 1–2 poin, anggap saja imbang.
Q3: Kapan LongCat 2.5 akan dirilis sebagai sumber terbuka?
Belum ada jadwal resmi. Saat ini, GitHub dan HuggingFace sama-sama masih menampilkan keterangan “segera hadir”, dan bobot model belum dirilis. Untuk proyek yang harus di-deploy sendiri, saat ini pilihannya adalah DeepSeek V4.1 Flash, yang bobot dan laporan teknisnya sudah tersedia untuk publik.
Q4: Apakah kedua model ini bisa dipanggil melalui APIYI?
Saat ini baru DeepSeek V4.1 Flash yang bisa dipanggil, dengan nama model `deepseek-v4.1-flash` dan `deepseek-v4.1-flash-1017`. Biayanya mengikuti daftar model di platform. LongCat-2.5 belum tersedia di APIYI, tetapi akan segera diluncurkan. Untuk nama model dan harga terbaru, lihat daftar model di platform APIYI apiyi.com.
Q5: Bagaimana cara menghemat biaya untuk tugas batch?
Saat menggunakan DeepSeek, manfaatkan dua pengaturan sekaligus: jadwalkan tugas di luar jam sibuk agar harga per unit langsung turun setengah, lalu atur reasoning_effort ke tingkat menengah. Laporan menunjukkan bahwa tingkat 60–80 sudah mendekati akurasi tingkat maksimum, dengan anggaran token kurang dari setengahnya. Harga saat cache hit hanya 1/50 dari harga saat cache miss. Letakkan petunjuk sistem dan definisi tool yang tetap di bagian awal permintaan untuk meningkatkan tingkat cache hit.
Kesimpulan: Pilih LongCat 2.5 atau DeepSeek V4.1 Flash?
Kesimpulannya jelas: harganya sama, tapi keunggulan tugasnya berbeda. Bagi penggunaan sesuai tugas dan jalankan tugas massal di luar jam sibuk.
- Skala: LongCat memiliki 1,6T parameter dengan 48B aktif, sedangkan DeepSeek memiliki 552B dengan 8B aktif untuk input dan 16B untuk output. Jendela konteks keduanya sama-sama 1M.
- Batas output: LongCat 128K, DeepSeek 384K. Pilih DeepSeek untuk tugas dengan output panjang.
- Harga: Harga promosi terbatas LongCat sama dengan harga DeepSeek pada jam sibuk. DeepSeek menawarkan setengah harga di luar jam sibuk; contoh perhitungannya $0.2112 berbanding $0.1056.
- Skor benchmark: LongCat unggul 7,3 poin untuk tugas terminal yang panjang, sedangkan DeepSeek unggul 9,6 poin untuk perbaikan bug di repositori. Sebagian besar metrik lainnya seimbang.
- Sumber terbuka: DeepSeek sudah bersumber terbuka, sedangkan LongCat belum merilis bobotnya.
- Integrasi: Keduanya kompatibel dengan format OpenAI dan Anthropic. Di Claude Code, cukup ubah variabel environment untuk beralih.
Intinya: pilih satu model utama berdasarkan pembagian tugas, lalu gunakan yang lain sebagai pelengkap. Sebisa mungkin jalankan tugas massal di luar jam sibuk. Untuk DeepSeek V4.1 Flash, Anda bisa melakukan pengujian skala kecil terlebih dahulu melalui antarmuka terpadu APIYI di apiyi.com sebelum menentukan model utama.
📚 Referensi
- Blog resmi LongCat-2.5: Posisi model, arsitektur, pelatihan, dan detail teknis
- Tautan:
longcat.ai/blog/longcat-2.5 -
Keterangan: Skala parameter, pendekatan token visual, data inferensi W4A4, dan tabel evaluasi resmi
-
Dokumentasi platform terbuka LongCat: Harga, endpoint, dan integrasi Claude Code
- Tautan:
longcat.ai/platform/docs -
Keterangan: Harga diskon terbatas, penanganan 429, paket kuota, dan ketentuan bonus
-
Pengumuman rilis DeepSeek V4.1 Flash: Arsitektur, sumber terbuka, dan perubahan API
- Tautan:
deepseek.com/news/deepseek-v4-1-flash -
Keterangan: MoE asimetris, kompresi KV Cache, dan panduan migrasi nama model
-
Halaman harga API DeepSeek: Harga jam sibuk dan luar jam sibuk serta batas konkurensi
- Tautan:
api-docs.deepseek.com/quick_start/pricing -
Keterangan: Definisi periode jam sibuk dan luar jam sibuk, batas konkurensi 2500, serta biaya pencarian dan pengambilan data yang ditagihkan terpisah
-
Repositori bobot DeepSeek-V4.1-Flash: Bobot sumber terbuka dan laporan teknis
- Tautan:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - Keterangan: Skor benchmark pada Tabel 3 dan analisis tingkat inferensi di bagian 5.3.3
Penulis: Tim teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama APIYI di apiyi.com. Materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com