Anmerkung des Autors: Vergleich von Qwen4-Max und Kimi K3.1 Pro entlang von fünf Dimensionen: offene Gewichte, Terminal-Aufgaben, Lieferung langer Aufgaben, Vision und Video sowie Kosten pro Million Tokens. Dazu erklären wir, warum die offiziellen Terminal-Bench-Werte der beiden Anbieter nicht übereinstimmen.
Fazit zuerst: Wenn du die Gewichte für Fine-Tuning, Quantisierung oder eine private Bereitstellung brauchst, nimm Kimi K3.1 Pro. Wenn du eine gehostete API brauchst, gleichzeitig Vision, Video und die Lieferung langer Aufgaben wichtig findest und die Kosten pro Million Tokens so niedrig wie möglich halten willst, nimm Qwen4-Max. Wenn deine Kern-Workload ein Kommandozeilen-Agent im Terminal ist, hat Kimi K3.1 Pro derzeit einen deutlichen Vorsprung.
Das ist keine Kompromissanalyse nach dem Motto „jeder hat seine Stärken“. Alle Zahlen unten sind mit Quellen belegt: Die Qwen-Zahlen stammen aus dem offiziellen Alibaba-Blog sowie aus einem vom Anbieter selbst veröffentlichten Vergleich im selben Diagramm. Die Kimi-Zahlen stammen aus der offiziellen Moonshot-Dokumentation. Drittanbieterdaten kommen von einem öffentlichen Arena-Leaderboard-Snapshot (2026-11-14). Warum die selbst gemeldeten Werte beider Anbieter für denselben Benchmark nicht übereinstimmen, wird in diesem Artikel separat aufgeschlüsselt.
Der Mehrwert: Nach dem Lesen dieses Artikels hast du eine klare Trennlinie für die Auswahl und weißt, wie du die beiden Vorteile „günstiger“ und „Zugriff auf die Gewichte“ auf deine eigenen Aufgaben übertragen kannst.
Zentrale Unterschiede zwischen Qwen4-Max und Kimi K3.1 Pro
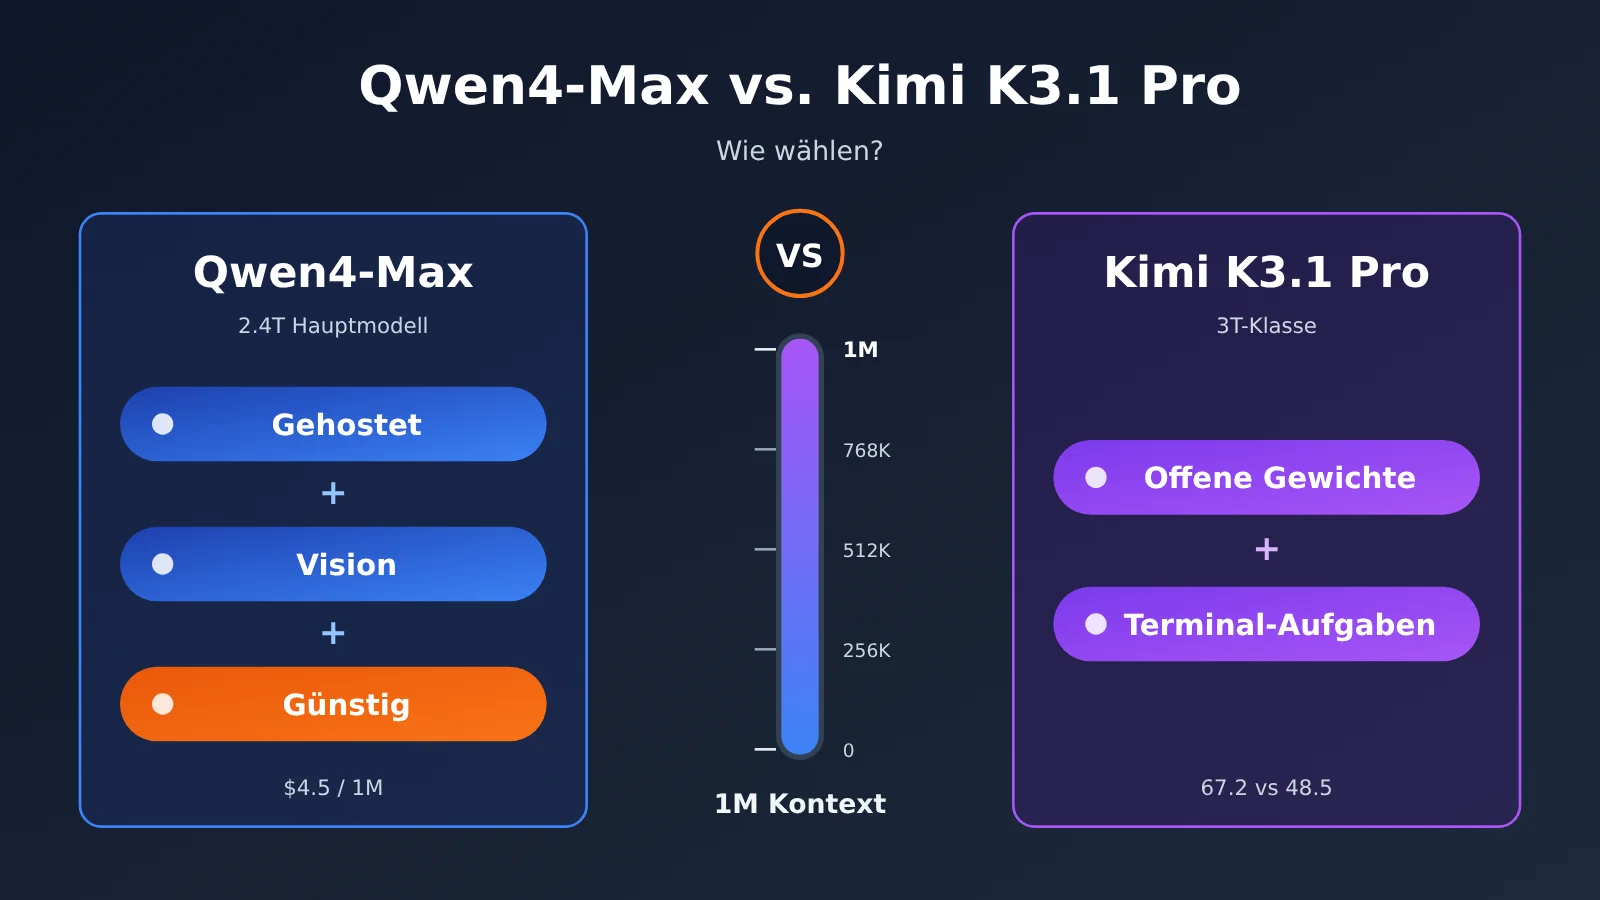
Beide Modelle sind chinesische Flaggschiffe der zweiten Jahreshälfte 2026. Ihre Kontextfenster liegen beide im 1M-Bereich, und auch die oberflächlichen Parameter wirken ähnlich – doch die Positionierung könnte unterschiedlicher kaum sein. Qwen4-Max setzt auf einen 2.4T-Backbone, 71B aktive Parameter plus ein 328B-N-gram-Embedding, unterstützt Vision nativ, hat eine maximale Ausgabe von 393K und eine maximale Chain-of-Thought von 262K; der Standardwert für reasoning_effort ist high. Kimi K3.1 Pro ist das erste Modell der K3.1-Reihe und gehört zur 3T-Klasse. Offiziell wird es als das leistungsfähigste Open-Weight-Modell der 3T-Klasse bezeichnet; das Kontextfenster beträgt 1,048,576 Token.
| Vergleichsdimension | Qwen4-Max | Kimi K3.1 Pro | Tendenz |
|---|---|---|---|
| Größe | 2.4T-Backbone / 71B aktiv + 328B-N-gram-Embedding | 3T-Klasse | — |
| Gewichte | In öffentlichen Unterlagen wird nur die von QwenCloud gehostete API erwähnt | Offene Gewichte | Kimi |
| Kontext | 1M, maximale Ausgabe 393K | 1,048,576 Token | Gleichauf |
| Terminal-Aufgaben (Alibaba, gleiche Grafik) | 48.5 | 67.2 | Kimi |
| Langlaufende Aufgaben und Branchenlieferung | In mehreren Bereichen führend | AutomationBench etwas höher | Qwen4 |
| Vision und Video | Native Vision, führend bei Diagramm- und Videometriken | Bei den Metriken im Rückstand | Qwen4 |
| Preis pro 1M Ausgabe | $4.5 | $10 | Qwen4 |
Kurz gesagt: Kimi punktet mit „anpassbar“ und „terminalfähig“, Qwen4 mit „breiter Lieferabdeckung“ und „günstiger“. Im Folgenden betrachten wir die fünf Dimensionen einzeln.
Kann Kimi K3.1 Pro oder Qwen4-Max die Gewichte ändern?
Das ist die härteste Trennlinie zwischen den beiden. Kimi K3.1 Pro ist ein Modell mit offenen Gewichten: Teams können es auf ihren eigenen Cluster ziehen und dort Domain-Fine-Tuning, Quantisierung und Kompression, Destillation oder in Umgebungen mit strengen Compliance-Anforderungen eine Offline-Bereitstellung durchführen. Für Teams, die „das Modell selbst ändern“ müssen, gibt es dazu keine Alternative – selbst ein noch so hoher Benchmark-Score ersetzt das nicht.
Zu Qwen4-Max findet man in den derzeit öffentlich verfügbaren Materialien nur, dass es über QwenCloud als gehostete API angeboten wird; in den Referenzmaterialien wird kein offenes Gewichtsangebot erwähnt. Der Vorteil des Hostings: Man muss sich keine Gedanken um GPUs, Inference-Frameworks und Skalierung machen. Der Nachteil: Man kann das Modell nur über Eingabeaufforderungen, Kontext und Tool-Aufrufe an das eigene Geschäft anpassen. Anzumerken ist, dass offene Gewichte nicht automatisch sicherer bedeuten – die Sicherheit hängt weiterhin von Ihrer Bereitstellung, Ihren Zugriffskontrollen und Ihren Audit-Prozessen ab.
Umrechnungsmethode: Wenn Sie das Modell nur „aufrufen“, ist der Wert offener Gewichte für Sie ungefähr null. Wenn Sie eindeutig Fine-Tuning oder Private Deployment brauchen, ist Kimi in diesem Vergleich die einzige Option – die folgenden Dimensionen dienen dann nur dazu, zu bewerten, ob es „ausreicht“.
Qwen4-Max vs. Kimi K3.1 Pro: Wer ist bei Terminal-Aufgaben stärker
Terminal-Aufgaben sind die Kategorie, in der ein Modell in einer Kommandozeilenumgebung Dateien liest und schreibt, Befehle ausführt und anhand von Fehlermeldungen iterativ Korrekturen vornimmt – die realitätsnächste Arbeitsumgebung für einen Coding-Agent. In dieser Disziplin ist Kimi K3.1 Pro deutlich stärker: In der von Alibaba selbst veröffentlichten Vergleichstabelle erreicht Qwen4-Max auf Terminal-Bench 4.0 einen Wert von 48.5, Kimi K3.1 kommt auf 67.2 – ein Abstand von 18.7 Punkten und damit die Kategorie, in der Qwen4 im gesamten Chart am weitesten zurückliegt.
Warum die Terminal-Bench-Werte der beiden Anbieter voneinander abweichen
Dabei gibt es ein leicht zu übersehendes Detail: Derselbe Kimi K3.1 Pro hat in den offiziellen Unterlagen beider Anbieter unterschiedliche Terminal-Bench-4.0-Werte.
| Quelle | Kimi K3.1 Pro | Weitere Referenzwerte |
|---|---|---|
| Offizielle Moonshot-Dokumentation | 65.7% | Claude Opus 5.5 mit 66.4%, GPT-6 Astra mit 58.2% |
| Von Qwen selbst veröffentlichte Vergleichstabelle | 67.2 | Qwen4-Max mit 48.5 |
Kimi selbst schreibt 65.7%, in Alibabas Chart ist Kimi mit 67.2 markiert – eine Differenz von 1.5 Punkten. Diese Abweichung stammt aus unterschiedlichen Evaluierungs-Harnesses (Agent-Framework, Tool-Definitionen, Timeout- und Retry-Strategien), unterschiedlichen Reasoning-Effort-Einstellungen und unterschiedlichen Versionen des Aufgaben-Sets. Sie lässt sich nicht als Beweis dafür lesen, dass einer der Anbieter schummelt, und man darf die beiden Zahlen auch nicht zu einem einzigen „Kimi-Wert für Terminal-Aufgaben“ vermischen und so zitieren. Analog gilt: Claude Opus 5.5 steht in der Moonshot-Dokumentation bei 66.4% und wird unter Alibabas Evaluierungsrahmen ebenfalls eine andere Zahl ergeben – ein Ranking durch das Zusammensetzen von Werten aus verschiedenen Dokumenten ist nicht haltbar.
Die richtige Lesart lautet: Relative Positionen nur innerhalb desselben Charts und desselben Harness vergleichen. Nach Moonshots Messgrundlage liegt Kimi etwas unter Opus 5.5 und deutlich über GPT-6 Astra; nach Alibabas Messgrundlage führt Kimi deutlich vor Qwen4-Max. Beide Schlussfolgerungen gelten, und sie zeigen in dieselbe Richtung – die Terminal-Fähigkeiten von Kimi K3.1 Pro gehören zur Spitzengruppe.
🎯 Technischer Tipp: Benchmark-Werte schwanken je nach Harness und Effort. Am verlässlichsten ist es, mit dem eigenen Agent-Framework und echten Aufgaben jeweils eine Runde laufen zu lassen. Über APIYI apiyi.com kannst du mit demselben API-Schlüssel Modelle wie
kimi-k3.1-proaufrufen – Framework unverändert lassen und nur denmodel-Parameter wechseln; nur dann ist der Vergleich aussagekräftig.
Ein weiterer relevanter Punkt sind die übrigen Kennzahlen bei Coding-Aufgaben. In Alibabas Chart liegen beide bei DeepSWE v1.1 praktisch gleichauf (75.7 zu 75.5), bei ProgramBench liegt Qwen4-Max um 6.5 Punkte vorn (31.5 zu 25.0). Die offizielle Moonshot-Dokumentation nennt außerdem für Kimi Code Bench 3.0 Long-horizon 61.2%, eine deutliche Verbesserung gegenüber den 55.95% der vorherigen K3-Generation. Die treffende Formulierung lautet also: Kimi ist bei Terminal-Interaktion stark, Qwen4 liegt bei einem Teil der nicht-terminalen Coding-Aufgaben nicht zurück.
Qwen4-Max und Kimi K3.1 Pro bei langen Aufgaben und Branchenlieferungen
Wenn dein Agent die Aufgabe hat, „eine Arbeit vollständig abzuliefern“ – Berichte aufbereiten, Geschäftsprozesse komplett durchlaufen, Fachfragen bearbeiten –, schneidet Qwen4-Max im Vergleichsdiagramm von Alibaba besser ab. Die folgende Tabelle zeigt die Kennzahlen aus dem von Qwen selbst gemeldeten Vergleich, die sich auf lange Aufgaben und Branchenszenarien beziehen.
| Benchmark (Qwen offiziell selbst gemeldet, gleiches Vergleichsdiagramm) | Qwen4-Max | Kimi K3.1 | Differenz |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 um 7.3 höher |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 um 6.6 höher |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 um 9.6 höher |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 um 12 höher |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 um 3.6 höher |
| AutomationBench-AA | 72.5 | 73.3 | Kimi um 0.8 höher |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 um 4.4 höher |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 um 2.8 höher |
| Humanity’s Last Exam | 51.7 | 51.1 | praktisch gleichauf |
Das Muster in diesen Daten ist klar: Qwen4-Max liegt bei beruflichen Aufgaben, Agenten-Lieferungen und Fachgebieten wie Biomedizin meist vorn, mit einem Abstand von 3 bis 10 Punkten. Kimi führt nur bei AutomationBench-AA mit einem knappen Vorsprung von 0.8 Punkten, bei HLE sind beide nahezu gleich. Zu beachten ist allerdings: Das ist das Bewertungsframework von Alibaba; die Zahlen von Kimi unter seinem eigenen Harness können abweichen.
Auch die maximale Ausgabe von 393K und die maximale Chain-of-Thought-Länge von 262K machen Qwen4-Max für lange Aufgaben sehr brauchbar. Das bedeutet, dass ein einzelner Aufruf sehr lange Berichte oder Codedateien erzeugen kann, ohne ständiges Aufteilen und wieder Zusammensetzen – das reduziert Fehlerquellen in der Agent-Orchestrierung.
Visuelle und Video-Fähigkeiten von Qwen4-Max und Kimi K3.1 Pro
Qwen4-Max unterstützt visuelle Eingaben von Haus aus. Das zeigt sich auch in den Benchmark-Zahlen von Alibaba: Beim Diagrammverständnis-Benchmark Chartography erreicht Qwen4 54,2 Punkte, Kimi 50,0. Beim Video-Verständnis-Benchmark Video-Index kommt Qwen4 auf 68,1, Kimi auf 63,2 – ein Vorsprung von 4,2 bzw. 4,9 Punkten.
Für Unternehmen, die Screenshots auslesen, Diagramme in Berichten analysieren, Produkt-Screencasts verstehen oder Videoinhalte auswerten müssen, ist Qwen4-Max die unkompliziertere Wahl. Kimi erzielt in diesen beiden Bereichen ebenfalls solide Werte, aber wenn Vision die Hauptlast trägt, wird sich die Lücke bei Skalierung vergrößern.
Für die Frontend-Generierung lohnt sich ein Blick auf Daten von Drittanbietern. In der öffentlichen arena-Rangliste (Snapshot vom 14.11.2026), Bereich Code Arena WebDev, liegt Qwen4-Max (xHigh) mit 1750 Punkten auf Platz 6, ist aber noch als „Preliminary“ gekennzeichnet und kommt auf 1.814 Stimmen. Kimi K3.1 Pro (Max) steht mit 1.686 Punkten auf Platz 13, hat 5.215 Stimmen und ist nicht mehr vorläufig. Qwen4 hat zwar die höhere Punktzahl, aber die kleinere Stichprobe – die Platzierung kann sich später also noch verschieben.
Qwen4-Max vs. Kimi K3.1 Pro: Wie sich die Kosten berechnen
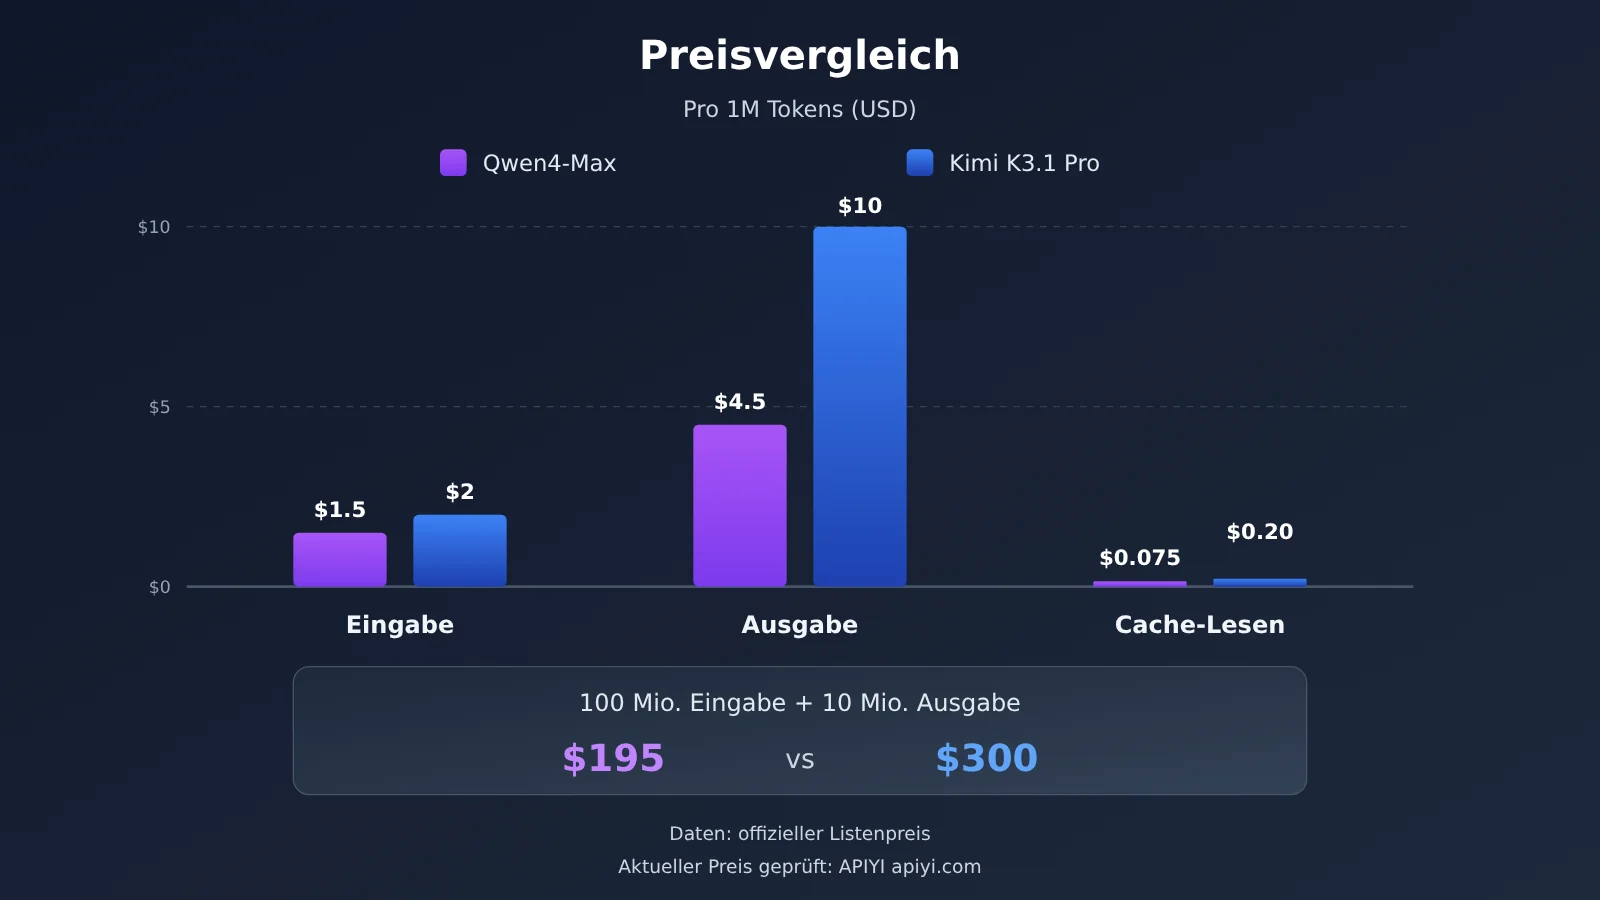
Offizielle Listenpreise (pro 1 Mio. Tokens, Stand 16.11.2026)
| Abrechnungsposten | Qwen4-Max (QwenCloud) | Kimi K3.1 Pro (Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| Eingabe | $1.5 | $2 | $4 |
| Ausgabe | $4.5 | $10 | $20 |
| Cache-Lesen / Cache-Treffer | $0.075 | $0.20 | $0.20 |
| Cache-Schreiben (5 Minuten) | $1.875 | $2 | — |
| Cache-Schreiben (1 Stunde) | $3 | $4 | — |
Umgerechnet nach Listenpreis liegt der Eingabepreis von Qwen4-Max bei 75 % von Kimi, der Ausgabepreis bei 45 % und das Cache-Lesen bei nur 37,5 %. Bei einer typischen Agent-Last von „100 Mio. Eingabe + 10 Mio. Ausgabe“ kommt Qwen4-Max auf rund $195, Kimi K3.1 Pro auf rund $300. Für Kimi gibt es zusätzlich einen Batch-Modus zum Preis von 60 % des Standardtarifs – ideal für Offline-Batch-Aufgaben. Die Highspeed-Version kostet das Doppelte und liefert dafür etwa 2 bis 3 Mal so viel Geschwindigkeit.
Günstiger pro Token heißt nicht günstiger pro Aufgabe
Das ist der kontraintuitivste Punkt in der Kostenbetrachtung. Ein arena-Schnappschuss zeigt: Qwen4-Max (xHigh) kostet pro Aufgabe $4.18, Kimi K3.1 Pro (Max) nur $0.89. Qwen4 ist pro Token günstiger, pro Aufgabe aber um ein Vielfaches teurer – der Grund: Bei hoher Effort-Stufe erzeugt das Modell massenhaft Reasoning-Token, deutlich mehr Ausgabe als Kimi.
Für die echten Kosten muss man also „Preis × tatsächlicher Token-Verbrauch“ rechnen. Bei Qwen4-Max steht reasoning_effort standardmäßig auf high. Wenn die Aufgabe keine tiefe Reasoning-Leistung braucht, lässt sich der Preisvorteil nur dann in einen Gesamtkostenvorteil umwandeln, wenn man den Effort aktiv herunterdreht.
Aktuelle Preise bei APIYI (16.11.2026)
| Modell-ID | Eingabe | Ausgabe | Cache-Lesen | Status |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | verfügbar |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | verfügbar |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | verfügbar |
qwen4-max |
— | — | — | noch nicht verfügbar, wir stellen es so bald wie möglich bereit |
Die Angaben oben gelten pro 1 Mio. Tokens. qwen4-max ist derzeit noch nicht in der Modellliste von APIYI zu finden – wir stellen das Modell so bald wie möglich bereit. Bis dahin lässt sich die Aufrufkette schon mit qwen3.8-max aufbauen. Maßgeblich sind stets die Modellnamen und Preise in der Modellliste der APIYI-Plattform apiyi.com. Bevor Sie das Modell wechseln, sollten Sie erst das Modell prüfen, dann den Preis abgleichen und schließlich das Aufrufprotokoll bestätigen.
So rufen Sie Kimi K3.1 Pro und die Qwen-Serie über APIYI auf
APIYI bietet eine OpenAI-kompatible Schnittstelle. Für die Anbindung sind nur drei Änderungen nötig – ein Wechsel des SDK ist nicht erforderlich:
- Setzen Sie im Client
base_urlaufhttps://api.apiyi.com/v1, der Anforderungspfad lautet/chat/completions; - Tragen Sie den API-Schlüssel ein, den Sie in der APIYI-Konsole erhalten haben;
- Setzen Sie den Parameter
modelaufkimi-k3.1-pro,kimi-k3.1-pro-highspeedoderqwen3.8-max; sobaldqwen4-maxverfügbar ist, ersetzen Sie einfach die Modellbezeichnung.
Für A/B-Vergleiche empfiehlt es sich, die Eingabeaufforderung, die Tool-Definitionen und die effort-Stufe festzuhalten, nur das Feld model zu wechseln und bei jedem Aufruf die Anzahl der Eingabe-, Ausgabe- und Cache-Token zu protokollieren. So lässt sich sowohl das aus dem vorigen Abschnitt bekannte Phänomen „harness verändert den Score“ reproduzieren als auch der tatsächliche Aufwand pro Aufgabe berechnen, den die beiden Modelle in Ihrem Geschäft verursachen.
🚀 Schnellstart: Neue Nutzer erhalten nach der Registrierung auf APIYI apiyi.com ein kostenloses Testkontingent und können mit demselben Key zwischen der Kimi- und der Qwen-Serie wechseln. Testen Sie zuerst mit wenig Traffic und entscheiden Sie dann, welches Modell in der Produktion die Hauptlast tragen soll.
Szenarioempfehlungen für Qwen4-Max und Kimi K3.1 Pro
Wann Sie Kimi K3.1 Pro wählen
- Private Deployment und Fine-Tuning: Sie benötigen offene Gewichte für domänenspezifisches Fine-Tuning, Quantisierung oder Offline-Betrieb;
- Terminal-Coding-Agent: Die Hauptlast liegt in Lese-, Ausführungs- und Reparaturschleifen auf der Kommandozeile;
- Offline-Batch-Verarbeitung: Asynchrone Ergebnisse sind akzeptabel; mit Batch zahlen Sie nur 60 % des Preises und senken so die Kosten;
- Interaktion mit geringer Latenz: Wenn Geschwindigkeit zählt, wählen Sie die Highspeed-Version und tauschen Preis gegen 2- bis 3-fache Geschwindigkeit.
Wann Sie Qwen4-Max wählen
- Managed Service bevorzugt: Sie möchten keinen Inferenz-Cluster betreiben und brauchen nur eine stabile API;
- Bild und Video: Screenshot-Verständnis, Diagramm-Analyse und Videoanalyse sind die wichtigsten Eingaben;
- Lieferung langlaufender Aufgaben: Berichtserstellung, Business-Process-Agenten, fachliche Q&A in Medizin und Biologie;
- Kostensensibel pro Token: Bei gut kontrolliertem effort sind die Kosten pro Million Token am niedrigsten.
Entscheidungsempfehlung: Qwen4-Max vs. Kimi K3.1 Pro
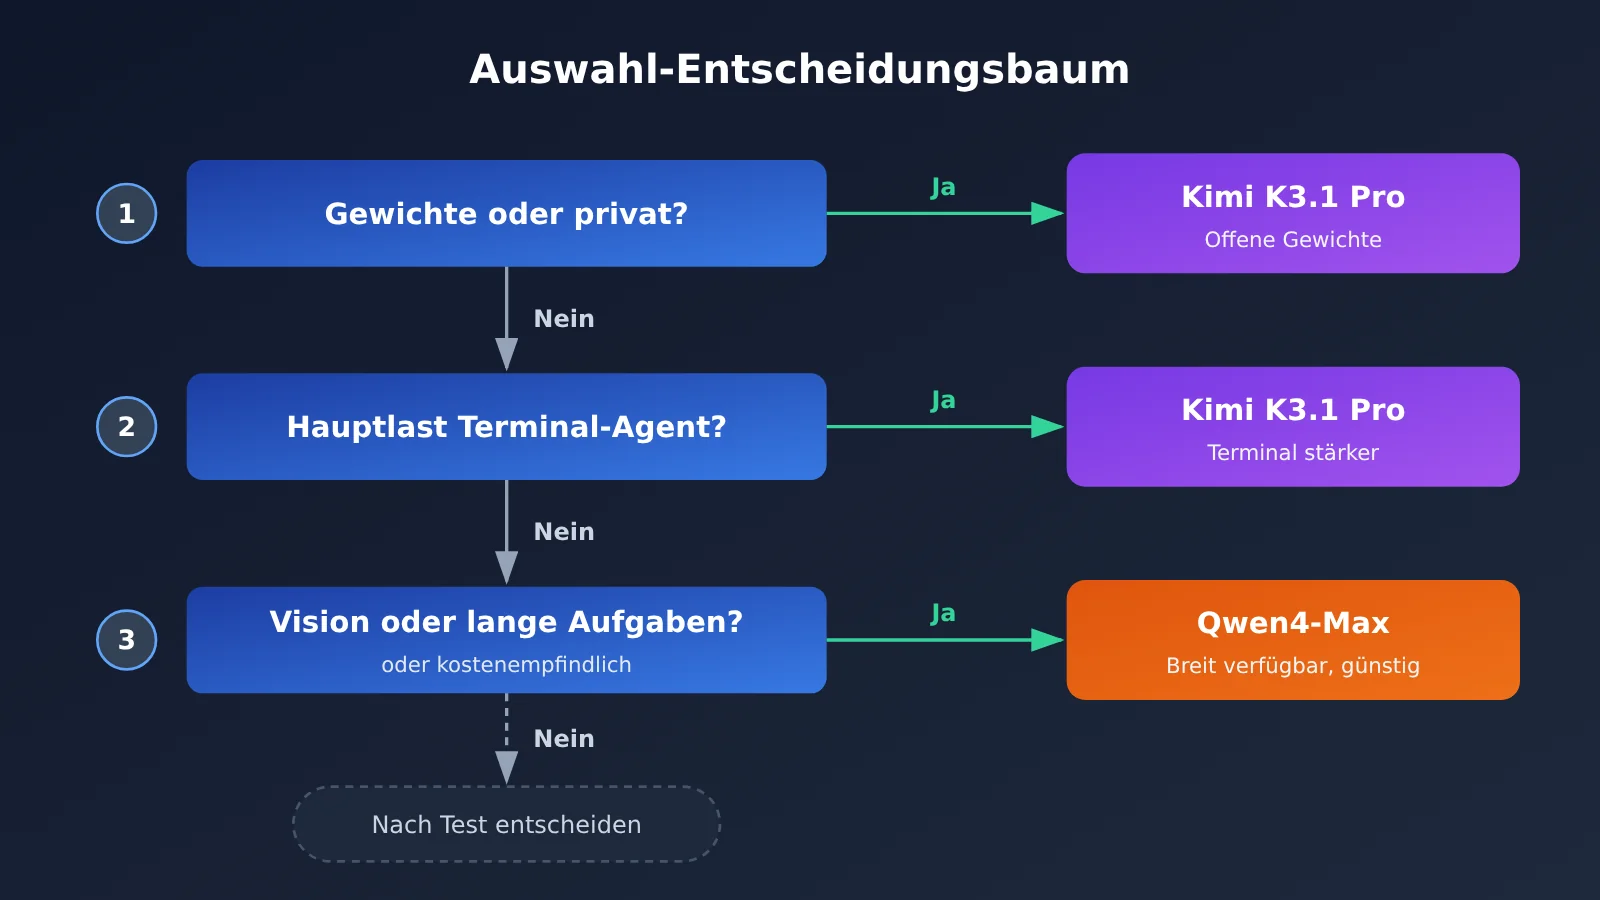
Fünf Dimensionen lassen sich auf drei Fragen verdichten: Erstens, müssen Sie unbedingt die Gewichte bekommen? Wenn ja, wählen Sie direkt Kimi K3.1 Pro. Zweitens, besteht Ihre Hauptlast aus Terminal-Kommandozeilen-Agenten? Wenn ja, ist Kimi stabiler. Drittens, trifft beides nicht zu – dann hat Qwen4-Max bei Vision, der Abwicklung langer Aufgaben und beim Stückpreis die Nase vorn.
Auch der gemischte Einsatz ist gängige Praxis: Kimi K3.1 Pro übernimmt die Terminal-Ausführung, die Qwen-Serie kümmert sich um Bildverständnis und Berichtserstellung. Eine solche Orchestrierung verlangt, dass beide Modelle über dieselbe Schnittstelle laufen – ein einheitliches Gateway spart eine Menge Anpassungsarbeit.
💡 Auswahlhinweis: Die Auswahl hängt letztlich von der Verteilung Ihrer Aufgaben ab. Wir empfehlen, auf APIYI apiyi.com einen Vergleich mit echten Aufgaben durchzuführen, mit derselben base_url die Erfolgsquote und den Token-Verbrauch beider Seiten zu protokollieren und danach das Hauptmodell zu bestimmen.
Häufig gestellte Fragen (FAQ)
F1: Worin liegt der größte Unterschied zwischen Qwen4-Max und Kimi K3.1 Pro?
Kimi K3.1 Pro ist ein Modell mit offenen Gewichten der 3T-Klasse, das Sie selbst deployen und fine-tunen können; Qwen4-Max wird als gehostete API angeboten, bringt native Vision mit und hat einen niedrigeren Listenpreis. Ersteres ist stark bei Terminal-Aufgaben, Letzteres bei Vision und der Abwicklung langer Aufgaben.
F2: Liegt der Terminal-Bench von Kimi K3.1 Pro nun bei 65.7 oder bei 67.2?
Beide Werte stimmen, messen aber unterschiedliche Grundlagen. Die 65.7 % stammen aus der offiziellen Dokumentation von Moonshot, die 67.2 aus der im selben Diagramm veröffentlichten Selbstauskunft von Qwen – der Unterschied ergibt sich aus Harness, Effort und der Version des Aufgabensets. Beim Zitieren muss die Quelle angegeben werden; Werte dürfen weder vermischt noch aus verschiedenen Dokumenten zu einem Ranking zusammengesetzt werden.
F3: Ist die Kontextlänge bei beiden gleich?
Im Wesentlichen ja. Kimi K3.1 Pro bietet 1.048.576 Token, Qwen4-Max 1M. Qwen4-Max veröffentlicht zusätzlich eine maximale Ausgabe von 393K und eine maximale Gedankenkette von 262K, was bei einer einzelnen langen Ausgabe von Vorteil ist.
F4: Warum ist Qwen4-Max pro Einheit günstiger, auf der Arena aber pro Aufgabe teurer?
Im Arena-Snapshot läuft Qwen4-Max auf der Stufe xHigh, wodurch viele Chain-of-Thought-Tokens verbraucht werden – die Kosten pro Aufgabe liegen bei 4,18 $, während Kimi K3.1 Pro (Max) bei 0,89 $ liegt. Die tatsächlichen Kosten ergeben sich aus Stückpreis × Tokenverbrauch; erst mit einem niedrigeren `reasoning_effort` kommt der Preisvorteil wirklich zum Tragen.
F5: Kann man Qwen4-Max inzwischen über APIYI aufrufen?
`qwen4-max` ist noch nicht gelistet, wir nehmen es aber so schnell wie möglich auf. Derzeit lassen sich über APIYI auf apiyi.com `kimi-k3.1-pro`, `kimi-k3.1-pro-highspeed` und `qwen3.8-max` aufrufen; die base_url lautet `https://api.apiyi.com/v1`. Modellbezeichnungen und Preise entnehmen Sie bitte der Modellliste der Plattform.
F6: Welche bekannten Schwächen haben beide Modelle?
Qwen4-Max liegt bei Terminal-Aufgaben deutlich zurück (im eigenen Diagramm von Alibaba 48.5 gegenüber 67.2), der Arena-Rang ist weiterhin Preliminary, und der standardmäßig hohe Effort kann die Kosten pro Aufgabe in die Höhe treiben. Kimi K3.1 Pro verlangt mehr als das Doppelte des Qwen4-Ausgabepreises und liegt bei Vision, Video und den meisten Kennzahlen zur Branchenabwicklung zurück.
Qwen4-Max im Vergleich zu Kimi K3.1 Pro – die wichtigsten Kernpunkte (Key Takeaways)
- Gewichte als harte Trennlinie: Wer feinabstimmen oder privat betreiben will, hat nur bei Kimi K3.1 Pro eine Wahl.
- Terminal-Aufgaben: Kimi ist stark: Im Vergleichsdiagramm von Alibaba liegt Kimi 18,7 Punkte vor Qwen4-Max.
- Bei Benchmarks zählt die Messmethodik: 65,7 und 67,2 stammen aus unterschiedlichen Harnesses und dürfen nicht vermischt werden.
- Auslieferung und Vision: Qwen4 ist stark: Bei JobBench, APEX-Agents, Video-Index und mehreren anderen liegt es vorn.
- Stückpreis: Qwen4 ist günstiger: Der Output-Preis beträgt nur 45 % von Kimi, aber der Effort muss kontrolliert werden.
- So legst du los: Bei APIYI mit demselben Key zwischen
kimi-k3.1-pround der Qwen-Serie wechseln, um zu vergleichen.
Fazit
Die wichtigsten Ergebnisse aus dem Vergleich von Qwen4-Max mit Kimi K3.1 Pro:
- Lässt sich das Modell überhaupt verändern? Offene Gewichte sind der exklusive Vorteil von Kimi K3.1 Pro;
- Terminal und Auslieferung: Kimi ist stark bei Command-Line-Agenten, Qwen4-Max stark bei der Abwicklung langer Aufgaben, bei Vision und Video;
- Kosten: Qwen4-Max ist pro Million Token am günstigsten, aber die tatsächliche Rechnung hängt vom Token-Verbrauch ab, den der Effort verursacht.
Benchmark-Werte können dir nur die Richtung zeigen – die endgültige Antwort findest du nur mit deinen eigenen Aufgaben. Empfohlen: Führe über APIYI (apiyi.com) mit einer einheitlichen Schnittstelle einen kleinen Vergleichslauf mit geringem Traffic durch. Sobald qwen4-max verfügbar ist, kannst du das Modell nahtlos austauschen und weiter verifizieren.
📚 Referenzen
- Offizieller Qwen4-Max-Blog: Modellspezifikationen, Kontext und QwenCloud-Preise
- Link:
qwen.ai/blog?id=qwen4-max -
Beschreibung: Enthält die von Qwen selbst angegebenen Vergleichsdaten in derselben Grafik
-
Kimi K3.1 Pro Schnellstart: Offizielle Moonshot-Dokumentation
- Link:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md -
Beschreibung: Enthält die offiziell angegebenen Ergebnisse für Terminal-Bench 4.0 und Kimi Code Bench 3.0
-
Preise für Kimi-Chat-Modelle: Offizielle Preisseite von Moonshot
- Link:
platform.kimi.ai/docs/pricing/chat.md -
Beschreibung: Abrechnungsregeln für die Standardversion, die Highspeed-Version und Batch
-
Arena Code Arena WebDev: Snapshot der öffentlichen Rangliste, 14.11.2026
- Link:
arena.ai - Beschreibung: Ranking aus Abstimmungen Dritter und Kosten pro Aufgabe
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Unterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com