Anmerkung des Autors: Qwen4-Max befindet sich noch in der Vorschau. Es gibt weder öffentliche Benchmark-Ergebnisse noch Angaben zur Kontextlänge oder zum Preis pro Token. In diesen drei Punkten lässt sich Qwen4-Max also nicht sinnvoll mit Qwen3.8-Max vergleichen. Per Modellaufruf nutzen lässt sich derzeit weiterhin nur qwen3.8-max.
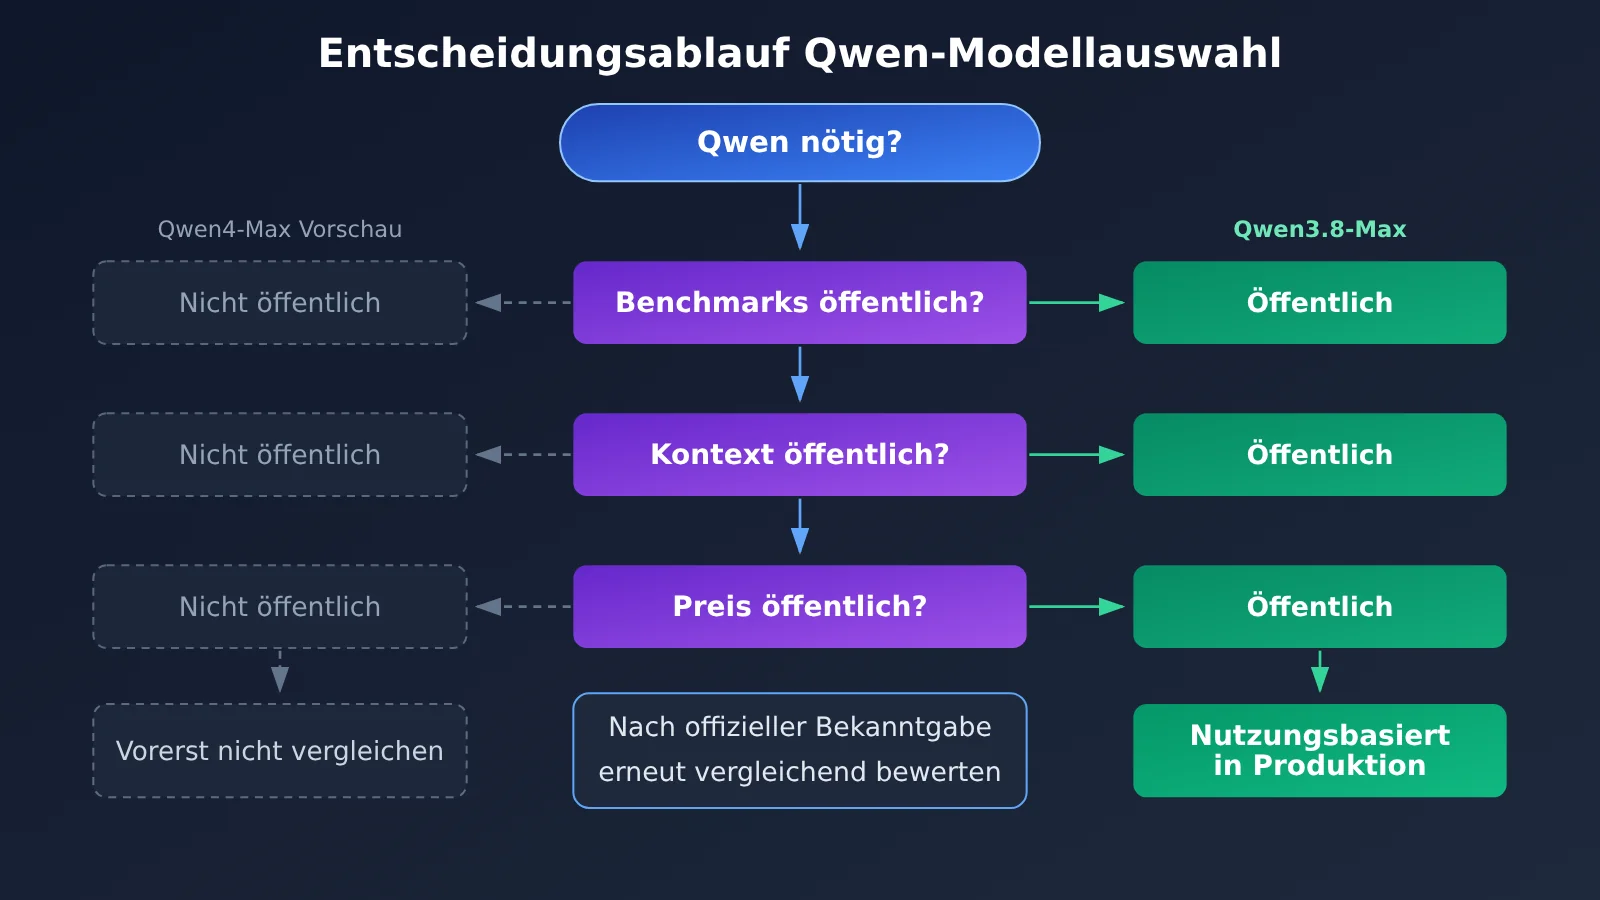
Kaum ist die Vorschau von Qwen4-Max draußen, fragen Entwicklerinnen und Entwickler, die bereits mit Qwen arbeiten, zuerst: Sollen wir wechseln? Wie viel stärker ist es als Qwen3.8-Max? Und wie viel teurer? Darauf gibt es derzeit keine belastbare, vergleichbare Antwort, weil in der Vorschauphase drei öffentliche Angaben fehlen, die für einen Vergleich nötig wären.
Das ist kein Schlechtreden von Qwen4-Max. Wir bewerten nicht, wie leistungsfähig das Modell ist, sondern halten nur einen Sachverhalt fest: Stand 12.11.2026 gibt es für die Qwen4-Max-Vorschau weder öffentliche Benchmark-Ergebnisse noch eine bekannte Kontextlänge oder einen Preis pro Token. Qwen3.8-Max dagegen ist bereits veröffentlicht und lässt sich nach Verbrauch abrechnen. Laut der Modellliste von APIYI (apiyi.com) vom 12.11.2026 können Sie derzeit direkt qwen3.8-max anbinden.
Kernnutzen: In 3 Minuten wissen Sie, welche Punkte sich zwischen der Qwen4-Max-Vorschau und Qwen3.8-Max aktuell nicht vergleichen lassen und wie Sie Ihre laufenden Projekte planen, bis offizielle Informationen vorliegen.
Qwen4-Max und Qwen3.8 im Überblick
Zunächst stellen wir zusammen, was sich für beide Modelle aktuell belegen lässt. Die Tabelle enthält nur Angaben, die durch Quellen gedeckt sind. Was nicht öffentlich ist, steht als „nicht veröffentlicht“ da, ohne Spekulation.
| Informationspunkt | Qwen4-Max (Vorschau) | Qwen3.8-Max |
|---|---|---|
| Veröffentlichungsstatus | Vorschauphase | Veröffentlichtes Modell |
| Öffentliche Benchmarks | Nicht veröffentlicht | Veröffentlichtes Modell, offizielle Unterlagen einsehbar |
| Kontextlänge | Nicht veröffentlicht | Maßgeblich sind die offizielle Dokumentation und die Modellbeschreibung |
| Preis pro Token | Nicht veröffentlicht | Eingabe $1.65 / Ausgabe $4.95 / Cache-Lesen $0.20625 (pro 1M Tokens) |
| Abrechnung nach Verbrauch | In der Modellliste vom 12.11.2026 noch nicht enthalten | Aufrufbar, Modell-ID qwen3.8-max |
| Verfügbare Plattformen | Maßgeblich sind spätere offizielle Ankündigungen | APIYI und weitere Plattformen |
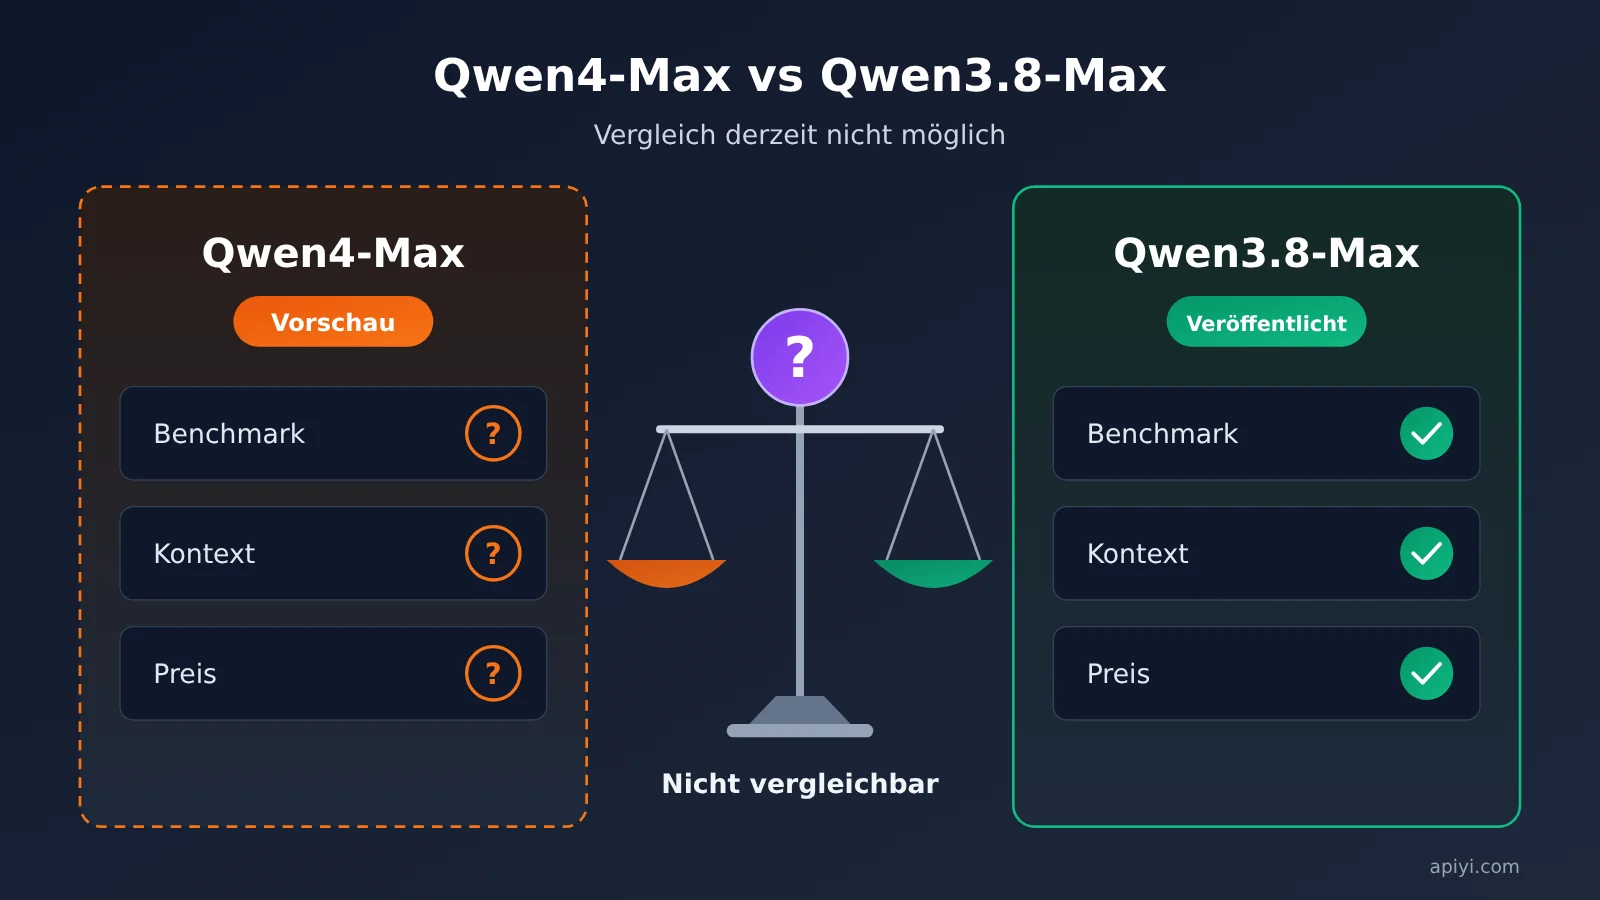
In der Tabelle steht dreimal „nicht veröffentlicht“: bei Benchmarks, Kontextlänge und Preis. Genau diese drei Punkte sind die gängigsten Vergleichsdimensionen bei der Modellauswahl. Fehlt auch nur einer davon, fehlt dem direkten Vergleich die Grundlage. Über die Öffnung der Vorschau wurde bereits berichtet. Dieser Artikel behandelt nur die Frage, warum sich diese drei Punkte nicht einfach „schätzen“ lassen.
Was die drei fehlenden Angaben in der Qwen4-Max-Vorschau jeweils beeinflussen
Benchmarks bestimmen die Einschätzung der Leistungsfähigkeit. Ohne offiziell veröffentlichte Benchmark-Ergebnisse gibt es keinen einheitlichen Maßstab, um Qwen4-Max bei Reasoning, Code oder langen Texten gegenüber Qwen3.8-Max einzuordnen. Vereinzelte Screenshots aus der Community oder persönliche Eindrücke aus Gesprächen sind kein Ersatz: Testsets, Eingabeaufforderungen und Sampling-Parameter unterscheiden sich jeweils, die Ergebnisse sind nicht vergleichbar.
Die Kontextlänge bestimmt das Architekturdesign. Die Chunk-Größe bei RAG, die Kürzungsstrategie für den Gesprächsverlauf und die Frage, ob lange Dokumente in einem Durchgang oder abschnittsweise verarbeitet werden, hängen alle von einer festen Obergrenze des Kontextfensters ab. Solange diese Zahl offen ist, lässt sich nicht beurteilen, ob nach einer Migration die vorhandene Segmentierungslogik entfallen kann, und auch nicht, ob Fehler durch überlange Eingaben auftreten.
Der Preis pro Token bestimmt das Kostenmodell. Budget, Preisgestaltung und Rate-Limiting-Strategie bauen auf dem Einzelpreis auf. Dass sich die Vorschau ausprobieren lässt, heißt noch nicht, dass es einen Preis gibt, den man in die Kostenrechnung übernehmen kann. Ein noch unbestimmter Preis lässt sich nicht sinnvoll mit dem aktuellen Preis von qwen3.8-max vergleichen.
Preise und Anbindung: So rufen Sie Qwen3.8-Max jetzt nutzungsbasiert auf
Die Voraussetzungen für einen Vergleich sind noch nicht gegeben. Deshalb orientieren sich laufende Projekte am bereits veröffentlichten Modell. Die folgende Tabelle zeigt die Preise von qwen3.8-max laut Modellliste vom 12.11.2026, jeweils pro 1M Tokens.
| Abrechnungsposten | Preis (pro 1M Tokens) | Hinweis |
|---|---|---|
| Eingabe | $1,65 | Teil der Eingabeaufforderung, der nicht im Cache getroffen wurde |
| Ausgabe | $4,95 | Vom Modell generierter Inhalt, dreifacher Preis der Eingabe |
| Cache-Lesezugriff | $0,20625 | Eingabeteil mit Cache-Treffer, 1/8 des Eingabepreises |
Strukturell kostet die Ausgabe das Dreifache der Eingabe, und ein Cache-Lesezugriff nur 12,5 % davon. Die beiden direktesten Stellschrauben, um die Kosten von qwen3.8-max zu senken, sind daher eine begrenzte Ausgabelänge und eine höhere Cache-Trefferquote. Besonders stark profitieren Sie vom Cache, wenn die Systemeingabeaufforderung lang ist oder das Präfix in mehrstufigen Dialogen stabil bleibt.
Beispielrechnung: Kosten mit Qwen3.8-Max
Mit den oben genannten Preisen lassen sich die Kosten einiger typischer Anfragen berechnen. Alle Zahlen ergeben sich direkt aus den öffentlichen Preisen, sodass Sie sie leicht auf Ihr eigenes Anfragevolumen übertragen können.
| Szenario | Eingabe-Tokens | Davon Cache-Treffer | Ausgabe-Tokens | Kosten pro Anfrage |
|---|---|---|---|---|
| Einzelne Standardanfrage | 10.000 | 0 | 2.000 | $0,0264 |
| Gleiche Anfrage, Präfix-Cache getroffen | 10.000 | 8.000 | 2.000 | $0,01485 |
| Batch-Verarbeitung mit 1M Eingabe | 1.000.000 | 0 | 200.000 | $2,64 |
Die zweite Zeile hat dieselbe Gesamtmenge an Ein- und Ausgabe wie die erste. Allein weil 8.000 Eingabe-Tokens im Cache getroffen werden, sinken die Kosten pro Anfrage von $0,0264 auf rund $0,0149, also um mehr als 40 %. Eine solche Berechnung ist mit der Qwen4-Max-Vorschau derzeit nicht möglich, weil ihr Preis noch nicht veröffentlicht wurde.
So binden Sie qwen3.8-max an
APIYI bietet eine OpenAI-kompatible Schnittstelle. Sie können sie direkt mit dem OpenAI-SDK oder jedem kompatiblen Client nutzen und müssen nur drei Parameter ändern:
base_url:https://api.apiyi.com/v1(einheitliche APIYI-Schnittstelle)api_key: der in der APIYI-Konsole erstellte API-Schlüsselmodel:qwen3.8-max
Der Aufruf entspricht den Chat Completions: Das messages-Array ordnen Sie einfach in der Reihenfolge der Rollen system, user und assistant an. Wenn Ihr Projekt bisher auf einen OpenAI-kompatiblen Endpunkt zugreift, genügt es meist, base_url und Modell-ID auszutauschen. Am Anwendungscode müssen Sie nichts ändern.
🚀 Schnellstart: Wenn Sie sich bei APIYI (apiyi.com) registrieren, erhalten Sie ein kostenloses Testguthaben. Lassen Sie zuerst Ihre eigenen Eingabeaufforderungen mit
qwen3.8-maxlaufen und notieren Sie die tatsächlichen Werte für Eingabe, Ausgabe und Cache-Trefferquote. Sobald Qwen4-Max offiziell verfügbar ist, haben Sie dann gleich Vergleichsdaten zur Hand.
Auswirkungen der Qwen4-Max-Vorschau auf bestehende Qwen-Projekte
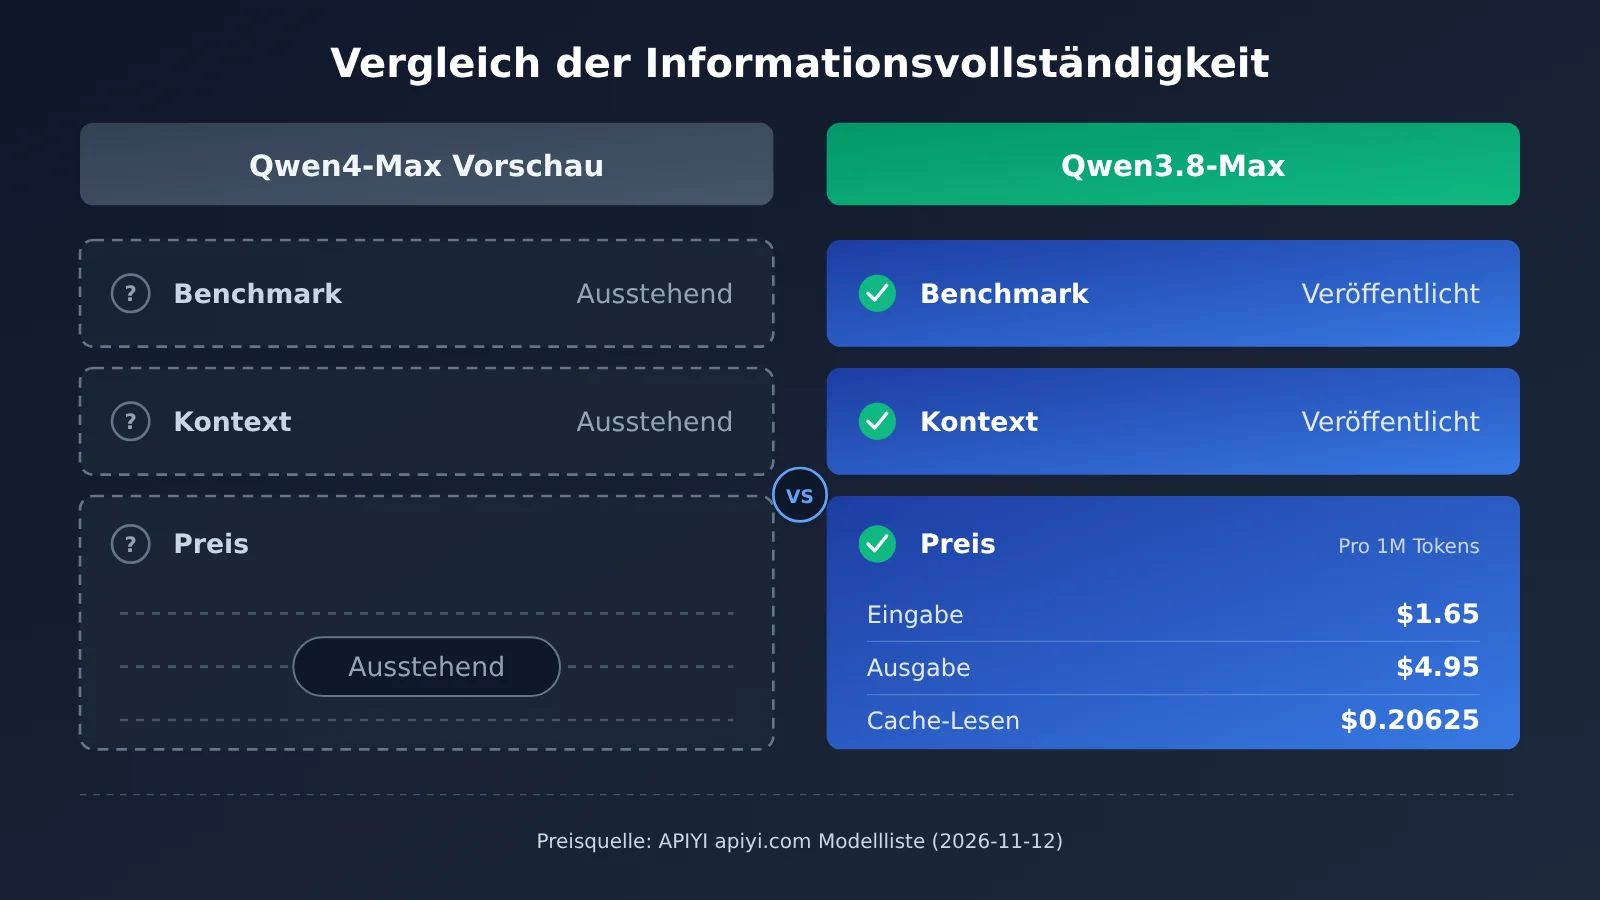
Die Abbildung stellt den Informationsstand beider Seiten nebeneinander: Auf der einen Seite drei offene Platzhalter, auf der anderen Seite Daten, die sich direkt nachschlagen lassen. In diesem Zustand fehlt jedem Vergleich die Grundlage – egal ob es um „wie viel stärker“ oder „wie viel teurer“ geht. Die Preisdaten können Sie in der Modellliste von APIYI apiyi.com nachprüfen.
Was das für Entwickler bedeutet, die Qwen nutzen
- Die Produktivumgebung bleibt unangetastet: Die Qwen4-Max-Vorschau ändert nichts an Verfügbarkeit und Preis von qwen3.8-max, bestehende Aufrufe laufen wie gewohnt weiter.
- Die Evaluierung lässt sich schon vorbereiten: Stellen Sie eine Reihe von Test-Eingabeaufforderungen zusammen, die Ihren Anwendungsfall abbilden, und legen Sie die Bewertungskriterien fest. Sobald die offiziellen Informationen vorliegen, können Sie beide Modelle direkt damit vergleichen.
- Die Kostenplanung bleibt bei qwen3.8-max: In der Vorschauphase gibt es keinen Preis, daher sollte Qwen4-Max weder in das Budget der nächsten Phase noch in Angebote einfließen.
- Umbauten rund um den Kontext zurückstellen: Solange die Kontextlänge von Qwen4-Max nicht bekannt ist, sollten Sie Ihre Chunking- oder Kürzungslogik nicht darauf anpassen.
Empfehlungen je nach Rolle
| Rolle | Was Sie jetzt tun können | Was erst nach offizieller Veröffentlichung ansteht |
|---|---|---|
| Anwendungsentwickler | Weiter qwen3.8-max nutzen, einen eigenen Evaluierungsdatensatz aufbauen |
Beide Modelle mit demselben Datensatz vergleichen |
| Architekturverantwortliche | Kontextstrategie an den tatsächlichen Grenzen von qwen3.8-max ausrichten | Anhand der Kontextlänge von Qwen4-Max prüfen, ob sich das Chunking vereinfachen lässt |
| Kostenverantwortliche | Budget mit Eingabe $1.65 und Ausgabe $4.95 pro 1M Tokens planen | Migrationskosten neu berechnen, sobald der Preis von Qwen4-Max feststeht |
| Produktmanager | Außenkommunikation weiter an den Fähigkeiten der veröffentlichten Modelle ausrichten | Anhand öffentlicher Benchmarks entscheiden, ob ein Upgrade beworben wird |
Was sich daraus für die Modellauswahl lernen lässt
Bei Vorschauversionen passiert am leichtesten ein Denkfehler: „Sieht neuer aus“ wird mit „ist schon besser“ gleichgesetzt. Ein sauberer Auswahlprozess braucht mindestens drei öffentlich verfügbare Grundlagen: Leistung (Benchmarks), Kapazität (Kontext) und Kosten (Preis). Solange nicht alle drei vorliegen, gehört ein neues Modell auf die Beobachtungsliste – aber nicht in den Produktivplan.
Wer Modellaufrufe über eine einheitliche Schnittstelle verwaltet, hat zudem einen Vorteil: Wenn Qwen4-Max irgendwann für die nutzungsbasierte Abrechnung freigegeben wird, genügt es, den model-Parameter zu ändern, um einen A/B-Vergleich zu fahren. Ein neues SDK müssen Sie dafür nicht anbinden.
💡 Empfehlung: Bis die drei zentralen Informationen zu Qwen4-Max veröffentlicht sind, empfiehlt es sich, qwen3.8-max als Hauptmodell im Produktivbetrieb zu nutzen. Wenn Sie es über die einheitliche Schnittstelle von APIYI apiyi.com anbinden, können Sie nach dem Start neuer Modelle im selben Code schnell wechseln und vergleichen.
Häufig gestellte Fragen (FAQ)
Q1: Lässt sich die Vorschau von Qwen4-Max schon mit Qwen3.8-Max vergleichen?
Bei Benchmark-Ergebnissen, Kontextlänge und Preis pro Token noch nicht. Qwen4-Max befindet sich weiterhin in der Vorschauphase, und zu allen drei Punkten gibt es keine öffentlichen Angaben – eine einheitliche Vergleichsbasis fehlt also. Sicher ist nur der Veröffentlichungsstatus: Qwen3.8-Max ist bereits erschienen und lässt sich nutzungsbasiert abrufen, Qwen4-Max ist noch in der Vorschau.
Q2: Hat Qwen4-Max Qwen3.8-Max bereits auf ganzer Linie übertroffen?
Derzeit gibt es keine öffentlichen Daten, die diese Aussage stützen. Eine höhere Versionsnummer bei einer neuen Modellgeneration bedeutet weder, dass das Modell bei allen Aufgaben stärker ist, noch dass der Preis besser passt. Ob und bei welchen Aufgaben Qwen4-Max vorne liegt, lässt sich erst beurteilen, wenn offizielle Benchmark-Ergebnisse vorliegen. Am besten prüfen Sie das zusätzlich mit Ihrem eigenen Evaluierungsdatensatz.
Q3: Was kostet der Aufruf von Qwen3.8-Max aktuell?
Laut Modellliste vom 12.11.2026 kostet qwen3.8-max pro 1 Mio. Tokens $1,65 für die Eingabe, $4,95 für die Ausgabe und $0,20625 für das Lesen aus dem Cache. Der Preis fürs Cache-Lesen beträgt nur 1/8 des Eingabepreises. Wenn das Präfix Ihrer Eingabeaufforderung stabil bleibt, lassen sich die Kosten dadurch spürbar senken.
Q4: Wie rufe ich Qwen3.8-Max schnell per API auf?
Empfehlenswert ist eine API-Aggregationsplattform, die mehrere Modelle unterstützt:
1. Besuchen Sie APIYI (apiyi.com), registrieren Sie ein Konto und holen Sie sich Ihren API-Schlüssel samt kostenlosem Testkontingent
2. Setzen Sie die base_url auf `https://api.apiyi.com/v1`
3. Tragen Sie als Modell-ID `qwen3.8-max` ein und rufen Sie das Modell im OpenAI-kompatiblen Chat-Completions-Format auf
Q5: Ist die Migration teuer, sobald Qwen4-Max offiziell verfügbar ist?
Der Migrationsaufwand auf Schnittstellenebene hängt davon ab, wie Sie das Modell anbinden. Wenn Sie alles über eine OpenAI-kompatible Schnittstelle verwalten, genügt in der Regel der Austausch der Modell-ID. Wirklich bewerten müssen Sie die Unterschiede bei Qualität und Kosten. Sinnvoll ist es, schon jetzt auf APIYI (apiyi.com) mit qwen3.8-max Evaluierungsdaten zu sammeln, um später direkt vergleichen zu können.
Q6: Welche Einschränkungen gelten in der Vorschauphase?
In der Vorschauphase können sich alle wichtigen Parameter noch ändern. Ohne veröffentlichte Benchmarks lassen sich die Leistungsgrenzen nicht einschätzen. Ohne bekannte Kontextlänge kann man Lösungen für lange Texte nicht festlegen, und ohne bekannten Preis lässt sich das Modell nicht im Budget einplanen. Deshalb raten wir davon ab, Vorschaumodelle im produktiven Betrieb einzusetzen, wenn Stabilität und Kosten eine Rolle spielen.
Qwen4-Max und Qwen3.8 – die wichtigsten Punkte (Key Takeaways)
- Unterschiedlicher Release-Status: Qwen4-Max ist weiterhin nur eine Vorschau, Qwen3.8-Max dagegen ist veröffentlicht und lässt sich nutzungsbasiert abrufen.
- Drei Punkte lassen sich nicht direkt vergleichen: Für Qwen4-Max sind weder Benchmark-Ergebnisse noch die Länge des Kontextfensters noch der Preis pro Token öffentlich.
- Keine voreiligen Schlüsse: Ohne öffentliche Daten lässt sich nicht behaupten, dass Qwen4-Max Qwen3.8-Max in allen Bereichen übertrifft.
- Aktuelle Preise sind einsehbar: qwen3.8-max kostet pro 1M Tokens $1,65 für die Eingabe, $4,95 für die Ausgabe und $0,20625 für Cache-Lesezugriffe.
- Caching ist der Schlüssel zur Kostensenkung: Der Preis für Cache-Lesezugriffe beträgt nur 1/8 des Eingabepreises, was sich vor allem bei Szenarien mit stabilem Präfix deutlich auszahlt.
- Für die Produktion gilt qwen3.8-max: Der Zugang läuft über die einheitliche Schnittstelle von APIYI. Wenn Sie später das Modell wechseln, ändern Sie nur die Modell-ID.
Fazit
So lässt sich das Verhältnis zwischen der Qwen4-Max-Vorschau und Qwen3.8-Max zusammenfassen:
- Die Voraussetzungen für einen Vergleich fehlen noch: Für die Qwen4-Max-Vorschau gibt es keine öffentlichen Benchmark-Werte, keine Angabe zur Kontextlänge und keinen Preis pro Token. In allen drei Punkten ist ein direkter Vergleich mit Qwen3.8-Max nicht möglich.
- Aktuell nutzbar ist qwen3.8-max: Die Preise sind klar benannt: $1,65 für die Eingabe, $4,95 für die Ausgabe und $0,20625 für Cache-Lesezugriffe (jeweils pro 1M Tokens).
- Jetzt vorbereiten, nach der offiziellen Veröffentlichung vergleichen: Bauen Sie zunächst einen eigenen Evaluierungsdatensatz für Ihre Anwendungsfälle auf und sammeln Sie Kostendaten. Eine Migrationsentscheidung treffen Sie erst, wenn alle Informationen vorliegen.
Bis die offiziellen Informationen zu Qwen4-Max veröffentlicht sind, ist es am sinnvollsten, Ihre Anwendungen weiterhin auf qwen3.8-max laufen zu lassen und parallel Evaluierung und Kostenbasis vorzubereiten. Wir empfehlen, qwen3.8-max über APIYI (apiyi.com) einzubinden. Die Plattform bietet eine OpenAI-kompatible, einheitliche Schnittstelle und ein kostenloses Testkontingent. Sobald neue Modelle verfügbar sind, können Sie sie mit demselben Code direkt vergleichen.
📚 Referenzen
- APIYI Modell- und Preisliste: Abgleich der abrufbaren Modelle (Stand: 12.11.2026)
- Link:
api.apiyi.com/api/pricing -
Hinweis: Dient dazu, die aktuell nutzungsbasiert abrufbaren Qwen-Modelle zu bestätigen
-
APIYI Moddelldokumentation: Abrechnungsinformationen zu qwen3.8-max
- Link:
docs.apiyi.com/models - Hinweis: Enthält die Einzelpreise von qwen3.8-max für Eingabe, Ausgabe und Cache-Lesezugriffe
Autor: APIYI Technikteam
Fachaustausch: Schreiben Sie uns gern über die Startseite von APIYI. Weitere Informationen zur Anbindung von Modellen finden Sie im APIYI-Dokumentationszentrum.