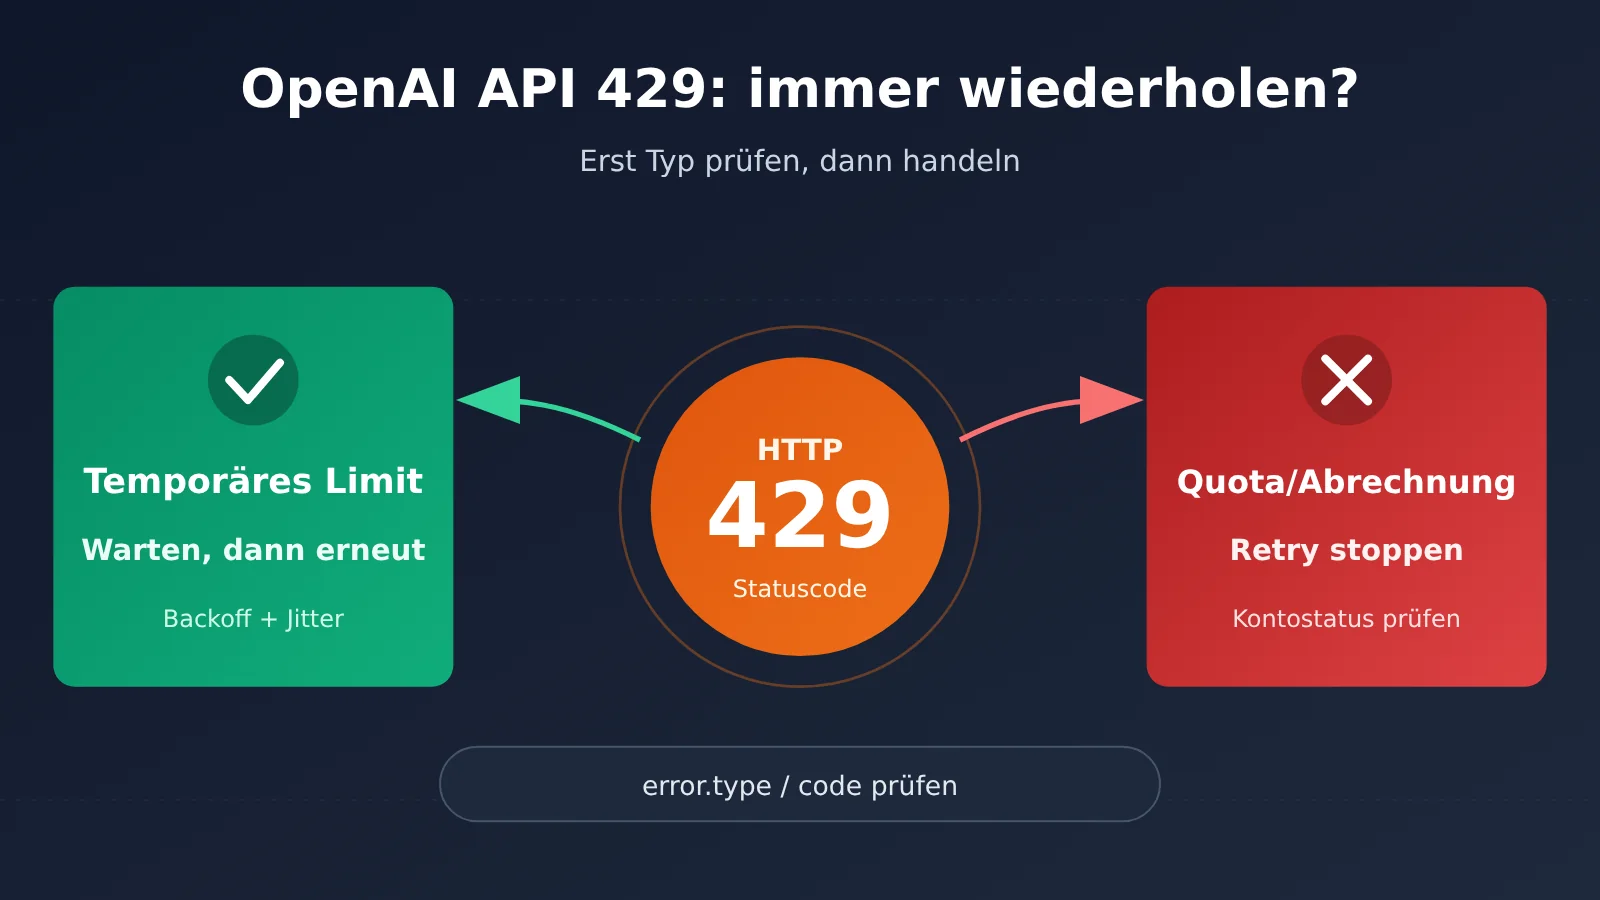
Nicht einfach immer wieder versuchen. Ein 429 von der OpenAI API bedeutet nicht „kurz warten, dann geht es schon“. Nur eine vorübergehende Ratenbegrenzung eignet sich für einen erneuten Versuch nach einer Wartezeit. Ist das Kontingent erschöpft, liegt eine Abrechnungsanomalie vor oder greift eine Nutzungsbeschränkung auf Organisationsebene, hilft auch wiederholtes Retrying nicht – es verstopft nur die Warteschlange.
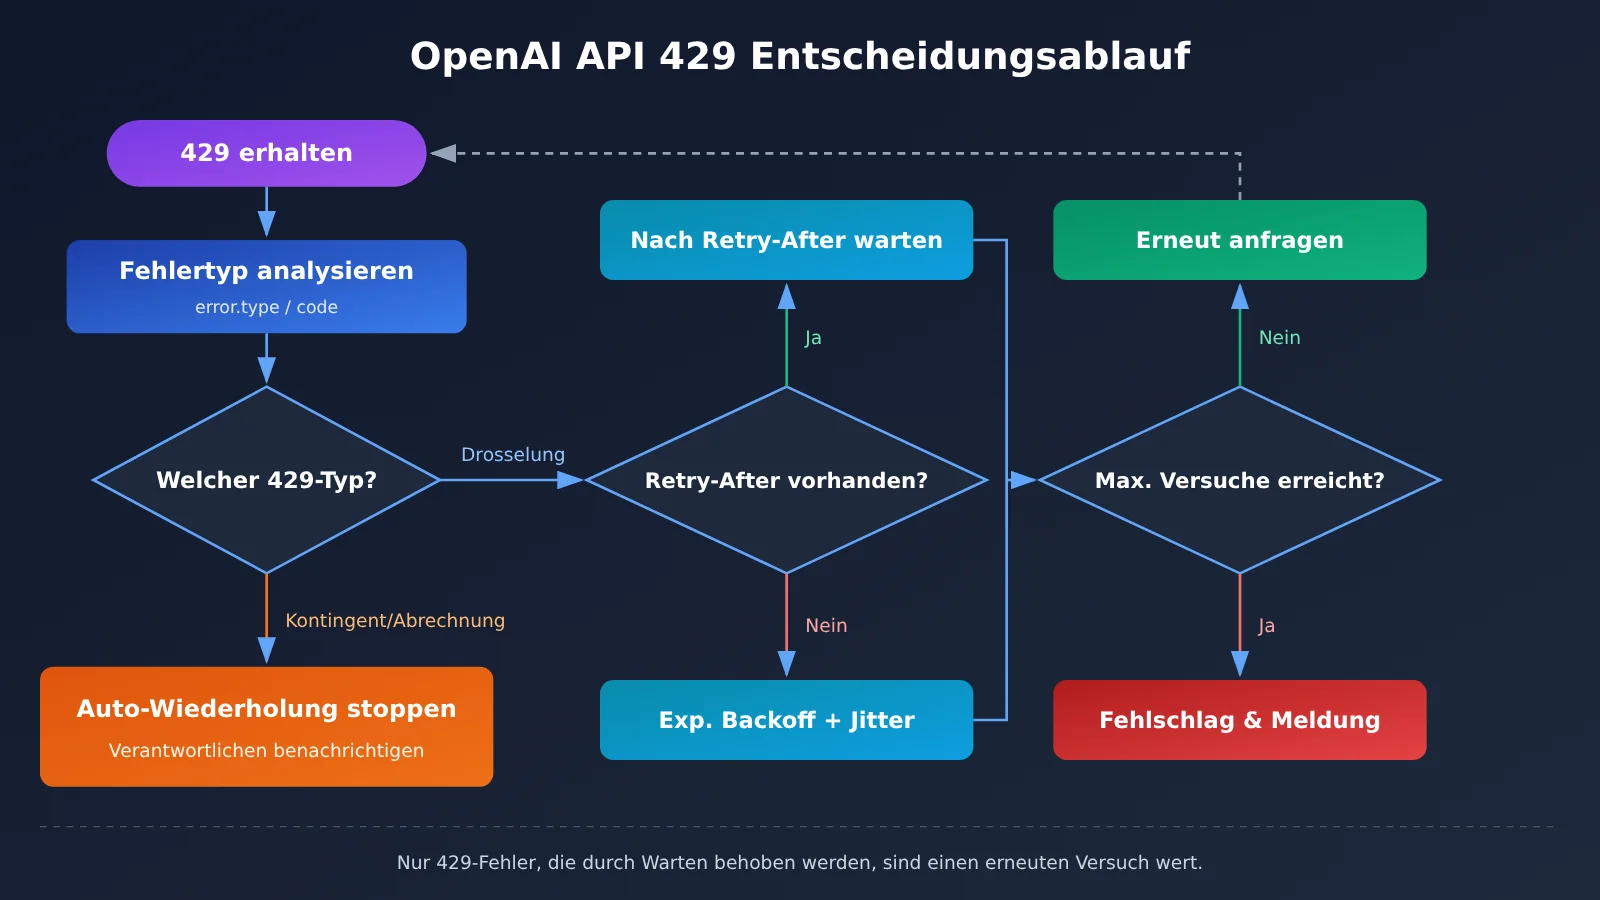
Richtig ist, zuerst die Fehlermeldung, error.type und – falls vorhanden – error.code anzusehen und zu bestimmen, um welche Art von 429 es sich handelt. Bei einer temporären Drosselung gilt: Ist ein gültiger Retry-After-Wert vorhanden, wartet man entsprechend; andernfalls verwendet man exponentielles Backoff mit zufälligem Jitter und setzt eine Obergrenze für die Anzahl der Versuche.
Was Sie nach dem Lesen dieses Artikels wissen
- In welche mindestens drei Kategorien sich 429-Antworten der OpenAI API einteilen lassen und wie man jeweils damit umgeht.
- In welchem Verhältnis
Retry-After, exponentielles Backoff und zufälliger Jitter zueinander stehen und wann man was einsetzt. - Warum sich 429-Fehler verstärken, wenn automatische Wiederholungen des offiziellen SDK, Aufgabenwarteschlangen und ein manueller „Erneut versuchen“-Button zusammenwirken.
- Wie sich Engpässe bei der Anzahl der Anfragen und Engpässe bei Tokens unterschiedlich beheben lassen – und was bei Fehlern mitten in Streaming-Anfragen zu beachten ist.
Inhaltsübersicht: Vor dem Hauptteil sorgen eine Begriffstabelle und eine Kurzübersicht zu den Auswirkungen dafür, dass die Terminologie einheitlich ist und Sie die für Sie relevanten Abschnitte finden. Der Abschnitt „Faktenlage“ fasst zusammen, wie die offizielle OpenAI-Dokumentation 429 beschreibt – einschließlich Fehlerklassifizierung, Wiederholungsregeln und SDK-Verhalten. Der Abschnitt „Analyse und Einschätzung“ behandelt die praktische Umsetzung: Strategien je nach Engpassart, das Design von Warteschlangen-Zuständen, die Fehlersuche bei sich überlagernden Wiederholungen und die semantischen Unterschiede, die beim Wechsel zu einem anderen Gateway zu beachten sind.
To Know: Zentrale Konzepte für das Verständnis von OpenAI API 429
| Konzept | Kurze Erklärung |
|---|---|
| HTTP 429 | Statuscode „Too Many Requests“. Die OpenAI API verwendet ihn sowohl für Ratenbegrenzungen als auch für Quota- oder Nutzungslimits. |
| Rate Limit | Obergrenze für die Anzahl der Anfragen in einem bestimmten Zeitraum. OpenAI zählt dabei Anfragen und Token-Menge getrennt. |
| RPM / TPM | Anfragen pro Minute und Tokens pro Minute. Wenn einer dieser beiden Werte das Limit erreicht, kann dies 429 auslösen. |
error.type / error.code |
Strukturierte Felder im Fehler-Response-Body. Sie unterscheiden die konkrete Ursache eines 429 und sind verlässlicher als der reine Statuscode. |
| Retry-After | Response-Header-Feld, das angibt, wie lange der Server dem Client empfiehlt zu warten, bevor er es erneut versucht. Ist der Wert gültig, sollte man ihn vorrangig befolgen. |
| Exponentielles Backoff (Exponential Backoff) | Nach jedem Fehlschlag steigt die Wartezeit multiplikativ an, zum Beispiel 1 Sekunde, 2 Sekunden, 4 Sekunden, mit einer Obergrenze. |
| Zufällige Streuung (Jitter) | Fügt der Backoff-Zeit einen zufälligen Anteil hinzu, damit nicht viele Clients gleichzeitig auf einen erneuten Versuch zusteuern. |
| Streaming-Ausgabe (Streaming) | Das Modell liefert Inhalte, während es sie erzeugt. Sobald die Ausgabe begonnen hat, lässt sich ein mitten in der Ausgabe auftretender Fehler nicht einfach durch eine vollständige Wiederholung ausgleichen. |
| Kumulierte Wiederholungen (Retry Overlap) | SDKs, Anwendungs-Queues und manuelle Eingriffe durch Nutzer lösen jeweils eigene Wiederholungen aus; dadurch vervielfacht sich die tatsächliche Anfragemenge. |
Auswirkungen im Überblick: Was OpenAI API 429 für verschiedene Rollen bedeutet
| Rolle | Hauptauswirkung | Worauf zu achten ist |
|---|---|---|
| Backend-Entwickler | Fehlerhafte Retry-Logik kann eine kurze Drosselung zu einem dauerhaften Ausfall machen | 429-Typen unterscheiden und Retries zentral in einer einzigen Schicht behandeln |
| Verantwortliche für Batch-Verarbeitung und Datenjobs | Große Batch-Aufgaben stoßen leicht gleichzeitig an die Limits für Anfragen und Tokens | Takt der Einreichung, Kontextgröße, Gestaltung des Warteschlangenstatus |
| Produkt und Frontend | Wenn Nutzer wiederholt auf „Erneut versuchen“ klicken, erzeugen sie weitere 429-Fehler | Nutzern den nächsten Versuchszeitpunkt nennen oder erklären, dass die Ursache im Konto liegt |
| Betrieb und Kontoverantwortliche | 429-Fehler wegen Kontingent oder Abrechnung lassen sich nicht durch Code selbst beheben | Accountstatus frühzeitig erkennen und bearbeiten, statt automatische Retries laufen zu lassen |
Faktenlage: Wie die offizielle OpenAI-Dokumentation 429 beschreibt
Dieser Abschnitt stützt sich auf die öffentlich gepflegten Fehlercode-Leitfäden von OpenAI, den Rate-Limit-Leitfaden und den 429-Artikel zur Fehlerbehebung im Help Center; Prüfdatum: 2026-11-17. Da es sich um fortlaufend aktualisierte Wartungsdokumente handelt, lässt sich nicht überprüfen, wann die betreffenden Inhalte erstmals veröffentlicht wurden. Deshalb wird dies nicht als tagesaktuelle Meldung behandelt, sondern als derzeit gültige Beschreibung der Regeln.
Die verschiedenen Ursachen für OpenAI API 429
Die offizielle Dokumentation vertritt im Kern die Position: Ein 429 ist nicht gleich ein 429 – die Bedeutung kann unterschiedlich sein, und man sollte die Fehlermeldung, error.type und, sofern vorhanden, error.code zur Beurteilung heranziehen. Temporäre Ratenbegrenzungen und Kontingent-, Abrechnungs- oder organisationsweite Nutzungslimits werden unterschiedlich behandelt.
Ersteres bedeutet „zu viele oder zu schnelle Anfragen im aktuellen Zeitfenster“ – nach einer Weile, wenn das Fenster zurückgesetzt wird, erholt es sich wieder. Letzteres betrifft den Zustand des Kontos selbst, zum Beispiel aufgebrauchtes Kontingent, Zahlungsprobleme oder nutzungsseitige Obergrenzen auf Organisationsebene. Solche Probleme verschwinden nicht von selbst mit der Zeit.
| 429-Typ | Typisches Signal | Lässt sich das Problem durch Warten lösen? | Empfohlene Maßnahme |
|---|---|---|---|
| Ratenbegrenzung der Anfragen | Fehlermeldung deutet auf eine Obergrenze der Anfragen hin, häufig code = rate_limit_exceeded |
In der Regel ja | Retry-After befolgen oder exponentielles Backoff mit Jitter verwenden |
| Ratenbegrenzung der Token-Menge | Fehlermeldung deutet auf eine Token-Obergrenze hin | In der Regel ja, aber leicht wiederholt auslösbar | Backoff und gleichzeitig die Token-Menge pro Anfrage reduzieren |
| Kontingent-/Abrechnungs-/Organisationslimit | Fehlermeldung deutet auf Kontingent oder Abrechnung hin, häufig code = insufficient_quota |
Nein | Automatische Wiederholungen stoppen und Verantwortliche über das Konto informieren |
Wichtig zu betonen: Der konkrete Wert von error.code sollte sich nach der tatsächlichen Antwort und der offiziellen Dokumentation richten. Die Codes in der Tabelle oben sind nur gängige Beispiele – im Code sollte man sich nicht ausschließlich auf hartcodierte Strings verlassen, sondern die Original-Fehlermeldung für die Log-Auswertung aufbewahren.
Anfragenzahl und Token-Menge können jeweils separat limitiert sein
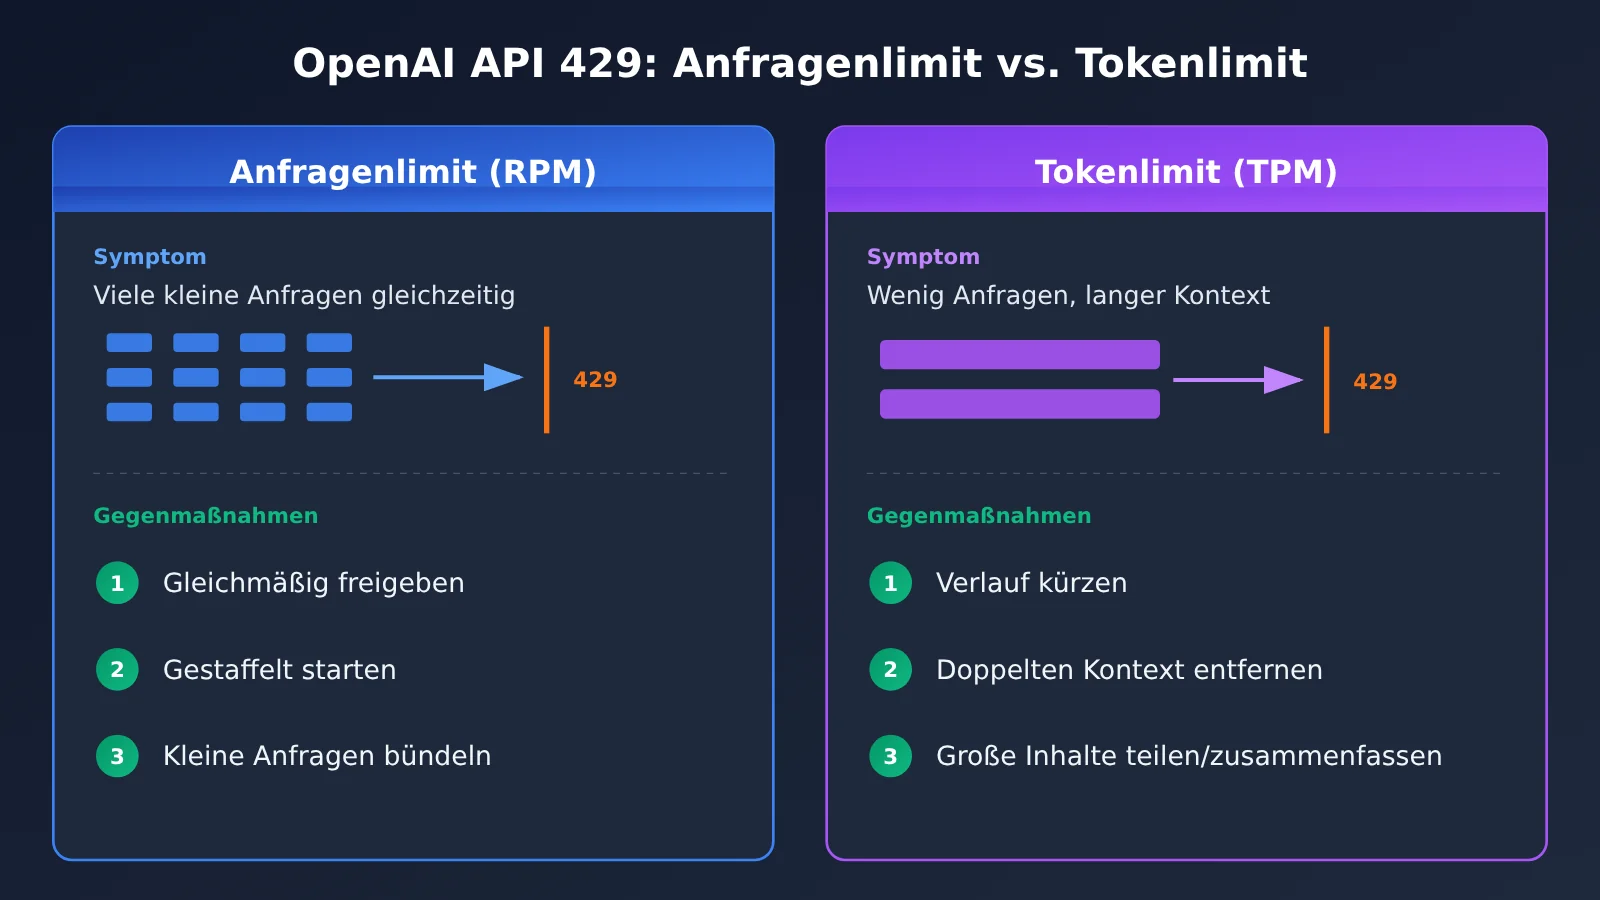
Der Leitfaden zu Ratenbegrenzungen erklärt, dass Limits aus mehreren Dimensionen gemessen werden. Am häufigsten begegnet man dabei der Anfragenzahl und der Token-Menge – beide gelten unabhängig voneinander. Das heißt: Selbst wenn man beim Anfragenlimit noch weit von der Obergrenze entfernt ist, kann man zuerst an die Token-Grenze stoßen, weil jede Anfrage einen sehr langen Kontext mitbringt. Umgekehrt kann auch eine große Zahl sehr kleiner Anfragen zuerst das Anfragenlimit ausschöpfen.
OpenAI stellt in den Antwort-Headern Informationen zur Ratenbegrenzung bereit, zum Beispiel die verbleibende Anfragenzahl, die verbleibende Token-Menge und die jeweilige Reset-Zeit. Diese Header-Felder helfen dabei, schon vor dem tatsächlichen Auslösen eines 429-Fehlers einzuschätzen, welchem Limit man näher ist.
Offiziell empfohlene Retry-Strategie für OpenAI API 429
Für temporäre Rate-Limits, bei denen ein erneuter Versuch sinnvoll ist, lassen sich die offiziellen Empfehlungen auf zwei Punkte verdichten:
- Wenn ein gültiger Retry-After-Wert vorliegt, diesem folgen. Das ist das unmittelbarste Signal des Servers und genauer, als wenn der Client selbst rät.
- Ohne Retry-After-Wert exponentielles Backoff mit zufälligem Jitter verwenden. Die Wartezeit steigt mit jedem Fehlversuch und wird um einen Zufallsanteil ergänzt, damit nicht alle Clients gleichzeitig erneut anfragen.
Beide Regeln setzen voraus, dass es sich bei dem 429 um eine Art Fehler handelt, der sich durch Warten lösen lässt. Geht es um ein Kontingent- oder Abrechnungsproblem, bringt selbst der ausgeklügeltste Backoff-Algorithmus nichts.
Automatisches Retry-Verhalten der offiziellen SDKs
Die offiziellen OpenAI-SDKs wiederholen Anfragen bei passenden Rate-Limit-Fehlern automatisch. Das genaue Verhalten hängt von der Client-Konfiguration ab. Beim Python-SDK lässt sich dies beispielsweise über den Parameter max_retries anpassen oder mit dem Wert 0 abschalten.
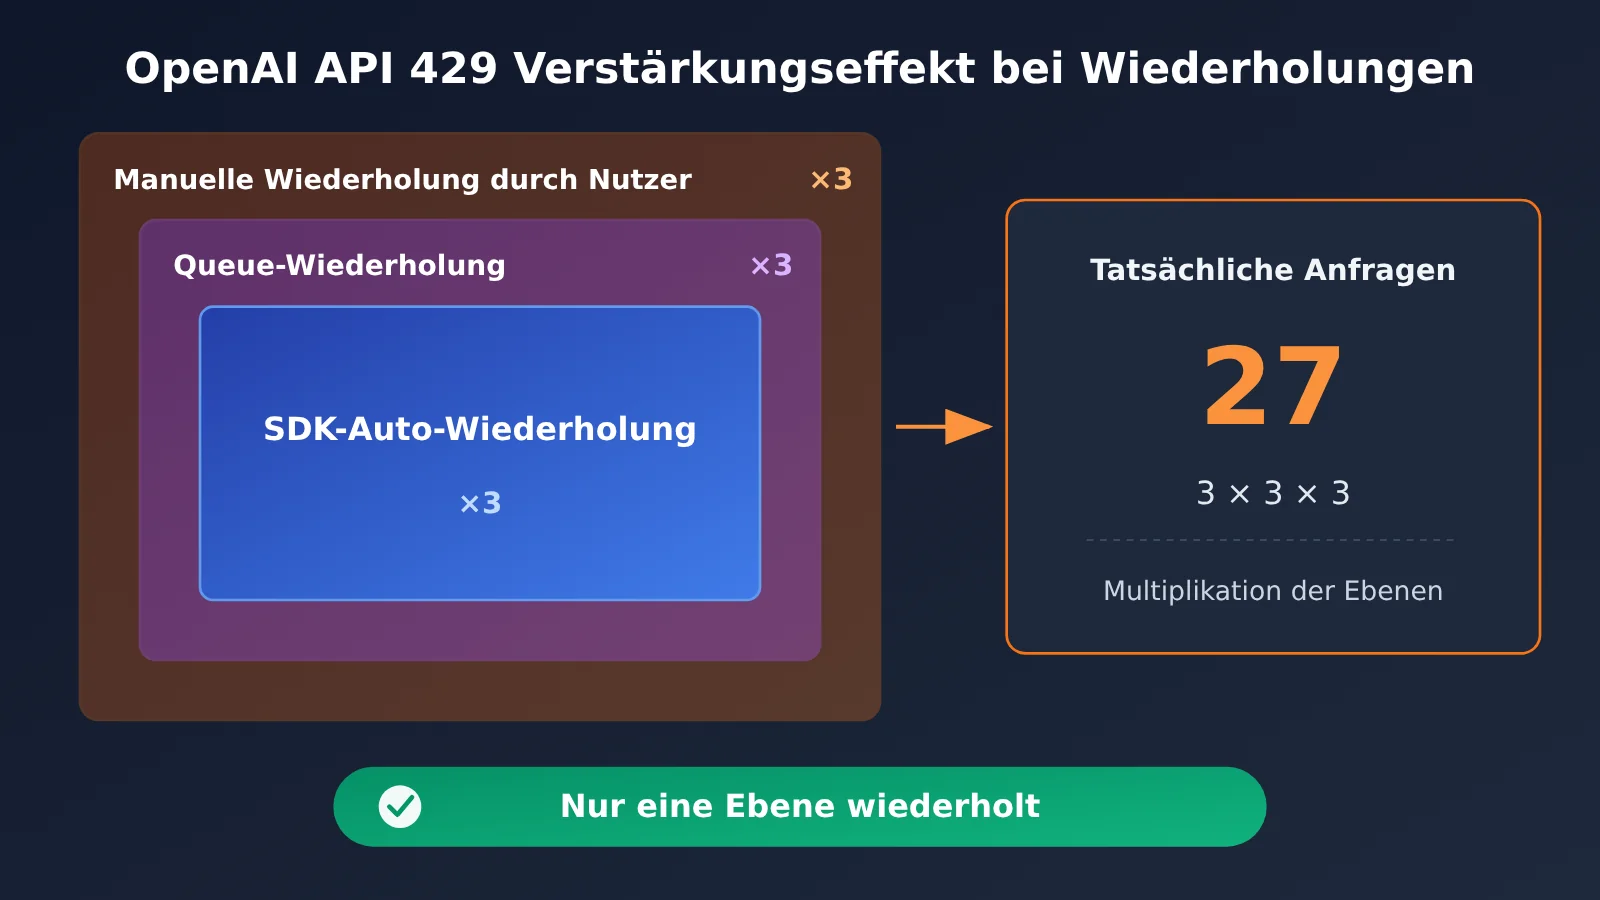
Das bedeutet: Selbst wenn im eigenen Anwendungscode keine einzige Retry-Logik steht, kann die Anfrage bereits mehrfach wiederholt worden sein. Legt die Anwendungsebene zusätzlich eine eigene Retry-Schicht darüber, multiplizieren sich die tatsächlichen Anfragezahlen beider Ebenen.
Fehler mitten in einer Streaming-Anfrage lassen sich nicht pauschal wiederholen
Die offizielle Dokumentation weist noch auf einen leicht zu übersehenden Grenzfall hin: Sobald die Streaming-Ausgabe begonnen hat, lassen sich Fehler, die danach auftreten, nicht pauschal durch Wiederholen der gesamten Anfrage behandeln. Der Nutzer hat vielleicht schon einen Teil des Inhalts gesehen, und auch nachgelagerte Systeme haben möglicherweise bereits einen Teil der Daten verarbeitet. Ein direktes Wiederholen führt zu doppelten Inhalten, zu Inkonsistenzen und verbraucht zusätzlich Tokens.
Analyse und Einordnung: Wie sich OpenAI API 429 in der Praxis umsetzen lässt
Der folgende Text ist eine technische Einschätzung auf Grundlage der oben genannten Fakten und keine offizielle Aussage von OpenAI.
Ein direkt anpassbares Beispiel für 429-Backoff bei der OpenAI API
Das folgende Beispiel setzt einige Prinzipien um: automatische Wiederholungen im SDK deaktivieren, damit die Business-Logik die Verantwortung einheitlich übernimmt; quotenbezogene Fehler direkt weiterwerfen; vorrangig Retry-After befolgen; wenn nicht vorhanden, exponentielles Backoff mit vollständigem Jitter verwenden; die maximale Anzahl an Versuchen begrenzen.
import random
import time
from openai import OpenAI, RateLimitError

# Automatische Wiederholungen im SDK deaktivieren, um eine Überschneidung mit dem benutzerdefinierten Retry unten zu vermeiden
client = OpenAI(max_retries=0)

# 429-Typen, bei denen Warten nichts bringt (maßgeblich sind die tatsächliche Antwort und die offizielle Dokumentation)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """Parst die Retry-After-Sekunden; gibt None zurück, wenn der Wert ungültig ist. Das HTTP-Datumsformat kann bei Bedarf ergänzt werden."""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # Quoten-/Abrechnungsprobleme: an den Kontoprozess übergeben
            if attempt == max_attempts - 1:
                raise  # Obergrenze überschritten: an die Warteschlange oder Alarmierung übergeben
            wait = parse_retry_after(e.response)
            if wait is None:
                # Vollständiger Jitter: Zufallswert innerhalb von [0, exponentielles Maximum]
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
Die Werte max_attempts, base und cap im Beispiel sind nur Ausgangspunkte, keine empfohlenen Werte. Je nach Konto gibt es unterschiedliche Limitstufen, und auch die Art der Aufgaben ist verschieden – es gibt keine einheitliche Parallelitätszahl oder Wiederholungsanzahl, die für alle Konten passt. Passen Sie die Werte an Ihre eigenen Monitoring-Daten an.
Nach Engpass-Typ anpassen: Anfragen-Bottleneck und Token-Bottleneck brauchen unterschiedliche Lösungen
Backoff beantwortet nur die Frage „wie warte ich dieses eine Mal?“, nicht aber „warum laufe ich ständig in die Grenze hinein“. Um 429 zu reduzieren, muss man zuerst klären, gegen welche Grenze man eigentlich stößt.
Beim Anfragen-Bottleneck kommt es darauf an, den Rhythmus der Übermittlung zu entzerren. Am Eingang der Warteschlange gibt man die Aufgaben gleichmäßig frei – etwa über einen Token-Bucket oder feste Intervalle –, damit nicht massenhaft Jobs in derselben Sekunde herausbrechen. Auch Batch-Aufgaben sollten zeitlich versetzt startet werden und nicht alle punktgenau zur selben Minute loslaufen.
Beim Token-Bottleneck kommt es darauf an, das Volumen einer einzelnen Anfrage zu verkleinern. Typische Verschwendung: In jeder Gesprächsrunde werden der lange System-Prompt und der komplette Verlauf mitgeschickt; dasselbe große Dokument wird über mehrere Anfragen hinweg immer wieder übergeben; das gesamte Material wird dem Modell vorgelegt, obwohl eigentlich nur ein Abschnitt davon gebraucht wird. Erst kürzen, zusammenfassen oder gezielt abrufen und dann absenden – das ist meist deutlich wirksamer, als einfach nur die Anzahl der Wiederholungsversuche zu erhöhen.
Warteschlangenstatus: „Warten auf Wiederholung“ und „Konto blockiert“ trennen
Viele Systeme kennen nur zwei Zustände: „in der Warteschlange“ und „fehlgeschlagen“. Bei einem 429 führt das zu zwei Fehlurteilen: Eine temporäre Ratenbegrenzung wird als Fehler behandelt und die Aufgabe verworfen, während ein Kontingentproblem als Warteschlange interpretiert und endlos gewartet wird.
Sinnvoller ist es, die beiden Arten von 429 auf zwei Zustände aufzuteilen und unterschiedlich darzustellen:
| Warteschlangenstatus | Auslösebedingung | Anzuzeigende Informationen | Weiterbehandlung |
|---|---|---|---|
| Warten auf Wiederholung | Temporäre Ratenbegrenzung | Voraussichtlicher Zeitpunkt des nächsten Versuchs, Anzahl bisheriger Versuche | Automatische Wiederholung zum genannten Zeitpunkt, Umwandlung in „fehlgeschlagen“ bei Erreichen des Limits |
| Konto blockiert | Kontingent, Abrechnung, Nutzungslimits der Organisation | Grund der Blockierung (z. B. unzureichendes Kontingent) | Nachfolgende Aufgaben desselben Kontos aussetzen, Verantwortliche benachrichtigen |
| Fehlgeschlagen | Überschreitung des Wiederholungslimits oder anderer nicht behebbarer Fehler | Fehlertyp und ursprüngliche Meldung | Manueller Eingriff oder Herabstufung der Geschäftslogik |
„Konto blockiert“ hat noch einen weiteren Nebeneffekt. Andere Aufgaben unter demselben Konto stoßen mit hoher Wahrscheinlichkeit ebenfalls auf denselben 429. In diesem Fall sollten sie insgesamt ausgesetzt werden, statt jede Aufgabe einzeln gegen die Fehlermeldung laufen zu lassen.
Wiederholungsebenen untersuchen: SDK, Warteschlange und manuelle Schaltfläche
Wenn du feststellst, dass 429 mit jedem weiteren Wiederholungsversuch zunimmt, solltest du zuerst prüfen, ob mehrere Wiederholungsebenen gleichzeitig aktiv sind. Eine typische Kette sieht so aus: Das SDK wiederholt automatisch einige Male, die Anwendungs-Warteschlange stellt die Aufgabe nach einem Fehler erneut einige Male zu, und im Frontend sieht der Nutzer die Fehlermeldung und klickt manuell auf „Erneut versuchen“. Wenn diese drei Ebenen zusammenwirken, kann aus einer ursprünglichen Anfrage ein gutes Dutzend tatsächlicher Anfragen werden – und diese konzentrieren sich oft auf das Rate-Limit-Fenster, wodurch die Drosselung noch verschärft wird.
Bei der Untersuchung solltest du Ebene für Ebene prüfen:
- SDK-Ebene: Prüfe den tatsächlichen Wert von
max_retriesund verlasse dich nicht auf den Standardwert aus dem Gedächtnis. - Warteschlangen-Ebene: Prüfe, ob Aufgaben nach einem Fehler automatisch erneut zugestellt werden und ob die erneute Zustellung ein Backoff verwendet.
- Interaktionsebene: Prüfe, ob die Schaltfläche „Erneut versuchen“ während der Wartezeit deaktiviert ist und den Zeitpunkt des nächsten Versuchs anzeigt.
- Protokollierungsebene: Weise jeder ursprünglichen Aufgabe eine eindeutige ID zu und zähle, wie viele Anfragen tatsächlich dafür gesendet wurden.
Die Regel ist einfach: Auf demselben Pfad sollte nur eine Ebene für Wiederholungsversuche zuständig sein; alle anderen Ebenen geben nur den Status weiter.
Streaming-Szenarien erfordern eine eigene Wiederherstellungsstrategie für OpenAI API 429
Trifft eine Streaming-Anfrage beim Verbindungsaufbau auf 429, bevor irgendeine Ausgabe erfolgt ist, kann sie wie eine normale Anfrage behandelt werden. Sobald jedoch bereits Ausgabe erfolgt ist, sollte die Entscheidung, ob ein Replay erfolgt, der Fachlogik überlassen werden. Zum Beispiel kann man dem Nutzer klar anzeigen, dass die Generierung unterbrochen wurde, und ihn entscheiden lassen, ob er neu generieren möchte; oder man verwirft den bereits ausgegebenen Teil und ersetzt ihn vollständig. Auf keinen Fall sollte im Hintergrund stillschweigend erneut gesendet werden, sodass in der Oberfläche zwei doppelte Inhaltsabschnitte erscheinen.
Beim Umstieg auf andere Plattformen nicht einfach die 429-Semantik von OpenAI übernehmen
Die in diesem Artikel beschriebene Fehlerklassifizierung, die Werte von error.code, das Retry-After-Verhalten und die Antwort-Header folgen der Semantik der offiziellen OpenAI-API. Wenn du Modelle über ein Drittanbieter-Gateway, einen Proxy oder eine Aggregationsplattform (zum Beispiel APIYI) aufrufst, gelten für Fehlercodes, Rate-Limit-Dimensionen und Retry-Empfehlungen die Dokumentation des jeweiligen Anbieters. Diese musst du gesondert prüfen und darfst das Verhalten von OpenAI nicht einfach übernehmen. Ein vergleichsweise robuster Ansatz besteht darin, in der Anbindungsschicht eine Fehlernormalisierung einzubauen: 429-Antworten aus verschiedenen Quellen werden auf die in diesem Artikel genannten drei Zustände „auf Retry warten / Konto blockiert / fehlgeschlagen“ abgebildet und anschließend an ein zentrales Retry-Modul übergeben.
Änderungen, die man im Blick behalten sollte
Die Dokumentation zu Fehlercodes und Rate Limits von OpenAI wird laufend gepflegt. Limitstufen, Messdimensionen und Antwort-Header-Felder können sich ändern. Es empfiehlt sich, im Code Logs mit dem Originalfehlertext aufzubewahren und die Entscheidungslogik regelmäßig anhand der offiziellen Dokumentation zu überprüfen. Außerdem gilt: „Alle 429 lassen sich durch Warten lösen“ gehört in keine Standardkonfiguration. Wenn diese Annahme bei ausgeschöpftem Kontingent greift, kostet das eine Aufgabenwarteschlange, die die ganze Nacht vergeblich läuft.
Ein 429 bedeutet im Kern, dass der Server „langsamer bitte“ sagt – manchmal aber auch „dieser Weg ist vorerst nicht gangbar“. Zu unterscheiden, welcher Fall vorliegt, und dann zu entscheiden, ob man wartet, etwas ändert oder aufhört, ist wichtiger als jeder noch so ausgeklügelte Retry-Algorithmus. Wie es in den Analekten (Lunyu · Zilu) heißt:
„Nichts überstürzen, nicht auf kleinen Vorteil zielen. Wer zu schnell sein will, kommt nicht ans Ziel; wer nur den kleinen Vorteil sieht, vollbringt keine großen Dinge.“