Hinweis des Autors: Dieser Beitrag vergleicht Gemini 4 Argon und Carbon bei Reasoning-Aufwand, Antwortgeschwindigkeit und Aufgabenkosten und hilft Entwicklern, das passende Modell nach Aufgabenschwierigkeit zu wählen.
Google hat Gemini 4 Argon am 13. Oktober 2026 veröffentlicht, Gemini 4 Carbon am 28. Oktober erstmals vorgestellt und am 10. November für Entwickler, Unternehmen und Endnutzer freigegeben. Viele fragen sich sofort: Ist Carbon der Nachfolger, der Argon ersetzt? Dieser Artikel vergleicht Gemini 4 Argon und Carbon in 5 Dimensionen: Reasoning-Aufwand, Antwortlatenz, Aufgabenkosten, Einsatzszenarien und Reasoning-Stufen.
Es geht hier nicht um die simple Faustregel „Das teurere Modell ist automatisch besser“. Laut der offiziellen Google-Entwicklerdokumentation bleibt Argon die empfohlene Wahl für die meisten Engineering- und Wissensarbeiten. Carbon richtet sich an Aufgaben, die tieferes Reasoning und längere Verifikationszyklen erfordern. Dieser Artikel stützt sich in erster Linie auf die offizielle Google-Dokumentation; bei Daten von Drittanbietern geben wir die Version des Benchmarks und die Reasoning-Stufe an.
Der Nutzen für dich: Nach der Lektüre weißt du, welche Aufgaben du an Argon übergibst, welche sich für Carbon lohnen und wie du mit dem Thinking Level Qualität, Geschwindigkeit und Kosten steuerst.
7 Begriffe, die Sie vor dem Vergleich von Gemini 4 Argon und Carbon kennen sollten
Beim Vergleich zweier Reasoning-Modelle werden einige Konzepte leicht durcheinandergebracht. Klären Sie sie vorab, damit Sie die Daten später nicht falsch interpretieren:
- Denkstufe (Thinking Level): Eine Einstellung, die steuert, wie viel Denkaufwand das Modell betreibt. Carbon bietet drei Stufen: LOW, MEDIUM und HIGH.
- Denk-Token: Token, die das Modell beim Schlussfolgern erzeugt. Sie werden wie Ausgabe-Token abgerechnet.
- Aufgabenkosten: Die Kosten aller Modellaufrufe, die zur Erledigung einer Aufgabe nötig sind. Sie entsprechen nicht den Kosten einer einzelnen Anfrage.
- Inferenzlatenz: Die Zeit zwischen dem Eingang der Anfrage und dem Ergebnis. In diesem Artikel betrachten wir vor allem die Latenz bis zum ersten Antwort-Token.
- Cache-Lesezugriff: Eine Abrechnungsart für die Wiederverwendung bereits vorhandenen Eingabekontexts. Der Preis liegt deutlich unter dem normaler Eingabe.
- Agent: Ein Agent, der über Werkzeuge mehrstufige Aufgaben ausführen kann, etwa Code schreiben, Tests ausführen und anschließend Fehler beheben.
- Benchmark: Eine Methode, Modelle anhand eines festen Aufgabensets zu bewerten und zu vergleichen. Die Ergebnisse gelten nur für genau diese Testkonfiguration.
Warum Google Gemini 4 Argon und Carbon gleichzeitig veröffentlicht
Laut der Modellkarte von Google DeepMind basiert Gemini 4 Carbon auf Gemini 4 Argon. Beide teilen sich also eine gemeinsame Modellgrundlage. Carbon ist eine darauf aufbauende Version, die zusätzlich für anspruchsvolles Reasoning, komplexe Softwareentwicklung, langfristige Agent-Workflows, wissenschaftliche Forschung und Cyberabwehr optimiert wurde. Wichtig: Google hat weder die Parameterzahl von Carbon offengelegt noch die Unterschiede in der internen Rechenarchitektur veröffentlicht. Aussagen wie „Carbon ist um ein Vielfaches größer als Argon“ entbehren daher jeder Grundlage.
Wenn Carbon stärker ist, warum ersetzt es Argon dann nicht einfach? Der Grund: Die beiden Modelle sind für unterschiedliche Arbeit gedacht. Bei der alltäglichen Feature-Entwicklung und bei häufigen, interaktiven Code-Änderungen zählen vor allem schnelle Antworten und der Token-Verbrauch pro Runde. Bei Aufgaben wie Architekturdesign, systemübergreifender Ursachenanalyse oder wissenschaftlichen Beweisen kommt es dagegen darauf an, ob das Modell immer wieder Hypothesen aufstellen, prüfen und korrigieren kann. Auch Googles Empfehlung in der Entwicklerdokumentation sieht eine Arbeitsteilung statt eines Ersatzes vor: Argon übernimmt den Großteil der alltäglichen Entwicklungsarbeit, Carbon die schwierigeren und länger laufenden Reasoning-Aufgaben.
Diese Arbeitsteilung zeigt sich auch in Googles eigenen Produkten. Für die Multi-Agent-Vorschau /swarm in Antigravity empfiehlt Google, Carbon die Gesamtarchitektur, die Aufgabenkoordination und die Sicherheitsprüfung zu überlassen, während die reguläre Code-Implementierung und parallele Dateiänderungen an schnellere, leichtere Modelle gehen. Im Endkundenbereich ist es ähnlich: Im Google-AI-Pro-Abo ist hauptsächlich Argon enthalten, Carbon gibt es erst im Ultra-Abo.
Kernunterschied zwischen Gemini 4 Argon und Carbon: unterschiedlicher Denkaufwand pro Runde
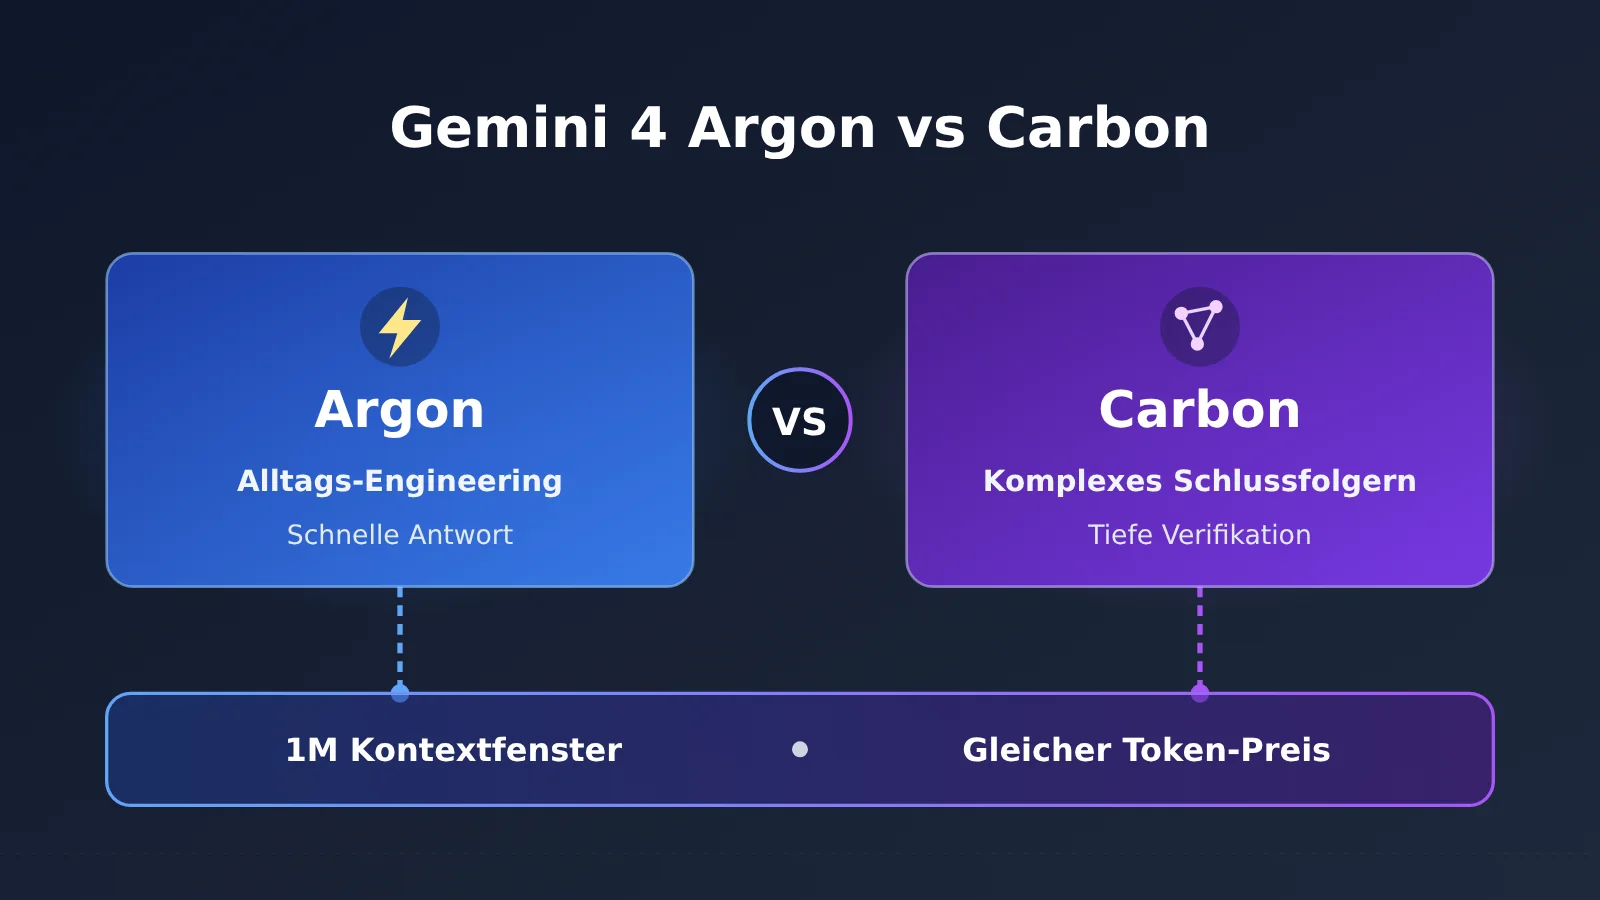
Google liefert im Abschnitt „Choosing between Carbon and Argon“ des Carbon-Entwicklerleitfadens die direkteste Erklärung: Carbon verbraucht pro Runde mehr Denk-Token, um seine eigene Arbeit gründlicher zu erkunden und zu überprüfen. Argon dagegen setzt auf schnellere Antworten und einen geringeren Token-Verbrauch pro Runde und eignet sich damit für interaktives Programmieren und die alltägliche Feature-Entwicklung. Beide teilen sich ein einheitliches Kontextfenster von 1M Token (1.048.576 Token, Eingabe und Ausgabe zusammen), nutzen dieselben integrierten Tools und kosten pro Token gleich viel.
| Vergleichskriterium | Gemini 4 Argon | Gemini 4 Carbon | Besser geeignet |
|---|---|---|---|
| Positionierung | Leistungsstarkes, effizientes Allzweck-Reasoning-Modell | Tieferes Modell für komplexes Reasoning | Kommt auf die Aufgabe an |
| Denk-Token pro Runde | Vergleichsweise wenige | Deutlich mehr pro Runde | Argon spart mehr |
| Antwortgeschwindigkeit | Schneller | Bei komplexen Aufgaben langsamer | Argon |
| Interaktive Entwicklung | Besser geeignet | Für besonders schwierige Aufgaben nutzbar | Argon |
| Alltägliche Feature-Entwicklung | Empfohlen | Meist nicht nötig | Argon |
| Architekturdesign, Ursachenanalyse | Machbar | Besser für extrem komplexe, tiefgehende Untersuchungen | Carbon |
| Wissenschaftliche Beweise, Sicherheitsaudits | Machbar / unterstützt | Besser für komplexes Reasoning und Verifikation | Carbon |
| Kontext und Preis pro Token | 1M geteiltes Kontextfenster, gleicher Preis | 1M geteiltes Kontextfenster, gleicher Preis | Gleichstand |
Die Tabelle zeigt: Die Trennlinie zwischen Gemini 4 Argon und Carbon verläuft nicht bei der Frage „Geht das überhaupt?“, sondern bei „Lohnt sich mehr Nachdenken?“. Auch Argon kann Architekturdesign und Ursachenanalyse übernehmen. Wird das Problem aber so komplex, dass mehrere Runden aus Hypothesen und Überprüfung nötig sind, investiert Carbon mehr Denk-Token und erkauft sich damit zuverlässigere Ergebnisse.
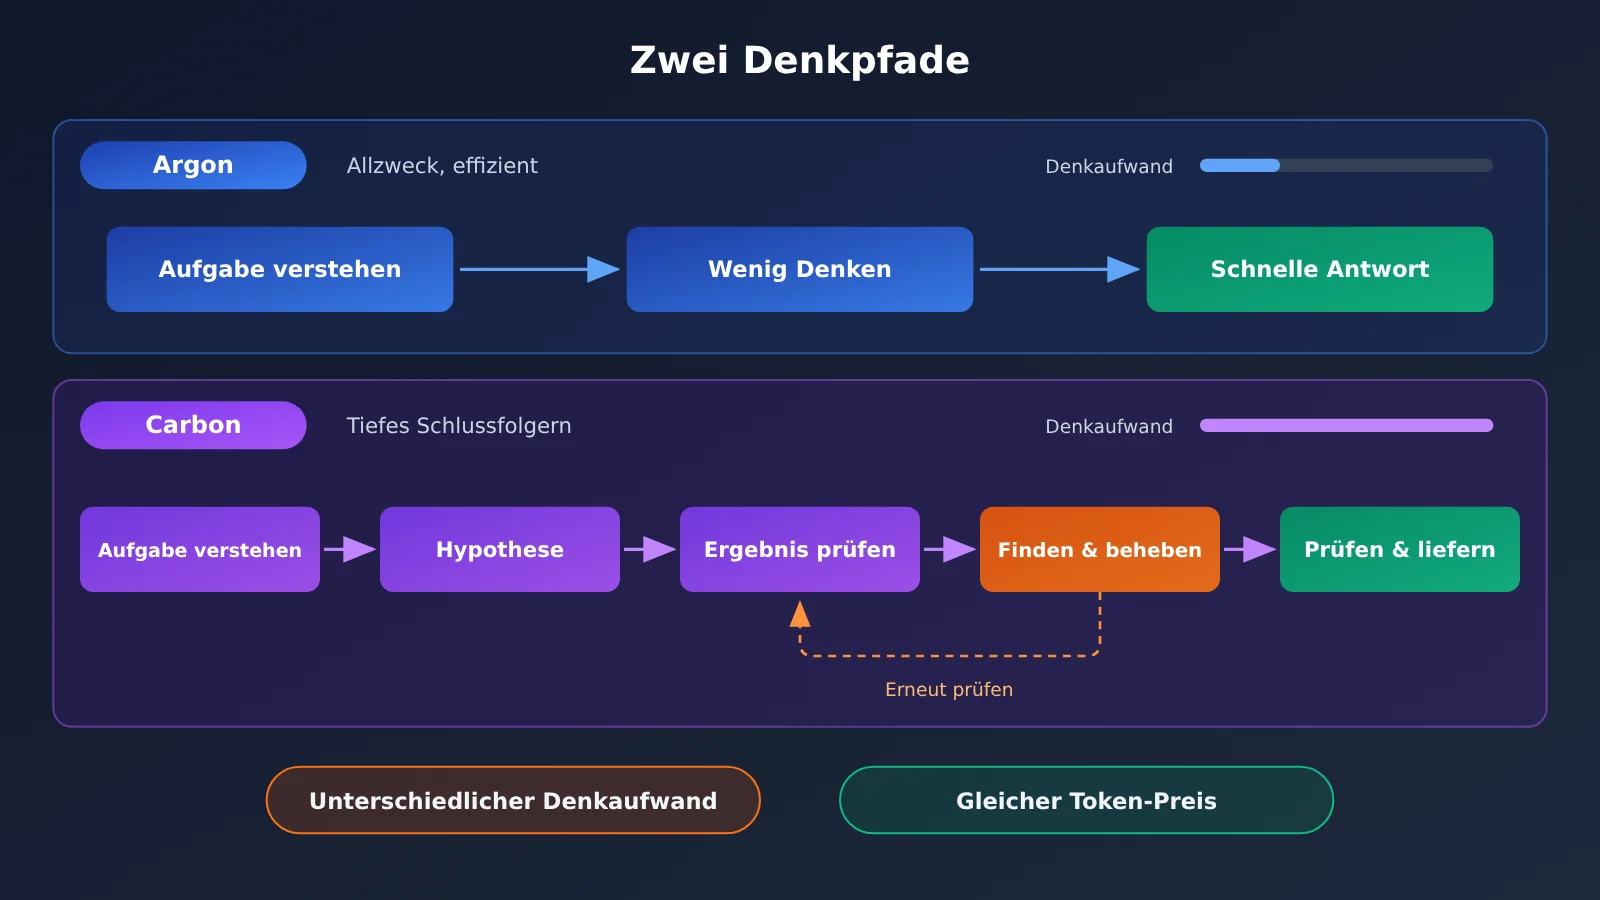
Carbon arbeitet eher wie ein vollständiger Ausführungskreislauf: Ziele und Rahmenbedingungen verstehen, die Aufgabe zerlegen, einen Plan aufstellen, Tools aufrufen, Zwischenergebnisse prüfen, Fehler erkennen, nachbessern, erneut verifizieren und schließlich ausliefern. Dieser Kreislauf verschafft Carbon Vorteile bei lang laufenden Aufgaben und erklärt auch, warum die Wartezeit bis zur ersten Antwort länger ist.
Unabhängiger Benchmark-Vergleich: Gemini 4 Argon und Carbon
Herstellerangaben brauchen unabhängige Daten zur Überprüfung. Artificial Analysis bietet im Intelligence Index v5.0.1 eine direkte Vergleichsseite für Carbon und Argon. Alle folgenden Zahlen stammen aus der High-Reasoning-Konfiguration.
| Kennzahl (AA v5.0.1, High Reasoning) | Carbon High | Argon High | Abstand |
|---|---|---|---|
| Gesamt-Intelligenzindex | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77,8 % | 77,5 % | praktisch gleichauf |
| Terminal-Bench 4.0 | 65,2 % | 57,1 % | Carbon vorn |
| FrontierCode 2.0 | 40,6 % | 25,7 % | Carbon deutlich vorn |
| AA-Omniscience (Score für Wissenszuverlässigkeit) | 54 | 46 | Carbon vorn |
| HLE-Diamond | 69,1 % | 56,7 % | Carbon vorn |
| Kosten pro Aufgabe | $7.76 | $9.95 | Carbon günstiger |
| Dauer pro Aufgabe | 25,6 Minuten | 28,9 Minuten | Carbon kürzer |
| Latenz bis zum ersten Antwort-Token | ca. 68 Sekunden | ca. 37 Sekunden | Argon schneller |
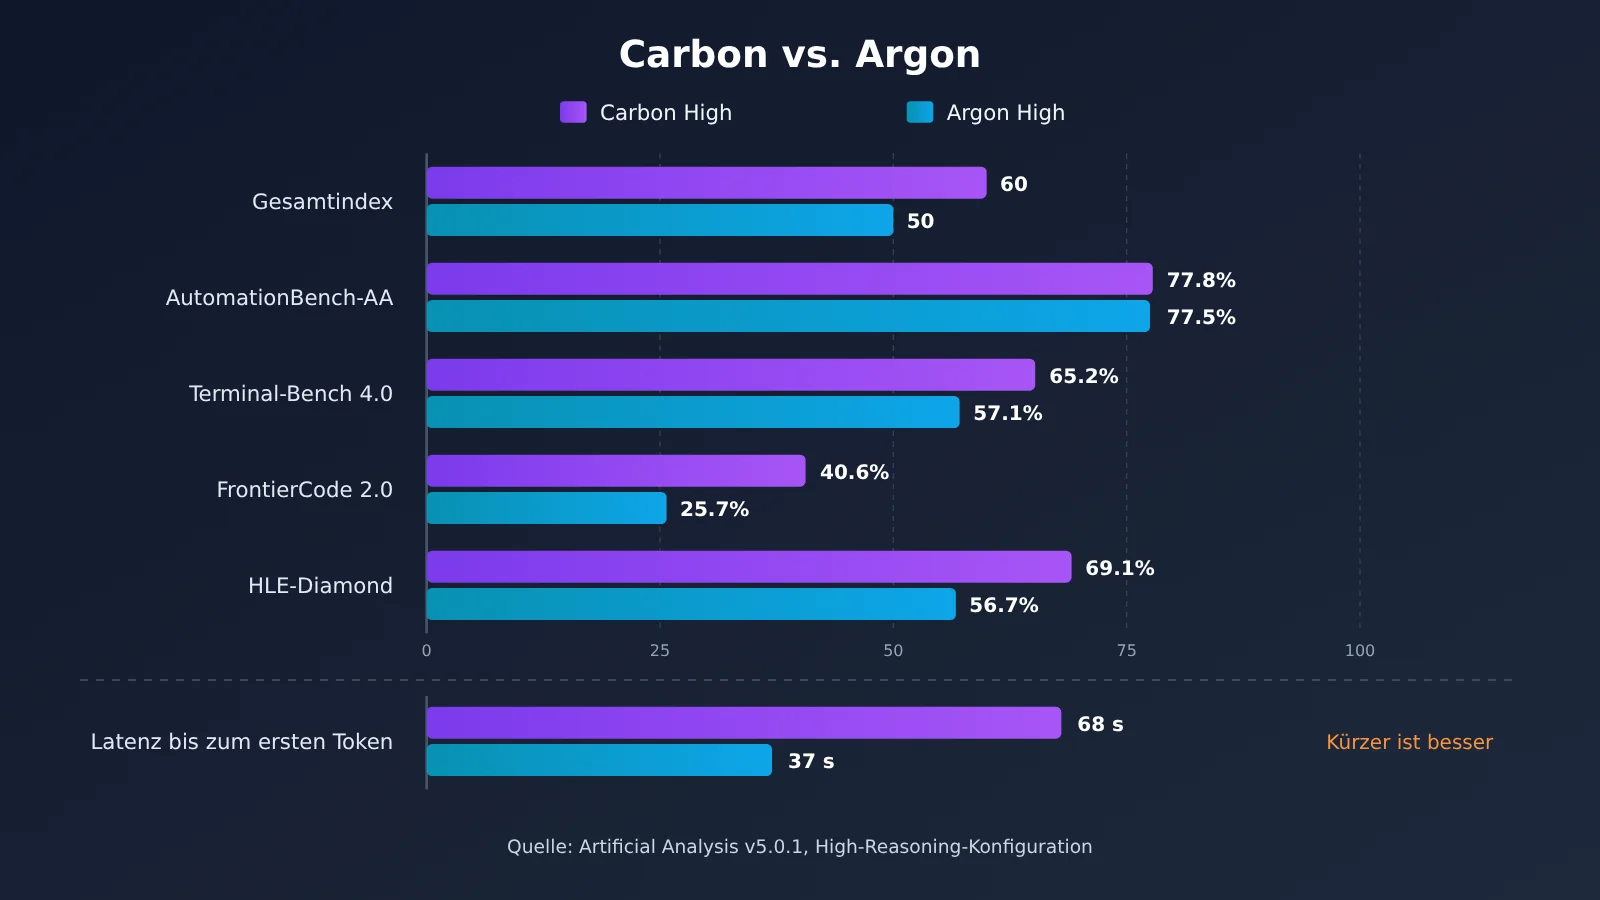
Einige Erkenntnisse sind besonders interessant:
- Der größte Abstand zeigt sich bei komplexem Engineering und anspruchsvollem Reasoning: Bei FrontierCode 2.0 liegt Carbon fast 15 Prozentpunkte vorn, bei HLE-Diamond rund 12 und bei Terminal-Bench 4.0 etwa 8 Prozentpunkte.
- Bei gewöhnlichen Automatisierungsaufgaben ist der Unterschied winzig: Bei AutomationBench-AA trennen die beiden nur 0,3 Prozentpunkte. Für prozessorientierte Automatisierung reicht Argon also völlig aus.
- Die Wissenszuverlässigkeit hat sich verbessert: AA-Omniscience steht 54 zu 46. Auch der Agentic Honesty Benchmark aus der Google-Modellkarte zeigt für Carbon 92 % gegenüber 70 % bei Argon.
- Argon antwortet deutlich schneller: Rund 37 gegenüber rund 68 Sekunden. Das ist der direkte Preis dafür, dass Carbon mehr Reasoning-Aufwand betreibt.
Auch die offizielle Google-Modellkarte (Evaluierungszeitpunkt: Oktober 2026, in der Regel Pass@1 mit der höchsten verfügbaren Reasoning-Stufe) zeigt denselben Trend: Bei SWE-sweep erreicht Carbon 9,6 % und Argon 4,3 %. Bei GraphWalks (256k–1M, BFS F1) sind es 96,2 % gegenüber 84,2 %, bei Terminal-Bench Science 0.1 64,8 % gegenüber 52,9 %. Die Modellkarte und Artificial Analysis verwenden allerdings unterschiedliche Bewertungssysteme und stammen aus verschiedenen Zeiträumen, deshalb sollte man sie nicht zu einem gemeinsamen Ranking vermischen. Außerdem nennt die Carbon-Modellseite für High eine Dauer pro Aufgabe von 24,9 Minuten, die Vergleichsseite dagegen 25,6 Minuten. Für die Tabelle in diesem Artikel gelten die Werte der Vergleichsseite.
基准成绩也不是全部。在 Google DeepMind 与 Artificial Analysis 联合推出的 MKA 多模态知识工作评测中,没有任何模型在全部 10 个行业领先:Argon 在科学领域领先,Carbon 在医疗健康领域领先。这提醒我们:Carbon 的综合分更高,并不意味着它在每个具体领域都胜过 Argon。
Hier die deutsche Fassung:
Benchmark-Ergebnisse sind nicht alles. Beim MKA-Benchmark für multimodale Wissensarbeit, den Google DeepMind und Artificial Analysis gemeinsam entwickelt haben, liegt kein Modell in allen 10 Branchen vorn: Argon führt im Bereich Wissenschaft, Carbon im Bereich Gesundheitswesen. Das zeigt: Dass Carbon insgesamt besser abschneidet, heißt nicht, dass es in jedem einzelnen Fachgebiet besser ist als Argon.
💡 Hinweis zum Vergleich: Benchmarks bilden nur die Leistung bei einem festen Aufgabenset ab. Ob Carbon für Ihren Anwendungsfall wirklich nötig ist, finden Sie am zuverlässigsten heraus, indem Sie beide Modelle mit Ihren eigenen, realen Aufgaben testen. Über APIYI (apiyi.com) können Sie mit demselben API-Schlüssel und demselben OpenAI-kompatiblen Code zwischen beiden Modellen wechseln – so lassen sich kleine Vergleichstests einfach umsetzen.
Warum Gemini 4 Carbon pro Runde mehr Token verbraucht, aber nicht unbedingt teurer ist
Das ist der Punkt, der am häufigsten falsch verstanden wird. Gemini 4 Argon und Carbon kosten pro Token dasselbe: Bis zum 30. November 2026 gilt ein Einführungspreis von 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token. Ab dem 1. Dezember steigen die Preise auf 4 bzw. 20 US-Dollar. Gecachte Eingaben sind um 95 % günstiger als der normale Eingabepreis. Denkende Token (Thinking-Token) werden als Ausgabe-Token abgerechnet. Weil Carbon pro Runde mehr nachdenkt, fällt die Rechnung für eine einzelne Runde in der Regel höher aus.
Die Rechnung für eine ganze Aufgabe ist aber nicht dasselbe wie die Rechnung für eine einzelne Runde. Im Vergleich der High-Konfigurationen in Artificial Analysis v5.0.1 liegen die Kosten pro Aufgabe bei Carbon bei 7,76 US-Dollar, bei Argon bei 9,95 US-Dollar. Carbon ist also rund 22 % günstiger und etwa 3 Minuten schneller. Eine plausible Erklärung: Die Kosten einer vollständigen Aufgabe hängen davon ab, wie viele Runden man braucht, wie viele Umwege man nimmt und wie oft man nachbessern muss. Wenn Carbon zu Beginn mehr nachdenkt und dafür weniger Fehler macht, entfallen später womöglich Wiederholungs- und Korrekturrunden.
| Konfiguration (AA v5.0.1) | Gesamtscore | Kosten pro Aufgabe | Dauer pro Aufgabe | Latenz bis zur ersten Antwort |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22,3 Minuten | 12,37 Sekunden |
| Carbon Medium | 58 | $6.59 | 23,3 Minuten | 23,16 Sekunden |
| Carbon High | 60 | $7.76 | 24,9 Minuten | 67,54 Sekunden |
| Argon High | 50 | $9.95 | 28,9 Minuten | ca. 37 Sekunden |
In diesen Daten steckt noch eine weitere kontraintuitive Beobachtung: Die Aufgabenkosten von Carbon Medium liegen unter denen von Low. Je niedriger die Reasoning-Stufe, desto günstiger ist zwar eine einzelne Runde, aber womöglich braucht man mehr Runden, um die Aufgabe abzuschließen. Bei der Einordnung sollten Sie besonders auf folgende Grenzen achten:
- Diese Kosten sind die durchschnittlichen Kosten pro Aufgabe in diesem Bewertungssystem, berechnet nach dem Standardpreis von 4/20 US-Dollar. Sie entsprechen nicht dem Preis einer gewöhnlichen API-Anfrage. Beim Einführungspreis halbieren sich die Kosten bei gleichem Token-Verbrauch ungefähr.
- Zeitangaben wie 24,9 Minuten sind gewichtete Laufzeiten von Agent-Bewertungsaufgaben. Sie bedeuten nicht, dass Sie bei einer normalen Frage 25 Minuten warten müssen.
- Die Schlussfolgerung gilt nur für die Aufgaben des AA Index. Ist Ihre Aufgabe von Natur aus simpel und lässt sich in ein bis zwei Runden erledigen, schlägt sich der Vorteil von Argon oder einer niedrigeren Stufe pro Runde direkt in einer niedrigeren Rechnung nieder.
💰 Kostentipp: Halten Sie bei der Modellbewertung die „Gesamtzahl der Token und die Gesamtdauer pro erledigter Aufgabe“ fest, statt nur Stückpreise zu vergleichen. APIYI (apiyi.com) rechnet nutzungsbasiert ab. In der Konsole sehen Sie die Verbrauchsdetails jedes Aufrufs, damit lassen sich die realen Aufgabenkosten von Argon und Carbon für Ihren Anwendungsfall gut nachrechnen.
Wann Gemini 4 Argon, wann Carbon?
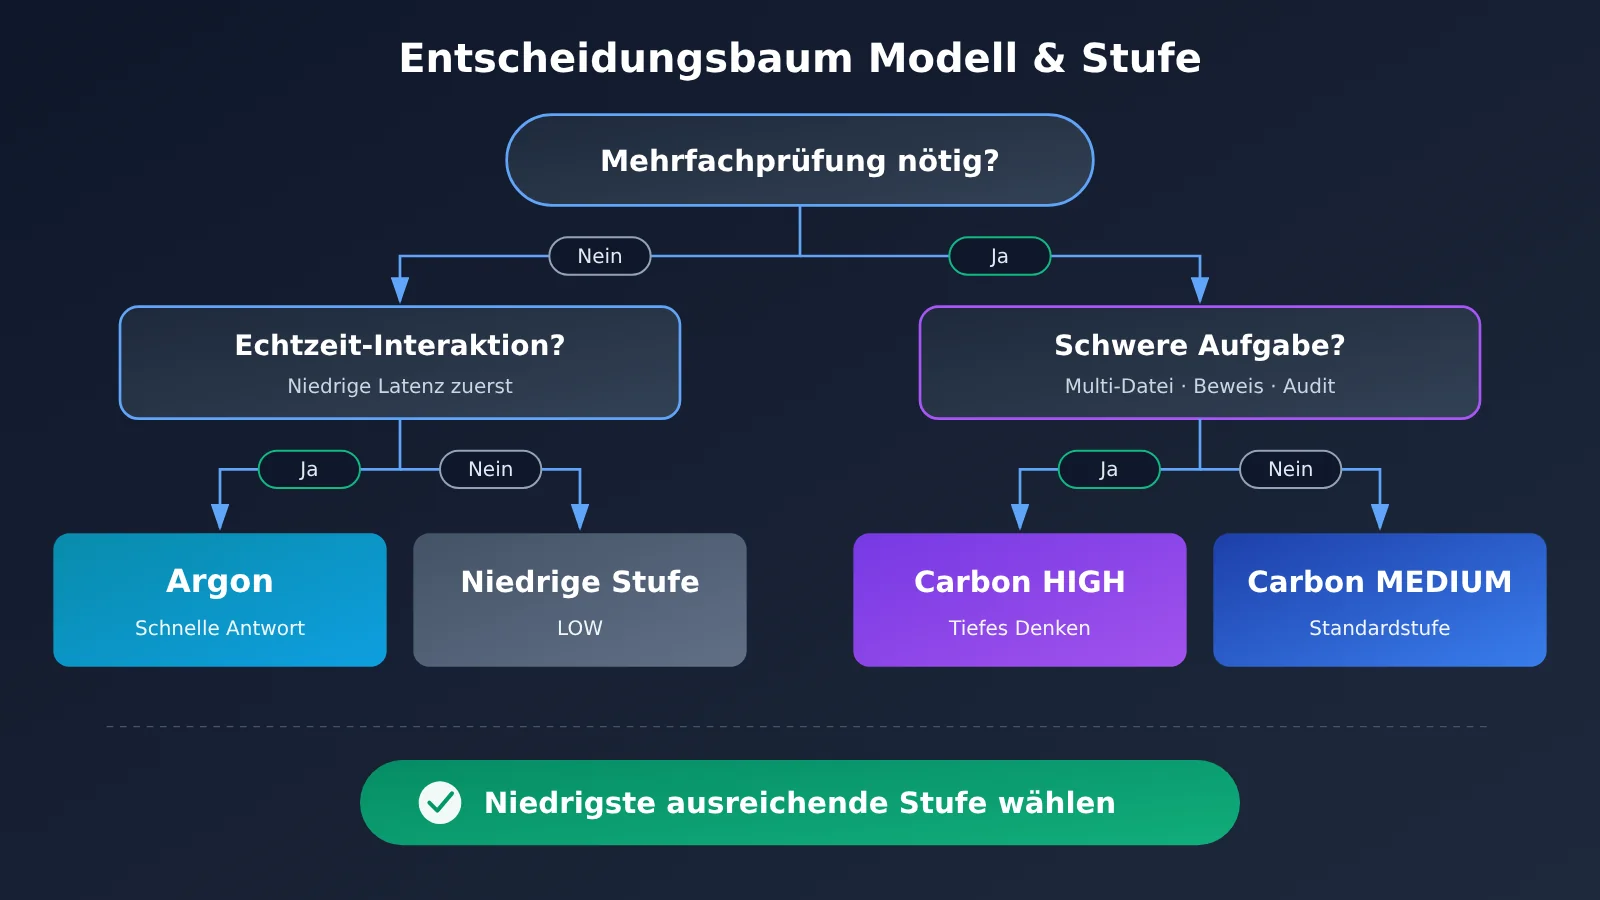
Aus Googles offizieller Positionierung und den obigen Daten lässt sich eine Aufteilung nach Aufgabenschwierigkeit ableiten. Das Grundprinzip: Erst fragen, ob sich tieferes Schlussfolgern für die Aufgabe überhaupt lohnt, und erst dann Modell und Stufe wählen.
| Aufgabentyp | Empfohlenes Modell | Empfohlene Stufe | Begründung |
|---|---|---|---|
| Alltägliche Feature-Entwicklung, übliche Codeänderungen | Argon | Standard oder mittel | Schnelle Antworten, geringer Overhead pro Runde, ideal für häufige Interaktion |
| Interaktives Programmieren, Echtzeit-Unterstützung in der IDE | Argon | Mittel | Deutlich niedrigere Latenz bis zur ersten Antwort |
| Komplexe Projekte über mehrere Dateien, Architekturentwurf | Carbon | HIGH | Deutlicher Abstand bei FrontierCode und Terminal-Bench |
| Tiefgehende Ursachenanalyse über Subsysteme hinweg | Carbon | MEDIUM / HIGH | Erfordert das Durchspielen mehrerer Hypothesen und wiederholtes Verifizieren |
| Anspruchsvolles wissenschaftliches Schlussfolgern, formale Beweise | Carbon | HIGH | Google nennt formale Beweise offiziell als HIGH-Einsatzgebiet |
| Sicherheitsaudits, Schwachstellensuche | Carbon | HIGH | Laut offizieller Positionierung besser für komplexe Audits geeignet |
| Einfache Klassifikation, Zusammenfassung, Metadaten-Extraktion | Niedrige Reasoning-Stufe | LOW | Kostensensibel, tiefes Schlussfolgern nicht nötig |
Wann Gemini 4 Argon die richtige Wahl ist
- Entwicklung mit häufiger Interaktion: Eine einzelne Funktion schreiben, Styles anpassen, Tests ergänzen – ob man 37 oder 68 Sekunden wartet, ist im Arbeitsfluss deutlich spürbar.
- Alltägliche Wissensarbeit und Automatisierungs-Workflows: Bei AutomationBench-AA liegen beide Modelle fast gleichauf, für den Abstand muss man also nicht extra zahlen.
- Wissenschaftliche Wissensarbeit: In der MKA-Evaluierung liegt Argon im Wissenschaftsbereich vorn und ist deshalb eine gute erste Wahl.
Wann Gemini 4 Carbon die richtige Wahl ist
- Langlaufende Agent-Aufgaben im Hintergrund: Die Latenz bis zur ersten Antwort spielt keine große Rolle, wichtiger ist, dass das Ergebnis auf Anhieb stimmt.
- Komplexe Engineering- und Architekturentscheidungen: Migrationen über mehrere Dateien, Systemrefactorings, aufwendige Code-Audits.
- Aufgaben mit hohen Anforderungen an die Überprüfbarkeit: Wissenschaftliches Schlussfolgern, Sicherheitsaudits, Analyseberichte, die sich selbst gegenprüfen müssen.
Auch das frühe Community-Feedback bestätigt diese Aufteilung. Auf Hacker News und Reddit berichten manche Entwickler, Carbon finde Probleme, die andere Modelle übersehen. Andere beklagen, dass die erste Antwort zu lange dauere und das Kontingent schnell aufgebraucht sei. Ein Reddit-Nutzer migrierte mit Carbon Medium in einem Go-Projekt eine Bibliothek mit 230 Dateien und hatte schon beim ersten Lauf Erfolg. Der Autor weist aber selbst darauf hin, dass es nur 4 Phasen waren und kein kontrollierter Versuch – es taugt also bestenfalls als Anschauungsbeispiel.
So steuern Sie mit dem Thinking Level Qualität, Geschwindigkeit und Kosten von Gemini 4 Carbon
Carbon bietet drei Reasoning-Stufen: LOW, MEDIUM und HIGH. Das öffentliche Modell gemini-4-carbon nutzt standardmäßig MEDIUM. Die offizielle Empfehlung für die Einsatzbereiche lautet:
- LOW: Klassifikation, Zusammenfassung, Extraktion von Metadaten
- MEDIUM: gängiger Code, Tool-Aufrufe, Fragen zu Dokumenten, Videoverständnis
- HIGH: Software-Engineering über mehrere Dateien, Architekturdesign, formale Beweise, Schwachstellensuche
Dass MEDIUM der Standard ist, hat gute Gründe. In AA v5.0.1 erreicht Carbon Medium einen Gesamtscore von 58, nur 2 Punkte weniger als High. Dabei verursacht es die niedrigsten Kosten pro Aufgabe, und die Latenz bis zur ersten Antwort liegt bei etwa einem Drittel von High. Im AA-Omniscience-Test zur Faktenzuverlässigkeit erfindet Medium in 4,2 % der Fälle Antworten, High dagegen in 11,4 % und Low in 20,0 % (das ist eine Kennzahl dieses konkreten Tests, keine allgemeine Halluzinationsrate). Auch Google empfiehlt Entwicklern, die verschiedenen Stufen auszuprobieren und die niedrigste Stufe zu wählen, die Ihre Qualitätsanforderungen erfüllt, statt pauschal HIGH zu verwenden.
Beim Aufruf sollten Sie außerdem einige technische Einschränkungen von Carbon beachten:
thinking_budgetwird nicht unterstützt. Wenn Sie den Parameter verwenden, erhalten Sie HTTP 400.- Die Stufe MINIMAL gibt es nicht.
temperature,top_pundtop_kwerden ignoriert.- Explizites Context Caching wird nicht unterstützt. Ab einem gemeinsamen Präfix der Eingabeaufforderung von 4096 Token greift aber automatisch implizites Caching.
Minimalbeispiel
Mit der OpenAI-kompatiblen Schnittstelle rufen Sie Gemini 4 Carbon mit gut zehn Zeilen Code auf:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche Schnittstelle von APIYI
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # Die Modell-ID richtet sich nach der Modellliste der Plattform
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
Vollständigen Code anzeigen: Argon und Carbon nach Aufgabenschwierigkeit routen
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Die Modellnamen sind Beispiele – maßgeblich sind die tatsächlichen IDs in der Modellliste der Plattform
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """Gibt je nach Aufgabenschwierigkeit (Modell, Reasoning-Stufe) zurück"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # Klassifikation, Zusammenfassung, Metadaten-Extraktion
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # Alltägliche Entwicklung, häufige Interaktion
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # Ursachenanalyse, gängige Agent-Aufgaben
    return CARBON_MODEL, "high"         # Projekte mit mehreren Dateien, Beweise, Sicherheitsaudits

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # Wie der Parameter für die Reasoning-Stufe abgebildet wird, steht in der Plattform-Dokumentation;
        # Carbon unterstützt thinking_budget nicht – die Übergabe führt zu einem 400-Fehler
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # Enthält Thinking-Token
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 Tipp für den schnellen Einstieg: Registrieren Sie sich am besten zuerst bei APIYI (apiyi.com) und holen Sie sich das kostenlose Testguthaben. Geben Sie dann mit der obigen Routing-Funktion dieselben realen Aufgaben nacheinander an Argon und Carbon in den verschiedenen Stufen und notieren Sie Laufzeit und
completion_tokens. Mit einem einzigen API-Schlüssel lässt sich der gesamte Vergleich durchführen – Sie müssen nicht mehrere SDKs einzeln anbinden.
Entscheidungshilfe: Gemini 4 Argon oder Carbon
Wenn Sie sich nur eine Regel merken wollen: Nutzen Sie standardmäßig Argon und wechseln Sie zu Carbon, sobald eine Aufgabe wirklich tiefes Nachdenken erfordert. In der Praxis lässt sich das in drei Schritten umsetzen:
- Routing-Regeln aufstellen: Teilen Sie Ihre Aufgaben anhand der Szenario-Tabelle oben in vier Klassen ein: einfach, alltäglich, komplex und extrem schwierig. Alltägliche Aufgaben laufen standardmäßig über Argon.
- Vergleich mit kleiner Stichprobe: Wählen Sie pro Klasse 10 bis 20 reale Aufgaben aus und vergleichen Sie Argon und Carbon auf allen Stufen nach Erfolgsquote, Gesamtzahl der Token und Gesamtdauer.
- Stufe nach Aufgabenkosten festlegen: Wählen Sie die niedrigste Stufe, die Ihre Qualitätsschwelle erreicht, und prüfen Sie das regelmäßig neu. Modelle, Preise und Ranglisten können sich jederzeit ändern.
Auch bei Multi-Agent-Systemen lohnt sich ein Blick auf den Ansatz von Google /swarm: Carbon übernimmt Planung, Koordination und Review, während Argon oder ein noch leichteres Modell die Massenausführung erledigt. So nutzen Sie die tiefe Reasoning-Fähigkeit von Carbon, ohne dass jeder Schritt seine Latenz mittragen muss.
💡 Empfehlung: Beide Modelle kosten pro Token gleich viel. Den Unterschied macht die Struktur Ihrer Aufgaben. Wir empfehlen, Argon und Carbon über die OpenAI-kompatible Schnittstelle von APIYI (apiyi.com) gleichzeitig anzubinden und im Code per Routing zwischen beiden umzuschalten. Wenn Sie Ihre Strategie später anpassen, müssen Sie den Geschäftscode dann nicht anfassen.
Häufig gestellte Fragen (FAQ)
Q1: In welchem Verhältnis stehen Gemini 4 Argon und Carbon zueinander?
Laut Modellkarte von Google DeepMind baut Gemini 4 Carbon auf Gemini 4 Argon auf. Beide gehören zur Reasoning-Modellfamilie Gemini 4 und teilen sich ein Kontextfenster von 1M Token sowie die integrierten Werkzeugfunktionen. Carbon investiert pro Durchlauf mehr Denk-Token in Exploration und Verifikation, während Argon stärker auf Antwortgeschwindigkeit und Effizienz pro Durchlauf ausgelegt ist. Google hat keine Angaben zu Parameterzahl und Architekturunterschieden veröffentlicht.
Q2: Wird Carbon Argon vollständig ersetzen?
Nein. Google betont ausdrücklich, dass Argon für die meisten Engineering- und Wissensarbeitsaufgaben weiterhin die ideale Wahl bleibt, während Carbon für schwierigere und länger laufende Aufgaben gedacht ist. Die Daten zeigen, dass Argon in vielen Szenarien konkurrenzfähig bleibt: Bei AutomationBench-AA liegen beide nahezu gleichauf, und bei MKA liegt Argon im naturwissenschaftlichen Bereich vorn.
Q3: Kosten beide Modelle dasselbe? Wann ändert sich der Preis?
Laut Entwicklerdokumentation von Google gilt für beide Modelle derselbe Preis pro Token. Der Einführungspreis beträgt 2 / 10 US-Dollar pro Million Eingabe-/Ausgabe-Token und gilt bis zum 30. November 2026. Ab dem 1. Dezember steigt er auf 4 / 20 US-Dollar. Denk-Token werden als Ausgabe abgerechnet. Gleiche Einzelpreise bedeuten deshalb nicht, dass eine Aufgabe auch gleich viel kostet.
Q4: Carbon antwortet anfangs sehr langsam – taugt es für Chat-Anwendungen?
Für Szenarien mit hohen Echtzeitanforderungen eignet es sich eher nicht. In AA v5.0.1 liegt die Latenz bis zum ersten Antwort-Token bei Carbon High bei etwa 68 Sekunden, bei Argon High bei etwa 37 Sekunden und bei Carbon Low bei etwa 12 Sekunden. Für Echtzeit-Interaktion empfehlen wir Argon. Carbon passt besser zu komplexen Analysen im Hintergrund und zu lang laufenden Agent-Aufgaben.
Q5: Wie vergleiche ich Argon und Carbon schnell per API?
Am besten nutzen Sie eine API-Aggregationsplattform, die mehrere Modelle unterstützt:
1. Registrieren Sie sich auf APIYI (apiyi.com) und holen Sie sich Ihren API-Schlüssel sowie ein kostenloses Testkontingent.
2. Setzen Sie `base_url` im Code auf `https://api.apiyi.com/v1`.
3. Ändern Sie nur den Parameter `model`, um zwischen beiden Modellen zu wechseln, und vergleichen Sie sie anschließend über verschiedene Reasoning-Stufen hinweg.
Q6: Kann ich Carbon auch ohne Google-AI-Ultra-Abo nutzen?
Ja. Das Ultra-Abo entscheidet lediglich darüber, ob Sie Carbon im Endnutzerbereich (etwa in der Gemini App) direkt auswählen können. AI Pro enthält hauptsächlich Argon. Entwickler können Carbon über die kostenpflichtige Stufe der Gemini API aufrufen, ohne Ultra zu kaufen. Beachten Sie jedoch, dass Google für die offizielle Carbon-API keine kostenlose Stufe anbietet.
Q7: Welche bekannten Einschränkungen hat Carbon?
Die Modellkarte nennt folgende Punkte: Halluzinationen sind weiterhin möglich, hohe Reasoning-Stufen können sehr viele Token verbrauchen, Antworten können langsam ausfallen oder in einen Timeout laufen, der Wissensstand reicht bis März 2026, und der Schutz vor Prompt Injection muss noch verbessert werden. Außerdem wird `thinking_budget` nicht unterstützt, und Sampling-Parameter werden ignoriert. Prüfen Sie das bei der Migration von altem Code.
Gemini 4 Argon und Carbon: die wichtigsten Erkenntnisse (Key Takeaways)
- Positionierung: Carbon baut auf Argon auf. Die beiden Modelle ergänzen sich und sind keine Variante in höherer oder niedrigerer Ausstattung.
- Hauptunterschied: Carbon denkt pro Runde mehr nach und prüft gründlicher. Argon antwortet schneller und ist pro Runde sparsamer.
- Benchmark-Ergebnis: In der Konfiguration AA v5.0.1 High erreicht Carbon insgesamt 60 Punkte, Argon 50 Punkte.
- Kosten im Detail: Der Preis pro Einheit ist gleich. Bei AA-Aufgaben liegen die Kosten pro Aufgabe mit Carbon High sogar unter denen von Argon High.
- Stufenwahl: Carbon steht standardmäßig auf MEDIUM. Wählen Sie nach dem Prinzip „die niedrigste Stufe, die ausreicht“ zwischen LOW, MEDIUM und HIGH.
- Einstieg: Über APIYI (apiyi.com) können Sie beide Modelle mit demselben OpenAI-kompatiblen Code testen.
Fazit
Die Unterschiede zwischen Gemini 4 Argon und Carbon lassen sich auf drei Punkte zusammenfassen:
- Unterschiedlicher Denkaufwand: Argon sorgt für Effizienz, Carbon setzt mehr Denk-Tokens ein, um die Grenzen komplexen Schlussfolgerns auszureizen.
- Latenz und Kosten getrennt betrachten: Carbon antwortet zum ersten Mal langsamer, kann in bestimmten Evaluierungen aber bei den Gesamtkosten einer vollständigen Aufgabe günstiger sein.
- Die Aufgabenschwierigkeit entscheidet: Für den Entwickleralltag greifen Sie zuerst zu Argon. Komplexe Engineering-Aufgaben, wissenschaftliches Schlussfolgern und Sicherheitsaudits übergeben Sie an Carbon.
Schicken Sie nicht jede Anfrage auf die höchste Reasoning-Stufe. Ermitteln Sie stattdessen anhand echter Aufgaben für jede Arbeitsart die Stufe, die gerade ausreicht. Nur so behalten Sie Qualität, Geschwindigkeit und Kosten im Griff. Mit APIYI (apiyi.com) können Sie schnell prüfen, wie beide Modelle in Ihrem Anwendungsfall abschneiden. Die Plattform bietet nutzungsbasierte Abrechnung und eine einheitliche Schnittstelle für mehrere Modelle.
📚 Referenzen
- Gemini 4 Carbon Model Card: Offizielle Model Card von Google DeepMind
- Link:
deepmind.google/models/model-cards/gemini-4-carbon -
Beschreibung: Carbon baut auf Argon auf; enthält Kontextspezifikationen, offizielle Evaluierungen und bekannte Einschränkungen
-
Choosing between Carbon and Argon: Entwicklerdokumentation von Google AI Studio
- Link:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
Beschreibung: Offizielle Positionierungsunterschiede der beiden Modelle und Empfehlungen zur Wahl des Thinking Level
-
Gemini 4 Carbon Developer Guide: Entwicklerleitfaden von Google Cloud
- Link:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
Beschreibung: Reasoning-Stufen, Einschränkungen bei API-Parametern und Hinweise zur Long-Decoding-Funktion
-
Gemini API Pricing: Google AI for Developers
- Link:
ai.google.dev/gemini-api/docs/pricing -
Beschreibung: Einführungspreis, Preisanpassung im Dezember sowie Abrechnungsregeln für Caching und Thinking-Tokens
-
Gemini 4 Carbon vs Gemini 4 Argon: Vergleichsseite von Artificial Analysis
- Link:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
Beschreibung: Vergleich von Leistung, Kosten und Latenz in der AA-Index-v5.0.1-Konfiguration „High“
-
MKA – Evaluierung für multimodale Wissensarbeit: Artificial Analysis
- Link:
artificialanalysis.ai/zh/evaluations/mka - Beschreibung: Führende Modelle nach Branchen sowie Daten zu den Kosten pro Aufgabe
Autor: APIYI Technik-Team
Austausch: Schreiben Sie uns gern über die Startseite von APIYI. Weitere Informationen zur Modellanbindung finden Sie im Dokumentationscenter unter docs.apiyi.com