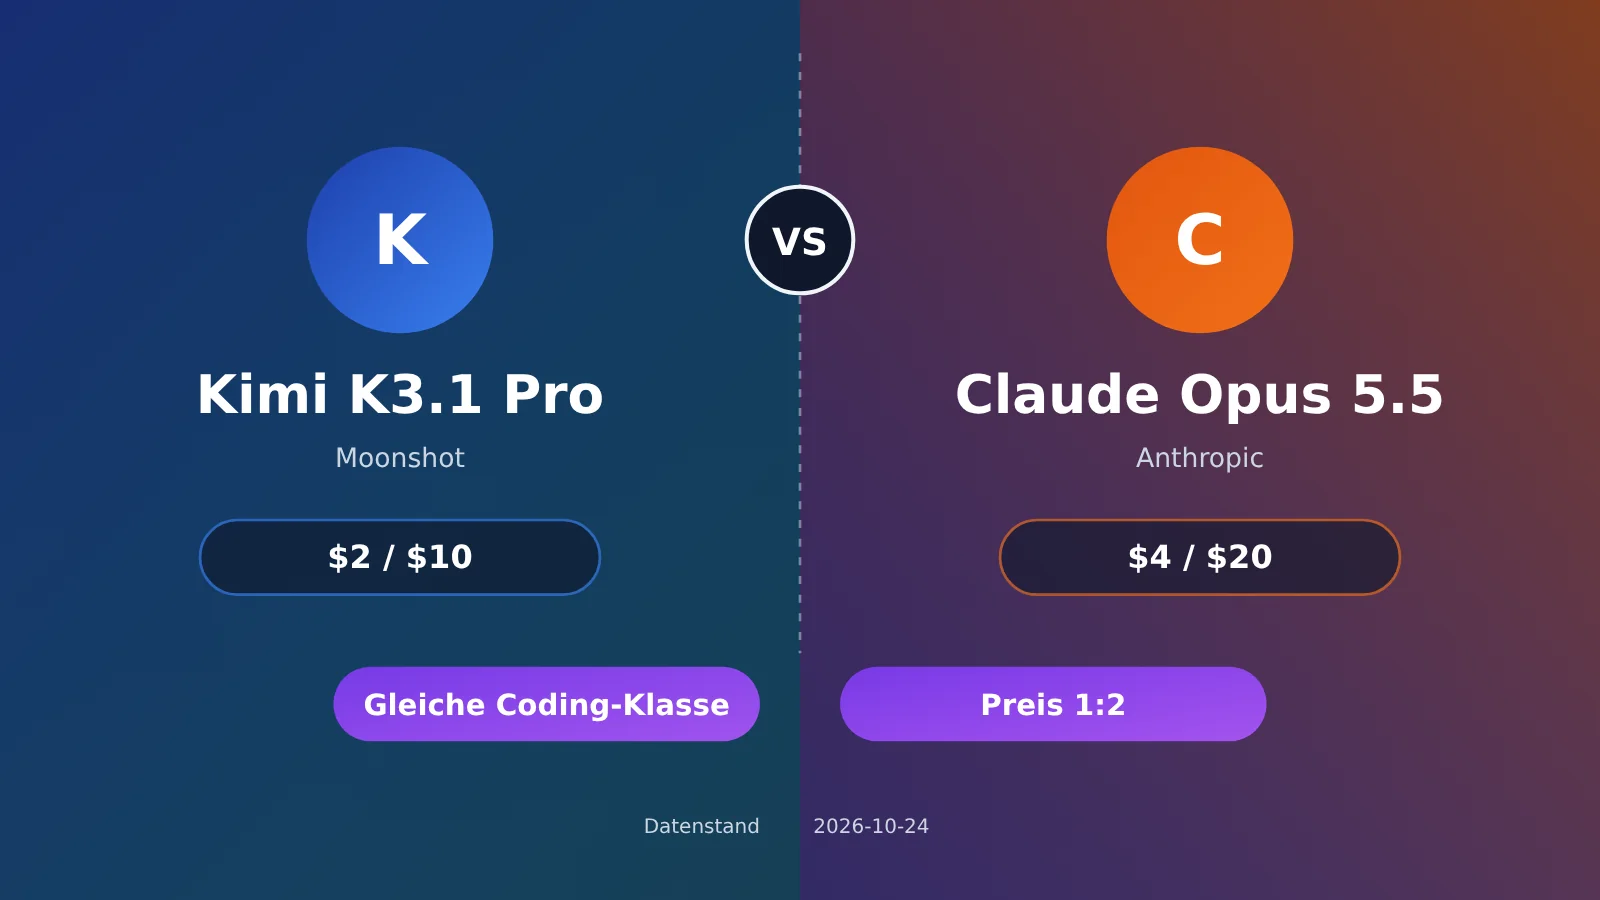
Kurz gesagt: Die Programmierfähigkeiten von Kimi K3.1 Pro und Claude Opus 5.5 liegen auf demselben Niveau. In den von Moonshot selbst veröffentlichten Ergebnissen für Terminal-Bench 4.0 erreicht K3.1 Pro 65,7 Prozent und Opus 5.5 66,4 Prozent – K3.1 Pro liegt also etwa 0,7 Prozentpunkte zurück. Betrachtet man nur die Ergebnisse von Artificial Analysis für Terminal-Bench 4.0, liegt K3.1 Pro hingegen vorn. Preislich ist K3.1 Pro bei Ein- und Ausgaben genau halb so teuer wie Opus 5.5 (2/10 US-Dollar gegenüber 4/20 US-Dollar). Die Preise für Cache-Treffer sind bei beiden gleich. Allerdings braucht K3.1 Pro länger für seine Denkprozesse. Laut Berechnungen eines Drittanbieters sind die tatsächlichen Kosten pro Aufgabe deshalb nicht halb so hoch.
Alle Daten im Folgenden sind mit ihrer Quelle gekennzeichnet und in drei Kategorien eingeteilt: vom Anbieter selbst veröffentlichte Angaben (Moonshot-Blog sowie offizielle Dokumentation von Kimi und Anthropic), Drittanbieterangaben (Artificial Analysis, im Folgenden AA) und nicht verifiziert (derzeit gibt es keine öffentlich zugänglichen Daten; möglich ist nur eine grobe Einschätzung). Tokens lassen sich als „Wort-Einheiten“ verstehen, nach denen das Modell abgerechnet wird. Ein chinesisches Schriftzeichen entspricht ungefähr etwas mehr als einem Token. Alle Preise sind in US-Dollar pro Million Tokens angegeben.
Dieser Artikel soll nicht zeigen, wer den anderen deutlich übertrifft. Beide Modelle haben Stärken und Schwächen. Wir stellen die Daten auf vergleichbarer Grundlage gegenüber und geben anschließend Empfehlungen für verschiedene Einsatzszenarien.
Der praktische Nutzen: Nach der Lektüre können Sie entscheiden, ob Sie für Ihre Aufgaben Kimi K3.1 Pro oder Claude Opus 5.5 verwenden sollten – und wissen, wie groß der tatsächliche Kostenunterschied zwischen beiden ist.
1. Kimi K3.1 Pro vs. Claude Opus 5.5: Die wichtigsten Unterschiede auf einen Blick
Die folgende Tabelle fasst die wichtigsten Unterschiede zusammen. In den nächsten Abschnitten gehen wir auf die einzelnen Punkte näher ein. Die Spalte „Quellenangabe“ zeigt, woher die jeweiligen Zahlen stammen, damit Sie sie selbst überprüfen können.
| Vergleichskriterium | Kimi K3.1 Pro | Claude Opus 5.5 | Quellenangabe |
|---|---|---|---|
| Terminal-Bench 4.0 (offizielle Angaben) | 65,7 % | 66,4 % | Eigene Angaben (Moonshot-Blog) |
| Terminal-Bench 4.0 (AA-Angaben) | 67 %, höchster Wert unter den von AA getesteten Modellen | In den Referenzquellen nicht aufgeführt | Drittanbieter (AA) |
| Preis für Ein- / Ausgabe | $2 / $10 | $4 / $20 | Offizielle Preisangaben |
| Preis bei Cache-Treffern | $0.20 | $0.20 | Offizielle Preisangaben |
| Kontextlänge | 1.048.576 Tokens | Bis zu 1 Mio. (je nach Modell) | Offizielle Dokumentation |
| Lässt sich der Denkmodus deaktivieren? | Nein, nur die Intensität lässt sich anpassen | Maßgeblich ist die Dokumentation von Anthropic | Offizielle Dokumentation / nicht verifiziert |
| Offene Gewichte | Veröffentlichung bis zum 04.11.2026 zugesagt | Nicht offen | Eigene Angaben |
„Kontext“ bezeichnet die Gesamtmenge an Inhalten, die ein Modell auf einmal verarbeiten kann. Beide Modelle erreichen eine Kontextlänge von einer Million Tokens. Damit lässt sich ein mittelgroßes Code-Repository im Grunde vollständig auf einmal eingeben. Dieser Punkt ist also kein entscheidender Unterschied bei der Auswahl.
2. Preisvergleich: Kimi K3.1 Pro vs. Claude Opus 5.5 – fünf Preise im direkten Vergleich
Zunächst zwei Begriffe zur Abrechnung: Cache-Treffer: Wenn du wiederholt denselben Text am Anfang sendest, etwa eine System-Eingabeaufforderung oder eine Zusammenfassung eines Code-Repositorys, speichert der Anbieter diesen Inhalt. Beim erneuten Abruf wird er dann zu einem deutlich niedrigeren Preis berechnet. Cache-Schreibvorgang: Diese Gebühr fällt an, wenn der Inhalt zum ersten Mal im Cache gespeichert wird. Die Preise unterscheiden sich je nachdem, ob der Inhalt 5 Minuten oder 1 Stunde gespeichert wird.
| Modell | Eingabe | Ausgabe | Cache-Treffer | Cache-Schreibvorgang, 5 Minuten | Cache-Schreibvorgang, 1 Stunde |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5 (zum Vergleich) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
Preisangaben: abgerufen am 24.10.2026; in US-Dollar pro Million Tokens, ohne Steuern. Quelle: offizielle Preisangaben von Kimi und Anthropic.
2.1 Preisunterschiede: Eingabe und Ausgabe kosten doppelt so viel, Cache-Treffer gleich viel
Bei Eingabe und Ausgabe kostet Opus 5.5 genau doppelt so viel wie K3.1 Pro. Für Cache-Treffer verlangen beide Anbieter $0.20, hier gibt es also keinen Unterschied. Beim Cache-Schreibvorgang ist Kimi günstiger: Für 5 Minuten fallen $2 statt $5 an, für 1 Stunde $4 statt $8.
Nimmt man Claude Sonnet 5.5 als Vergleich hinzu, zeigt sich: Die Preise für Eingabe und Ausgabe sind identisch mit denen von K3.1 Pro. Der Preis für Cache-Treffer liegt mit $0.10 sogar nur bei der Hälfte. Wenn du also nach einer günstigeren Variante im Flaggschiff-Segment suchst, ist Sonnet 5.5 der direktere Vergleich zu Kimi – nicht nur Opus 5.5.
2.2 Beide Modelle haben eine schnelle Variante
Beide Anbieter bieten schnellere, aber teurere Varianten an. Achte beim Vergleich darauf, nicht die falschen Versionen gegenüberzustellen:
kimi-k3.1-pro-highspeed: $4 / $20, Cache-Treffer $0.20, Cache-Schreibvorgang für 5 Minuten $4 und für 1 Stunde $8 (offizielle Preisangaben)- Claude Opus 5.5 im Fast-Modus: $8 / $40, gilt für das gesamte Kontextfenster, auch für Abschnitte über 200k Tokens hinaus (offizielle Preisangaben)
Die Preise für Eingabe und Ausgabe der schnellen Kimi-Version entsprechen denen der regulären Opus-5.5-Version. Der Cache-Schreibvorgang für 5 Minuten ist bei Kimi dennoch günstiger.
3. Kimi K3.1 Pro vs. Claude Opus 5.5: Programmier-Benchmarks nach zwei getrennten Bewertungsmaßstäben
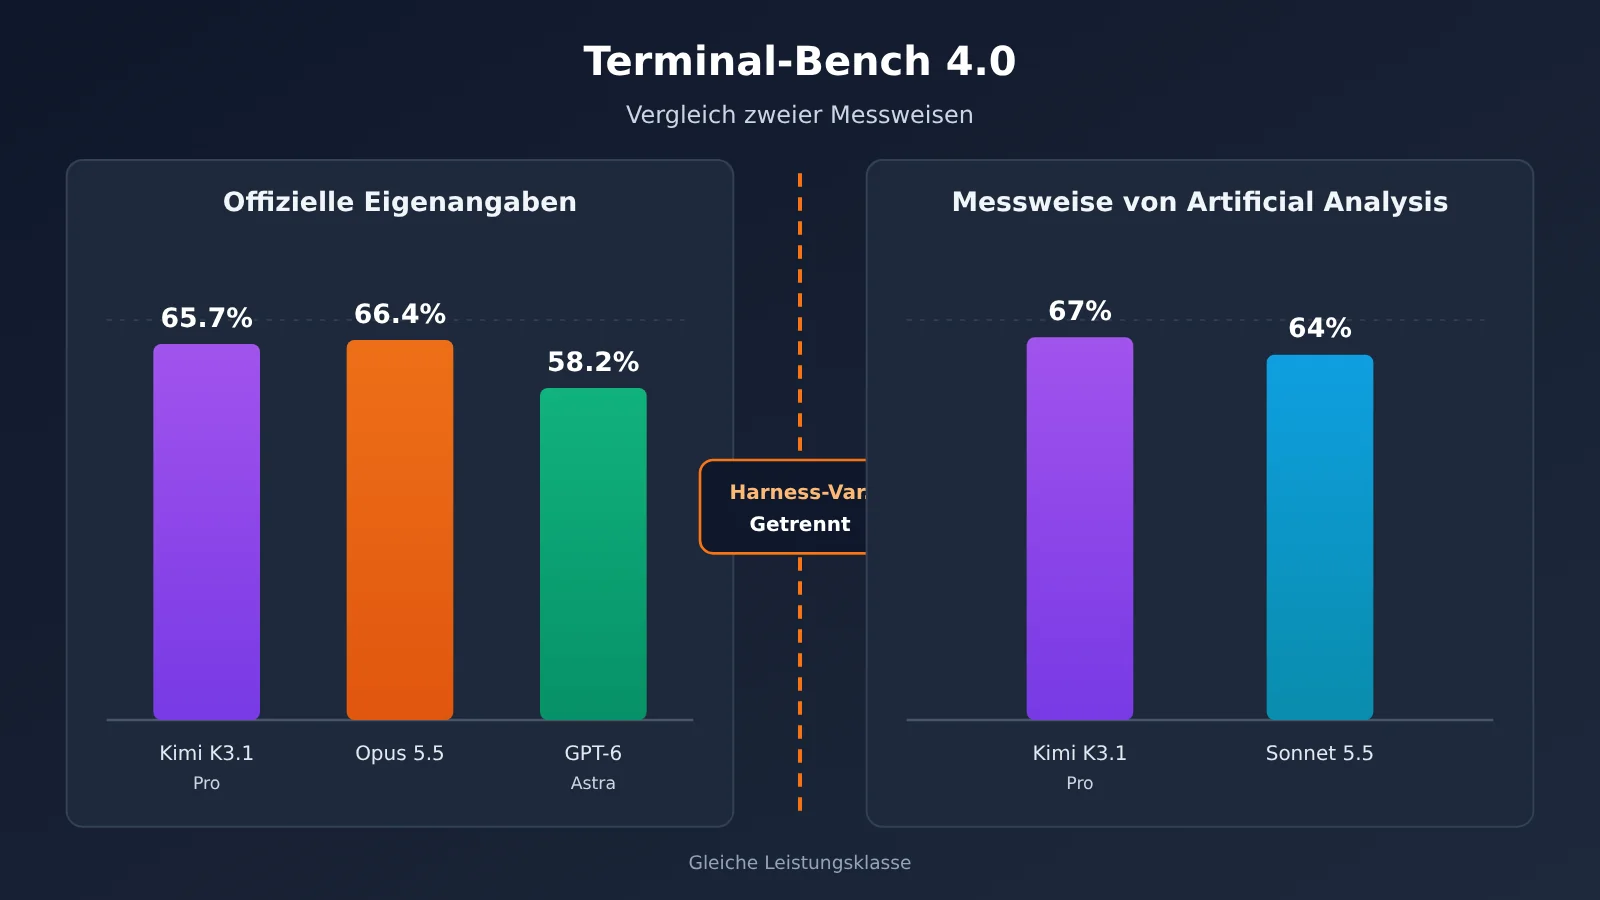
Terminal-Bench 4.0 prüft, ob reale Aufgaben im Terminal erledigt werden können – zum Beispiel Abhängigkeiten installieren, Fehler beheben oder Skripte ausführen. Als bestanden gilt ein Test nur, wenn das Endergebnis korrekt ist. Die beiden folgenden Tabellen stammen von unterschiedlichen Organisationen. Die Zahlen sind daher nicht direkt miteinander vergleichbar.
3.1 Offizielle, selbst veröffentlichte Ergebnisse (Moonshot-Blog)
| Test | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | 58,2 % |
| BenchCAD (3D-Rekonstruktion durch CAD-Code aus mehreren Ansichten) | 92,7 % (mit Tools) | 96,2 % | — |
Als Testbedingung wurde reasoning_effort auf max gesetzt, die Denkintensität also auf die höchste Stufe. K3.1 Pro wurde mit dem Harness von Claude Code ausgeführt. Moonshot beschreibt das Ergebnis im eigenen Blog als „narrowly behind Claude Opus 5.5“, also als knapp hinter Opus 5.5 liegend.
3.2 Angaben eines Drittanbieters (Artificial Analysis, 23.10.2026)
| Test | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index (Gesamtindex für Intelligenz) | 55 (Platz 4) | 58 | 56 |
| Terminal-Bench 4.0 | 67 % (höchster Wert im Feld) | In den Quellen nicht aufgeführt | 64 % |
| GDPval-AA (Elo) | 1846 (Platz 3) | 1866 | — |
| AA-Omniscience (Wissenszuverlässigkeit) | Index 30, Halluzinationsrate 44 % | In den Quellen nicht aufgeführt | — |
Für den Gesamtindex von Opus 5.5 wurde die Testbedingung „max with fallback“ verwendet. Muse Wonder Full erreichte in derselben Rangliste ebenfalls 56 Punkte. Elo ist ein Wertungssystem ähnlich dem im Schach: Die Punktzahl ergibt sich aus Siegen und Niederlagen in direkten Vergleichen. Je höher der Wert, desto besser. Die Halluzinationsrate lässt sich vereinfacht als Anteil der Fälle verstehen, in denen das Modell eine Antwort erfindet, statt einzugestehen, dass es die Frage nicht beantworten kann. Die 44 % von K3.1 Pro sind daher ein beachtenswerter Wert.
3.3 Warum sich die beiden Messverfahren nicht zusammenrechnen lassen
Die offiziellen 65,7 % und die 67 % von AA sind beide Ergebnisse von K3.1 Pro im Terminal-Bench 4.0. Die Tests wurden jedoch mit unterschiedlichen Harnesses durchgeführt. Ein Harness ist gewissermaßen das „Prüfungsprogramm“ für das Modell. Es legt fest, welche Werkzeuge das Modell verwenden kann, wie es Dateien liest und schreibt und wie lange es Zeit hat. Wird dieses Prüfungsprogramm geändert, kann sich auch die Punktzahl desselben Modells ändern.
Deshalb sollte man nicht sagen: „K3.1 Pro hat bei AA 67 % erreicht und liegt damit über den offiziellen 66,4 % von Opus.“ Korrekt ist: Nach offizieller Messmethode liegt K3.1 Pro um 0,7 Prozentpunkte zurück. Nach der Messmethode von AA erzielte K3.1 Pro den höchsten Wert unter den von dieser Organisation getesteten Modellen. Beide Aussagen sind für sich genommen richtig. Zusammengenommen zeigen sie lediglich, dass die beiden Modelle im selben Leistungsbereich liegen.
3.4 Was bedeutet ein Punkt Unterschied in der Praxis?
Terminal-Bench 4.0 bewertet Aufgaben strikt: Das Ergebnis ist entweder bestanden oder nicht bestanden. Ein Prozentpunkt entspricht ungefähr einer Aufgabe mehr oder weniger pro 100 Aufgaben. Solche Unterschiede zeigen sich oft bei seltenen Long-Tail-Aufgaben, etwa bei wenig verbreiteten Toolchains oder speziellen Umgebungskonfigurationen. Beim Schreiben von Schnittstellen, Ändern von Geschäftscode oder Ergänzen von Unit-Tests ist ein so kleiner Unterschied im Alltag kaum spürbar.
Was sich tatsächlich auf die Entwicklungserfahrung auswirkt, sind zwei Unterschiede im „Charakter“ der Modelle. Erstens der Denkstil: K3.1 Pro denkt immer nach. AA beobachtete, dass die Ausgaben pro Aufgabe länger ausfallen (Drittanbieter). Zweitens die Gewohnheiten beim Aufrufen von Tools – etwa wie oft das Modell Befehle ausführt oder ob es Dateien eher erst liest, bevor es sie ändert. Dazu gibt es derzeit keine verlässlichen öffentlichen Vergleichsdaten (nicht verifiziert). Am besten testen Sie das mit einigen realistischen Aufgaben in Ihrem eigenen Repository.
4. Vor- und Nachteile von Kimi K3.1 Pro und Claude Opus 5.5
Vorteile von Kimi K3.1 Pro (offizielle Dokumentation):
- Die Preise für Ein- und Ausgabe betragen die Hälfte der Preise von Opus 5.5; auch das Schreiben in den Cache ist günstiger.
- Kontextfenster mit 1.048.576 Tokens;
max_completion_tokensist standardmäßig auf 131072 gesetzt und kann bis auf 1048576 erhöht werden. - Kompatibel mit den Schnittstellenformaten von OpenAI und Anthropic. Der offizielle Anbieter empfiehlt den Einsatz in Programmier-Agenten wie Kimi Code, Codex und Claude Code.
- Unterstützt strukturierte Ausgaben, Tool-Aufrufe und das Fortsetzen mit
partial. API-Kunden können eine Speicherung von Daten ausschließen. Der Anbieter verspricht, die vollständigen Gewichte bis zum 04.11.2026 bereitzustellen.
Einschränkungen von Kimi K3.1 Pro (offizielle Dokumentation und Drittanbieter):
- Der Denkmodus lässt sich nicht ausschalten.
reasoning_effortkann nur auflow,highodermaxgesetzt werden; standardmäßig giltmax. temperatureist fest auf 1.0 undtop_pauf 0.95 eingestellt. Diese Parameter lassen sich nicht selbst übergeben.- Bei Bildeingaben werden keine öffentlichen URLs unterstützt. Bilder müssen entweder als Base64-kodierte Daten (eine lange Textzeichenfolge) oder über
ms://file-idübermittelt werden. - AA maß eine Halluzinationsrate von 44 Prozent; die Ausgaben pro Aufgabe fallen vergleichsweise lang aus.
Vorteile von Claude Opus 5.5: Bei den offiziellen Benchmark-Ergebnissen und im Gesamtindex von AA liegt das Modell vorn. Bei BenchCAD beträgt der Vorsprung etwa 3,5 Prozentpunkte, und auch bei GDPval-AA schneidet es besser ab. Mit einer Cache-Stufe von einer Stunde und dem Fast-Modus lässt sich je nach Bedarf zwischen Geschwindigkeit und Kosten abwägen. Die wichtigste Einschränkung ist der Preis: Ein- und Ausgabe kosten doppelt so viel wie bei K3.1 Pro; im Fast-Modus verdoppeln sich die Kosten nochmals.
5. Kimi K3.1 Pro vs. Claude Opus 5.5: Empfehlungen für 6 Aufgabentypen
Ein „Agent“ ist eine Modellanwendung, die selbstständig Arbeitsschritte planen, Tools aufrufen und Aufgaben über mehrere Interaktionen hinweg ausführen kann – zum Beispiel ein Programmierassistent, der Code automatisch anpasst und anschließend Tests ausführt.
| Aufgabentyp | Empfehlung | Fazit in einem Satz |
|---|---|---|
| Große Mengen an Offline-Aufgaben | Kimi K3.1 Pro | Der Preis pro Einheit ist halb so hoch, und auch das Schreiben in den Cache ist günstiger. Bei Stapelverarbeitung fällt die Ersparnis besonders deutlich aus. |
| Programmier-Agenten mit mehreren Interaktionen | Beide sind geeignet; am besten selbst testen | In Benchmarks liegen sie auf ähnlichem Niveau. Entscheidend ist vor allem, ob die Länge der Denkprozesse und der Umgang mit Tool-Aufrufen zu deinem Repository passen. |
| Generierung von 3D- und CAD-Code | Claude Opus 5.5 | Laut eigenen Angaben des Anbieters liegt das Ergebnis bei BenchCAD bei 96,2 % gegenüber 92,7 % – Opus 5.5 arbeitet zuverlässiger. |
| Bildverständnis | Je nach Anbindung auswählen | K3.1 Pro unterstützt Bilder, kann aber keine öffentlichen URLs direkt verarbeiten. Für die Bildfähigkeiten beider Modelle fehlen vergleichbare Daten (nicht verifiziert). |
| Unternehmensanwendungen mit hohen Anforderungen an Stabilität und Compliance | Tendenz zu Claude Opus 5.5; bei Bedarf an Datenkontrolle kommt Kimi infrage | Opus 5.5 erzielt insgesamt einen höheren Index. Kimi bietet eine Speicherung ohne Datenaufbewahrung und will seine Gewichte demnächst veröffentlichen. |
| Szenarien mit niedriger Latenz, in denen das Denken deaktiviert werden muss | Claude | Bei K3.1 Pro lässt sich das Denken nicht deaktivieren. Die Einstellungen für den Denkmodus bei Claude richten sich nach der Anthropic-Dokumentation; alternativ kommt auch der Fast-Modus infrage. |
6. Kimi K3.1 Pro vs. Claude Opus 5.5: Die Kosten im Vergleich – halbierter Preis bedeutet nicht halbe Kosten
Rechnen wir kurz nach: Bei einer Anfrage mit 50.000 Tokens Eingabe und 5.000 Tokens Ausgabe ergibt sich Folgendes:
- Kimi K3.1 Pro: 50.000 × $2 ÷ 1.000.000 + 5.000 × $10 ÷ 1.000.000 = $0,10 + $0,05 = $0,15
- Claude Opus 5.5: 50.000 × $4 ÷ 1.000.000 + 5.000 × $20 ÷ 1.000.000 = $0,20 + $0,10 = $0,30
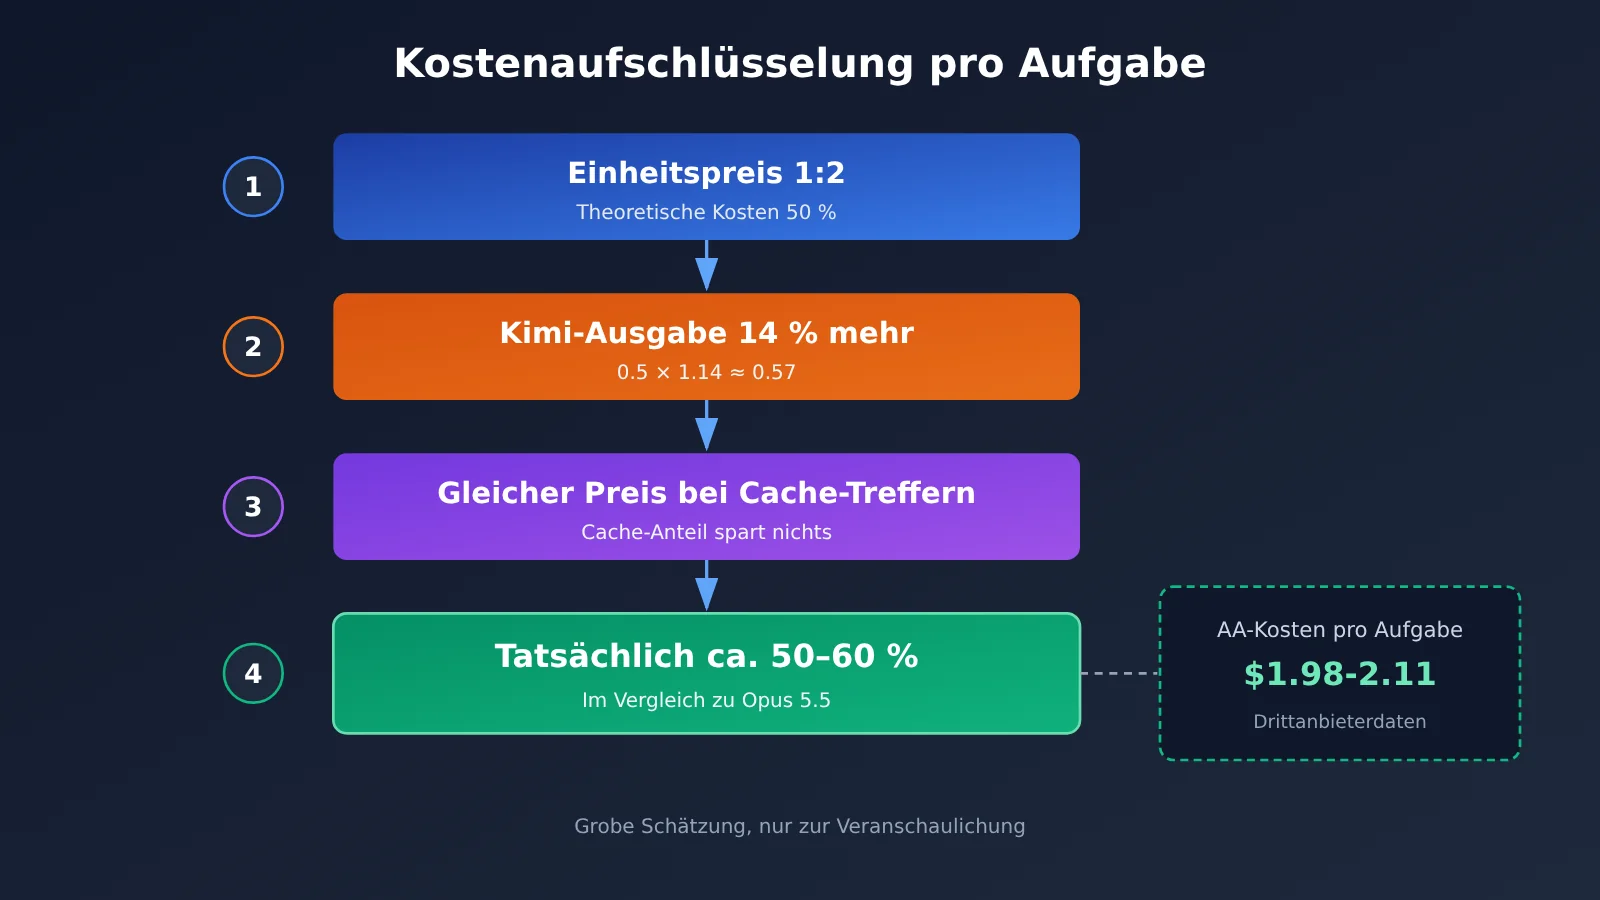
Gemessen am Preis pro Token ist Kimi also genau halb so teuer. Das gilt allerdings nur unter einer Voraussetzung: Beide Modelle erzeugen gleich lange Ausgaben. In der Praxis ist das nicht der Fall. Laut den Daten von AA erzeugt Kimi pro Aufgabe etwa 14 % mehr Ausgabetokens. Im Durchschnitt sind es rund 55.000 Ausgabetokens pro Aufgabe, was Kosten von etwa $1,98 pro Aufgabe entspricht (auf der Modellseite werden $2,11 angegeben) (Drittanbieter). AA kommt zu dem Schluss: Kimi kostet pro Token zwar nur halb so viel wie Opus 5.5, aber sein Denkprozess ist ausführlicher. Deshalb ist eine einzelne Aufgabe in der Praxis nicht halb so teuer.
Eine grobe Schätzung (nicht überprüft, nur zur Veranschaulichung): Bei Programmieraufgaben mit einem Agenten entfällt der größte Teil der Kosten auf die Ausgabe. Wenn Kimi 14 % mehr ausgibt, betragen die Kosten für die Ausgabe etwa 1,14 × 0,5 ≈ 57 % der Kosten von Opus 5.5. Die Ersparnis liegt also bei etwas mehr als 40 % und nicht bei der Hälfte. Das ist immer noch beachtlich – bei der Budgetplanung sollte man jedoch nicht mit 50 % Ersparnis rechnen.
7. Kimi K3.1 Pro und Claude Opus 5.5 in China aufrufen
Entwickler in China stoßen bei der direkten Anbindung an offizielle Schnittstellen im Ausland oft auf Probleme mit der Bezahlung und der Netzwerkverbindung. APIYI (apiyi.com) ist eine API-Aggregationsplattform, über die sich mehrere Modelle mit einem einzigen API-Schlüssel aufrufen lassen. Die Schnittstelle ist mit dem OpenAI-Format kompatibel und wird nutzungsbasiert abgerechnet. Laut Abgleich vom 24.10.2026 kostet claude-opus-5-5 auf der Plattform 4 $ pro Eingabe, 20 $ pro Ausgabe und 0,2 $ für das Lesen aus dem Cache. Für claude-sonnet-5-5 liegen die Preise bei 2 $ / 10 $ / 0,1 $ – beide Modelle entsprechen damit den Preisen von Anthropic. Aktuell sind folgende Modelle der Kimi-Serie verfügbar:
kimi-k3: 3 $ / 15 $, Lesen aus dem Cache: 0,3 $kimi-k2.7-code: 0,95 $ / 3,99 $kimi-k2.6: 0,6 $ / 2,4 $kimi-k2.5: 0,6 $ / 3,15 $
kimi-k3.1-pro war an diesem Tag noch nicht in der Liste enthalten. Den Modellnamen und Preis bei APIYI entnehmen Sie bitte der Modellübersicht der Plattform. Wir werden dieses Modell so bald wie möglich anbieten. Die Anbindung funktioniert wie folgt:
- OpenAI-kompatibles Format:
base_urlaufhttps://api.apiyi.com/v1setzen - Anthropic-Format: Als Basisadresse
https://api.apiyi.comeintragen - Programmieragenten wie Claude Code verwenden in der Regel das Anthropic-Format, gewöhnliche SDKs das OpenAI-Format
Tipp für den schnellen Einstieg: Nutzen Sie zunächst das kostenlose Startguthaben für Neukunden bei APIYI auf apiyi.com. Führen Sie mit
claude-opus-5-5undclaude-sonnet-5-5ein paar echte Aufgaben in Ihrem eigenen Repository aus und verwenden Sie die Ergebnisse als Vergleichsbasis. Die verfügbaren Modelle und Preise finden Sie in der Modellübersicht der Plattform. Kimi K3.1 Pro werden wir so bald wie möglich anbieten. Sobald das Modell verfügbar ist, können Sie einfach den Modellnamen ändern und es direkt vergleichen.
8. Entscheidungshilfe: Kimi K3.1 Pro vs. Claude Opus 5.5
Wenn du viele Aufgaben hast, auf dein Budget achten musst und damit leben kannst, dass das Modell ständig im Denkmodus läuft, bietet Kimi K3.1 Pro das bessere Preis-Leistungs-Verhältnis. Wenn dir eine insgesamt zuverlässige Leistung wichtig ist, du 3D-/CAD-Inhalte generieren möchtest oder für geringe Latenz den Denkmodus ausschalten musst, passt ein Modell von Claude – Opus 5.5 oder Sonnet 5.5 – besser. Bei mehrstufigen Programmieraufgaben mit Agenten liegen beide auf einem ähnlichen Niveau. Statt dich auf Ranglisten zu verlassen, solltest du die Modelle eine Woche lang mit deiner eigenen Codebasis testen.
Eine weitere Option wird leicht übersehen: Wenn du Kimi vor allem wegen des „halben Preises“ in Betracht ziehst, solltest du auch Claude Sonnet 5.5 auf die Liste setzen. Die Preise pro Ein- und Ausgabe sind identisch, der Preis für Cache-Treffer ist niedriger und auch der AA-Gesamtindex fällt etwas höher aus.
Häufig gestellte Fragen (FAQ)
Q1: Wie groß ist der Unterschied bei der Programmierleistung von Kimi K3.1 Pro und Claude Opus 5.5?
Laut den von Moonshot veröffentlichten eigenen Ergebnissen liegt K3.1 Pro bei Terminal-Bench 4.0 um 0,7 Prozentpunkte zurück (65,7 % gegenüber 66,4 %). In den unabhängigen Tests von AA erzielt K3.1 Pro bei Terminal-Bench 4.0 dagegen den höchsten Wert aller getesteten Modelle. Beide liegen auf einem ähnlichen Niveau; der Unterschied beträgt ungefähr 1–3 Prozentpunkte.
Q2: Wie groß ist der Preisunterschied?
Die Preise pro Ein- und Ausgabe unterscheiden sich um den Faktor 2. Der Preis für Cache-Treffer ist gleich (jeweils 0,20 $), beim Schreiben in den Cache ist Kimi günstiger. Da Kimi längere Ausgaben erzeugt, liegen die tatsächlichen Kosten pro Aufgabe schätzungsweise bei etwa 50 bis 60 % der Kosten von Opus 5.5.
Q3: Warum unterscheiden sich die offiziellen 65,7 % von den 67 % bei AA?
Die Tests verwenden unterschiedliche Test-Harnesses. Moonshot nutzt den Claude-Code-Harness. Ergebnisse aus unterschiedlichen Testverfahren lassen sich jeweils nur innerhalb desselben Verfahrens vergleichen, nicht direkt miteinander.
Q4: Kann man bei Kimi K3.1 Pro den Denkmodus ausschalten?
Nein. Du kannst nur `reasoning_effort` auf `low` setzen. Auch `temperature` und `top_p` sind fest eingestellt. Wenn es auf besonders geringe Latenz ankommt, empfiehlt sich ein Modell von Claude.
Q5: Wie kann ich die beiden Modelle innerhalb Chinas parallel aufrufen und vergleichen?
Über APIYI unter apiyi.com kannst du `claude-opus-5-5` mit demselben API-Schlüssel aufrufen. Setze dazu `base_url` auf `https://api.apiyi.com/v1`. Die Modellbezeichnung und der Preis für Kimi K3.1 Pro richten sich nach der Modellliste der Plattform. Wir werden dieses Modell so bald wie möglich anbieten. Bis dahin kannst du mit `kimi-k3` einen ersten Vergleich durchführen.
Q6: Welches Modell eignet sich für Einsteiger zum Üben?
Wir empfehlen, zunächst mit Claude Sonnet 5.5 eine Vergleichsbasis zu schaffen. Der Preis pro Einheit ist derselbe wie bei K3.1 Pro. Nach der Registrierung bei APIYI unter apiyi.com steht ein kostenloses Testguthaben zur Verfügung. Die verfügbaren Modelle und Preise findest du in der Modellliste der Plattform. K3.1 Pro werden wir so bald wie möglich anbieten; nach dem Start kannst du zum Vergleich einfach die Modellbezeichnung wechseln.
Kimi K3.1 Pro vs. Claude Opus 5.5: Die wichtigsten Erkenntnisse
- Programmieren auf ähnlichem Niveau: Laut offiziellen Angaben liegt K3.1 Pro um 0,7 Prozentpunkte zurück. In den AA-Tests erreicht K3.1 Pro bei Terminal-Bench 4.0 den Spitzenwert.
- Preisverhältnis 1:2: 2/10 US-Dollar gegenüber 4/20 US-Dollar; der Preis für Cache-Treffer beträgt bei beiden 0,20 US-Dollar.
- Die Kosten halbieren sich nicht: Kimi gibt pro Aufgabe etwa 14 % mehr aus. AA ermittelte Kosten von 1,98 bis 2,11 US-Dollar pro Aufgabe.
- Testergebnisse nicht vermischen: Die offiziellen 65,7 % und die 67 % von AA basieren auf unterschiedlichen Test-Harnesses.
- Stärken von Opus: Opus liegt beim Gesamtindex, bei BenchCAD und bei GDPval-AA vorn.
- Einschränkungen von Kimi: Der Denkmodus lässt sich nicht deaktivieren, Bilder können nicht über öffentliche URLs übermittelt werden, und die Halluzinationsrate liegt bei 44 %.
- Einstieg: Claude-Modelle können Sie zunächst auf APIYI apiyi.com testen. Modellbezeichnungen und Preise für K3.1 Pro entnehmen Sie bitte der Modellübersicht der Plattform. Wir werden das Modell so bald wie möglich anbieten.
Fazit
Der Vergleich zwischen Kimi K3.1 Pro und Claude Opus 5.5 lässt sich auf drei Punkte bringen:
- Leistungsfähigkeit: Bei Programmier- und Agent-Fähigkeiten liegen beide auf einem ähnlichen Niveau. Die Punktunterschiede bewegen sich im Rahmen von Testungenauigkeiten und unterschiedlichen Testmethoden.
- Preis: Der Preis pro Token unterscheidet sich genau um den Faktor 2. Da Kimi jedoch länger nachdenkt, liegen die tatsächlichen Kosten ungefähr 40 % niedriger.
- Modellauswahl: Für umfangreiche Aufgaben und bei knappem Budget ist Kimi eine gute Wahl. Für 3D/CAD, niedrige Latenz und hohe Anforderungen an die Gesamtstabilität empfiehlt sich Claude.
Am zuverlässigsten ist ein Test mit den eigenen Aufgaben. Sie können zunächst mit Claude-Modellen auf APIYI apiyi.com eine Vergleichsbasis schaffen. Modellbezeichnungen und Preise finden Sie in der Modellübersicht der Plattform. Kimi K3.1 Pro werden wir so bald wie möglich anbieten. Nach dem Start können Sie einfach den Modellnamen wechseln und die Ergebnisse vergleichen.
Referenzen
- Offizieller Moonshot-Blog und Kimi-API-Dokumentation: Benchmarks, Parameterbeschränkungen und Preise von K3.1 Pro
- Link:
platform.moonshot.cn/docs -
Hinweis: Von Moonshot veröffentlichte Ergebnisse für Terminal-Bench 4.0 und BenchCAD sowie Erläuterungen zu den Parametern
-
Offizielle Anthropic-Preise: Fünf Preisstufen für Claude Opus 5.5 und Sonnet 5.5
- Link:
anthropic.com/pricing -
Hinweis: Einschließlich Fast-Modus und einer Cache-Option mit einer Stunde Laufzeit
-
Artificial Analysis: Unabhängige Gesamtindizes und Kosten pro Aufgabe
- Link:
artificialanalysis.ai -
Hinweis: Daten vom 23.10.2026, einschließlich Terminal-Bench 4.0, GDPval-AA und AA-Omniscience
-
Modellübersicht von APIYI: Plattformmodelle und Preise
- Link:
docs.apiyi.com/models - Hinweis: Stand der Prüfung: 24.10.2026. Maßgeblich ist die aktuelle Modellübersicht.
Autor: Technisches Team von APIYI
Technischer Austausch: Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com. Maßgeblich für Modelle und Preise ist die Modellübersicht der Plattform. Wir werden Kimi K3.1 Pro so bald wie möglich anbieten.