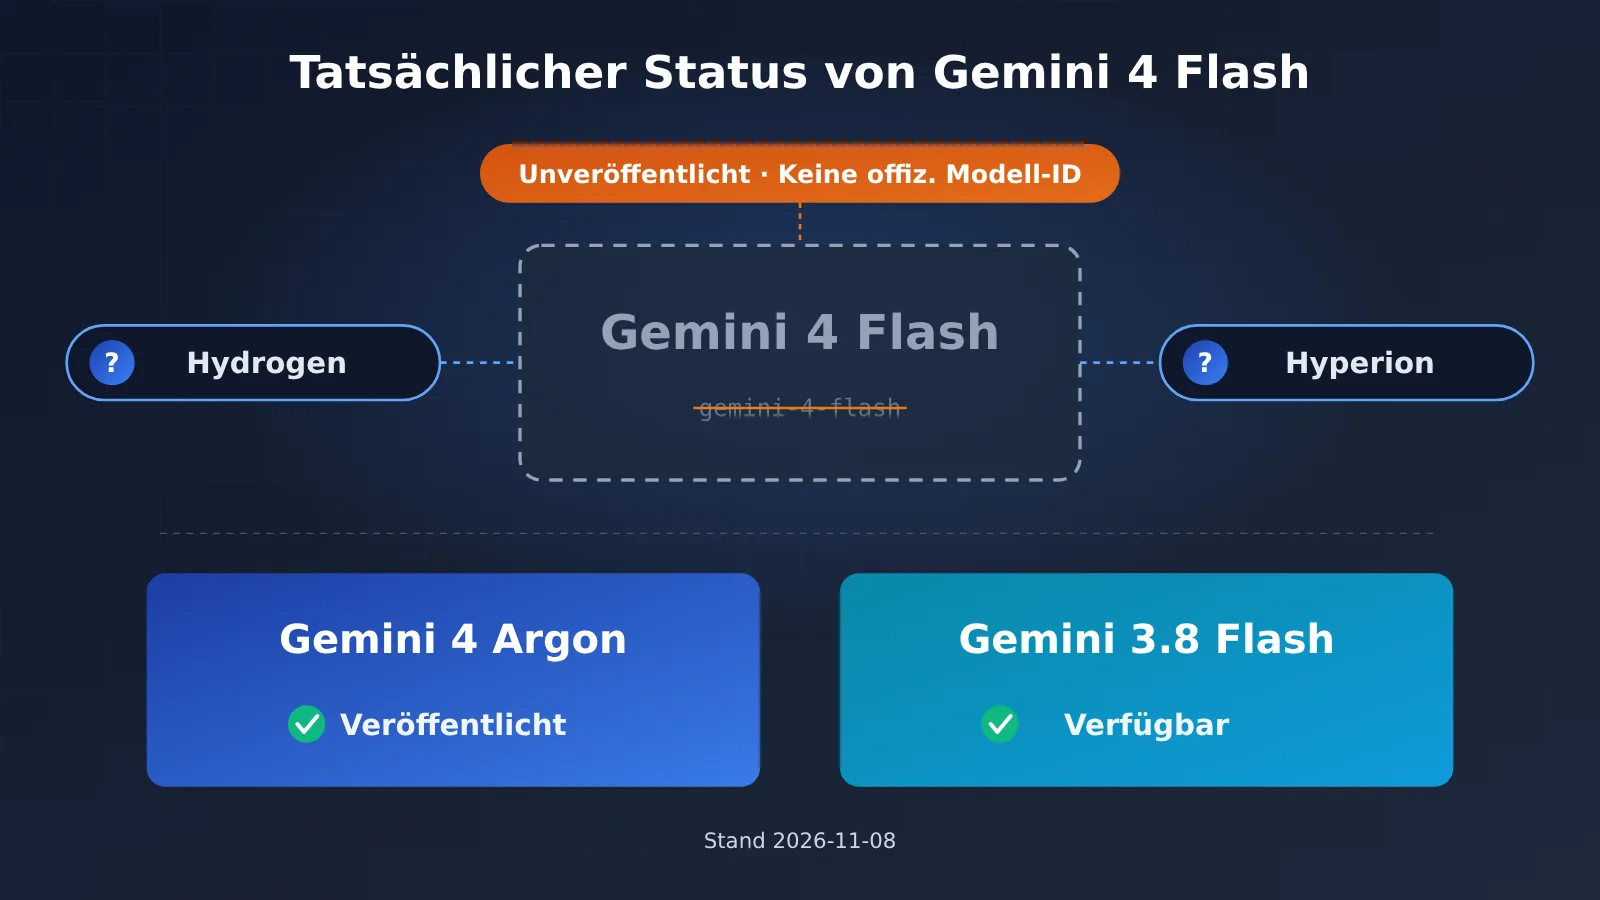
Anmerkung des Autors: Stand 8. November 2026 gibt es für Gemini 4 Flash noch keine offizielle Modell-ID. Dieser Artikel untersucht die Quellen der Hinweise auf die Codenamen Hydrogen und Hyperion, grenzt das Modell von Gemini 4 Argon und Gemini 3.8 Flash ab und zeigt, wie Sie sich bis zur Veröffentlichung auf die Modellauswahl vorbereiten können.
Das Wichtigste vorweg: Gemini 4 Flash ist noch nicht veröffentlicht. Bis zum 8. November 2026 hat Google keine offizielle Modell-ID für Gemini 4 Flash bekannt gegeben. Auch in der Modellreferenz der Gemini API ist gemini-4-flash nicht zu finden. Ein offizielles Veröffentlichungsdatum gibt es ebenfalls nicht. Falls Ihr Team seine Planung aussetzen will, weil „Flash nächste Woche kommt“, warten Sie damit lieber noch.
Aktuell stehen zwei Modelle für Aufrufe zur Verfügung: gemini-4-argon, wenn Sie die Fähigkeiten eines Flaggschiffmodells und einen langen Kontext benötigen, und Gemini 3.8 Flash, wenn es auf viele gleichzeitige Anfragen, geringe Latenz und kontrollierbare Kosten ankommt. Die Codenamen Hydrogen und Hyperion sind zwar interessant, bislang aber nur Hinweise aus Leaks und kein Zeichen für eine bevorstehende Veröffentlichung.
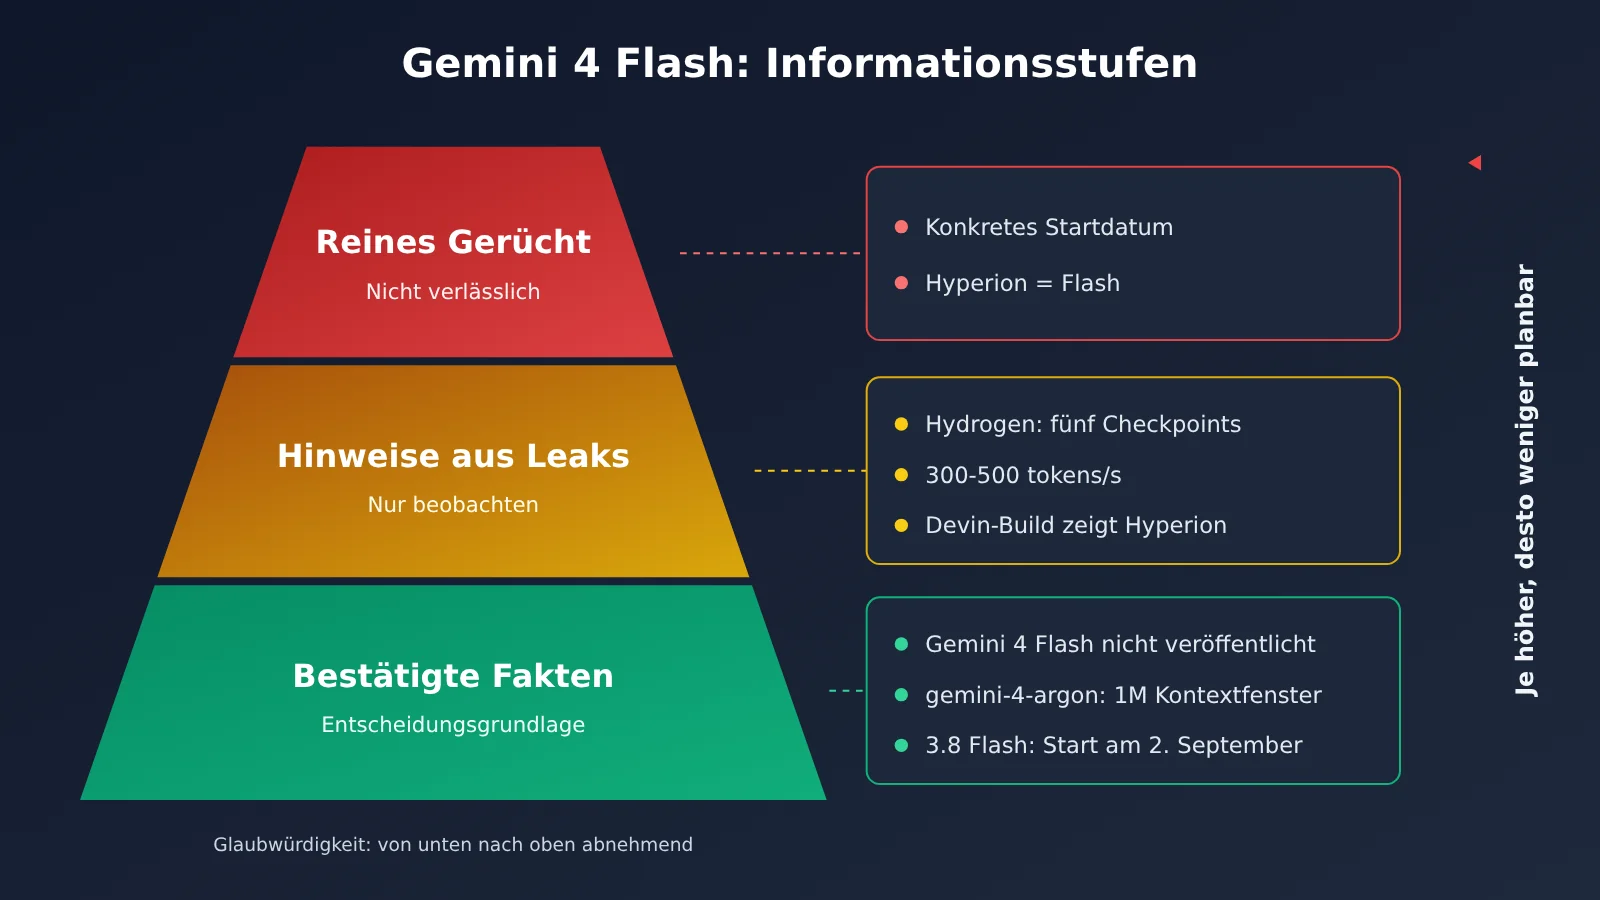
Das ist keine Kritik am neuen Modell. Wir trennen lediglich „bestätigte Fakten“, „Hinweise aus Leaks“ und „reine Gerüchte“, damit Sie Ihre Planung auf überprüfbare Informationen stützen können.
Das Wichtigste auf einen Blick: In drei Minuten erfahren Sie, wo Gemini 4 Flash wirklich steht, und erhalten eine Entscheidungshilfe dazu, was Sie bereits nutzen und wie Sie sich bis zur Veröffentlichung vorbereiten können.
Ist Gemini 4 Flash erschienen? Ein klares Kriterium
Bevor ein Team über Gerüchte zu einer Modellveröffentlichung diskutiert, sollte es sich auf gemeinsame Kriterien einigen. Sonst sieht der Produktmanager eine Meldung, die Entwicklerin einen Screenshot – und beide verstehen etwas anderes unter „veröffentlicht“. Wir empfehlen, ausschließlich die offiziellen Veröffentlichungskanäle von Google als Grundlage zu nutzen und mehrere Bedingungen gleichzeitig zu prüfen.
| Prüfkriterium | Konkrete Anforderung | Aktueller Stand bei Gemini 4 Flash |
|---|---|---|
| Offizielle Modell-ID | Auf der Modellreferenzseite der Gemini-API-Dokumentation aufgeführt | ❌ Nicht aufgeführt, nur gemini-4-argon |
| Preisseite | Preis des Modells auf der Preisseite der Gemini API aufgeführt | ❌ Nein |
| In AI Studio auswählbar | Direkt im Modellauswahlmenü von AI Studio auswählbar | ❌ Keine offizielle Auswahlmöglichkeit |
| Offizielle Ankündigung | Veröffentlichung im offiziellen Google-Blog oder über einen offiziellen Account | ❌ Keine |
Die Regel ist einfach: Erst wenn die ersten drei Kriterien gleichzeitig erfüllt sind, gilt das Modell als „veröffentlicht“. Eine offizielle Ankündigung ist ein Pluspunkt. Ohne Modell-ID und Preis können Entwickler das Modell aber auch mit einer Ankündigung noch nicht in einer Produktionsumgebung einsetzen. Nach diesem Maßstab erfüllt Gemini 4 Flash keines der vier Kriterien – das Ergebnis ist eindeutig.
Dieser Maßstab hat einen weiteren Vorteil: Teams können ihn direkt in ihren Prozess zur Modellfreigabe aufnehmen. Ob Gemini, Claude oder ein neues Modell eines anderen Anbieters – zuerst wird diese Hürde geprüft. Danach lässt sich entscheiden, ob sich der Aufwand für eine Evaluierung lohnt.
💡 Praktischer Hinweis: Neben der offiziellen Dokumentation ist auch die Modellliste des jeweiligen Zugangsanbieters ein nützlicher Prüfpunkt. Bei APIYI apiyi.com zeigt beispielsweise die Modellliste in der Konsole, ob ein Modell aufrufbar ist. Modelle, über die nur spekuliert wird, erscheinen dort nicht, nur weil ein Gerücht viel Aufmerksamkeit bekommt.
Gemini 4 Flash: Fakten, Leaks und Gerüchte im Vergleich
Statt jede Behauptung einzeln zu diskutieren, ist es hilfreicher, die derzeit kursierenden Informationen nach ihrer Glaubwürdigkeit einzuordnen. Die folgende Tabelle bildet die Grundlage für die Einschätzungen in diesem Artikel:
| Information | Kategorie | Quelle | Als Entscheidungsgrundlage geeignet? |
|---|---|---|---|
| Gemini 4 Flash ist nicht veröffentlicht; es gibt keine offizielle Modell-ID | Bestätigte Tatsache | Modellreferenz der Gemini API | ✅ Ja |
gemini-4-argon ist veröffentlicht, hat ein Kontextfenster von 1M und ist über die API verfügbar |
Bestätigte Tatsache | Dokumentation der Gemini API | ✅ Ja |
| Gemini 3.8 Flash ist das aktuellste Flash-Modell und wurde am 2. September 2026 veröffentlicht | Bestätigte Tatsache | Offizielle Veröffentlichung von Google | ✅ Ja |
| Gemini 4 Flash trägt intern den Codenamen Hydrogen und hat fünf Checkpoints | Leak-Hinweis | Bericht eines Accounts auf X | ⚠️ Nur beobachten |
| Hydrogen erreicht eine Ausgabegeschwindigkeit von 300-500 tokens/s | Leak-Hinweis | Bericht eines Accounts auf X | ⚠️ Keine Grundlage für die Kapazitätsplanung |
| Seit Ende Oktober laufen A/B-Tests auf LMArena und in AI Studio | Leak-Hinweis | Bericht eines Accounts auf X | ⚠️ Nur beobachten |
| In einem Devin-Build taucht die Modellfamilie Hyperion auf | Leak-Hinweis | Devin-Build von Cognition | ⚠️ Vom Anbieter nicht bestätigt |
| „Hyperion ist Gemini 4 Flash“ | Reine Spekulation | Vermutung aus der Community | ❌ Nein |
| „Gemini 4 Flash erscheint an einem bestimmten Datum“ | Reines Gerücht | Keine offizielle Quelle | ❌ Nein |
Gemini 4 Flash mit dem Codenamen Hydrogen: Wie belastbar sind die Hinweise?
Hydrogen ist derzeit der Codename, der am engsten mit Gemini 4 Flash in Verbindung gebracht wird. Gerüchten auf X zufolge trägt Gemini 4 Flash intern diesen Namen und hat bereits fünf Checkpoints durchlaufen. Demnach soll das Modell 300–500 Tokens pro Sekunde ausgeben und seit Ende Oktober in A/B-Tests auf LMArena und in AI Studio eingesetzt werden.
Das klingt zwar konkret, doch die Quelle ist entscheidend: Alle Aussagen zu Hydrogen stammen von X-Accounts, nicht aus offiziellen Google-Dokumenten, Blogbeiträgen oder Modellkarten. Fünf Checkpoints deuten darauf hin, dass das Modell intern noch weiterentwickelt wird – nicht darauf, dass es kurz vor der Fertigstellung steht.
Was bedeuten die Hinweise auf Hydrogen für Entwickler?
Selbst wenn man alle Gerüchte für bare Münze nimmt, lassen sich daraus nur begrenzte Schlüsse ziehen. A/B-Tests bedeuten, dass das Modell möglicherweise anonym auf Evaluierungsplattformen auftaucht. Nutzer können es dort weder gezielt auswählen noch erhalten sie eine stabile Modell-ID. Auch die Spanne von 300–500 Tokens pro Sekunde ist groß. Ohne Angaben zu den Testbedingungen lässt sich daraus weder die Latenz noch die Kapazität für parallele Anfragen deines Dienstes abschätzen.
Für Entwickler ist vor allem diese Einordnung hilfreich: Hydrogen deutet darauf hin, dass Google wahrscheinlich an einem Flash-Modell der Gemini-4-Familie arbeitet. Zeitpunkt, Preise und Leistungsgrenzen sind aber weiterhin offen. Du kannst das Modell auf deine Beobachtungsliste setzen, solltest deine Zeitplanung aber nicht davon abhängig machen.
- Das kannst du tun: Die Modellreferenz und die Preisseite der Gemini-API-Dokumentation verfolgen und Änderungen an der Modellauswahl in AI Studio im Blick behalten.
- Das solltest du nicht tun: Timeout-Parameter in der Produktion vorsorglich anhand von 300–500 Tokens pro Sekunde anpassen oder den Start einer Funktion verschieben, um auf Hydrogen zu warten.
Codename Hyperion: Wie hängt er mit Gemini 4 Argon zusammen?
Hyperion stammt aus einer anderen Quelle als Hydrogen. Der Name tauchte in einem Build von Devin, dem Produkt von Cognition, als Bezeichnung einer Modellfamilie auf – in der Liste vor Gemini 4 Argon. Diese Position führte in der Community zu Spekulationen, dass Hyperion mit der Gemini-4-Reihe zusammenhängt.
Dabei sind zwei Punkte wichtig: Erstens hat kein Hersteller bestätigt, was Hyperion ist. Es könnte sich um ein Google-Modell handeln, aber auch nur um einen internen Codenamen von Cognition für eine Vorschauversion. Zweitens gibt es selbst dann, wenn Hyperion tatsächlich ein Google-Modell ist, keinerlei Belege dafür, dass es zur Flash-Klasse gehört.
Warum Hyperion nicht mit Gemini 4 Flash gleichzusetzen ist
Modellnamen in Produkten von Drittanbietern stimmen häufig nicht mit den offiziellen Namen der Hersteller überein. Entwickler vergeben oft Codenamen für Vorschaumodelle – etwa für interne Tests, schrittweise Umstellungen oder aus Geheimhaltungsgründen. Auch die Reihenfolge in einer Liste kann sich einfach nach Alphabet, Veröffentlichungszeitpunkt oder interner Priorität richten. Daraus lassen sich keine Modellspezifikationen ableiten.
Hyperion zeigt also nur, dass eine noch nicht öffentlich vorgestellte Modellfamilie in einem Build eines Drittanbieters aufgetaucht ist. Mehr nicht. Wer Hyperion und Hydrogen zusammenführt und daraus schließt, „Gemini 4 Flash wird bereits in Devin eingesetzt“, interpretiert die Kombination dieser Hinweise falsch.
Gemini 4 Argon und Gemini 3.8 Flash: Zwei Modelle, die heute verfügbar sind
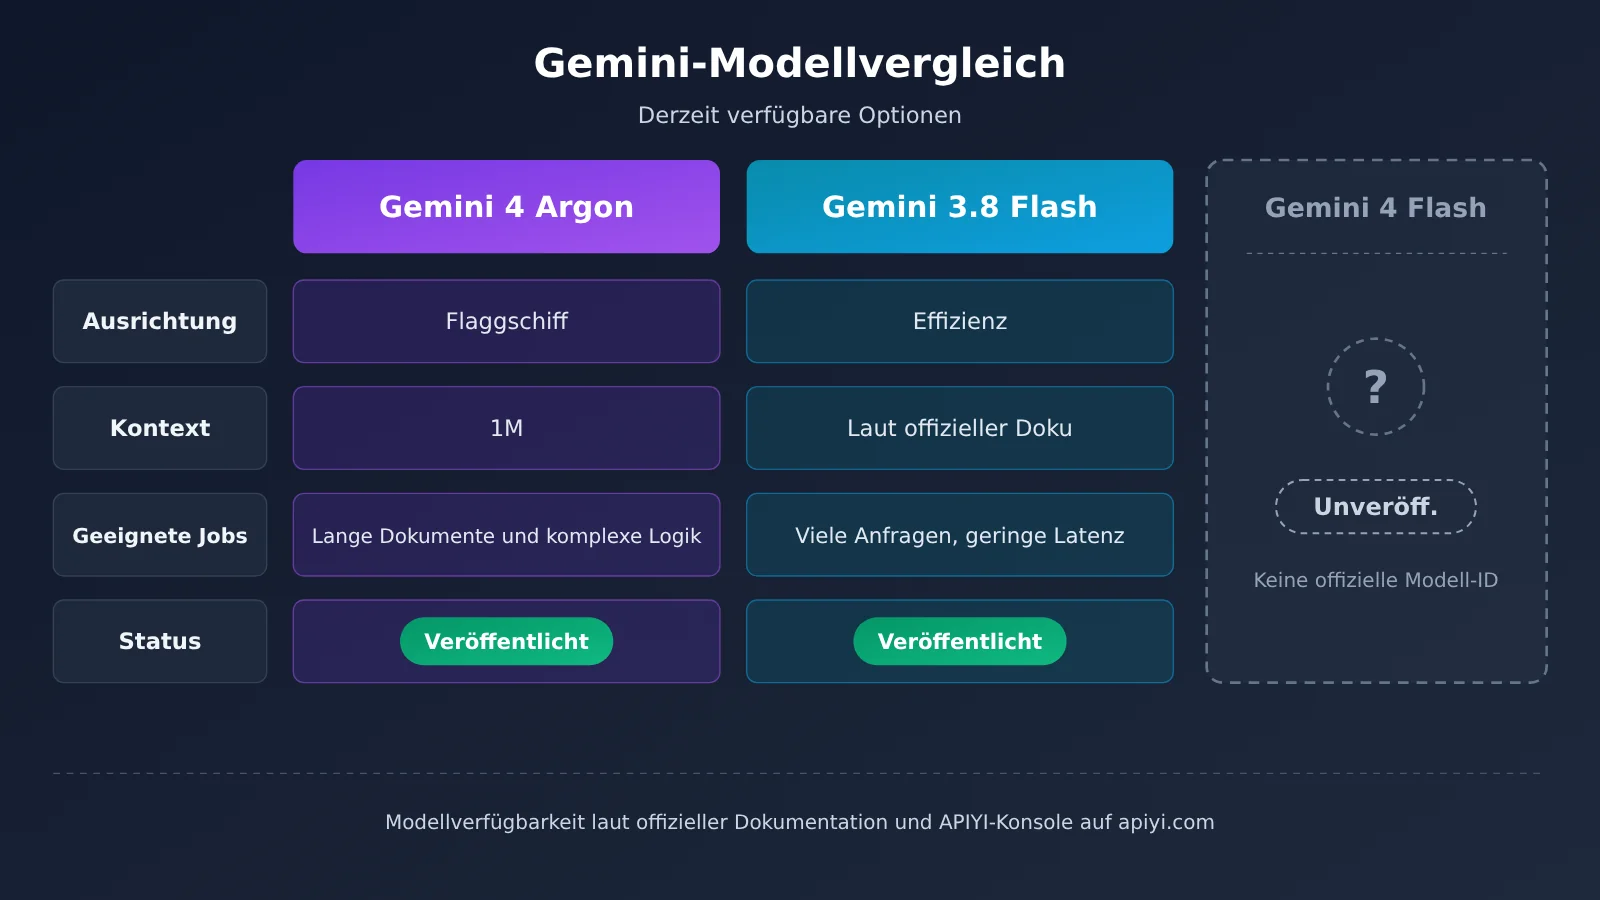
Bis Gemini 4 Flash erscheint, sind diese beiden Gemini-Modelle die wichtigsten Optionen für Entwickler. Ihre Ausrichtung ist klar unterschiedlich: Das eine stellt die Leistungsfähigkeit in den Vordergrund, das andere die Effizienz.
Gemini 4 Argon: Das veröffentlichte Flaggschiff der Gemini-4-Familie
gemini-4-argon ist das erste Flaggschiff der Gemini-4-Familie und derzeit das einzige Gemini-4-Modell in der Modellreferenz der Gemini API. Es unterstützt ein Kontextfenster von 1M und ist bereits über die offizielle API verfügbar. Geeignet ist es für die Analyse langer Dokumente, das Verständnis großer Codebasen, komplexe Schlussfolgerungen über mehrere Dateien hinweg und Aufgaben, bei denen die Antwortqualität wichtiger ist als die Geschwindigkeit.
Wichtig ist: Argon und Gemini 4 Flash gehören zur selben Generation, sind aber in unterschiedlichen Leistungsklassen angesiedelt. Dass Argon verfügbar ist, bedeutet nicht, dass Flash unmittelbar folgen wird. Zum Zeitplan für beide Modelle gibt es keine offiziellen Angaben.
Gemini 3.8 Flash: Die derzeit aktuellste Flash-Option
Gemini 3.8 Flash wurde am 2. September 2026 veröffentlicht und ist derzeit das neueste Flash-Modell von Google. Es ist für kostensensitive Aufgaben mit vielen gleichzeitigen Anfragen und niedriger Latenz ausgelegt, etwa für die Stapelklassifizierung, Informationsextraktion, erste Antworten im Kundensupport, Echtzeitvervollständigung und einfache Tool-Aufrufe in Agents.
Bis Gemini 4 Flash erscheint, ist 3.8 Flash die naheliegendste Wahl in der Flash-Klasse. Statt auf die nächste Generation zu warten, lohnt es sich, zunächst Leistung und Kosten von 3.8 Flash zu testen. Diese Daten dienen später als Vergleichsbasis für Gemini 4 Flash.
| Modell | Offizielle Modell-ID / Status | Hauptmerkmale | Einsatzbereiche | Verfügbare Plattformen |
|---|---|---|---|---|
| Gemini 4 Argon | gemini-4-argon, veröffentlicht |
Erstes Gemini-4-Flaggschiff, 1M Kontextfenster | Langer Kontext, komplexe Schlussfolgerungen, hochwertige Antworten | Offizielle Google API, APIYI apiyi.com |
| Gemini 3.8 Flash | Veröffentlicht (2026-09-02) | Aktuellstes Flash-Modell, niedrige Latenz | Viele gleichzeitige Anfragen, Echtzeitantworten, kostensensitive Aufgaben | Offizielle Google API, APIYI |
| Gemini 4 Flash | Keine offizielle Modell-ID | Nicht veröffentlicht | Noch nicht planbar | Maßgeblich sind die offizielle Dokumentation und die Modellliste in der Konsole |
Die richtige Wahl vor dem Start von Gemini 4 Flash: Argon und 3.8 Flash kombinieren
Die meisten Produktionssysteme müssen nicht ausschließlich auf ein einziges Modell setzen. Zuverlässiger ist es, Aufgaben nach Anforderungen aufzuteilen: Argon und 3.8 Flash übernehmen jeweils ihre Stärken, während Modelle anderer Anbieter bei Bedarf als Fallback oder zum Vergleich dienen.
- Komplexe Aufgaben mit Argon: Qualitätskritische Aufgaben wie die Recherche in langen Kontexten, dokumentübergreifende Zusammenfassungen und Code-Reviews übernimmt
gemini-4-argon. - Häufige Aufgaben mit 3.8 Flash: Gemini 3.8 Flash bearbeitet Aufgaben mit hohem Aufrufvolumen und geringem Wert pro Aufruf, etwa Klassifizierung, Extraktion, Umformulierung und Absichtserkennung.
- Kaskadiertes Routing: Zunächst bearbeitet 3.8 Flash die Aufgabe. Ist die Konfidenz zu niedrig oder die Eingabe zu lang, wird an Argon weitergeleitet. So lassen sich Kosten und Qualität ausbalancieren.
- Anbieterübergreifender Vergleich: Für kritische Abläufe bleibt ein Claude- oder OpenAI-Modell als Alternative verfügbar, damit Schwankungen bei einem einzelnen Anbieter den Betrieb nicht beeinträchtigen.
Diese Architektur hat noch einen weiteren Vorteil: Sobald Gemini 4 Flash tatsächlich erscheint, lässt sich das neue Modell auf der Ebene für häufige Aufgaben schrittweise testen. Die Auswirkungen bleiben dabei überschaubar. Werden dagegen jetzt schon alle Aufrufe fest auf ein Modell programmiert, ist ein späterer Wechsel aufwendiger.
🎯 Empfehlung: Bei der Kombination mehrerer Modelle ist die Anbindung verschiedener API-Schlüssel und Abrechnungssysteme oft der grösste Aufwand. Über APIYI apiyi.com lassen sich Gemini 4 Argon, Gemini 3.8 Flash sowie Modelle von Claude, OpenAI und anderen Anbietern mit einem einzigen API-Schlüssel aufrufen. Die Schnittstelle ist mit dem OpenAI-Format kompatibel; für einen Modellwechsel muss nur der Parameter
modelgeändert werden. Das erleichtert das oben beschriebene Routing.
Vor dem Release von Gemini 4 Flash: vier technische Vorbereitungen
Den Zeitplan nicht wegen Gerüchten zu ändern, heißt nicht, untätig zu bleiben. Der professionelle Ansatz ist, die Integration neuer Modelle technisch vorzubereiten. So können Sie Gemini 4 Flash innerhalb weniger Stunden statt erst nach Wochen evaluieren – unabhängig davon, wann es erscheint.
| Vorbereitung | Konkrete Maßnahme | Vorteil nach dem Modellstart |
|---|---|---|
| Evaluierungsdatensatz | Repräsentative Beispiele aus dem echten Betrieb auswählen sowie Eingaben und Bewertungskriterien festlegen | Das neue Modell lässt sich sofort testen, statt es nach Gefühl zu beurteilen |
| Modell-Mapping | Im Anwendungscode nur logische Namen wie fast-tier verwenden und diese per Konfiguration konkreten Modell-IDs zuordnen |
Zum Modellwechsel muss nur die Konfiguration geändert werden, nicht der Anwendungscode |
| Kostenbasis | Aktuellen Tokenverbrauch, Kosten pro Anfrage und Latenzverteilung für Argon und 3.8 Flash erfassen | Es lässt sich genau berechnen, ob das neue Modell tatsächlich günstiger und schneller ist |
| Rollback und schrittweise Einführung | Einen festgelegten Anteil des Datenverkehrs umstellen und eine Rückfalloption zum alten Modell bereithalten | Bei unerwartet schlechter Leistung lässt sich schnell zurückwechseln |
Modell-Mapping und Evaluierungsdatensatz: Modellwechsel per Konfiguration
Das Modell-Mapping wird von den vier Vorbereitungen am leichtesten übersehen – und lohnt sich besonders. Empfehlenswert ist eine Zuordnung „logische Leistungsstufe → Modell-ID“ in der zentralen Konfiguration, zum Beispiel quality-tier für gemini-4-argon und fast-tier für Gemini 3.8 Flash. Wenn Sie APIYI für die Anbindung nutzen, verwenden alle Modelle dieselbe base_url: https://api.apiyi.com/v1. In der Zuordnung müssen Sie dann nur die Modellnamen pflegen, nicht für jedes Modell eine eigene Adresse und einen eigenen Schlüssel.
Der Evaluierungsdatensatz sollte drei Arten von Beispielen abdecken: typische Anfragen, seltene schwierige Fälle und Fälle, die in der Vergangenheit Probleme verursacht haben. Der Datensatz muss nicht groß sein. Wichtig ist, dass er feststeht und sich wiederholt ausführen lässt. Sobald Gemini 4 Flash eine offizielle Modell-ID hat, können Sie denselben Datensatz durchlaufen lassen und das Ergebnis direkt mit 3.8 Flash vergleichen.
Kostenbasis und Nutzungsprotokolle: Daten statt Vermutungen
Für eine Kostenbasis brauchen Sie echte Aufrufdaten – nicht den offiziellen Stückpreis multipliziert mit einer geschätzten Menge. Erfassen Sie mindestens eine Woche bis einen Monat lang Tokenverbrauch und Anfragezahlen nach Modell und Geschäftsbereich und protokollieren Sie zusätzlich die P50- und P95-Latenz. Wenn ein neues Modell als „schneller und günstiger“ beworben wird, können Sie das anhand Ihrer eigenen Daten überprüfen.
📊 Daten-Tipp: APIYI apiyi.com bietet eine einheitliche Abrechnung und Nutzungsprotokolle. Die Aufrufe verschiedener Modelle werden zentral erfasst und eignen sich daher, um die Kostenbasis für Argon und 3.8 Flash zu erstellen. Für konkrete Preise und Verfügbarkeit sind die Angaben in der Konsole und der Dokumentation maßgeblich.
Häufige Fragen zu Gemini 4 Flash
F1: Lässt sich Gemini 4 Flash derzeit aufrufen?
Nein. Stand 8. November 2026 hat Google Gemini 4 Flash nicht veröffentlicht. In der Gemini-API-Dokumentation gibt es keine Modell-ID `gemini-4-flash`, und ein offizielles Datum wurde nicht genannt. Das einzige derzeit verfügbare Gemini-4-Modell ist `gemini-4-argon`.
F2: Sind Hydrogen und Hyperion dasselbe Modell?
Dafür gibt es keine Belege. Hydrogen stammt aus einem Leak auf X über den angeblichen internen Codenamen von Gemini 4 Flash. Hyperion tauchte in einem Devin-Build von Cognition auf und wurde vom Anbieter nicht bestätigt. Es könnte sich um ein Google-Modell oder um einen von Cognition vergebenen Codenamen für eine Vorschauversion handeln. Die beiden Bezeichnungen stammen aus unterschiedlichen Quellen und sollten weder zusammengeführt noch als offizielle Informationen betrachtet werden.
F3: Auf Gemini 4 Flash warten oder zuerst Gemini 3.8 Flash nutzen?
Nutzen Sie zunächst Gemini 3.8 Flash. Es ist das aktuell neueste Flash-Modell und eignet sich für Aufgaben mit vielen gleichzeitigen Anfragen, niedrigen Latenzanforderungen und begrenztem Budget. Die jetzt gesammelten Evaluierungs- und Kostendaten dienen später als Vergleichsbasis für Gemini 4 Flash. Über APIYI apiyi.com können Sie 3.8 Flash und Argon mit demselben API-Schlüssel aufrufen und so zunächst ein abgestuftes Modellkonzept testen.
F4: Wie lässt sich nach der Veröffentlichung sofort prüfen, ob Gemini 4 Flash verfügbar ist?
Prüfen Sie die im Artikel genannten Kriterien: Eine offizielle Modell-ID muss in der Gemini-API-Dokumentation stehen, die Preisseite muss Preise ausweisen und das Modell muss in AI Studio auswählbar sein. Erst wenn alle drei Bedingungen erfüllt sind, gilt es als veröffentlicht. Ob es bereits über APIYI apiyi.com verfügbar ist, zeigt die Modellliste in der Konsole. Sobald das entsprechende Modell dort erscheint, können Sie es mit Ihrem vorbereiteten Evaluierungsdatensatz testen.
Gemini 4 Flash: Die wichtigsten Punkte und eine Checkliste für Gerüchte
Das Wichtigste in Kürze:
- Veröffentlichungsstatus: Gemini 4 Flash war bis zum 8. November nicht veröffentlicht. Es gibt weder eine offizielle Modell-ID noch ein offizielles Datum.
- Hydrogen: Ein von einem X-Account genannter interner Codename. Weder die fünf Checkpoints noch die 300–500 Tokens/s sind offiziell bestätigt.
- Hyperion: Tauchte in einem Devin-Build vor Argon auf. Der Hersteller hat das Modell nicht bestätigt; daraus lässt sich nicht ableiten, dass es sich um Flash handelt.
- Gemini 4 Argon: Das erste veröffentlichte Flaggschiffmodell von Gemini 4 bietet ein Kontextfenster von 1M und ist per API verfügbar.
- Gemini 3.8 Flash: Am 2. September 2026 veröffentlicht und derzeit die realistischste Wahl in der Flash-Klasse.
- Handlungsempfehlung: Die Planung nicht aufschieben. Stattdessen jetzt ein Evaluierungsset, eine Modellzuordnung, eine Kostenbasis und einen Rollback-Mechanismus vorbereiten.
Checkliste zur Prüfung von Gemini-4-Flash-Gerüchten
Wenn Sie das nächste Mal lesen, dass „Gemini 4 Flash verfügbar ist“, können Sie die Meldung anhand dieser Checkliste prüfen:
| Prüfpunkt | So prüfen Sie | Kriterium |
|---|---|---|
| Offizielle Modell-ID | Die Modellreferenz in der Gemini-API-Dokumentation prüfen | Eine eindeutige Modell-ID für Gemini 4 Flash ist aufgeführt |
| Preise | Die Preisseite der Gemini API prüfen | Preise für Eingabe und Ausgabe sind aufgeführt |
| AI Studio | Die Modellauswahl in AI Studio öffnen | Das Modell lässt sich gezielt auswählen und ist nicht nur Teil eines anonymen A/B-Tests |
| Offizielle Ankündigung | Den offiziellen Google-Blog oder offizielle Accounts prüfen | Ein offizieller Artikel zur Veröffentlichung liegt vor |
| Informationsquelle | Den ursprünglichen Ursprung der Meldung zurückverfolgen | Die Meldung stammt aus offizieller Quelle, nicht von einem X-Account oder aus einem Build eines Drittanbieters |
| Zuordnung des Codenamens | Prüfen, ob es eine offizielle Zuordnung von Codename und endgültigem Namen gibt | Die Zuordnung ist offiziell bestätigt und keine Vermutung der Community |
| Verfügbarkeit für die Integration | Die Modellliste in der Konsole Ihrer Plattform prüfen | Das Modell steht in der Liste und lässt sich aufrufen |
Erst wenn die ersten drei Punkte erfüllt sind, gilt das Modell als veröffentlicht. Die übrigen vier helfen dabei, die Glaubwürdigkeit der Meldung einzuschätzen. Solange der erste Punkt nicht erfüllt ist, gehört die Information in die Kategorie „Beobachten“ und nicht „Entscheiden“ – ganz gleich, wie konkret die Gerüchte klingen.
Zusammenfassung
Der Stand zu Gemini 4 Flash lässt sich in drei Punkten zusammenfassen:
- Es ist noch nicht veröffentlicht: Es gibt weder eine offizielle Modell-ID noch Preise oder ein Datum. Hydrogen und Hyperion sind lediglich Hinweise.
- Es gibt bereits Alternativen:
gemini-4-argonübernimmt Aufgaben, die ein Spitzenmodell und ein langes Kontextfenster erfordern. Gemini 3.8 Flash eignet sich für viele gleichzeitige Anfragen und geringe Latenz. - Vorbereitung ist wichtiger als Warten: Wer Evaluierungsdatensätze, Modellzuordnung, Kostenbasis sowie schrittweise Rollouts und Rollbacks vorbereitet, kann nach der Veröffentlichung schnell auf das neue Modell wechseln.
Für Entwickler und Produktteams ist es am besten, die bestehenden Pläne weiterzuverfolgen und zugleich einen standardisierten technischen Prozess für die Anbindung neuer Modelle aufzubauen. Empfehlenswert ist, über APIYI auf apiyi.com zunächst die Kombination aus Argon und 3.8 Flash mit einem einzigen API-Schlüssel zu testen und anhand der Nutzungsprotokolle eine Kostenbasis zu schaffen. Sobald Gemini 4 Flash offiziell verfügbar ist, lässt es sich dann schrittweise im Vergleich testen.
Referenzen
- Gemini API-Modellreferenz: Offizielle Modell-IDs und Kontextfenster
- Link:
ai.google.dev/gemini-api/docs/models -
Hinweis: Die erste Anlaufstelle, um zu prüfen, ob Gemini 4 Flash veröffentlicht wurde
-
Gemini API-Preisseite: Offizielle Modellpreise
- Link:
ai.google.dev/gemini-api/docs/pricing -
Hinweis: Hier werden die Preise nach der offiziellen Veröffentlichung eines neuen Modells aufgeführt
-
Google AI Studio: Offizielle Plattform zum Testen von Modellen
- Link:
aistudio.google.com - Hinweis: Hier lässt sich prüfen, ob das Modell auswählbar ist
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Hinweise zur Modellanbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.